

取引におけるニューラルネットワーク:空間と時間の統合的視点(Global-Local Attention)
 17
 0

はじめに
金融市場は、空間と時間が密接に絡み合った、複雑かつダイナミックなシステムです。 あらゆる価格変動は、その瞬間の需給バランスだけでなく、過去の出来事の痕跡や、関連する金融商品、セクター、さらには各国経済全体からの影響も反映しています。 従来の手法を用いてこのようなシステムの挙動を予測することは、常に極めて複雑な課題でした。 統計モデルや従来のニューラルネットワークは、短期予測ではまずまずの性能を発揮しましたが、数時間を超える予測を試みると、安定性と精度が低下しました。 主な問題は、時間的要因と空間的要因が別々に考慮されていた点にありました。 しかし、これらを組み合わせようとすると、計算コストが爆発的に増加しました。
Extralongerフレームワークは、前回の記事で検討を始めたもので、根本的に異なるアプローチを提示しました。 その著者たちは、空間と時間は一つの全体として捉えるべきであるという考えに基づいていました。 アインシュタインの相対性理論に通じるこの考え方は、統一時空間表現として具現化されました。これは、時系列と空間的関係を人為的に分離することなく統合した表現です。 この解決策により、計算量が劇的に削減されました。 従来は演算数が指数関数的に増加していましたが、Extralongerはその増加を二次関数的なものに抑えました。 実際の成果は目覚ましいものでした。 学習速度は数百倍になり、メモリ消費量は数分の1に削減されました。そして何よりも重要なのは、数時間にとどまらず、数日、さらには数週間にわたる予測が可能になったことです。
これにより、金融市場に新たな機会がもたらされます。 これまでトレーダーやアナリストは短期的な評価にとどまっていましたが、今では、数取引日先を見通したり、マクロ経済指標の発表や中央銀行の政策決定の前後における市場の動きを予測したりする機会が生まれています。Extralongerによって、1週間先までの予測は、実現不可能な夢から実用的なツールへと変わります。
しかし、このフレームワークの真の実力は、そのアーキテクチャを通じて明らかになります。 これは3つの経路を持つTransformerに基づいており、各経路が分析の特定の側面を担当しています。
時間経路は、マクロ経済アナリストに例えることができます。 このアナリストは市場のリズムを研究し、成長と衰退のサイクルを見極め、季節性や繰り返されるパターンを検出します。 このモデルは、Self-Attention機構を用いて、時系列の離れた区間を結びつけます。 この通貨ペアの現在の動きは、1か月前に始まったトレンドの継続である可能性があります。
空間経路は、市場間の関係を分析する専門家としての役割を果たします。 金融市場では、他の資産から孤立して存在する資産はありません。 金価格の変動は株価指数に反映されます。 ドルの為替レートは商品市場に影響を与えます。 一方、債券利回りは株式市場の基調を左右します。Extralongerは、Global-Local Spatial Transformerを通じて、こうした関係を考慮します。この構成要素は、各証券を他のすべての証券と結びつける大域的な視点と、業種や地域ごとにまとめられた資産のクラスタに焦点を当てる局所的な視点を組み合わせています。
混合経路は、ポートフォリオマネージャーの役割に最も近いものです。 その役割は、時間的な変化と空間的関係を統合し、全体像を形成することです。 その結果、このモデルは市場を包括的に捉えます。 このモデルにとって、原油価格や金利の変動を伴うテクノロジーセクターのボラティリティの上昇は、単なる偶然の事象の集まりではなく、市場における大きなシナリオが形成されつつあることを示すシグナルです。
3つの経路が交差する地点で、最終的な予測が生まれます。 各専門家がそれぞれの知見を寄せ合う投資委員会と同様に、Extralongerは、すべての参加者の結論を重み付けして統合し、意思決定をおこないます。 その結果、このモデルは、局所的な分析の深さと大域的なつながりの網羅性に加え、時間とともに進む市場の動きを全体として捉える能力も獲得します。
この設計により、このフレームワークは金融アプリケーションにおいて特に有用なものとなっています。 このフレームワークは、時系列分析の深さ、市場間の関係の幅広い把握、そして全体を捉える視点を兼ね備えています。 その結果、Extralongerは、他のモデルでは精度が低下したり、過度なリソースが必要になったりする状況でも、頑健な予測を生成できます。
著者によるExtralongerフレームワークの構成図を以下に示します。
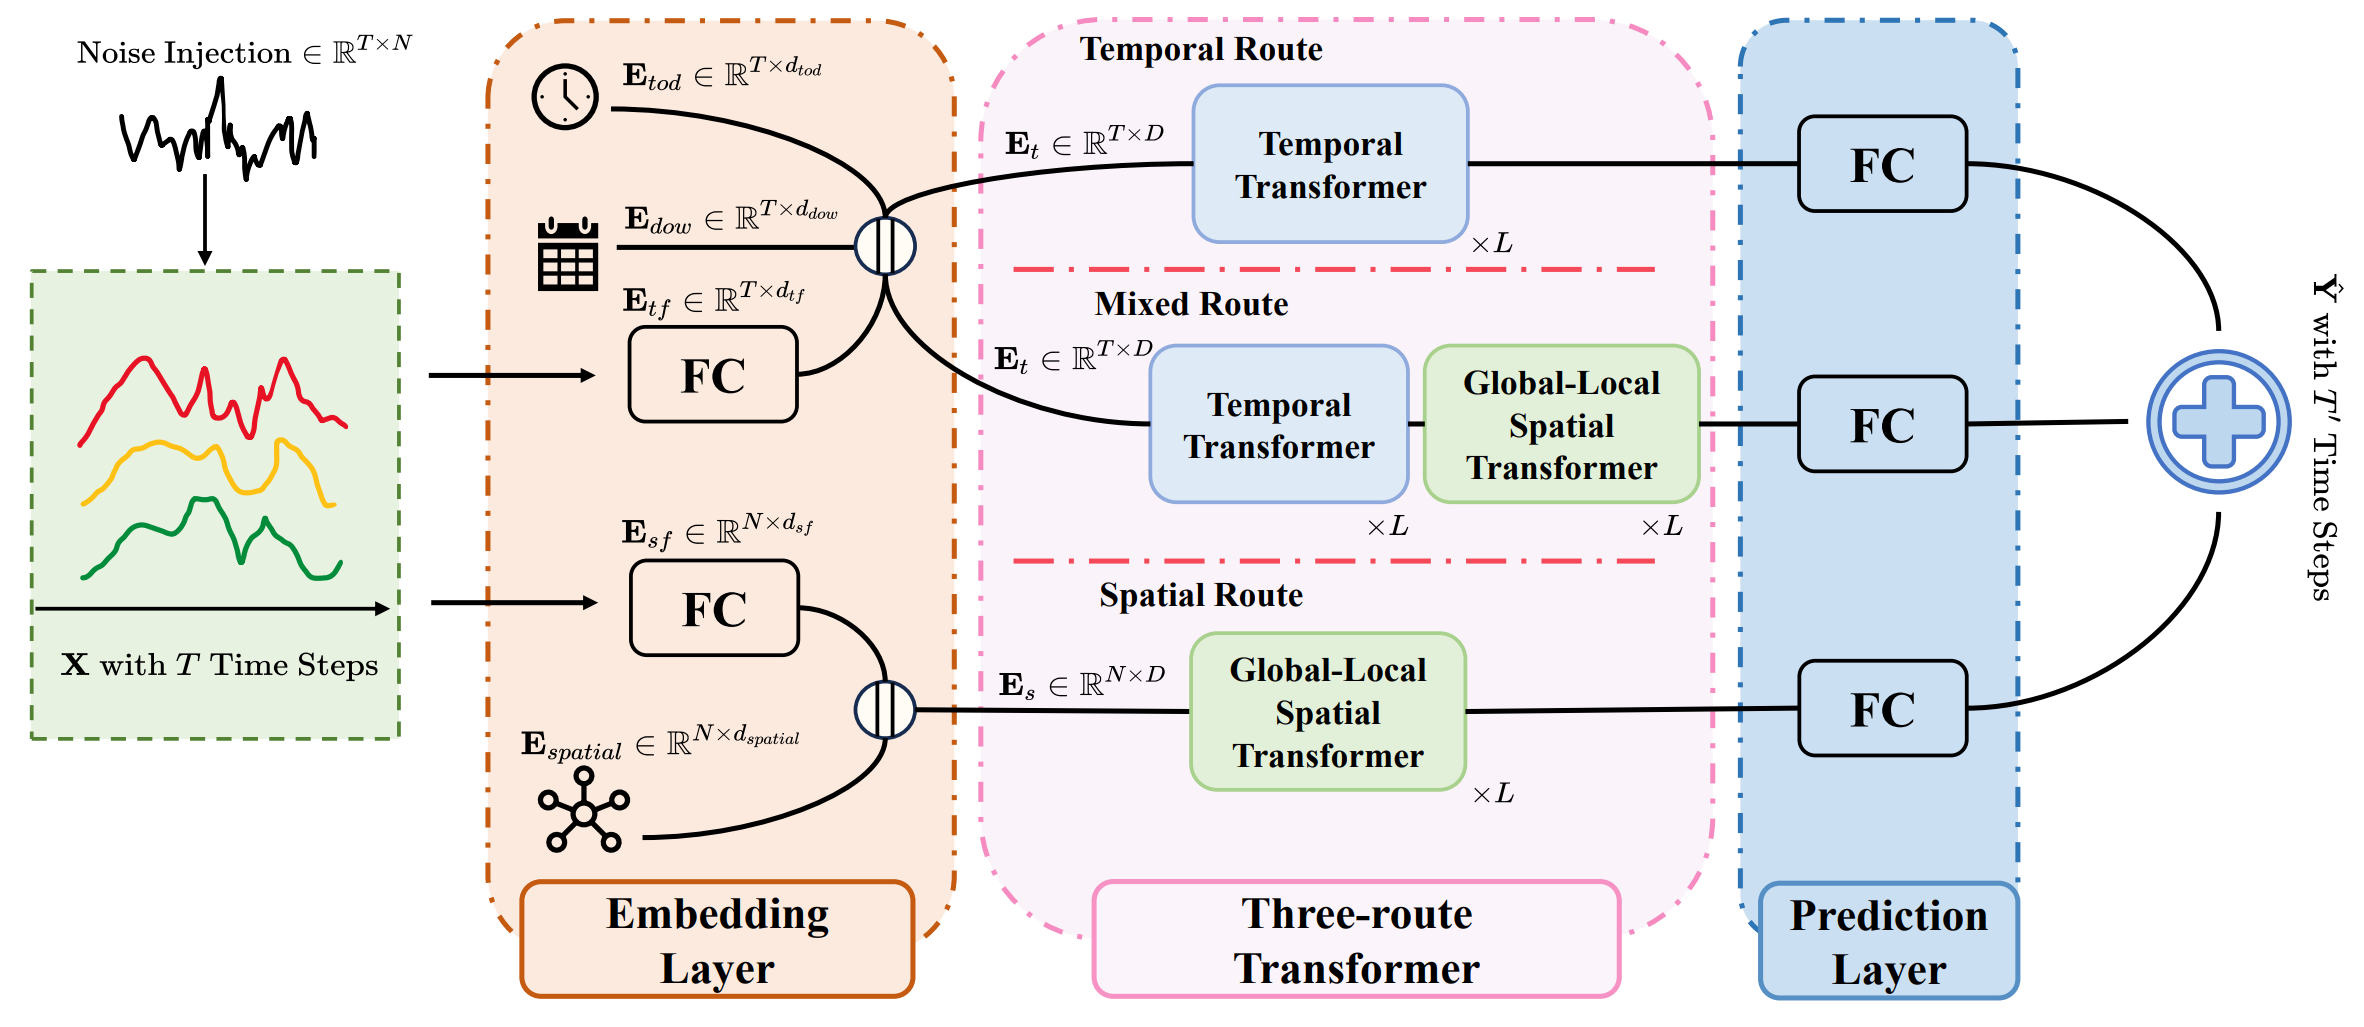
前回の記事の実践編では、提案された手法をMQL5を使用して実装するための第一歩を踏み出しました。 金融商品間の相互依存性を処理する空間エンコーディングモジュールを開発し、時間エンコーディングを担うOpenCLプログラムの個々のブロックも紹介しました。 これらの開発成果は、このフレームワークの本格的な実装版を構築するための基盤となっています。
今回はこの取り組みを継続し、Extralongerの基盤となるアイデアの実装に向けて、さらに進めていきます。 私たちの目標は、著者らが提案したアーキテクチャをMQL5環境へ段階的に移植し、実際の金融データで実用的に動作するようにすることです。
時間埋め込み
Extralongerフレームワーク向けのアルゴリズムを、MQL5を用いて引き続き開発しています。 前回の記事では、入力データに時間埋め込みを追加するOpenCLプログラムのカーネルについて詳しく解説しました。 ここからは、メインプログラム側でこの処理を実装していきます。 このために、新しいCNeuronTempEmbeddingオブジェクトを作成します。このオブジェクトは、CNeuronBaseOCLクラスから基本機能を継承します。
class CNeuronTempEmbedding    : public CNeuronBaseOCL
  {
protected:
   uint              iWindow;
   uint              iUnits;
   uint              aiEmbeddingDim[2];
   uint              aiFrames[2];
   uint              aiPeriod[2];
   CParams           caEmbeddings[2];
   //---
   virtual bool      ConcatByLabel(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   virtual bool      ConcatByLabelGrad(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override;

public:
                     CNeuronTempEmbedding(void) {};
                    ~CNeuronTempEmbedding(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window,
                          uint embed_dim1, uint period1, uint frame1,
                          uint embed_dim2, uint period2, uint frame2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronTempEmbedding;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
オブジェクトの主なパラメータには、分析対象の特徴量の数iWindow、系列長iUnits、埋め込み次元aiEmbeddingDim、1ステップ幅iFrames、繰り返し周期aiPeriodがあります。 これらはすべて配列を用いて定義されているため、このオブジェクトは柔軟性が高く、金融データのさまざまな時間スケールに対応できるようになっています。
オブジェクトの構造はInitメソッドで定義されており、このメソッドは、時間エンコーディング層およびその内部構成要素のすべての主要なパラメータの初期化を担当しています。
bool CNeuronTempEmbedding::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window,
                                uint embed_dim1, uint period1, uint frame1,
                                uint embed_dim2, uint period2, uint frame2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            (window + embed_dim1 + embed_dim2)*units, optimization_type, batch))
      return false;
最初のステップでは、親クラスCNeuronBaseOCLが初期化されます。 ここでは、層の主な特性を指定し、継承されたインターフェースを初期化します。 基底クラスの初期化に失敗した場合、この関数はfalseを返し、無効なオブジェクトの作成処理がそれ以上進まないようにします。
次に、データの時間埋め込みを生成するために、2つのcaEmbeddingsコンポーネントが初期化されます。 各埋め込みは、それぞれ固有の次元(embed_dim1およびembed_dim2)と繰り返し周期(period1およびperiod2)に基づいて作成されます。 これにより、モデルはさまざまな時間スケールと分析の深さで時間的パターンを捉えられます。これは、金融市場の動態を扱う際に特に重要です。
   if(!caEmbeddings[0].Init(0, 0, OpenCL, embed_dim1 * period1, optimization, iBatch))
      return false;
   if(!caEmbeddings[1].Init(0, 1, OpenCL, embed_dim2 * period2, optimization, iBatch))
      return false;
埋め込みコンポーネントの初期化が正常に完了すると、そのオブジェクトのパラメータが内部変数に格納されます。 これらのパラメータは、時間層の構造を定義し、ニューロンが時間の経過とともに市場をどのように捉えるかを制御します。
   iWindow = window;
   iUnits = units;
   aiEmbeddingDim[0] = embed_dim1;
   aiEmbeddingDim[1] = embed_dim2;
   aiFrames[0] = MathMax(1, frame1);
   aiFrames[1] = MathMax(1, frame2);
   aiPeriod[0] = period1;
   aiPeriod[1] = period2;
//---
   return true;
  }
最後に、このメソッドはtrueを返し、完全に機能するオブジェクトが正常に作成されたことを示します。
feedForwardメソッドは、層を通じたシグナルの順伝播を実装しています。 まず、オブジェクトが学習モードにあるかどうかを確認します(bTrain==true)。 その場合、各埋め込み成分に対して個別に順伝播が実行されます。 この手順により、さまざまな時間スケールにわたるパターンを捉えるための時間的特徴量からなるテンソルを構築することができます。 埋め込みのうち1つでも処理できない場合、この関数はfalseを返し、無効なデータがそれ以上伝播するのを防ぎます。
bool CNeuronTempEmbedding::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(bTrain)
      for(uint i = 0; i < caEmbeddings.Size(); i++)
         if(!caEmbeddings[i].FeedForward())
            return false;
//---
   return ConcatByLabel(NeuronOCL, SecondInput);
  }
埋め込み成分の順伝播が正常に完了すると、データはConcatByLabelメソッドを使用して結合されます。このメソッドは、OpenCLプログラム内の対応するカーネルのラッパーです。 ここでは、時間的特徴量が入力データと慎重に統合されています。 その結果、このオブジェクトは、過去のデータと現在の市場観測データを組み合わせた、処理可能なシグナルを生成し、モデルの精度と金融市場の変動に対する感度を確保します。
ご覧のとおり、順伝播メソッドは、比較的単純で直線的な処理の流れで実装されています。 同様に、誤差逆伝播と勾配更新のメソッドも単純明快で、標準的なニューラルネットワークの学習ロジックに従っています。より深く理解するために、これらの動作をご自身で確認してみてください。 CNeuronTempEmbeddingクラスおよびそのすべてのメソッドの完全なソースコードは添付ファイルに記載されています。これにより、このオブジェクトの実装や、モデルの計算チェーンへの組み込みについて詳細に確認することができます。
Attentionオブジェクト
時間埋め込みを準備し、入力データと統合した後、作業の次の段階であるGlobal-Local Spatial Attentionモジュールのアルゴリズムの実装に進みます。 コーディングに進む前に、このフレームワークの著者らが提案しているアプローチについて検討しておくことが重要です。
その主な考え方は、従来のSelf-Attentionに特徴的な大域的Attentionと、隣接行列を用いて実現する局所的Attentionとを組み合わせることです。 このアプローチは、これまで取り上げてきたグラフ畳み込み手法と類似していますが、この場合は、データの時空間構造に合わせて調整されています。
この記事の著者らは、隣接行列がどのように構築されたかについて、詳細な情報を提供していません。 この不足を補うため、Significant Neighbors Sampling(重要近傍サンプリング)アルゴリズムをSAGDFNフレームワークから採用します。 これは疎な隣接行列の作成に使用され、重要な局所的依存関係を考慮するモデルの能力を維持しながら、計算リソースを大幅に節約します。 ただし、このアプローチでは、疎行列を扱う際にインデックスや計算スレッドを慎重に扱う必要があるため、処理の実装にいくつかの注意点が生じます。
OpenCLコンテキスト側の実装
アルゴリズムをOpenCLプログラムに移植する際、市場データ分析の速度と精度に直接影響を及ぼす2つの大きな課題に直面します。 1つ目は、大域的Attentionと局所的Attentionの逐次実行です。これによりモデル全体の性能が低下し、大量の過去の価格データストリームの処理が遅くなります。 2つ目の課題はさらに微妙なものです。それは、価格水準間の局所的な関係に関する重要な情報を失わないように、全範囲を処理する大域的Attentionのスレッドを、疎な隣接行列とどのように連携させるかということです。 このモデルが複雑な市場パターンをどれほど効果的に認識できるかは、この設定の質に直接左右されます。
この2つの問題の解決は、意外なほど簡単でした。 Multi-Head Attentionの考え方に基づき、計算を個別のスレッドに分散させ、モデルが市場データのさまざまな側面を同時に分析できるようにしました。 もちろん、そのためには、処理対象のAttention Headに応じてアルゴリズムを分岐させる必要がありました。 しかし、このアプローチにより、大規模な過去の時系列データを処理する際の速度と精度を維持できました。これは、市場パターンを適時に特定する上で極めて重要です。
単一カーネルの並列スレッド内で大域的Attentionと局所的Attentionを実行するためのアーキテクチャ上の問題を解決し、次は順伝播アルゴリズムの具体的な実装に進みます。 これをGlobalLocalAttentionカーネルに実装しました。 ここにある各行は、モデルが過去のデータを分析し、有意義なシグナルを特定する際に行う各ステップを表しています。
__kernel void GlobalLocalAttention(__global const float *q,
                                   __global const float2* kv,
                                   __global float *scores,
                                   __global const float* mask,
                                   __global const float* label,
                                   __global float *out,
                                   const int dimension,
                                   const int total_kv,
                                   const int total_mask
                                  )
  {
//--- init
   const int q_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_q = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
カーネルは、以下の主要なデータをすべて受け取ります。
- Queryベクトルq:現在の市場に対する問い
- Key-Valueペア(kv):過去のパターンとその結果
- 局所的な制約を設けるためのマスクとラベル
- 特徴量空間の次元数およびデータ量に関するパラメータ
カーネル本体では、モデルはまず、3次元の問題空間で各エンティティが何に対応するかを特定します。
- q_idは特定のQueryです。
- local_idはグループ内のスレッドを表し、Attention Headに応じて、KeyとQueryのペア、または疎行列形式の隣接行列内の位置を指します。
- h_idは、市場の特定の側面を分析するAttention Headです。
ローカル配列は、中間計算用の一時バッファとして機能します。これは、最終評価の前に、その時点で得られたすべての結果を集めておくトレーダーのデスクのようなものです。
次に、分析対象のQueryのメモリオフセットを特定します。これは、チャート上で該当するバーを見つけ、過去の価格変動と比較するようなものです。
int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
次に、アルゴリズムに分岐を設けます。偶数番目のAttention Headは市場を大域的に捉え、過去のデータセット全体にわたって主要なパターンを評価する一方、奇数番目のAttention Headは市場を局所的に捉えます。
偶数番目のAttention Headについて、Keyの位置と、それに対応するAttention係数を計算します。 これは、現在のQueryに対して、チャート上の過去の支持線と抵抗線をすべてマークするようなものです。
   if(h_id % 2 == 0)
     {
      const int shift_kv = RCtoFlat(h_id, 0, total_heads, dimension, local_id);
      const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2, total_kv + total_mask, q_id);
      float score = 0;
      if(local_id < total_kv)
        {
         //---
         for(int d = 0; d < dimension; d++)
            score += IsNaNOrInf(q[shift_q + d] * kv[shift_kv + d].s0, 0);
        }
      else
         score = MIN_VALUE;
      //--- norm score
      score = LocalSoftMax(score, 1, temp);
      if(local_id < total_kv)
         scores[shift_s] = score;
現在のQueryと過去のデータとの相関関係を算出します。 あるスレッドが計算の対象外となる場合、市場における非アクティブなトレーダーと同様に、全体像を歪めないよう、そのスレッドには最小値を割り当てます。 その後、各パターンの重みを正規化します。 これは、シグナルの重要性を比較検討するようなものです。価格水準によっては強い影響力を持つものもあれば、ほとんど考慮されないものもあります。
最後に出力をまとめます。過去の値にそれぞれの重みを掛け、合計します。
      //--- out
      for(int d = 0; d < dimension; d++)
        {
         float val = (local_id < total_kv ? kv[shift_kv + d].s1 * score : 0);
         val = LocalSum(val, 1, temp);
         if(local_id == 0)
            out[shift_q + d] = val;
        }
     }
出力は現在のQueryに対するシグナルであり、そのまま分析や取引戦略に利用できます。
アルゴリズムの第2の経路では、対応するマスクを用いて局所的な接続を処理します。 ここでは、実質的に疎な隣接行列を扱っており、その要素の多くは存在しないか、現在の分析とは無関係です。
このアルゴリズムは、まず現在のローカル要素に対して接続が存在するかどうかを確認することから始まります。 ローカル変数kv_idは、Attention係数を計算する際に使用する実際のKeyを指しています。 kv_idが0未満の場合、疎行列に対応する要素が存在しないことを意味し、そのスレッドはスキップされます。 mマスクは、無効な接続をさらに除外します。
   else
     {
      int kv_id = -1;
      float score = 0;
      int shift_kv = -1;
      float m = 0;
      if(local_id < total_mask)
        {
         const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                        total_kv + total_mask, q_id);
         const int l = RCtoFlat(q_id, local_id, total_q, total_mask, 0);
         kv_id = IsNaNOrInf(label[l], -1);
         m = IsNaNOrInf(mask[l], 0);
         shift_kv = RCtoFlat(h_id, 0, total_heads, dimension, kv_id);
         if(kv_id >= 0)
            for(int d = 0; d < dimension; d++)
               score += IsNaNOrInf(q[shift_q + d] * kv[shift_kv + d].s0, 0);
         else
            score = MIN_VALUE;
        }
      else
         score = MIN_VALUE;
      //--- norm score
      score = LocalSoftMax(score * m, 1, temp);
      if(local_id < total_mask)
         scores[shift_s] = score;
Attention係数の計算には、既存のローカル接続のみが使用され、それ以外の接続には最小値が割り当てられます。 これにより、疎な構造が結果に悪影響を及ぼすことを防ぎ、モデルが関連する局所的なパターンのみに注目するようにします。
SoftMax正規化ではマスクが考慮され、確率の総和が実際に存在する局所要素だけに配分されます。
最後に、疎行列に実際に存在する局所的なパターンのみを考慮して、Queryに対する出力を生成します。
      //--- out
      for(int d = 0; d < dimension; d++)
        {
         float val = (kv_id >= 0 ? IsNaNOrInf(kv[shift_kv + d].s1, 0) * score : 0);
         val = LocalSum(val, 1, temp);
         if(local_id == 0)
            out[shift_q + d] = val;
        }
     }
  }
疎行列を使用すると、すべてのAttention Headに適用できる単純で汎用的なアルゴリズムを構築することはできません。 大域的Attention Headは密行列に対して処理を行います。すべての要素が存在するため、計算は単純です。 局所的Attention Headは疎な構造に対して処理を行います。多くの接続が欠けているため、マスクとラベルのチェック、NaN/Infのフィルタリング、および個別の加算ロジックが必要です。 そのため、単一のカーネル内に、それぞれが扱うデータ型に最適化された2つの別々のアルゴリズムを実装する必要がありました。1つは大域的な密行列用、もう1つは局所的な疎行列用です。
順伝播の実装が完了すると、誤差勾配の分配という、さらに困難な課題に直面しました。 ここで、GlobalLocalAttentionGradカーネルは、全体像と局所的なパターンの両方に同時に目を配る、経験豊富なトレーダーのような役割を果たします。 カーネル内の各スレッドは、チャートの特定のセクションを担当する個別のアナリストのようなものです。 ただし、その担当範囲は狭いものではありません。
ここでのglobal_idの解釈は、具体的なステージによって異なります。 Query、Key、またはValueのいずれかを指します。 その役割は各段階で変化し、誤差勾配を計算する対象を示します。 同様に、local_idの機能も変化します。これはグループ内のスレッドを特定するもので、トレーダーが複数の時間足を確認する様子になぞらえられます。 また、h_idはAttention Head、つまりアナリストが注目している市場の側面を決定します。
これらすべてのインデックスが観測ネットワークを形成し、勾配を正確に分配できるようにします。これは、細部を見逃さないように、さまざまな価格データに注意を振り分けるようなものです。
__kernel void GlobalLocalAttentionGrad(__global const float *q,
                                       __global float *q_gr,
                                       __global const float *kv,
                                       __global float *kv_gr,
                                       __global float *scores,
                                       __global const float *mask,
                                       __global const float *mask_gr,
                                       __global const float *label,
                                       __global float *out_gr,
                                       const int dimension,
                                       const int total_q,
                                       const int total_kv,
                                       const int total_mask
                                      )
  {
//--- init
   const int global_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_global = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
大域的な密行列を扱う偶数番号のAttention Headでは、その処理は完全な履歴データに基づく市場分析に似ています。 まず、Valueに対する勾配を計算します。各スレッドは、自身の位置が全体の結果に与える影響をLocalSumで加算して蓄積します。 これは、トレーダーが過去のすべてのローソク足からのシグナルを集約して、全体的なトレンドを見極める方法と似ています。
   if(h_id % 2 == 0)
     {
      //--- Value Gradient global_id -> v_id, local_id -> q_id
      for(int d = 0; d < dimension; d++)
        {
         const int shift_v = RCtoFlat(h_id, 2 * d + 1, total_heads, 2 * dimension, global_id);
         float grad = 0;
         for(int q_id = local_id; q_id < total_q; q_id += total_local)
           {
            int shift_s = RCtoFlat(h_id / 2, global_id, total_heads / 2, total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, d, total_heads, dimension, q_id);
            grad += IsNaNOrInf(scores[shift_s] * out_gr[shift_q], 0);
           }
         grad = LocalSum(grad, 1, temp);
         kv_gr[shift_v] = grad;
        }
次に、Queryの勾配が計算されます。 ここでは、SoftMaxによる正規化を考慮することが重要です。これは、アナリストがノイズによって全体像が歪められないよう、各シグナルの重要性を他のすべてのシグナルとの相対関係で評価するのと同じです。Queryの勾配は、ローカルスレッド間で慎重に合計され、q_grに書き込まれます。
      //--- Query Gradient global_id -> q_id, local_id -> k_id/v_id
      if(global_id < total_q)
        {
         //--- 1. Score grad
         float grad_s = 0;
         const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, local_id);
         const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2,
                                          total_kv + total_mask, global_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
         if(local_id < total_kv)
            for(int d = 0; d < dimension; d++)
               grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
         //--- 2. SoftMax grad
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         //--- 3. Query grad
         const int shift_k = shift_v - 1;
         for(int d = 0; d < dimension; d++)
           {
            float grad = 0;
            if(local_id < total_kv)
               grad = kv[shift_k + 2 * d] * grad_s;
            grad = LocalSum(grad, 1, temp);
            if(local_id == 0)
               q_gr[shift_q + d] = grad;
           }
        }
Keyの最終的な勾配は、すべてのQueryからの寄与を合計することで求められます。
      //--- Key Gradient global_id -> k_id, local_id -> score_id/v_id/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. Score grad local_id -> score_id/v_id
            float grad_s = 0;
            const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, local_id);
            const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2,
                                                total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
            if(local_id < total_kv)
               for(int d = 0; d < dimension; d++)
                  grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
            //--- 2. SoftMax grad
            grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
            BarrierLoc;
            if(global_id == local_id)
               temp[0] = grad_s;
            BarrierLoc;
            grad_s = temp[0];
            //--- 3. Key grad local_id -> dimension
            shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(q[shift_q] * grad_s, 0);
           }
         const int shift_k = RCtoFlat(h_id, 2 * local_id, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_k] = IsNaNOrInf(grad);
        }
     }
大域的な成分の場合、すべてのデータが揃っているため処理はスムーズに進行し、アルゴリズムは勾配を並列に分散させることができます。
局所的な疎行列を扱う奇数番目のAttention Headでは、カーネルにまさにトレーダーのような緻密さが求められます。 前述のアルゴリズムと同様に、まずValueの勾配を、すべてのQueryエントリにわたってループ処理で合計します。 ただし、ここでは各エントリについて、まずマスクとラベルを用いて接続の有無を確認します。 接続がない場合、またはマスクによってその要素の使用が禁止されている場合は、Queryスレッドはスキップされます。
   else
     {
      //--- Value Gradient global_id -> v_id, local_id -> mask_index/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. kv_id
            int kv_id = -1;
            float m = 0;
            const int l = RCtoFlat(q_id, local_id, total_q, total_mask, 0);
            const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                           total_kv + total_mask, q_id);
            //--- Check whether current Value is used
            if(local_id < total_mask)
               kv_id = (int)label[l];
            if(local_id == 0)
               temp[0] = 0;
            BarrierLoc;
            if(kv_id == global_id)
               temp[0] = scores[shift_s];
            BarrierLoc;
            if(temp[0] == 0)
               continue;
Valueの勾配は、存在する要素についてのみ計算されます。 Attention係数に対応する出力勾配を掛け、その積を累積します。
            //--- Value grad
            int shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(temp[0] * out_gr[shift_q], 0);
           }
         const int shift_v = RCtoFlat(h_id, 2 * local_id + 1, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_v] = IsNaNOrInf(grad, 0);
        }
Queryの勾配は、SoftMaxとマスクを考慮して算出されるため、トレーダーがノイズの多いバーや誤ったパターンを無視するのと同様に、不要なシグナルを除外できます。
      //--- Query Gradient global_id -> q_id, local_id -> mask label
      if(global_id < total_q)
        {
         //--- 1. kv_id;
         int kv_id = -1;
         float m = 0;
         const int l = RCtoFlat(global_id, local_id, total_q, total_mask, 0);
         if(local_id < total_mask)
           {
            kv_id = (int)IsNaNOrInf(label[l], -1);
            m = IsNaNOrInf(mask[l], 0);
           }
         //--- 2. Score grad
         float grad_s = 0;
         const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, kv_id);
         const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                   total_kv + total_mask, global_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
         if(local_id < total_mask)
            for(int d = 0; d < dimension; d++)
               grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
         //--- 3. SoftMax grad
         float score = IsNaNOrInf(scores[shift_s], 0);
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         mask_gr[l] = IsNaNOrInf(grad_s * score, 0);
         grad_s *= m;
         //--- 4. Query grad
         const int shift_k = shift_v - 1;
         for(int d = 0; d < dimension; d++)
           {
            float grad = 0;
            if(local_id < total_mask)
               grad = kv[shift_k + 2 * d] * grad_s;
            grad = LocalSum(grad, 1, temp);
            if(local_id == 0)
               q_gr[shift_q + d] = grad;
           }
        }
Keyの勾配は、そのKeyと実際に接続されているQueryについてのみ累積され、BarrierLocによるスレッド同期により、シグナルが失われないことが保証されます。 まるで、アナリストが最終的に取引にエントリーする前に、同僚の結果を突き合わせて確認しているかのようです。 各計算は、局所的な疎行列における影響の実際の分布を正確に反映し、不要なデータによる勾配の汚染を防ぎます。
      //--- Key Gradient global_id -> k_id, local_id -> score_id/v_id/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. kv_id;
            int kv_id = -1;
            float m = 0;
            const int l = RCtoFlat(global_id, local_id, total_q, total_mask, 0);
            if(local_id < total_mask)
              {
               kv_id = (int)label[l];
               if(kv_id == global_id)
                  m = mask[l];
              }
            m = LocalSum(m, 1, temp);
            if(m == 0)
               continue;
            //--- 2. Score grad local_id -> score_id/v_id
            float grad_s = 0;
            const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, kv_id);
            const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                           total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
            if(local_id < total_mask)
               for(int d = 0; d < dimension; d++)
                  grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
            //--- 3. SoftMax grad
            grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
            BarrierLoc;
            if(global_id == local_id)
               temp[0] = grad_s * m;
            BarrierLoc;
            grad_s = temp[0];
            //--- 4. Key grad local_id -> dimension
            shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(q[shift_q] * grad_s, 0);
           }
         const int shift_k = RCtoFlat(h_id, 2 * local_id, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_k] = IsNaNOrInf(grad);
        }
     }
  }
大域的な成分と局所的な成分には根本的に異なるアプローチが必要であるため、論理的に異なる2つのアルゴリズムが単一のカーネル内に実装されています。 大域的な密行列では、トレーダーが市場全体を一目で把握できるかのように、すべての要素について勾配を直接計算できます。 局所的な疎行列では、慎重なフィルタリングと同期処理を行い、存在する接続についてのみ勾配を合計する必要があります。 これは、トレーダーがチャートの限られた範囲で重要なシグナルを一つひとつ注意深く確認するのと同じです。 この分離により、密な大域的依存関係と疎な局所的相関が共存する大規模な過去の時系列データでモデルを学習する際に、勾配を正確かつ効率的に分配できます。
カーネルのあらゆる動作は、トレーダーが一つずつ踏み出すステップのようなものです。 マスクやラベルの確認は、真に重要な価格水準を選定することと似ています。 NaNやInfを除外することは、ノイズの多いデータを無視することを意味します。 LocalSumによる総和の計算とスレッドの同期は、重要なシグナルを見逃さないようアナリスト間の連携を図ることに相当します。 その結果、モデルはValue、Query、Keyに対する正確な勾配を取得できるようになり、過去のデータから学習し、重要な市場パターンを認識し、予測誤差を最小限に抑えることが可能になります。 このカーネルは、抽象的な計算を動的な市場分析プロセスへと変換し、各勾配演算がアナリストの実際の注目点や行動を反映することで、正確かつ安定した学習を保証します。
カーネルのコード全体は添付ファイルに含まれています。
メインプログラムでの実装
メインプログラムでは、Global-Local Spatial Attentionアルゴリズムを、新しいオブジェクトCNeuronGlobalLocalAttentionとして簡潔に実装しています。このオブジェクトは、マルチヘッド・フィードフォワード構造であるCNeuronMHFeedForwardの機能を継承しています。 このオブジェクトは、いくつかの主要な構成要素を組み合わせたものであり、それぞれがAttentionの構築において厳密に定義された役割を果たしています。
class CNeuronGlobalLocalAttention   :  public CNeuronMHFeedForward
  {
protected:
   CNeuronSNSMHAttention   cMask;
   CNeuronConvOCL          cQ;
   CNeuronConvOCL          cKV;
   CNeuronBaseOCL          cScore;
   CNeuronBaseOCL          cMHAttention;
   CNeuronConvOCL          cW0;
   CNeuronBaseOCL          cResidual;
   //---
   virtual bool      GlobalLocalAttention(void);
   virtual bool      GlobalLocalAttentionGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGlobalLocalAttention(void) {};
                    ~CNeuronGlobalLocalAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint dimension_k,
                          uint heads, uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronGlobalLocalAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
このクラス内部には、局所的な接続マスクの管理を担当するcMaskオブジェクトがあり、これにより、クラスは疎行列を正しく処理し、無関係なローカルパターンを除外することができます。 2つの畳み込みオブジェクトcQとcKVは、それぞれQueryとKey-Valueのペアを変換し、Attention係数の計算に向けてデータを準備します。 cScore要素はスコアを累積し、cMHAttentionはMulti-Head Attentionの結果を集約して、大域的な成分と局所的な成分を組み合わせます。 最後に、cW0およびcResidualは、線形変換と残差接続の加算を担い、出力シグナルの更新の安定性と正確性を確保します。 フィードフォワードブロックの機能は、親クラスによって実装されています。
Initメソッドは、ニューロンの完全な初期化を担当し、Global-Local Spatial Attentionアルゴリズムのすべての主要なパラメータを設定します。 まず、基底クラスCNeuronMHFeedForwardが初期化されます。 オブジェクトの主要なパラメータはすべてここで指定します。
bool CNeuronGlobalLocalAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                       uint units, uint window, uint dimension_k,
                                       uint heads, uint m_units, float sparse,
                                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronMHFeedForward::Init(numOutputs, myIndex, open_cl, window, 2 * window, units,
                                                      1, heads, optimization_type, batch))
      return false;
   activation = None;
この段階で何らかの問題が発生した場合、取引セッションは開始されません。オブジェクトが初期化されないために誤った計算がおこなわれるのを防ぐことができます。
次に、活性化関数を無効にします。これは、トレーダーが感情的なフィルターを介さず、市場の直接的なシグナルだけに頼って取引すると決めるようなものです。
まずはcMaskです。 局所的なマスクを管理し、疎なパターンをフィルタリングすることで、トレーダーが重要でないシグナルに気を取られることがないようにします。 この仕組みのおかげで、モデルはどの局所的な接続が重要で、どの接続を無視してもよいかを理解できるようになります。
   int index = 0;
   if(!cMask.Init(0, index, OpenCL, units, window, heads, m_units, sparse, optimization, iBatch))
      return false;
次に、cQとcKVが生成され、生データを意味のある分析シグナルに変換します。cQは、トレーダーが現在の市場ポジションを評価するのと同様にQueryを処理し、cKVは、トレーダーが過去のローソク足や支持線、抵抗線に関する情報を収集するのと同様に、KeyとValueを蓄積します。 両方のブロックでは、分析の線形性を歪みなく保つために、活性化関数を無効にしています。
   index++;
   if(!cQ.Init(0, index, OpenCL, window, window, 2 * dimension_k * heads, units, 1,
                                                             optimization, iBatch))
      return false;
   cQ.SetActivationFunction(None);
   index++;
   if(!cKV.Init(0, index, OpenCL, window, window, 4 * dimension_k * heads, units, 1,
                                                              optimization, iBatch))
      return false;
   cKV.SetActivationFunction(None);
次に、cScoreが作動し、受け取ったスコアを集計します。これは、トレーダーがすべての指標からのシグナルを組み合わせて、どこでポジションを取るかを判断する仕組みと似ています。
   index++;
   if(!cScore.Init(0, index, OpenCL, (units + m_units)*units * heads, optimization, iBatch))
      return false;
   cScore.SetActivationFunction(None);
   index++;
   if(!cMHAttention.Init(0, index, OpenCL, 2 * dimension_k * heads * units, optimization, iBatch))
      return false;
   cMHAttention.SetActivationFunction(None);
これらのスコアに基づき、Multi-Head Attention機構であるcMHAttentionが、さまざまな金融商品や時間間隔にリソースを配分します。 これは、経験豊富なアナリストが、現在の市場状況において何に最も重点を置くべきかを判断するのと同じです。
この処理の連鎖を締めくくるのが、cW0とcResidualです。 前者は、トレーダーが現在の市場出来高や流動性を考慮して計算を調整するのと同様に、シグナルに対して線形変換を行います。
   index++;
   if(!cW0.Init(0, index, OpenCL, 2 * dimension_k * heads, 2 * dimension_k * heads,
                                           window, units, 1, optimization, iBatch))
      return false;
   cW0.SetActivationFunction(None);
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
//---
   return true;
  }
2つ目は、残差接続を追加することで、これまでの学習ステップに関する情報が失われることなく、シグナルが安定した状態を保つようにします。これは、新しい取引を開始する前に、過去の取引のポジションを確認するようなものです。
各ブロックには一意のインデックスとパラメータが割り当てられ、OpenCLコンテキストにリンクされており、他のブロックと連携して動作する準備が整っています。 それはまるで、トレーダーとアナリストからなる、連携の取れたチームのようなものです。ある者はシグナルを絞り込み、別の者はトレンドを分析し、さらに別の者は結果をまとめ、そしてもう一人は各金融商品に注意を配分します。 その結果、初期化が完了すると、そのオブジェクトは完全に稼働可能となり、大域的な市場パターンと局所的な市場パターンを同時に分析し、ノイズを除去し、履歴データに基づいて正確な判断を下すことができるようになります。
オブジェクトの初期化が完了し、すべてのブロックの設定が終わると、順伝播が開始されます。この段階で、モデルは実際に市場を観察し、予測を生成します。 feedForwardメソッドは、各構成要素が厳密に定義された役割を果たし、データが変換の連鎖全体を通過するという明確な一連の処理を定義しており、これは連携の取れたトレーダーチームの働きに似ています。
bool CNeuronGlobalLocalAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cMask.FeedForward(NeuronOCL))
      return false;
まず、cMaskが起動され、局所的な接続の確認とフィルタリングがおこなわれます。 それは、トレーダーが、ノイズの多いパターンや欠損のあるパターンを無視し、真に重要なシグナルのみを慎重に選別するようなものです。 ここで何か問題が発生した場合、それ以上の分析は不可能となります。モデルは、誤ったデータに基づいて予測を生成することはありません。
次に、cQとcKVが順に実行されます。 前者はQueryを処理し、Keyとの比較に備えます。これは、アナリストが現在の市場状況を評価し、潜在的なエントリーポイントのリストを作成するのと同じようなものです。
   if(!cQ.FeedForward(NeuronOCL))
      return false;
   if(!cKV.FeedForward(NeuronOCL))
      return false;
2つ目は、各金融商品の価格データや出来高の履歴をまとめるように、KeyとValueを蓄積し、それによって各シグナルの影響を評価するための基盤を作ります。
準備フェーズが正常に完了すると、GlobalLocalAttentionラッパーメソッドが呼び出されます。このメソッドは、OpenCLコンテキスト内でメインアルゴリズムを実行する同名のカーネルをキューに追加する処理を管理します。
   if(!GlobalLocalAttention())
      return false;
ここでは、QueryとKeyが組み合わされて、大域的Attentionと局所的Attentionが生成されます。 ここでモデルの魔法が発揮されます。各パターンは、疎な接続と密な接続の両方を含む、関連するすべての接続を考慮して評価され、各パターンの寄与はすべてのAttention Headにわたって丁寧に合計されます。
この段階は、トレーダーが現在のシグナルを過去のデータと照らし合わせ、どのポジションに最も注目すべきかを判断する瞬間と似ています。
次に、cW0が実行され、Multi-Head Attentionの結果に対して線形変換が適用されます。 これは、市場の規模、流動性、および各パターンの重みを考慮してシグナルを調整するものだと考えることができます。
   if(!cW0.FeedForward(cMHAttention.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getOutput(), cW0.getOutput(), cResidual.getOutput(),
                       cW0.GetFilters(), true, 0, 0, 0, cW0.GetUnits()))
      return false;
//---
   return CNeuronMHFeedForward::feedForward(cResidual.AsObject());
  }
その後、データはSumAndNormalizeを通過します。 線形ブロックと残差接続の出力を合計し、それを正規化します。 この手順により、シグナルの安定性と拡張性が保たれます。これは、トレーダーが複数のアナリストの分析結果を統合し、その一貫性を確認したうえで、シグナルの総合的な強さを評価してから意思決定をおこなうことに似ています。
最後に、更新されたシグナルは親クラスCNeuronMHFeedForwardの同名のメソッドに渡されます。このメソッドは、フィードフォワードブロックの機能を実行し、その結果をモデル構造全体に統合することで、順伝播を完了します。
したがって、順伝播の処理全体は、各ブロックがデータのフィルタリング、評価、蓄積、調整、合計という特定の機能を担う、一連の市場分析と見なすことができます。これにより、予測の正確性と一貫性が確保されます。
モデルが順伝播を正常に完了し、予測を生成すると、学習フェーズが始まります。この段階で、ニューロンは自身の処理がどの程度正確だったかを評価し、内部パラメータを調整します。 calcInputGradientsメソッドは、この評価をおこなうとともに、モデルの各構成要素が最終結果に及ぼす影響を定量化し、その定量化された影響を各構成要素に配分する役割を担います。
bool CNeuronGlobalLocalAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
   if(!CNeuronMHFeedForward::calcInputGradients(cResidual.AsObject());)
      return false;
まず、受け取ったNeuronOCL入力データオブジェクトへのポインタが有効かどうかを確認します。 そのオブジェクトが存在しない場合、それ以上の計算はできません。これは、トレーダーがチャートや価格データなしにデータを分析しようとするのと同じことです。
次に、親クラスの同名のメソッドが呼び出され、勾配を残差接続オブジェクトまで逆伝播させる処理が開始されます。
次に、DeActivationメソッドがcW0ブロックに対して呼び出され、得られた勾配が線形層の活性化関数に基づいて調整されます。 これは、アナリストがシグナルをフィルタリングし、正規化することで、各指標が最終的な判断に与える影響を考慮に入れるのと同様です。
   if(!DeActivation(cW0.getOutput(), cW0.getGradient(), cResidual.getGradient(), cW0.Activation()))
      return false;
その後、勾配はcMHAttentionに渡され、そこで各Multi-Head Attentionパターンの影響が累積されます。
   if(!cMHAttention.CalcHiddenGradients(cW0.AsObject()))
      return false;
   if(!GlobalLocalAttentionGrad())
      return false;
この段階で、GlobalLocalAttentionGradが呼び出され、疎な接続と密な接続を考慮して、大域的な成分と局所的な成分の間で勾配が正確に分配されます。これは、トレーダーが全体のトレンドに対する各ローソク足や各支持線の寄与を評価するのとよく似ています。 また、勾配はcQブロックおよびcKVブロックへと慎重に伝播されます。
次に、すべての情報ストリームから、入力データレベルでの誤差勾配を収集する必要があります。 これらの情報ストリームは4つあります。 まず、cQから勾配を下方向に伝播させます。
   if(!NeuronOCL.CalcHiddenGradients(cQ.AsObject()))
      return false;
得られた値を残差接続経路の勾配と合算しますが、その前に、入力データ層の活性化関数に応じて、残差接続経路の勾配を調整します。
   if(!DeActivation(cResidual.getOutput(), cResidual.getGradient(),
                    cResidual.getGradient(), NeuronOCL.Activation()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
次のステップでは、cKVの勾配を処理し、それをそれまでに蓄積したデータに加算します。
   if(!NeuronOCL.CalcHiddenGradients(cKV.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
順序としては最後ですが、重要性ではほかに劣らない処理として、局所的なマスクcMaskの勾配を下方向に伝播させます。 また、それらの影響を、以前に蓄積されたデータと合算します。
   if(!NeuronOCL.CalcHiddenGradients(cMask.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), NeuronOCL.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
//---
   return true;
  }
その結果、calcInputGradientsメソッドは、大域的Attention Headと局所的Attention Headから、Query、Key、Value、マスクに至るまで、すべてのモデル構成要素が及ぼす影響について、包括的かつ詳細な評価を提供します。 各ブロックは定量的なフィードバックを受け取り、これによりモデルは重みを適切に更新し、誤差を最小限に抑え、予測の精度を向上させることができます。 このプロセスは、抽象的な勾配計算を、システム内の各要素の重要性に対する具体的な評価へと変換し、学習プロセスを可能な限り透明で制御しやすいものにします。
モデルが誤差逆伝播によって各構成要素の影響を推定したら、次は具体的な措置を講じる段階です。つまり、内部パラメータを調整し、モデルを実際の市場データに適応させます。 updateInputWeightsメソッドは、まさにこの処理を実行します。
bool CNeuronGlobalLocalAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cMask.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cQ.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cKV.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cW0.UpdateInputWeights(cMHAttention.AsObject()))
      return false;
//---
   return CNeuronMHFeedForward::updateInputWeights(cResidual.AsObject());
  }
このメソッドのアルゴリズムは、実は非常に単純明快です。学習可能なパラメータを含む内部コンポーネントに、制御を順次委譲していくというものです。 まず、局所的なマスクcMaskの重みが更新され、次にQuerycQおよびKey/ValuecKVのパラメータが調整されます。 その後、線形変換cW0の重みが更新されます。 最後に、親クラスのパラメータが調整されます。
各ステップは、シンプルでありながら重要なプロセスです。モデルはパラメータを調整して市場をより正確に評価し、予測を生成します。その間、すべての構成要素が、統一された戦略に従うトレーダーのチームのように、一丸となって機能します。
ここまで多くの作業に取り組み、数々の課題を無事に完了しました。 今こそ、少し休憩して一息つき、結果を振り返る絶好の機会です。 次回の記事では、気力を新たにし、新鮮な視点で取り組みを続け、完成へと導いていきます。
結論
ここまで長い道のりを歩んできました。Global-Local Spatial Attentionアルゴリズムの各ブロックを丁寧に統合し、単一の計算パイプラインとして構成しました。 順伝播、勾配の分配、そしてモデルパラメータの更新はすべて、シグナルを選別し、各金融商品の影響を評価し、最良の結果を得るためにポジションを調整する、経験豊富なトレーダーの仕事を思わせるものでした。
MQL5で実装したこのアプローチにより、複雑なAttentionアルゴリズムを実用に適した形にし、抽象的な計算を正確で制御可能な予測へと変換できることが示されました。 モデルの各ブロックは、独立したアナリストとしての役割を果たし、最終的な意思決定に寄与することで、システム全体の柔軟性、堅牢性、および拡張性を確保しました。
次の段階は、これまでの取り組みの最終検証となります。モデルを完成させ、実際の市場データを用いてテストし、提案したフレームワークの実用上の有効性を評価します。
参考文献
- Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19538
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。



