

取引におけるニューラルネットワーク:Adaptive Graph Diffusionモデル(SAGDFN)
 11
 0

はじめに
多変量時系列は、よく知られた時間的依存性(トレンド、季節性、活動の急増)だけでなく、それよりもはるかに厄介な空間相関によっても特徴づけられます。 空間相関は、ある系列の変化が他の系列にどのような影響を与えるかを表します。 そして、こうしたつながりは、まるで生き物のように独自に変化します。現れたり消えたりするだけでなく、その強さや方向も、世界のニュース、各国の金融政策の転換、政治的危機、技術的な飛躍的進歩に応じて変わります。 たとえば、エネルギーショックによって欧州の天然ガス価格が変動すると、それに応じてEURUSDの為替レートが変動することがあります。一方、半導体メーカーの株価は、アジアの工場の状況に影響を受けることがあります。
ARIMAやVARといった従来のモデルは、個々の時系列に対してはそれなりに有効でしたが、対象となる金融商品が数百にも及ぶと、対応が難しくなります。 サポートベクターマシン(SVM)やガウス過程といった次世代の機械学習手法は分析の可能性を広げましたが、そのアーキテクチャでは、豊かな相互関係のネットワークが考慮されることはほとんどありませんでした。 系列処理で目覚ましい成果を上げてきた現代のリカレントニューラルネットワーク(RNN)やTransformerでさえ、多変量を扱う場合には限界があることが明らかになっています。動的な相関ネットワークを扱うために必要な柔軟性が不足していたのです。
こうした背景のもと、グラフニューラルネットワーク(GNN)が登場しました。これはもともと、交通ネットワーク、社会的相互作用、サプライチェーンなど、明確なグラフ構造を持つ対象を扱うタスク向けに設計されたものです。 しかし、金融の世界では、このようなグラフの構築は、もはや芸術ともいえる作業です。 同じ業界に属する2つの企業がまったく正反対の動きを示すこともあれば、地理的に離れた2つの市場(たとえば米国と日本)が、同じマクロ経済的な刺激に対して足並みを揃えて反応することもあります。
その解決策となったのが、仮定に基づくのではなく、データから直接グラフを構築する適応重み付きグラフニューラルネットワーク(Adaptive-Weight GNN)です。 これらのモデルは、資産間の関係を表す行列を学習し、形式的な相関ではなく、実際の相関を特定します。 典型的な例として、しばしば安全資産として機能する金や日本円が挙げられます。 通常であれば、両者の間には明確な関連性が見られないかもしれませんが、世界的な激動の時期には、このモデルは両者の動きの連動性を検知し、それに応じて予測を調整します。
とはいえ、こうしたアプローチにも限界がないわけではありません。 第一に、スケーラビリティの問題です。多数の資産を対象とするN×Nの相関行列は、リソースを大量に消費する「怪物」と化し、中間計算の結果でメモリを埋め尽くして、高性能なGPUでさえ処理を停滞させることがあります。 第二に、見せかけのつながりです。 多くの適応アルゴリズムは、すべてのノードがある程度は相互に接続されていると仮定していますが、実際にはそうではありません。 金融予測では、地域市場の小規模な銘柄が世界全体の予測に大きな影響を与えるべきではありません。
これらの問題に対処するため、グラフ拡散と空間的スパース性の原理に基づく新しいアプローチが開発されました。 重要なのは、考えられるあらゆるつながりを分析しようとすることではなく、システム全体の基調を決定づける、いわば「影響力の拠点」となる重要なノードを特定することです。 金融の文脈では、米ドル、ユーロ、原油、金、そしてS&P 500や日経225といった株価指数などが該当します。
こうしたアルゴリズムの中でも、SAGDFNフレームワークは特に際立っており、論文「SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting」で発表されました。 このフレームワークの著者らは、重要ノードサンプリングアルゴリズムを用いて、最も重要なノードを選択することを提案しています。 次に、Sparse Spatial Multi-Head Attentionモジュールを用いて、これらの相互依存関係をさらに精緻化します。 その結果、コンパクトなN×M行列が得られます。ここで、MはNよりもはるかに小さくなります。
提案された手法を用いることで、計算複雑度はN²からMNに低減されると同時に、メモリ消費量も削減されます。 これにより、計算リソースに過度な負荷をかけることなく、膨大なデータセットに対する予測を生成できるようになり、システムのノイズに対する堅牢性も高まります。 これは、中央銀行による予期せぬ決定や商品価格の急激な変動によって引き起こされる市場の混乱期において、特に重要となります。
その実務上の意味合いは明らかです。 大規模な投資ファンドは、ポートフォリオのリバランスをより精緻におこなうためのツールを得ることができます。 ヘッジファンドにとっては、個々の資産の動向だけでなく、世界的な相互依存関係が織りなす複雑な相互作用も考慮した戦略の基盤となります。 アルゴリズムトレーダーは、意思決定に重大な遅れを生じさせることなく、多数の金融商品を扱うことができるようになります。
SAGDFNアルゴリズム
Scalable Adaptive Graph Diffusion Forecasting Network(SAGDFN)は、極めて大規模なグラフを扱う場合でも、時系列予測の柔軟性、拡張性、効率性を高めるように設計された最先端のアルゴリズムです。 基本的な考え方は、予測精度を損なうことなく、計算負荷と必要なメモリ量を大幅に削減することです。 このモデルは、グラフ構造全体を機械的に処理するのではなく、最終結果に実際に影響を与える最も重要な要素やつながりに焦点を当てます。 このアプローチは、余分なノイズを除去するだけでなく、より迅速に、より高い費用対効果と精度で予測を生成することも可能にします。
SAGDFNの動作において、α-Entmax関数は極めて重要な役割を果たしています。 これは一種のフィルターとして機能し、モデルがグラフのノード間の真に重要な空間相関を特定し、重要度の低い接続を無視できるようにします。 これは、金融市場や都市交通システムなど、データの構造が複雑で動的に変化する状況において、特に有用です。 選択された接続に基づいて、コンパクトな隣接行列が形成されます。この行列は手動で指定されるものではなく、学習プロセス中に生成されます。 この動的な構成により、アルゴリズムの柔軟性が高まり、完全な再構成をおこなうことなく、新たな状況に適応しやすくなります。
SAGDFNのアーキテクチャは、長年にわたり実績のあるEncoder-Decoderフレームワークに基づいていますが、空間的な関係に関する事前知識は一切必要としません。 これにより、このモデルの汎用性が確保され、多数の資産間の相互関係を特定することが重要な金融市場の変動分析から、エネルギーの流れや物流ルート、さらには生産チェーンの予測に至るまで、幅広い分野での適用が可能となります。 このモデルは、各ノードの最も重要な近傍を順次特定し、それらを初期情報と組み合わせて密な隣接行列を構築し、時空間解析に用います。
SAGDFNの特徴は、その主要な構成要素すべてが、同期し、互いに連携しながら学習される点にあります。 単一の最適化ループ内で、重要なノードのインデックス、それらの埋め込み、Attention機構のパラメータ、および最終的な隣接行列が最適化されます。 学習にはL1損失関数を使用し、予測精度とデータ内のノイズに対する頑健性のバランスをとります。 このアプローチにより、時間の経過とともに、モデルは予測の精度を向上させるだけでなく、分析対象のシステムの構造の変化にも適応できるようになります。
このように、SAGDFNは、グラフニューラルネットワークにおける長年の課題の一つ、すなわち、過度な複雑さや計算上のオーバーヘッドを回避しつつ高い予測精度を維持するという課題を解決します。
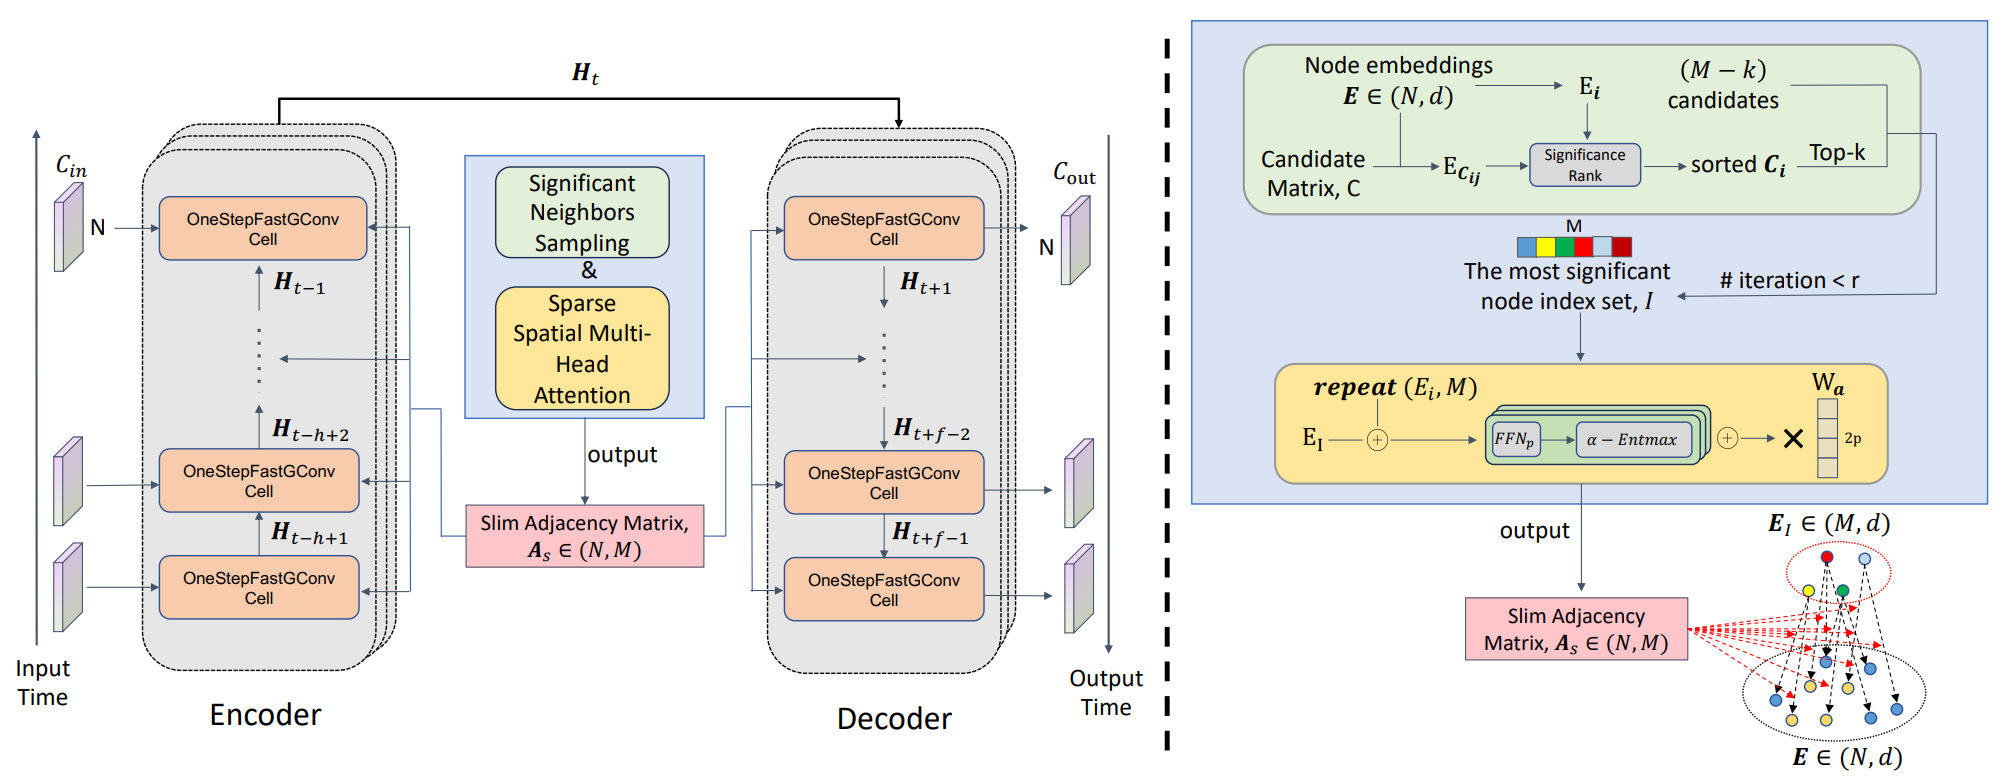
SAGDFNフレームワークの著者らは、最も重要なノードを選択するタスクをSignificant Neighbors Sampling (SNS)モジュールに割り当てました。これは、相互に接続された多数の要素を持つ時系列を予測する際に、グラフニューラルネットワーク(GNN)における計算プロセスの最適化を目指す手法です。
グラフモデルの従来の実装では、完全なN×Nの隣接行列を構築し、それを後続のグラフ畳み込みに用いて、分析対象のグラフ内のすべてのノード間の空間相関を特定します。 しかし、このアプローチの計算量は二次のオーダーで増大するため、非常に多くの計算資源を必要とします。 これは、ノード数が2000を超える場合に特に当てはまります。これは、金融市場、交通ネットワーク、産業用監視システムなど、実世界のアプリケーションにおいて頻繁に見られる状況です。
SNSの根底にある主な考え方は、接続の重要性を再考することにあります。つまり、すべてのノードが、グラフ内の特定の要素の状態に大きな影響を与えるわけではありません。 正確な予測をおこなうには、プロセスの動態に大きく寄与する、関連性の高い少数の近傍のみを考慮すれば十分です。 この手法では、全N個のノードから、このような重要な近傍を動的に選択し、サイズがN×Mのコンパクトな隣接行列を作成することを提案しています。ここで、MはNよりも大幅に小さい値です。 これにより、計算リソースへの負荷が軽減され、データ処理が高速化される一方で、システムの内部関係を正確に反映するモデルの能力は維持されます。
SNSの処理は、ノード埋め込み行列E ∈ RN×dの初期化から始まります。ここで、各行Eiは、i番目のノードのベクトル表現であり、その特性や関係性に関する情報を含んでいます。 同時に、候補行列C ∈ {1,…,N}N×Mが構築されます。各行は、対応するノードにとって重要である可能性のある近傍の集合を指定します。 この段階では、どの近傍が最も重要となるかはまだ正確には決まっていません。この選択問題は、データの空間的特性と文脈的特性を考慮して、後の段階で解決されます。
次に、SNSアルゴリズムは、埋め込み間の近接度を表す尺度を用いて、各ノードのM個の候補を重要度に応じて順位付けします。この尺度には通常、ユークリッド距離を用いますが、他の指標を用いることもできます。 2つのノードのベクトル表現間の距離が小さいほど、それらの関係が、一方から他方への実際の影響を正しく反映している確率が高くなります。 その後、重要度が最も高いK個の近傍からなる最終的な集合が形成され、これが隣接行列の中核となります。 残りのM−K個の位置には、ランダムに選択した要素を配置できます。これにより、接続の多様性を高め、データの局所的な変動に対するモデルの頑健性を向上させることができます。 この組み合わせによるアプローチは、構造が過度に硬直化するのを避け、接続を静的に固定した場合にしばしば生じる過学習を防ぎます。
この手法は、重要なノードのインデックス集合Iを出力します。この集合から、コンパクトな隣接行列Asが、サイズN×Mで構築されます。 このアプローチにより、計算量が大幅に削減され、従来の実装における二次の計算量O(N²)から、線形に近い計算量になります。 しかも、予測の精度を損なうことなく、それを実現しています。 その結果、SNSは、これまで計算リソースの負担が大きすぎると考えられていた分野にも、グラフニューラルネットワークを適用する道を開きます。市場価格の変動、交通流の分布、エネルギー消費量の変化など、要素間の相互関係が決定的な役割を果たすさまざまなプロセスを、リアルタイムで予測できるようになります。
このように、重要近傍サンプリングは単にリソースを節約するだけでなく、大規模グラフを扱うという概念そのものを再考することを可能にします。 すべての関係を大域的に分析する方法から、動的かつ選択的に分析する方法へ移行することで、より柔軟で適応性の高い予測モデルを構築するための条件が整います。このようなモデルは、過剰なデータに埋もれるのではなく、本当に重要なものに注目することを学習します。
Sparse Spatial Multi-Head Attentionモジュールは、SAGDFNの中核となる構成要素で、選択された重要な近傍ノードをコンパクトな接続行列Asに変換します。この行列のサイズはN×Mであり、グラフ畳み込みの際に、M個のノードそれぞれから対象ノードiへ伝達される情報の量を決定します。 グラフの接続構造に関する事前知識に基づくアプローチとは異なり、SS-MHAモジュールは完全にデータに基づいて構築されます。 このモジュールは外部の構造に依存せず、空間的な関係に関する誤った仮定や古くなった仮定の影響を受けません。 これにより、モデルの汎用性が高まり、金融市場、電力網、交通流などにおけるさまざまな問題に適用できるようになります。これらの分野では、構成要素間の関係が時間とともに変化するため、人手で設計した単純なモデルでは捉えきれません。
技術的には、このモジュールは2つの重要な概念を組み合わせたものです。 まず、ベクトルの内積を用いることで、ノード間の類似性の基本的な指標を効率的かつ並列に推定できます。ノードiのベクトルをM×d行列に変換する際には、行を繰り返し、そのノードのM個の重要な近傍の埋め込みと連結します。 これにより、ノードの局所的な文脈と近傍候補に関する情報を同時に含む行列が生成され、現代の自動微分フレームワークで高速な行列演算を実行できるようになります。
次に、SAGDFNフレームワークの著者らは、純粋に線形なアプローチから離れ、小規模なFeed-Forwardニューラルネットワークブロック(FFN)を用いて、非線形の相関尺度を学習します。 各ノードおよび各Attention Headについて、これらのFFNは連結された表現をスコア行列Yに変換します。この行列の2つの列は、それぞれ可能性の高い相関と可能性の低い相関として解釈されます。 この文脈において、Multi-Headアーキテクチャは、同じデータセットを異なる角度から検証する専門家グループの働きに似ています。あるヘッドは季節的な関連性を特定し、別のヘッドはニュースに対する反応を検出し、さらに別のヘッドは潜在的なリスク指標を明らかにします。
重要な手順の一つが、スコアの正規化です。 標準的なSoftMaxは、集合全体に重みを分散させ、重みが小さく重要性の低い接続を多数生み出しがちです。このフレームワークの著者らは、その代わりにα-Entmax関数を用いることを提案しています。 この関数は、スパースでありながら情報量の多い注意重みの分布を生成します。大きな値は増幅され、小さな値はゼロに抑えられます。 金融分野では、これは極めて重要です。どの時点でも、市場の方向性を実際に決定づける金融商品はごく少数に限られます。たとえば、基軸通貨、主要指数、主要なコモディティなどです。α-Entmaxは、目立つ対象に焦点を合わせ、背景のノイズを取り除くレンズのように機能します。 パラメータαは調整でき、α=1ではSoftMax、α=2ではSparseMax に対応します。 対象とするデータ領域に応じて、最適なスパース性の程度を選択します。
実際には、各Attention Headについて正規化スコアZpを計算し、それらを多次元テンソルZiにまとめます。このテンソルはノードiに対応します。 次に、全ノード分をまとめたテンソルZをサイズN×M×(2P)で構築し、重みWaを用いた線形変換によって、最終行列Asへと縮約します。この行列のサイズはN×Mです。 この行列は、もはや密なN×Nグラフではありません。代わりに、各ノードについて、後続のグラフ畳み込みに実際に影響を与えるM個の信号だけを慎重に選択します。
金融市場では、今日の価格変動に影響を与える金融商品が、明日も同じ影響を及ぼすとは限りません。このアプローチは、こうした市場で特に有効です。 たとえば、パニック局面では金や円が、経済成長局面ではS&P 500指数やハイテク株が、エネルギーショック時には原油価格やエネルギー輸出国の通貨が、市場を主導する可能性があります。 このモジュールにより、こうした顕在的なリーダーや潜在的なリーダーを特定すると同時に、予測を歪める可能性のある偶然の相関関係を排除することが可能になります。
予測精度の向上に加え、α-Entmaxには他にも利点があります。スパースなスコアによって、グラフ畳み込みにおける不要な演算が減り、モデルの解釈もしやすくなります。アナリストは、特定の金融商品の予測に実際に影響を与えたM個のノードを確認できます。 近傍の選択時におこなうランダムな置換とスパースな正規化を組み合わせることで、重要な変数を見落とさずに、ネットワーク全体にわたって埋め込みを確実に更新できます。
技術的な実装では、GPUと自動微分フレームワークの効率的な利用を考慮しています。具体的には、連結とバッチ処理、各Head向けのコンパクトなFFN、そして最終テンソルZからAsへの線形変換により、各ヘッドと各チャネルの影響をきめ細かくパラメータ化します。
これらを総合すると、Sparse Spatial Multi-Head Attentionは、精度とリソース効率の間で実用的なバランスを実現しています。すなわち、最も重要なシグナルに対する感度、変化する状況への適応性、そして数千の時系列に対応できる拡張性を兼ね備えています。
Encoder-Decoderアーキテクチャに基づく予測は、SAGDFNフレームワークにおける、それまでのすべての段階の集大成です。 このアプローチは、事前に選択された重要な近傍、Sparse Spatial Multi-Head Attention機構、および効率的なグラフ畳み込みを、時間的な変動を捉えられる強力な系列モデルと組み合わせたものです。 空間的な依存関係か時間的側面のいずれかに着目する単純なアプローチとは異なり、このフレームワークの著者らが提案するアプローチでは、両方の側面を一体として記述・活用できます。 これにより、多変量時系列に対して、より正確で堅牢な予測が可能になります。
直感的には、Encoder-Decoderの動作は次のように捉えることができます。 Encoderは、過去の系列から情報を凝縮し、時空間パターンを隠れ状態のコンパクトな表現として蓄積します。 その後、Decoderはこの表現と、各ステップで受け取った予測値を用いて、段階的に予測を生成します。
ここで重要な要素となるのは、高速なグラフ拡散メカニズムです。このメカニズムはコンパクトな隣接行列Asに基づき、各時間ステップでグラフのノード間に関連情報を伝達します。
近傍間の情報拡散を実現する多段階グラフ畳み込みは、次の式で定義されます。
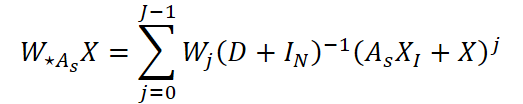
ここで、DはAsに対応する対角行列である次数行列、INはサイズNの単位行列、XIは選択されたM個の近傍(インデックスはI)について集約された入力データの行列です。
このような演算子は、ノード自身の状態に関する情報(Xの項)を保持し、関連する近傍からの信号(AsXI)を蓄積した後、それらを次数の和で正規化し、線形フィルタWjに通します。 実用上の利点は、パラメータJを用いて情報の伝播半径を制御できる点にあります。Jが小さいと局所的なつながりを捉え、大きいとより遠くのノードからの影響を考慮します。
次に、SAGDFNフレームワークの著者らは、このグラフ演算をGRUに類似したステップに組み込み、標準的な行列乗算をグラフ畳み込みに置き換えます。 これにより、空間的な集約と時間的な再帰を組み合わせた1ステップの反復処理であるOneStepFastGConvが得られます。
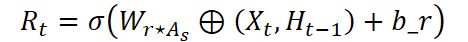
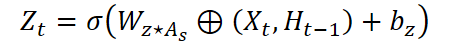
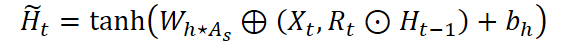
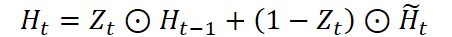
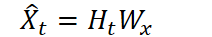
ここで、連結演算子⊕は現在の観測値と直前の隠れ状態を連結し、演算子⊙およびσは通常の意味を持ちます。 このステップにより、各ノードは、隠れ状態を更新する前に、自身の特徴量と、グラフ内の最も重要なパートナーからのシグナルを確実に考慮に入れるようになります。 これは金融分野において特に重要です。株価を予測する際には、その銘柄自体の過去の推移だけでなく、通貨、コモディティ、指数といった主要な関連金融商品の動きも考慮されます。
データの予測は、EncoderとDecoderの2段階でおこなわれます。 Encoderでは、OneStepFastGConvを長さhの履歴ウィンドウに対して実行し、最終的に、解析対象のデータウィンドウ全体の時空間情報を蓄積した表現Ht0-1を得ます。
その後、Decoderは初期状態Ht0-1とステップt0における観測値を起点として、指定された数の将来ステップを順次生成します。
学習はエンドツーエンドの誤差逆伝播法を用いておこなわれます。すなわち、Θ(埋め込み、注意モジュール内のFFNのパラメータ、グラフ畳み込みの重み、GRUのパラメータを含む)に関する勾配が計算され、モデルの更新に用いられます。 注目すべき点は、埋め込みが近傍の選択とAsの計算の両方に関与しているため、学習の過程でグラフ構造も変化することです。これにより、システムは適応性を獲得し、市場の変化に応じて新たな意味のあるつながりを発見できるようになります。
Encoder-Decoderは、OneStepFastGConvおよび適応的なAs構造と組み合わせることで、時空間予測のための強力かつ柔軟なプラットフォームを構成します。 この手法は、解釈可能性(疎な接続行列や関連性の高い近傍の可視化を通じて)、適応性(埋め込みやグラフ構造の動的な更新)、そして実用的なスケーラビリティを兼ね備えており、金融市場における分析や意思決定にとって特に有用なツールとなっています。
著者らによるSAGDFNフレームワークの構成図を以下に示します。
MQL5での実装
SAGDFNフレームワークの理論面について詳しく検討したところで、提案された手法の実装に移ります。 ここでは、フレームワークの著者らのアイデアをMQL5環境に実装する具体的な方法を1つ紹介します。 この実装にあたり、以下の点を検討します。
- データの準備
- 埋め込みの保存と更新
- 重要近傍のサンプリング
- スパースAttention機構
- 高速グラフ畳み込みの再帰処理への統合
目標は、必要な機能と再現性を備え、何よりも実運用に適した実用的な実装を実現することです。
Significant Neighbors Samplingモジュールは、単純でありながら極めて重要な1つの役割を果たしています。それは、ネットワークの情報構造を真に形作るリーダーを選定することです。 適切な近傍の選択によって、どの信号が増幅され、どの信号がバックグラウンドノイズとして残されるかが決まります。
ここで留意すべき点は、SAGDFNフレームワークの著者らが、前のステップで得られた重要度が最も高いM個の近傍を順位付けし、その中で最も近いK個の要素からなる集合を隣接行列の中核とすることを提案した点です。 残りのM−K個の位置には、接続の多様性を高めるために、ランダムに選択された要素が配置されます。 本実装では、さらに一歩踏み込んで、ランダムに抽出したサンプルの並列順位付けを追加することにしました。
考え方はシンプルながら効果的です。まず最も近いK個の候補を選び、その後ランダムな要素を補充するのではなく、事前選択された候補とランダムな候補の2つのプールを作成します。 その後、それらを同時に評価します。 最終的なサンプルには、ヒューリスティックで選択されたかランダムに選択されたかにかかわらず、統合したプールの中で埋め込みが実際に最も近いノードが含まれます。 この活用と探索の組み合わせにより、モデルは安定性と柔軟性を両立できます。実績のある有力なノードを維持しながら、市場への影響の新たな中心となるノードも見つけられるのです。
このアルゴリズムの具体的な実装は、OpenCLの実行環境でおこないます。 そのために、SignificantNeighborsSamplingカーネルを作成します。
__kernel void SignificantNeighborsSampling(__global const float *data,
                                           __global const float *candidates,
                                           __global const float *random_cands,
                                           __global float *neighbors,
                                           const int dimension
                                          )
  {
   const size_t main = get_global_id(0);
   const size_t slave = get_local_id(1);
   const int total_main = (int)get_global_size(0);
   const int total_slave = (int)get_local_size(1);
カーネルは、シグネチャ宣言から始まります。 このカーネルは、グローバル配列data、candidates、random_candsを入力として受け取ります。これらは、時系列の埋め込みと2つの候補プールを格納するためのものです。 neighbors配列は、結果を格納するために使用されます。 整数パラメータdimensionは、埋め込みの次元数を指定します。 このシグネチャは、処理の分担を定義しています。1つのグローバルワークアイテムが1つの主ノード(main)を担当し、グループ内の複数のローカルワークアイテムが候補の処理を担当します。
次に、実行コンテキストの識別子を取得し、ローカル配列を宣言して、処理に用いるローカルサイズを計算します。
   __local int Idx[LOCAL_ARRAY_SIZE];
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int ls = min(total_slave, (int)LOCAL_ARRAY_SIZE);
ローカルメモリは、計算を高速化するための強力なツールです。ここでは、サブグループ内のインデックスや距離を一時的に格納するためのバッファとして使用されています。
次のブロックでは、一次元の入力データ配列内で、必要な系列要素へのオフセットを求めます。
   const int shift_main = RCtoFlat(main, 0, total_main, dimension, 0);
   int cand = (int)candidates[slave];
   int rand_cand = (int)random_cands[slave];
ここで、最も近い近傍の探索には2つのプールを使用し、そのうち一方はランダムサンプリングによって生成している点に注意してください。 この場合、系列の1つ以上の要素が両方のサンプルに含まれる可能性がかなり高くなります。 したがって、次のブロックでは、単純な重複チェックをおこないます。 これにより、同じインデックスが再度考慮されることを防ぐことができます。これは理にかなっており、計算負荷を軽減します。 最初のステップでは、現在のワークアイテム内で重複がないかを確認します。
//--- duplicate check
   if(rand_cand == cand)
      rand_cand = -1;
次に、以前に選択された近傍の集合内に重複がないかを確認します。
//--- Look in candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Idx[slave - l] = cand;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i >= (slave - l))
            continue;
         if(cand == Idx[i])
            cand = -1;
         if(rand_cand == Idx[i])
            rand_cand = -1;
        }
      BarrierLoc;
     }
ここでは、候補のインデックスをバッチ単位でローカルデータ配列に書き込み、その後、各ワークアイテムが自身のインデックスを配列の要素と比較します。
各要素が1つだけ保持されるように、重複チェックでは先行するワークアイテムのインデックスのみを調べる点に注意してください。 その結果、後続のワークアイテムに含まれる要素のみが除外され、最初に現れた要素は保持されます。
続いて、無作為に選択された候補のプールについても、同じ方法でチェックします。
//--- Look in random candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Idx[slave - l] = rand_cand;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i >= (slave - l))
            continue;
         if(cand == Idx[i])
            cand = -1;
         if(rand_cand == Idx[i])
            rand_cand = -1;
        }
      BarrierLoc;
     }
候補がローカルグループ内での一意性チェックに合格したら、平坦化された配列内のオフセットshift_candとshift_rand_candを計算し、data配列内の各候補の埋め込みの開始位置を求めます。
   const int shift_cand = RCtoFlat(cand, 0, total_main, dimension, 0);
   const int shift_rand_cand = RCtoFlat(rand_cand, 0, total_main, dimension, 0);
次に、ユークリッド距離の計算が始まります。 まず、両方のプールに含まれる候補の距離を表すローカル変数をゼロに初期化します。
//--- calc distance
   float dist_cand = 0;
   float dist_rand_cand = 0;
   for(int d = 0; d < dimension; d++)
     {
      float value = IsNaNOrInf(data[shift_main + d], 0);
      if(main != cand && cand >= 0)
         dist_cand += pow(value - IsNaNOrInf(data[shift_cand + d], 0), 2.0f);
      if(main != rand_cand && rand_cand >= 0)
         dist_rand_cand += pow(value - IsNaNOrInf(data[shift_rand_cand + d], 0), 2.0f);
     }
次に、埋め込みの各次元を走査するループで、対象の埋め込みと候補の埋め込みの値を取得します。 距離を求めるために、対象の要素と対応する候補の要素との差の二乗をローカル変数に加算していきます。
なお、計算は除外されていない要素に対してのみおこなわれます。
距離を計算した後、順位付けの準備を始めます。 まず、ローカル変数cand_positionとrand_positionを、配列の先頭要素に対応する0に初期化します。 ただし、事前選択された候補のプールと無作為に選択された候補のプールの要素について、距離が等しいかどうかを確認します。 距離が等しい場合は、以前に選択された候補のプールを優先し、rand_positionをインクリメントします。
//--- calc position
   int cand_position = 0;
   int rand_position = (int)(dist_cand >= dist_rand_cand);
続いて、一連のブロックで、ローカルメモリTempのチャンクから現在の距離をまとめて収集し、処理対象の距離よりも小さい距離を持つローカルサンプル内の要素数を数えます。 最初の一連のブロックでは、事前に選択された候補のプールから距離(候補が存在しない場合は-1)をコピーします。
//--- by candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Temp[slave - l] = (cand >= 0 ? IsNaNOrInf(dist_cand, -1) : -1);
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (slave - l))
            continue;
         if(Temp[i] < 0)
            continue;
         if(cand >= 0)
           {
            if(Temp[i] < dist_cand)
               cand_position++;
            else
               if(Temp[i] < dist_cand && i < (slave - l))
                  cand_position++;
           }
         if(rand_cand >= 0)
           {
            if(Temp[i] < dist_rand_cand)
               rand_position++;
            else
               if(Temp[i] < dist_rand_cand && i < (slave - l))
                  rand_position++;
           }
        }
      BarrierLoc;
     }
グループ内の各ワークアイテムは、Tempの要素を順に処理し、距離の大小関係に応じてcand_positionとrand_positionをインクリメントします。 ここでは、同順位の解消に細かなロジックが用いられています。2つの距離が等しい場合はインデックスで順序を決めるため、距離が等しくても決定論的な順位付けが保証されます。 バリアにより、Tempには読み取り前に値が適切に格納され、読み取り後にクリアされることが保証されます。
同様に、第2の一連の処理でも同じ操作をおこないますが、ランダムサンプルの要素の距離をTempに移し、ローカルサブグループの残りの要素を考慮して、位置を再度調整します。
//--- by random candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Temp[slave - l] = (rand_cand >= 0 ? IsNaNOrInf(dist_rand_cand, -1) : -1);
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (slave - l))
            continue;
         if(Temp[i] < 0)
            continue;
         if(cand >= 0)
           {
            if(Temp[i] < dist_cand)
               cand_position++;
            else
               if(Temp[i] < dist_cand && i < (slave - l))
                  cand_position++;
           }
         if(rand_cand >= 0)
           {
            if(Temp[i] < dist_rand_cand)
               rand_position++;
            else
               if(Temp[i] < dist_rand_cand && i < (slave - l))
                  rand_position++;
           }
        }
      BarrierLoc;
     }
この部分を理解することが重要です。このアルゴリズムでは位置のカウントを分散しておこない、各slaveが、ローカルグループ内で距離順に並べたリストにおける自身の位置を独立に決定します。 これにより、グローバルなソートをおこなわずに、ローカルな処理だけで順位付けができるため、メモリと時間の両方を節約できます。
最後のステップは、結果を書き出すことです。 候補が存在し、その位置が探索する近傍の総数より小さい場合、オフセットインデックスを計算し、その候補のインデックスをneighbors配列の対応する要素に書き込みます。
//--- result
   if(cand >= 0 && cand_position < total_slave)
     {
      const int shift_dist_cand = RCtoFlat(main, cand_position, total_main, total_slave, 0);
      neighbors[shift_dist_cand] = cand;
     }
   if(rand_cand >= 0 && rand_position < total_slave)
     {
      const int shift_dist_cand = RCtoFlat(main, rand_position, total_main, total_slave, 0);
      neighbors[shift_dist_cand] = rand_cand;
     }
  }
ここで示したアルゴリズムは、決定論的な候補とランダムな候補を並列に評価し、ローカルに重複を排除して距離を計算し、グローバルなソートを行わずにローカルな部分サンプル内での位置に基づいて候補を順位付けします。
今日は多くの実質的な作業を進め、記事もすでにかなり充実した内容になりました。 ひと息ついて、考えを整理し、これまでの取り組みを新たな視点で振り返る絶好のタイミングです。 次回の記事では、新たな意気込みを持ってこの話題に戻り、これまで歩んできた道を、一歩ずつ着実に進んでいきます。
結論
本記事では、SAGDFNフレームワークについて考察しました。このフレームワークは、スケーラビリティ、大規模グラフを効率的に処理する能力、そして精度を犠牲にすることなく計算コストを最小限に抑える能力により、類似のソリューションの中でも際立っています。 ノード間の有意義な関連性を選択するためのこの適応的なアプローチにより、重要な情報を保持しつつ、不要なデータによってモデルに過度な負荷がかかるのを回避することが可能になります。
理論編では、このフレームワークの主な特徴と内部メカニズムについて詳しく検討しました。 アルゴリズムの仕組みについて説明した後、その実装に向けた第一歩を踏み出しました。 特に注目したのは、Significant Neighbors Samplingモジュールです。このモジュールは、大規模なグラフを扱う際の計算の最適化やコスト削減において重要な役割を果たします。 同時に、近傍選択のプロセスをより柔軟かつ適応性の高いものにするため、いくつかの改良を加えました。
この取り組みは、大量のデータを効果的に処理し、そこから有用な時空間依存関係を抽出できる本格的な予測ツールの開発に向けた、重要な一歩となりました。 次回の記事では、この方向性を踏襲し、アーキテクチャに新しいコンポーネントを追加しながら、実際の履歴データを用いたシステム全体の包括的なテストへと段階的に進んでいきます。
リンク
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19323
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。



