

Neuronale Netze im Trading: Das adaptive Graphdiffusionsmodell (Fazit)
 20
 0

Einleitung
Heute schließen wir unsere Arbeit an der Umsetzung der von den Autoren des SAGDFN-Frameworks vorgeschlagenen Ansätze ab. Die Autoren des Frameworks schlugen eine mögliche Lösung für das drängendste Problem bei der räumlich-zeitlichen Prognose vor – die unaufhaltsam zunehmende Komplexität bei der Verarbeitung großer Graphen. Herkömmliche Modelle graphneuronaler Netze (GNN) leiden unter redundanten Kanten: Je mehr Knoten vorhanden sind, desto größer ist die Wahrscheinlichkeit, dass aussagekräftige Informationen in einer Flut unbedeutender Interaktionen untergehen. Der Versuch, alle Kanten unterschiedslos zu verarbeiten, führt zu einem quadratischen Anstieg des Rechenaufwands und zu einer Verschlechterung der Generalisierungsfähigkeit des Modells. Die Autoren von SAGDFN schlugen vor, diesen Teufelskreis zu durchbrechen, indem man sich ausschließlich auf wirklich signifikante Zusammenhänge konzentriert und Irrelevante bereits in den frühen Phasen der Datenverarbeitung herausfiltert.
Das Modul „Significant Neighbors Sampling“ (SNS) war der erste Baustein dieses Konzepts. Das Ziel besteht darin, für jeden Knoten eine Menge relevanter Nachbarn zu ermitteln, die den größten Vorhersagewert bieten. Beim klassischen Ansatz berücksichtigen Graphmodelle entweder unterschiedslos alle Nachbarn oder sind streng auf eine feste Struktur beschränkt. SNS geht noch einen Schritt weiter: Es bildet dynamisch eine Menge von Kanten, indem es sowohl die ähnlichsten Kandidaten gemäß einer Ähnlichkeitsmetrik als auch zufällig ausgewählte Elemente analysiert, um die Vielfalt zu erhalten. Dies verringert nicht nur die Dimensionalität des Graphen, sondern senkt auch das Risiko einer Überanpassung, da das Modell nicht auf eine vordefinierte Struktur beschränkt ist, sondern lernt, adaptiv eine Karte der Bedeutung der Kanten zu erstellen.
Sobald die Graphstruktur gebildet wurde, kommt „Sparse Spatial Multi-Head Attention“ (SSMHA) zum Einsatz – ein adaptiver Aufmerksamkeitsmechanismus, der auf der im vorherigen Schritt erhaltenen dünnbesetzten Struktur arbeitet. Dieses Modul erfüllt gleich zwei wichtige Funktionen: Es verteilt die Gewichte unter den Nachbarn neu und ermöglicht es jedem Knoten, durch Mehrkopfaufmerksamkeit verschiedene Aspekte des Kontexts zu berücksichtigen. Im Gegensatz zum klassischen SoftMax, bei dem die Summe aller Gewichte stets streng normiert ist, verwendet SAGDFN α-Entmax, wodurch die Gewichte unbedeutender Kanten konsequenter auf null gesetzt werden können. Bei α = 1 reduziert sich diese Funktion auf das Standardverfahren SoftMax und bei α = 2 auf Sparse-SoftMax, bei dem unwesentliche Elemente effektiv aus den Berechnungen ausgeschlossen werden. Dadurch gewinnt das Modell an Flexibilität. Es kann für schwache Signale empfindlich bleiben, wenn es darauf ankommt. Und gleichzeitig kann es sich auf die wirklich wichtigen Knoten konzentrieren, wenn der Graph zu dicht wird.
Eine weitere, ebenso wichtige Komponente ist OneStepFastGConv – eine optimierte Graphfaltung, die eine räumliche Merkmalstransformation in einem einzigen Schritt durchführt und so redundante Operationskaskaden vermeidet. Anstatt mehrere Schichten nacheinander anzuwenden, von denen jede nur eine kleine Transformation durchführt, nutzt dieser Ansatz eine einstufige Aggregation, wodurch das Training beschleunigt und der Speicherbedarf reduziert wird. Dieser Ansatz ist besonders wichtig für Echtzeitaufgaben, bei denen jede Millisekunde der Datenverarbeitung zählt.
Die Art und Weise, wie diese Module zusammenwirken, erinnert an ein gut eingespieltes Orchester: SNS wählt die wichtigsten Musiker aus, SSMHA verteilt unter ihnen die Rollen und Akzente, und FastGConv verwandelt diese Kakophonie von Signalen in eine harmonische Melodie der Vorhersage. Zudem wurden alle Elemente ursprünglich so konzipiert, dass sie skalierbar sind. Das heißt, sie können sowohl mit relativ kompakten Graphen als auch mit großen Strukturen aus Tausenden Knoten und Millionen potenzieller Kanten effektiv arbeiten.
Nachstehend ist eine vom Autor erstellte Darstellung des SAGDFN-Rahmenwerks abgebildet.
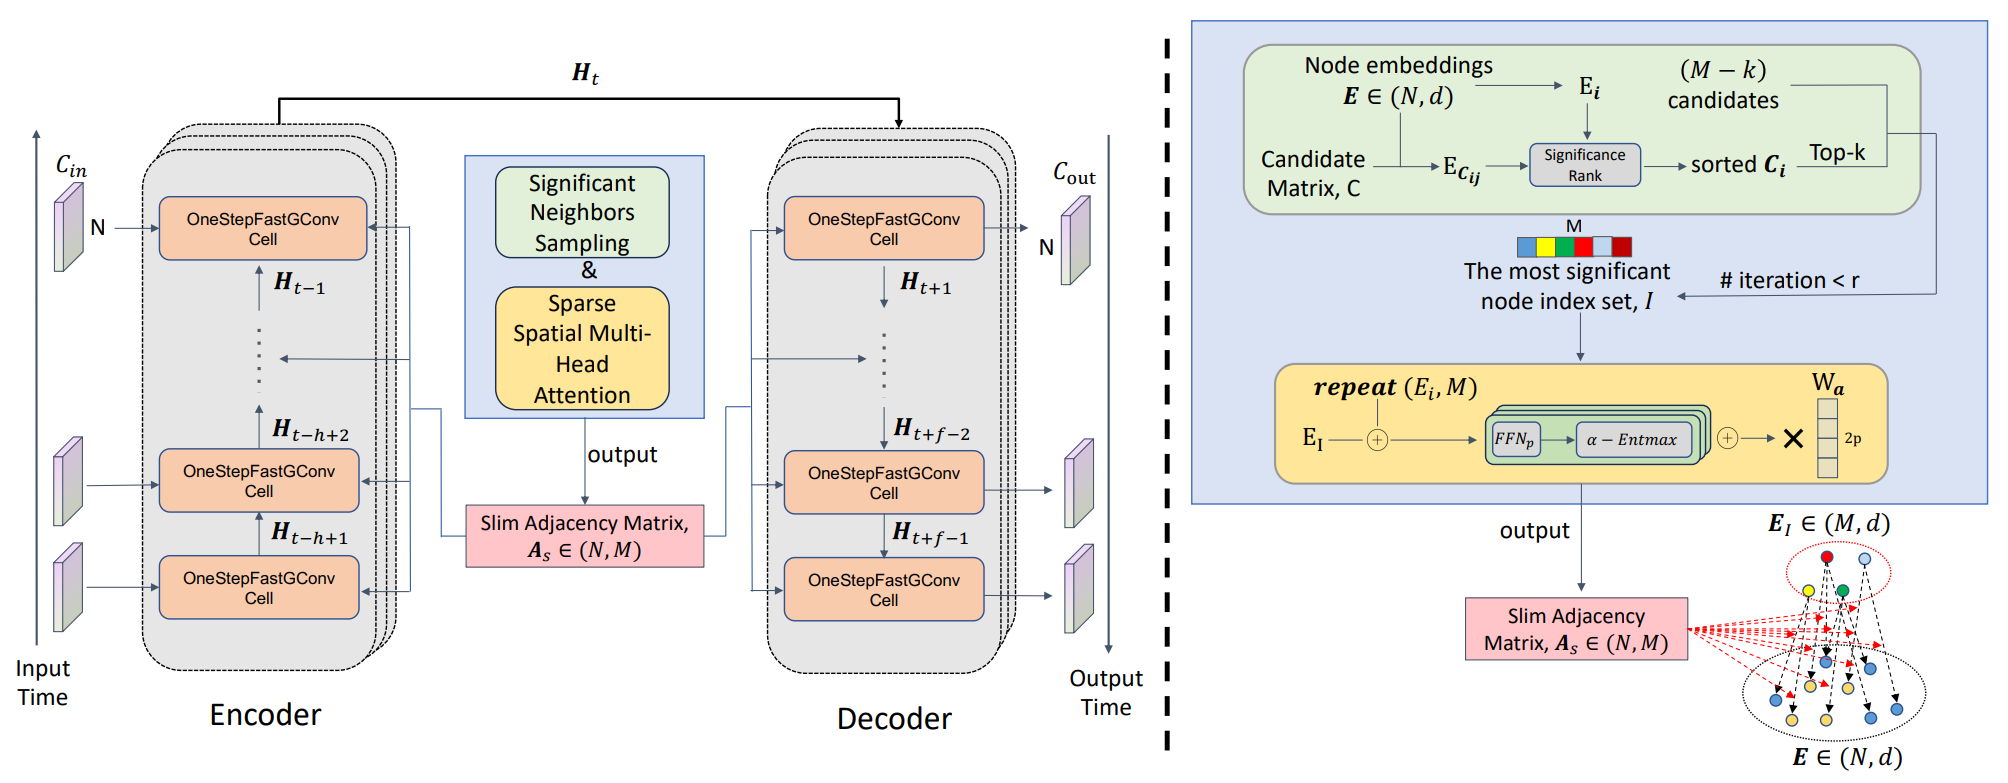
In früheren Artikeln haben wir die wichtigsten Bausteine des Rahmenwerks systematisch untersucht. Wir haben die Module „Significant Neighbors Sampling“ und „Sparse Spatial Multi-Head Attention“ Schritt für Schritt mithilfe von MQL5 und OpenCL implementiert. Dabei haben wir den ursprünglichen Algorithmus nicht einfach eins zu eins übernommen – im Gegenteil: Wir haben eine Reihe wichtiger Optimierungen vorgenommen, um die Recheneffizienz und Stabilität des Modells zu verbessern. Anstelle der iterativen α-Entmax-Funktion, die aufgrund der Suche nach dem optimalen Parameter τ erhebliche Ressourcen erfordert, haben wir daher das ressourcenschonendere und stabilere Sparse-SoftMax verwendet. Dadurch war es möglich, das Konzept der selektiven Herausfilterung unwesentlicher Elemente beizubehalten und die Belastung des Prozessors zu verringern. Zudem wurde das Verfahren zur Bildung von Kanten im Modul zur Nachbarstichprobenziehung verbessert. Wir haben eine parallele Auswertung von zuvor ausgewählten und zufällig ausgewählten Kandidaten durchgeführt, wodurch wir die Vielfalt der Kanten erhöhen und die Wahrscheinlichkeit verringern konnten, potenziell nützliche Informationen zu verlieren.
Nachdem nun die Mechanismen zum Aufbau des Graphen und zur Verteilung der Gewichte auf seine Knoten vorhanden sind, ist es an der Zeit, zum nächsten logischen Schritt überzugehen – der Implementierung des Moduls OneStepFastGConv. Diese Komponente spielt in der SAGDFN-Architektur eine besondere Rolle, da sie für die Aggregation räumlicher Informationen und die Generierung der Merkmale zuständig ist, auf denen die endgültige Vorhersage basiert.
Objekt für rekurrente Graphfaltung
Anknüpfend an die Überlegungen aus dem vorherigen Artikel, in dem wir bereits die Graphstruktur aufgebaut (Significant Neighbors Sampling) und gelernt haben, wie man Gewichte sorgfältig auf wichtige Kanten verteilt (Sparse Spatial Multi-Head Attention), wenden wir uns nun dem Kern des rekurrenten Blocks zu – der schnellen Graphfaltung. Dies ist nicht unser erster Ausflug in die Welt der rekurrenten Graphmodule: In HimNet haben wir GCRU verwendet, und es hat bei dichtbesetzten Strukturen sehr gut funktioniert. Bei SAGDFN sieht die Lage jedoch anders aus. Wir arbeiten bewusst mit einer dünnbesetzten Matrix von Abhängigkeiten, und genau diese Dünnbesetztheit erfordert einen anderen algorithmischen Ansatz. Um zu vermeiden, dass wir ein Haus auf Sand bauen, beginnen wir mit der grundlegenden Operation, auf der OneStepFastGConv aufbaut: der effizienten Multiplikation einer dünnbesetzten Matrix mit einer dichtbesetzten Matrix.
Diese Phase ist von entscheidender Bedeutung, da sie es uns erst ermöglicht, die zuvor ermittelte dünnbesetzte Beziehungsstruktur effizient in den Gesamtkontext der Datenverarbeitung zu integrieren. Zu diesem Zweck erstellen wir im OpenCL-Programm einen Kernel, der diese Operation so einfach wie möglich ausführt und dabei den Schwerpunkt auf Leistung und Speichereffizienz legt.
__kernel void SparseMatMult(__global const float *sparse_index,
                            __global const float *sparse_data,
                            __global const float *full,
                            __global float *result,
                            const int full_rows
                           )
  {
   const size_t sparse_row = get_global_id(0);
   const size_t sparse_col = get_local_id(1);
   const size_t full_col = get_global_id(2);
   const size_t sparse_rows = get_global_size(0);
   const size_t sparse_cols = get_local_size(1);
   const size_t full_cols = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
Gleich zu Beginn seiner Ausführung ermittelt der Kernel die Koordinaten der auszuführenden Aufgabe: die Zeilen- und Spaltenindizes der dünnbesetzten Matrix, wobei letztere in Work-Groups zusammengefasst sind. Außerdem bestimmt der Kernel den Spaltenindex der dichtbesetzten Matrix. Diese Parameter bilden eine Art Koordinatentripel, anhand dessen jedes Work-Item genau weiß, für welchen Datenabschnitt es zuständig ist. Anschließend werden die Größen aller Dimensionen ermittelt. Sie sind für die korrekte Adressierung von Elementen erforderlich.
Anschließend wird ein lokales Array Temp angelegt, das zur Synchronisation und zur Summierung von Zwischenwerten innerhalb der Work-Group dient.
Im nächsten Schritt ermittelt jedes Work-Item den Speicherversatz für das aktuelle Element der dünnbesetzten Matrix und ruft den Index der entsprechenden Zeile in der dichtbesetzten Matrix ab.
   const int shift_sparse = RCtoFlat(sparse_row, sparse_col, sparse_rows, sparse_cols, 0);
   const int full_row = sparse_index[shift_sparse];
   const int shift_full = RCtoFlat(full_row, full_col, full_rows, full_cols, 0);
Liegt dieser Index innerhalb des gültigen Bereichs, wird das Produkt aus dem Koeffizienten der dünnbesetzten Matrix und dem Element der dichtbesetzten Matrix berechnet. Andernfalls wird der Wert Null verwendet, wodurch fehlerhafte Operationen verhindert werden.
   float res = (full_row >= 0 && full_row < full_rows ?
                IsNaNOrInf(sparse_data[shift_sparse] * full[shift_full], 0) : 0);
   res = LocalSum(res, 1, Temp);
Das resultierende Teilprodukt wird an eine lokale Summationsprozedur übergeben, die die Ergebnisse aller Work-Items in der Work-Group aufsummiert. Sobald die Summierung abgeschlossen ist, schreibt das erste Work-Item jeder Gruppe (mit einem lokalen Spaltenindex von Null) den Endwert in die Ergebnismatrix. Dadurch wird ein Gleichgewicht zwischen Rechenparallelität und Kontrolle über das Schreiben von Daten hergestellt, wodurch Zugriffskonflikte verhindert werden.
   if(sparse_col == 0)
     {
      const int shift_result = RCtoFlat(sparse_row, full_col, sparse_rows, full_cols, 0);
      result[shift_result] = res;
     }
  }
Dieser Ansatz gewährleistet eine optimale Nutzung der GPU-Ressourcen. Jedes Work-Item führt nur seinen eigenen Teil der Arbeit aus, und die gemeinsame Summierung gewährleistet die Genauigkeit und Konsistenz des Endergebnisses.
Nachdem wir den Vorwärtsdurchlauf implementiert und gelernt haben, wie man die Beiträge der Nachbarn sorgfältig in die resultierenden Merkmale einbezieht, folgt als nächster Schritt der Rückwärtsdurchlauf: die korrekte Verteilung des Fehlergradienten auf alle beteiligten Elemente. Der Algorithmus ist im Kernel SparseMatMultGrad implementiert, der folgende Eingabedaten entgegennimmt:
- Indizes und Gewichte einer dünnbesetzten Matrix,
- ein Puffer für Gradienten in Bezug auf diese Gewichte,
- eine dichtbesetzte Matrix und ihr Gradientenpuffer,
- ein Array von Ergebnisgradienten,
- die Größen aller Dimensionen.
__kernel void SparseMatMultGrad(__global const float *sparse_index,
                                __global const float *sparse_data,
                                __global float *sparse_gr,
                                __global const float *full,
                                __global float *full_gr,
                                __global const float *result_gr,
                                const int sparse_rows,
                                const int sparse_cols,
                                const int full_rows,
                                const int full_cols
                               )
  {
   const size_t row_id = get_global_id(0);
   const size_t local_id = get_local_id(1);
   const size_t col_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t total_cols = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
Im Kernel-Rumpf erhält jedes Work-Item seine eigenen Koordinaten im Aufgabenraum:
- row_id — die Zeile, die gerade in der Matrix verarbeitet wird;
- local_id – die lokale Kennung innerhalb einer Gruppe;
- col_id – die Matrixspalte.
Der Puffer Temp im lokalen Speicher wird für Reduktionen und für die Übertragung kleiner Datenmengen zwischen Work-Items innerhalb derselben Work-Group bereitgestellt. Dies ist das wichtigste Koordinationswerkzeug: Es ermöglicht den Work-Items, Zwischenergebnisse auszutauschen und sich zu synchronisieren.
An dieser Stelle sei darauf hingewiesen, dass wir in diesem Kernel die Fehlergradienten auf zwei Matrizen unterschiedlicher Größe verteilen müssen. Sowohl die Zeilen- als auch die Spaltenkennungen beziehen sich jeweils auf die Matrix, bezüglich derer die Gradienten berechnet werden. Zu diesem Zweck planen wir, bei der Einreihung des Kernels in die Ausführungswarteschlange die Maximalwerte aus beiden Matrizen zu verwenden. Die überzähligen Work-Items werden innerhalb des Kernels herausgefiltert.
Zunächst folgt der Block zur Berechnung der Fehlergradienten in Bezug auf die Gewichte der dünnbesetzten Matrix. Zunächst prüfen wir die Indexgrenzen: Liegt die aktuelle Position innerhalb des gültigen Bereichs, berechnet das Work-Item shift_sparse – einen linearen Speicherversatz in den Index- und Datenarrays der dünnbesetzten Matrix.
//--- Calculate sparse gradient
   if(row_id < sparse_rows && col_id < sparse_cols)
     {
      float grad = 0;
      int shift_sparse = 0;
      if(local_id == 0)
        {
         shift_sparse = RCtoFlat(row_id, col_id, sparse_rows, sparse_cols, 0);
         Temp[0] = sparse_index[shift_sparse];
        }
      BarrierLoc;
      uint full_row = (uint)Temp[0];
Das Work-Item, dessen local_id den Wert 0 hat, liest den entsprechenden Index und speichert ihn im ersten Element des Puffers im lokalen Speicher, sodass die anderen Work-Items diesen Wert ohne zusätzliche Zugriffe auf den globalen Speicher nutzen können.
Nach der Barriere kennen alle Work-Items in der Work-Group den Zeilenindex der dichtbesetzten Matrix.
Bitte beachten Sie: Es ist wichtig, die Richtigkeit des ermittelten Zeilenindex zu überprüfen. Wenn der Zeilenindex gültig ist, durchläuft jedes Work-Item die ihm zugewiesenen Positionen in der Merkmalsdimension und akkumuliert den Beitrag des jeweiligen Elements.
      if(full_row < (uint)full_rows)
         for(int i = local_id; i < full_cols; i += total_local)
           {
            int shift_result = RCtoFlat(row_id, i, sparse_rows, full_cols, 0);
            int shift_full = RCtoFlat(full_row, i, full_rows, full_cols, 0);
            grad += IsNaNOrInf(result_gr[shift_result] * full[shift_full], 0);
           }
Dies ist eine klassische skalare Akkumulation über Merkmale: Wir nehmen den Gradienten des Ergebnisses bezüglich jedes Merkmals, multiplizieren ihn mit dem Wert der entsprechenden Zelle in der dichtbesetzten Matrix und summieren über alle Merkmale.
Nachdem der lokale Durchlauf abgeschlossen ist, wird eine Reduktion über alle Work-Items der Work-Group durchgeführt, um den Gesamtbeitrag für das jeweilige (row_id, col_id)-Paar zu ermitteln.
      grad = LocalSum(grad, 1, Temp);
      if(local_id == 0)
         sparse_gr[shift_sparse] = grad;
     }
Nur ein Work-Item schreibt das Endergebnis der Work-Group in das entsprechende Element des globalen Puffers sparse_gr.
Wenn wir nun zum zweiten wichtigen Teil übergehen (der Berechnung des Gradienten in Bezug auf die dichtbesetzte Matrix), stoßen wir auf das inverse Problem. Für jedes Element der dichtbesetzten Matrix müssen wir dessen Beitrag zur Ausgabe des Blocks sorgfältig aufsummieren. Hier stoßen wir jedoch auf das Problem, dass eine explizite Zuordnung zu den Elementen der dünnbesetzten Matrix fehlt. Daher müssen wir die gesamte Indexmatrix der dünnbesetzten Matrix nach den benötigten Zeigern durchsuchen. Genau diese Aufgabe werden wir den Work-Items in der lokalen Work-Group zuweisen.
Zunächst richten wir eine Schleife ein, um die Zeilen des Fehlergradienten-Tensors durchzugehen. Ich möchte Sie daran erinnern, dass die Anzahl der Zeilen im Fehlergradienten-Tensor und in der dünnbesetzten Matrix identisch ist.
//--- Calc full gradient
   if(row_id < full_rows && col_id < full_cols)
     {
      float grad = 0;
      for(int r = 0; r < sparse_rows; r ++)
        {
         float s = 0;
         for(int c = local_id; c < sparse_cols; c += total_local)
           {
            int shift_sparse = RCtoFlat(r, c, sparse_rows, sparse_cols, 0);
            if((int)sparse_index[shift_sparse] == (int)row_id)
              {
               s = sparse_data[shift_sparse];
               break;
              }
           }
Innerhalb der Schleife versuchen wir, unter den Indizes der dünnbesetzten Matrix einen Zeiger auf die aktuelle Zeile der dichtbesetzten Matrix zu finden. Um eine effiziente Parallelisierung zu gewährleisten, durchsucht jedes Work-Item in der lokalen Work-Group nur einen Teil der Spalten der dünnbesetzten Matrix; bei der ersten Übereinstimmung liest es den Aufmerksamkeitskoeffizienten aus und beendet die Suche.
Ich möchte Sie daran erinnern, dass wir bei der Auswahl der nächsten Nachbarn einen Mechanismus implementiert haben, um Duplikate auszuschließen. Daher gehen wir davon aus, dass Kanten in keiner Zeile der dünnbesetzten Matrix mehr als einmal vorkommen.
Anschließend verwenden wir LocalSum, um die Aufmerksamkeitskoeffizienten aller Work-Items in der Work-Group zu aggregieren.
         s = LocalSum(s, 1, Temp);
         if(s != 0 && local_id == 0)
           {
            int shift_result = RCtoFlat(r, col_id, sparse_rows, full_cols, 0);
            grad += IsNaNOrInf(s * result_gr[shift_result], 0);
           }
        }
Ist die Summe ungleich null, multipliziert das erste Work-Item der Work-Group das resultierende Gewicht mit dem Wert des entsprechenden Elements aus dem Fehlergradientenpuffer des Blocks und addiert das Ergebnis zum Wert der Variablen grad.
Nachdem alle Iterationen der verschachtelten Schleifen abgeschlossen sind und der gesamte Fehlergradient aus allen abhängigen Elementen akkumuliert wurde, schreibt das erste Work-Item der Work-Group den akkumulierten Wert in den globalen Puffer full_gr.
      if(local_id == 0)
        {
         int shift_full = RCtoFlat(row_id, col_id, full_rows, full_cols, 0);
         full_gr[shift_full] = grad;
        }
     }
  }
Nachdem die Vorbereitungsarbeiten nun abgeschlossen sind, wenden wir uns der praktischen Implementierung des rekurrenten Blocks OneStepFastGConv im Hauptprogramm zu. Hier implementieren wir die vorgeschlagenen Ansätze in der Klasse CNeuronFastGConv, die als kompakter Container für alle Zwischenpuffer und die Logik konzipiert ist. Die Klassenstruktur ist unten dargestellt.
class CNeuronFastGConv   :     public CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL          cInpAndHidden;
   CNeuronBaseOCL          cNormAttention;
   CNeuronBaseOCL          cInvDiag;
   CNeuronBaseOCL          cAX;
   CNeuronBaseOCL          cAXplusX;
   CNeuronBaseOCL          cNormAXplusX;
   CNeuronConvOCL          cZ_R;
   CNeuronBaseOCL          cZ;
   CNeuronBaseOCL          cR;
   CNeuronBaseOCL          cCandidate;
   CNeuronConvOCL          cHC;
   //---
   virtual bool      RandomWalk(CBufferFloat* data,
                                CBufferFloat* normal,
                                CBufferFloat* inv_diag,
                                const int rows,
                                const int cols
                               );
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)  override { return false; };
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override { return false; }
   //---
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronFastGConv(void) {};
                    ~CNeuronFastGConv(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      FeedForward(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent);
   virtual bool      CalcInputGradients(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent);
   //---
   virtual int       Type(void)   const   {  return defNeuronFastGConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   //---
   virtual uint      GetCount(void) const { return (uint)cInvDiag.Neurons(); }
   virtual uint      GetSparseDimension(void) const { return (uint)cNormAttention.Neurons() / GetCount(); }
   virtual uint      GetWindow(void) const { return (uint)Neurons() / GetCount(); }
  };
In der Struktur der neuen Klasse finden wir eine recht große Anzahl interner Objekte. Sie sind jedoch alle statisch deklariert, wodurch wir den Konstruktor und den Destruktor der Klasse leer lassen können. Der gesamte Algorithmus zur Konfiguration der Architektur des Objekts wurde in die Initialisierungsmethode Init verschoben.
bool CNeuronFastGConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint units, uint window, uint sparse_dimension,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
   activation = None;
Die erste Zeile innerhalb der Methode übergibt die Kontrolle an die übergeordnete Klasse. Dies umfasst die grundlegende Anbindung der Schicht an den OpenCL-Kontext sowie die Erstellung aller vererbten Schnittstellen, die erforderlich sind, damit das Modul innerhalb des Modells funktionieren kann. Wenn diese Initialisierung fehlschlägt, ist es nicht sinnvoll, die Methode weiter auszuführen; daher geben wir sofort false zurück. Dieser vorzeitige Abbruch schützt vor weiteren Fehlern und unnötigen Speicherallokationen.
Unmittelbar danach deaktivieren wir die Aktivierungsfunktion explizit. Das ist sinnvoll: Der Block selbst steuert die Aktivierungen in seinen Komponenten (Sigmoid-Funktionen für Gates, tanh für Kandidatenzustände), sodass hier keine externe globale Aktivierung erforderlich ist.
Als Nächstes folgt die Initialisierung der internen Komponenten. Das erste Objekt dient dazu, den vorherigen verborgenen Zustand und die Eingabedaten zu konkatenieren.
   int index = 0;
   if(!cInpAndHidden.Init(0, index, OpenCL, 2 * units * window, optimization, iBatch))
      return false;
In der nächsten Zeile wird cNormAttention erstellt. Hier wird die kompakte Aufmerksamkeitsmatrix As nach der Normalisierung gespeichert. Die Gewichte stammen aus dem Modul Sparse Attention.
   index++;
   if(!cNormAttention.Init(0, index, OpenCL, units * sparse_dimension, optimization, iBatch))
      return false;
   index++;
   if(!cInvDiag.Init(0, index, OpenCL, units, optimization, iBatch))
      return false;
Kommen wir nun zu cInvDiag – einem Vektor aus den Kehrwerten der Diagonalelemente, der bei der Normalisierung zur Multiplikation der Zeilen des Diffusionsergebnisses verwendet wird.
Als Nächstes wird cAX erstellt. Dieser Puffer speichert das Ergebnis von SpMM. Seine Größe basiert auf cInpAndHidden, wodurch die Dimensionskompatibilität mit den nachfolgenden Schritten gewährleistet wird.
   index++;
   if(!cAX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cAXplusX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cNormAXplusX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
Nach cAX folgt cAXplusX – ein Puffer für die Summe AX + X. An dieser Stelle speichern wir das Zwischenergebnis explizit, bevor wir die Diagonalinversion anwenden. Ein solcher expliziter Puffer erleichtert die Fehlersuche und ermöglicht die Steuerung der Reihenfolge der Operationen.
Als Nächstes wird cNormAXplusX erstellt – der endgültige normalisierte Tensor (D+I)-1(AX + X). Anschließend wird er in einen GRU-ähnlichen Block eingespeist. Fehlt er, funktioniert die Update-Gate-Mechanik nicht mehr; daher ist auch diese Überprüfung von entscheidender Bedeutung.
Als Nächstes wird cZ_R initialisiert. Dies ist eine kompakte Faltungsschicht, die gleichzeitig Logits für die Z- und R-Gates erzeugt. Hier verwenden wir die Sigmoid-Funktion als Aktivierungsfunktion. Dieser Ansatz ist einfach und zuverlässig: Die Werte der Gates liegen stets im Bereich [0,1].
   index++;
   if(!cZ_R.Init(0, index, OpenCL, 2 * window, 2 * window, 2 * window, units, 1, optimization, iBatch))
      return false;
   cZ_R.SetActivationFunction(SIGMOID);
   index++;
   if(!cZ.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
   index++;
   if(!cR.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
Die nächsten beiden Puffer, cZ und cR, werden angelegt, um die Gate-Werte voneinander zu trennen. Die Verwendung separater Puffer vereinfacht die schrittweise Logik zur Aktualisierung des verborgenen Zustands.
Durch die Initialisierung von cCandidate wird ein Puffer für die konkatenierte Zwischeneingabe des Kandidatenblocks erstellt.
   index++;
   if(!cCandidate.Init(0, index, OpenCL, 2 * window * units, optimization, iBatch))
      return false;
   index++;
   if(!cHC.Init(0, index, OpenCL, 2 * window, 2 * window, window, units, 1, optimization, iBatch))
      return false;
   cHC.SetActivationFunction(TANH);
//---
   return true;
  }
Im cHC-Block erfolgt die eigentliche Berechnung des Kandidatenzustands. Die Verwendung von TANH als Aktivierungsfunktion ist gängige Praxis, die dafür sorgt, dass die Kandidatenwerte begrenzt und in ihrer Größenordnung stabil bleiben.
Sobald alle Aufrufe innerhalb der Init-Methode erfolgreich abgeschlossen sind, geben wir ganz am Ende true zurück, um anzuzeigen, dass die Schicht konfiguriert und betriebsbereit ist.
Lassen Sie uns nahtlos von der Initialisierung zur Ausführung übergehen. Nachdem nun alle Ressourcen zugewiesen und konfiguriert sind, stellt die FeedForward-Methode einen aktiven Datenfluss durch OneStepFastGConv dar.
bool CNeuronFastGConv::FeedForward(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent)
  {
   if(!SourceData || !SparseAttent)
      return false;
//---
   const uint units = GetCount();
   const uint window = GetWindow();
   const uint sparse = GetSparseDimension();
Zunächst überprüft die Methode die Eingaben, um sicherzustellen, dass die Zeiger auf die Quelldatenobjekte gültig sind. Dies ist eine einfache, aber unverzichtbare Sicherheitsmaßnahme: Wenn die Datenquelle oder das Modul für dünnbesetzte Aufmerksamkeit fehlt, kann die Ausführung nicht fortgesetzt werden. Dieser vorzeitige Abbruch verhindert unkontrollierte Ausfälle und ermöglicht eine vorhersehbare Fehlerdiagnose.
Als Nächstes rufen wir die Konfigurationsparameter der Schicht ab. Es ist sehr praktisch, diese Variablen lokal zu halten: Das Auslesen über Klassenmethoden in einer häufig durchlaufenen Schleife ist langsamer und weniger übersichtlich.
Die folgende Zeile startet RandomWalk. Dies ist ein Vorverarbeitungsschritt für die Aufmerksamkeitsmatrix. RandomWalk ermittelt statistische Werte über die Zeilen der kompakten Matrix und führt eine glättende Normalisierung durch. Anschließend schreibt RandomWalk die normalisierte Matrix in cNormAttention (N×M) und die inversen Diagonalwerte in cInvDiag (N). Es ist wichtig zu beachten, dass RandomWalk parallel auf der GPU läuft, dabei sorgfältig über M summiert und stabile inv_diag-Werte zurückgibt. Sollte dieser Schritt fehlschlagen, ist es besser, die Ausführung abzubrechen: Alle nachfolgenden Normalisierungen hängen davon ab.
   if(!RandomWalk(SparseAttent.getOutput(), cNormAttention.getOutput(), cInvDiag.getOutput(), window, sparse))
      return false;
   if(!SwapOutputs())
      return false;
   if(!Concat(SourceData.getOutput(), PrevOutput, cInpAndHidden.getOutput(), window, window, units))
      return false;
Danach wird SwapOutputs ausgeführt. Dies ist ein interner Mechanismus der Schicht, der die Zeiger auf die vorherige und die aktuelle Ausgabe vertauscht (Rolling-Buffer). Durch den Austausch wird sichergestellt, dass PrevOutput den Wert Ht-1 enthält, während der aktuelle Output zum Schreiben frei ist.
Als Nächstes wird die Eingabe für SpMM/GRU zusammengestellt. Hier erfolgt die Konkatenation entlang der Kanaldimension: Für jede Zeile wird ein Vektor gebildet, der das aktuell beobachtete Fragment Xt und den vorherigen verborgenen Zustand Ht-1 kombiniert.
Sobald die Vorbereitungsarbeiten abgeschlossen sind, wird die zentrale Operation ausgeführt: die Multiplikation der dünnbesetzten Aufmerksamkeitsmatrix mit der zuvor vorbereiteten dichtbesetzten Matrix aus den konkatenierten Eingabedaten und dem verborgenen Zustand.
   if(!SparseMatMul(SparseAttent.GetIndexes(), cNormAttention.getOutput(), cInpAndHidden.getOutput(),
                                                  cAX.getOutput(), units, sparse, units, 2 * window))
      return false;
   if(!SumAndNormilize(cAX.getOutput(), cInpAndHidden.getOutput(), cAXplusX.getOutput(),
                                                         2 * window, false, 0, 0, 0, 1))
      return false;
Als Nächstes wird die Summe unter Einbeziehung der Selbstschleife berechnet. Hier addieren wir AX+X.
Der nächste Schritt besteht darin, eine Diagonalnormalisierung durchzuführen.
   if(!DiagMatMul(cInvDiag.getOutput(), cAXplusX.getOutput(), cNormAXplusX.getOutput(), units, 2 * window, 1, None))
      return false;
Dies ist eine einfache kanalweise Multiplikation der Zeilen mit dem vorab berechneten inv_diag.
Anschließend werden die Logits für die Gates berechnet. Die Faltungsschicht cZ_R nimmt normalisierte, aggregierte Merkmale entgegen und gibt einen 2×hidden-Vektor zurück (Logits für Z und R). Da die SIGMOID-Aktivierungsfunktion während der Initialisierungsphase festgelegt wurde, liefert diese Operation Werte im Bereich [0,1].
   if(!cZ_R.FeedForward(cNormAXplusX.AsObject()))
      return false;
   if(!DeConcat(cZ.getOutput(), cR.getOutput(), cZ_R.getOutput(), window, window, units))
      return false;
Anschließend teilen wir die resultierenden Logits auf separate Puffer auf.
Darauf folgt unmittelbar die elementweise Multiplikation des Reset-Gates mit dem vorherigen verborgenen Zustand. Daraus ergibt sich R⊙Ht-1. Das Ergebnis wird dann als modifizierte Version des verborgenen Zustands verwendet, um Kandidaten zu generieren.
   if(!ElementMult(cR.getOutput(), PrevOutput, cR.getPrevOutput()))
      return false;
Als Nächstes wird die Kandidateneingabe gebildet: Wir verketten R⊙Ht-1 mit dem aktuellen Xt.
   if(!Concat(SourceData.getOutput(), cR.getPrevOutput(), cCandidate.getOutput(), window, window, units))
      return false;
   if(!cHC.FeedForward(cCandidate.AsObject()))
      return false;
   if(!GateElementMult(PrevOutput, cHC.getOutput(), cZ.getOutput(), Output))
      return false;
//---
   return true;
  }
Der Aufruf der Methode für den Vorwärtsdurchlauf der Faltungsschicht cHC führt eine nichtlineare Transformation durch, wendet tanh an und gibt einen Kandidatenzustand zurück. Die endgültige Zusammensetzung bildet dann den neuen verborgenen Zustand.
Nach der Beschreibung des Vorwärtsdurchlaufs wenden wir uns nun der Rückwärtskette zu – dabei müssen wir genau untersuchen, wie sich der Fehler rückwärts durch alle Glieder von OneStepFastGConv ausbreitet. Der Prozess wird in der Methode CalcInputGradients implementiert.
bool CNeuronFastGConv::CalcInputGradients(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent)
  {
   if(!SourceData || !SparseAttent)
      return false;
//---
   const uint units = GetCount();
   const uint window = GetWindow();
   const uint sparse = GetSparseDimension();
beenden wir die Operation mit dem Rückgabewert false. Anschließend beenden wir die Operation ordnungsgemäß mit dem Rückgabewert false. Dies ist eine einfache, aber notwendige Überprüfung – es ist besser, den Trainingsdurchlauf frühzeitig abzubrechen, als später mit rätselhaften NaN-Werten konfrontiert zu werden.
Anschließend werden die Konfigurationsparameter abgerufen. Diese Zahlen bestimmen die Form aller Gradiententensoren und sind für eine korrekte Adressierung erforderlich.
Der erste eigentliche Aufruf ist GateElementMultGrad. Dies ist die Umkehrung der endgültigen Zusammensetzung Ht = Z⊙Ht-1+(1−Z)⊙H̃.
   if(!GateElementMultGrad(PrevOutput, cInpAndHidden.getGradient(),
                           cHC.getOutput(), cHC.getGradient(),
                           cZ.getOutput(), cZ.getGradient(),
                           Gradient, None, cHC.Activation(), cZ_R.Activation()))
      return false;
Die Funktion berechnet drei Größen gleichzeitig: den Gradienten in Bezug auf H̃ (Kandidaten), in Bezug auf Z (Update-Gate) und in Bezug auf Ht-1 (den vorherigen verborgenen Zustand), wobei der Gesamtgradient sorgfältig in seine Komponenten zerlegt wird.
Als Nächstes leiten wir den Fehlergradienten durch die Faltungsschicht zur Erzeugung von Kandidaten weiter.
   if(!cCandidate.CalcHiddenGradients(cHC.AsObject()))
      return false;
   if(!DeConcat(SourceData.getGradient(), cR.getPrevOutput(),
                cCandidate.getGradient(), window, window, units))
      return false;
Als Nächstes teilen wir die resultierenden Gradienten in zwei Teile auf – den Einfluss der Eingabedaten und den von R⊙Ht-1.
Anschließend verteilt ElementMultGrad die Beiträge des Reset-Gates und des vorherigen verborgenen Zustands.
   if(!ElementMultGrad(cR.getOutput(), cR.getGradient(),
                       PrevOutput, cInpAndHidden.getGradient(),
                       cR.getPrevOutput(), cZ_R.Activation(), None))
      return false;
Im nächsten Schritt werden die lokalen Gradienten in Bezug auf Z und R wieder zu einem flachen Vektor aus Logits zusammengefasst, den wir zur Fehlerrückpropagation der Schicht in cZ_R einspeisen.
   if(!Concat(cZ.getGradient(), cR.getGradient(),
              cZ_R.getGradient(), window, window, units))
      return false;
   if(!cNormAXplusX.CalcHiddenGradients(cZ_R.AsObject()))
      return false;
   if(!DiagMatMulGrad(cInvDiag.getOutput(), cInvDiag.getGradient(),
                      cAXplusX.getOutput(), cAX.getGradient(),
                      cNormAXplusX.getGradient(), units, 2 * window, 1))
      return false;
   if(!SparseMatMulGrad(SparseAttent.GetIndexes(), cNormAttention.getOutput(),
                        cNormAttention.getGradient(), cInpAndHidden.getOutput(),
                        cInpAndHidden.getGradient(), cAX.getGradient(),
                        units, sparse, units, 2 * window))
      return false;
Als Nächstes führen wir den Rückwärtsdurchlauf durch die Faltungsschicht durch, die die Gate-Logits erzeugt. Dadurch erhalten wir den Gradienten in Bezug auf cNormAXplusX – also in Bezug auf die normalisierte aggregierte Eingabe.
Darauf folgt eine Reihe von Iterationen, in denen die Fehlergradienten zwischen dem konkatenierten Eingabedatentensor und den normalisierten Aufmerksamkeitskoeffizienten verteilt werden. Zunächst propagieren wir den Gradienten durch die diagonale Normalisierung zurück. Anschließend führen wir den Rückwärtsdurchlauf durch die SpMM-Operation aus und verteilen die Gradienten auf die normalisierten Aufmerksamkeitsgewichte und die konkatenierten Merkmale.
Es ist wichtig zu beachten, dass wir nach der Ausführung von SparseMatMulGrad die Beiträge zum Fehlergradienten des konkatenierten Merkmalstensors aus den beiden Datenpfaden summieren müssen.
   if(!SumAndNormilize(cAX.getGradient(), cInpAndHidden.getGradient(),
                      cInpAndHidden.getGradient(), 2 * window, false, 0, 0, 0, 1))
      return false;
Als Nächstes müssen wir die Fehlergradienten auf der Ebene der Eingabedaten erfassen. Hier müssen wir bedenken, dass wir die Eingabedaten in zwei Datenpfaden verwendet haben: bei der primären Merkmalskonkatenation und bei der Tensorkonkatenation für die Kandidaten. Wir haben den Fehlergradienten aus dem zweiten Datenpfad bereits zurückpropagiert. Nun müssen wir die Werte aus dem zweiten Datenpfad extrahieren und sie zu den zuvor ermittelten Werten hinzufügen.
   if(!DeConcat(cAXplusX.getGradient(), cAXplusX.getPrevOutput(),
                cInpAndHidden.getGradient(), window, window, units))
      return false;
   if(!SumAndNormilize(SourceData.getGradient(), cAXplusX.getGradient(),
                      SourceData.getGradient(), window, false, 0, 0, 0, 1))
      return false;
   if(SourceData.Activation() != None)
      if(!DeActivation(SourceData.getOutput(), SourceData.getGradient(),
                       SourceData.getGradient(), SourceData.Activation()))
         return false;
Außerdem muss geprüft werden, ob auf den Eingabedatentensor eine Aktivierungsfunktion angewendet wurde. Falls erforderlich, korrigieren wir die ermittelten Werte anhand der Ableitung der Aktivierungsfunktion.
Der letzte wichtige Schritt besteht darin, den Fehlergradienten von der normalisierten Aufmerksamkeitsmatrix cNormAttention auf deren ursprüngliche Form SparseAttent zurückzuführen. Im Vorwärtsdurchlauf haben wir eine Normalisierung durchgeführt, und nun leiten wir die Gradienten durch diesen diagonalen Schritt zurück in die Form, die das Modul SparseAttent erwartet.
   if(!DiagMatMul(cInvDiag.getOutput(), cNormAttention.getGradient(),
                  SparseAttent.getGradient(), units, sparse, 1, None))
      return false;
//---
   return true;
  }
Am Ende gibt die Methode true zurück, was bedeutet, dass alle Gradienten korrekt zurückpropagiert und für die entsprechenden Eingaben und internen Parameter korrekt akkumuliert wurden.
Damit ist unsere Erörterung der Algorithmen abgeschlossen, die zur Implementierung der Methoden der Klasse CNeuronFastGConv verwendet werden. Der vollständige Code für dieses Objekt und alle seine Methoden sind im Anhang enthalten.
SAGDFN-Objekt der obersten Ebene
Nachdem wir das Objekt eines einzelnen rekurrenten Blocks erstellt haben, wenden wir uns der obersten Ebene zu – dem Wrapper, der den Encoder und den Decoder zu einem einheitlichen System verbindet. Die Klasse CNeuronSAGDFN ist mehr als nur ein Container: Sie organisiert den Datenfluss, verwaltet die gemeinsame Nutzung derselben kompakten Adjazenzmatrix und gewährleistet die Konsistenz der zeitlichen und räumlichen Transformationen im gesamten Modell.
class CNeuronSAGDFN  :  public CNeuronTransposeOCL
  {
protected:
   CNeuronTransposeOCL     cTranspose;
   CLayer                  cEmbedding;
   CNeuronSNSMHAttention   cAttention;
   CLayer                  cGCRU;
   CLayer                  cProjection;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSAGDFN(void) {};
                    ~CNeuronSAGDFN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint time_steps, uint variables, uint embedding_dim,
                          uint emb_layers, uint sparse_dimension, uint heads,
                          float sparse, uint gcru_layers,
                          uint forecast, uint forec_layers,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSAGDFN;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Bei der Organisation der Funktionsweise der Klasse CNeuronSAGDFN ist zu beachten, dass das SAGDFN-Framework darauf basiert, wichtige räumliche Abhängigkeiten durch die Analyse von Korrelationen zwischen univariaten Sequenzen in einer multimodalen Zeitreihe zu identifizieren. Wir hingegen arbeiten in der Regel mit Zeitreihen. Daher haben wir innerhalb des Objekts die Transponierung des Quelldatentensors und die inverse Transponierung des Ergebnistensors implementiert.
Um die erste Operation auszuführen, deklarieren wir das entsprechende interne Objekt, während die zweite Operation über die übergeordnete Klasse CNeuronTransposeOCL ausgeführt werden soll. Diese Lösung vereinfacht die Aufbereitung der Daten vor der Eingabe in das Modul und erleichtert die Integration des Modells in die bestehende Pipeline.
Darüber hinaus haben wir die Möglichkeit geschaffen, die Architektur des Objekts dynamisch zu ändern. Zu diesem Zweck wurden drei dynamische Arrays eingebunden:
- cEmbedding – ein Mini-Modell zur Erzeugung von Einbettungen einer bestimmten Größe aus den Eingabedaten;
- cGCRU – ein Stapel aufeinanderfolgender GCRU-Einheiten (Graph-Convolutional Recurrent Unit), der eine Folge von OneStepFastGConv-Blöcken aggregiert;
- cProjection – ein Projektionsblock, der verborgene Repräsentationen im Decoder in Zielvorhersagen umwandelt.
Dieser Ansatz ermöglicht es, die Tiefe des rekurrenten Stapels flexibel zu erhöhen und mit der Anzahl der Diffusionsschritte zu experimentieren. CNeuronSAGDFN kombiniert die Transponierung der Eingabedaten, Einbettung, gemeinsam genutzte Attention und einen GCRU-Stapel zu einem einzigen Encoder-Decoder. Sie steuert, wie dieselbe kompakte Adjazenzmatrix im gesamten Stapel wiederverwendet wird, gewährleistet die Kompatibilität der Datenformate und fungiert während des Trainings als zentraler Koordinator.
Die eigentliche Erstellung der Architektur des neuen Objekts erfolgt in der Methode „Init“.
bool CNeuronSAGDFN::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                         uint time_steps, uint variables, uint embedding_dim,
                         uint emb_layers, uint sparse_dimension, uint heads,
                         float sparse, uint gcru_layers,
                         uint forecast, uint forec_layers,
                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(emb_layers <= 0 || gcru_layers <= 0 || forec_layers <= 0)
      return false;
Im Hauptteil der Methode wird zunächst eine einfache Überprüfung der empfangenen Parameter durchgeführt – sollte die Anzahl der Schichten in einem der Blöcke null sein, wird die Initialisierung sofort abgebrochen. Das ist eine sinnvolle und nützliche Überprüfung: Es ist besser, die Eingabedaten zurückzuweisen, als eine fehlerhafte Struktur weiter aufzubauen.
Anschließend wird die Kontrolle an die gleichnamige Methode in der übergeordneten Klasse übergeben, die die allgemeine Struktur des Neurons definiert und die grundlegenden Ressourcen reserviert. Sollte dieser Schritt fehlschlagen, beenden wir die Methode ebenfalls ordnungsgemäß mit dem Rückgabewert false, da alles, was danach folgt, von einem korrekten Basiskontext abhängt.
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, variables, forecast, optimization_type, batch))
      return false;
Als Nächstes initialisieren wir ein Objekt, um den Quelldatentensor in das erwartete Format zu transponieren.
   uint index = 0;
   if(!cTranspose.Init(0, index, OpenCL, time_steps, variables, optimization, iBatch))
      return false;
Als Nächstes beginnen wir mit dem Aufbau des Einbettungs-Minimodells. Wir leeren den Container und binden den OpenCL-Kontext ein. Der erste Faltungsblock passt die Dimensionalität der Daten an den vorgegebenen Wert an. Wir fügen ihn dem cEmbedding-Container hinzu und weisen ihm SoftPlus als Aktivierungsfunktion zu.
//--- Embedding
   cEmbedding.Clear();
   cEmbedding.SetOpenCL(OpenCL);
   index++;
   CNeuronConvOCL *conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps, time_steps, embedding_dim, variables, 1, optimization, iBatch) ||
      !cEmbedding.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   for(uint i = 1; i < emb_layers; i++)
     {
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, embedding_dim, embedding_dim,
                    embedding_dim, variables, 1, optimization, iBatch) ||
         !cEmbedding.Add(conv))
        {
         DeleteObj(conv);
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
     }
Als Nächstes fügen wir in der Schleife über emb_layers weitere Faltungsschichten mit der SoftPlus-Aktivierungsfunktion hinzu. Dies führt zu einem tiefen Einbettungsstapel mit derselben Kanalbreite.
Nach den Faltungen fügen wir BatchNorm hinzu – ein separates Objekt, das die Ausgabe der letzten Faltungsschicht normalisiert.
   CNeuronBatchNormOCL *norm = new CNeuronBatchNormOCL();
   index++;
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cEmbedding.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   norm.SetActivationFunction(None);
Als Nächstes bereiten wir die GCRU-Blöcke vor. Wir leeren den cGCRU-Container, binden OpenCL ein und initialisieren unmittelbar danach cAttention.
//--- GCRUs
   cGCRU.Clear();
   cGCRU.SetOpenCL(OpenCL);
   index++;
   if(!cAttention.Init(0, index, OpenCL, variables, embedding_dim, heads,
                       sparse_dimension, sparse, optimization, iBatch))
      return false;
Beachten Sie, dass cAttention initialisiert wird, bevor die gcru-Objekte erstellt werden – dies ist beabsichtigt und korrekt, da alle GCRU-Blöcke dieselbe kompakte Adjazenzmatrix lesen. Sollte die Initialisierung von attention fehlschlagen, brechen wir den Vorgang ab und melden den Fehler.
Anschließend erstellen wir in einer Schleife die erforderliche Anzahl an CNeuronFastGConv-Objekten. Sollte die Erstellung eines gcru-Objekts fehlschlagen, löschen wir es und geben false zurück. Dadurch entsteht ein Stapel aus rekurrenten Graphblöcken, die alle gemeinsam mit der von cAttention erzeugten Matrix arbeiten.
   CNeuronFastGConv *gcru = NULL;
   for(uint i = 0; i < gcru_layers; i++)
     {
      index++;
      gcru = new CNeuronFastGConv();
      if(!gcru ||
         !gcru.Init(0, index, OpenCL, variables, embedding_dim, sparse_dimension, optimization, iBatch) ||
         !cGCRU.Add(gcru))
        {
         DeleteObj(gcru);
         return false;
        }
     }
Anschließend wird der Projektionsblock cProjection erstellt. Die erste Faltungsschicht wandelt die Daten für jede Variable von der Einbettungsdimension in den Prognoseraum um.
//--- Forecast
   cProjection.Clear();
   cProjection.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, embedding_dim, embedding_dim,
                 forecast, variables, 1, optimization, iBatch) ||
      !cProjection.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   for(uint i = 1; i < forec_layers; i++)
     {
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, forecast, forecast,
                    forecast, variables, 1, optimization, iBatch) ||
         !cProjection.Add(conv))
        {
         DeleteObj(conv);
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
     }
   norm = new CNeuronBatchNormOCL();
   index++;
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cProjection.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   norm.SetActivationFunction(None);
//---
   return true;
  }
Als Nächstes fügen wir in einer Schleife weitere Faltungsschichten hinzu. Am Ende des Minimodells fügen wir eine BatchNorm-Schicht ohne externe Aktivierung hinzu, genau wie im Einbettungsstapel. Wenn alle Elemente erfolgreich hinzugefügt wurden, gibt Init den Wert true, zurück und die Architektur ist fertig aufgebaut.
Gehen wir nun nahtlos von der Struktur der Schichten zu ihrer Ausführung über und betrachten wir die Methode feedForward Schritt für Schritt, um zu sehen, was genau zur Laufzeit geschieht – welche Puffer verschoben werden, welche Prüfungen Abstürze verhindern und wo die subtilen Fallstricke liegen.
bool CNeuronSAGDFN::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cTranspose.FeedForward(NeuronOCL))
      return false;
Zu Beginn der Methode werden die Eingabedaten transponiert. An dieser Stelle wechseln wir von einer multimodalen Zeitreihendarstellung zu einer Menge univariater Sequenzen. Wenn der Vorgang fehlschlägt, ist es sinnlos, die Pipeline weiter abzuarbeiten – wir beenden den Vorgang ordnungsgemäß.
Anschließend definieren wir lokale Zeigervariablen für die internen Objekte. Eine einfache, aber wichtige Operation, die es uns ermöglicht, denselben Code-Block für verschiedene Objekte wiederzuverwenden.
   CNeuronBaseOCL *inputs = cTranspose.AsObject();
   CNeuronBaseOCL *current = NULL;
Zunächst wird die Einbettung durchgeführt. Wir durchlaufen alle Komponenten des cEmbedding-Containers in einer Schleife. Bei jeder Iteration speichern wir die nächste Schicht in der Variablen current und rufen unmittelbar darauf auf sichere Weise ihre Methode für den Vorwärtsdurchlauf auf. Das bedeutet, dass jede Einbettungsschicht die Eingabedaten nacheinander transformiert und das Ergebnis an die nächste Schicht weiterleitet.
//--- Embedding
   for(int i = 0; i < cEmbedding.Total(); i++)
     {
      current = cEmbedding[i];
      if(!current ||
         !current.FeedForward(inputs))
         return false;
      inputs = current;
     }
Nach erfolgreicher Ausführung ändern wir den Zeiger in der Variablen inputs – das heißt, das soeben erhaltene Ergebnis übernimmt nun die Rolle der Eingabedaten. Dann fahren wir mit der nächsten Iteration der Schleife fort.
Nach Abschluss aller Iterationen der Schleife zeigt der Zeiger in der Variablen inputs somit auf die letzte Einbettungsschicht – die resultierende dichte Darstellung des analysierten Zeitfensters.
Der nächste Schritt ist der GCRU-Stapel. Zunächst bilden wir die kompakte Matrix As (Indizes und Gewichte) auf der Grundlage der aktuellen Darstellungen. Wenn der Aufmerksamkeitsmechanismus nicht funktioniert hat, ist es besser, abzubrechen, statt die Verarbeitung fortzusetzen.
//--- GCRUs
   if(!cAttention.FeedForward(inputs))
      return false;
   CNeuronFastGConv *gcru = NULL;
   for(int i = 0; i < cGCRU.Total(); i++)
     {
      gcru = cGCRU[i];
      if(!gcru ||
         !gcru.FeedForward(inputs, cAttention.AsObject()))
         return false;
      inputs = gcru;
     }
Anschließend durchlaufen wir den cGCRU-Container in einer Schleife und rufen für jedes Element nacheinander dessen Methode für den Vorwärtsdurchlauf auf.
Bitte beachten Sie: In diesem Fall werden zwei Argumente übergeben – der aktuelle Tensor und ein Verweis auf das attention-Objekt, aus dem GCRU die Indizes und Gewichte As abruft. Nach jedem erfolgreichen Schritt aktualisieren wir den Zeiger in der lokalen Quelldatenvariablen und fahren mit der nächsten Iteration fort.
Somit arbeitet der GCRU-Stapel sequenziell: Jeder Block liest dieselbe kompakte Matrix, wendet sie jedoch auf seinen eigenen Zustand an und gibt eine aktualisierte verborgene Darstellung zurück.
Sobald der Stapel aus rekurrenten Blöcken seine Verarbeitung abgeschlossen hat, fahren wir mit dem Projektionsblock für die Prognose fort. Die Schleife über den cProjection-Container folgt derselben Logik: Wir nehmen die nächste Projektionsschicht, rufen die Methode für den Vorwärtsdurchlauf auf und aktualisieren anschließend den Zeiger auf das Quelldatenobjekt.
//--- Forecast
   for(int i = 0; i < cProjection.Total(); i++)
     {
      current = cProjection[i];
      if(!current ||
         !current.FeedForward(inputs))
         return false;
      inputs = current;
     }
//--- result
   return CNeuronTransposeOCL::feedforward(inputs);
  }
Konzeptionell handelt es sich hierbei um die Umwandlung der verborgenen Darstellung in die endgültige Prognoseform für jede Variable.
Abschließend wandeln wir die Daten mithilfe der Methoden der übergeordneten Klasse wieder in ihr ursprüngliches Format um. Hierbei handelt es sich um eine umgekehrte Transposition: Die Prognosen werden nun wieder in das Format umgewandelt, das vom restlichen System erwartet wird. Wenn der letzte Schritt erfolgreich ist, liefert die Methode den Wert true, und die gesamte Verarbeitungskette des Vorwärtsdurchlaufs wird korrekt abgeschlossen.
Die Methode feedForward ist linear und transparent implementiert: Die Daten werden transponiert, durchlaufen anschließend den Einbettungsstapel, erhalten eine gemeinsam genutzte kompakte Aufmerksamkeitsmatrix, werden sequenziell von GCRU-Blöcken verarbeitet, in die Prognose projiziert und in ihr ursprüngliches Format zurückgeführt. Dieser Datenpfad lässt sich leicht debuggen und erweitern – man muss lediglich bei Zeigern vorsichtig sein und darauf achten, dass die Zwischentransformationen effizient bleiben.
Die Methoden für den Rückwärtsdurchlauf sind ähnlich aufgebaut. Daher schlage ich vor, auf eine eingehende Betrachtung dieser Methoden zu verzichten. Der vollständige Code der Klasse CNeuronSAGDFN und all ihrer Methoden ist im Anhang enthalten und steht zum Selbststudium zur Verfügung.
Tests
Das Training des Modells gleicht einer gut geplanten Expedition: Bevor wir uns auf die offene See des realen Marktes begaben, übten wir gründlich im ruhigen Hafen der historischen Daten. Diese erste Offline-Phase basierte auf Daten für das Währungspaar EURUSD im H1-Zeitrahmen über das gesamte Jahr 2024 hinweg – ein Zeitraum, der von starken Kontrasten geprägt war. Hier fanden wir alles vor: vom ruhigen, fast spiegelglatten Wasser der Seitwärtsphasen bis hin zu den heftigen Stürmen ausgeprägter Trendbewegungen und unerwarteten Schüben nachrichtenbedingter Volatilität. Dank dieser großen Vielfalt an Marktszenarien konnte das Modell eine robuste Navigation entwickeln und lernen, sowohl häufige als auch seltene Kursbewegungsmuster zu erkennen, ohne selbst unter schwierigen Bedingungen die Orientierung zu verlieren.
Nachdem diese Vorbereitungen abgeschlossen waren, war es an der Zeit, das Trainingsdock zu verlassen und in den Strömungen des realen Marktes das Schiff auf die Probe zu stellen. Die zweite Phase – die Online-Feinabstimmung – wurde unter realitätsnahen Einsatzbedingungen im Strategietester von MetaTrader 5 durchgeführt. Hier trafen die Daten nacheinander ein, eine Kerze nach der anderen, und das Modell lernte nicht nur, Streaming-Daten zu analysieren, sondern auch, inmitten von Rauschwirbeln, auf den wandernden Untiefen geringer Liquidität und bei unerwarteten Nachrichtenstürmen stabil zu bleiben. Diese Phase diente der präzisen Feinabstimmung: Sie ließ das bereits etablierte Grundgerüst intakt, half jedoch, es besser an die Realität anzupassen, wodurch die Anpassungsfähigkeit erhöht und das Risiko einer Überanpassung verringert wurde.
Der abschließende Test erwies sich als echte Feuerprobe. Wir haben die Daten für Januar 2025 herangezogen – völlig neue Daten, die von früheren Experimenten unberührt waren – und alle zuvor abgeleiteten Parameter ohne jegliche Änderung geladen. Das war ein entscheidender Punkt: keine Feinabstimmung, keine zusätzlichen Anpassungen – lediglich ein reiner Test, der die tatsächliche Generalisierungsfähigkeit des Modells widerspiegelte.
Die Testergebnisse sind unten aufgeführt.
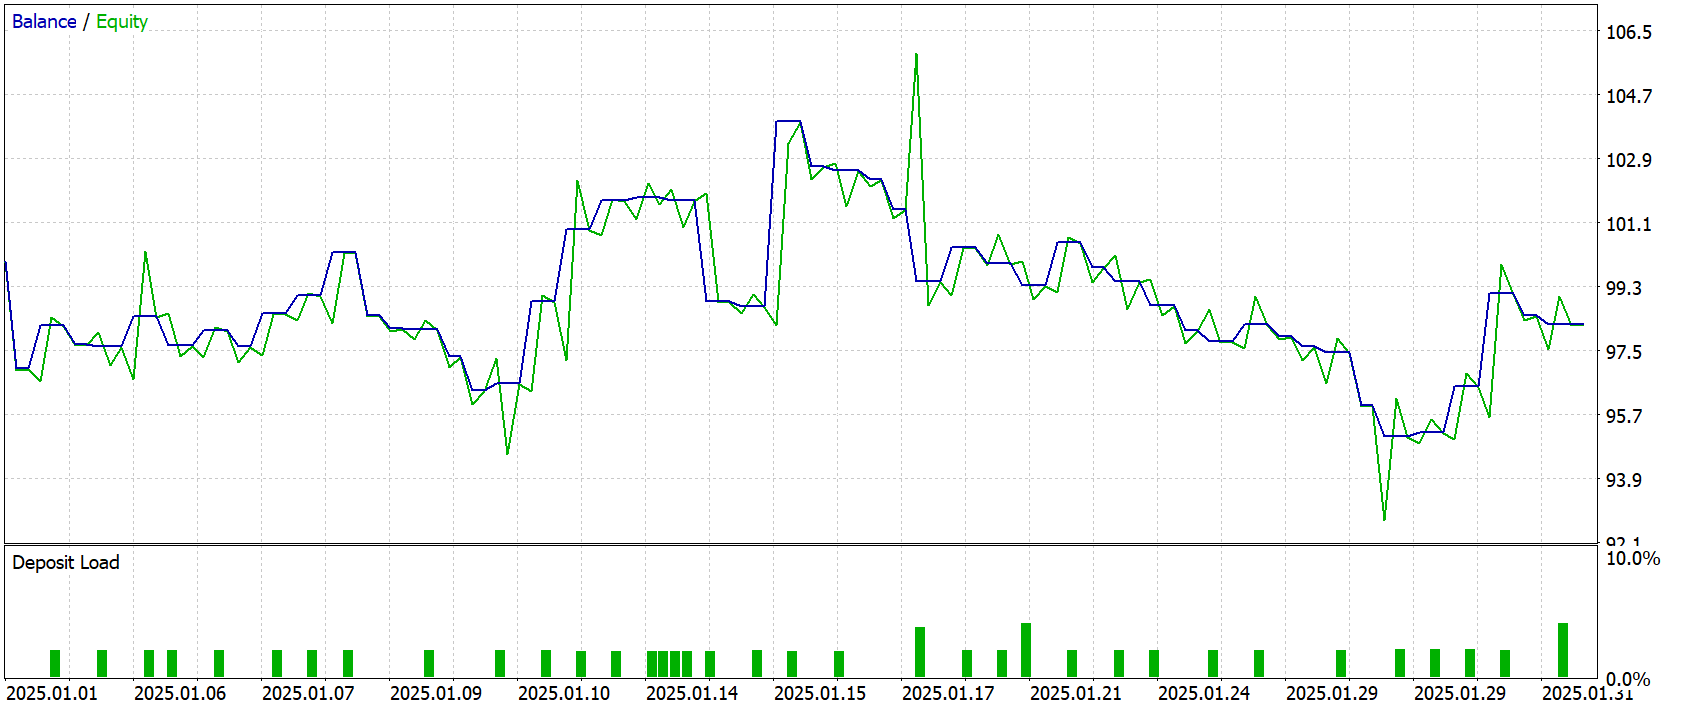
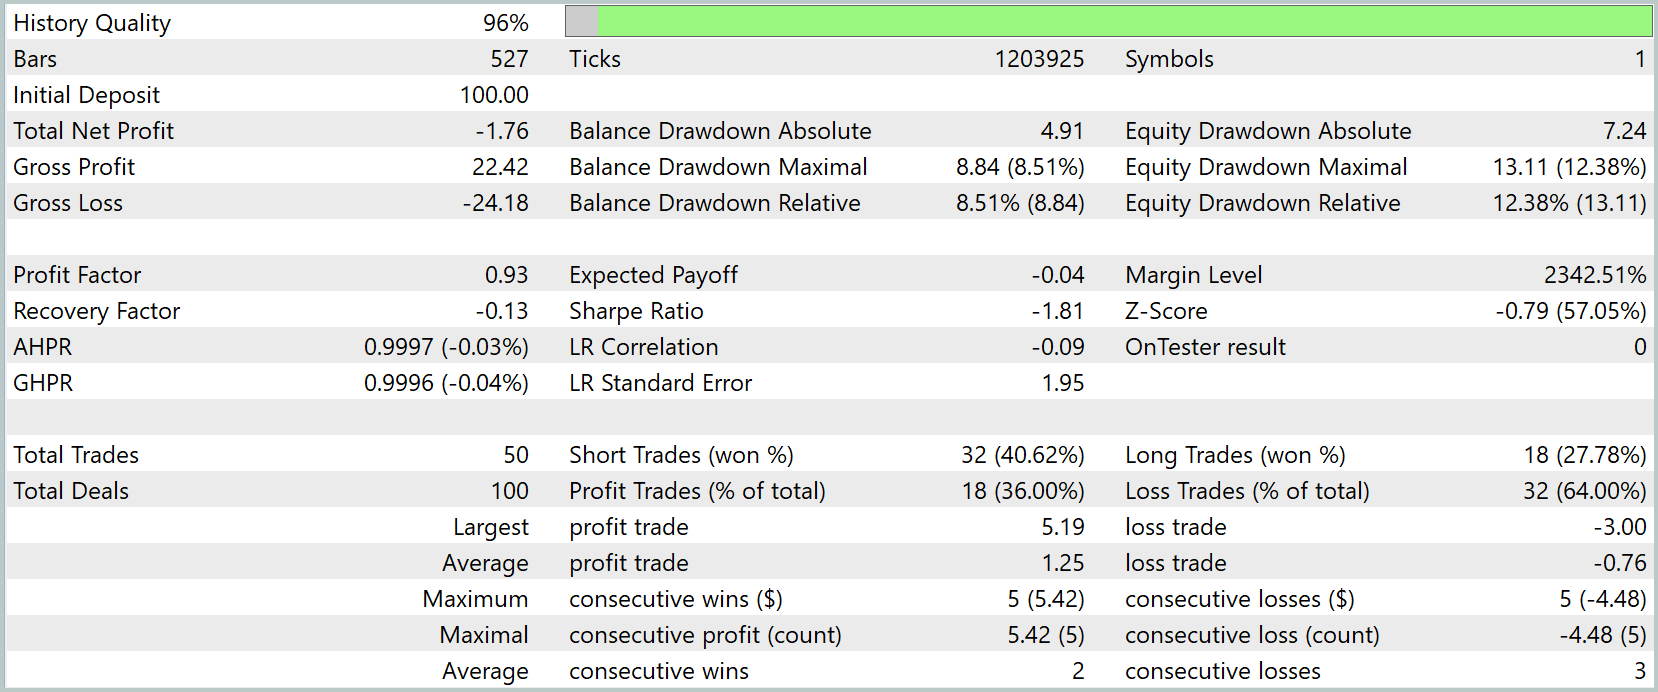
Die Testergebnisse zeigten, dass sich das Modell zurückhaltend verhielt und weitgehend vorhersehbar blieb. Das Endergebnis fiel jedoch negativ aus: -1,76 USD bei einer Ersteinzahlung von 100,0 USD. Der Bruttogewinn belief sich auf 22,42 USD, doch der Bruttoverlust lag mit 24,18 USD darüber. Dies spiegelte sich auch in den wichtigsten Kennzahlen wider: Der Profitfaktor lag bei 0,93, was auf ein leichtes Überwiegen der Verlustgeschäfte hindeutete. Auch der Erholungsfaktor rutschte in den negativen Bereich ab und erreichte -0,13.
Die Verteilung der Trades zeigt, dass das Modell 50 Orders aufgab, von denen 32 auf Short-Positionen mit einer Erfolgsquote von etwa 40 % entfielen, während es nur 18 Long-Trades mit einer Erfolgsquote von knapp unter 28 % gab. Es gab 18 gewinnbringende Geschäfte, die 36 % der Gesamtzahl ausmachten, während 32 Geschäfte zu einem Verlust führten. Die längste Gewinnserie fiel relativ bescheiden aus – fünf aufeinanderfolgende Trades, die einen Gewinn von etwa 5,42 USD einbrachten –, während die längste Verlustserie ebenfalls aus fünf Trades bestand und zu einem Drawdown von -4,48 USD führte.
Das Diagramm von Kontostand und Eigenkapital zeigt, dass die Strategie einem wellenförmigen Verlauf folgte, bei dem auf Phasen moderaten Wachstums Rückgänge folgten – ohne starke Einbrüche, aber auch ohne anhaltenden Aufwärtstrend. Nach der anfänglichen Anpassung war ein kurzfristiger Anstieg zu beobachten; dieser hielt jedoch nicht an, und der Kontostand glitt allmählich in die Verlustzone ab und schwankte bis zum Ende des Testzeitraums um das Ausgangsniveau. Dies deutet darauf hin, dass der Algorithmus im betrachteten Zeitraum noch keinen beständigen Vorteil erzielen konnte, aber auch keine katastrophalen Ausfälle verzeichnete – der Drawdown blieb beim Kontostand innerhalb von 8,5 % und lag beim Eigenkapital bei etwa 12 %.
Insgesamt lassen sich die Testergebnisse als vorläufig bezeichnen und als Hinweis darauf, dass das Modell einer weiteren Feinabstimmung und möglicherweise eines erweiterten Trainingsdatensatzes bedarf, um seine Generalisierungsfähigkeit zu verbessern. Es neigt zwar nicht zu starken Drawdowns, hat jedoch noch keine beständigen Gewinne gezeigt, weshalb sein Verhalten eher konservativ und vorsichtig als risikoreich ist.
Fazit
Zusammenfassend lässt sich feststellen, dass wir anhand der durchgeführten Tests den aktuellen Stand des entwickelten Ansatzes objektiv bewerten und dessen Stärken und Schwächen ermitteln konnten. Das Modell zeigte sich widerstandsfähig gegenüber starken Marktschwankungen und wies einen moderaten Drawdown auf, wobei die Risikokontrolle auch unter ungünstigen Szenarien gewährleistet blieb. Die Gesamtrendite bleibt jedoch vorerst negativ, und das Verhältnis von gewinnbringenden zu verlustbringenden Trades deutet darauf hin, dass eine weitere Optimierung der Parameter und wahrscheinlich auch eine Erweiterung des Trainingsdatensatzes erforderlich sind.
Diese Ergebnisse sind kein Misserfolg – im Gegenteil: Sie zeigen die Grenzen der aktuellen Umsetzung auf und geben die Richtung für die zukünftige Entwicklung vor. Die nächsten Schritte sollten darauf abzielen, den Entscheidungsprozess zu verfeinern, die Rauschfilterung zu verbessern und die Prognosegenauigkeit in einem volatilen Markt zu steigern. Somit bietet das hier vorgestellte Framework bereits eine stabile, funktionsfähige Grundlage, doch sein Potenzial wurde bislang nur teilweise ausgeschöpft, sodass noch Raum für weitere Verbesserungen und die praktische Anpassung an reale Handelsaufgaben besteht.
Literaturverzeichnis
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19425
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



