

取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(最終回)
 18
 8

はじめに
これまでの記事では、GinARの概要から理論的な考察、そして提案手法の実装へと段階的に進み、フレームワークのアーキテクチャと動作原理を詳しく解説してきました。GinARは、構造的不確実性が高く、ノイズの多い環境下で時系列データを分析・予測するために開発された、独自のニューラルネットワークフレームワークです。 多層・多要素からなるアーキテクチャを採用したGinARは、Attention機構、グラフ変換、再帰的ダイナミクスを組み合わせています。これにより、データの構造を捉えるだけでなく、その構造の変化にもリアルタイムで適応することを目指しています。
そして今回、最も重要で、おそらく最も興味深い段階に進みます。GinARフレームワークを実際の環境に近い条件下で評価する段階です。 これまでに、アーキテクチャの設計、主要コンポーネントの実装、順伝播・逆伝播アルゴリズムの開発を完了しました。 各コンポーネントについても、金融時系列データ特有の性質を考慮しながら、開発・テスト・調整を進めてきました。 ここで、すべての要素を統合し、実際の性能を確かめることにします。つまり、GinARが実際の分析・予測タスクをどの程度効果的に処理できるのか、実地で検証する段階に入ります。
本記事は、単に開発工程を締めくくるものではありません。多大な労力をかけて実装してきた構想の集大成でもあります。 中心となるのは、実運用に近い条件下でのモデルの学習とテストです。
評価結果を確認する前に、まずGinARフレームワークの構造を簡単に振り返っておきましょう。 その中核を担うのが、独自に設計したセルGinARCellです。このセルは、以下の主要構成要素を組み合わせて構成されています。
- Interpolation Attention(IA:補間アテンション):入力データを前処理し、関連性の高い要素にモデルの注意を向けるためのコンテキスト型Attention機構です。 いわば、最初の段階で働く知覚フィルターとして機能し、主要な変換処理に入る前に重要なパターンを特定するとともに、欠損した要素の再構成を可能にします。
- AGCNブロック(適応型グラフ畳み込みネットワーク):3つのモジュールから構成されます。そのうち1つは主要な処理を担うcX_AGNCで、残る2つは制御信号を処理するForgetGateとResetGateです。 これらのブロックは、データの構造やトポロジーに関する情報を抽出し、時間的・構造的な依存関係に基づいてデータの流れをモデル化します。
- コンテキストブロック(Context):時間的な状態を保持するストアとして機能し、処理の継続性と長期的な記憶を支えます。 その状態は、制御ゲート(gates)との相互作用に基づく重み付け方式によって更新されます。
- 二重制御メカニズム(ForgetGateとResetGate):コンテキストの情報を選別するフィルタリングと、新たな情報で置き換える上書きの原理に基づいて動作します。 両者は独立したAGCNセルとして実装されており、モデルの内部状態を柔軟に制御できます。
セルの出力は、ELU活性化関数とコンテキストアテンションの乗算係数に基づいて生成されます。これにより、時間区間間の変化に対して、滑らかでありながらも適切に反応する出力を実現します。
こうした要素の組み合わせが、GinARの独自性を形作っています。 従来の再帰型ニューラルネットワークが過去の情報を記憶するのに対し、GinARはその情報を構造化することも目指しています。 また、標準的なGCNモデルとは異なり、固定されたトポロジーに依存するのではなく、処理の進行に応じてトポロジーを学習します。 さらに、汎用的なTransformerモデルとは異なり、GinARは局所性と動的な適応能力を維持します。これら2つの特性は、金融時系列データを分析するうえで重要です。
著者によるGinARフレームワークの構成図を以下に示します。
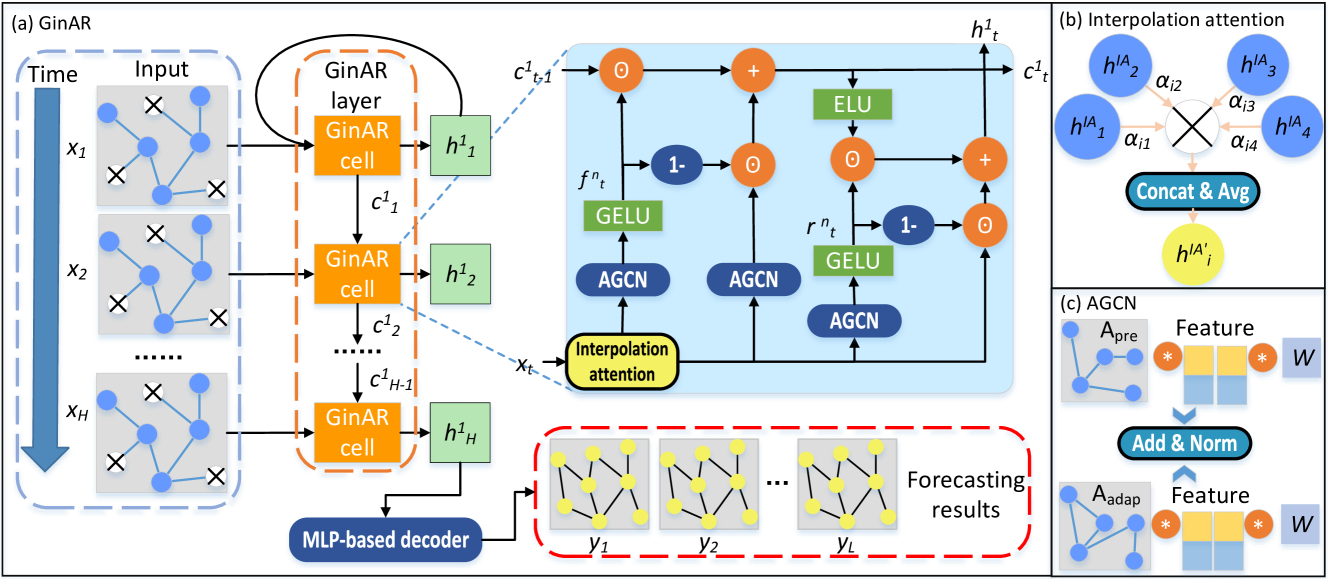
本記事は、技術的な解説の締めくくりであると同時に、これまで構築してきた設計全体の完成度を検証する機会でもあります。 フレームワークが実際にどのような性能を発揮するのか、どのようなボトルネックが生じるのか、そして新たなデータに対してどの程度の予測精度と頑健性を示すのかを確認していきます。 そして何より重要なのは、これほど複雑なアーキテクチャを採用するだけの価値がある、トレーダーにとっての実質的な優位性をGinARが本当に提供できるのか、という点です。
GinARブロック
GinARアーキテクチャは、階層構造を採用しています。 複数のGinAR層を連続して配置し、最後に多層パーセプトロン(MLP)で構成されたDecoderを接続する構造です。 各GinARは、複数のGinARCellセルから構成されます。これらのセルは、映画の各フレームが連続したシーンを形成するように、時系列データを順番に処理していきます。。
各層の出力では、最後のセルの最終隠れ状態だけを保持します。 これらの状態を統合して、単一の最終テンソルhⁿₐₗₗを生成します。このテンソルには、分析対象となるシーケンス全体を圧縮し、その情報を可能な限り効率よく表現した特徴が含まれています。 このテンソルがMLP Decoderに入力されます。Decoderは2つの全結合層で構成され、その間にReLU活性化関数が配置されています。
ここで、GinARの多層構造におけるデータフローの設計について、重要な点を確認しておきましょう。 複数の層を順番に適用し、各層の出力を次の層の入力として渡す方法自体は、ごく一般的な手法です。これは、各処理を直線的につないでいくモデルの考え方にもよく合致しています。
しかし、元のGinARモデルでは、これよりも複雑な構成が採用されています。複数の層で順次処理した後、最後の層の出力だけを使用するのではなく、すべての層の出力を連結して、統合された表現を生成するのです。 この方法により、Decoderは、抽象化の異なる段階で生成された内部特徴を幅広く利用できます。その結果、モデルの表現能力が高まります。 一方で、これは従来の実装が前提としている直線的なデータ転送構造から外れるため、複数のレイヤーから得られたデータを収集し、統合するための追加処理が必要になります。
今回使用している高水準のモデル構築オブジェクトは、もともと複数のレイヤーの出力を1つのテンソルに統合する操作をサポートしていません。そのため、オリジナルのGinARアーキテクチャのこの部分を、そのまま直接実装することはできません。 そこで、この制約を回避するために、専用のGinARブロックを開発しました。このブロックは、複数のCNeuronGinARCellセルを使用して入力データを順次処理し、その後、各セルの結果を1つのテンソルに集約します。 この最終テンソルをDecoderに渡すことで、異なる抽象化レベルで得られた特徴を統合するという、オリジナルモデルの重要な特性を再現しています。
GinARブロックの構造を詳しく見る前に、オリジナルモデルとの重要な違いについても触れておきます。 基本構造に加えて、今回の実装では、分析対象データの各要素間にあらかじめ定義された関係を表す、学習可能な行列を追加しました。 この行列には、各GinARCell内の構造的依存関係行列で使用されているものと同様の、適応的な学習メカニズムを採用しています。 ただし、適用範囲には重要な違いがあります。 各セル内の適応行列は、それぞれのセルが捉える局所的なパターンを反映するため、セルごとに独立して形成されます。一方、今回追加した行列はグローバルな性質を持ち、1つのGinARブロック内のすべてのセルで共有されます。 これにより、分析対象全体を通じて繰り返し現れる、変数間の安定した相関関係を捉えやすくなり、モデル全体の構造的一貫性を高めることができます。
このGinARブロックをアーキテクチャに組み込むため、CNeuronSwiGLUOCLを継承するCNeuronGinARという専用クラスを作成しました。 この階層構造により、モデルの他の部分との互換性を維持しつつ、基礎となる活性化設計の利点と、柔軟なSwiGLU非線形性を併せて活用できます。 ただし、主要な機能要素と処理ロジックについては、大幅に拡張し、再定義しています。 新しいオブジェクトの構造を以下に示します。
class CNeuronGinAR   :  public CNeuronSwiGLUOCL
  {
protected:
   CParams              cEa;
   CNeuronSwiGLUOCL     cWx;
   CNeuronSwiGLUOCL     cWe;
   CNeuronBaseOCL       cWconcat_ex;
   CNeuronConvOCL       cEn;
   CNeuronTransposeOCL  cEnT;
   CNeuronBaseOCL       cEnEnT;
   CNeuronSoftMaxOCL    cApre;
   CNeuronGinARCell     caCells[4];
   CNeuronBaseOCL       cConcat;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGinAR(void) {};
                    ~CNeuronGinAR(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinAR; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   //---
   virtual bool      Clear(void) override;
  };
CNeuronGinARクラスは、MQL5環境でOpenCLを利用して実装された、GinARフレームワークの本格的な構成ブロックです。 時系列データを処理し、階層的な線形関係に基づいて複雑なパターンを抽出することを目的としています。 このクラスは、構造的依存関係を表すグローバル行列の生成と解釈を担う複数の主要構成要素と、入力データを順次処理するCNeuronGinARCellセルの配列を統合しています。 各セルの処理結果は、最終的に連結され、分析対象のシーケンスを表す最終的な特徴表現が生成されます。
クラスの設計は、モジュール性と再利用性を重視しています。 内部要素はすべて静的に宣言されています。 つまり、オブジェクトの生成、破棄、メモリの解放といったライフサイクルの管理は自動的に行われるため、コンストラクタやデストラクタから明示的に処理する必要はありません。
Initメソッドは、すべての内部構成要素を設定するために使用されます。 初期化処理の唯一の入口となるメソッドであり、オブジェクトの構造やパラメータ最適化の方式を指定する引数を受け取ります。
bool CNeuronGinAR::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                        uint units_count, uint dimension,
                        ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSwiGLUOCL::Init(numOutputs, myIndex, open_cl, caCells.Size()*dimension,
                              caCells.Size()*dimension, dimension, units_count, 1,
                              optimization_type, batch))
      return false;
最初に、親クラスCNeuronSwiGLUOCLの同名メソッドを呼び出します。今回の実装では、この処理によってGinARCellセルの出力を集約した表現を扱うための基盤を構築します。 その後、ブロックのアーキテクチャを構成する各構成要素を順番に初期化していきます。
最初に初期化するのは、時系列データの変数間におけるグローバルな構造的依存関係を表す、学習可能な行列です。
int index = 0;
if(!cEa.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cEa.SetActivationFunction(None);
従来の方法では、予測対象のシーケンス構造に関する事前知識や予備分析に基づいて、あらかじめ共分散行列を構築します。これに対し、今回の実装では、1つのブロック内にあるすべてのGinARCellセルで共有する、学習可能な構造的依存関係行列を使用します。 この方法では、手動でパラメータを調整したり、外部でデータ分析を行ったりする必要がありません。また、学習中に変数間の関係をより柔軟かつ適応的に調整できるようになります。
次に、線形変換層cWxとcWeを初期化します。 これらの層は、入力データと共分散行列を共通の次元数に変換したうえで、単一のテンソルcWconcat_exに統合する役割を担います。
   index++;
   if(!cWx.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                            optimization, iBatch))
      return false;
   index++;
   if(!cWe.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                            optimization, iBatch))
      return false;
   if(!cWconcat_ex.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
      return false;
   cWconcat_ex.SetActivationFunction(None);
畳み込み層cEnは、特徴とその依存関係を深く混合するために使用します。
   index++;
   if(!cEn.Init(0, index, OpenCL, 2 * dimension, 2 * dimension, dimension, units_count,
                                                              1, optimization, iBatch))
      return false;
   cEn.SetActivationFunction(None);
   index++;
   if(!cEnT.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
      return false;
   index++;
   if(!cEnEnT.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
      return false;
   cEnEnT.SetActivationFunction(GELU);
まず、得られたデータを転置します。次に、元の表現とその転置表現を乗算し、変数間の相互依存関係を表す対称行列cEnEnTを生成します。 活性化関数にはGELUを使用し、重要な関係が強調されるようにします。
続いて、SoftMax関数を使用して依存関係行列を正規化し、確率分布へと変換します。
   index++;
   if(!cApre.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
      return false;
   cApre.SetHeads(units_count);
次に、CNeuronGinARCellセルの配列を初期化します。各セルは、階層構造のそれぞれの段階で分析対象のシーケンスを処理します。 各セルは論理的には独立していますが、アーキテクチャはすべて同一です。そのため、初期化処理は簡潔に記述できます。適切に構成した1つのループで、すべてのセルを初期化できます。
   for(uint i = 0; i < caCells.Size(); i++)
     {
      index++;
      if(!caCells[i].Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
         return false;
     }
   index++;
   if(!cConcat.Init(0, index, OpenCL, GetWindow()*units_count, optimization, iBatch))
      return false;
//---
   return true;
  }
各セルの出力は、cConcatオブジェクトに集約されます。 すべての内部コンポーネントの初期化が正常に完了すると、処理結果として真偽値を呼び出し元のプログラムに返します。
ここで重要なのは、Initメソッド自体が、これらのオブジェクトのライフサイクルを管理するわけではないという点です。 このメソッドの役割は、各構成要素のパラメータを正確に設定し、層の構造を構築したうえで、モデルの実行処理に制御を引き渡すことです。 この設計により、高い安定性と予測可能な動作を確保し、メモリも効率的に使用できます。
初期化が完了すると、CNeuronGinARブロックのすべての構成要素が、順伝播処理を実行できる状態になります。 この段階では、構造的なモジュール、各セルの隠れ状態、そして学習可能な依存関係行列がどのように連携するかが明らかになります。 feedForwardメソッドは、構造的依存関係行列の構築から最終出力テンソルの生成まで、入力シーケンスの処理全体を担当します。生成された出力テンソルは、ニューラルネットワークの次の層に渡されます。
bool CNeuronGinAR::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
//--- Calculate Apre
   if(bTrain)
     {
      if(!cEa.FeedForward())
         return false;
      if(!cWe.FeedForward(cEa.AsObject()))
         return false;
     }
最初に、学習可能な依存関係行列を構築します。 モデルが学習モード(bTrain == true)の場合、まずグローバルな構造的依存関係を表すテンソルを処理し、その出力を線形射影層に渡します。
これと並行して、入力データの主要な情報フローも、cWx線形射影層を通過する際に処理されます。
//---
   if(!cWx.FeedForward(NeuronOCL))
      return false;
   if(!Concat(cWx.getOutput(), cWe.getOutput(), cWconcat_ex.getOutput(),
              cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
      return false;
次に、Concat操作によって2つの経路の処理結果を1つのテンソルに統合し、その結果を畳み込み層cEnに入力します。
   if(!cEn.FeedForward(cWconcat_ex.AsObject()))
      return false;
   if(!cEnT.FeedForward(cEn.AsObject()))
      return false;
   if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(), cEnT.GetCount(),
                                                  cEnT.GetWindow(), cEnT.GetCount()))
      return false;
   if(cEnEnT.Activation() != None)
      if(!Activation(cEnEnT.getOutput(), cEnEnT.getOutput(), cEnEnT.Activation()))
         return false;
その後、生成されたテンソルを転置してcEnTに格納し、元のテンソルと転置テンソルを乗算します。 この段階で、実質的に共分散行列に相当する行列が形成されます。必要に応じて、指定された活性化関数による非線形変換も適用されます。
最終的な共分散行列はcApre層で構築されます。ここではSoftMax関数を用いてデータを確率的な表現に変換します。
if(!cApre.FeedForward(cEnEnT.AsObject()))
   return false;
if(!IdentSum(cApre.getOutput(), cApre.getOutput(), cApre.Heads()))
   return false;
行列の安定性を確保し、各要素が最低限の自己接続を持つようにするため、単位行列を加えます。 つまり、各変数は他の変数との関係に関する情報を受け取るだけでなく、自分自身への基本的な参照も維持します。 これにより、大域的な依存関係と各要素固有の重要性の両方を考慮できる、バランスの取れたAttention重みの構造が形成されます。 この最終的な行列は、各GinARCellセルの入力に渡され、信号を選択的に強調するための共通の仕組みとして機能します。
続いて、セルの配列を通じて入力シーケンスの主要な処理を開始します。 外部プログラムから受け取った分析対象データは、最初のセルに入力されます。 2番目以降のセルは、直前のセルの出力を分析しながら、潜在表現の詳細度を高めていきます。 こうして、時系列分析の階層構造を反映した、一連の隠れ表現が形成されます。
//--- GimAR Cells
   CNeuronBaseOCL *temp = NeuronOCL;
   for(uint i = 0; i < caCells.Size(); i++)
     {
      if(!caCells[i].FeedForward(temp, cApre.getOutput()))
         return false;
      temp = caCells[i].AsObject();
     }
//---
   if(!Concat(caCells[0].getOutput(), caCells[1].getOutput(), caCells[2].getOutput(),
              caCells[3].getOutput(), cConcat.getOutput(), GetWindow() / 4,
              GetWindow() / 4, GetWindow() / 4, GetWindow() / 4, GetUnits()))
      return false;
//---
   return CNeuronSwiGLUOCL::feedForward(cConcat.AsObject());
  }
このメソッドの最後では、すべてのセルの出力をcConcatという単一のテンソルに統合します。続いて、このテンソルを親クラスCNeuronSwiGLUOCLの同名メソッドに入力し、さらに処理を進めます。 この構造により、GinARブロック内で情報を連携させながら効率的に伝達できます。また、使用しているフレームワークのアーキテクチャ上の制約がある中でも、システムの動作をオリジナルの構造にできるだけ近づけています。
順伝播が完了し、ブロックの出力が計算されたら、次の重要な段階である誤差勾配の伝達に進みます。 ここでは、予測モデルの学習に必要な逆方向の計算がおこなわれます。Decoderから返される誤差情報をアーキテクチャ内の各要素に伝え、重みを適切に調整してモデルを最適化します。
calcInputGradientsメソッドは、ブロック全体の逆伝播処理を担当します。出力側から入力データ側に向かって、アーキテクチャのすべての要素を通じて勾配を伝播させます。 このブロックは、順次実行される演算に加え、テンソルの分岐や結合も含む複雑な構造です。そのため、逆伝播では、各処理を順序どおりに実行し、相互の整合性を保ちながら勾配を伝える必要があります。
bool CNeuronGinAR::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronSwiGLUOCL::calcInputGradients(cConcat.AsObject()))
      return false;
   if(!DeConcat(caCells[0].getPrevOutput(), caCells[1].getPrevOutput(),
                caCells[2].getPrevOutput(), caCells[3].getGradient(),
                cConcat.getGradient(), GetWindow() / 4,
                GetWindow() / 4, GetWindow() / 4,
                GetWindow() / 4, GetUnits()))
      return false;
最初に、親クラスCNeuronSwiGLUOCLの同名メソッドを呼び出し、内部セルの出力を連結したテンソルcConcatに勾配を伝えます。 順伝播では、4つのGinARセルの出力を連結してこのテンソルを生成しました。そのため、逆伝播では、勾配を4つの情報経路に正しく振り分ける必要があります。 DeConcatメソッドを使用して、最終結果への寄与に応じた勾配を各セルに渡します。
ここで、GinARブロック内の誤差勾配の伝播について、特に注意すべき点があります。 各セルは一見すると対称的ですが、学習時に果たす機能的な役割は同じではありません。
まず、最後のセルは、連結によってブロックの最終出力テンソルを形成するためにのみ使用されます。 一方、それより前のセルは、2つの役割を担っています。すなわち、それぞれの出力は最終出力の連結に使われるだけでなく、階層構造における次のGinARCellの入力にもなります。 そのため、これらのセルには2つの経路から誤差勾配が伝わります。 最初の3つのセルの勾配を計算する際には、データが利用される2つの経路からの勾配を集め、正しく加算する必要があります。 これにより、勾配の流れを途切れさせることなく、階層の各段階で適切なフィードバックを実現できます。
//--- GimAR Cells
   cApre.getGradient().Fill(0);
   for(uint i = caCells.Size() - 1; i > 0; i--)
      if(!caCells[i - 1].CalcHiddenGradients(caCells[i].AsObject(), cApre.getOutput(),
                                             cApre.getPrevOutput(),
                                             (ENUM_ACTIVATION)cApre.Activation()) ||
         !SumAndNormilize(caCells[i - 1].getGradient(), caCells[i - 1].getPrevOutput(),
                          caCells[i - 1].getGradient(), cWx.GetWindow(), false, 0, 0, 0, 1) ||
         !SumAndNormilize(cApre.getGradient(), cApre.getPrevOutput(),
                          cApre.getGradient(), GetUnits(), false, 0, 0, 0, 1))
         return false;
   if(!NeuronOCL.CalcHiddenGradients(caCells[0].AsObject(), cApre.getOutput(),
                                     cApre.getPrevOutput(), (ENUM_ACTIVATION)cApre.Activation()) ||
      !SumAndNormilize(cApre.getGradient(), cApre.getPrevOutput(),
                       cApre.getGradient(), GetUnits(), false, 0, 0, 0, 1))
      return false;
次に、cApreオブジェクトで表されるグローバルな共分散行列の勾配を計算する際には、さらに注意が必要です。 この行列は、4つのGinARCellすべてに同時に渡されています。 そのため、逆伝播では、各セルからの独立した4つの経路を通じて伝わる勾配を、この行列に集約しなければなりません。 具体的には、形状とスケールの整合性を維持しながら、各経路から届く勾配を順番に加算します。 この処理を誤ると、重みが急激に変動し、学習が不安定になる可能性があります。
続いて、依存行列を生成するブロック内で誤差逆伝播をおこないます。 まずcEnEnTの勾配を計算し、対応する活性化関数の導関数を用いて値を調整します。
//---
   if(!cEnEnT.CalcHiddenGradients(cApre.AsObject()))
      return false;
   if(cEnEnT.Activation() != None)
      if(!DeActivation(cEnEnT.getOutput(), cEnEnT.getGradient(),
                       cEnEnT.getGradient(), cEnEnT.Activation()))
         return false;
   if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
                  cEnT.getOutput(), cEnT.getGradient(),
                  cEnEnT.getGradient(), cEnT.GetCount(),
                  cEnT.GetWindow(), cEnT.GetCount()))
      return false;
   if(!cEn.CalcHiddenGradients(cEnT.AsObject()))
      return false;
   if(!SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(),
                       cEn.getGradient(), cEnT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEn.Activation() != None)
      if(!DeActivation(cEn.getOutput(), cEn.getGradient(),
                       cEn.getGradient(), cEn.Activation()))
         return false;
次に、行列乗算演算MatMulGradに対する勾配を計算し、誤差を畳み込み層cEnとその転置コピーcEnTの間に振り分けます。 同時に、転置表現側の誤差勾配も畳み込みレイヤーに逆向きに伝え、2つの情報経路から得られた値を加算します。 この方法により、対称な共分散行列に相当する表現を、微分可能な形で構築できます。複雑な接続構造であっても、誤差勾配の伝播精度と一貫性を維持できるようになります。
次に、得られた値をテンソルcWconcat_ex値の段階まで逆伝播させます。
if(!cWconcat_ex.CalcHiddenGradients(cEn.AsObject()))
   return false;
if(!DeConcat(cWx.getGradient(), cWe.getGradient(), cWconcat_ex.getGradient(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
cWconcat_exの出力は、cWxとcWeの処理結果から構成されていました。 逆伝播では、これらの勾配を再び分割し、それぞれの経路に戻します。その後、必要に応じて活性化関数の逆伝播処理をおこないます。 続いて、cWxから入力元のデータオブジェクトNeuronOCLへと逆伝播を進めます。
ただし、ここでは、最初のセルからの誤差勾配がすでに入力データの段階まで伝わっていることを忘れてはいけません。 そのため、データバッファへのポインタを一時的に差し替え、2つの情報経路から得られた値を合算する方法を使用します。
   if(cWx.Activation() != None)
      if(!DeActivation(cWx.getOutput(), cWx.getGradient(),
                       cWx.getGradient(), cWx.Activation()))
         return false;
   if(cWe.Activation() != None)
      if(!DeActivation(cWe.getOutput(), cWe.getGradient(),
                       cWe.getGradient(), cWe.Activation()))
         return false;
   CBufferFloat* temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(cWx.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), temp,
                       NeuronOCL.getGradient(), cWx.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.SetGradient(temp, false))
      return false;
最後に、誤差勾配をグローバルな依存関係行列cEaの段階まで伝播させます。
   if(!cEa.CalcHiddenGradients(cWe.AsObject()))
      return false;
//---
   return true;
  }
すべての処理が正常に完了すると、このメソッドの実行結果を示す真偽値が呼び出し元のプログラムに返されます。
このように、calcInputGradientsメソッドは、GinARブロック全体を通じて誤差勾配が正しく伝播することを保証します。 逆伝播の構造は順伝播の構造に対応しており、複雑な注意機構や入れ子状のコンポーネントを使用する場合には、特に重要な設計上の要件となります。
このクラスと各メソッドの完全なソースコードは添付ファイルに収録されており、詳細を確認するために参照できます。
モデルアーキテクチャ
GinARフレームワークの構築に必要な構成要素がすべて揃ったので、次の段階として、学習可能なモデルのアーキテクチャについて説明します。 ここで扱うアーキテクチャは、単なる時系列予測の枠を大きく超えています。目標は、GinARフレームワークをEnvironment-State Encoderとして機能させる、本格的な取引エージェントを構築することです。
モデルの各構成要素は、それぞれ特定の役割を担います。 Encoderは、過去のデータから情報を抽出し、要約する役割を担います。 3つの並列モデルで構成される予測モジュールは、それぞれ異なる予測期間について予測をおこないます。 続いて、強化学習アーキテクチャを構成するActorとCriticが配置されます。Actorは取引行動を生成し、Criticは現在の市場状態において、モデルが選択した行動によって期待されるパフォーマンスを評価します。
アーキテクチャの定義には、CreateDescriptionsメソッドを使用します。このメソッドは、すべてのモジュールの構成を生成します。 最初に、Encoder、予測モジュール、Actor、Criticそれぞれのコンテナを初期化します。 これらのコンテナは、ニューラルネットワークの各層の定義を格納するオブジェクト配列として実装されています。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
初期化が完了したら、モデルの構造を定義していきます。 Encoderは、過去の入力データをそのまま受け取る基本的な全結合層から始まります。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、ノイズを加えたバッチ正規化層を配置します。この層は、生データの分布を安定させるとともに、データ表現に揺らぎを加えることで、過学習を抑制し、モデルの頑健性を高めることを目的としています。
続いて、隣接するローソク足の差分特徴量を追加します。 これにより、絶対値だけでなく、価格や各種指標の変化の方向と大きさも捉えられるようになります。 これは、市場の動きが激しく、不規則に変化する状況において、特に重要です。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次の層では、イムスタンプの高調波成分を埋め込み表現に取り込み、データ表現を豊かにします。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
前処理されたデータは、続いて転置層を通過します。この層はデータの軸を入れ替え、時間方向の系列を特徴量方向の表現に変換して、畳み込みフィルタに入力できる形にします。 tanh活性化関数を用いる畳み込み層は、埋め込み表現に含まれる重要なパターンや構造的な依存関係を抽出し、市場に潜む規則性を圧縮して表現します。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = 1;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Encoderの最後に配置されるのが、GinARフレームワークを実装する層です。 ここでは、それまでに抽出された特徴量を統合し、GinARセルの階層構造を通じて解釈します。 各セルは同期して動作し、共有の学習可能な共分散行列を用いて、データに潜む構造的な依存関係をモデル化します。 この層は、単に情報を次の層へ渡すだけではありません。市場状態を表す、より高度な内部表現を形成します。この表現は、取引判断に利用するための情報基盤となります。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronGinAR;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
このように、GinARフレームワークの手法は、モデルのアーキテクチャに一貫した形で組み込まれており、不必要な複雑さも生じていません。 Encoderが最終的に生成する隠れ状態は、市場状況を高い抽象度で表現したものであり、将来予測と取引判断の生成の両方に利用できます。
Environment-State Encoderの学習には、複数の独立したサブシステムから誤差勾配を同時に逆伝播させる、エンドツーエンドの学習戦略を採用します。 中心となるのは3つの予測モデルです。それぞれが、異なる計画期間における時系列の将来の推移を予測することに特化しています。 これらのモジュールは、Encoderが生成した同じ隠れ状態を入力として受け取りますが、予測期間に応じて異なる観点から解釈します。 これにより、現在の市場状況を複数の時間スケールから捉えられるようになります。
さらに、取引判断を生成するActorも学習に参加します。 Actorは、環境状態を圧縮した同じ表現を利用し、それを行動選択の指針として解釈します。 つまり、Encoderは4つの方向から同時に学習信号を受け取ります。3つの予測モデルにとって有用な情報を表現すると同時に、Actorが市場の不確実性に対応した取引判断を下すうえでも有用な表現を生成しなければなりません。
なお、これらのモデルのアーキテクチャは、すべて先行研究から引き継いだものです。 そのため、本研究では各モデルの詳細な説明には立ち入らず、 新しい要素であるGinARフレームワークを学習可能なシステムに統合する方法に焦点を当てます。
各層の構成を含むすべての構成要素の完全なコードは、添付ファイルに記載されています。
学習
すべての構成要素の構築と、学習可能なモデルのアーキテクチャの設定が完了したので、最終段階であり、おそらく最も重要な段階であるモデルの学習に進みます。 本システムでは、オフライン学習とオンライン学習の両方の長所を組み合わせた手法を採用しています。 これにより、モデルの初期学習を堅牢に行えるだけでなく、市場局面の変化、ボラティリティの水準、売買シグナルの発生頻度など、特定の取引条件に合わせてモデルの挙動を適応させることも可能になります。
これまでの研究と同様に、学習プロセスは2段階で構成されます。 第1段階はオフライン学習です。 ここでは、モデルを過去のデータで学習させます。 さらに、事前に学習用サンプルを収集する必要のない手法を採用しています。 その代わりに、ターミナルの過去データから環境状態を直接構築すると同時に、口座状態をシミュレーションします。 この方法は柔軟性が高く、手作業でデータセットを準備することなく、任意の過去データ期間を利用できます。
第2段階はオンラインでの微調整です。 MetaTrader 5のストラテジーテスターを使用し、実取引に可能な限り近い条件下で実施します。 モデルは、これまでに遭遇していない新たな市場シナリオに直面しながら学習を続け、それらにリアルタイムで適応していきます。 この段階では、オフライン学習中に生じた不整合をさらに解消し、実口座での完全自律運用に向けてシステムを準備します。
なお、2段階学習という考え方自体は、本研究で初めて導入するものではありません。 これまでの研究でも、この戦略を適用してきました。 しかし、今回のプロジェクトでは、理論的な考察と、過去のモデルの実装を通じて得られた実践的な経験に基づき、オフライン学習の段階において本質的に重要な変更を加えています。
今回のアーキテクチャには、Directorと呼ばれる構成要素が存在しないことにお気づきかもしれません。 最近のいくつかの研究では、DirectorをCriticと並行して動作する追加の評価モデルとして使用していました。 その主な役割は、エージェントの行動を、利益につながるものか損失につながるものかに二値分類することでした。 このような厳格ななフィードバック方式は、学習初期の段階では有効であり、方策の初期適応を加速するのに役立ちました。
しかし、今回は異なるアプローチを採用しました。 そこで、オフライン学習の段階で、強化学習と教師あり学習という2つの手法を直接組み合わせることにしました。 この方法は、フィードバックの質と学習の方向性を明確にするという点で、より洗練され、効果的であることが分かりました。
変更点の要旨は次のとおりです。Criticがエージェントの現在の行動を評価するのと並行して、将来の価格変動の分析から導出した参照行動をActorに与えます。 オフライン学習段階では、その後の価格変動を含む完全な時系列区間にアクセスできるため、いわゆるほぼ理想的な行動軌跡を算出できます。 事後的に生成されるこれらの行動は、単に取引の方向を示すだけではありません。Actorの方策が目指すべき参照点として機能します。
このように、エージェントは自身の失敗から学ぶと同時に、あらかじめ計算された利益につながる戦略の例からも学習します。 これにより、Directorによる厳格な二値フィードバックから脱却しながらも、その学習効果を維持できます。 それどころか、学習を導く信号の質が向上し、収益性の高い方策をより管理しやすく、堅牢な形で構築できるようになります。
この手法は、エキスパートアドバイザー(EA)「…\MQL5\Experts\GinAR\Study.mq5」のTrainメソッドに実装されています。 このメソッドは、強化学習と教師あり学習を組み合わせたオフライン学習の中核を担います。 その基本となるのは、過去データを用いて市場状況を順次シミュレーションし、現在の状態と理想化された取引判断の軌跡の両方を分析しながら取引戦略を学習することです。
まず、学習データを準備します。ユーザーが指定した期間を過去の価格データから選択し、各時間区間について分析対象のテクニカル指標を計算します。 この段階では、すべての指標が計算済みで、利用可能な状態になっていることを確認します。指標の準備が整っていない場合、処理は中断されます。
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
//---
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
入力状態、タイムスタンプ、目標値を保存するためのバッファを作成します。
続いて、メインの学習ループが始まります。 学習は一連のエポックで構成され、各エポックでは、選択した過去データ全体を一通り処理します。 各エポックの内部では、市場状況を順番にシミュレーションしていきます。
//---
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int epoch = 0; (epoch < Epochs && !IsStopped() && !Stop); epoch ++)
     {
      if(!cEncoder.Clear())
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
      for(int posit = start - HistoryBars - NForecast - 1; posit >= end; posit--)
        {
         if(!CreateBuffers(posit, GetPointer(bState), GetPointer(bTime), Result))
           {
            PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
            ExpertRemove();
            return;
           }
         const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
         const vector<float> target_action = OraculAction(account, Result);
         if(!bAccount.AssignArray(account))
           {
            PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
            ExpertRemove();
            return;
           }
各ステップでは、現在の市場状態を数値ベクトルとして構築し、対応する時間情報を特定します。 これらのデータをEncoderに入力し、市場の状況を凝縮したコンパクトな隠れ表現へと変換します。これは、市場の全体像を本質的な情報に圧縮した表現といえます。
//--- Feed Forward
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false,
                                   (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
 }
こうして得られた潜在ベクトルは、同時に3つの用途に利用されます。 まず、3つの予測モデルに入力されます。 それぞれ短期・中期・長期の予測期間を担当し、今後の市場推移を予測します。
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].feedForward(GetPointer(cEncoder), -1, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
一方、同じ隠れ表現は、取引判断を生成するActorにも渡されます。 Actorは、市場状態と現在の口座状態に基づいて、行動テンソルを生成します。
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
生成された行動はCriticによって評価され、与えられた条件下で、その判断がどの程度妥当であるかを判定します。
if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
順伝播が完了したら、各モデルにフィードバックを与えます。 まず、予測モデルのパラメータを調整します。
//--- Study
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].backProp(Result, (CBufferFloat*)NULL) ||
     !cEncoder.backPropGradient((CBufferFloat*)NULL))
     {
     PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
Actorが生成した行動の評価には、報酬の計算を用います。報酬は、基準残高で正規化した有効証拠金の変化に基づいて算出します。 損失が発生した場合には、フィードバックをより厳格にするため、ペナルティを2倍にします。 算出した報酬をCriticに渡し、 そこから誤差勾配をActorとEncoderへ逆伝播させます。
//---
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(reward < 0)
   reward *= 2;
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
  !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, false) ||
  !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
 {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
  break;
  }
このようにして、選択した行動に対する市場の実際の反応に基づく初期学習がおこなわれます。
しかし、学習はここで終わりません。 次に、この手法の第2の要素である教師あり学習を導入します。 市場の実際の反応だけに依存するのではなく、実取引では利用できない情報、すなわち将来の価格変動に関する情報を活用します。 各状態について、ほぼ理想的な参照用の軌跡を計算します。これは、その後の価格変動を踏まえた場合に、最良の結果につながったと考えられる行動です。 このアクションをActorに渡し、Actor自身の方策と比較させます。 つまり、試行錯誤を通じて戦略を学習させるだけでなく、目指すべき明確な基準も与えるのです。 実際の行動に基づく学習と、理想化された行動に基づく学習を組み合わせたこの方式により、学習を加速させ、モデルの挙動をより安定的かつ合理的なものにすることを目指します。
//--- Oracul
if(!Action.AssignArray(target_action))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(!cActor.backProp(Action, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
参照行動は、Actorの学習だけでなく、 Criticの入力にも使用します。最初の評価とは異なり、今回は望ましいと考えられる行動をCriticに評価させます。 順伝播の後、この理想化された行動に基づく誤差をEncoderへ逆伝播させます。 これにより、Criticは報酬関数の構造をより正確に捉えられるようになります。また、エージェントが特に正確な行動を取る必要がある状態空間の領域について、追加の情報を得ることができます。その結果、後続のActorの学習における評価能力の向上が期待できます。
if(!cCritic.feedForward(Action, 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
//---
これで、1つの状態に対する学習サイクルが完了します。 学習は、実際の行動と参照行動という2つの経路に沿って同時に進みます。 このデュアルループ構造は、誤差の低減を加速するだけでなく、市場のノイズや局所的な変動の影響を受けにくい内部表現の形成にも役立ちます。
学習処理の全体を通じて、指定された頻度でターミナル上のレポートが更新されます。 画面には、すべてのモデルの平均誤差が表示されます。 開発者はこれらの情報を利用して、学習の進捗状況をリアルタイムで監視し、学習プロセスの安定性を評価するとともに、潜在的な障害や異常を検出できます。
    if(GetTickCount() - ticks > 500)
      {
       double percent = (epoch + 1.0 - double(posit - end) /
                        (start - end - HistoryBars - NForecast))
                        / Epochs * 100.0;
       string str = "";
       for(uint f = 0; f < caForecast.Size(); f++)
          str += StringFormat("%-12s%d %6.2f%% -> Error %15.8f\n", "Forecast", f,
                                 percent, caForecast[f].getRecentAverageError());
       str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                 cActor.getRecentAverageError());
       str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                cCritic.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
すべてのエポックの処理が完了すると、アルゴリズムは学習結果を集計し、各モデルの平均誤差を表示します。 その後、EAは終了します。
   Comment("");
//---
   for(uint f = 0; f < caForecast.Size(); f++)
      PrintFormat("%s -> %d -> %-15s%d %10.7f", __FUNCTION__, __LINE__, "Forecast", f,
                                               caForecast[f].getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor",
                                                      cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__,
                                            "Critic",cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
最終的に、Trainメソッドは、実際の行動の結果と、将来の価格変動から導出した理想的な参照行動の両方を利用して、取引戦略を学習させる方法を示しています。 このアーキテクチャは、過去データへの適応にとどまらず、潜在的な利益の獲得に向けて方策を導く仕組みを提供します。
このEAの完全なコードと、本記事の作成に使用したすべてのプログラムのコードは、添付ファイルに含まれています。
テスト
前述のとおり、モデルの学習プロセス全体は、2つの連続した段階に分けて実施しました。 第1段階では、2024年全体のEURUSD通貨ペアのH1時間足の過去データを用いて、オフライン学習をおこないました。 この期間には、長期にわたるレンジ相場から急激なトレンド相場まで、また、値動きの乏しい停滞期からボラティリティが爆発的に高まる局面まで、幅広い市場シナリオが含まれています。 このような多様性により、モデルは典型的な状況と非典型的な状況の両方を経験でき、信頼性と汎用性を確保するうえで重要な役割を果たしました。
学習の過程で、Encoderは市場情報に繰り返し現れるパターンを識別し、それらをコンパクトでありながら豊富な特徴を持つ表現へと圧縮する方法を学習しました。 この内部的な市場状態を基盤として、ActorはCriticからのフィードバックを活用し、さまざまな市場環境で効果的に機能する堅牢な戦略を形成しました。 さらに、オフライン学習の段階では、いわゆるほぼ理想的な軌跡もモデルに与えました。これは、将来の価格変動に関する知識に基づいて生成された参照行動です。 こうした手がかりは、方策をより高い利益へと導くだけでなく、戦略を構築するための信頼できる基準にもなりました。特に、モデル自身の経験がまだ限られている学習初期の段階で、大きな役割を果たしました。
オフライン学習を終えた後、第2段階として、実際の市場に近い条件下でオンライン微調整を実施しました。 学習にはMetaTrader 5のストラテジーテスターを使用し、モデルはストリーミングモードで、ステップごと、ローソク足ごとに市場を分析しました。 この方法により、ノイズ、市場の歪み、ランダムな変動に対するモデルの耐性を検証できただけでなく、モデルを適応させるための重要な手段にもなりました。つまり、モデルは単にデータを記憶するのではなく、現実の予測不可能な環境で実際に機能する方法を学習したのです。 このアプローチにより、モデルの頑健性が大幅に向上し、過学習が抑制され、汎化能力も改善されました。
最後の段階では、まったく新しいデータ、すなわち2025年1月から3月までの市場価格データを用いてモデルを検証しました。 学習時に使用したすべてのパラメータと内部設定は、一切変更せずに維持しました。 これにより、提案手法の精度だけでなく、実運用における信頼性についても客観的に評価できるようになりました。
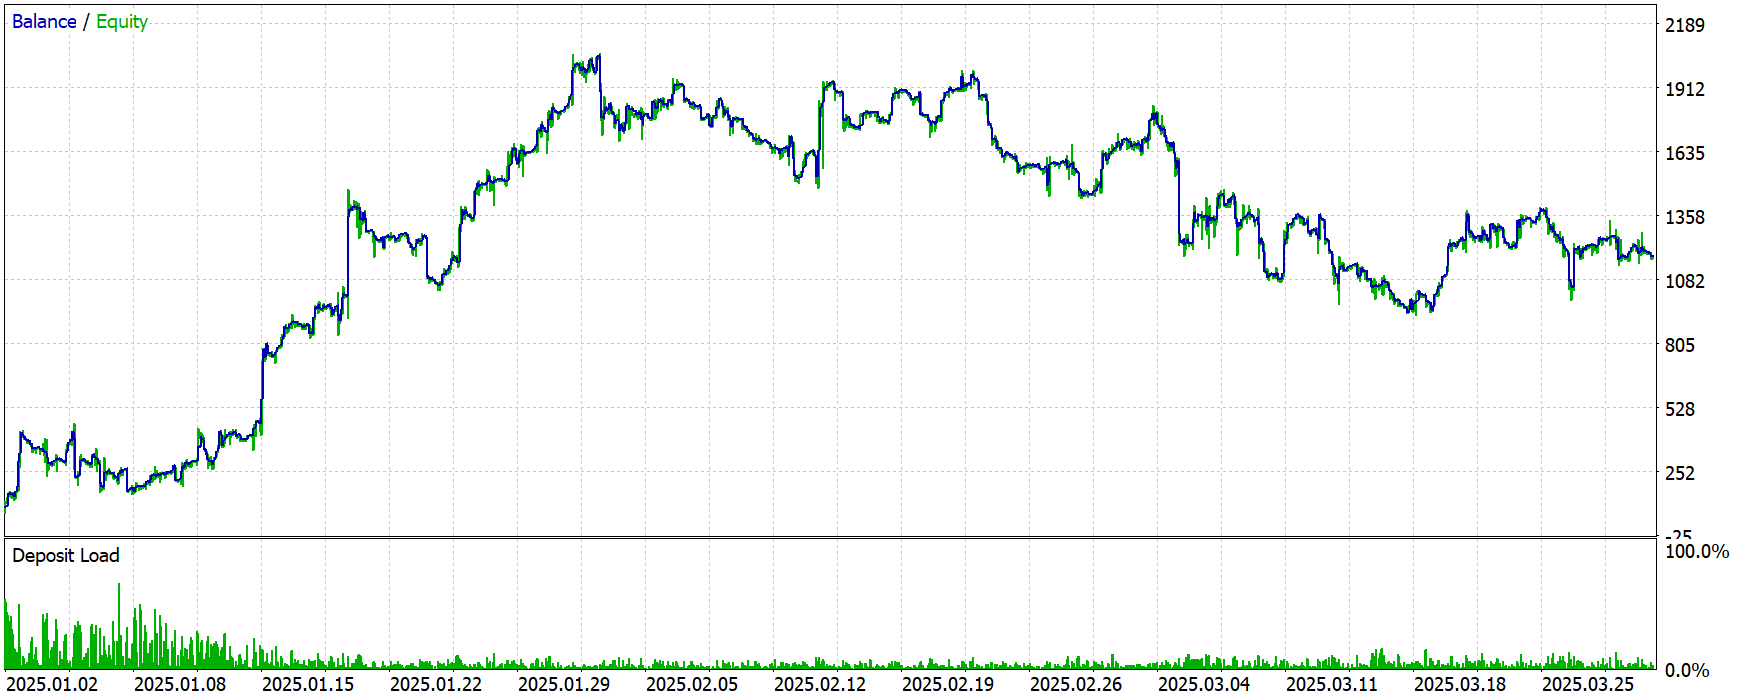
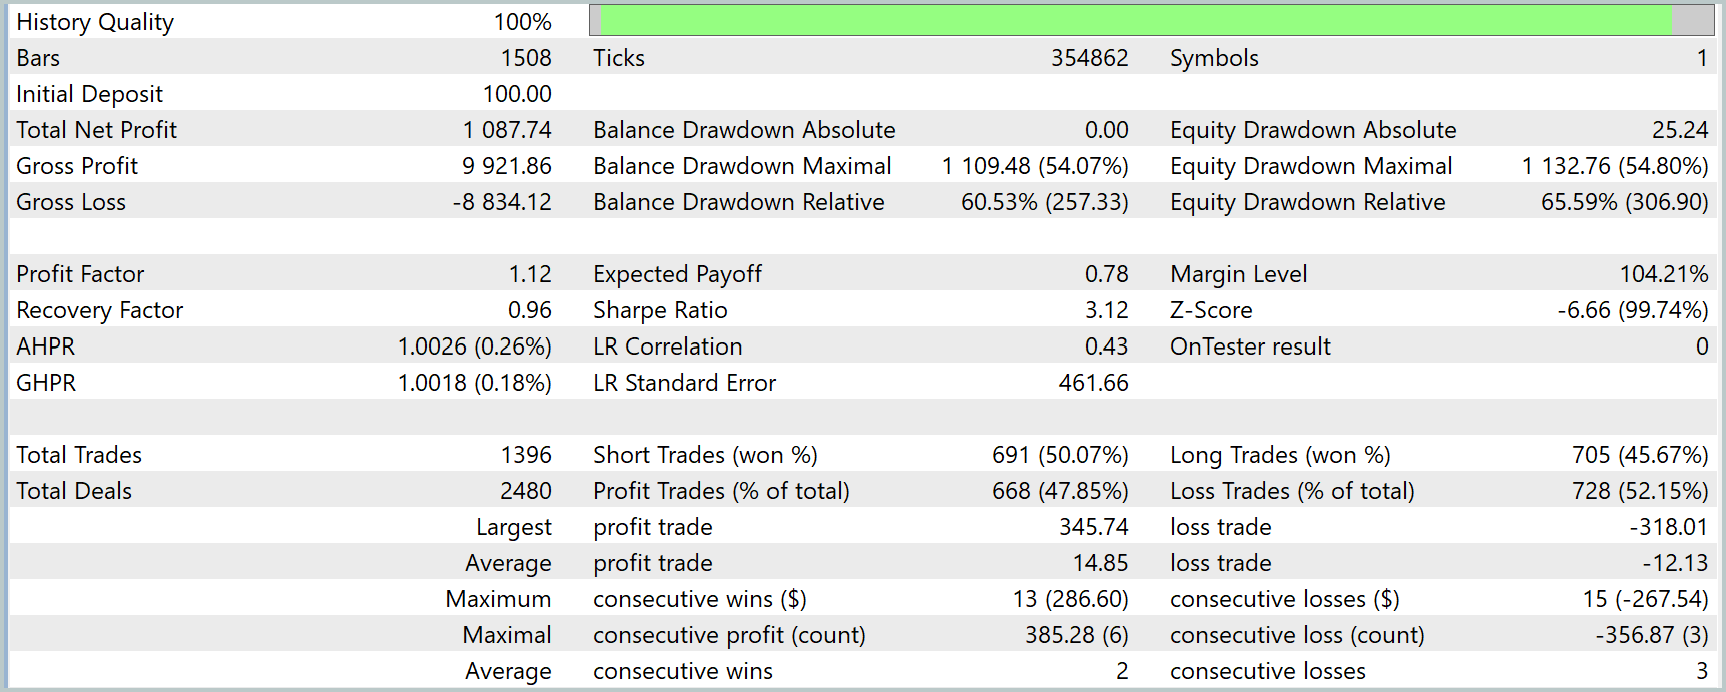
モデルのテスト結果からは、学習用サンプルに含まれていない期間における実際の有効性と頑健性を客観的に把握できます。 初期入金の100ドルは1,087.74ドルに増加し、資金は10倍以上になりました。一見すると、非常に印象的な結果です。 しかし、詳しく分析すると、特徴的な傾向が見えてきます。テスト期間の初期には非常に高いパフォーマンスを発揮するものの、学習用サンプルの期間から離れるにつれて、性能が低下し始めるのです。
残高曲線は、この傾向を明確に示しています。 テスト期間の最初の3分の1では急速な成長が見られ、ドローダウンを最小限に抑えながら安定した利益を上げ、参照軌跡に近い推移をたどっています。 しかし、2月中旬以降、特に3月に入ると、曲線は横ばいになり、さらには悪化の兆候も現れます。価格変動の影響が大きくなり、連敗が長引き、利益の増加ペースも目に見えて鈍化しています。
この傾向は、数値指標からも裏付けられます。 リカバリーファクターは0.96と1を下回っており、利益とドローダウンの大きさの比率が十分ではないことを示しています。 有効証拠金(エクイティ)ベースの相対ドローダウンは65.59%に達しており、かなり高いリスク水準です。特に、テスト開始時の絶対ドローダウンがほぼゼロだったことを考慮すると、この数値は注目に値します。 プロフィットファクターは1.12であり、安定した運用を目指す戦略としては、許容できる最低限の水準にとどまっています。 また、利益取引と損失取引のバランスもモデルに不利な状態で、利益取引の割合は48%未満です。
このような挙動は、学習用サンプルの規模が限られていることによって説明できます。 モデルは2024年のデータだけを使って学習しました。そのデータにはさまざまな市場局面が含まれていたものの、市場は常に変化し、変動し続けます。 学習済みの期間から離れるほど、モデルは未知の状況に遭遇する機会が増えます。 追加の学習をおこなわなければ、特に新しい市場環境やボラティリティの高い局面では、モデルの判断が実際の市場状況に適合しなくなる可能性があります。
この問題を解決する明確な方法の一つは、学習用サンプルを拡充することです。 たとえば、2020年や2015年など、過去のデータを追加すれば、モデルはより幅広い市場シナリオを学習できるようになります。 これにより、汎化性能の向上だけでなく、発生頻度は低いものの極めて重要な価格変動パターンへの理解も深まると考えられます。 もう一つの選択肢は、段階的なオンライン学習です。新しいデータが蓄積されるたびにモデルの重みを定期的に更新することで、モデルを常に最新の市場環境に適応させることができます。この方法なら、モデル全体を最初から再学習する必要もありません。
結論
本研究では、実際の市場環境におけるGinARフレームワークの実用性を実証しました。 モデルのアーキテクチャ構築から段階的な学習、最終的なテストに至るまで、一連のプロセスを通じて、提案手法の実現可能性が確認されました。
テスト期間の初期には高いパフォーマンスを示したものの、その後の推移からは、学習用サンプルの範囲が限られていることに起因するモデル固有の限界が明らかになりました。 これは、時系列データを扱ううえでの基本原則を浮き彫りにしています。すなわち、戦略の頑健性は、学習時の環境を超えて知識を汎化できる能力に直接左右されるということです。
今回得られた結果は、今後の研究と改良に向けた確かな基盤となります。 特に、今後の開発では、学習データの量を増やすことと、継続学習の仕組みを導入することが重要な方向性となります。 こうした取り組みにより、厳しい市場環境でも単に生き残るだけでなく、継続的に利益を生み出すことを目指す、真に適応的で高度な取引システムの構築が期待できます。
参考文献
- GinAR: An End-To-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18914
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:構造成分の分離(SCNN)
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(主要構成要素)
 取引におけるニューラルネットワーク:構造成分の分離(Encoder)
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(GinAR)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
続いて、NeuroNet.mqh モジュールでも同様の問題が発生しています
修正されたライブラリは、「トレーディングにおけるニューラルネットワーク:スケーリングの代わりに分解 — モジュールの構築」 という記事に掲載されています- MQL5に関する記事
記事「トレーディングにおけるニューラルネットワーク:スケーリングの代わりに分解 — モジュールの構築」 の修正済みライブラリ- MQL5に関する記事