初級から中級まで:キュー、リスト、ツリー(I)
 10
 0

はじめに
前回の「基礎から中級まで:バブルソート」では、ごく単純なソート機能の実装方法を紹介しました。 実行時間の点ではあまり効率的ではないかもしれませんが、多くの場合、このアプローチは、一連のデータを並べ替え、それによってデータの解釈やデータ内での簡単な検索を容易にすることを目的とする、幅広い状況に適しています。
前回の記事で説明した仕組みは、必ずしも単独で動作するとは限りません。 多くの場合、ソートや検索のシステムは、他の種類の仕組みと連動しています。 この記事では、こうしたメカニズムのうちの1つについて考察します。
確かに、まだ基本的なトピックに焦点を当てているとはいえ、ここで取り上げている内容は、人によってはより高度なものに感じられるかもしれません。 とはいえ、これらはすべて、プロのプログラマーなら誰もが知っておくべき基礎知識に関連するものです。
さて、良いスタートを切るために、新しい話題に移りましょう。 ここで紹介する内容を理解するのが難しい場合や、説明の中に本記事では解説していない話題が出てきた場合は、過去の記事を参照してください。 そこには、この記事を理解するために必要な情報がすべて掲載されています。
キュー、リスト、ツリー(I)
多くの初心者が不要だと考えておろそかにしてしまう学習内容がありますが、それは、実際には、しっかりと習得し、深く理解しておくべきものです。 初心者が軽視しがちなこの学習内容は、まさにデータを適切に分析し、構造化できるようにするためのものです。
ご注意ください。 アプリケーションが生成するすべてのデータを適切に分析する方法が分からなければ、エキスパートアドバイザー(EA)はもちろん、単純なインジケータでさえ、作り方を学んでも意味がありません。 さて、ここで少し立ち止まって、考えてみてください。 アプリケーションが受信するデータを分析・分類する方法を理解すれば、その動作を効率化でき、その結果、処理速度が向上します。
現在、機械学習や関連する話題に大きな注目が集まっています。 しかし、人工知能システムでさえ、単なる分類器や統計的データ分析システムに過ぎません。 どのような場合でも、これらのシステムは、人間の創造性や特定の主題を理解する能力を超えるような真の知能を備えているわけではありません。
つまり、多くの人が技術の頂点と見なす人工知能や機械学習は、驚くべきものに見えるかもしれませんが、結局のところ、優れたプログラマーなら誰もが習得すべきいくつかの基礎を応用できるアルゴリズムに過ぎないのです。 他の実装モデルではなく、この特定の実装モデルをどのように使うべきか、そして何よりも、なぜ使うべきなのかを理解することが、極めて重要になる場合があります。 この技術を習得するには、時間をかけて、地道な練習と経験を積むしかありません。 これらの記事の目的は、特定の実装モデルをいつ使用すべきかを説明することではなく、これらのモデルを紹介し、MQL5で活用してMetaTrader 5で成果を得る方法を示すことにあります。
つまり、ここで取り上げる内容は、そう呼んでよければ、ある種の論理的な順序に沿って説明していきます。 できるだけわかりやすく説明したいですし、初心者の中にはこの内容の重要性をまだ十分に理解できない方もいるかもしれませんので、まずは最もシンプルな実装であるキューから始めましょう。
原則として、キューは配列に似た性質を持つことがあります。 こうした類似点があるにもかかわらず、キューにはさまざまな形態があり、その中には互いに大きく異なるものもあります。 したがって、これらの形態は、具体的な状況や実装方法によって、まったく異なる目的に使われることがあります。 データ配列と非常に似ているからこそ、多くの初心者はしばしばキューを配列と混同してしまいますが、それも無理はありません。 ただし、キューは必ずしも配列とは限りません。その目的や処理方法が、配列そのものと大きく異なるからです。
キューには、非常に独特でありながら、同時に非常に興味深い特性があり、また、使用している言語が提供する機能によっては極めて風変わりな実装も可能であるため、まずはごく単純なものから始めましょう。 実のところ、クラスの概念や仕組みについては、まだ説明していません。 とはいえ、さまざまなデータ構造をそれほど苦労せずに実装できるだけの内容は、すでに説明してあります。 したがって、以下に示すコードを記述する(より正確には、実装する)ことができます。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> struct stFIFO
05. {
06.     private:
07. //+----------------+
08.         T   value[];
09. //+----------------+
10.     public:
11. //+----------------+
12.     T Restore(void)
13.     {
14.         T local = NULL;
15.
16.         if (value.Size() > 0)
17.         {
18.             local = value[0];
19.             ArrayRemove(value, 0, 1);
20.         };
21.         return local;
22.     };
23. //+----------------+
24.     void Stock(T arg)
25.     {
26.         T local[1];
27.         local[0] = arg;
28.         ArrayInsert(value, local, value.Size());
29.     }
30. //+----------------+
31. };
32. //+------------------------------------------------------------------+
33. void OnStart(void)
34. {
35.     stFIFO <char> fifo;
36.
37.     fifo.Stock(10);
38.     fifo.Stock(84);
39.     fifo.Stock(-6);
40.
41.     Print(fifo.Restore());
42.     Print(fifo.Restore());
43.     Print(fifo.Restore());
44.     Print(fifo.Restore());
45. }
46. //+------------------------------------------------------------------+
コード01
つまり、これは、プログラミングの世界で「キュー」「リスト」「ツリー」として知られるデータ構造について、より広く理解するための第一歩となります。 このコードの細部をいくつか、じっくりと見ていただきたいと思います。 なお、8行目では動的配列を宣言していますが、8行目の宣言を見ればわかるように、この配列には任意の型の値を格納することができます。
この配列は、これまで見てきたものと同じように捉えてはいけません。 その理由は、12行目の関数と24行目の手続きにあります。 これらの手続きや関数には、任意の名前を付けることができます。 本当に重要なのは、それらがどのように機能するかということです。 ですから、これからの説明を注意深く読んでください。 というのも、使用する関数や手続きによって、実装されるデータ構造はたちまち変わり得るからです。 これにより、キューの種類が変わることもあれば、キューの代わりにリストや木を実装するほどの根本的な変化が生じることもあります。
これは最も簡単な部分です。 12行目のRestore関数のコードを見ると、8行目で宣言した配列にデータがある場合は、後で呼び出し元に返すために、常にその配列の添字0のデータを取得していることがわかります。 ここで最も重要なのは、19行目が実際にどのような動作をするかということです。 その目的は、添字0の要素を削除することです。 「ちょっと待ってください。 よくわかりません。 常に添字0の内容を返すのなら、その位置の要素を削除すると、コードに何らかの不整合が生じてしまうのではないですか。 次の呼び出しでは、添字0にはデータが入っていないはずです。」
ところが、実際にはそうはならないのです。 先ほども述べたように、多くの初心者がこれらの概念を混同するのは、まさに、コードにざっと目を通すだけで、その裏側で何が起きているのかを理解していないからです。 でも、もうすぐすべてをよりよく理解できるようになると断言できます。 これからの説明を、注意深く読んでください。
これで、12行目の関数は常に配列の添字0の位置にある要素を返すことがわかりました。 では、24行目の手続きはどうでしょうか。 どのような働きをするのでしょうか。 この場合、この手続きは、渡されたデータを配列に格納します。 ただし、このデータは常に配列の末尾に格納されます。 「よくわかりません。 もう少し詳しく説明していただけますか。」
もちろんです。 配列の添字には、0から任意の値までの値を使えることは、すでにご存じでしょう。 24行目のStock手続きに最初の値が渡されると、その値は添字0の位置に格納されます。 ここまでは問題ありません。Restore関数を使うと、まさに添字0の位置にある内容を読み取るからです。 まさにこの点が、多くのプログラミング初心者が混乱してしまうところなのです。 次にStockに渡されるデータ項目は、添字1の位置に格納されます。 これは、添字0の位置にすでにデータが存在しているためです。 次の要素も、同じ理由で添字2の位置に格納されます。つまり、添字1の位置にはすでにデータが存在するからです。 といった具合です。
ただし、いずれの場合も、Restore関数が読み取るのは常に添字0の位置にある内容です。 しかし、ここからが説明の面白いところなのです。 Restore関数を使うと、残りの要素は添字が1つ小さくなる方向に移動します。 このようにして、処理キューを作成します。 実際にどう動作するかを確認するために、33行目から始まるOnStart手続き内のコマンドのリストを見てみましょう。 37行目から39行目までが実行されると、値を宣言した順序とまったく同じ順序でキューが作成されます。 逆に、41行目から44行目を実行すると、キューに挿入された内容が読み込まれます。 少し奇妙に思えるかもしれませんが、これで正しく動作します。 実行結果は次の図に示されています。
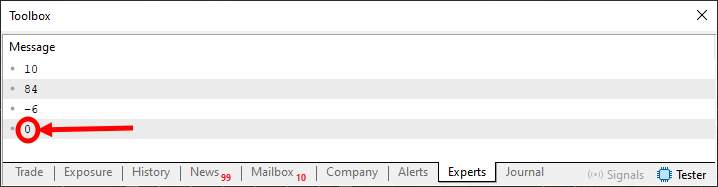
図01
図01では、別の要素が強調表示されている点にご注意ください。 キュー内に要素がもうないため、Restore関数はそれを返します。 これは、14行目で、08行目で宣言された配列にデータがない場合にどのような値が返されるかを定義しているためです。
Restore関数では常に添字0にアクセスしているにもかかわらず、キューに挿入されたデータを確認できることは明らかです。 この種のキューには、FIFOという特定の名称があります。これはFirst In, First Out(先入れ先出し)の略です。 これをよりよく理解するために、いくつかテストを実行してみてください。 たとえば、キューにいくつかの値を追加し、その一部を読み取ってから、さらに値を追加してみてください。 読み取りと書き込みの操作がどのように動作するのかを理解してみてください。
この種のキューは、データを特定の順序で分析する必要があり、その順序を絶対に崩してはならないさまざまな状況において、非常に役立ちます。 したがって、次の方法に進む前に、実際に試しながら、この最初のコード例の動作を理解しておくことをお勧めします。
このあと見ていく以下のコードでは、先ほど説明したものとは目的がまったく異なる、別の種類のキューを作成します。 しかし、次のコード例で何が起こるのかを理解しようとする前に、読者の皆様には、コード01で示された内容とその仕組みをしっかりと理解するために、少し時間を割いていただくことを強くお勧めします。 こうしておけば、次のコードで扱う内容について混乱せずに済みます。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> struct stQueue
05. {
06.     private:
07. //+----------------+
08.         T       value[];
09.         uint    c_Pos,
10.                 c_Max;
11. //+----------------+
12.     public:
13. //+----------------+
14.     void Init(uint arg)
15.     {
16.         ArrayResize(value, arg + 1);
17.         c_Pos = c_Max = 0;
18.     }
19. //+----------------+
20.     bool GetInfo(T &arg)
21.     {
22.         if (c_Pos == c_Max)
23.             return false;
24.         c_Pos = (c_Pos < value.Size() - 1 ? c_Pos + 1 : 0);
25.         arg = value[c_Pos];
26.
27.         return true;
28.     }
29. //+----------------+
30.     void Stock(const T arg)
31.     {
32.         c_Max = (c_Max < value.Size() - 1 ? c_Max + 1 : 0);
33.         c_Pos = (c_Pos == c_Max ? (c_Pos < value.Size() - 1 ? c_Pos + 1 : 0) : c_Pos);
34.         value[c_Max] = arg;
35.     }
36. //+----------------+
37. };
38. //+------------------------------------------------------------------+
39. void OnStart(void)
40. {
41.     stQueue <char> Queue;
42.
43.     Queue.Init(5);
44.
45.     Queue.Stock(10);
46.     Queue.Stock(84);
47.     Queue.Stock(-6);
48.     Queue.Stock(15);
49.     Queue.Stock(-35);
50.     Queue.Stock(40);
51.     Queue.Stock(-35);
52.
53.     for (char info; Queue.GetInfo(info);)
54.         Print(info);
55. }
56. //+------------------------------------------------------------------+
コード02
コード02では、プログラマーの間で「循環キュー」として知られる、別の種類のキューを実装します。 この種のキューはクラスを使うとより簡単に実装できますが、これまでの記事で説明した機能を使って実装することもできます。 これをクラスを使って実装すると、作成時にも、ここで紹介した実装を使用する際にも、すべてがはるかにシンプルになることがお分かりいただけるでしょう。 しかし、その話はまた別の機会にしましょう。 まずは、今手元にあるものに集中しましょう。
さて、ここからさらに注意深くお読みください。 もし「コード01」が少し分かりにくく複雑に感じられたなら、「コード02」ではさらに混乱するでしょう。というのも、ここでは多くの人にとってまったく正気の沙汰とは思えないようなことをおこなうからです。 とはいえ、実際には、多くの場面でこれが非常に役立つことがあります。 コード02の4行目で宣言されている構造体の一部は、コード01で実装したものと非常によく似ていることに注目してください。 非常によく似たコード片も含まれています。 ただし、ここで実装したバージョンは、コード01の実装とは大きく異なります。 それだけではありません。 この場合、コード02を使用すると、コード01とは異なり、一部のデータが失われる可能性があります。
「ちょっと待ってください。 そもそも、どうしてデータが失われてしまうことがあるのでしょうか。 「それではコードに問題が生じるのではありませんか。」実はそうではないのです。 こうした事態が予想される場合もあります。つまり、最終結果に影響を及ぼす心配をせずに、データを失ってもよい場合もあるということです。 これは、皆さんの多くにとっては少し奇妙に思えるかもしれません。 ですが、チャートで使用されている移動平均について見てみましょう。 移動平均は、ある意味で、最も古い値が破棄される値のキューとして機能します。 たとえば、20期間の移動平均では20個の値が保存されます。最初の値が最も新しいもので、新しい値がキューに追加されると、最後の値は直ちに破棄されます。
ここは重要なので、よく注意してください。 値の範囲が固定されており、それらが新しい値に置き換えられるため、この種の構造はリストではなくキューと呼ぶべきです。 値のリストには別の用途があります。一方、キューの用途は非常に単純で実用的です。 この2つの用語は、しばしば混同されます。 ただし、解釈上の混乱を避けるため、ここで示す構造を「キュー」と呼びます。 もっとも、一見すると単なる値のリストに見えるかもしれません。
さて、循環キューの場合、キュー内の値の範囲や数を制限する方法が必要になることに注意してください。 これは、14行目に記述されている手続きでおこないます。 ここでは、キューが格納する値の数を指定します。この数は、0より大きい任意の値にすることができます。 したがって、16行目では、08行目で作成された動的配列用に十分なメモリを割り当てています。 ただし、循環キューの初期化にあたっては、さらに2つの値も初期化する必要があります。 これは17行目でおこなわれます。 これでキューが作成され、データの受け取りや読み出しができる状態になりました。
この方法に初めて触れる人の多くが、大いに戸惑うのがこの点です。 キューから要素を読み取る必要があるため、20行目にその関数を実装しました。 この関数は、キュー内の任意の要素を1つ返します。 どの要素でしょうか。 それは状況次第です。 こう答えた理由を理解するには、22行目でチェックがおこなわれている点に注目してください。 現在の読み取り位置を示すc_Posの値が、現在の書き込み位置を示すc_Maxの値と等しい場合、返す要素は存在しません。 したがって、22行目のチェックは、場合によってはfalseを返すことがあります。
falseが返されなければ、読み取り可能な値が存在することを意味します。 この状況では、24行目でキュー内の新しい読み取り位置を計算します。 なぜこの計算が必要なのでしょうか。 c_Posカウンタの値をインクリメントしたほうが簡単ではないでしょうか。 読者の皆さん、実はそうではありません。 これは、循環キューを扱っているためです。キューのサイズがuint型で表せる値の全範囲よりも小さい場合、24行目のように、添字を先頭に戻す必要があります。 その結果、c_Posカウンタは、キューの上限に達すると、再び配列の添字01を指すようになります。 このようにして、循環キューが作成されます。 残りのコードは簡単です。
それでは、30行目の手続きに移りましょう。この手続きは、とても興味深く、同時に好奇心をそそる処理を担っています。 次の点に注目してください。32行目には24行目と非常によく似たロジックがあり、唯一の違いは、調整の対象となる変数が異なることです。 ただし、目的は同じです。16行目で確保した要素数の上限に達したら、配列の先頭に戻ることです。
「ちょっと待ってください。いよいよ話が複雑になってきました。 というのも、34行目では、渡した値の格納先の添字を指定するのに、同じ値c_Maxが使われていることに気づいたからです。 しかし、32行目では添字が定期的に0に戻るとおっしゃっています。 では、20個の要素を格納できるキューに21個(つまり、16行目で定義した上限より1個多く)格納すると、読み取れるのは1個の要素だけになってしまうのでしょうか。」いいえ。 保存済みの20個の要素を引き続き読み取ることができます。 ただし、キューに最初に格納した要素は、この新しい要素、つまり21番目の要素に置き換えられます。 「ずいぶんと回りくどい説明です。 どうすればそんなことができるのか、わかりません。」心配しないでください。すぐにすべてわかるようになります。 ただし、循環キュー全体でこのように読み取れる状態を維持するには、33行目の処理を実装する必要があります。 この行では、配列の要素を移動させることなく、キューを前進させることができます。
c_Maxがc_Posと等しくなった場合、キューが満杯であることを意味します。 そうでなければ、これらの値が等しくなることは決してありません。 キューはすでに満杯であるため、c_Posを強制的に次の位置に移動させます。 ただし、c_Posがキュー内の次の有効な位置を指すようにするため、2つ目の三項演算子を使用し、それによって循環キューの境界が守られるようにしています。 したがって、この2つ目の三項演算子は、24行目の演算子とまったく同じです。 皆さんの多くは初心者で、コード02を理解するのに少し苦労するかもしれませんので、添付ファイルに、そのコードを少し修正したバージョンを用意しました。 コードは以下の通りです。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> struct stQueue
05. {
06.     #define macro_AdjustLimit(A) (A < value.Size() - 1 ? A + 1 : 0)
07. //+----------------+
08.     private:
09. //+----------------+
10.         T       value[];
11.         uint    c_Pos,
12.                 c_Max;
13. //+----------------+
14.     public:
15. //+----------------+
16.     void Init(uint arg)
17.     {
18.         ArrayResize(value, arg + 1);
19.         c_Pos = c_Max = 0;
20.     }
21. //+----------------+
22.     bool GetInfo(T &arg)
23.     {
24.         if (c_Pos == c_Max)
25.             return false;
26.         c_Pos = macro_AdjustLimit(c_Pos);
27.         arg = value[c_Pos];
28.
29.         return true;
30.     }
31. //+----------------+
32.     void Stock(const T arg)
33.     {
34.         c_Max = macro_AdjustLimit(c_Max);
35.         c_Pos = (c_Pos == c_Max ? macro_AdjustLimit(c_Pos) : c_Pos);
36.         value[c_Max] = arg;
37.     }
38. //+----------------+
39.     #undef macro_AdjustLimit
40. //+----------------+
41. };
42. //+------------------------------------------------------------------+
43. void OnStart(void)
44. {
45.     stQueue <char> Queue;
46.
47.     Queue.Init(5);
48.
49.     Queue.Stock(10);
50.     Queue.Stock(84);
51.     Queue.Stock(-6);
52.     Queue.Stock(15);
53.     Queue.Stock(-35);
54.     Queue.Stock(40);
55.     Queue.Stock(-35);
56.
57.     for (char info; Queue.GetInfo(info);)
58.         Print(info);
59. }
60. //+------------------------------------------------------------------+
コード03
コード03は、コード02と同じ動作をします。 唯一の違いは、このコード03の06行目にあるマクロの定義にあります。 とはいえ、これにより、コード02の33行目が多少理解しやすくなります。 これは、コード03の35行目の方がはるかに読みやすいからです。 これはコード02の33行目と同じ内容ですが、こちらの方が読みやすいです。
しかし、ここでより注目したいのは、この構造体がどのように機能し、いわゆる循環キューをどのように作成・維持しているかという点です。 循環キューを作成するこの構造体をテストするために、OnStartの内容を使用します。
それでは、コード03に注目してみましょう。 こうすれば、指定された行を追いながら確認できます。 まず、キューそのものを定義します。 その定義は45行目に記載されています。 次に、キューに何個の要素を格納するかを決定します。 この場合、47行目に指定されています。 なお、この場合、要素の数は最大で5つとなることを指定します。
さて、ここからが最も興味深い部分、循環キューの活用です。 これには、49行目から55行目までを使用します。 ここで、キューに格納できる要素は最大5つであることに注意してください。 ところが、このキューに7つの要素を追加するよう指示します。 「ここでは何が起こるのでしょうか?」 「キューが進むにつれて、古い要素が上書きされます。」 どうすればそれを確認できるでしょうか。 それを確認するために使うのが57行目です。ここには、一見すると興味を引くループがあります。 ただし、for文を使って、非常に興味深い用途のループを作成する方法については、別の記事で詳しく説明しました。 これもその一例です。 ループ自体が、実行と終了に必要な条件を作り出していることに注意してください。 ここで注目したいのは、58行目の実行です。 この行により、どの要素が削除され、どの要素がキューに残っているかを確認できます。
コード03またはコード02を実行すると、次の図に示す結果が得られます。
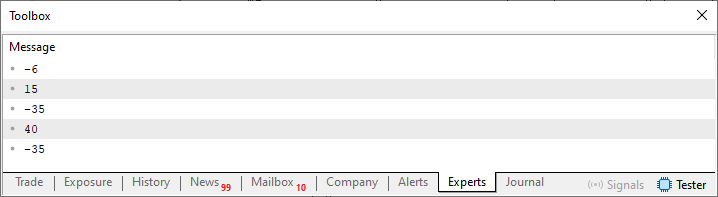
図02
読者の皆さん、これで以上です。 ここで少し立ち止まって、図02に示されている結果について考えてみてください。 そして、これをコード03の49行目から55行目までの内容と比較してみてください。 ここで何が起きているのか、わかりますか。 コード01で実装したFIFOキュー(先入れ先出し)と、 コード03で実装されているこの循環キューとの間に、 何か関連性を見出すことはできますか。 多分ですね。 関連が見えないかもしれませんが、この記事の冒頭で説明したことと、ここで見ていることにはつながりがあります。 要点はこうです。キューの先頭にある要素が、常に最初に取得されます。 同様に、キューの最後の要素は、最後に表示される要素となります。 これまでの方法とは異なり、ここではキューに格納できる要素の数を制限しています。 この制限は、コード03の47行目で定義されています。
ここで混乱が生じるのですが、これは多くの人が理解していない点です。 プログラミングを始めたばかりの頃は、何かを作成したり実装したりしようとして、多くの時間を無駄にしてしまいます。 しかし、実現しようとしていることは、すでにどこかで実装されている可能性が十分にあります。 ここで、次のことを考えてみましょう。期間Xの移動平均を分析するEAを作成していると仮定します。 「なぜX個を超える価格値を保存する必要があるのでしょうか。 それは意味がありません。」同様に、X個の価格値からなる配列を最新の状態に保つためだけに、価格データを変更しても意味がありません。 必要なのは、循環キューなどのデータ構造を作成するか、実装することだけです。 使用する添字カウンタがシフトの役割を果たしてくれるため、この実装では実際のシフト操作をほとんど行わずに、価格を常に最新の状態に保てます。 その結果、コードの実行速度が大幅に向上し、保守も容易になります。
最後に
この記事では、プログラミング初心者にあまり知られていないトピックの一つについて学び始めました。 プログラミングを学びたいと強く願いながらも、基本的な概念を理解しようとしない人は少なくありません。 私の考えでは、これらの概念を正しく理解することは、延々とコードを書くことよりもはるかに重要であり、必要不可欠です。 これは、特定の概念を正しく理解することで、より安全で、高速で、メンテナンスしやすいコードを書くことができるようになるからです。
読者の皆さん、焦らずにこの記事の内容を学び、学んだことを実践してみてください。 私が今、皆さんに伝えようとしているこれらの基本を理解するまでには、かなりの時間がかかりました。 私がこのテーマを学んでいた頃は、誰もあまり関心を払っていませんでした。 誰もが、私たちがどのように成果を上げたかには関係なく、結果だけを求めていました。 しかし、ここでは皆さんにその道筋を示しています。 皆さんは、その道をどう進んでいくかを学ぶ必要があります。 そうすることで、学習プロセスを可能な限りスムーズかつ一貫性のあるものにすることができます。 焦らずに取り組んでください。 この記事で学んだことをよく理解し、実践してみましょう。 次の記事では、キュー、リスト、および木についての解説を続けます。
| ファイル | 説明 |
|---|---|
| コード01 | 単純キュー |
| コード02 | 単純キュー |
MetaQuotes Ltdによりポルトガル語から翻訳されました。
元の記事: https://www.mql5.com/pt/articles/16491
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。