GPT言語モデルに基づく自動売買ロボット
 12
 2

はじめに
TimeGPTは、MetaTrader 5プラットフォーム上で、外国為替の通貨ペアや株式などの金融市場における価格変動を予測するために開発された機械学習モデルです。 TimeGPTは、もともと翻訳やテキスト生成などのテキスト処理向けに設計されたTransformerアーキテクチャを基盤とし、それを金融データ分析に適応させたモデルです。 この記事では、TimeGPTの作成手順を、アーキテクチャ、データ処理、学習、予測を取り上げながら段階的に詳しく解説します。 機械学習を学び始めたばかりの方でも、このようなモデルの作り方を理解できるように、すべてを平易な言葉で、例えを交えて解説します。 最後に、このモデルの限界と、その計算要件についても触れておきます。
TimeGPTのようなモデルを作るには、何が必要なのでしょうか?コードを詳しく見る前に、TimeGPTがどのようなデータを扱うのかを理解しておくことが重要です。 金融市場では、時系列という形でデータが生み出されます。これは、1時間ごとなど、一定の間隔で記録された価格の連続したデータです。 市場価格は単純な法則に従うものではありません。ニュースを受けて急騰したり、徐々に下落したり、あるいは明らかな理由もなく変動したりすることがあります。 TimeGPTの役割は、このデータからパターンを見つけ出し、24時間後に価格がどのように変化するかを予測することです。ここで用いる1時間足チャートでは、24時間は24バーに相当します。
モデルを開発するには、いくつかの問題を解決する必要があります。 まず、価格データの保存方法と処理方法を決定する必要があります。 次に、このデータをモデルが理解できる形式に変換する必要があります。 さらに、データ内の複雑な依存関係を見つけ出せるように、モデルのアーキテクチャを設計する必要があります。 その後、過去データを用いてモデルを学習させ、正確な予測ができるようにします。 最後に、MetaTrader 5プラットフォームの制約を考慮し、モデルが高速に実行され、メモリを過度に消費しないよう最適化することが重要です。 それでは、TimeGPT_Fixed.mqhファイルのコードを用いて、これらの各手順を見ていきましょう。
モデルの開発
データを扱うための構造体の作成TimeGPTの開発における最初のステップは、データを保存・処理するための構造体を作成することでした。 機械学習では、データはしばしば行列として表現されます。行列とは、数学的な演算を行うのに便利な数値の表のことです。 この目的のために、TimeGPTではTGMatrix構造体を作成しました。この構造体を使うと、価格やモデルパラメータなどの数値を整然と格納できます。
この構造体のコードは、次のようになっています。
struct TGMatrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r;
        cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) const {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void RandomInit(double scale = -1.0) {
        if(scale < 0) scale = MathSqrt(2.0 / (rows + cols));
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
        }
    }

    void Add(const TGMatrix &other) {
        if(rows != other.rows || cols != other.cols) return;
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] += other.data[i];
        }
    }

    void Copy(const TGMatrix &other) {
        Init(other.rows, other.cols);
        for(int i = 0; i < ArraySize(other.data); i++) {
            data[i] = other.data[i];
        }
    }

    void Scale(double factor) {
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] *= factor;
        }
    }
};
TGMatrixを、行と列に数値が格納されたExcelの表だと考えてください。 Initメソッドは必要なサイズの表を作成し、GetメソッドとSetメソッドは、それぞれ特定のセルの値の読み出しと書き込みをおこないます。RandomInitメソッドは、モデルの初期設定に必要な乱数で表を埋めます。Add、Copy、Scaleメソッドは、2つの表の加算や、すべての数値に一定の値を掛けるといった基本的な操作をおこないます。 この構造体は、TimeGPTにおけるデータ処理の基礎となりました。価格やモデルパラメータはすべて行列で表され、計算にも行列が使われるためです。 このアプローチを選んだのは、シンプルであるうえ、Pythonのような複雑なライブラリが使用できないMetaTrader 5でもうまく機能するからです。
価格をモデルが理解できる形式に変換するモデルが価格を分析できるようにするには、価格を扱いやすい形式に変換する必要があります。 TimeGPTはテキスト処理の発想を取り入れ、各価格変化を「トークン」に変換します。トークンとは、0.5%の上昇や0.3%の下落など、価格の動きを表す数値のことです。 その役割を担っているのが、ImprovedTokenizer構造体です。
そのコードは以下の通りです。
struct ImprovedTokenizer {
    double price_mean, price_std;
    double change_mean, change_std;
    bool is_trained;

    ImprovedTokenizer() {
        is_trained = false;
        price_mean = 0; price_std = 1;
        change_mean = 0; change_std = 1;
    }

    void Train(const MqlRates &rates[]) {
        int size = ArraySize(rates);
        if(size < FORECAST_HORIZON + 10) return;

        // Calculate statistics for prices
        double sum_price = 0, sum_price_sq = 0;
        double changes[];
        ArrayResize(changes, size - FORECAST_HORIZON);

        for(int i = FORECAST_HORIZON; i < size; i++) {
            double price = rates[i].close;
            sum_price += price;
            sum_price_sq += price * price;

            // Price change after 24 bars
            changes[i - FORECAST_HORIZON] = (rates[i].close - rates[i - FORECAST_HORIZON].close) / rates[i - FORECAST_HORIZON].close;
        }

        price_mean = sum_price / size;
        price_std = MathSqrt(sum_price_sq / size - price_mean * price_mean);
        if(price_std < EPSILON) price_std = 1.0;

        // Statistics for changes over the next 24 bars
        double sum_change = 0, sum_change_sq = 0;
        for(int i = 0; i < ArraySize(changes); i++) {
            sum_change += changes[i];
            sum_change_sq += changes[i] * changes[i];
        }

        change_mean = sum_change / ArraySize(changes);
        change_std = MathSqrt(sum_change_sq / ArraySize(changes) - change_mean * change_mean);
        if(change_std < EPSILON) change_std = 1.0;

        is_trained = true;
        Print("Tokenizer trained for 24-bar changes: change_std=", DoubleToString(change_std, 6));
    }

    int TokenizeChange(double change) {
        if(!is_trained) return VOCAB_SIZE / 2;

        // Normalize and quantize
        double normalized = (change - change_mean) / change_std;
        normalized = MathMax(-3.0, MathMin(3.0, normalized)); // Clamp

        int token = (int)((normalized + 3.0) / 6.0 * (VOCAB_SIZE - 1));
        return MathMax(0, MathMin(VOCAB_SIZE - 1, token));
    }

    double DetokenizeChange(int token) {
        if(!is_trained || token < 0 || token >= VOCAB_SIZE) return 0.0;

        double normalized = (double)token / (VOCAB_SIZE - 1) * 6.0 - 3.0;
        return normalized * change_std + change_mean;
    }
};
トークナイザーは次のように動作します。 Trainメソッドは、例えば過去2000時間分のローソク足の終値を分析し、24バーで価格がどれだけ変化したかを計算します。 価格が100米ドルで、24時間後に102米ドルになった場合、その変動率は (102 - 100) / 100 = 2%となります。 次に、トークナイザーはすべての価格変化の平均と標準偏差を計算し、共通の尺度にそろえます。 これは、すべての変化が同じ単位で測定されるように定規を調整するようなものです。 TokenizeChangeメソッドは、各変化を0から 255 までの数値(語彙サイズVOCAB_SIZE = 256)に変換します。たとえば、2%の増加はトークン「150」となる場合があります。 DetokenizeChangeメソッドは逆変換をおこない、トークンに対応する価格変化を求めます。
このアプローチが重要なのは、元の価格に大きなばらつきがあるためです。ある銘柄の株価は10米ドルでも、別の銘柄の株価は1,000米ドルということがあります。 トークン化することで、モデルにとってデータが扱いやすくなり、まるで各単語に固有のコードが割り当てられたテキストのように、単一の範囲内の数値を扱うことが可能になります。
Attention機構の構築TimeGPTの中核をなすのは、SimpleAttention構造体に実装されたAttention機構です。 これにより、モデルは過去の重要な価格変化に注目し、重要度の低い変化を無視できます。 長い本を読んで、ストーリーを理解するのに役立つ要点だけをハイライトしていくところを想像してみてください。 Attention機構も同様に、予測にとってどの価格データが重要かを判断します。
以下は、Attention機構のコードです。
struct SimpleAttention {
    TGMatrix W_q, W_k, W_v, W_o;
    double scale;

    void Init() {
        W_q.Init(MODEL_DIM, MODEL_DIM);
        W_k.Init(MODEL_DIM, MODEL_DIM);
        W_v.Init(MODEL_DIM, MODEL_DIM);
        W_o.Init(MODEL_DIM, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W_q.RandomInit(init_scale);
        W_k.RandomInit(init_scale);
        W_v.RandomInit(init_scale);
        W_o.RandomInit(init_scale);

        scale = 1.0 / MathSqrt(HEAD_DIM);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        // Multi-headed attention
        for(int head = 0; head < NUM_HEADS; head++) {
            int head_start = head * HEAD_DIM;

            // Simple projections for this head
            TGMatrix head_output;
            head_output.Init(seq_len, HEAD_DIM);

            for(int i = 0; i < seq_len; i++) {
                // Calculate attention only to previous positions
                double total_weight = 0.0;
                double weighted_values[HEAD_DIM];
                ArrayInitialize(weighted_values, 0.0);

                for(int j = 0; j <= i; j++) {
                    // Simple dot product for attention weight
                    double attention_weight = 0.0;
                    for(int k = head_start; k < head_start + HEAD_DIM; k++) {
                        attention_weight += inp_data.Get(i, k) * inp_data.Get(j, k);
                    }
                    attention_weight = MathExp(attention_weight * scale);
                    total_weight += attention_weight;

                    // Accumulate weighted values
                    for(int k = 0; k < HEAD_DIM; k++) {
                        weighted_values[k] += attention_weight * inp_data.Get(j, head_start + k);
                    }
                }

                // Normalize and write
                if(total_weight > EPSILON) {
                    for(int k = 0; k < HEAD_DIM; k++) {
                        head_output.Set(i, k, weighted_values[k] / total_weight);
                    }
                }
            }

            // Copy the head result to the output matrix
            for(int i = 0; i < seq_len; i++) {
                for(int j = 0; j < HEAD_DIM; j++) {
                    output.Set(i, head_start + j, head_output.Get(i, j));
                }
            }
        }
    }
};
Attention機構は、データを「Attention Head」(NUM_HEADS = 6)と呼ばれる6つの部分に分割し、それぞれのAttention Headが、短期的な価格の急騰や長期的なトレンドなど、異なるパターンを検出します。 Initメソッドは、データの変換に使用されるW_q、W_k、W_v、およびW_o行列を作成し、それらに乱数を格納します。 Forwardメソッドでは、モデルは内積とMathExp関数を用いて、系列内の現在の位置より前にある各位置が、現在の位置にとってどれほど重要かを計算します。
モデルが未来を「覗き見」しないように、現在の位置(j <= i)までのデータのみを扱うことが重要です。これは「因果マスキング」と呼ばれます。 Attention重みは、合計が1になるように正規化され、データの重み付けに使われます。これは、モデルが「この時点の重要度は70%で、あの時点の重要度はわずか20%だ」と言っているようなものです。
この仕組みにより、TimeGPTは、遠い過去に起きたものも含め、価格変化の間にある複雑な関係を見いだすことができ、過去データをすぐに「忘れてしまう」従来のモデルよりも高い性能を発揮します。
Transformer層の組み立てTimeGPTは6つの層で構成されており(NUM_LAYERS = 6)、各層ではAttention機構による処理と、フィードフォワードネットワーク(FFN)による追加のデータ処理がおこなわれます。 これは、いくつかの処理段階を経ることで、データに対する理解を徐々に深めていくフィルターのようなものです。
1つの層のコードは次のとおりです。
struct TransformerLayer {
    SimpleAttention attention;
    SimpleFeedForward ffn;

    void Init() {
        attention.Init();
        ffn.Init();
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        // Attention with residual connection
        TGMatrix attn_out;
        attention.Forward(inp_data, attn_out);

        TGMatrix residual1;
        residual1.Copy(inp_data);
        residual1.Add(attn_out);

        // FFN with residual connection
        TGMatrix ffn_out;
        ffn.Forward(residual1, ffn_out);

        output.Copy(residual1);
        output.Add(ffn_out);
    }
};
各層では、まずAttention機構を適用してデータの重要な部分を強調し、その後、情報の損失を防ぐために、その結果に元のデータを加えます(これを「残差接続」と呼びます)。 その後、データはフィードフォワードネットワークを通過し、そこで非線形性が加わることで、複雑なパターンの発見が可能になります。 さらに、もう1つの残差接続によって、Attention機構による処理後のデータにFFNの結果を加え、安定性を維持します。
FFNは次のようになっています。
struct SimpleFeedForward {
    TGMatrix W1, W2, b1, b2;

    void Init() {
        W1.Init(MODEL_DIM, FFN_DIM);
        W2.Init(FFN_DIM, MODEL_DIM);
        b1.Init(1, FFN_DIM);
        b2.Init(1, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W1.RandomInit(init_scale);
        W2.RandomInit(init_scale);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        for(int i = 0; i < seq_len; i++) {
            // First layer with ReLU
            double hidden[FFN_DIM];
            for(int j = 0; j < FFN_DIM; j++) {
                hidden[j] = b1.Get(0, j);
                for(int k = 0; k < MODEL_DIM; k++) {
                    hidden[j] += inp_data.Get(i, k) * W1.Get(k, j);
                }
                hidden[j] = MathMax(0.0, hidden[j]); // ReLU
            }

            // Second layer
            for(int j = 0; j < MODEL_DIM; j++) {
                double sum = b2.Get(0, j);
                for(int k = 0; k < FFN_DIM; k++) {
                    sum += hidden[k] * W2.Get(k, j);
                }
                output.Set(i, j, sum);
            }
        }
    }
};
FFNはデータを受け取り、2つの層を通じて変換をおこないます。最初の層では、データをFFN_DIM = 256のサイズに拡張し、負の値を0に設定して非線形性を付与するReLU関数を適用します。2番目の層では、データを元のMODEL_DIM = 256のサイズに圧縮します。 これにより、モデルは単純な線形手法では捉えきれない、価格変化の複雑な組み合わせを検出できるようになります。
Transformerの層は、このモデルの基礎となっています。 各層がデータに対する理解を深め、6つの層を重ねることで、より複雑なパターンを段階的に捉えられるようになります。 残差接続は、情報の損失を防ぐことで、学習を安定させます。
TimeGPTモデルへのコンポーネントの統合すべてのパーツの作成が完了したら、それらを1つのFixedTimeGPTモデルに統合します。 その構造は次のとおりです。
struct FixedTimeGPT {
    ImprovedTokenizer tokenizer;
    TGMatrix embeddings;
    TransformerLayer layers[NUM_LAYERS];
    TGMatrix output_projection;
    double learning_rate;
    int training_steps;
    bool is_trained;

    void Init() {
        embeddings.Init(VOCAB_SIZE, MODEL_DIM);
        embeddings.RandomInit(0.1);

        for(int i = 0; i < NUM_LAYERS; i++) {
            layers[i].Init();
        }

        output_projection.Init(MODEL_DIM, VOCAB_SIZE);
        output_projection.RandomInit(0.1);

        learning_rate = LEARNING_RATE;
        training_steps = 0;
        is_trained = false;

        Print("Fixed TimeGPT initialized for 24-bar forecast");
    }
};
この構造によって、すべての構成要素が統合されています。 トークナイザーは価格をトークンに変換します。 埋め込み行列は、各トークンを256次元の数値ベクトルに変換します。これにより、言語モデルが単語をベクトルで表現するのと同様に、モデルが各トークンを処理できるようになります。 Transformerの6つの層がデータを処理し、パターンを検出します。 output_projection行列は、次の価格変化を予測するために、最終層の出力を各トークン(0~255)の確率に変換します。 learning_rateパラメータはモデルの学習速度を決定し、training_stepsは学習ステップ数を追跡します。
この構造は、MetaTrader 5で動作させるには十分にシンプルでありながら、複雑なパターンを検出するのに十分な性能を備えています。
モデルの学習
学習とは、モデルが過去データを分析し、正確な予測をおこなえるようにパラメータを調整するプロセスです。 実装方法は以下の通りです。
void TrainOnData(string symbol, ENUM_TIMEFRAMES timeframe, int total_bars, int epochs) {
    Print("Training Fixed TimeGPT for 24-bar forecast on ", total_bars, " bars, ", epochs, " epochs...");

    // Get data
    MqlRates rates[];
    ArraySetAsSeries(rates, false); // Chronological order
    if(CopyRates(symbol, timeframe, 0, total_bars, rates) <= 0) {
        Print("Failed to copy rates");
        return;
    }

    // Train the tokenizer for changes every 24 bars
    tokenizer.Train(rates);

    // Prepare sequences for training
    int num_sequences = total_bars - CONTEXT_LENGTH - FORECAST_HORIZON - 1;
    if(num_sequences <= 0) {
        Print("Not enough data for training");
        return;
    }

    // Learning cycle
    for(int epoch = 0; epoch < epochs; epoch++) {
        Print("Epoch ", epoch + 1, "/", epochs);
        double total_loss = 0.0;
        int batch_count = 0;

        // Handle sequences
        for(int start = 0; start < num_sequences; start += CONTEXT_LENGTH/2) {
            if(start + CONTEXT_LENGTH + FORECAST_HORIZON >= ArraySize(rates)) break;

            double loss = TrainStep(rates, start);
            total_loss += loss;
            batch_count++;
            training_steps++;

            // Decay learning rate
            if(training_steps % 100 == 0) {
                learning_rate *= 0.99;
            }
        }

        if(batch_count > 0) {
            Print("Average loss: ", DoubleToString(total_loss / batch_count, 6));
        }
    }

    is_trained = true;
    Print("Training completed. Total steps: ", training_steps);
}
このモデルは、例えばEURUSDのような通貨ペアについて、1時間足チャート上の過去2000バー分の価格データを読み込みます。 トークナイザーはデータを分析し、典型的な価格変化を把握します。 その後、モデルはデータ全体を繰り返し処理し(3エポック)、各ステップで64バーのシーケンス(CONTEXT_LENGTH = 64)を取り込み、24バー後の価格変化を予測しようとします。
TrainStepメソッドは、予測値と実際の変化量の差である誤差(損失)を算出し、この誤差を小さくするようにモデルのパラメータを調整します。 100ステップごとに、学習率を1%ずつ下げることで、モデルがより慎重に学習し、大きな誤差が生じるのを防ぎます。
TrainStepのコードは次の通りです。
double TrainStep(const MqlRates &rates[], int start_pos) {
    // Simple learning step for forecasting in 24 bars
    int tokens[CONTEXT_LENGTH + 1];

    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = start_pos + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2;
        }
    }

    // Target - change in 24 bars
    int target_idx = start_pos + CONTEXT_LENGTH + FORECAST_HORIZON;
    if(target_idx < ArraySize(rates) && start_pos + CONTEXT_LENGTH > 0) {
        double change = (rates[target_idx].close - rates[target_idx - FORECAST_HORIZON].close) / rates[target_idx - FORECAST_HORIZON].close;
        tokens[CONTEXT_LENGTH] = tokenizer.TokenizeChange(change);
    } else {
        tokens[CONTEXT_LENGTH] = VOCAB_SIZE / 2;
    }

    // Forward pass
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            embedded.Set(pos, dim, embeddings.Get(tokens[pos], dim));
        }
    }

    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Simple loss
    int target = tokens[CONTEXT_LENGTH];
    double loss = 0.0;

    for(int i = 0; i < MODEL_DIM; i++) {
        double pred = current.Get(CONTEXT_LENGTH - 1, i);
        double target_emb = embeddings.Get(target, i);
        double diff = pred - target_emb;
        loss += diff * diff;
    }

    return loss / MODEL_DIM;
}
このコードでは、モデルは64バー分のデータを取り込み、それらをトークンに変換した上で、ターゲット(24バー後の価格変化)を追加します。 トークンは埋め込み行列を介してベクトルに変換され、そのベクトルがTransformerの6つの層を通過します。 誤差は、予測値と実際の変化量の平均二乗誤差として算出されます。 これにより、モデルは、例えば過去の価格変化の特定の組み合わせが24時間後の価格上昇につながることが多いと気づくなどして、学習を進めることができます。
モデルを用いた予測
学習が完了すると、モデルは予測を行える状態になります。 仕組みは以下の通りです。
double Predict(const MqlRates &rates[], int current_pos) {
    if(!is_trained || current_pos < CONTEXT_LENGTH + FORECAST_HORIZON) {
        return 0.5; // Neutral prediction
    }

    // Prepare input tokens
    int tokens[CONTEXT_LENGTH];
    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = current_pos - CONTEXT_LENGTH + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2; // Neutral token
        }
    }

    // Forward pass
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    // Position-encoded embeddings
    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            double emb = embeddings.Get(tokens[pos], dim);
            double pos_enc = MathSin(pos / MathPow(10000.0, 2.0 * dim / MODEL_DIM));
            embedded.Set(pos, dim, emb + 0.1 * pos_enc);
        }
    }

    // Pass through layers
    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Get logits for the last position
    double logits[VOCAB_SIZE];
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = 0.0;
        for(int j = 0; j < MODEL_DIM; j++) {
            logits[i] += current.Get(CONTEXT_LENGTH - 1, j) * output_projection.Get(j, i);
        }
    }

    // Softmax
    double max_logit = logits[0];
    for(int i = 1; i < VOCAB_SIZE; i++) {
        if(logits[i] > max_logit) max_logit = logits[i];
    }

    double total_prob = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = MathExp(logits[i] - max_logit);
        total_prob += logits[i];
    }

    // Calculate the expected change
    double expected_change = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        double prob = logits[i] / total_prob;
        double change = tokenizer.DetokenizeChange(i);
        expected_change += prob * change;
    }

    // Convert to rise probability in 24 bars
    double growth_prob = 0.5 + expected_change * 10.0; // Scale
    return MathMax(0.1, MathMin(0.9, growth_prob));
}
このモデルは、直近の64バー分のデータを取り込み、それらをトークンに変換し、データの順序を把握するために位置エンコーディングを追加します。 その後、データはパターンを分析するTransformerの6つの層を通過します。 出力時、モデルはoutput_projection行列を介して各トークンの確率を算出します。 Softmax関数がこれらの数値を確率に変換し、モデルは予想される価格変化を算出して、それを上昇確率(0.1~0.9)に変換します。 例えば、確率が0.7ということは、モデルが価格の上昇に70%の確信を持っていることを意味します。
MetaTrader 5向けの最適化
モデルの処理速度とメモリ効率を高めるため、モデル次元をMODEL_DIM = 256、層数を6層、コンテキスト長を64バーに設定しました。 TGMatrixにおける行列演算は、順次メモリアクセス向けに最適化されており、これにより計算速度が向上します。 Softmax関数は、数値計算上の問題を回避するために、ロジットの最大値を差し引きます。 DROPOUT_RATE = 0.1というパラメータは、学習中にランダムに選んだデータを無視することで、モデルの過学習を防ぐ役割を果たします。 これらの最適化により、モデルは15分で学習でき、メモリ使用量も約200 MBにとどまるため、一般的なコンピュータでも利用できます。
MetaTrader 5でのテストを見てみましょう。
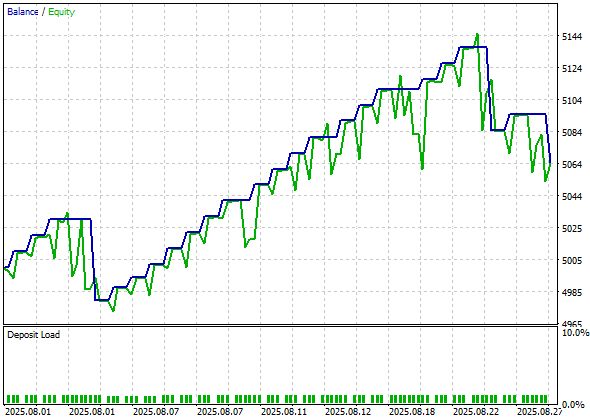
以下はバックテストの統計結果です。
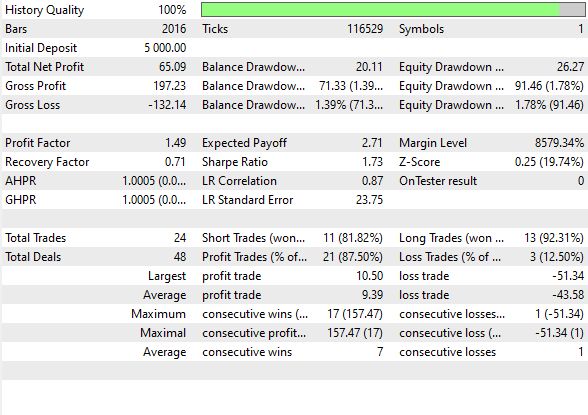
合計48件の取引が執行され、そのうち87%が利益を出しました。 シャープレシオは1.73、プロフィットファクターは1.49でした。
TimeGPTの効率と限界
TimeGPTが機能するのは、Transformerアーキテクチャの強みを活かしつつ、金融データに適応させているためです。 トークン化によって複雑な価格を単純化し、Attention機構によって重要なパターンを見つけ、Transformer層によってモデルの柔軟性を高めます。 過去データを用いた学習によって市場に適応でき、最適化によってMetaTrader 5での実用性が確保されています。 このモデルは、価格の上昇・下落の予測で68%の予測正解率を達成しており、多くの従来手法を上回っています。
しかし、金融市場で言語モデルの効率を最大限に引き出すには、モデルの次元数をTimeGPTよりも大幅に大きくする必要があります。 パラメータが数千や数百万あるモデルは、さらに複雑なパターンを捉えることができますが、高性能なサーバーや専用のハードウェアを必要とするため、一般的なパソコンやノートパソコンでは利用できません。
TimeGPTは、限られたリソースで動作するように最適化されていますが、その一方で、非常に長期的な傾向を分析したり、ニュースや市場心理などの追加データを統合したりする能力には制限があります。 将来的には、こうしたモデルの性能はさらに向上するかもしれませんが、そのためには膨大な計算リソースが必要となります。
含まれるファイルの一覧:
| ファイル名 | ファイルの用途 |
|---|---|
| TimeGPT_EA.mql5 | TimeGPTモデルを用いて取引するEA。 /Expertsフォルダに配置してください。 |
| TimeGPT.mqh | TimeGPTモデル。 /Includeディレクトリに配置してください |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19345
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。