

取引におけるニューラルネットワーク:Adaptive Graph Diffusionモデル(Attentionモジュール)
 6
 0

はじめに
前回の記事では、SAGDFNフレームワークについて紹介しました。 その動作の基本原理を解説し、強みを明らかにしました。 しかし、市場は建築模型の博物館ではありません。 ここでは、過度なためらいや生気のない構想は許されません。 建物がしっかりと立つには、各段の安定性を確かめながら、レンガを一つずつ積み上げていかなければなりません。
SAGDFNフレームワークは、金融市場で古くから存在し、今なお極めて切実な問題の一つであるデータの冗長性と真のシグナルを覆い隠すノイズへの対応策として、当初考案されました。 従来の分析手法は、この情報の洪水に飲み込まれるか、粗雑なフィルタリングでそれを排出しようとするものでした。しかし、SAGDFNは、別の道を示しています。それは、単にフィルタリングするのではなく、賢く選択することです。このフレームワークの著者たちは、システムの挙動に実際に影響を与える近傍だけを保持することを提案しました。 これは、古くから伝わる取引の格言に似ています。「市場の声に耳を傾けよ。しかし、群衆の叫びと、道を知る者たちのささやきとを見分ける術を身につけよ」というものです。
アーキテクチャ全体の中核となる概念は、重要な近傍を動的にサンプリングする仕組みである重要近傍サンプリング(Significant Neighbors Sampling)です。 毎分何百隻もの船が到着し、あらゆる海からの知らせを運んでくる古い港を想像してみてください。 そのすべてがあなたのビジネスにとって重要なわけではありません。海外市場の噂話ばかりを運ぶものもあれば、明日には価値がなくなってしまう貨物を運ぶものもあるからです。 SAGDFNの目標は、その帆で貿易を本当に正しい方向へと進める船だけを港に受け入れることです。 これを実現するため、このモデルでは、決定論的な重要度評価と制御されたランダム性を組み合わせています。これは一種の変革の風のようなもので、システムが既存の関連性に固着してしまうのを防ぎ、それによって過学習のリスクを低減します。
もう一つ、同様に重要な要素がα-Entmax機構です。これは、Attentionの配分を司る数学的な「指揮者」です。 穏やかでありながらすべてを包み込むSoftMaxとは異なり、この機構はすべての入力に力を分散させるのではなく、分布をスパース化し、本当に必要な箇所に強い重みを残します。 これは、昔からの商人の知恵にも通じるものです。つまり、些細なことに資本を散財するのではなく、最大の利益をもたらすものに投資すべきだということです。
SAGDFNは、局所的な文脈と大域的な文脈のバランスが取れている点でも際立っています。 経験豊富なアナリストのように、隣接するデータや個々のバー、局所的な取引の集まりを分析し、市場を間近で詳しく調べることができます。 そして同時に、トレンドや確立されたパターン、長期的な流れの構造といった大局的な視点も常に念頭に置いています。 その点で、星を頼りに船を導きながらも、竜骨の下の水深を忘れない航海士のような役割を果たします。
SAGDFNフレームワークのアーキテクチャはモジュール式で拡張性が高く、絶えず変化する取引環境において特に有用です。 ここには、研究者を閉じ込めるような石の壁などありません。 各ブロックは、近傍サンプリング、Attentionの正規化、外部データソースとの統合のいずれを担うものであっても、改良、最適化、あるいは置き換えが可能です。
著者らによるSAGDFNフレームワークの構成図を以下に示します。
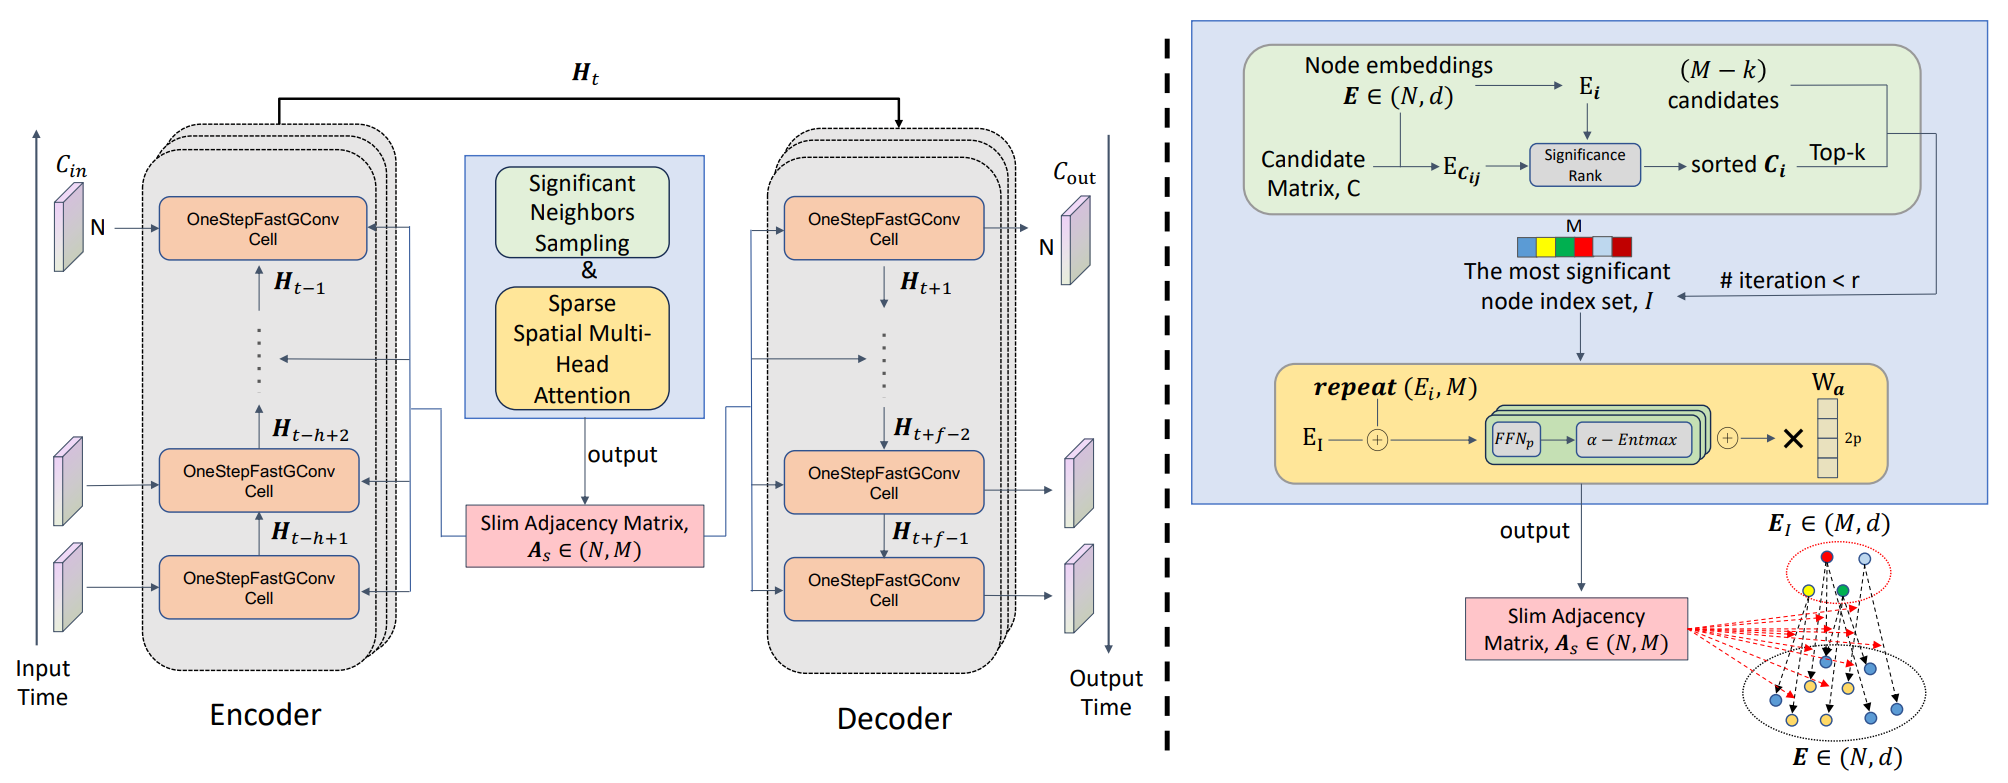
前回の記事の実践編では、すでに最初の大きな一歩として、重要近傍サンプリングアルゴリズムをOpenCLのコンテキスト内で実装し、全体構造の基礎を築きました。 膨大なデータセットの中から、真に重要な関連性だけを正確に抽出し、過度なノイズを伴わずに、それを後続の計算パイプラインに渡す方法を習得しました。 これは単なる技術的な実験ではなく、将来の取引メカニズムの開発における極めて重要な段階でした。適切に調整されたサンプリングメカニズムがなければ、信頼性の高い分析システムを構築することは不可能だからです。
本日は、引き続き作業を進め、SAGDFNフレームワークの著者らが提案したアプローチについて、私たち独自の構想をMQL5のツールで実装に取り込む次の段階へと進みます。
実装に関する検討
最も重要な接続を選択する仕組みであるSignificant Neighbors Samplingモジュールのアルゴリズムを無事に実装できたので、次の自然なステップは、データの準備から、より深い分析と変換へと進むことです。 本日はまず、すでに選択された近傍から構造的なパターンを抽出するための重要なツールとなる、Sparse Spatial Multi-Head Attentionモジュールのアルゴリズムの開発から始めます。
このモジュールは、一種の「スマートなふるい」として機能し、情報を処理するだけでなく、大域的な文脈を見失うことなく、真に重要な空間的つながりに集中するようモデルのAttentionを導くこともできます。 このモジュールはMulti-Head Attention機構を使用しますが、従来のアプローチとは異なり、フレームワークの著者らはこれをスパース形式で実装しています。 これにより、解析の品質を損なうことなく、計算負荷を大幅に軽減することが可能になります。 したがって、各データストリームは、一枚岩の重み行列ではなく、より効率的でありながら選択的な情報抽出に優れたAttentionネットワークを通過します。そこでは、各Attention Headが、それぞれ独自のフィルタリングと強調の役割を果たします。
実際の実装に着手する前に、フレームワークの著者らが提案したアルゴリズムをどのように実装していくかというビジョンを概説し、特に注意を払うべき重要なポイントを確認しておくことが重要です。 このフレームワークの開発者たちは、かなり直感的でわかりやすいアプローチを提案しています。 グラフを構築するために、著者らは各要素の埋め込みを、Significant Neighbors Samplingモジュールで事前に選択された、その要素に最も近い近傍の埋め込みとペアごとに連結します。 続いて、各ペアを小規模な全結合モデルに入力し、エッジの表現を生成します。
一見すると、この手法は明快で論理的であり、処理手順も単純明快に思えます。 しかし、このアプローチを実際の実装という観点から、特にエッジ密度の高い実際の取引データに適用する場合について検討すると、この見かけの単純さの裏には非常に大きなオーバーヘッドが潜んでいることが分かります。 各要素とその近傍要素の埋め込みをペアごとに連結すると、データ量が大幅に増加し、その結果、必要なメモリ容量が増えます。 各ペアは実質的に新しいベクトルを生成することになり、そのようなペアが多ければ多いほど、それらを保存し、さらに処理するために必要なリソースも増えます。
さらに、各ペアに対して全結合モデルを使用すると、各ペアを個別に処理する必要があるため、計算負荷が増大します。 その結果、実行時間が長くなり、大規模なグラフを扱う場合や、計算リソースが限られている状況では、システムの柔軟性が低下します。 したがって、この解決策は見た目には分かりやすいものの、効率的でスケーラブルなシステムを構築するうえでボトルネックとなる可能性があります。
元の構成を詳しく見ると、著者らが同じ小規模な全結合ネットワークを使って、すべてのペア [ei ‖ ej] を処理していることが分かります。ここで、eiはノードの埋め込み、ejはそのノードについて選択された近傍の1つの埋め込みです。 このネットワークのパラメータはすべてのペアに共通しています。つまり、これは異なるモデルの集合ではなく、同じ重みの集合が繰り返し再利用されているのです。 まさにこのパラメータの共通性こそが、高速化の足がかりとなります。
全結合層は、本質的には線形変換と非線形性を組み合わせたものです。 線形処理の段階では、入力ベクトルの各成分に対応する重みを掛け、その結果を合計します。 入力が連結ベクトル [ei ‖ ej] ∈ R2dで、第1層の重み行列がW ∈ Rh × 2dであれば、その積は2つの項の和に分解できます。
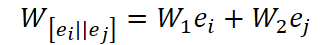
ここで、W1とW2 ∈ Rh × dは、それぞれWの左半分と右半分です。
この単純な代数的考察から、改善の方向性が見えてきます。すべての近傍に対してM回ずつ各eiを同じ層に通すのではなく、各ノードの射影pi = W1 eiを一度だけ計算し、別途、近傍の射影ki = W2 eiを計算する方が合理的です。 この場合、線形処理の段階では、任意のペア(i,j)に対する結果をpi + kjとして即座に求められます。 その後、同じ非線形処理と次の線形Attention Headが続きますが、連結されたベクトルに対して計算負荷の高い行列演算を繰り返す必要はありません。
実際には、初期埋め込みテンソルEに2つの重み行列をそれぞれあらかじめ掛け、2つの射影テンソルを得ることになります。 これらの演算はバッチごとに1回実行され、GPU上で非常に効率的にベクトル化されます。 その後は、各ノードと近傍のペアについて、対応する射影を足し合わせるだけで済みます。 利点は2つあります。各eiは、近傍の数にかかわらず、Query重みW1と1回だけ乗算されます。また、各ejも、他の数十のリストに含まれていたとしても、Key重みW2と1回だけ乗算されます。 計算の密な部分の処理量は、もはやMに比例しません。
漸近的計算量に注目すると、負荷の構成の変化が明らかになります。 単純な連結では、N × M回の、次元がh × 2dの行列とベクトルの乗算が必要となり、最初の線形処理段階の計算量はO(NMhd)となります。 リファクタリング後の処理では、EW1とEW2の2つの乗算を、それぞれO(Nhd)で実行します。その後に必要なのは、N × M回のh次元ベクトルの加算と、軽量なAttention Headの処理だけです。つまり、この部分の計算量はO(NMh)となり、計算コストを増大させる因子dがなくなります。 dが大きく、Mがそれほど小さくない場合、その違いはプロファイラの出力からすぐに確認できます。 メモリの面でも同様です。N × M個の長さ2dの連結済みベクトルを格納する代わりに、それぞれサイズがN × hの2つの行列プールPとKを保持し、必要なペアの和をその都度計算します。 メモリへの負荷が軽減され、ALUのスループットがより効率的に活用されます。
この論理は、MQL5 + OpenCL での実装にも見事に当てはまります。 射影の計算には、フィルタ数が2hの標準的な畳み込み層を使用できます。この層は、現在の近傍集合にかかわらず、1回の伝播につき1回実行されます。 これは重要な点です。リストIは反復ごとに変わり得ますが、射影の再計算は引き続き安定しており、計算コストも低く抑えられるためです。 次に、各ペア(i,j)について、行PiとKjを読み込み、要素ごとに加算して、Attention Headを適用します。 従来の連結テンソルに対する行列乗算に代わり、残るのは単純なベクトル加算と小さな線形層1つだけです。これらの演算は、幅広いベクトル化に最適です。 これにSparse Attentionの正規化を適用しても、得られたロジットに直接作用するため、事前の射影処理の仕組みを一切変更する必要はありません。
また、解釈可能性の面でも嬉しいメリットがあります。 行列W1はQuery射影として機能するようになり、W2はKeyとして機能します。 それらの行と活性化値から、特定のAttention Headにおいて、どの埋め込み成分がAttentionの形成により強く寄与しているかが分かります。 リスク管理において、これは細かな点ではありますが、なぜモデルが今、債券ではなく原油に注目しているのか、あるいはなぜある通貨ペアが突然、ハイテク株にとって最も影響力の大きい近傍となったのかを説明する助けになります。
特に注目すべきもう一つの重要な点は、α-Entmax関数の使用に関するものです。 この関数の主な特徴は、重要度の低い要素を除外する度合いを調整しながら、入力データを滑らかに正規化できる点です。 α==1の場合、この関数は標準的なSoftMaxと同等であり、α==2の場合はSparse-SoftMaxに近づき、重要度の低い値をより積極的にゼロにします。 しかし、このアイデアは魅力的であるものの、α-Entmaxアルゴリズムではパラメータτの反復探索が必要となり、計算量と処理時間が必然的に増加する点に注意が必要です。 今回の実装では、効率性を優先し、この関数をSparse-SoftMaxに置き換えました。 このアプローチは、分析対象から重要でない要素を除外するというフレームワークの設計理念を維持しつつ、計算段階におけるパフォーマンスの向上とリソース消費の削減を実現します。
次のステップでは、この仕組みを既存のパイプラインに慎重に組み込んでいきます。 線形代数がすでに難しい作業を済ませてくれています。あとは、時間とメモリの両面で計算を適切に配分し、Multi-Head Attentionという光学系が、不要なノイズを伴わずに素早く正確に焦点を合わせられるようにするだけです。
OpenCLプログラムの拡張
Sparse Spatial Multi-Head Attentionモジュールのアーキテクチャ上の原則について解説したところで、次は、この概念を実際に適用してみましょう。 前のステップでは、入力テンソルにパラメータ行列を1回乗算することで、リソースを節約できるだけでなく、最も重要な近傍の選択を含め、アルゴリズムのすべての重要な特性を維持できることを強調しました。 OpenCLでは、これは特別な意味を持ちます。あらゆる演算とローカルメモリの使用が、高いパフォーマンスを発揮できるよう最適化されているからです。
まず、SparseMHScores順伝播カーネルから始めます。これは、中心要素とその最も重要な近傍との間の重み係数を計算する役割を担います。 カーネルは、各要素の処理ができる限り並列におこなわれるように設計されています。 同時に、重みのスパース性に対する制御も維持されます。
__kernel void SparseMHScores(__global const float* data,
                             __global const float* indexes,
                             __global float* scores,
                             const float sparse              ///< [0.0 .. 1.0) sparsity coefficient
                            )
  {
   const int main = (int)get_global_id(0);
   const int slave = (int)get_local_id(1);
   const int head = (int)get_global_id(2);
   const int total_mains = (int)get_global_size(0);
   const int total_slaves = (int)get_local_size(1);
   const int total_heads = (int)get_global_size(2);
まず、各グローバルスレッドは、自身の中心要素のインデックスmainと、近傍のローカル識別子slaveを取得します。 同時に、現在のAttention Headheadも決定されます。これにより、すべてのヘッドを同時に処理し、多次元のAttentionマップを作成できます。 次に、Tempという名前のローカル配列が作成されます。これは、ブロック内の最大値と最小値を求める際に、中間計算結果を一時的に格納するために使用されます。
__local float Temp[LOCAL_ARRAY_SIZE];
次に、data配列から中心要素とその近傍のロジット値を取得します。 IsNaNOrInf関数は、その後の演算が正しく実行されることを保証します。 値が無効(NaNまたはInf)の場合は、0に置き換えられます。
   float value = IsNaNOrInf(data[RCtoFlat(main, head, total_mains, 2 * total_heads, 0)], 0);
   int slave_id = (int)indexes[RCtoFlat(main, slave, total_mains, total_slaves, 0)];
   if(slave_id < total_mains && slave_id >= 0)
      value += IsNaNOrInf(
                  data[RCtoFlat(slave_id, head + total_heads, total_mains, 2 * total_heads, 0)],
                  0);
まず、indexesバッファから正確な近傍インデックスを取得する点に注意してください。 ここでは、取得したインデックスの有効性の確認に特に注意を払います。 近傍が範囲外にあるか、負のインデックスを持つ場合、その近傍は計算から除外されます。 これにより、計算の正確性が確保され、誤った合計が防がれます。
次に、重要なSparse-Softmax演算を実装します。 まず、LocalMax関数とLocalMin関数を使用して局所最大値と局所最小値を計算し、これにより閾値を決定します。 この閾値は、重要度の低い要素のフィルタリングを制御します。閾値未満の値はゼロに設定され、重要度の高い要素には指数関数が適用され、その後、ブロック内の全要素の合計で正規化されます。
   const float max_value = LocalMax(value, 1, Temp);
   const float min_value = LocalMin(value, 1, Temp);
   const float threshold = (max_value - min_value) * sparse + min_value;
   value = (threshold <= value ? IsNaNOrInf(exp(value - max_value), 0) : 0);
   const float sum = LocalSum(value, 1, Temp);
   value = IsNaNOrInf(value / sum, 0);
//---
   scores[RCtoFlat(slave, head, total_slaves, total_heads, main)] = value;
  }
その結果、現在の要素に対する各近傍の重要度を反映した、スパースでありながら情報量の多い重みベクトルが得られます。 計算された重みは、出力配列scoresに書き込まれます。 RCtoFlat関数は、多次元インデックスを1次元の位置に変換します。 このアプローチにより、結果の一貫した保存が保証され、次のグラフ畳み込み段階において、それらの結果を情報の集約に直接活用できるようになります。
以上をまとめると、このカーネルは、コンパクトかつ高性能な並列Attention処理を実現し、各要素とその重要な近傍との間で重みが正確に配分されるようにします。 このカーネルは、著者らが提案したSAGDFNアプローチのロジックをすべて維持しつつ、計算を効率的かつスケーラブルにし、大規模な時系列データの実用的な処理に適したものにしています。
順伝播を詳細に検討し、各Attention Headおよび各要素に対してSparse Attention重みがどのように形成されるかを理解したところで、次の自然なステップは逆伝播を実装することです。
逆伝播は、モデルの学習中に勾配を正しく計算するために必要です。 これは、出力で得られた誤差を、Attention重みの計算に関与する埋め込みやパラメータへと正確に逆向きに伝播させる役割を担っています。 OpenCLでは、これは、順伝播の構造を踏襲しつつ、勾配を正しく累積し、重みのスパースな構造を考慮することに重点を置いた別のカーネルを作成することを意味します。
ただし、ここで強調しておくべき重要な点がいくつかあります。 何よりもまず、Queryのロジットは、すべてのAttention係数の計算に同時に関与しています。 つまり、逆伝播では、関連するすべての情報フローからの誤差勾配を累積し、誤差信号がネットワーク全体に正しく伝播されるようにする必要があります。
第二に、近傍要素については一種の疎行列を扱うため、逆伝播アルゴリズムの設計には一定の制約が生じ、特有の考慮事項が伴います。 この構造では、どの要素が実際に計算に関与しているかを慎重に検討する必要があります。そうすることで、勾配がアクティブな接続に沿ってのみ伝播し、空の要素や重要性の低い要素にリソースを浪費することなく済みます。
そしてもちろん、SoftMax関数の特性も忘れてはなりません。つまり、1つの要素を変更すると自動的にベクトル全体に影響が及び、係数間に相互依存関係が生じます。 今回の場合、選択された近傍に含まれない要素に対しては、重みをゼロに設定します。 同時に、誤差勾配はAttentionベクトル全体にわたって慎重に伝播されるため、実際にアクティブな接続に関与しなかった要素についてもパラメータが正しく更新され、逆伝播処理の整合性と安定性が保たれます。
逆伝播カーネルの仕組みをより体系的かつ深く理解するために、まずSparse Spatial Multi-Head Attentionモジュールのロジックを振り返りましょう。 順伝播では、事前に計算したインデックスとノードの射影を用いて、選択された近傍に対するSparse Attentionスコアを生成しました。 これらの値はグラフのノード間で情報を分配する上で重要な役割を果たすため、モデルを安定して学習させるには、逆方向に誤差を正しく伝播させることが極めて重要です。
SparseMHScoresGradカーネルは、スパース性とSoftMaxの特性を考慮しつつ、誤差勾配を入力テンソルの各要素に慎重に分配する役割を担っています。 特に、1つのロジットの変化がAttentionベクトルのすべての要素に影響するため、最終的な集合に含まれなかった近傍にも適切な勾配を与える必要があります。 これにより、正しい計算構造を維持し、誤差分布のバランスを崩すことを回避することが可能となります。
__kernel void SparseMHScoresGrad(__global float* data_gr,
                                 __global const float* indexes,
                                 __global const float* scores,
                                 __global const float* scores_gr
                                )
  {
   const int main = (int)get_global_id(0);
   const int slave = (int)get_local_id(1);
   const int head = (int)get_global_id(2);
   const int total_mains = (int)get_global_size(0);
   const int total_slaves = (int)get_local_size(1);
   const int total_heads = (int)get_global_size(2);
カーネルの各スレッドには、次の3つの主要なインデックスが割り当てられます。
- main:勾配の計算対象となるノード
- slave:近傍のローカルインデックス
- head:Attention Head
ローカルメモリ内のTempバッファは、ローカルなスレッドブロック内で勾配の中間値を一時的に格納するために使用され、BarrierLocによる同期により、並列処理中のデータの一貫性が確保されます。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total_slaves, (uint)LOCAL_ARRAY_SIZE);
最初の計算ブロックでは、解析対象のノードに対する勾配を計算します。 まず、現在の近傍のAttention係数と、そのインデックスであるslave_idを取得します。
//--- Calculate gradient by main
     {
      float value = IsNaNOrInf(scores[RCtoFlat(slave, head, total_slaves, total_heads, main)], 0);
      int slave_id = (int)indexes[RCtoFlat(main, slave, total_mains, total_slaves, 0)];
      const float sc_gr = IsNaNOrInf(
                            scores_gr[RCtoFlat(slave, head, total_slaves, total_heads, main)], 0);
勾配gradは、実際の重みと期待値の差に、現在の位置におけるAttention係数の誤差勾配sc_grを乗じたものとして計算されます。
      float grad = 0;
      for(uint d = 0; d < total_slaves; d += ls)
        {
         if(slave >= d && slave < (d + ls))
            Temp[slave - d] = IsNaNOrInf(sc_gr, 0);
         BarrierLoc;
         for(uint l = 0; l < min(ls, (uint)(total - d)); l++)
            grad += IsNaNOrInf(Temp[l] * ((float)((d + l) == slave && slave_id == main) - value), 0);
         BarrierLoc;
        }
Tempによるローカル集約をおこない、続いてLocalSumによる総和計算をおこなうことで、効率的な並列総和計算が可能となり、大規模なデータセットを扱う際のレイテンシを最小限に抑えることができます。
      grad = LocalSum(grad, 1, Temp);
      if(slave == 0)
         data_gr[RCtoFlat(main, head, total_mains, 2 * total_heads, 0)] = grad;
     }
結果は 1 つのスレッドのみによってグローバルバッファに書き込まれるため、競合状態を防ぐことができます。
2番目のブロックは、近傍に関する勾配の計算を担当します。 ここで重要なのは、理論上、すべての近傍が、各ノードに対応するAttention係数の算出に関与するという点です(その係数がゼロの場合も含みます)。 したがって、mainの値を解析対象の近傍のインデックスとして扱い、すべてのノードを順に処理します。
//--- Calculate gradient by slave
     {
      float grad = 0;
      for(uint d = 0; d < total_mains; d++)
        {
         float value = IsNaNOrInf(scores[RCtoFlat(slave, head, total_slaves, total_heads, d)], 0);
         const float sc_gr = IsNaNOrInf(
                               scores_gr[RCtoFlat(slave, head, total_slaves, total_heads, d)], 0);
         int slave_id = (int)indexes[RCtoFlat(d, slave, total_mains, total_slaves, 0)];
各スレッドは、現在のインデックスが近傍ノードに対応しているかどうかを確認し、そのノードの寄与分を勾配全体に慎重に加算します。 ローカルバリアとTempを介した集約により、すべてのスレッドが協調してこのプロセスに参加することが保証されます。
         float gr = IsNaNOrInf(sc_gr * ((float)(slave_id == d) - value), 0);
         gr = LocalSum(gr, 1, Temp);
         if(slave == 0)
            grad += gr;
        }
      if(slave == 0)
         data_gr[RCtoFlat(main, head + total_heads, total_mains, 2 * total_heads, 0)] =
                                                                             IsNaNOrInf(grad, 0);
     }
  }
結果は、モデルパラメータのその後の更新に備えて、グローバルバッファdata_grに格納されます。 このアプローチにより、多くの要素の重みがゼロであるSparse Attention構造の場合でも、計算の整合性を損なうことなく、誤差を正しく伝播させることができます。
また、この実装ではGPUの並列処理能力を最大限に活用している点にも留意する必要があります。 各スレッドはデータの独立した部分集合に対して処理を行い、ローカルメモリとバリアによって競合を最小限に抑え、一貫性を確保します。 これは、数千ものノードを持つ大規模なグラフでモデルを学習させる場合に特に重要であり、そのような場合、従来の逐次的な勾配計算では処理速度が遅すぎ、リソースを過度に消費してしまうからです。
全体として、SparseMHScoresGradカーネルは、スパースなMulti-Head Attentionの逆伝播を効率的に実装する方法を示しており、精度、スパース性の維持、そして高い計算効率を兼ね備えています。
これで、OpenCLプログラム側の実装フェーズを締めくくることができます。 Multi-Head Sparse Attention機構の構築プロセス全体、すなわち重みの計算を伴う順伝播から、逆伝播における勾配の正確な分配に至るまでが、完全に並列処理環境へ移行されました。 ノードとその近傍間の正確かつ効率的な相互作用を確保し、メモリと計算リソースを節約するためにスパースな構造を維持するとともに、その後のモデル学習に向けた勾配の正確性を保証しました。 これで、このアルゴリズムをMQL5プログラムの他の部分と統合する準備が整いました。
Multi-Head Attentionオブジェクト
この段階では、これまでに開発したすべてのコンポーネントを、メインプログラム内の単一の構造に統合していきます。 このために、CNeuronSNSMHAttentionクラスを作成します。このクラスは、CNeuronConvOCLから畳み込み層の基本機能を継承し、Significant Neighbors SamplingとSparse Spatial Multi-Head Attentionという2つの主要なモジュールを組み合わせています。 このクラスは、重要な近傍の選択、射影の生成、Attention重みの計算といった処理を統合する、いわば計算の中核としての役割を果たしており、アーキテクチャ全体の動作において高い一貫性と整合性を確保しています。
class CNeuronSNSMHAttention   :  public CNeuronConvOCL
  {
   float             fSparse;
   //---
   CNeuronBaseOCL    cNeighbors;
   CNeuronBaseOCL    cRamdomCandidates;
   CNeuronConvOCL    cProjection[2];
   CNeuronBaseOCL    cScores;

   //---
   virtual bool      SignificantNeighborsSampling(CNeuronBaseOCL *NeuronOCL);
   virtual bool      SparseMHScores(void);
   virtual bool      SparseMHScoresGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSNSMHAttention(void) {};
                    ~CNeuronSNSMHAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint heads,
                          uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSNSMHAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
  };
このクラスにはいくつかの内部オブジェクトが含まれており、それぞれが特定の役割を果たしています。
- cNeighborsとcRamdomCandidatesは、近傍候補の処理を担当します。 前者は最も重要な近傍を扱い、後者はランダムな近傍を扱います。これにより、サンプルの多様性が維持され、モデルが狭い範囲のデータパターンに局所的に固着してしまうのを防ぐことができます。
- cProjectionオブジェクトは、初期埋め込みをQuery空間およびKey空間に射影し、これがその後のMulti-Head Attention計算の基礎となります。
- cScoresは、計算されたAttention係数を蓄積し、それらをグラフ畳み込みの段階で使用される疎な影響行列に変換します。
- fSparseパラメータは、Attentionのスパース性係数を設定するもので、特に大規模な時系列データを扱う際に、予測精度と計算負荷のバランスを調整することができます。
この段階では、CNeuronSNSMHAttentionクラスのすべての内部オブジェクトがstaticとして宣言されている点に留意することが重要です。これにより、クラスのコンストラクタとデストラクタを空のままにしておくことができます。 この設計により、メモリ管理が簡素化され、層の初期化がより予測しやすくなります。 ニューラル層のアーキテクチャの主な設定と構築は、Initメソッドを通じておこなわれます。このメソッドは、すべての要素を適切に統合し、それらのパラメータを設定します。
bool CNeuronSNSMHAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint window, uint heads,
                                 uint m_units, float sparse,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!sparse >= 1 || sparse < 0)
      return false;
   fSparse = sparse;
//---
   if(!CNeuronConvOCL::Init(numOutputs, myIndex, open_cl, heads, heads, 1, units * m_units,
                                                              1, optimization_type, batch))
      return false;
このメソッドのアルゴリズムは、スパース性係数sparseの妥当性を確認することから始まります。 値が有効範囲 [0, 1) 内にない場合、関数は直ちにfalseを返し、それ以降の設定エラーを防ぎます。 その後、fSparseパラメータが保存され、Attention重みの計算に使用されます。
次に、親クラスが初期化され、そこでオブジェクトの基本パラメータが設定されます。
ここで明確にしておくべき点は、この場合、親クラスの機能を単なる基本的なインターフェースの作成に限定しているわけではないということです。 これは、Multi-Head Attention畳み込みを実行する、モデルの一員として十分な機能を備えたオブジェクトです。
基本的な初期化が完了すると、内部オブジェクトの段階的な設定が始まります。 まず、cNeighborsモジュールが初期化されます。このモジュールは、最も重要な近傍の処理を担当します。
   int index = 0;
   if(!cNeighbors.Init(0, index, OpenCL, units * m_units, optimization, iBatch))
      return false;
   CBufferFloat* temp = cNeighbors.getOutput();
   if(!temp ||
      !temp.Random(0, (float)(units - 1)))
      return false;
初期段階では、オブジェクトの結果バッファにランダムな近傍インデックス値を格納し、多様なサンプルが得られるようにします。
cRamdomCandidatesモジュールについても同様の処理がおこなわれます。このモジュールは、サンプルを拡張するためのランダムな候補を格納するものです。
   index++;
   if(!cRamdomCandidates.Init(0, index, OpenCL, units * m_units, optimization, iBatch))
      return false;
   temp = cRamdomCandidates.getOutput();
   if(!temp ||
      !temp.Random(0, (float)(units - 1)))
      return false;
このアプローチは、重要な要素とランダムな要素を組み合わせたハイブリッドな近傍選択メカニズムを提供します。
次に、cProjection配列内の2つのオブジェクトを初期化します。これらは、元の埋め込みをQuery空間およびKey空間へ射影します。 1つ目のオブジェクトには活性化関数としてSoftPlusが、2つ目にはTANHが割り当てられます。 これにより非線形変換がおこなわれ、モデルは要素間の複雑な相互作用を考慮できるようになります。
   index++;
   if(!cProjection[0].Init(index, 0, OpenCL, window, window, 2 * heads, units, 1,
                                                             optimization, iBatch))
      return false;
   cProjection[0].SetActivationFunction(SoftPlus);
   index++;
   if(!cProjection[1].Init(index, 0, OpenCL, 2 * heads, 2 * heads, 2 * heads, units,
                                                           1, optimization, iBatch))
      return false;
   cProjection[0].SetActivationFunction(TANH);
   index++;
   if(!cScores.Init(0, index, OpenCL, units * m_units * heads, optimization, iBatch))
      return false;
//---
   return true;
  }
最後に、cScoresオブジェクトが初期化されます。このオブジェクトは、Sparse Attention重みを蓄積し、グラフ畳み込みで使用される最終的な影響行列を形成します。
全体として、Initメソッドは、層のすべてのコンポーネントが正しく設定されることを保証する、綿密に設計された段階的な初期化プロセスです。 これにより、各オブジェクトに、統一されたアーキテクチャ内で動作するために必要な次元、活性化関数、およびパラメータが確実に割り当てられます。 このアプローチにより、層に柔軟性と拡張性がもたらされ、計算効率と高い精度を維持しながら、さまざまなデータ構成、Attention Head数、近傍サンプルサイズに対応できるようになります。
feedForwardメソッドは、モジュールの統一されたアーキテクチャを通るデータの順伝播を綿密に実装し、すべての内部コンポーネントが順序立てて連携するようにします。 まず、SignificantNeighborsSamplingメソッドが呼び出され、重要な近傍のインデックス配列が作成されます。 何らかの理由でこのステップが失敗した場合、関数は直ちにfalseを返し、それ以降の計算をおこなわず、層の正しい状態を維持します。
bool CNeuronSNSMHAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!SignificantNeighborsSampling(NeuronOCL))
      return false;
近傍の選択が正常に完了すると、入力データオブジェクトNeuronOCLへのポインタがローカル変数inputsに格納され、その後、射影ブロックへ順に渡されます。 このループは、cProjection配列の各要素を順に処理します。 各要素に対して、その要素のFeedForwardメソッドが呼び出されます。このメソッドは、入力テンソルに線形変換と非線形変換を行い、後続のAttention演算に用いるQueryとKeyの射影を生成します。
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(uint i = 0; i < cProjection.Size(); i++)
     {
      if(!cProjection[i].FeedForward(inputs))
         return false;
      inputs = cProjection[i].AsObject();
     }
また、各ブロックの処理が完了するたびに、次のステップの入力を直前のステップの出力に設定し直すことで、途切れのないデータフローと整然としたカスケード変換を実現します。
次に、SparseMHScoresメソッドを呼び出します。このメソッドは、すべてのノードと近傍のペアについて、スパース性係数fSparseを考慮してSparse Attention係数を計算します。
   if(!SparseMHScores())
      return false;
   if(!CNeuronConvOCL::feedForward(cScores.AsObject()))
      return false;
//---
   return true;
  }
算出された値は累積され、畳み込みMulti-Head Attention集約層に渡されます。この層の機能は、親クラスによって実装されています。 ここで最終的な変換がおこなわれ、層の最終的な出力値が生成されます。
このプロセス全体は、データが主要な段階を論理的かつ順序立てて通過するように設計されています。まず重要な近傍の選択、次に射影の生成、続いてSparse Attention係数の計算、最後に情報の集約がおこなわれます。 このアプローチにより、コードの高い可読性が確保され、アーキテクチャ全体を損なうことなく、追加の変換や最適化を容易に組み込むことができます。 このメソッドの終了時にtrueが返され、順伝播が正常に完了し、その層が次の処理に進む準備が整ったことを示します。
calcInputGradientsメソッドは、誤差勾配を層のすべての内部コンポーネントおよび入力データに正確に分配し、モデルの学習において正しい逆伝播がおこなわれるようにする役割を担っています。 まず、前の層へのポインタであるprevLayerが有効かどうかを確認します。 ポインタが存在しない場合、関数は直ちにfalseを返し、誤った計算を防ぎます。
bool CNeuronSNSMHAttention::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!prevLayer)
     return false;
次に、親クラスの同名メソッドが呼び出され、集約層cScoresのレベルで勾配が分配されます。
   if(!CNeuronConvOCL::calcInputGradients(cScores.AsObject()))
      return false;
   if(!SparseMHScoresGrad())
      return false;
その後、SparseMHScoresGradが呼び出されます。これは、Sparse Spatial Multi-Head Attentionモジュールによって生成されたSparse Attention係数を通じて勾配を分配する役割を担っています。 ここでは、アーキテクチャの動作原理を維持しつつ、スパース近傍行列の特性を考慮に入れています。
次に、cProjection配列に対して、最後のブロックから順に逆順でループが開始されます。 各射影について、入力オブジェクトinputsが定義されます。最初のブロックでなければ前のブロックの出力が使用され、最初のブロックであればprevLayerが使用されます。
   int total=(int)cProjection.Size();
   CNeuronBaseOCL* inputs = NULL;
   for(int i = total-1; i >=0; i--)
     {
      inputs = (i>0 ? cProjection[i-1].AsObject() : prevLayer);
      if(!inputs.CalcHiddenGradients(cProjection[i].AsObject()))
         return false;
     }
//---
   return true;
  }
各オブジェクトに対して、CalcHiddenGradientsメソッドが呼び出されます。このメソッドは、次の層から蓄積されたすべての勾配を考慮して、隠れ状態の局所勾配を計算します。 これにより、重みと隠れ状態の整合性を保ちつつ、すべての中間層を通じて一貫した正しい逆伝播がおこなわれることが保証されます。
このように、calcInputGradientsは、結合されたモジュール全体で構造化された逆伝播を実行し、Sparse Attention係数とすべての射影層の両方に勾配を正確に分配することで、その後の最適化ステップに向けた準備を整えます。
updateInputWeightsメソッドは、誤差勾配が分配された後、層のすべての内部コンポーネントの重みパラメータを順次更新する役割を担っています。 このメソッドは、計算された勾配に基づいてモデルを正しく最適化し、アーキテクチャの各要素に変更を適切に反映します。
bool CNeuronSNSMHAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(uint i = 0; i < cProjection.Size(); i++)
     {
      if(!cProjection[i].UpdateInputWeights(inputs))
         return false;
      inputs = cProjection[i].AsObject();
     }
まず、このメソッドでは、入力データオブジェクトへのローカルポインタinputsを宣言します。このポインタは、初期状態では外部のNeuronOCL層を指しています。 次に、すべてのcProjectionブロックに対してループが開始されます。 各ブロックについて、UpdateInputWeightsメソッドが呼び出され、計算された勾配が現在のブロックの重みパラメータに適用されます。 重みの更新がいずれかの段階で失敗した場合、このメソッドは直ちにfalseを返し、モデルが不整合な状態になるのを防ぎます。 ブロックの更新が正常に完了すると、inputsに格納されたポインタの参照先を現在の射影の出力に切り替え、次のブロックが現在の入力データを正しく受け取れるようにします。
ループが完了すると、親クラスにある同名のメソッドが呼び出されます。このメソッドは、Multi-Head Attention集約層の重みを更新し、モデルの全レベルにわたって一貫性を確保します。 この手順は、Sparse Attention係数が正しく機能することを保証し、最終的な予測関数において選択された各近傍の影響を保持するために極めて重要です。
   if(!CNeuronConvOCL::updateInputWeights(cScores.AsObject()))
      return false;
//---
   return true;
  }
最後に、このメソッドはtrueを返し、モジュールのすべての内部コンポーネントについて重みの最適化が正常に完了したことを示します。
これらを総合すると、CNeuronSNSMHAttentionオブジェクトにより、複雑な近傍選択アルゴリズムとMulti-Head Attentionを単一の構造内で明確に統合することが可能となり、透明性、スケーラビリティ、および柔軟性が確保されます。
今日の作業は密度が高く、実り多いものでした。 Significant Neighbors SamplingモジュールとSparse Spatial Multi-Head Attentionモジュールの実装を深く掘り下げました。 それらのアーキテクチャ上の特徴を分析し、順伝播と逆伝播の仕組み、および重みの最適化について詳しく検討しました。 ここで少し休憩を取り、これまで吸収した情報をじっくりと噛みしめ、次のステップに向けた土台を築く時です。
次回の記事では、今回着手した作業を再開し、筋道を立てて丁寧に仕上げていきます。 構築したモデルを過去データで検証し、その頑健性と予測精度を評価するとともに、実際の金融時系列データを用いて、提案した手法の実用性を実証します。
結論
この記事では、SAGDFNフレームワークの主要モジュールをMQL5とOpenCLで実装する方法について詳しく解説しました。 重要近傍サンプリングを用いて重要な近傍を選択する方法、スパースなMulti-Head Attentionを構築する方法、および単一のニューラル層内で順伝播と逆伝播を効率的に構成する方法を分析しました。 計算の最適化には特に注意を払いました。重みパラメータの再利用やスパース正規化への切り替えにより、メモリ負荷を大幅に軽減し、データ処理を高速化できることを実証しました。
その結果、このアーキテクチャは高い予測精度と計算効率を両立し、このモデルは多数の時系列を処理するのに適しています。
参考文献
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19370
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。



