取引におけるニューラルネットワーク:あらゆる相場環境におけるロバストな売買シグナル(ST-Expert)
 19
 0

はじめに
今日の金融市場は、何百万件もの取引、規制当局の決定、企業の報告、そしてマクロ経済のシグナルが交錯して複雑なパターンを形成する、ダイナミックなエコシステムです。 トレーダーやアナリストにとって、重要な課題は、このパターンに潜む規則性を特定し、それを基に予測を立てることです。 しかし、まさにここに最大の矛盾が生じます。市場の変化の速度が、従来のモデルが適応できる速度を上回っているのです。 昨日有効だったことが、明日には役に立たないばかりか、危険になる可能性もあります。
私たちは、相関という観点から物事を考えることに慣れています。 原油価格とカナダドルの為替レート、米連邦準備制度理事会(FRB)の金利とハイテクセクター、そして金の需要とドルの値動きの間には、安定した関係が見られます。 しかし、外部環境が変化すると、こうした依存関係はたちまち崩れてしまいます。 2020年の新型コロナウイルスによる市場暴落の際、株式、債券、コモディティの間に通常見られる相関は、わずか数週間のうちに現実を反映しなくなりました。 FRBによる利上げと利下げのサイクルといった、より緩やかなレジームシフトでさえ、相関を劇的に変化させ、かつては信頼できると思われていたモデルの信頼性を損なうことがあります。
この問題の核心は、現代のアルゴリズムが、比較的短く、かつ均質なデータ区間を用いて学習されているという点にあります。 こうした実験室的な条件の下では、これらのアルゴリズムは資産間の微妙な相関を検出し、目覚ましい成果を上げます。 しかし、市場が通常の分布の範囲を外れると、予測の精度は急激に低下します。 基本的に、これらのモデルは市場が落ち着いている時期には完璧に機能しますが、市場の相転移には対応できません。
この状況は、多くの点で都市交通ネットワークを思わせます。これは、論文「Robust Traffic Forecasting against Spatial Shift over Years」の著者らが、新しいフレームワークであるST-Expertを提案する際に用いた例です。 都市の状況が変わらない限り、交通予測は完璧に機能します。 しかし、新しいインターチェンジが建設されたり、大規模なショッピングセンターがオープンしたりすると、従来のルートは実情に合わなくなってしまいます。 金融環境において、こうした変化を引き起こす要因としては、規制当局の決定、制裁、地政学的紛争、あるいは新技術の登場などが挙げられます。 市場における関係性の構図は変化しており、従来のモデルは有効に機能しなくなっています。
この課題に取り組むため、ST-Expertの著者らは、エキスパートの混合に基づく独自の解決策を提案しています。 その核心となる考え方は、このモデルが単一の固定的な依存関係構造からではなく、「Graphon」と呼ばれる一連のグラフ生成器から学習するという点にあります。 それらはそれぞれ、特定の種類の市場行動を反映しています。 あるGraphonは持続的なトレンドの下でのパターンを特定し、別のGraphonはボラティリティが高い局面を記述し、さらに別のGraphonは業界内の局所的な相関を検出します。 市場の状況が変化しても、システムは機能不全に陥ることはありません。むしろ、これまでに学習したシナリオを適応的に組み合わせることで、金融商品間の新たな関連性を構築し、予測の精度を維持します。
まさにこの点において、このアプローチの最初の、そしておそらく最も重要な利点が明らかになります。それは、変化する市場の状況に適応できるという点です。 標準的なモデルが特定の歴史的時期に縛られてしまうのに対し、この新しい枠組みでは、市場をモザイクのようなものと捉え、各市場レジームは全体の一時的な断片に過ぎないと見なしています。 その結果、このアルゴリズムは、すでに学習済みの要素から新たな組み合わせを構築し、他のシステムが頑健性を失うような状況でも正確な予測をおこなうことができます。 トレーダーにとって、これは市場の乱高下期に誤った売買シグナルが減り、長期的な戦略を策定する際の信頼性が高まることを意味します。
しかし、適応力というのは、あくまで一面に過ぎません。 もう一つの大きな利点は、このアーキテクチャの汎用性です。 エキスパートGraphonの層は、既存のソリューションに容易に統合することができます。 これは、資産間のネットワーク関係を分析するグラフニューラルネットワークにも、価格の時系列を扱うTransformerにも追加することができます。 このため、このアプローチは実務家にとって特に有益なものとなります。 インフラの抜本的な見直しを必要とせず、すでに定着しているシステムをさらに強化することができます。
もう一つの利点は、いわゆるレジームシフトに対する頑健性にあります。 金融市場の歴史は、不変の状態は稀であり、変化こそが常であることをはっきりと示しています。 10年ごとに新たな危機が訪れ、その危機の各段階では、予測不可能な衝撃が次々と押し寄せます。 時を超えて変わらない不変の要素を見つけようとする試みは、結局のところ幻想にすぎません。 この新しい枠組みは、市場が絶えず変化するという性質を率直に認めており、シナリオを切り替える能力こそがその強みの源泉となっています。 これは、予測を誤った場合のコストが極めて高くなるストレステストや長期予測において、特に重要です。
その一方で、このアプローチはコンパクトかつ効率的であることに変わりはありません。 金融分野のアプリケーションにおいて、時間は極めて重要です。 取引の判断は、ミリ秒単位で行わなければなりません。 したがって、モデルがどれほど正確であっても、計算負荷が過度に高くなってはなりません。 提案されている枠組みでは、この要素が考慮されています。 この枠組みは、計算コストを大幅に増加させることなく、柔軟性と頑健性を高めます。 その結果、アルゴリズム取引からリスク管理に至るまで、リアルタイムシステムでの利用が可能となります。
最後に、拡張性という点での柔軟性にも注目すべきです。エキスパートGraphonは、特定の市場や資産クラスに限定されることはありません。 これらは、株式、債券、為替、暗号資産の各市場で利用できます。 さらに、市場の気配値やニュースフィードからマクロ経済指標に至るまで、さまざまな種類のデータを統合できます。 これにより、金融システムの多層的な性質を考慮した、真に包括的なモデルを構築する道が開かれます。
これは、不確実性の下でのモデリングの本質そのものに対する、根本的に新しい視点です。 従来のモデルが時を超えて変わらない特定のパターンを追い求め続ける一方で、ST-Expertは、変化する世界に適応するようシステムを学習させます。 これにより、予測は、予期せぬ変化を考慮し、リアルタイムで適応できる動的なプロセスへと変化します。
ST-Expertアルゴリズム
金融市場向けの信頼性の高い予測モデルを構築するには、さまざまな市場レジームを区別し、それらを考慮に入れる能力が必要です。 実際には、資産間の相関構造は決して静的なものではありません。 昨日までは確固たるルールのように思えたものが、明日には単なる偶然に過ぎないことが判明するかもしれません。 テクノロジーセクターの成長期には、IT企業の株価と金利との関連はごく弱いかもしれませんが、過熱の兆しが現れ始めると、その関連が顕著になります。 商品市場では、原油価格と輸出国の通貨との相関は、危機の時期には特に顕著になりますが、その後は事実上消失することもあります。 こうした多様性をすべて単一の固定された関係行列に還元しようとするモデルが、必然的に精度を損なうことは明らかです。
まさにその理由から、著者らは、市場が比較的均一な動きを示す特徴的な時間区間を特定することに基づくアプローチを提案しています。 その考え方は単純です。 過去のデータをすべて単一のデータセットとして扱うと、重要な市場レジームの特徴が埋もれてしまい、どのエキスパートもそれらを正しく学習できなくなります。 しかし、過去のデータを、それぞれ固有の安定した相関構造を持つ期間に分割すれば、各期間に特化したエキスパートを構築できます。 その後、モデルはこれらのエキスパートを組み合わせ、市場環境の柔軟な表現を作り出します。
形式的には、これは「最大時空間グラフ分割(MSGD)」問題につながります。 時系列全体(Tと表記する)は、K個の重複しない区間に分割されます。 各区間Tkには、組(Xt, Yt)が、t ∈ [tk, tk+1) の範囲について含まれます。 重要なのは、そのような区間内では市場の関係が同じ構造Rkによって記述される一方、その構造は区間ごとに異なるという点です。
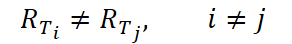
要するに、異なる日であっても、朝の株式市場の取引セッションは互いに似通うことがあるということです。 個人投資家の活動はある種の相関を生み出す一方、機関投資家が市場に参入する夕方の時間帯には、まったく異なる関係のパターンが形成されます。 MSGDの考え方は、特定される区間間の差が最大になるようにデータを分割することにあります。
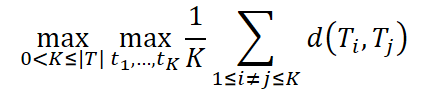
ただし、以下の条件を満たすものとします。
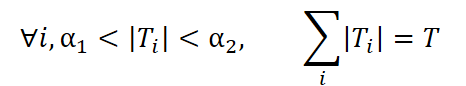
ここで、フレームワークの著者らは、非類似度の尺度d(•,•)として、期間ごとに相関構造がどの程度異なるかを反映するケンドールの順位相関係数τを用いることを提案しています。 制約α1およびα2は、それぞれ許容される区間長の最小値と最大値を指定し、Tは時系列全体の長さを表します。
したがって、この課題は、依存関係の種類という観点から、互いに最も大きく異なる部分へと履歴データを分割することに帰着します。 つまり、求めているのは純粋な市場レジーム、すなわち上昇トレンド局面、レンジ相場局面、高ボラティリティ局面です。 このアプローチは、テーマ別インデックスの構築と似ています。 各指数は、同一種類の有価証券をひとまとめにし、他の市場セグメントのパフォーマンスと混ぜることなく、そのパフォーマンスを追跡します。
もちろん、この問題を解決するのは容易なことではありません。 この問題は解析的に表現できないため、このフレームワークの著者らは動的計画法を用いています。 これにより、大量のデータを扱う場合でも、区間数Kと各区間の境界の両方を効率的に決定できます。
各期間が定義された後、次のような疑問が生じます。すなわち、それぞれの期間内における関係の構造を、具体的にどのように定義すべきなのでしょうか。 この目的のために、確率的なグラフ生成器であるGraphonという概念が導入されます。 固定の隣接行列とは異なり、ここではGraphonは確率行列Pによって定義され、その要素P(i,j)は資産iとjの間に接続が存在する確率を表します。 したがって、Graphonは辺の存在を厳密に規定するのではなく、その確率分布を記述します。 これは、関係が本質的に確率的である金融市場の実態にはるかに近いものです。
各エキスパートのGraphonを構築するために、学習可能な埋め込み行列Egk ∈ R|V|*dと、現在の市場データに依存する動的な埋め込み層Et ∈ R|V|*dを用います。 この場合、k番目のエキスパートの確率行列は、次の式で計算されます。
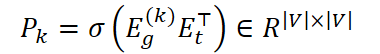
ここで、σはすべての値を(0, 1)の範囲に写像するシグモイド関数です。
この確率行列から具体的なグラフを得るために、Gumbel-SoftMaxを用いた再パラメータ化を適用します。
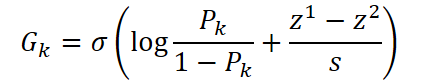
ここで、z1とz2はGumbel(0,1)分布からサンプリングされ、sは温度パラメータです。
要するに、この手法では、厳密な二値化を避けながら具体的な関係をサンプリングすると同時に、金融市場に多く見られるノイズを含む弱い相関の影響を最小限に抑えることができます。
その結果、各エキスパートには、それぞれ独自の市場の振る舞いを反映するグラフ生成器が割り当てられます。 一部のGraphonは、例えば同一業種内で、密なクラスタを形成する傾向があります。 一方、他のGraphonは、資産クラス間の大域的な相関に典型的に見られる、より疎な接続を形成します。 これらが一体となってエキスパートのアンサンブルを構成し、これまで遭遇したことのない新たな市場レジームであっても、それを記述し、組み合わせられるようになります。
しかし、エキスパートの構築は最初の一歩にすぎません。 重要なのは、変動のある条件下でエキスパートを学習させることです。 現実の世界では、市場の依存関係は絶えず変化しています。 資産間の相関構造は、さまざまな要因の影響を受けて形成されたり、崩れたりします。 中央銀行の決定は、通貨や債券の動向を変化させます。 税制や規制の変更は、セクター間のつながりを再編します。 危機や技術的な転換も、それぞれ急激な変化をもたらします。 比較的安定したデータセットで学習されたモデルにとって、このような変化は深刻な問題となります。 モデルが持つ市場の地図が、突然、現実と一致しなくなります。
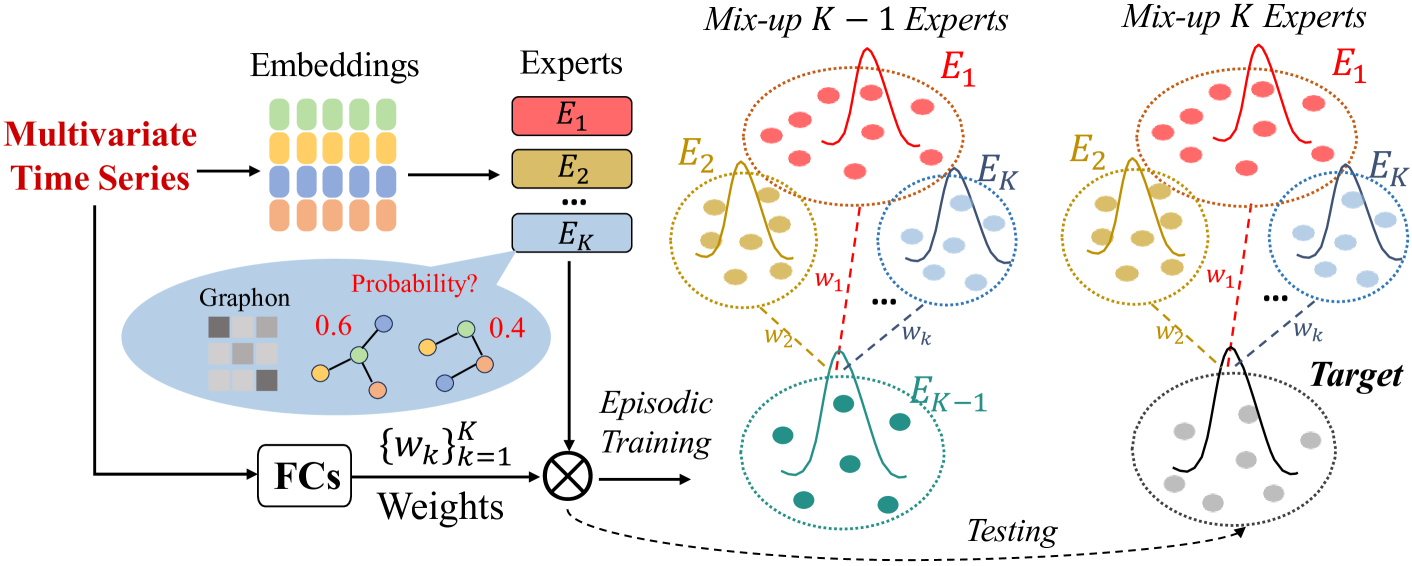
この種の不確実性にシステムが対応できるようにするため、このフレームワークの著者らは、エピソード学習の利用を提案しています。 このアプローチの本質は、エキスパートの役割を分けることにあります。 観測値xi ∈ Tiが入力されると、その時間区間に割り当てられたGraphonPiのみが主要な予測タスクを実行します。 このGraphonを用いてグラフGi ⁓ Piを構築し、そのグラフをST-GNNモジュールに入力して予測を生成します。
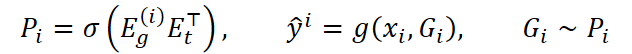
したがって、予測精度を担う主損失関数を通じて学習されるのは、その時間区間に対応するエキスパートです。
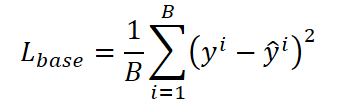
しかし、学習プロセスはそこで終わるわけではありません。 残りのエキスパート{Pk}Kk=1,k≠iは、この場合、直接の予測には使用されませんが、重要な補助的役割を果たします。 これらを用いてGraphonの混合Pimix(x)を形成し、これが参照GraphonPiの構造を可能な限り正確に再現するようにします。
この目的のために、入力信号xiから重みベクトルを算出するゲーティングネットワークを導入します。
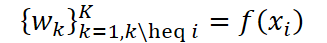
これらの重みにより、他のエキスパートを組み合わせる割合が決まります。
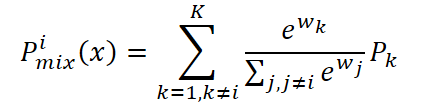
その後、参照GraphonPiと比較されます。
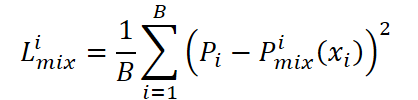
Lmixは混合重みwのみを更新し、Graphon自体のパラメータには影響を与えない点に注意が必要であります。 その結果、エキスパートは独立性を保ち、それぞれの市場レジームに特化し続ける一方で、重みベクトルは、参照Graphonの特性を再現するために、それらを適切に組み合わせることを学習します。
したがって、学習は2つの並行するプロセスに分けられます。 各エキスパートは、他のエキスパートに干渉することなく、自身が担当する市場レジームに特化して予測能力を高める一方、ゲーティングネットワークは模倣タスクで学習します。 ゲーティングネットワークは、他のエキスパートの知識を組み合わせ、それらが全体として現在の参照Graphonの構造を再現できるように学習しなければなりません。 このような役割分担により、このモデルは高度に専門化されていると同時に柔軟性も兼ね備えており、新たな市場状況に適応することが可能となっています。
これは、アナリストチームの業務に例えることができます。 それぞれが独自の専門分野を持っています。 ある者はコモディティ資産に精通しており、別の者は為替市場を専門とし、さらに別の者は債券を専門としています。 新たな状況が生じた場合、その状況に最も関連する専門分野を持つアナリストが予測をおこないます。 その際、他のメンバーは補助的な役割を担います。 他のメンバーは、自分たちの視点を組み合わせることで、予測を主導するエキスパートの重要な洞察をどの程度再現できるかを、チームがより的確に評価できるよう支援します。
学習を終えた後、モデルが実際の市場データにさらされると、初めて完全な不確実性の状況に置かれることになります。 学習中は、対応する時間区間に割り当てられた正しいGraphon Piに常にアクセスできていましたが、推論時にはもはやそのような手がかりは得られません。 これは、取引における自然な状況に合致しています。 トレーダーは過去のパターンに頼ることはできますが、市場が今日、サイクルのどの段階にあるかを事前に正確に知ることは決してできません。
推論フェーズの最初のステップは、すべてのエキスパートが同時に確率的Graphonの集合を生成することです。 それぞれが、資産間の関係構造について独自の解釈を展開しています。 要するに、各エキスパートはそれぞれ独自の市場仮説を提示しています。 明確なセクター別クラスタを特定するエキスパートもあれば、通貨と商品資産の間の大域的な相関を捉えるエキスパートもあり、さらに、不安定ながらも意味のある局所的な相互関係を検出するエキスパートもあります。
次のステップでは、現在の市場シグナルxtestに基づいて重みベクトルを計算します。
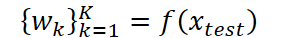
これらの重みは、現時点における各エキスパートの重要性を反映しています。 ゲーティングネットワークは、その時点での各エキスパートの意見の重要度を決める仲裁役を務めると言えるでしょう。 例えば、市場で商品資産のボラティリティが急上昇した場合、関連するシナリオで学習したエキスパートに、より大きな重みが与えられます。
重みの計算後、最終的な混合Graphonが生成され、市場における関係性を集約した表現が得られます。
推論フェーズと学習フェーズの主な違いは、推論時にはすべてのエキスパートが同時に処理に関与する点です。 学習時には、システムはどのエキスパートが適切かを把握しており、他のエキスパートは模倣のためだけに利用していましたが、推論時にはエキスパート全体による評価に頼る必要があります。 この点は極めて重要です。 実際の市場では既成の参照基準は与えられないため、モデルは蓄積された知識をもとに新たな表現を合成できなければなりません。
最終段階では、得られた確率行列から、資産間の関係性の現在の分布を反映した具体的なグラフがサンプリングされます。 このグラフは、ST-GNNモジュールで予測を生成する際に使用されるものです。 ここでシステムは、本質的には、固定された硬直的な構造ではなく、すべてのエキスパートが共同で柔軟に形成した表現に基づいて、市場動向を予測しています。
その結果、推論フェーズで経験豊富なポートフォリオマネージャーのように振る舞うモデルが得られます。 単一の情報源に依存するのではなく、さまざまな視点を比較・統合することで、ダイナミックな市場マップを構築しています。 このアプローチにより、モデルは頑健性と柔軟性を備え、新たな出来事の影響で従来の市場パターンが崩れた場合でも、予測精度を維持できます。
提案されたアプローチのもう一つの大きな利点は、学習可能なGraphonの汎用性にあります。 上記の説明では時空間グラフニューラルネットワーク(ST-GNN)と組み合わせて使用されていますが、その可能性ははるかに幅広いものです。 Graphonは、それ自体が確率的な関係を記述するための柔軟なツールであり、幅広いアーキテクチャをつなぐ架け橋としての役割を果たすことができます。
特にTransformerモデルでは、Graphonは動的なマスクや、生成されるAttention行列として機能できます。この場合、系列内の要素間の接続は、あらかじめ定義されたルールではなく、学習された確率的構造によって決まります。 これにより、変化する市場の動向をより的確に捉えることができる、より適応性の高いTransformerの開発に向けた道が開かれます。 さらに、Graphonは、CNN、RNN、注意機構を組み合わせたハイブリッドシステムにも活用でき、それによってこれらの構成要素のいずれの性能も向上させることができます。
以下に、著者によるST-Expertフレームワークの構成図を示します。
MQL5を使用した実装
ST-Expertフレームワークの理論的な側面を確認したところで、MQL5を用いてそのアプローチを実装していきます。 そしてもちろん、まずはGraphonの構築から作業を始めます。 ただし、その前に、今回の実装で採用するアプローチについて説明します。
個人的には、このフレームワークの著者らが提案する学習プロセスには、気になる点が2つあります。 1つ目は、特定の市場レジームを識別するために、学習用サンプルを前処理する必要があることです。 このプロセスはかなり手間がかかり、追加の最適化手順が必要であり、多くの場合、ヒューリスティック手法に依存しています。 実際の市場環境では、このような厳密な分割は、多くのリソースを必要とするだけでなく、信頼性も十分ではない可能性があります。 こうした市場レジーム間の境界はしばしば曖昧であり、レジーム自体も急速に変化することがあります。 過去のデータを分割する際に厳密さを求めすぎると、多くの市場変動の基盤をまさに形作っている重要な移行局面を見失うおそれがあります。
2つ目は、Graphonと重みを学習させる仕組みそのものに関する点です。 元の定式化では、区間Tiの観測値が入力されると、対応するエキスパートPiが予測をおこない、残りのエキスパートは、その構造を再現するための混合モデルにまとめられると仮定されています。 形式的に言えば、このアプローチは洗練されているように見えます。 各Graphonは自身が担当する市場レジームを予測するように学習する一方、 ゲーティングネットワークは、残りのGraphonを組み合わせて参照Graphonを模倣できるように学習します。 しかし、実際には、これによって微妙な問題が生じます。 事実上、エキスパートの役割を厳格に固定し、エキスパート間の相互学習を排除していることになります。 これにより、過度な専門化のリスクが生じます。つまり、エキスパートはごく限られた領域でしか十分な性能を発揮できず、市場環境がわずかに変化しただけで、まったく対応できなくなるおそれがあります。
さらに、このアプローチでは、重みの学習が参照Graphonの正しさに依存することになります。 ある時点で、Piがノイズによって損なわれていることが判明したり、非典型的な市場の状態を捉えていたりすると、ゲーティングネットワークは、より一般的なパターンを特定するのではなく、その状態を再現するよう学習せざるを得なくなります。 偶発的な外れ値や見せかけの相関が多く含まれる金融データでは、これが重大な誤差の原因となり得ます。
今回の実装では、この厳格な階層構造を緩和するよう努めます。 各エキスパートに固有の市場レジームを恒久的に割り当てるのではなく、各Graphonが、市場の現在の状態に応じて決まる確率で予測に寄与できるようにしましょう。 形式的には、このシステムはN個のエキスパートで構成され、各エキスパートが独自の予測を出力します。ゲーティングは、市場の特徴量に基づいてロジットを返す軽量なネットワークです。 エピソード性を導入し、特定のエキスパートだけに注意が集中するのを防ぐため、ランダムなドロップアウトマスクを使用し、その出力をSoftMaxに通します。 その結果、重みとアンサンブルの最終予測が得られます。 このアプローチでは、参照Graphonを模倣するタスクだけでなく、全体として予測を改善することを通じても重みを学習できます。各エキスパートの重要度は、特定の市場の状態において、その寄与がアンサンブルの予測性能をどの程度向上させるかによって決まります。
損失関数は、複数のタスクの混合として構成されます。 この損失関数は、アンサンブルの予測性能を測る指標を基本とし、そこに各エキスパートの個別の損失の重み付き和を加えたものにする必要があります。 これにより、各エキスパートは、自身の寄与が最も重要となる状況で予測を改善するよう促されます。
ゲーティングモジュールでのドロップアウトにより、学習はエピソード的な試行になります。 バッチごとに有効なエキスパートの集合が少しずつ変わり、モデルは特定の「たまたまうまくいったエキスパート」に常に依存しないよう学習します。ドロップアウトは学習時には有効ですが、推論時には無効になるため、すべてのエキスパートの知識を活用できます。
新しいCNeuronGraphonsクラスは、今回実装する柔軟なGraphonアンサンブルのためのドメイン特化型ラッパーとして機能します。 このクラスは、ゲートの状態、入力データの埋め込み、エキスパートのパラメータ、Graphonの集合そのものをカプセル化します。これらは、各ステップでエキスパートの投票の集合から重み付きGraphonを生成するために必要なすべての要素です。
class CNeuronGraphons   :  public CNeuronBaseOCL
  {
protected:
   CLayer            acProbability;
   CLayer            acDataEmb;
   CParams           cExpertsEmb;
   CNeuronBaseOCL    cGraphs;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGraphons(void) {};
                    ~CNeuronGraphons(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint emb_dimension,
                          uint experts, float dropout,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronGraphons;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
このクラス内には4つの内部オブジェクトが宣言されており、それぞれが異なる機能を果たしています。詳細については、メソッドを実装する際に説明します。 この実装では、それらのライフサイクルはクラス内で管理されるため、コンストラクタとデストラクタを空のままにしておくことができます。 オブジェクトが作成されるたびに追加の初期化やクリーンアップをおこなう必要はありません。 このアプローチにより、リソース管理が簡素化され、複数のインスタンスを作成する際に生じるオーバーヘッドが軽減され、クラスの挙動がより予測しやすくなります。
Initによる初期化では、出力数、ネットワーク内のニューロンインデックス、OpenCLコンテキストへのポインタ、内部ユニットの数と集約ウィンドウ、埋め込みサイズ、エキスパートの数、ドロップアウト値、最適化タイプ、バッチサイズなど、設定を完全に制御できます。 これにより、簡単なテスト用にゲートを軽量なMLPで実装することも、必要に応じて高性能なOpenCL実行経路に切り替えることも可能になります。 TrainMode(bool)メソッドは動作モードを制御します。学習中は、反転ドロップアウトが有効になり、その他の確率的手法が使用される場合もあります。推論中は、ドロップアウトを無効にすることで動作が決定論的になります。これは、本番運用や安定した売買判断において重要です。
オブジェクトのアーキテクチャの構築から内部コンポーネントの初期化に至るまでの全プロセスは、プロセス全体の調整役として機能するInitメソッドによって処理されます。 基本的なニューロン階層を構築し、内部コンポーネントをOpenCLコンテキストに紐付け、各ステップを綿密にチェックすることで、すぐに使用可能なモジュールを生成します。
bool CNeuronGraphons::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                           uint units, uint window, uint emb_dimension,
                           uint experts, float dropout,
                           ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * units, optimization_type, batch))
      return false;
   activation = None;
まず、親クラスにある同名のメソッドが呼び出されます。これは、基底オブジェクトに対して必須の事前初期化です。 falseが返された場合、基盤となる仕組みの準備ができておらず、構築を続行しても意味がないため、このメソッドは直ちにfalseを返して終了します。 正常に処理が完了した後、活性化関数の設定を明示的にクリアします。これは、以下でサブコンポーネントごとに活性化関数を個別に設定するためです。
次のステップは、cGraphsバッファの初期化です。ここでは、各エキスパートのGraphonを格納するためのコンテナを準備します。 その後、内部ロジックが所望の範囲内で動作するように、活性化関数を明示的にSIGMOIDに設定します。
   int index = 0;
   if(!cGraphs.Init(0, index, OpenCL, Neurons()*experts, optimization, iBatch))
      return false;
   cGraphs.SetActivationFunction(SIGMOID);
次に、モデルを段階的に組み立てる際に操作するサブコンポーネントへのポインタを一時的に格納するため、複数のローカル変数を宣言します。
   CNeuronBaseOCL       *neuron  = NULL;
   CNeuronConvOCL       *conv    = NULL;
   CNeuronTransposeOCL  *transp  = NULL;
   CNeuronDropoutOCL    *dout    = NULL;
   CNeuronSoftMaxOCL    *softmax = NULL;
ここからは、エキスパートの使用確率を生成するモデルの構築に移ります。 まず、対応する動的配列をクリアし、それをOpenCLコンテキストにバインドします。
//--- Probability
   acProbability.Clear();
   acProbability.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(experts, index, OpenCL, window, window, experts, units, 1, optimization, iBatch) ||
      !acProbability.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
続いて、各要素を順に組み立てていきます。 まず、非線形関数SoftPlusを用いた畳み込み層を作成します。これにより、ロジットに滑らかな単調増加変換を施してから、次の層に渡します。 その後、エキスパートの数だけ値を返す全結合層を作成します。これが、ドロップアウト前のロジットベクトルです。
   index++;
   neuron = new CNeuronBaseOCL();
   if(!neuron ||
      !neuron.Init(0, index, OpenCL, experts, optimization, iBatch) ||
      !acProbability.Add(neuron))
     {
      DeleteObj(neuron);
      return false;
     }
これまでと同様に、割り当てや初期化のエラーが発生した場合は、オブジェクトを適切に破棄し、falseを返して初期化を終了します。
次に、ドロップアウト層を作成します。これは、先ほど述べたエキスパートのランダムな除外を実現するオブジェクトです。
   index++;
   dout = new CNeuronDropoutOCL();
   if(!dout ||
      !dout.Init(0, index, OpenCL, experts, dropout, optimization, iBatch) ||
      !acProbability.Add(dout))
     {
      DeleteObj(dout);
      return false;
     }
次に、SoftMax層を作成します。この層は、先ほど求めたロジットを、各エキスパートの重要度を表す確率ベクトルに変換します。
   index++;
   softmax = new CNeuronSoftMaxOCL();
   if(!softmax ||
      !softmax.Init(0, index, OpenCL, experts, optimization, iBatch) ||
      !acProbability.Add(softmax))
     {
      DeleteObj(softmax);
      return false;
     }
   softmax.SetHeads(1);
次に、入力データの埋め込みブロックacDataEmbの準備を始めます。 それをクリアし、OpenCLにバインドしてから、同様の方法で畳み込み層から組み立て始めます。 ここでは、2つの連続した畳み込み層からなり、その間に非線形関数SoftPlusを挟んだ小規模なMLPを使用します。
//--- Data Embedding
   acDataEmb.Clear();
   acDataEmb.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, window, window, 2 * emb_dimension, units, 1, optimization,
                                                                                   iBatch) ||
      !acDataEmb.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, 2 * emb_dimension, 2 * emb_dimension, emb_dimension, units,
                                                                   1, optimization, iBatch) ||
      !acDataEmb.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
このMLPの出力として、解析対象のマルチモーダル系列の各時間ステップに対する埋め込みが得られるものと期待しています。 ただし、Graphonを生成するには、この表現の転置されたコピーが必要になります。 そこで、次にデータ転置層を追加します。
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, units, emb_dimension, optimization, iBatch) ||
      !acDataEmb.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   transp.SetActivationFunction((ENUM_ACTIVATION)conv.Activation());
次に、エキスパートの埋め込みを生成するためのオブジェクトであるcExpertsEmbを初期化すれば完了です。 ここでは、各エキスパートの表現を格納する領域を用意します。
   index++;
   if(!cExpertsEmb.Init(0, index, OpenCL, units * emb_dimension * experts, optimization, iBatch))
      return false;
//---
   return true;
  }
最後に、エラーがなければ、このメソッドはtrueを返し、オブジェクトが完全に初期化され、学習の準備が整ったことを示します。
このメソッドの動作からは、明確な設計思想がうかがえます。まず、Graphonコンテナを準備し、次に確率生成パイプラインを構築し、入力データの埋め込みを形成し、最後にエキスパート用のパラメータ空間を割り当てます。 この一連の手順により、デバッグやその後のOpenCLとの統合が容易な、論理的な構築プロセスが実現します。
feedForwardメソッドは、綿密に定義された信号生成の仕組みとして順伝播を実装しています。 まず、現在の信号源へのポインタをローカル変数に格納し、処理中の層への参照を一時的に格納するための変数を追加で宣言します。
bool CNeuronGraphons::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* prev = NeuronOCL;
   CNeuronBaseOCL* current = NULL;
次に、エキスパートを使用する確率を予測するブロックで処理をおこないます。 このループ内では、ロジットの生成を担当するすべてのサブコンポーネントを順に処理します。
//--- Probability
   for(int i = 0; i < acProbability.Total(); i++)
     {
      current = acProbability[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
各反復で、次のコンポーネントを取り出し、そのコンポーネント自身の順伝播を実行させます。 コンポーネントが存在しない場合、またはそのFeedForwardがfalseを返す場合は、直ちにfalseを返してメソッドを終了します。 これは、パイプラインの誤った構築を防ぐ、厳格かつ信頼性の高いフェイルファストポリシーです。
層の実行が正常に完了したら、ポインタをソースデータオブジェクトに移動します。 次の層は、現在の層の出力を入力として受け取ります。 このループの結果、正規化された確率のベクトルが得られます。
次に、ソースデータポインタを再初期化し、まったく同じパターンでacDataEmbブロックを反復処理します。 この2回目の線形処理により、ソースデータの埋め込みを生成します。
//--- Data Embedding
   prev = NeuronOCL;
   for(int i = 0; i < acDataEmb.Total(); i++)
     {
      current = acDataEmb[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
次に、小さいながらも重要な分岐があります。学習モードの場合は、エキスパートの埋め込みを生成するメソッドを呼び出します。 つまり、パラメータやエキスパートの表現は、学習の実行中にのみ更新されるということです。 推論モードでは、cExpertsEmbにすでに使用可能な重みが格納されていると想定し、時間短縮のためにこの手順を省略します。
//--- Experts
   if(bTrain)
      if(!cExpertsEmb.FeedForward())
         return false;
次に、中核となる代数演算をおこないます。 オブジェクトのアーキテクチャに必要な補助的な次元サイズを計算します。
//--- Graphs
   uint units = (uint)MathSqrt((double)Neurons());
   uint emb_dim = acDataEmb[-1].Neurons() / units;
   uint experts = cExpertsEmb.Neurons() / acDataEmb[-1].Neurons();
これらの簡単な計算により、行列積を計算する前に、行列の形状の整合性を確保します。 最初におこなう行列の乗算により、各エキスパート固有のグラフ行列が構築されます。 その結果生成されるcGraphsバッファには、すべてのエキスパートについて、こうした行列の系列が整然と格納されています。
   if(!MatMul(cExpertsEmb.getOutput(), current.getOutput(), cGraphs.getOutput(),
              units, emb_dim, units, experts, false))
      return false;
   if(cGraphs.Activation() != None)
      if(!Activation(cGraphs.getOutput(), cGraphs.getOutput(), cGraphs.Activation()))
         return false;
未加工のGraphon行列を取得した後、制御用の非線形変換を適用します。 ここでは、選択した活性化関数を出力バッファのすべての要素に適用します。 これは、値を所定の範囲内に収め、望ましい非線形性を付与するための重要なステップです。
最後のリダクションにより、エキスパートの行列群と確率ベクトルを、単一の最終的な重み付きグラフテンソルに変換します。 つまり、最後のacProbability層から正規化された重みのベクトルを取り出し、すべてのエキスパートの行列を組み合わせて、単一の重み付き結果にまとめます。
//--- Result
   if(!MatMul(acProbability[-1].getOutput(), cGraphs.getOutput(), Output, 1, experts, units * units, 1, false))
      return false;
//---
   return true;
  }
すべての手順が正常に完了した場合、このメソッドはtrueを返し、順伝播が正しく完了したことを示します。
逆伝播メソッドのアルゴリズムは、順伝播と同じロジックに従いますが、処理は逆方向に進みます。 誤差信号は、すべての層を逆順に伝播します。勾配は慎重に累積され、出力から入力へと伝播されることで、すべての構成要素が正しく学習されるよう保証されます。 この構造はfeedForwardメソッドの構造と完全に対応しており、すでに説明した処理の流れからすべてのステップを容易にたどれるため、ここでは各段階の詳細な説明は省略します。 このクラスのすべてのメソッドを完全に理解し、実際に活用していただくために、逆伝播を含む完全なソースコードを添付ファイルとして用意しました。
今日はかなり集中して取り組んできました。ここで少し休憩を挟み、得られた情報を咀嚼しながら、頭の中で整理する時間を取りましょう。 次回の記事では、今回始めた取り組みを引き続き進め、Graphonの実用的な応用について詳しく見ていきます。
結論
本記事では、柔軟なゲーティング、集合的学習、適応的集約の原則を組み合わせたST-Expertフレームワークの理論的側面について、詳細に考察しました。 確率生成ブロック、入力データの埋め込み、エキスパートの表現を組み合わせることで、ノイズや不確実性に対して頑健なモデルを構築できる仕組みについて検討しました。
実践編では、Graphonの構築と学習を可能にするCNeuronGraphonsクラスのアーキテクチャについて解説しています。 ここで説明した手法は、今後の実践的な応用に向けた強固な基盤となります。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19595
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。