

取引におけるニューラルネットワーク:あらゆる市場レジームで頑健な売買シグナル(Attentionモジュール)
 18
 1

はじめに
金融市場は、呼吸し、進化し、絶えず変化し続ける生き物のようなものです。 ここには絶対的な安定性など存在しません。 資産間の通常の相関関係は、わずか数回の取引セッションで消えてしまうことがあります。 市場とは、単にチャート上の数字だけではなく、極めて複雑な相互関係の網の目に絡み合った人間の感情、期待、そして意思決定の反映でもあるのです。 そして、この混沌と不確実性に満ちた世界において、隠された秩序を見抜くことのできる手段は、とりわけ貴重なものです。
ST-Expertフレームワークについては、前回の記事で解説を始めましたが、これはまさに、従来の分析手法では十分に捉えられないパターンを特定するために開発されたものです。 その最大の特徴は、時間と空間という2つの次元を組み合わせることができる点にあります。 時間的側面は、金融市場の予測における典型的な要素です。つまり、過去のデータを分析し、過去の相場に基づいて将来を予測しようとするものです。 空間的な側面は、理解に新たな次元をもたらします。すなわち、市場はすべての資産が互いに結びついたネットワークとして捉えられ、あるセグメントでの変化は必然的に隣接するセグメントに影響を及ぼすのです。
株式市場を分析していると想像してみてください。 原油価格が上昇し始めると、その影響はほぼ即座に石油会社の株価に反映されます。 そして、産油国の通貨に加え、関連産業のセクター全体も、これに追随する可能性があります。 価格の時系列データのみに基づいて構築された従来のモデルは、特定の金融商品の直接的な推移しか捉えることができません。一方、ST-Expertは、時間軸だけでなく市場の相互関係が織りなす空間も扱うため、変化の連鎖全体を捉えることが可能です。
このフレームワークのアーキテクチャは、混合エキスパート、すなわち複数の専門家を組み合わせるという原理に基づいています。 このアプローチは、投資委員会の活動に例えることができます。 ここでは、さまざまな専門分野を持つアナリストたちが一堂に会しています。ある者はテクニカル分析を専門とし、別の者はマクロ経済学を専門とし、さらに別の者はセクター間の相関関係を追跡しています。 個々に見れば、それぞれには限られた能力しかありません。 しかし、それぞれの意見を組み合わせると、最終的な判断は現実にずっと近いものになります。 ST-Expertでも同様に、各エキスパートブロックがそれぞれの分析領域を担当し、システムがそれらの予測を統合して、一貫した解を導き出します。
このようにタスクを分担することで、システムは次の3つの主要な利点を得られます。
- 適応性: 市場は刻一刻と変化しており、システムもそれに合わせて変化していかなければなりません。 昨日の相場変動の主な原動力がコモディティセクターで、今日は通貨へと移った場合、ST-Expertはエキスパート間の比重を変えることで、自らの構成を調整します。
- 頑健性: エキスパートの1つが誤った予測をしても、エキスパート間の調整によって、予測全体の質は維持されます。 これにより、単一の戦略に過度に依存するリスクが軽減され、システムの頑健性が高まります。
- 解釈可能性: トレーダーにとって、予測の結果だけでなく、その背景にある理由も理解することが重要です。 ST-Expertでは、どのエキスパートが主に寄与したのか、またどの関係性が重要だったのかを、いつでも確認できます。 これにより、このシステムはブラックボックスではなく、判断の根拠を理解したうえで活用できるツールになります。
取引の観点から見ると、ST-Expertは単なるインジケータではなく、包括的なナビゲーションシステムです。 トレンドの流れを考慮し、局所的な変動を捉え、資産間の相関関係を分析して、市場の地図をリアルタイムで描き出します。 さらに、普段通るルートが通行止めになっていることが判明した場合、システムはこの地図を更新することができます。 実際の取引では、これはダマシが減り、実際の市場の動きを反映した判断が増えることを意味します。
このフレームワークのアーキテクチャには、いくつかの重要な要素が含まれています。 その中心にあるのはグラフモデルであり、頂点は資産や時点を表し、辺はそれらの間のつながりを表しています。 こうした関係には、金価格がドル為替レートに依存しているような、直接的で明白なものもあれば、あるセクター内の個別銘柄間の相関関係のような、隠れたものもあります。 このシステムの目的は、単にこうしたつながりを特定することだけでなく、市場の状況の変化に応じてそれらを再構成できるようにすることにもあります。
適応型グラフ結合モジュールは、極めて重要な役割を果たしています。 これは、オーケストラの指揮者に例えることができます。 それぞれの楽器にはそれぞれの役割がありますが、どの音をどのタイミングでより大きく響かせるかは、指揮者が決めるのです。 ある関係性の重要性が低下しても、システムは他の関係性を強化することで、予測の整合性を維持します。
ST-Expertの学習の仕組みも同様に重要です。 この学習の仕組みは、システムがさまざまなシナリオに習熟するように設計されています。 これにより、ニュースの急増、相関関係の変化、あるいは新たな市場変動要因の出現といった、新しい状況に備えることができます。 取引の観点から言えば、これは、穏やかな横ばい相場から激しいトレンド相場に至るまで、あらゆる市場シナリオに備えることに似ています。
以下に、著者によるST-Expertフレームワークの構成図を示します。
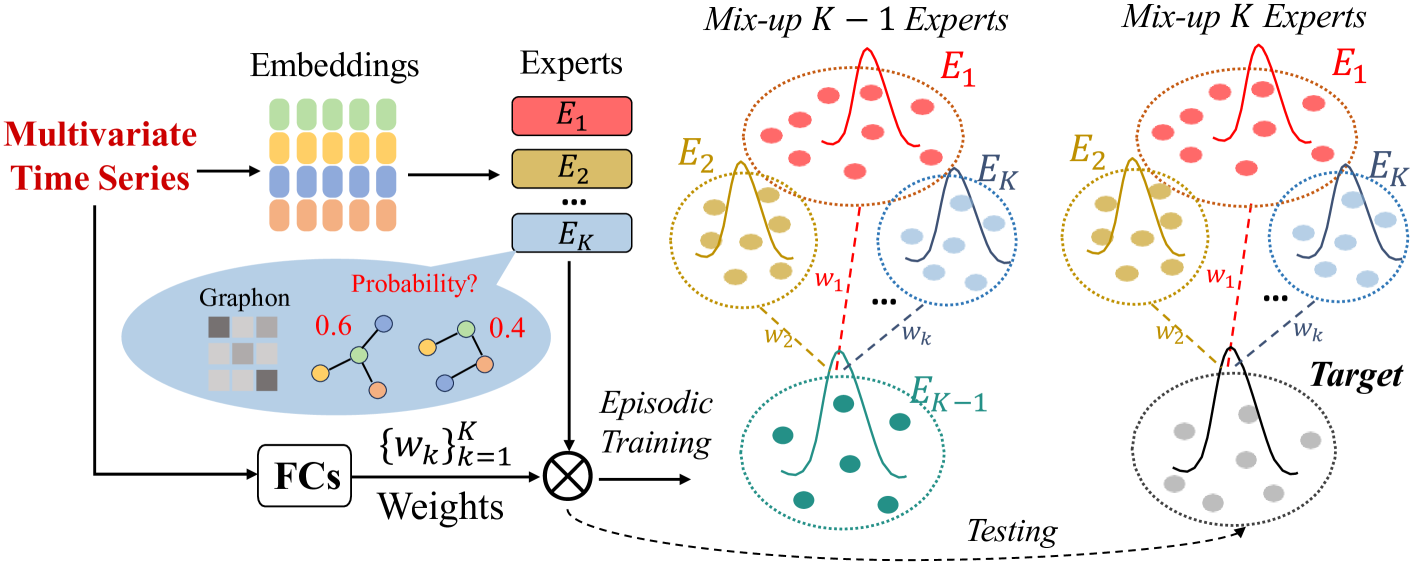
前回の記事では、理論だけにとどまらず、ST-ExpertのアプローチをMQL5で実装するための第一歩を踏み出しました。 私たちは、確率的な関係のモデル化を担う、このアーキテクチャの主要な構成要素であるGraphon生成オブジェクトを構築しました。 この基幹的な構成要素は、空間構造を適応的に分析するための基盤となります。
今回は、前回着手した作業を引き続き進めていきます。 私たちの目標は、このフレームワークを段階的に開発し、単なるアイデアの集まりから、本格的なアルゴリズム取引ツールへと発展させることです。
活用アイデア
モデルの開発を進めるにあたり、ST-Expertフレームワークのもう一つの重要な特徴である汎用性について改めて確認しておきましょう。 このフレームワークの著者らは、提案するアプローチがグラフベースのモデルでの利用に限定されないことを強調しています。 それどころか、それらを多種多様な従来型モデルに組み込むことで、モデルを強化し、新たな特性を付与することができます。 要するに、鍵となるのはモジュール性です。ST-Expertは、単独でも、より大規模なシステムの一部としても動作できる適応型コンポーネントの集合と見なすことができます。
この汎用性は、金融の分野において特に価値のあるものです。 何しろ、トレーダーや研究者が単一のモデルだけに頼ることはめったにありません。たいていの場合、一連のツールを駆使しているのです。 ST-Expertの手法をそれらのツールに統合できれば、実験の新たな可能性が開かれます。 空間シフトに対する頑健性を高めたり、分析能力を拡張したり、解釈可能性を新たな水準に引き上げたりできます。
本研究では、この方向性をさらに発展させることにしました。 実験の基盤として、Extralongerフレームワークを選びました。 これは、局所的要因と大域的要因を組み合わせるという考え方に基づいており、金融市場における複雑なプロセスをより正確にモデル化できます。
ST-ExpertとExtralongerの統合は、理にかなった一歩のように思われます。 前者は、動的グラフを扱う仕組みと、接続構造の変化に適応できる混合エキスパートを導入します。 後者は、時系列を扱うための確立された環境と、実装済みの時空間分析用モジュールを提供します。 両者は、互いを強化する共生関係を形成します。Extralongerは適応性と頑健性をさらに高め、ST-Expertはアルゴリズム取引への統合に向けた実績あるプラットフォームを得ます。
実際にこれがどのようなものになるのか、想像してみましょう。 Extralongerが通貨ペアの動向を分析し、時間的な変動に基づいて予測を生成すると仮定しましょう。 しかし、ある時点で、商品価格や株価指数が市場に大きな影響を与え始めます。 Extralongerの基本機能のみを使用している場合、市場を動かす要因のこうした変化を見逃すかもしれません。 しかし、Graphonとエキスパートブロックを扱う組み込みのST-Expertモジュールは、新たな接続関係を捉え、全体像を再構築します。 その結果、市場の状況が劇的に変化したとしても、予測の精度は維持されます。
アイデアを実践に移すためには、統合ポイントを特定する必要があります。 改めて確認すると、Extralongerフレームワークは、モジュール設計の原則に従って構築された3ルート構成のTransformerを基盤としています。 このフレームワークは、時間分析、空間分析、混合分析という3種類の分析を組み合わせています。 各ルートは、市場データを理解するためのそれぞれの層を担っており、これらが連携して機能することで、包括的な予測を立てることができます。
Extralongerにおける時間分析は、データシーケンスを処理し、時系列からパターンを抽出する従来型のTransformerを用いて実装されています。 このモジュールは土台のようなもので、よく知られた動的な関係性を特定することで、分析のための強固な基盤を提供します。
空間分析は、大域・局所アプローチに基づいています。 このアーキテクチャでは、市場を相互に接続されたノードのネットワークとして捉えています。このネットワークでは、隣接する要素が局所的なパターンを形成する一方で、離れたノード間のつながりが大域的な視点をもたらします。 このアプローチは、金融の分野で特に重要です。金融商品は、直接的に、あるいはより複雑な仕組みを通じて結びついている場合があるためです(たとえば、テクノロジーセクターと株価指数の関係など)。
最後に、混合ルートは、時間的アプローチと空間的アプローチの両方を組み合わせたものです。 これにより、モデルはさまざまなレベルの分析を統合し、一種の三次元的な視点を得ることができます。 その結果、Extralongerはトレンドの動きを追跡すると同時に、ネットワーク内の依存関係も考慮できます。
まさにここに、ST-Expertを統合する余地が生まれます。 ST-ExpertのGraphonエキスパートは、このモジュールにシームレスに統合でき、変化し続ける結合構造への対応能力を高めます。 さらに、混合エキスパート(Mixture of Experts)という考え方そのものが、すでにタスクをルートごとに分担しているExtralongerのモジュール設計の概念に完全に合致しています。
まずは時間ルートから見ていきましょう。 従来型のTransformerのアーキテクチャをグラフモデルと比較してみると、理解の助けになります。 Self-Attention機構は、基本的に、シーケンス内の各要素が他の要素に及ぼす確率的な影響を反映したロジットの表を構築します。 シーケンスの要素をノードと見なすと、ロジットの表は、辺が相互の影響の強さを表すグラフとなります。 この意味で、Transformerは単にシーケンスを分析するだけではありません。シーケンスを相互作用の動的なネットワークへと変換することで、そうしなければ隠れたままとなる局所的・大域的な依存関係を特定できるようにします。
そして、これにより興味深い機会が生まれます。 ロジットを生成する従来のSelf-Attentionの仕組みを使わず、代わりにグラフを用いることができます。このグラフは、ST-Expertフレームワークの原理に基づいています。 このアプローチにより、統計的相関、専門家のルール、および構造化された依存関係に基づいて、シーケンス内の要素間により有意義な関係を確立することが可能になります。 期待するのは、モデルが市場をより深く理解することです。標準的なSelf-Attentionでは見落としかねない微妙な相互関係を捉えることで、それが可能になると考えています。
大域・局所依存関係を分析するモジュールでも、同様のアプローチを採用できます。 ここでは、モデルが大まかなパターンやトレンドを捉え、一種の市場の骨組みを構築します。 大域的なつながりは、市場全体の動向を予測するのに役立ち、モデルが森全体を見渡し、個々の木だけにとらわれないようにします。
しかし、局所的な依存関係には、別のアプローチが必要です。 シーケンス内のノード間で、最も重要かつ存在する確率の高いつながりだけを考慮した疎グラフを構築する必要があります。 これは、ノイズの多い取るに足らないシグナルを無視し、重要なエントリーポイントやエグジットポイントに焦点を当てる、経験豊富なトレーダーのアプローチと似ています。 ST-Expertフレームワークの手法はここでも適用できますが、その際には、最も重要な関係の選択に特に注意を払う必要があります。 このアプローチにより、モデルは広い視野を保ちながら細部にも注意を払い、短期的な変動に大きな影響を与える微細な要因を特定できます。
そのコンセプトは明確です。 それでは、理論から実践へと移り、MQL5を使ってこれらのアイデアを実際に試してみましょう。
Graph Attentionモジュール
上記で提案したGraphonに基づくTransformerの派生モデルを実装するために、CNeuronGraphAttentionオブジェクトを作成します。このオブジェクトは、CNeuronBaseOCLの基本機能を継承し、Graph Attentionモデルの中心となります。 このオブジェクトは、単に従来のValue処理とグラフ構造を組み合わせるだけでなく、一連のデータを動的な関係性のネットワークへと変換します。
class CNeuronGraphAttention   :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    cValue;
   CNeuronGraphons   cGraphs;
   CNeuronSoftMaxOCL cScores;
   CNeuronBaseOCL    cAttention;
   CNeuronBaseOCL    cResidual;
   CNeuronConvOCL    cFeedForward[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGraphAttention(void) {};
                    ~CNeuronGraphAttention(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint emb_dimension,
                          uint experts, float dropout,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronGraphAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
モデル内では、ST-Expertの原理に基づいて構築されたグラフが、シーケンス内の要素間の関係構造を定義します。これにより、重要なつながりを特定し、ノイズを無視できます。 同時に、SoftMax関数はグラフ全体にわたるAttentionの確率分布を生成し、最も重要な相互作用を強調します。一方、残差接続は、新たな依存関係とそれまでに蓄積された依存関係の両方を保持・統合し、一種のモデルの記憶を形成します。
重要なのは、このオブジェクトでは通常のSelf-Attentionの構成から離れ、標準的なQueryとKeyを生成しないという点です。 従来のTransformerでは、これらはシーケンス内の要素間の相互影響を反映したロジット行列を構築するために用いられます。 しかし、本アプローチでは、この機能はST-Expertの原則に基づいて構築されたグラフが担います。 これにより、不要な中間テーブルを生成することなく、ノード間の関係を直接管理し、最も重要な相互作用に焦点を当てることができます。 この場合、Valueの値のみが残り、これらを使って最終的なAttentionの結果が生成されます。 熟練した職人の手にかかった原材料のように、それらはグラフブロックとフィードフォワードブロックを通過し、市場予測に役立つ情報豊かなシグナルへと変わっていきます。
このアプローチにより、モデルはより的を絞った形で動作できるようになります。 Attentionは、すべての要素に均等に配分されるのではなく、金融時系列にとって真に重要な主要な関係に集中します。 その結果、Transformerの有効性を維持しつつ、シーケンス内の関係について、はるかに意味のある構造化された解釈を提供する仕組みが得られます。
Initメソッドは、CNeuronGraphAttentionオブジェクトを使用可能な状態にする役割を担っています。 ここでモデルが一つにまとまり、精密に調整された機構のように、金融データを処理する準備が整います。
bool CNeuronGraphAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint window, uint emb_dimension,
                                 uint experts, float dropout,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
   activation = None;
まず、親クラスの初期化が呼び出され、そこでニューロンの一般的なパラメータが設定されます。 その後、オブジェクトの内部コンポーネントが一つずつ設定されます。
cValueブロックが最初に初期化されます。このブロックは、シーケンスの値の初期エンコーディングを担当します。 その解析ウィンドウと、解析対象のシーケンスに含まれる要素数が指定されます。 データを可能な限りそのまま通過させられるよう、その活性化関数は無効化されています。
   int index = 0;
   if(!cValue.Init(0, index, OpenCL, window, window, window, units, 1, optimization, iBatch))
      return false;
   cValue.SetActivationFunction(None);
次に、cGraphsというGraphonブロックを作成します。このブロックはST-Expertの原則に基づいて構築され、シーケンスの要素間の関係構造を定義します。
   index++;
   if(!cGraphs.Init(0, index, OpenCL, units, window, emb_dimension, experts, dropout, optimization, iBatch))
      return false;
cGraphsモジュールの出力は、シーケンスのノード間の接続確率を反映したグラフです。 これだけでも貴重な情報ですが、Attentionモジュールでは、これらの確率を、シーケンス内の各要素が分析対象に及ぼす影響の完全な分布へと変換する必要があります。 ここで活躍するのが、cScoresブロックです。このブロックにはSoftMax関数が組み込まれています。 このブロックは確率を丁寧に正規化し、主要な接続を強め、二次的な接続を弱めることで、正確で解釈可能なAttention分布を生成します。 その結果、シーケンスの各要素には、分析における固有の重要度の重みが割り当てられ、モデルはノイズや重要でない変動を無視しながら、真に重要な相互作用に焦点を当てることができます。
このアプローチにより、ST-Expertによって生成されたグラフベースの接続を従来のAttentionメカニズムとシームレスに統合し、抽象的な確率を、後続の処理や金融時系列の予測に利用できる具体的なシグナルへと変換できます。
   index++;
   if(!cScores.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cScores.SetHeads(units);
次に、cAttentionブロックとcResidualブロックを設定し、Attentionメカニズムと残差接続の結果を格納できるようにします。 また、信号の歪みを防ぐため、これらのブロックでも活性化関数を無効にします。
   index++;
   if(!cAttention.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cAttention.SetActivationFunction(None);
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
最後に、フィードフォワードブロックを構成する連続した2つの層を設定します。 最初の層はSoftPlus活性化関数を使用し、モデルの非線形性と複雑な関係を識別する能力を高めます。一方、2番目の層は追加の活性化を行わず、情報を圧縮・変換して最終的なAttention信号を生成します。
   index++;
   if(!cFeedForward[0].Init(0, index, OpenCL, window, window, 2 * window, units, 1, optimization, iBatch))
      return false;
   cFeedForward[0].SetActivationFunction(SoftPlus);
   index++;
   if(!cFeedForward[1].Init(0, index, OpenCL, cFeedForward[0].GetFilters(), cFeedForward[0].GetFilters(),
                                                                  window, units, 1, optimization, iBatch))
      return false;
   cFeedForward[1].SetActivationFunction(None);
//---
   return true;
  }
その結果、Initメソッドはすべてのコンポーネントを1つのシステムにシームレスに統合します。 Value処理ブロック、グラフ、Attention分布、およびフィードフォワード層が動作可能な状態となり、金融時系列の動的変化を効果的に分析できる、完全に機能するGraph Attentionメカニズムが構築されます。
オブジェクトの初期化が完了すると、モデルの処理における次のステップは、feedForwardメソッドで実装されている順伝播です。
bool CNeuronGraphAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.FeedForward(NeuronOCL))
      return false;
これは、複雑かつダイナミックな金融の世界を巡る探求の旅です。 すべては、偵察役を務めるcValueオブジェクトから始まります。 あらゆる市場シグナルを綿密に調べ、生データを分析しやすい形に変換します。まるでハイキングの前に地形図を作成するようなものです。
次に、cGraphsグラフモジュールが活躍し、シーケンスのノード間に相互作用の経路を構築します。
   if(!cGraphs.FeedForward(NeuronOCL))
      return false;
これは、この地図上の道路や小道のネットワークのようなものだと考えてください。それぞれのつながりは、ある要素が別の要素に及ぼす影響の強さを表しています。 cScoresブロックは、SoftMaxを使用して遠征隊の隊長のような役割を果たし、どの経路が最も重要か、またどの経路を最初にたどるべきかを決定します。 このブロックは、接続の未処理の確率を明確な移動戦略へと変換し、重要な相互作用を際立たせる一方で、重要でないノイズ信号を無視します。
   if(!cScores.FeedForward(cGraphs.AsObject()))
      return false;
偵察が完了すると、cValueからの情報とAttention分布が行列乗算によって結合され、Attentionモジュールの結果がcAttentionに生成されます。 これは、分析対象にどのような力や影響が作用しているかを確認するために、収集した情報をすべて1枚の地図にまとめるようなものです。
   if(!MatMul(cScores.getOutput(), cValue.getOutput(), cAttention.getOutput(),
              cValue.GetUnits(), cValue.GetUnits(), cValue.GetFilters(), 1, false))
      return false;
次のステップでは、データを残差信号と組み合わせ、cResidualで正規化します。これにより、データを安定させ、ランダムな変動によってモデルが進むべき方向を見失うのを防ぎます。
   if(!SumAndNormilize(NeuronOCL.getOutput(), cAttention.getOutput(), cResidual.getOutput(),
                       cValue.GetFilters(), true, 0, 0, 0, 1))
      return false;
続いて、遠征隊の熟練した分析官のような役割を果たすフィードフォワードブロックの処理段階に入ります。 SoftPlus活性化関数を使用する最初のモジュールは、隠れた相互依存関係を特定し、重要なシグナルを増幅します。これは、研究者が地図上で重要な資源の隠された場所を突き止めるのとよく似ています。 2番目のモジュールは、その情報を、予測に利用できるコンパクトで解釈しやすい表現に変換します。
   if(!cFeedForward[0].FeedForward(cResidual.AsObject()))
      return false;
   if(!cFeedForward[1].FeedForward(cFeedForward[0].AsObject()))
      return false;
   if(!SumAndNormilize(cFeedForward[1].getOutput(), cResidual.getOutput(), Output,
                       cFeedForward[1].GetFilters(), true, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
最終的な正規化では、残差データとフィードフォワードの結果を組み合わせ、市場に対するモデルの見解(大局的な視点と詳細な視点の両方)を反映した最終的なシグナルを形成します。
最終的に、feedForwardメソッドは、複雑な金融データのシーケンスを、予測に利用できる構造化された意味のある知識へと変換します。
順伝播は、モデルの処理の最初の段階にすぎません。 真に有益な予測を得るためには、誤差解析のプロセスを構築する必要があり、これはcalcInputGradientsメソッドで実装されています。
bool CNeuronGraphAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
この段階は、すでにたどった経路を逆方向に進む探検のようなものと考えられ、その過程でモデルは、どの判断が正しかったか、どこで逸脱が生じたかを評価します。
この処理は、順伝播の最後のフィードフォワードブロックから始まります。ここでは、誤差勾配を正しく計算するために、信号に活性化の逆処理を適用します。
   if(!DeActivation(cFeedForward[1].getOutput(), cFeedForward[1].getGradient(),
                    Gradient, cFeedForward[1].Activation()))
      return false;
   if(!cFeedForward[0].CalcHiddenGradients(cFeedForward[1].AsObject()))
      return false;
   if(!cResidual.CalcHiddenGradients(cFeedForward[0].AsObject()))
      return false;
その後、勾配はブロックの第1層とcResidual残差ブロックに送られ、それによって前の段階で処理された情報を調整できるようになります。 この段階では、勾配が総和されます。これにより、モデルの頑健性が維持され、誤差逆伝播中に信号が発散するのを防ぐことができます。
   if(!SumAndNormilize(Gradient, cResidual.getGradient(), cAttention.getOutput(),
                       cValue.GetFilters(), false, 0, 0, 0, 1))
      return false;
次に、行列乗算によって勾配がcScoresAttention分布ブロックおよびcValueブロックを通じて伝播され、各要素が他の要素に及ぼす影響の強さを調整できるようになります。 cGraphsグラフブロックは勾配を受け取り、蓄積された誤差に基づいてノード間の接続確率を微調整します。
   if(!MatMulGrad(cScores.getOutput(), cScores.getGradient(),
                  cValue.getOutput(), cValue.getGradient(),
                  cAttention.getGradient(), cValue.GetUnits(),
                  cValue.GetUnits(), cValue.GetFilters(), 1, false))
      return false;
   if(!cGraphs.CalcHiddenGradients(cScores.AsObject()))
      return false;
その後、NeuronOCLオブジェクトの入力データレベルに、cValueブロックから勾配が伝達されます。そこで、シーケンスの各要素がモデルの誤差にどのように寄与したかが最終的に特定されます。
   if(!NeuronOCL.CalcHiddenGradients(cGraphs.AsObject()))
      return false;
順伝播中、入力データは、cValueValueブロック、cGraphsのグラフ接続、残差接続の仕組みという3つの経路を同時に通る点に留意する必要があります。 これらの経路はそれぞれ独自の情報の流れを形成し、シーケンス内の相互関係の異なる側面を反映しています。
したがって、逆伝播では、これら3つの経路からの勾配を慎重に組み合わせる必要があります。 これは、研究者たちが並行する複数のルートから戻った後、それぞれの観察結果を統合して景観の全体像を把握する探検のようなものです。 まず、各ルートの出力で勾配が生成されます。 その後、残差接続を考慮してこれらの勾配を加算し、情報の整合性とバランスを保ちます。 こうした統合を経て初めて、モデルは、どこで誤差が生じたのか、どの影響が過小評価され、どの影響が過大評価されていたのかを正確に把握できるようになります。
   if(!DeActivation(NeuronOCL.getOutput(), cResidual.getGradient(),
                    cAttention.getGradient(), NeuronOCL.Activation()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cValue.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(cValue.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), NeuronOCL.getGradient(),
                       cValue.GetWindow(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
このアプローチにより、Graph Transformerを効果的に学習させることができます。 この手法は、大域的な相互依存関係と局所的な相互依存関係の両方を考慮し、個々の区間だけでなくルート全体にわたってそれらを調整します。 その結果、シーケンス内の各ノードについて、モデルの誤差における役割が適正に評価され、学習プロセスは一貫性と安定性を備え、最大限の情報を活用できるものとなります。
モデルパラメータの学習は、updateInputWeightsメソッドに実装されており、このメソッドはシステム全体の動作を調整するものと捉えることができます。 この段階では、このオブジェクトは自ら直接重みを調整するのではなく、この処理を内部コンポーネントに委ねます。
bool CNeuronGraphAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cGraphs.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cFeedForward[0].UpdateInputWeights(cResidual.AsObject()))
      return false;
   if(!cFeedForward[1].UpdateInputWeights(cFeedForward[0].AsObject()))
      return false;
//---
   return true;
  }
つまり、updateInputWeightsメソッドは、オブジェクト内のすべての演奏者を統率する指揮者のような役割を果たします。 それぞれのブロックが独自の役割を果たしていますが、全体としての調和は、それらが一体となって初めて実現されるものです。 その結果、モデルは、逆伝播中に特定された誤差から学習し、シーケンス内の要素間の重要な関係を強化することで、予測精度を徐々に高めていきます。
CNeuronGraphAttentionクラスの完全なソースコード(すべてのメソッドの実装を含む)は添付ファイルに記載されており、Graph Attentionの背後にある概念的なアイデアが、動的な金融時系列を分析できる実用的なメカニズムへとどのように変換されているかを示しています。
スパースSoftMax
次のステップは、局所Attentionモジュール用の疎グラフを作成することです。 その一方で、グラフ生成オブジェクトを全面的に見直す必要はありません。基本的なアーキテクチャと動作ロジックを維持しつつ、最小限の変更で十分です。 前述のGraph Attentionモジュールでは、出力として生成された依存関係のグラフがSoftMax関数を用いて確率分布に変換され、より重要な相互作用が強調されます。
局所Attentionの段階では、さらに一歩踏み込むことができます。 確率の低い接続をゼロにし、重要な相互依存関係だけを残します。 このアプローチにより、計算リソースをノード間の最も重要な相互作用に集中させることができます。これは、金融時系列の局所的な変動を分析する際に特に重要です。 実際には、これは経験豊富なアナリストの仕事と似ています。彼らは、重要度の低いシグナルをすべて精査するのではなく、現在のトレンドに実際に影響を与える極めて重要な要因にのみ焦点を当てています。
モデルをさらに最適化するために、出力側で、有効かつ重要な接続のみを格納する疎行列を生成します。 これにより、情報量を損なうことなく、メモリ使用量を大幅に削減し、計算速度を向上させることができます。 この疎な構造により、モデルは計算ブロックに過度な負荷をかけることなく、長い時間ウィンドウや複雑なシーケンスを処理できます。また、局所Attentionは、微細な影響を特定するための高速かつ高精度なツールとなります。
最終的に、このアプローチは2つの戦略的利点を兼ね備えています。 一方では、ST-Expertのグラフで定義された大域的なつながりが維持され、市場の全体像を把握できます。他方では、疎行列を通じて特定された局所的なつながりにより、極めて重要な細かな相互作用に焦点を当てることができます。
疎な局所Attentionの具体的な実装は、スパースSoftMaxアルゴリズムをOpenCLプログラム側に作成することから始めます。 その役割は、グラフブロックから得られた接続確率をAttention分布に変換すると同時に、重要度の低い要素をゼロに設定し、疎行列を作成することです。
__kernel void SparseSoftMax(__global const float *data,
                            __global float *outputs,
                            __global float *indexes,
                            const int out_dimension
                           )
  {
   const size_t row = get_global_id(0);
   const size_t col_in = get_local_id(1);
   const int total_rows = (int)get_global_size(0);
   const int total_cols_in = (int)get_local_size(1);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int ls = min(total_cols_in, (int)LOCAL_ARRAY_SIZE);
各ワーカースレッドは、入力データ配列のそれぞれ異なる行を処理します。各行は、ノード間の関係の確率を表します。 まず、値の妥当性がチェックされます。NaNや無限大の値は除外され、最小値に置き換えられます。 その後、各スレッドは、自身が扱う値の行内の他の要素に対する順位を計算します。 値が重要度の最も低いものに含まれる場合、その値はゼロに設定されます。
   const int shift_in = RCtoFlat(row, col_in, total_rows, total_cols_in, 0);
//--- calc position
   float value = IsNaNOrInf(data[shift_in], MIN_VALUE);
   int position = 0;
   for(int l = 0; l < total_cols_in; l += ls)
     {
      if(col_in >= l && col_in < (l + ls))
         Temp[col_in - l] = value;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (col_in - l))
            continue;
         if(Temp[i] > value)
            position++;
         else
            if(Temp[i] == value && i < (col_in - l))
               position++;
        }
      BarrierLoc;
     }
その後、残りの要素に通常のSoftMax関数を適用しますが、正規化は要素のサブグループごとに局所的におこないます。
//--- SoftMax
   if(position >= out_dimension)
      value = MIN_VALUE;
   value = LocalSoftMax(value, 1, Temp);
//--- result
   const int shift_out = RCtoFlat(row, position, total_rows, out_dimension, 0);
   if(position < out_dimension)
     {
      outputs[shift_out] = value;
      indexes[shift_out] = (float)col_in;
     }
  }
このアプローチにより、数値計算の安定性を維持しつつ、最も重要な関係のみを考慮することが可能になります。 出力は疎行列となります。指定された閾値を超える値は保持され、それ以外の値はすべて無視されるため、データ量が大幅に削減され、モデルの効率が向上します。
最終的な結果は、次の2つの配列で構成されます。
- outputs:重要な接続の正規化された値のみを格納
- indexes:これらのアクティブな要素の位置を記録
この情報は局所Attentionモジュールですぐに利用でき、モデルはメモリや計算リソースに過度な負荷をかけることなく、系列内のノード間の重要な局所的相互作用に焦点を当てることができます。
メインプログラム側では、新しいCNeuronSparseSoftMaxオブジェクトを作成します。このオブジェクトは、CNeuronSoftMaxOCL層から基本機能を継承し、疎な分布の処理に特化しています。 標準のSoftMaxとは異なり、このオブジェクトでは、メモリ使用量を削減して計算効率を高めながら、系列内の要素間の最も重要な接続だけにAttentionを集中させることができます。
class CNeuronSparseSoftMax    :  public CNeuronSoftMaxOCL
  {
protected:
   uint              iDimensionIn;
   CBufferFloat      cIndexes;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSparseSoftMax(void) {};
                    ~CNeuronSparseSoftMax(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint dimension_in, uint dimension_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual int       Type(void) override const { return defNeuronSparseSoftMax; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual CBufferFloat* GetIndexes(void)  { return GetPointer(cIndexes); }
   virtual uint      DimensionOut(void) const {  return uint(Neurons() / iHeads); }
  };
このクラスは、入力データの次元数を示すiDimensionInと、アクティブな接続のインデックスを格納するバッファcIndexesを保持します。このバッファの値は、Attention分布の形成時に考慮する要素を指します。 feedForwardメソッドとcalcInputGradientsメソッドは、OpenCLプログラム内の順伝播カーネルと逆伝播カーネルのラッパーです。これにより、モデルはアクティブで意味のある接続のみを考慮しながら、データを正しく処理し、誤差から学習できます。
このオブジェクトはInitメソッドで初期化され、このメソッドでは、スパースなAttention分布を扱うためのモデルの準備がおこなわれます。
bool CNeuronSparseSoftMax::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint dimension_in, uint dimension_out,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(dimension_in < dimension_out)
      return false;
   if(!CNeuronSoftMaxOCL::Init(numOutputs, myIndex, open_cl, units * dimension_out, optimization_type, batch))
      return false;
まず、入力の次元数が適切かどうかを確認します。モデルが分布を正しく形成できるように、dimension_inはdimension_out以上でなければなりません。 次に、基底クラスが初期化されます。
その後、Attentionヘッドの数を設定し、入力データの次元数を保存して、有効で意味のある接続のみを格納するためのインデックスバッファcIndexesを作成します。
   SetHeads(units);
   iDimensionIn = dimension_in;
   if(!cIndexes.BufferInit(Neurons(), -1) ||
      !cIndexes.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
バッファは初期化され、計算を高速化するためのOpenCL対応も含めて、メモリが割り当てられます。 その結果、このオブジェクトは動作の準備が完全に整い、入力データを受け取り、重要な接続を特定し、リソースを効率的に使用しながら疎なAttention分布を形成できる状態になります。
このように、CNeuronSparseSoftMaxは、局所Attentionの疎グラフを、最も重要な相互接続にAttentionが集中する、扱いやすく効率的な分布へと変換します。 これにより、モデルは、ST-Expertのメイングラフによって定義される全体像を維持しつつ、局所的な影響を正確に考慮し、金融時系列の詳細かつ有益な予測を生成できます。
このモデルで局所Attentionを構成するには、最小限の効果的な変更を加えるだけで十分です。 すでに実装済みのグラフTransformerオブジェクトを使い、そのSoftMax確率投影モジュールを、疎なバージョンであるCNeuronSparseSoftMaxに置き換えることができます。 このアプローチにより、大域的なグラフの接続関係とブロックのロジックを維持しながら、アーキテクチャ全体の再構築を回避でき、同時に局所的な相互影響を正確に特定できます。
スパースSoftMaxは、ノード間の最も重要な接続に焦点を当て、重要度の低い接続を無視することで、メモリと計算リソースの使用を最適化します。
class CNeuronSparseGraphAttention   :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL       cValue;
   CNeuronGraphons      cGraphs;
   CNeuronSparseSoftMax cScores;
   CNeuronBaseOCL       cAttention;
   CNeuronBaseOCL       cResidual;
   CNeuronConvOCL       cFeedForward[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSparseGraphAttention(void) {};
                    ~CNeuronSparseGraphAttention(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint experts, float dropout,
                          uint emb_dimension, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronSparseGraphAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
ここで紹介したすべてのクラスの完全なコードと、各メソッドの実装内容は、この記事の添付ファイルでご覧いただけます。
ここまでで多大な取り組みをおこない、大きな成果を上げました。 今は、情報をしっかりと理解し、記憶に定着させるために、少し休憩を取る絶好のタイミングです。 次回の記事では、今回の続きから始め、実装したソリューションの有効性を評価し、このモデルが金融時系列の分析にどの程度うまく対応できるかを確認していきます。
結論
これまでの取り組みでは、困難な道のりを歩みながら、Graph Transformerのアーキテクチャを探求し、その主要な構成要素であるValueブロック、依存グラフ、Attention分布への理解を深めてきました。 これらの要素は、金融市場という複雑で刻々と変化する地形の中で、協力して進路を描く探検隊員のように、それぞれの役割を果たしました。
局所AttentionのためのスパースSoftMaxの実装には、特に注意を払いました。 このツールにより、モデルは重要度の低いシグナルを無視しつつ、最も重要な相関関係を特定できるようになり、リソースを節約するとともに、市場の動向に対応する精度を向上させることができました。 順伝播と逆伝播、および重み更新によって継続的な軌道修正が行われ、モデルは自らの誤りから学び、予測を徐々に改善することができました。
得られた結果は、今後の研究に向けた強固な基盤となりました。 次回の記事では、導入したソリューションの有効性を評価し、予測の精度を分析し、モデルが金融時系列の変動にどの程度適切に対応できているかを検証することで、この探求をさらに進めていきます。
リンク
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19624
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


記事「トレーディングにおけるニューラルネットワーク:あらゆる市場状況下で安定した売買シグナル(アテンション・モジュール)」 が公開されました:
著者:Dmitriy Gizlyk