Artikel über das Programmieren in MQL4 und MQL5

Lernen Sie die Sprache von Handelsstrategien MQL5 nach den hier veröffentlichten Artikeln, die meisten von denen Sie - die Mitglieder der Community - geschrieben haben. Alle Artikel sind in drei Kategorien aufgeteilt, damit man eine Antwort auf unterschiedliche Fragen des Programmierens schnell finden könnte: "Integration", "Tester", "Handelsstrategien" und vieles mehr.
Verfolgen Sie neue Veröffentlichungen und diskutieren Sie über diese im Forum!
Neuer Artikel

Sie verpassen Handelsmöglichkeiten:
- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Registrierung
Einloggen
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Wenn Sie kein Benutzerkonto haben, registrieren Sie sich

Algorithmen zur Optimierung mit Populationen: Algorithmus des Mind Evolutionary Computation (MEC)
Der Artikel befasst sich mit einem Algorithmus aus der MEC-Familie, dem Simple Mind Evolutionary Computation Algorithmus (Simple MEC, SMEC). Der Algorithmus zeichnet sich durch die Schönheit seiner Idee und die Einfachheit seiner Umsetzung aus.

Algorithmen zur Optimierung mit Populationen: Der Algorithmus Charged System Search (CSS)
In diesem Artikel werden wir einen weiteren Optimierungsalgorithmus betrachten, der von der unbelebten Natur inspiriert ist - den CSS-Algorithmus (Charged System Search, Suche geladener Systeme). In diesem Artikel wird ein neuer Optimierungsalgorithmus vorgestellt, der auf den Prinzipien der Physik und Mechanik beruht.

Aufbau eines Modells aus Kerzen, Trend und Nebenbedingungen (Teil 3): Erkennung von Trendänderungen bei der Verwendung dieses Systems
In diesem Artikel wird untersucht, wie Wirtschaftsnachrichten, das Anlegerverhalten und verschiedene Faktoren die Trendumkehr an den Märkten beeinflussen können. Es enthält eine Videoerklärung und fährt fort mit der Integration von MQL5-Code in unser Programm, um Trendumkehrungen zu erkennen, uns zu warnen und geeignete Maßnahmen auf der Grundlage der Marktbedingungen zu ergreifen. Dieser Artikel knüpft an frühere Artikel der Reihe an.

PSAR, Heiken Ashi und Deep Learning gemeinsam für den Handel nutzen
Dieses Projekt erforscht die Verschmelzung von Deep Learning und technischer Analyse, um Handelsstrategien im Forex-Bereich zu testen. Für schnelle Experimente wird ein Python-Skript verwendet, das ein ONNX-Modell neben traditionellen Indikatoren wie PSAR, SMA und RSI einsetzt, um die Entwicklung des EUR/USD vorherzusagen. Ein MetaTrader 5-Skript bringt diese Strategie dann in eine Live-Umgebung und nutzt historische Daten und technische Analysen, um fundierte Handelsentscheidungen zu treffen. Die Backtesting-Ergebnisse deuten auf einen vorsichtigen, aber konsequenten Ansatz hin, bei dem der Schwerpunkt eher auf Risikomanagement und stetigem Wachstum als auf aggressivem Gewinnstreben liegt.

Einen handelnden Expert Advisor von Grund auf neu entwickeln (Teil 27): Der Zukunft entgegen (II)
Gehen wir nun zu einem vollständigeren Auftragssystem direkt auf dem Chart über. In diesem Artikel zeige ich einen Weg, das Auftragssystem zu reparieren, oder besser gesagt, es intuitiver zu gestalten.


Integration von ML-Modellen mit dem Strategy Tester (Schlussfolgerung): Implementierung eines Regressionsmodells für die Preisvorhersage
Dieser Artikel beschreibt die Implementierung eines Regressionsmodells auf der Grundlage eines Entscheidungsbaums. Das Modell soll die Preise von Finanzanlagen vorhersagen. Wir haben die Daten bereits aufbereitet, das Modell trainiert und evaluiert, sowie angepasst und optimiert. Es ist jedoch wichtig zu beachten, dass dieses Modell nur für Studienzwecke gedacht ist und nicht im realen Handel eingesetzt werden sollte.

Kategorientheorie in MQL5 (Teil 16): Funktoren mit mehrschichtigen Perceptrons
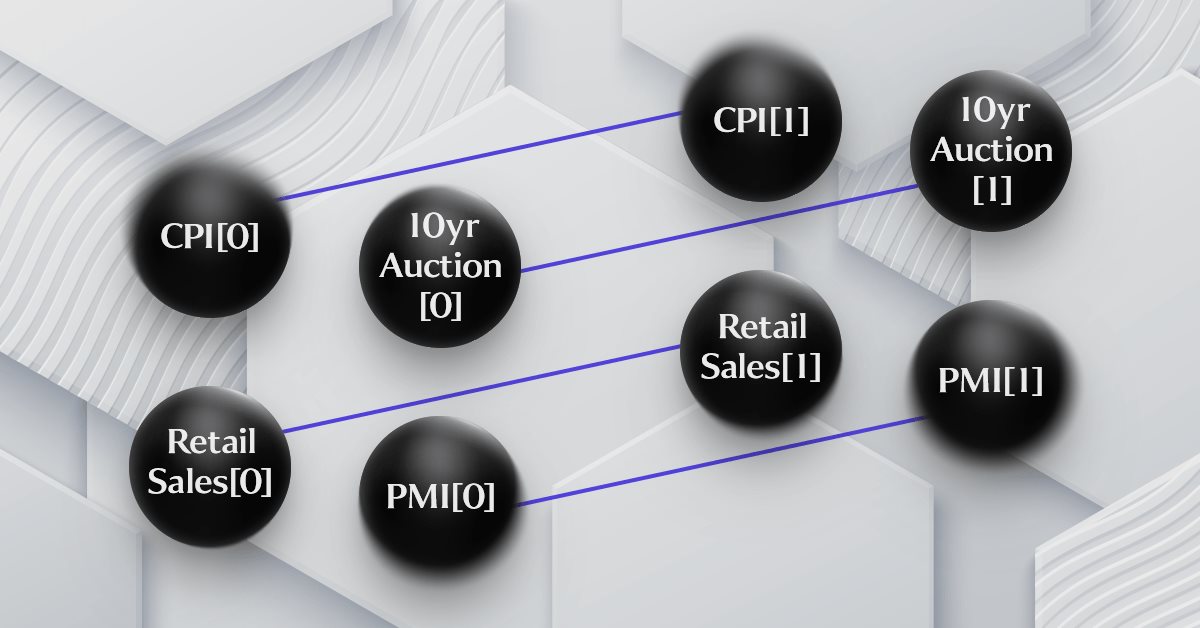
In diesem Artikel, dem 16. in unserer Reihe, geht es weiter mit einem Blick auf Funktoren und wie sie mit künstlichen neuronalen Netzen implementiert werden können. Wir weichen von unserem bisherigen Ansatz der Volatilitätsprognose ab und versuchen, eine nutzerdefinierte Signalklasse zum Setzen von Ein- und Ausstiegssignalen zu implementieren.


Algorithmen zur Optimierung mit Populationen: Umformen, Verschieben von Wahrscheinlichkeitsverteilungen und der Test auf Smart Cephalopod (SC)
Der Artikel untersucht die Auswirkungen einer Formveränderung von Wahrscheinlichkeitsverteilungen auf die Leistung von Optimierungsalgorithmen. Wir werden Experimente mit dem Testalgorithmus Smart Cephalopod (SC) durchführen, um die Effizienz verschiedener Wahrscheinlichkeitsverteilungen im Zusammenhang mit Optimierungsproblemen zu bewerten.

Erstellen eines integrierten MQL5-Telegram Expert Advisors (Teil 5): Senden von Befehlen von Telegram an MQL5 und Empfangen von Antworten in Echtzeit
In diesem Artikel erstellen wir mehrere Klassen, um die Echtzeitkommunikation zwischen MQL5 und Telegram zu erleichtern. Wir konzentrieren uns darauf, Befehle von Telegram abzurufen, sie zu entschlüsseln und zu interpretieren und entsprechende Antworten zurückzusenden. Am Ende stellen wir sicher, dass diese Interaktionen effektiv getestet werden und in der Handelsumgebung funktionieren.

Einführung in MQL5 (Teil 9): Verstehen und Verwenden von Objekten in MQL5
Lernen Sie, wie Sie Chart-Objekte in MQL5 mit aktuellen und historischen Daten erstellen und anpassen. Dieser projektbasierte Leitfaden hilft Ihnen bei der Visualisierung von Handelsgeschäften und der praktischen Anwendung von MQL5-Konzepten, was die Erstellung von Tools, die auf Ihre Handelsanforderungen zugeschnitten sind, erleichtert.


Developing a Replay System — Market simulation (Part 13): Die Geburt des SIMULATORS (III)
Hier werden wir einige Elemente im Zusammenhang mit der Arbeit im nächsten Artikel vereinfachen. Ich erkläre auch, wie Sie sich vorstellen können, was der Simulator in Bezug auf die Zufälligkeit erzeugt.

Implementierung eines ARIMA-Trainingsalgorithmus in MQL5
In diesem Artikel wird ein Algorithmus implementiert, der das autoregressive integrierte gleitende Durchschnittsmodell von Box und Jenkins unter Verwendung der Powells-Methode der Funktionsminimierung anwendet. Box und Jenkins stellten fest, dass die meisten Zeitreihen mit einem oder beiden Rahmen modelliert werden können.


Datenwissenschaft und maschinelles Lernen (Teil 20): Algorithmische Handelseinblicke, eine Gegenüberstellung von LDA und PCA in MQL5
Entdecken Sie die Geheimnisse dieser leistungsstarken Dimensionsreduktionstechniken, indem wir ihre Anwendungen in der MQL5-Handelsumgebung analysieren. Vertiefen Sie sich in die Feinheiten der linearen Diskriminanzanalyse (LDA) und der Hauptkomponentenanalyse (PCA) und gewinnen Sie ein tiefes Verständnis für deren Auswirkungen auf die Strategieentwicklung und Marktanalyse,


Chaostheorie im Handel (Teil 2): Tiefer tauchen
Wir setzen unsere Untersuchung der Chaostheorie auf den Finanzmärkten fort. Dieses Mal werde ich seine Anwendbarkeit auf die Analyse von Währungen und anderen Vermögenswerten untersuchen.


Schnellhandel meistern: Überwindung der Umsetzungslähmung
Der Indikator UT BOT ATR Trailing ist ein persönlicher und anpassbarer Indikator, der sehr effektiv für Händler ist, die gerne schnelle Entscheidungen treffen und Geld aus Preisunterschieden machen, die als kurzfristiger Handel bezeichnet werden (Scalper), und sich auch als wichtig und sehr effektiv für langfristige Händler (positionelle Händler) erweist.

Entwicklung eines Replay-Systems — Marktsimulation (Teil 02): Erste Versuche (II)
Diesmal wollen wir einen anderen Ansatz wählen, um das 1-Minuten-Ziel zu erreichen. Diese Aufgabe ist jedoch nicht so einfach, wie man vielleicht denkt.

Die Kategorientheorie in MQL5 (Teil 1)
Die Kategorientheorie ist ein vielfältiger und expandierender Zweig der Mathematik, der in der MQL-Gemeinschaft noch relativ unentdeckt ist. In dieser Artikelserie sollen einige der Konzepte vorgestellt und untersucht werden, mit dem übergeordneten Ziel, eine offene Bibliothek einzurichten, die zu Kommentaren und Diskussionen anregt und hoffentlich die Nutzung dieses bemerkenswerten Bereichs für die Strategieentwicklung der Händler fördert.


Neuronale Netze leicht gemacht (Teil 64): Die Methode konservativ gewichtetes Klonen von Verhaltensweisen (CWBC)
Aufgrund von Tests, die in früheren Artikeln durchgeführt wurden, kamen wir zu dem Schluss, dass die Optimalität der trainierten Strategie weitgehend von der verwendeten Trainingsmenge abhängt. In diesem Artikel werden wir uns mit einer relativ einfachen, aber effektiven Methode zur Auswahl von Trajektorien für das Training von Modellen vertraut machen.

Einführung in MQL5 (Teil 10): Eine Anleitung für Anfänger zur Arbeit mit den integrierten Indikatoren in MQL5
Dieser Artikel führt in die Arbeit mit integrierten Indikatoren in MQL5 ein und konzentriert sich auf die Erstellung eines RSI-basierten Expert Advisors (EA) mit einem projektbasierten Ansatz. Sie werden lernen, RSI-Werte abzurufen und zu nutzen, Liquiditätsdurchbrüche zu handhaben und die Handelsvisualisierung mit Chart-Objekten zu verbessern. Darüber hinaus wird in dem Artikel ein wirksames Risikomanagement hervorgehoben, einschließlich der Festlegung eines prozentualen Risikos, der Umsetzung von Risiko-Ertrags-Verhältnissen und der Anwendung von Risikomodifikationen zur Sicherung von Gewinnen.


Datenwissenschaft und maschinelles Lernen (Teil 19): Überladen Sie Ihre AI-Modelle mit AdaBoost
AdaBoost, ein leistungsstarker Boosting-Algorithmus, der die Leistung Ihrer KI-Modelle steigert. AdaBoost, die Abkürzung für Adaptive Boosting, ist ein ausgeklügeltes Ensemble-Lernverfahren, das schwache Lerner nahtlos integriert und ihre kollektive Vorhersagestärke erhöht.

MetaTrader 5 Machine Learning Blueprint (Teil 1): Datenlecks und Zeitstempelfehler
Bevor wir überhaupt damit beginnen können, ML für unseren Handel auf dem MetaTrader 5 zu nutzen, müssen wir uns mit einem der am meisten übersehenen Fallstricke befassen - dem Datenleck. In diesem Artikel wird erläutert, wie Datenlecks, insbesondere die Falle von MetaTrader 5-Zeitstempel, die Leistung unseres Modells verzerren und zu unzuverlässigen Handelssignalen führen können. Indem wir uns mit den Mechanismen dieses Problems befassen und Strategien zu seiner Vermeidung vorstellen, ebnen wir den Weg für den Aufbau robuster Modelle für maschinelles Lernen, die zuverlässige Vorhersagen in Live-Handelsumgebungen liefern.


Neuronale Netze leicht gemacht (Teil 37): Sparse Attention (Verringerte Aufmerksamkeit)
Im vorigen Artikel haben wir relationale Modelle erörtert, die in ihrer Architektur Aufmerksamkeitsmechanismen verwenden. Eines der besonderen Merkmale dieser Modelle ist die intensive Nutzung von Computerressourcen. In diesem Artikel wird einer der Mechanismen zur Verringerung der Anzahl von Rechenoperationen innerhalb des Self-Attention-Blocks betrachtet. Dadurch wird die allgemeine Leistung des Modells erhöht.


Datenkennzeichnung für die Zeitreihenanalyse (Teil 4):Deutung der Datenkennzeichnungen durch Aufgliederung
In dieser Artikelserie werden verschiedene Methoden zur Kennzeichnung (labeling) von Zeitreihen vorgestellt, mit denen Daten erstellt werden können, die den meisten Modellen der künstlichen Intelligenz entsprechen. Eine gezielte und bedarfsgerechte Kennzeichnung von Daten kann dazu führen, dass das trainierte Modell der künstlichen Intelligenz besser mit dem erwarteten Design übereinstimmt, die Genauigkeit unseres Modells verbessert wird und das Modell sogar einen qualitativen Sprung machen kann!

Quantisierung beim maschinellen Lernen (Teil 1): Theorie, Beispielcode, Analyse der Implementierung in CatBoost
Der Artikel befasst sich mit der theoretischen Anwendung der Quantisierung bei der Konstruktion von Baummodellen und stellt die in CatBoost implementierten Quantisierungsmethoden vor. Es werden keine komplexen mathematischen Gleichungen verwendet.


Entwicklung eines Replay System (Teil 32): Auftragssystem (I)
Von allen Dingen, die wir bisher entwickelt haben, ist dieses System, wie Sie wahrscheinlich bemerken und letztendlich zustimmen werden, das komplexeste. Nun müssen wir etwas sehr Einfaches tun: unser System soll den Betrieb eines Handelsservers simulieren. Die Notwendigkeit, die Funktionsweise des Handelsservers genau zu implementieren, scheint eine Selbstverständlichkeit zu sein. Zumindest in Worten. Aber wir müssen dies so tun, dass alles nahtlos und transparent für den Nutzer des Wiedergabe-/Simulationssystems ist.


Schildkrötenpanzer-Evolutionsalgorithmus (TSEA)
Dies ist ein einzigartiger Optimierungsalgorithmus, der von der Evolution des Schildkrötenpanzers inspiriert wurde. Der TSEA-Algorithmus emuliert die allmähliche Bildung keratinisierter Hautbereiche, die optimale Lösungen für ein Problem darstellen. Die besten Lösungen werden „härter“ und befinden sich näher an der Außenfläche, während die weniger erfolgreichen Lösungen „weicher“ bleiben und sich im Inneren befinden. Der Algorithmus verwendet eine Gruppierung der Lösungen nach Qualität und Entfernung, wodurch weniger erfolgreiche Optionen erhalten bleiben und Flexibilität und Anpassungsfähigkeit gewährleistet werden.


Entwicklung eines Replay Systems — Marktsimulation (Teil 18): Ticks und noch mehr Ticks (II).
Offensichtlich sind die aktuellen Metriken sehr weit von der idealen Zeit für die Erstellung eines 1-Minuten-Balkens entfernt. Das ist das erste, was wir in Angriff nehmen werden. Die Behebung des Synchronisationsproblems ist nicht schwierig. Das mag schwierig erscheinen, ist aber eigentlich ganz einfach. Wir haben die erforderliche Korrektur im vorigen Artikel nicht vorgenommen, da er darauf abzielte, zu erklären, wie man die Tick-Daten, die zur Erstellung der 1-Minuten-Balken im Chart verwendet wurden, in das Fenster der Marktübersicht überträgt.


Datenwissenschaft und maschinelles Lernen (Teil 17): Geld von Bäumen? Die Kunst und Wissenschaft der Random Forests im Devisenhandel
Entdecken Sie die Geheimnisse der algorithmischen Alchemie, während wir Sie durch die Mischung aus Kunstfertigkeit und Präzision bei der Entschlüsselung von Finanzlandschaften führen. Entdecken Sie, wie Random Forests Daten in Vorhersagefähigkeiten umwandeln und eine einzigartige Perspektive für die Navigation auf dem komplexen Terrain der Aktienmärkte bieten. Begleiten Sie uns auf dieser Reise in das Herz der Finanzmagie, wo wir die Rolle von Random Forests bei der Gestaltung des Marktgeschehens entmystifizieren und die Türen zu lukrativen Gelegenheiten aufschließen


Filterung und Merkmalsextraktion von Frequenzen
In diesem Artikel untersuchen wir die Anwendung digitaler Filter auf Zeitreihen, die im Frequenzbereich dargestellt werden, um einzigartige Merkmale zu extrahieren, die für Vorhersagemodelle nützlich sein können.

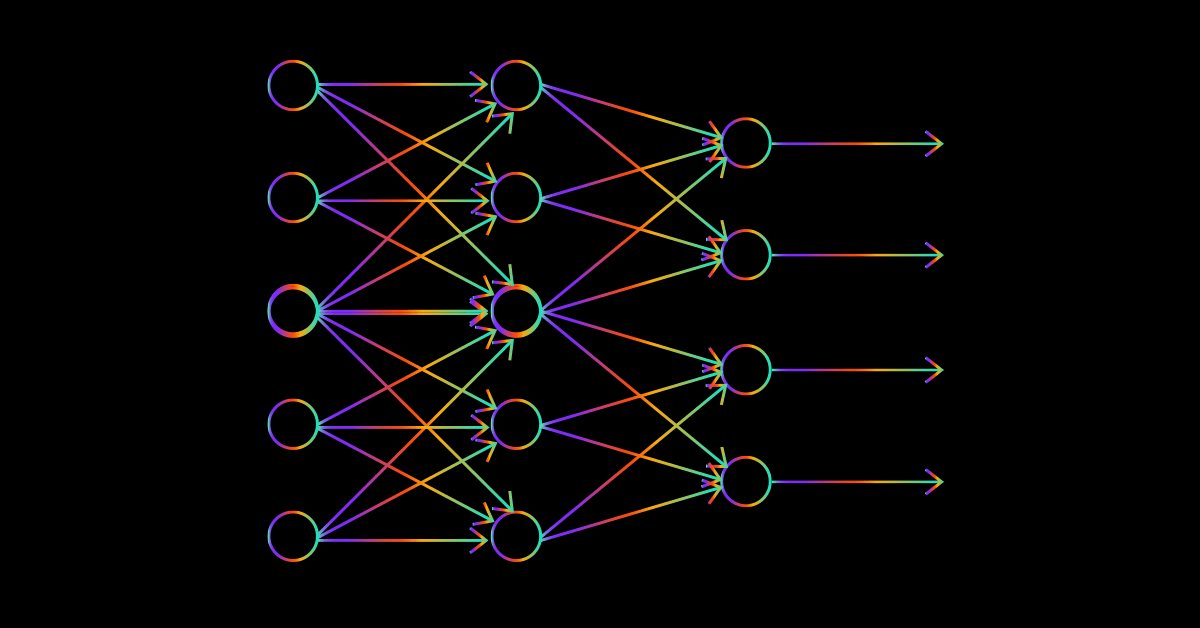
Datenwissenschaft und maschinelles Lernen — Neuronales Netzwerk (Teil 02): Entwurf von Feed Forward NN-Architekturen
Bevor wir fertig sind, müssen wir noch einige kleinere Dinge im Zusammenhang mit dem neuronalen Feed-Forward-Netz behandeln, unter anderem den Entwurf. Sehen wir uns an, wie wir ein flexibles neuronales Netz für unsere Eingaben, die Anzahl der verborgenen Schichten und die Knoten für jedes Netz aufbauen und gestalten können.


Entwicklung einer Zone Recovery Martingale Strategie in MQL5
In diesem Artikel werden die Schritte, die für die Erstellung eines auf dem Zone Recovery-Handelsalgorithmus basierenden Expert Advisors erforderlich sind, ausführlich beschrieben. Dies hilft, das System zu automatisieren und spart den Algotradern Zeit.

Automatisieren von Handelsstrategien in MQL5 (Teil 6): Beherrschen der Erkennung von Auftragsblöcken für den Handel des Smart Money
In diesem Artikel automatisieren wir das Erkennen von Auftragsblöcken in MQL5 mithilfe der reinen Preisaktionsanalyse. Wir definieren Auftragsblöcke, implementieren ihre Erkennung und integrieren die automatische Handelsausführung. Schließlich führen wir einen Backtest der Strategie durch, um ihre Leistung zu bewerten.


Der Kalman-Filter für Forex-Strategien der Rückkehr zur Mitte
Der Kalman-Filter ist ein rekursiver Algorithmus, der im algorithmischen Handel verwendet wird, um den wahren Zustand einer Finanzzeitreihe durch Herausfiltern von Rauschen aus den Preisbewegungen zu schätzen. Er aktualisiert die Vorhersagen dynamisch auf der Grundlage neuer Marktdaten, was ihn für adaptive Strategien wie Mean Reversion wertvoll macht. In diesem Artikel wird zunächst der Kalman-Filter vorgestellt und seine Berechnung und Anwendung erläutert. Als nächstes wenden wir den Filter auf eine klassische Devisenstrategie, der Rückkehr zur Mitte, als Beispiel an. Schließlich führen wir verschiedene statistische Analysen durch, indem wir den Filter mit einem gleitenden Durchschnitt für verschiedene Devisenpaare vergleichen.


Популяционные алгоритмы оптимизации: Гибридный алгоритм оптимизации бактериального поиска с генетическим алгоритмом (Bacterial Foraging Optimization - Genetic Algorithm, BFO-GA)
В статье представлен новый подход к решению оптимизационных задач, путём объединения идей алгоритмов оптимизации бактериального поиска пищи (BFO) и приёмов, используемых в генетическом алгоритме (GA), в гибридный алгоритм BFO-GA. Он использует роение бактерий для глобального поиска оптимального решения и генетические операторы для уточнения локальных оптимумов. В отличие от оригинального BFO бактерии теперь могут мутировать и наследовать гены.

Kategorientheorie in MQL5 (Teil 15) : Funktoren mit Graphen
Dieser Artikel über die Implementierung der Kategorientheorie in MQL5 setzt die Serie mit der Betrachtung der Funktoren fort, diesmal jedoch als Brücke zwischen Graphen und einer Menge. Wir greifen die Kalenderdaten wieder auf und plädieren trotz der Einschränkungen bei der Verwendung von Strategy Tester für die Verwendung von Funktoren zur Vorhersage der Volatilität mit Hilfe der Korrelation.

Erstellen eines MQL5 Expert Advisors basierend auf der PIRANHA Strategie unter Verwendung von Bollinger Bändern
In diesem Artikel erstellen wir einen Expert Advisor (EA) in MQL5, der auf der PIRANHA-Strategie basiert und Bollinger-Bänder zur Verbesserung der Handelseffektivität nutzt. Wir erörtern die Grundprinzipien der Strategie, die kodierte Umsetzung und die Methoden zur Prüfung und Optimierung. Dieses Wissen ermöglicht es Ihnen, den EA in Ihren Handelsszenarien effektiv einzusetzen

Datenwissenschaft und ML (Teil 32): KI-Modelle auf dem neuesten Stand halten, Online-Lernen
In der sich ständig verändernden Welt des Handels ist die Anpassung an Marktveränderungen nicht nur eine Option, sondern eine Notwendigkeit. Täglich entstehen neue Muster und Trends, die es selbst den fortschrittlichsten Modellen für maschinelles Lernen erschweren, angesichts der sich verändernden Bedingungen effektiv zu bleiben. In diesem Artikel erfahren Sie, wie Sie Ihre Modelle durch ein automatisches Neu-Training relevant halten und auf neue Marktdaten reagieren können.


Formulierung eines dynamischen Multi-Paar-EA (Teil 4): Volatilität und Risikoanpassung
In dieser Phase erfolgt die Feinabstimmung Ihres Multi-Pair-EAs, um die Handelsgröße und das Risiko in Echtzeit anhand von Volatilitätsmetriken wie ATR anzupassen und so die Konsistenz, den Schutz und die Leistung unter verschiedenen Marktbedingungen zu verbessern.


Grafiken in der DoEasy-Bibliothek (Teil 91): Standard-Ereignisse für grafische Objekte. Geschichte der Objektnamensänderung
In diesem Artikel werde ich die Grundfunktionalität für die Kontrolle über grafische Objektereignisse in einem bibliotheksbasierten Programm verfeinern. Ich beginne mit der Implementierung der Funktionalität zur Speicherung der Änderungshistorie grafischer Objekte am Beispiel der Eigenschaft "Objektname".

Neuronale Netze leicht gemacht (Teil 40): Verwendung von Go-Explore bei großen Datenmengen
In diesem Artikel wird die Verwendung des Go-Explore-Algorithmus über einen langen Trainingszeitraum erörtert, da die Strategie der zufälligen Aktionsauswahl mit zunehmender Trainingszeit möglicherweise nicht zu einem profitablen Durchgang führt.