

取引におけるニューラルネットワーク:異質性を考慮したメタパラメータ学習(最終回)
 12
 0

はじめに
アルゴリズム取引では、過度に複雑な解決策も、正当な理由なく単純化しすぎた解決策も、ほとんど通用しません。 極めて複雑なニューラルネットワークのアンサンブルであれ、最小限の構成の自己回帰フィルターであれ、どのようなモデルも、最終的には時間と市場の試練に耐えなければなりません。 まさにこの観点から構想されたのが、HimNetです。このフレームワークは、学習可能なパラメータの数や計算手法の奇抜さで人目を引こうとするものではありません。 むしろ、安定性と再現性があり、経済的に意義のある結果をもたらすことに重点を置いています。
HimNetは当初から、他の多くのアプローチとは一線を画す3つの特徴を備えています。 第一に、アーキテクチャの合理性です。分析の深さを見せかけるだけの、過剰に複雑な層は含まれていません。 ここにあるすべてのモジュールは、機能的であり、存在意義があります。 第二に、適度な適応性です。このフレームワークは、市場の変動に伴うあらゆるノイズに無思慮に順応するのではなく、柔軟性と安定性のバランスを保っています。 そして第三に、パラメータ管理におけるミニマリズムです。HimNetは、学習可能な係数の数を必要最小限に抑えるように設計されています。 これにより、過去データへの過学習を回避し、時系列上で遠く離れた区間でも予測能力を維持できます。
これまでの研究では、このフレームワークの内部メカニズムを体系的に検討してきました。 理論的基礎から始めて、埋め込みの生成手法を詳しく検討し、再帰型の構成要素と畳み込みの構成要素がどのように補完し合うかを分析しました。 HimNetのアーキテクチャは、各部がうまく連携する機構のようなものです。チェビシェフ多項式ブロックであれ、GCRU機構であれ、一つひとつの歯車がそれぞれ明確な役割を担っています。 これは単なる技術の寄せ集めではなく、処理速度を損なうことも計算過程を過度に複雑にすることもなく、市場の情報を豊かに表現できるよう綿密に練られた設計です。
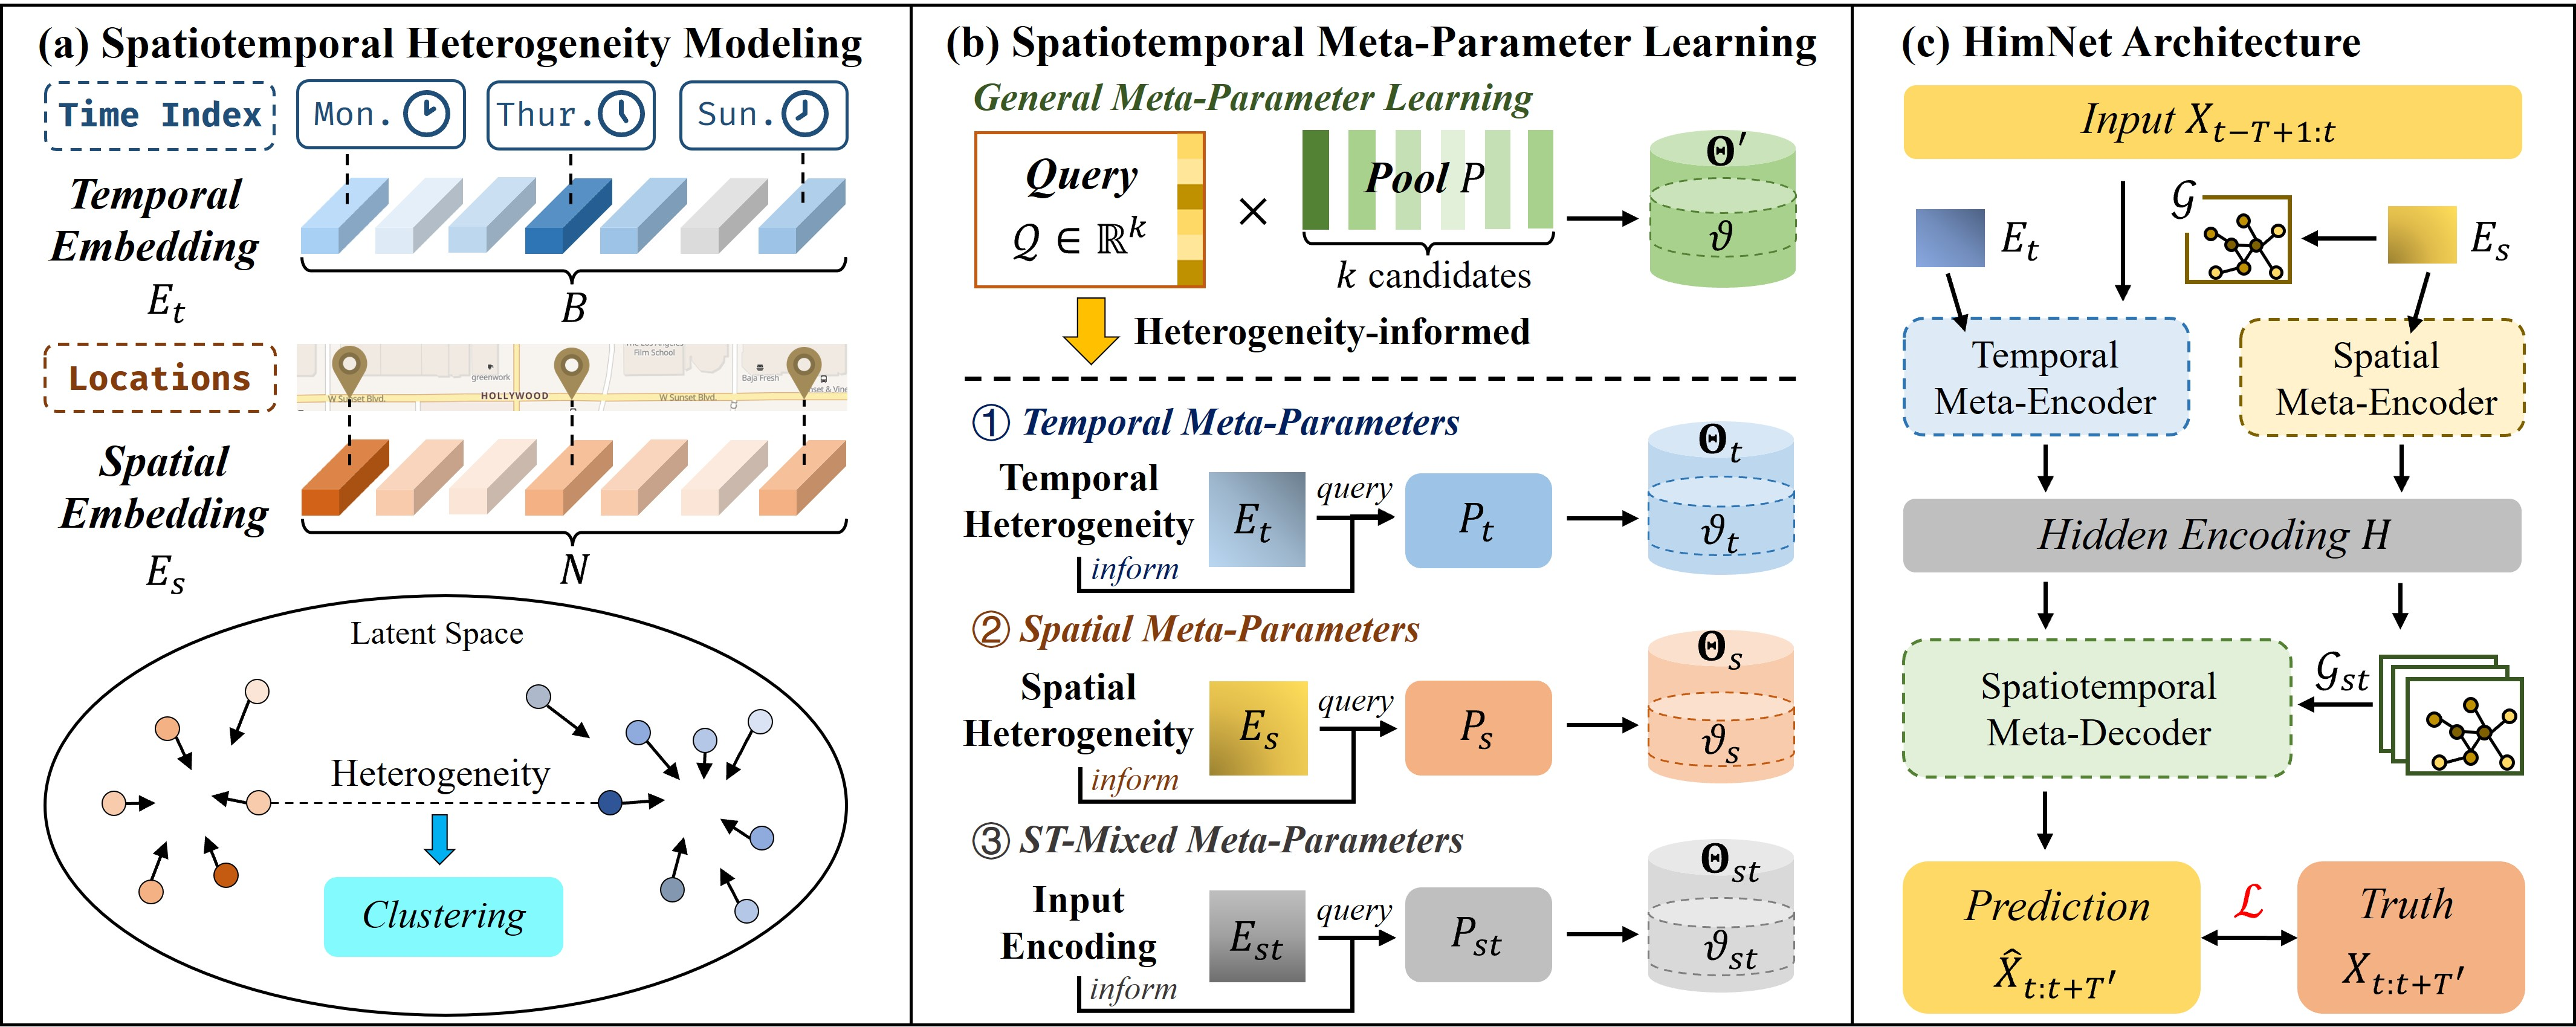
HimNetフレームワークは、古典的で、多くの点で長年にわたり有効性が実証されてきたEncoder-Decoderアーキテクチャに基づいて構築されています。 この方式は、複雑な系列を処理するタスクで有効性が実証されています。こうしたタスクでは、市場の現在の状態を捉えるだけでなく、その後の予測に向けて安定したパターンを抽出することも重要です。 EncoderとDecoderは共通の基盤を持ち、どちらも学習可能な埋め込みとグラフリカレントブロック(GCRU)を使用しています。 しかし、両者には、埋め込みが形成される仕組みそのものに、微妙ながらも重要な違いがあります。
Encoderでは、時間的および空間的な埋め込みが事前定義された集合から直接抽出され、メタパラメータのプールに対する一種のクエリとして使用されます。 これにより、Encoderは文脈に応じて適応できるようになります。
一方、Decoderは、Encoderの出力から合成された潜在表現に基づいて、間接的に埋め込みを生成します。 Decoderは、隠れ表現を時空間埋め込みに投影します。この埋め込みがSTメタパラメータモデルへのクエリとなり、Decoderによる重みの生成を可能にします。
すでに多くの準備作業をおこなってきました。具体的には、データに含まれる時空間的な依存関係を効果的に処理できるグラフリカレントブロックなど、モデルの基本構成要素を実装しました。 それでは、階層構造の次の段階へと進みましょう。EncoderとDecoderの本格的な構造を構築していきます。 この段階は、フレームワークの個々の要素と、その実践的な応用との架け橋となるものです。 ここで、抽象的なブロックが相互に接続され、データフローが将来の市場状態を意味のある形で表現し始めるのです。
Encoder
HimNetフレームワークの著者らは、空間的依存関係と時間的依存関係をそれぞれ個別のEncoderが担当する、2系統のデータ処理機構を用意しました。 このアプローチにより、異なる信号構造を混在させずに並列の分岐で解析し、主要なパターンをより正確かつ明確に特定することができます。 これまで紹介してきた考え方に基づき、今回はまずTemporal Encoderの構築から始めます。 何といっても、時間こそが、あらゆる市場の動きが織りなされる糸だからです。
Temporal Encoder
CNeuronHimNetTempEncoderオブジェクトは、このフレームワーク内の一種の時間フィルターであり、価格データの系列や市場パターンに潜む規則性を抽出するように設計されています。 さらに、この処理は複数のスケールで同時におこなわれます。
class CNeuronHimNetTempEncoder   : public CNeuronBaseOCL
  {
protected:
   uint              aTimeframes[2];
   CCircleParams     caEmbeddings[2];
   CNeuronBaseOCL    cConcatEmbeddings;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;

public:
                     CNeuronHimNetTempEncoder(void) {};
                    ~CNeuronHimNetTempEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support,
                                 int label);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetTempEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
//---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
重要な要素は、caEmbeddings配列によって表される 2 つの埋め込み集合です。 これらの辞書はそれぞれ、完全なデータではなく、個々の時間ステップのコンパクトな表現、すなわちモデルのパラメータプールに対するクエリとして機能する埋め込みのみを格納しています。 つまり、各時間ステップが実質的にアクセスするのは、それぞれに固有のパラメータ部分空間であり、そこから必要な値を取得することで、その後のデータフローを構成します。
両方の埋め込み集合が、協調的でありながらも独立した形で機能することを強調しておくことが重要です。これにより、モデルは2つの時間スケールを同時に捉えることができ、短期的なノイズと長期的な慣性を混同せずに済みます。 メソッドを実装していく中で、これらのクエリがデータストリームとどのように相互作用するか、またTemporal Encoderの他の構成要素がどのようなタスクを処理するのかを詳しく見ていきます。
すべての内部オブジェクトは静的に宣言されるため、コンストラクタとデストラクタは最小限に抑えられています。 宣言された構成要素および継承されたオブジェクトのすべてに対する実際の初期化は、Initメソッド内で一元的におこなわれます。
bool CNeuronHimNetTempEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint units, uint window, uint window_out, uint cheb_k,
                                    uint layers, uint embed_dim, uint period1,
                                    uint timeframe1, uint period2, uint timeframe2,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(layers <= 0)
      return false;
このアルゴリズムは、小さな制御ブロックから始まります。まず、Encoderの内部層の数をチェックします。 layersパラメータの値が0以下の場合、このメソッドは直ちに失敗します。 これにより、無意味な構成を防ぐことができます。層が存在しなければ、学習すべきものもないからです。
次に、親クラスにある同名のメソッドが呼び出され、そのオブジェクトの基本パラメータが渡されます。 このステップでは、Encoderの出力テンソルの形状を定義し、必要なリソースを確保します。 基本的な初期化に失敗した場合、操作を続行しても意味がないため、このメソッドはfalseを返します。
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
次に、埋め込み集合が準備され、時間ステップサイズが直ちにaTimeframes配列の対応する要素に格納されます。
   int index = 0;
   if(!caEmbeddings[0].Init(0, index, OpenCL, embed_dim, period1, optimization, iBatch))
      return false;
   aTimeframes[0] = MathMax(1, timeframe1);
   index ++;
   if(!caEmbeddings[1].Init(0, index, OpenCL, embed_dim, period2, optimization, iBatch))
      return false;
   aTimeframes[1] = MathMax(1, timeframe2);
   if(!cConcatEmbeddings.Init(numOutputs, myIndex, open_cl, 2 * embed_dim, optimization_type, batch))
      return false;
各埋め込み辞書は、それぞれ固有の時間粒度に合わせて構成されます。埋め込みのサイズと周期によって、パラメータプールに送られる時間的なクエリが具体的に決まります。 これらの初期化処理のいずれかが失敗した場合、このメソッドは処理を中止します。Encoderが部分的にしか組み立てられていない状態は許容しません。
辞書が定義された後、cConcatEmbeddingsオブジェクトが作成されます。これは、2つの埋め込みを1つのベクトルに結合するオブジェクトです。
次に、GRCU層の構築が始まります。 まず、cGRCUsコンテナをクリアし、OpenCLコンテキストを明示的にバインドします。
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
      return false;
次に、最初のCNeuronHimNetGCRUオブジェクトを作成し、第1層のパラメータを用いて初期化します。この層では、入力特徴の数は分析対象の時系列の対応する次元数と同じに設定され、出力次元は潜在表現の次元数に設定されます。 この最初の層が、スタックの最下層となります。
初期化に成功した場合、その層はcGRCUsコンテナに追加されます。 追加または初期化に失敗した場合は、falseを返します。
それ以降のすべての層では、処理ロジックがやや単純になります。 ループ内で追加のCNeuronHimNetGCRUオブジェクトが作成されますが、この時点では入力テンソルと出力テンソルの次元が同じになっています。 これは標準的な手法です。最初の層が文脈を拡張して集約し、後続の層がこの文脈をさらに深く精緻化します。 作成、初期化、追加のいずれかの段階で何らかの失敗が発生した場合は、システムが不整合な状態に陥らないよう、メソッドからfalseを返して安全に終了します。
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
         return false;
     }
GRCUスタックが形成されたら、補助バッファbSupportAccumを初期化します。このバッファは、Encoderの各層から得られるチェビシェフ多項式の誤差勾配を蓄積するために使用されます。
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(units * units * cheb_k, 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
次に、実装上重要な点があります。Encoderの出力は、cGRCUsコンテナ内の最後のオブジェクトの出力となります。 大きなテンソルの不必要なコピーを避けるため、活性化関数に加え、結果バッファおよび勾配バッファへのポインタも同期させます。 つまり、Encoderは最終層の活性化の仕様を引き継ぎ、外部インターフェースの参照先を最後のGRCUの内部バッファに直接設定します。 これにより、メモリと処理時間の両方で大幅な節約が実現されます。
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
オブジェクトの初期化が完了したら、Temporal Encoderの中核となる機能、すなわち順伝播メソッドfeedForwardの作成に移ります。
bool CNeuronHimNetTempEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support, int label)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
     {
      int position = (label / int(aTimeframes[i])) % caEmbeddings[i].GetPeriod();
      if(!caEmbeddings[i].SetPosition(position) ||
         !caEmbeddings[i].FeedForward())
         return false;
     }
   if(!Concat(caEmbeddings[0].getOutput(), caEmbeddings[1].getOutput(),
              cConcatEmbeddings.getOutput(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
このアルゴリズムでは、まず埋め込み辞書から埋め込みを取得します。 この処理は、配列内の辞書を順次処理するループとして構成されています。 各辞書について、外部プログラムから受け取ったタイムスタンプに基づいて、現在の位置を算出します。 次に、対応する辞書のFeedForwardメソッドを呼び出すことで、特定の時間埋め込みを生成します。
要するに、ここで時間を、専用の重みを取得するためのアドレスに変換します。 取引に例えると、特定の時間帯になった際に、モデルを再学習させることなく、適切なモデル構成を選択します。つまり、単に別のクエリを使用するだけです。
両方の埋め込みが得られたら、その結果を1つのテンソルに統合します。
続いて、処理の要となるGRCUコンテナを通じた伝播をおこないます。 ローカル変数inputsは、入力データオブジェクトへのポインタで初期化されます。 cGRCUsコンテナの要素を処理するループ内で、各層を順次取り出し、その順伝播メソッドを呼び出します。
   CNeuronBaseOCL *inputs = NeuronOCL;
   CNeuronHimNetGCRU *current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
入出力の仕様を理解することが重要です。最初のGRCUは、解析対象の系列の生データと、共有の埋め込みクエリを受け取ります。 この層は独自の隠れ表現を形成します。 その後、inputs内のポインタを現在のオブジェクトに置き換えます。これにより、最初の層の出力が次の層の入力となります。 このようにして、逐次的な変換のスタックが構築されます。最初の層がコンテキストを拡張し、後続の層が表現を精緻化して圧縮します。 これは、取引実務において、あらゆる詳細情報を収集する最初の分析工程に似ています。その後の層は、より経験豊富なマネージャーのように、情報を選別・集約し、出力に向けてシグナルを整えます。
チェビシェフ多項式バッファSupportは、グラフ集約(K-hop)の中核をなします。 各層に同じオブジェクトを渡すことで、スタック全体を通じて個々のシーケンス間の関係構造を一貫して扱えます。一方、各GRCUは、埋め込みから生成された独自のメタパラメータを用いて、このSupportを解釈します。
順伝播について説明したので、次は逆伝播に進みましょう。ここでは、モデルが評価され、そのすべての構成要素に誤差の責任を慎重に割り当てていきます。 calcInputGradientsメソッドとは、Encoderの出力で蓄積された誤差をGRCUスタックおよび埋め込みセットを通じて逆方向に伝播させ、各構成要素の挙動を調整する処理そのものです。
bool CNeuronHimNetTempEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   if(!NeuronOCL || !Support)
      return false;
まず、このメソッドは安全性チェックをおこない、入力として渡されたポインタが有効であることを確認します。 次に、最終層への入力ソースが決定されます。 スタックに複数の層が存在する場合は、最後から2番目のGRCUを取得します。そうでない場合は、ソースデータオブジェクトを取得します。 誤差勾配の分配は、最後のGRCUから開始します。これは、初期化時にその出力をEncoderの外部出力として指定したオブジェクトです。 これは理にかなっています。勾配はまずスタックの最上部に到達し、そこから下に向かって伝播し始めるからです。
   CNeuronBaseOCL *inputs = (cGRCUs.Total() > 1 ? cGRCUs[-2] : NeuronOCL);
   CNeuronHimNetGCRU* current = cGRCUs[-1];
   if(!current ||
      !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
      return false;
   if(!DeConcat(caEmbeddings[0].getGradient(), caEmbeddings[1].getGradient(),
                cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
ここで、主な局所的処理がおこなわれます。最後のGRCUは、受け取った勾配を、その入力、内部メタパラメータ、およびチェビシェフ多項式の勾配バッファ(Support)に分配します。 この時点で、Supportは共有の接続マップとして機能しており、スタック内の各層がそこに寄与できることを理解しておくことが重要です。 だからこそ、蓄積の仕組みが必要なのです。
次のステップは、結合された埋め込みの勾配を再び2つの部分、つまり2つの埋め込み集合の勾配に分割することです。 各分岐にそれぞれの誤差への寄与分を戻すことで、後で辞書がパラメータプールへのクエリを調整できるようにします。
スタックに複数の層がある場合、Supportの勾配を慎重に蓄積する処理が始まります。 まず、それまでに蓄積した値を含むバッファを見失わないように、現在の勾配バッファへのポインタをローカル変数tempに保存します。 次に、誤差勾配を一時的に、あらかじめ割り当てられたbSupportAccumバッファにリダイレクトします。
   if(cGRCUs.Total() > 1)
     {
      CBufferFloat *temp = Support.getGradient();
      if(!Support.SetGradient(GetPointer(bSupportAccum), false))
         return false;
      for(int i = cGRCUs.Total() - 2; i >= 0; i--)
        {
         current = cGRCUs[i];
         inputs = (i > 0 ? cGRCUs[i - 1] : NeuronOCL);
         if(!current ||
            !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
            return false;
         if(!SumAndNormilize(temp, Support.getGradient(), temp, 1, false, 0, 0, 0, 1))
            return false;
         if(!DeConcat(caEmbeddings[0].getPrevOutput(), caEmbeddings[1].getPrevOutput(),
                      cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
            return false;
         for(uint i = 0; i < caEmbeddings.Size(); i++)
            if(!SumAndNormilize(caEmbeddings[i].getGradient(), caEmbeddings[i].getPrevOutput(),
                                caEmbeddings[i].getGradient(), 1, false, 0, 0, 0, 1))
               return false;
        }
      if(!Support.SetGradient(temp, false))
         return false;
     }
//---
   return true;
  }
スタック内のオブジェクトを逆順に反復処理するループ内で、各層の誤差勾配伝播メソッドを呼び出します。 次に、新しい寄与量を、tempバッファにすでに蓄積されている寄与量と合算します。 その後、結合された埋め込みの勾配を再び2つの情報ストリームに分割します。 最後に、各辞書について、得られた値をこれまでに蓄積してきた値に加算します。
すべての層を順に処理した後、データバッファへのポインタを初期状態にリセットします。 これは重要な点です。この方法をとって初めて、外部のオプティマイザは、グラフ集約の基礎となるパラメータを更新するための正しいシグナルを認識できるようになります。
すべての反復処理が正常に完了すると、このメソッドはtrueを返します。これは、勾配がEncoderのすべての構成要素を経て、ソースデータレベルまで正常に伝播されたことを示しています。
勾配を慎重に収集した後、次のステップはパラメータを更新することです。 updateInputWeightsメソッドは、形式的には単純ですが、実質的には重要な役割を果たしています。このメソッドは、学習可能な重みを含む内部構成要素に、順番に制御を委譲します。 これは、計算シーケンスが実装されるのと同じ順序でおこなわれます。
bool CNeuronHimNetTempEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
      if(!caEmbeddings[i].UpdateInputWeights())
         return false;
まず、ループ内で両方の埋め込み集合が更新されます。 UpdateInputWeightsが呼び出されるたびに、前のステップで蓄積された勾配が、対応する辞書のパラメータに適用されます。
その後、このメソッドはGRCUスタックを順方向に走査します。各層は、その層の埋め込みとメタプールのパラメータを局所的に更新する役割を担っています。
   CNeuronBaseOCL* inputs = NeuronOCL;
   CNeuronHimNetGCRU* current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current.updateInputWeights(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
このクラスの完全なソースコード(すべてのメソッドの実装を含む)を添付します。これには、前述したすべての詳細が含まれています。 これで、Temporal Encoderに関する分析は完了したと言えるでしょう。それでは、次に進みましょう。
Spatial Encoder
話を進める前に、Spatial Encoderとは何か、またTemporal Encoderとどのように異なるのかについて説明しておきましょう。この違いを理解することは、HimNetアーキテクチャ全体に適切に統合するために重要だからです。
Temporal Encoderは、さまざまな時間的粒度に対応するパラメータプールへのクエリとして機能する一連の埋め込み集合を処理していました。 対照的に、Spatial Encoderでは、多数の周期キーを必要としません。この問題における空間データの構造は安定しているからです。 したがって、辞書の代わりに、cEmbeddingオブジェクトにカプセル化された単一の学習可能パラメータセットを使用します。 これにより、モデルは市場空間の一元的な表現を持つことができます。この表現は学習中に精緻化され、その後はGRCUに対して文脈に応じたクエリを継続的に供給するために使用されます。
class CNeuronHimNetSpatEncoder   :     public CNeuronBaseOCL
  {
protected:
   CParams           cEmbedding;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;
   CBufferFloat      bEmbeddingAccum;

public:
                     CNeuronHimNetSpatEncoder(void) {};
                    ~CNeuronHimNetSpatEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetSpatEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
   //---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
アーキテクチャの面では、CNeuronHimNetSpatEncoderオブジェクトはTemporal Encoderと非常によく似ています。 同じグラフリカレントブロックcGRCUsのスタック、同様のチェビシェフ多項式の勾配蓄積器、および順伝播と逆伝播のための一連のメソッドを備えています。 主な違いは、2つの埋め込みセットの代わりに、単一のパラメータ化されたcEmbeddingモジュールと、追加のbEmbeddingAccumバッファがあるという点です。 このバッファは、スタック内のすべての層からの埋め込み勾配の寄与を蓄積するために必要です。
Spatial EncoderとTemporal Encoderの違いは細部に限られるため、アーキテクチャの仕組みとデータフローに焦点を当てることで、本文での不要な繰り返しを避けられます。 添付ファイルに収録されたクラスとその全メソッドの完全なコードを参照することで、読者は細かな違いを自分で確認し、埋め込みのパラメータと勾配がGRCU層内でどのように更新されるかを正確に理解できます。
Combined Encoder
ここからは、並列に動作する2つのEncoderの処理結果を、単一の一貫した表現に統合する中核モジュールに進みます。 CNeuronHimNetEncoderクラスは調整役として機能し、空間表現と時間表現を確実に統合します。 Temporal Encoderは時間の経過に伴う変化を捉えて短期的・長期的な傾向を特定し、一方、Spatial Encoderは異なるオブジェクト間の関係を分析します。 両ストリームの出力はクラス内で慎重に統合され、システムの状態を表す完全な潜在表現を形成します。
class CNeuronHimNetEncoder    :  public CNeuronBaseOCL
  {
protected:
   CParams                    cEmbedding;
   CNeuronTransposeOCL        cEmbeddingT;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CNeuronHimNetTempEncoder   cTempEncoder;
   CNeuronHimNetSpatEncoder   cSpatEncoder;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetEncoder(void) {};
                    ~CNeuronHimNetEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
アーキテクチャ上、このオブジェクトは独自の学習可能パラメータセット(cEmbedding)を含んでおり、これがチェビシェフ多項式を生成するための基礎となります。
このフレームワークのこれまでのモジュールと同様、クラスの構造は、オーバーヘッドを最小限に抑え、不要な動的操作を排除するように設計されています。 ここにあるすべての内部オブジェクトは静的に宣言されているため、コンストラクタとデストラクタは空のままです。 これらの目的は、リソース割り当てのロジックに干渉せず、オブジェクトのライフサイクルを形式的に定義することにすぎません。 構成要素の準備に関わる実際の作業はすべて、Initメソッドに集約されています。このメソッドは一種の指揮者の役割を果たし、各内部要素を順次設定し、Encoder間で役割を割り当て、それらを単一の計算チェーンとして連結します。
bool CNeuronHimNetEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out, uint cheb_k,
                                uint layers, uint embed_dim, uint period1,
                                uint timeframe1, uint period2, uint timeframe2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
初期化は、親クラスに制御を移すことから始まります。この親クラスには、基底インターフェースを作成するためのアルゴリズムがすでに組み込まれています。 次に、学習可能な埋め込みパラメータ、それらを転置する層、対角相関行列を作成するためのオブジェクト、そして得られた依存関係の正規化処理を順につなぎ、一連の構成要素を形成します。 また、グラフ変換用のチェビシェフ多項式を生成するオブジェクトもあります。
   int index = 0;
   if(!cEmbedding.Init(0, index, OpenCL, units * embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cEmbeddingT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
各要素には、計算パイプライン内で固有のインデックスが割り当てられ、活性化関数は位置によって厳密に定義されます。 埋め込み生成オブジェクトには、双曲正接関数を使用しています。これにより、直接依存関係と逆依存関係を正規化された形で定義することが可能になります。
時間ストリーム(cTempEncoder)と空間ストリーム(cSpatEncoder)の2つのストリームの同期には、特に注意が払われています。 前者は、複数の時間スケールの周期と予測ウィンドウを考慮して時間的パターンを特定する役割を担い、後者は、分析単位間の関係をマッピングする役割を担います。 最後に、両者の勾配バッファを同期することで、データの過剰な重複を防ぎ、逆伝播時の誤差伝播を円滑にします。
   index++;
   if(!cTempEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, (embed_dim + 1) / 2,
                                           period1, timeframe1, period2, timeframe2, optimization, iBatch))
      return false;
   index++;
   if(!cSpatEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, embed_dim, optimization,
                                                                                                      iBatch))
      return false;
//---
   if(!SetGradient(cTempEncoder.getGradient(), true))
      return false;
//---
   return true;
  }
このように、Initメソッドはモジュール全体の統合ポイントとして機能し、ばらばらな構成要素を、実際の金融データを用いた学習と運用に対応できる、一貫した単一のアーキテクチャへと統合します。
オブジェクトの初期化が完了したら、順伝播アルゴリズムの開発に進みます。
bool CNeuronHimNetEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
まずは基本から始めましょう。第2の情報ストリームの入力データオブジェクトを指す有効なポインタが渡されているかを確認します。 このオブジェクトを通じて、解析対象のシーケンスのタイムスタンプを受け取ることを想定しています。 ポインタが存在しない場合は、グラフやバッファの破損を防ぐため、直ちに処理を終了します。
次は重要な分岐点です。 学習モードでは、適応グラフを最初から再構築します。 まず、埋め込みを生成します。 次に、その転置表現を準備します。
   if(bTrain)
     {
      if(!cEmbedding.FeedForward())
         return false;
      if(!cEmbeddingT.FeedForward(cEmbedding.AsObject()))
         return false;
      if(!MatMul(cEmbedding.getOutput(), cEmbeddingT.getOutput(), cSupport.getOutput(),
                 cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
         return false;
      if(!cNormSupport.FeedForward(cSupport.AsObject()))
         return false;
      if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
         return false;
     }
MatMul演算では、得られた埋め込みとその転置コピーの行列積を計算し、ノード間の未処理の相関行列を生成します。 取引の文脈では、これは、値動きの特徴が似ている金融商品のペアほど、より強く結び付けられることを意味します。
SoftMax関数を用いて未処理のグラフを正規化し、安定した後処理を適用します。 この処理の結果、グラフ畳み込みに適した確率的隣接行列が得られます。
次に、チェビシェフ多項式を構築します。 これが、ここで用いるK-hop望遠鏡です。ラプラシアンを対角化することなく、最大K本のエッジを隔てた近傍ノードの影響を蓄積できます。処理は高速かつ数値的に安定しており、すべてGPU上で実行されます。
推論モードでは、このセクションはスキップされます。 ナノ秒単位の時間も無駄にせず、決定性を維持するために、学習中にすでに得られた埋め込みと多項式を使用します。
次に、2つのEncoderが登場します。 まず、分析対象のマルチモーダルなデータ系列、チェビシェフ多項式の集合、およびタイムスタンプを時間ストリームに入力します。
   if(!cTempEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject(), int(SecondInput[0])))
      return false;
Encoderは、今何が起きているかとそれが正確にはいつ起きているかを融合し、グラフのダイナミクスに時間的なレジームを重ね合わせます。
これと並行して、Spatial Encoderを実行します。
   if(!cSpatEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
時間ラベルは必要ありません。ここでは、定常ノード埋め込みが使用されています。 空間的な基盤は、安定した市場マップの形成を担います。 両ストリームは同じK-hop基底を参照しますが、時間と空間という異なる角度からそれを捉えます。
最後の仕上げは、得られた結果を丁寧にまとめることです。 Encoderの出力を合計します。
   if(!SumAndNormilize(cTempEncoder.getOutput(), cSpatEncoder.getOutput(), Output,
                       cTempEncoder.GetWindowOut(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
実際には、これはシンプルでありながら信頼性の高いアンサンブルとして機能します。時間チャネルは取引セッションのレジームやカレンダー効果を捉え、空間チャネルは安定したクラスタを捉えます。 その結果、市場が落ち着いているときも、ニュースによる急変動の際も同等の性能を発揮する潜在表現が得られます。シグナルは連携する2つの情報源から得られるため、モデルは単一の種類のシグナルに過学習しません。
各ステップがエラーなく実行された場合、このメソッドはtrueを返します。 そうでない場合は、バッファに不整合な状態を残さず、直ちに終了します。 このような保守的なフロー制御は、実際の取引で特に重要です。ティックデータや1分足を使ってモデルを実行する場合、部分的に破損したデータから復旧する余裕はありません。予測は正確かつタイムリーでなければならず、そうでなければ予測自体を出すべきではありません。
順伝播が完了すると、モデルは最も重要な段階の一つである誤差勾配の分配へと進みます。 ここで、アーキテクチャの各要素がフィードバック信号をどの程度正確に解釈し、自身の重みを調整できるかが決まります。 このクラスのcalcInputGradientsメソッドは、不要な計算オーバーヘッドを生じさせず、データのコピーを最小限に抑えながら、この処理を順次進めるように設計されています。
bool CNeuronHimNetEncoder::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!cTempEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()))
      return false;
まず、Temporal Encoderから勾配を抽出し、多項式サポートバッファと前の層へ慎重に転送します。
ここでは、Spatial Encoderについても同様の手順を繰り返しますが、その前に、すでに取得したデータが保持されていることを確認する必要があります。 ここで対象となるのは、内部構成要素だけでなく、ソースデータオブジェクトも含まれます。 両方のEncoderは順伝播中に同じソースデータを処理するため、まず、すでに得られた勾配を保持しておきます。
   CBufferFloat* temp = cPolinomSupport.getGradient();
   CBufferFloat* prev = prevLayer.getGradient();
   if(!cPolinomSupport.SetGradient(cPolinomSupport.getPrevOutput(), false) ||
      !prevLayer.SetGradient(prevLayer.getPrevOutput(), false) ||
      !cSpatEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()) ||
      !SumAndNormilize(temp, cPolinomSupport.getGradient(), temp,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(prev, prevLayer.getGradient(), prev,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !cPolinomSupport.SetGradient(temp, false) ||
      !prevLayer.SetGradient(prev, false))
      return false;
   if(prevLayer.Activation() != None)
      if(!DeActivation(prevLayer.getOutput(), prev, prev, prevLayer.Activation()))
         return false;
2つの情報ストリームからのデータを慎重に合算します。
次に、逆伝播は処理の連鎖をさらにたどって進みます。情報の流れの連続性を維持しながら、チェビシェフ多項式から埋め込みのレベルまで誤差勾配を分配する必要があります。
//---
   if(!cNormSupport.CalcHiddenGradients(cPolinomSupport.AsObject()))
      return false;
   if(!cSupport.CalcHiddenGradients(cNormSupport.AsObject()))
      return false;
   if(!MatMulGrad(cEmbedding.getOutput(), cEmbedding.getPrevOutput(),
                  cEmbeddingT.getOutput(), cEmbeddingT.getGradient(),
                  cSupport.getGradient(),
                  cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
      return false;
   if(!cEmbedding.CalcHiddenGradients(cEmbeddingT.AsObject()))
      return false;
   if(!SumAndNormilize(cEmbedding.getGradient(), cEmbedding.getPrevOutput(), cEmbedding.getGradient(),
                       cEmbeddingT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEmbedding.Activation() != None)
      if(!DeActivation(cEmbedding.getOutput(), cEmbedding.getGradient(),
                       cEmbedding.getGradient(), cEmbedding.Activation()))
         return false;
//---
   return true;
  }
その結果、このメソッドは綿密に構築されたフィードバック経路に従い、各層は自身に割り当てられた分の補正信号を正確に受け取ります。 これにより、勾配の発散リスクが低減され、学習の安定性が高まり、最適化プロセスをより制御しやすくなります。
パラメータ更新メソッドは極めて簡潔に実装されており、まさにそこに強みがあります。 各ブロックの計算に干渉しようとするのではなく、単に適切な構成要素に責任を委ねるだけです。
bool CNeuronHimNetEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cEmbedding.UpdateInputWeights())
      return false;
   if(!cTempEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
   if(!cSpatEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
//---
   return true;
  }
さらに詳しく知りたい方のために、このクラスとそのすべてのメソッドの完全なコードを添付ファイルに含めています。ご自身のペースでじっくりと確認してください。
Decoder
HimNetフレームワークのアプローチの実装を締めくくるにあたり、最後の、そして他と同じく重要な構成要素であるDecoderに進みます。 Encoderが情報の収集役としてデータを圧縮し、コンパクトな表現に構造化していたのに対し、Decoderは熟練した修復師のように機能します。層を一つずつたどりながら潜在空間から元の表現を再構築し、データを見慣れた形に戻しますが、そのデータは情報が豊かになり、余分なノイズが取り除かれています。
class CNeuronHimNetDecoder    :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL             cProjection;
   CNeuronTransposeOCL        cProjectionT;
   CNeuronConvOCL             cEmbedding;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CLayer                     cGRCUs;
   CBufferFloat               bSupportAccum;
   CBufferFloat               bEmbeddingAccum;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetDecoder(void) {};
                    ~CNeuronHimNetDecoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out,
                          uint cheb_k, uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetDecoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
  };
アーキテクチャ上、DecoderはEncoderとの連続性と対称性を維持しており、ネットワーク構造全体のバランスが取れ、解釈しやすくなっています。 しかし、空間埋め込みと時間埋め込みを別々に生成して相互に補完できたEncoderとは異なり、Decoderは、Encoderの出力として得られた潜在表現に基づいて生成される、単一の時空間埋め込みを使用します。 この同じ潜在表現が、チェビシェフ多項式を生成する基盤にもなります。これらの多項式は、時系列を再構築する際に複雑な動態を近似するために用いられます。
Decoderのアーキテクチャを理解したら、次のステップは、そのすべての内部構成要素を順次初期化することです。 Initメソッドは、まず親クラスに制御を渡し、親クラスが基底インターフェースを初期化することから始まります。
bool CNeuronHimNetDecoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out,
                                uint cheb_k, uint layers, uint embed_dim,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
次に、ソースデータの投影層cProjectionと、得られた投影を転置するためのオブジェクトcProjectionTを作成します。
   int index = 0;
   if(!cProjection.Init(0, index, OpenCL, window, window, embed_dim, units, 1, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cProjectionT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
最初の層にはTANH活性化関数が割り当てられ、Encoderから受け取った潜在表現に基づいて時空間表現を適切に形成できるようになります。
次に、ニューロンの数と特徴の次元数に対応する次元を持つ埋め込み生成層cEmbeddingが作成されます。 これらの埋め込みは、リカレントブロック内での後続の計算に使用されます。
   index++;
   if(!cEmbedding.Init(0, index, OpenCL, units, units, 1, 1, embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(SIGMOID);
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
cSupportおよびcNormSupportオブジェクトは、チェビシェフ多項式用のデータを準備する上で重要な役割を果たします。 まず、cSupportは、さまざまな特徴量や時系列ストリーム間の関係を反映した対角相関行列を生成します。次に、cNormSupportは、この行列の値を共通の尺度に正規化し、計算の安定性と後続の演算の正確性を確保します。 この正規化された行列は、cPolinomSupportブロックの基礎となります。このブロックでは、行列に基づいてチェビシェフ多項式が構築され、その後、GCRUリカレントブロックの計算に使用されます。 このアプローチにより、計算プロセスの精度と一貫性を維持しつつ、特徴量間の複雑な関係をモデル化できます。
次のステップでは、cGRCUsコンテナを作成し、そこにGCRUリカレントブロックを格納します。 ブロックは順次追加されます。最初のブロックには入力データに対応する特徴空間サイズが割り当てられ、それ以降のすべてのブロックでは固定のテンソルサイズが使用されます。
//---
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
     {
      DeleteObj(temp);
      return false;
     }
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
        {
         DeleteObj(temp);
         return false;
        }
     }
すべてのブロックはOpenCLコンテキストにバインドされており、これにより計算が高速化されます。
バッファbSupportAccumおよびbEmbeddingAccumは、誤差勾配の中間結果を格納するために割り当てられます。
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(cPolinomSupport.Neurons(), 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
   bEmbeddingAccum.BufferFree();
   bEmbeddingAccum.Clear();
   if(!bEmbeddingAccum.BufferInit(cEmbedding.Neurons(), 0) ||
      !bEmbeddingAccum.BufferCreate(OpenCL))
      return false;
//---
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
最後のブロックとDecoder全体の間で、活性化関数、および出力バッファと誤差勾配へのポインタを同期させることで、初期化処理が完了します。 これにより、不要なデータのコピーを省き、モデルの学習と順伝播の準備を整えることができます。 各ステップは徹底的にチェックされます。エラーが発生した場合、このメソッドはfalseを返し、モデルが誤った状態になるのを防ぎ、その後の計算の安定性を確保します。
Decoderのすべての構成要素の初期化が正常に完了したら、信号処理の中核となる順伝播メソッドの実装に進みます。 この段階では、分析対象の情報は、相互に接続された複数のブロックを順次通過します。各ブロックが特定の機能を果たすことで、モデル全体が連携して正確に動作します。
bool CNeuronHimNetDecoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjection.FeedForward(NeuronOCL))
      return false;
   if(!cProjectionT.FeedForward(cProjection.AsObject()))
      return false;
   if(!MatMul(cProjection.getOutput(), cProjectionT.getOutput(), cSupport.getOutput(),
              cProjectionT.GetCount(), cProjectionT.GetWindow(), cProjectionT.GetCount(), 1, false))
      return false;
   if(!cNormSupport.FeedForward(cSupport.AsObject()))
      return false;
初期段階では、信号はcProjectionおよびcProjectionTモジュールによって処理されます。これらのモジュールは、元のデータを指定された次元数の潜在表現に変換します。 得られたテンソル同士の行列乗算により、対角相関行列が生成されます。 次に、この行列をSoftMax関数を用いて正規化します。 この正規化は、cPolinomSupportブロックでチェビシェフ多項式を生成する上で極めて重要です。計算の安定性を確保するとともに、後続の層に対する各要素の影響を適切な尺度に調整するためです。
   if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
      return false;
//---
   if(!cEmbedding.FeedForward(cProjectionT.AsObject()))
      return false;
次に、cEmbeddingブロックで埋め込みが生成され、データの隠れた特徴がコンパクトかつ情報量の多い形で表現されます。
データの準備が完了すると、最初のGCRUブロック(cGRCUsコンテナ内)に信号が送られ、そこで情報のグラフ再帰処理がおこなわれます。 後続の各GCRUブロックは、直前のブロックの出力を入力として受け取ります。これにより、Decoderは時間的・空間的な依存関係を捉え、履歴データ内の複雑なパターンを特定できます。
   CNeuronHimNetGCRU* current = NULL;
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(NeuronOCL, cPolinomSupport.AsObject(), cEmbedding.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
こうした一連の変換を経て、Decoderの最終出力が形成されます。 このアプローチにより、モデルの一貫した動作と計算リソースの最適化が保証されます。これは、大規模な金融データを処理したり、過去の時系列データを用いて学習をおこなったりする際に特に重要です。
おそらく、Decoderの動作アルゴリズムが、前述のEncoderで示されたロジックをいかに自然に受け継いでいるか、すでにお気づきのことでしょう。 したがって、逆伝播の各メソッドについては、ご自身で詳しく調べてみることをお勧めします。 すべてのメソッドを含むクラスの完全なコードは、添付ファイルに記載されています。
テスト
HimNetフレームワークの主要な構成要素をすべて組み立てたところで、いよいよ最も興味深い段階、つまりモデルの学習とテストに移りましょう。 私たちの目標は変わりません。それは、市場を自律的に分析し、意思決定をおこなうことのできる取引システムを構築することです。 この仕組みにおいて、HimNetはEnvironmental-State Encoderとして機能し、現在の市場状況を簡潔かつ情報量の多い形で表現します。 Actorはこの表現に基づいて行動を選択し、Criticはその行動の質を評価してフィードバックを提供し、戦略の調整を可能にします。
学習は互いに補完し合う2つの段階で構成されており、これにより、実際の市場環境で動作するために必要な強固な基盤と柔軟性の両方が得られます。 最初のオフライン段階では、2024年の通年にわたるEURUSD通貨ペアのH1時間足の履歴データを用いて、徹底的に学習をおこないました。 この期間は、穏やかな横ばい相場、安定したトレンド、ボラティリティの急激な上昇、ノイズが増大する局面など、あらゆる市場状況を網羅しており、モデルにとって絶好の訓練の場となりました。
第2段階はオンラインでのファインチューニングです。 このモデルは、実際の取引を可能な限り忠実にシミュレートするMetaTrader 5ストラテジーテスターで、ローソク足のストリームを順次処理しました。 この段階では、オフライン学習とは全く異なる特性が明らかになります。具体的には、ノイズに対する耐性、流動性の変化に適切に対応する能力、そして遅延やスリッページを考慮する能力です。 実際の市場環境に移行した際にもモデルの挙動が予測可能なままとなるよう、実際の約定条件を綿密にシミュレートしました。
最終段階となる最も厳格な検証は、完全に外部のサンプル、すなわち2025年1月から3月までの価格データを用いて実施しました。 この検証の間、すべてのモデルパラメータは固定されたままでした。 このような検証により、実用上の有効性を客観的に評価できます。つまり、新しい環境下でもアルゴリズムが安定性と予測可能性を維持できるかどうかを確認できます。
テストの結果を以下に示します。
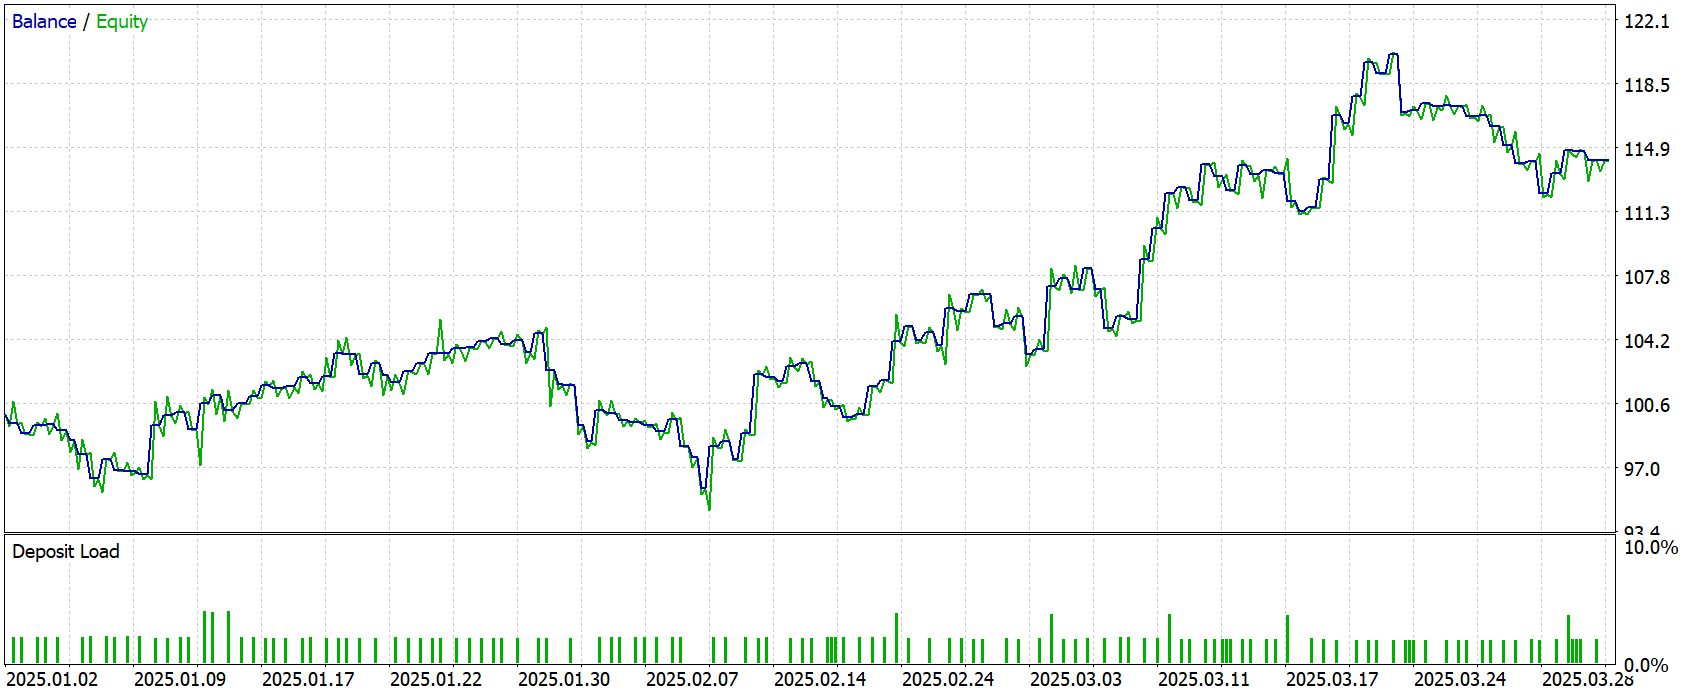
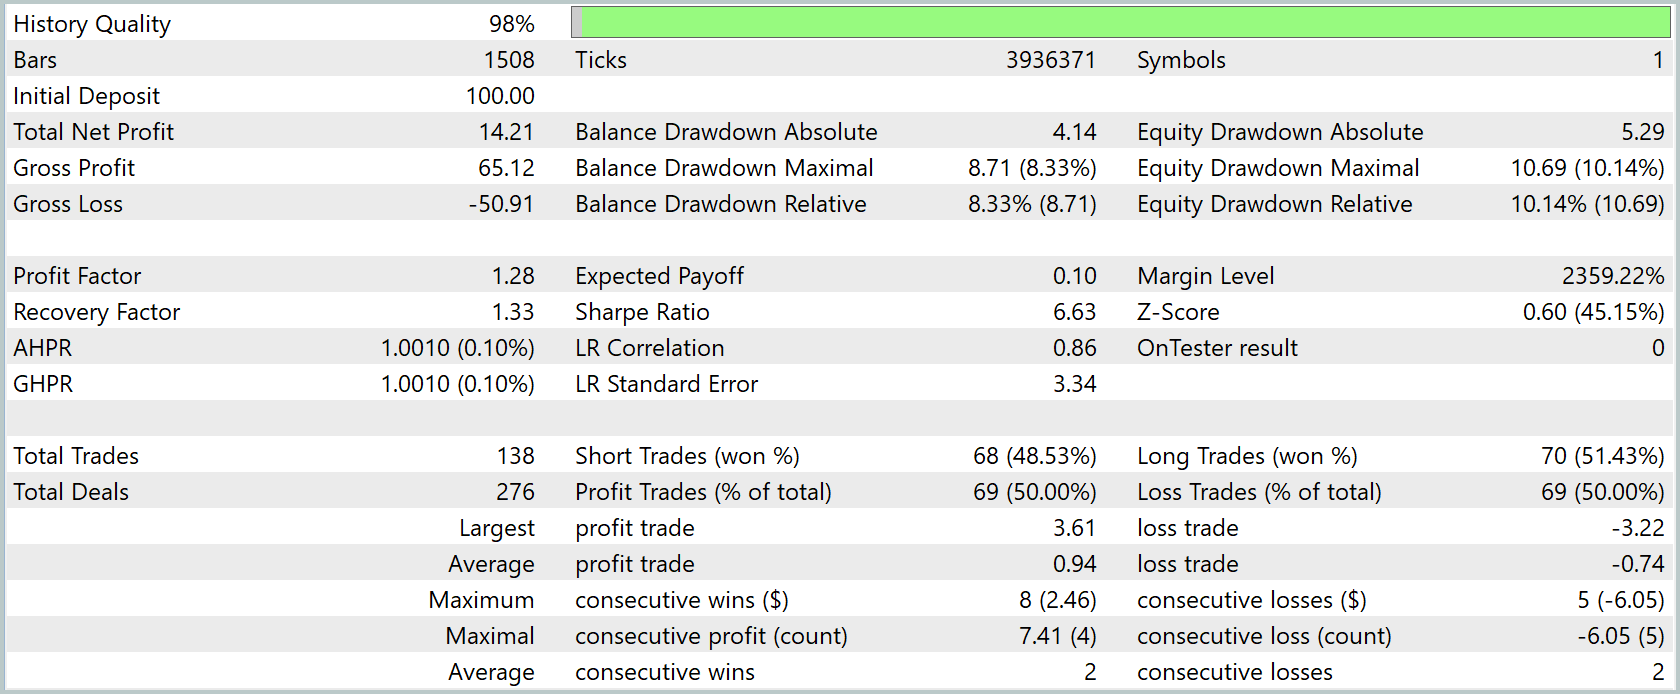
3か月のテスト期間中、純利益は初期資本の14.21%に達しました。 損失1ドルあたりの利益は1.28ドルでしたが、1取引あたりの平均期待利得はわずか0.10ドルにとどまりました。 リカバリーファクターが1.33であることは、総利益が残高の最大ドローダウンを上回ったことを示しています。
ドローダウンは比較的穏やかだったといえます。絶対ドローダウンは残高ベースで4.14ドル、有効証拠金ベースで5.29ドルであり、最大相対ドローダウンはそれぞれ8.33%、10.14%でした。 一方、利益曲線は着実な上昇を示しており、時間に対するトレンド相関係数が0.86であることからも裏付けられています。
テスト全体を通じて、このエキスパートアドバイザー(EA)は138回の取引を実行し、買いと売りはほぼ均等に分かれており、利益が出た取引の割合は、買い・売りの両方向で50%近くでした。 利益が出た取引の平均利益は0.94ドル、損失が出た取引の平均損失は0.74ドルで、1取引あたりの最大利益は3.61ドル、最大損失は3.22ドルでした。 ポジションの平均保有時間は1時間強で、保有時間は57分から2時間の範囲に収まっており、明確に短期の日中取引スタイルであることを示しています。
これらの結果を総合すると、この戦略は比較的安定しているものの、収益性はそれほど高くないことが示唆されます。 この戦略の強みとしては、ドローダウンが抑制されていること、買い・売りの両方向で安定した成績を示すこと、期待利得がプラスであることが挙げられます。 この戦略の弱点は、プロフィットファクターの余裕が限られていることと、1取引あたりの平均利益が小さいことであり、実口座ではスプレッドや手数料の影響を受けやすい可能性があります。
結論
本記事をもって、HimNetフレームワークのアプローチをMQL5で実装する一連の作業が完了します。 このフレームワークの主な利点は、アーキテクチャの柔軟性と、時系列予測および分析に関連する幅広いタスクに適応できる点にあります。
学習データに含まれていなかった新しい価格データを用いた最終テストでは、良好な推移が見られました。 このモデルによる取引の残高は着実に増加しており、市場環境の変化に効果的に適応できることを示しています。
リンク
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19286
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。



