

取引におけるニューラルネットワーク:適応的周期セグメンテーション(最終回)
 21
 0

はじめに
これまでの記事では、LightGTSフレームワークが時系列を楽譜へと変換する仕組みを、段階を追って解説してきました。 まず、Period Patchingモジュールでは、分析対象のデータを、FFTを用いて特定した完全な周期ごとに自動的に分割します。 次に、各周期をFlex Projection Layer(柔軟投影層)によってトークンへと射影します。これにより、長さの異なるデータ断片を柔軟に処理できます。 Encoderでは、これらのトークンに回転位置エンコーディング(Rotary Positional Encoding, RoPE)を適用します。これは、位相シフトや相対位置の情報をコンパクトに織り込む手法です。その後、Multi-Head Attentionを備えた従来型のTransformerブロックが、局所的なパターンを統合し、ひとつのコンテキストを形成します。 予測は、自己回帰を用いることなく出力系列全体を一度に生成する、周期的並列デコーディングメカニズムによっておこなわれます。 最後に、Flex-resizeモジュールで出力を調整し、周期的な一貫性を維持します。
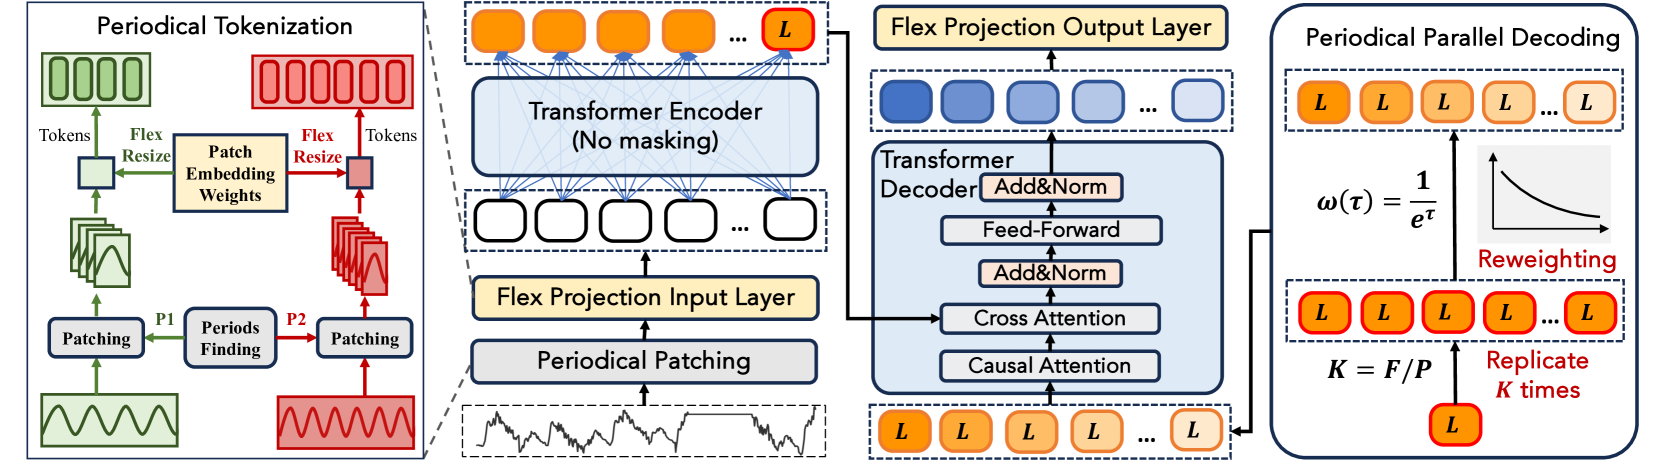
ここまでで、すでにLightGTSの主要なアイデアをコードとして実装してきました。適応型パッチ化を用いて*時系列を周期的なセグメントに自動分割し、各セグメントを情報量の豊富なトークンへと変換する方法を習得しました。 また、オリジナルのアルゴリズムに独自の工夫を加え、柔軟な射影処理の仕組みを改良することで、局所的な市場サイクルを表す実用的な表現を得ることができました。 今回はさらに一歩進み、LightGTSフレームワークの著者たちが提案した手法について、独自の視点から検討していきます。
RoPEメカニズム
適応型畳み込みによって、生の時系列から情報量の豊富なトークン群が抽出されたら、次はそれらをTransformerブロックという強力なフィルタに通します。 標準的なEncoder–Decoderアーキテクチャでは、正弦波ベースまたは学習可能な位置エンコーディングベクトルを各トークンに加算し、その後、Attentionメカニズムに入力します。 これに対して、LightGTSフレームワークの著者たちは、より洗練された柔軟な手法である回転位置エンコーディング(Rotary Positional Encoding, RoPE)を提案しています。 固定された位置エンコーディングベクトルを加算する代わりに、各トークンを埋め込み空間内で回転させます。
RoPEの基本的な考え方は、追加のパラメータを導入することなく、トークンの位置と各次元のインデックスに応じたベクトルの位相シフトを導入することです。 なお、この手法は論文「RoFormer: Enhanced Transformer with Rotary Position Embedding」で初めて提案されました。同論文では、回転行列を用いてQueryベクトルとKeyベクトルの座標ペアを回転させることで、モデルが相対的な時間方向のずれを確実に捉えられることが示されています。
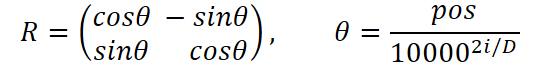
この手法は、次元を値のペアに分割することで、多次元空間にも容易に一般化できます。 そのため、空間の次元数は偶数でなければならないという制約があります。
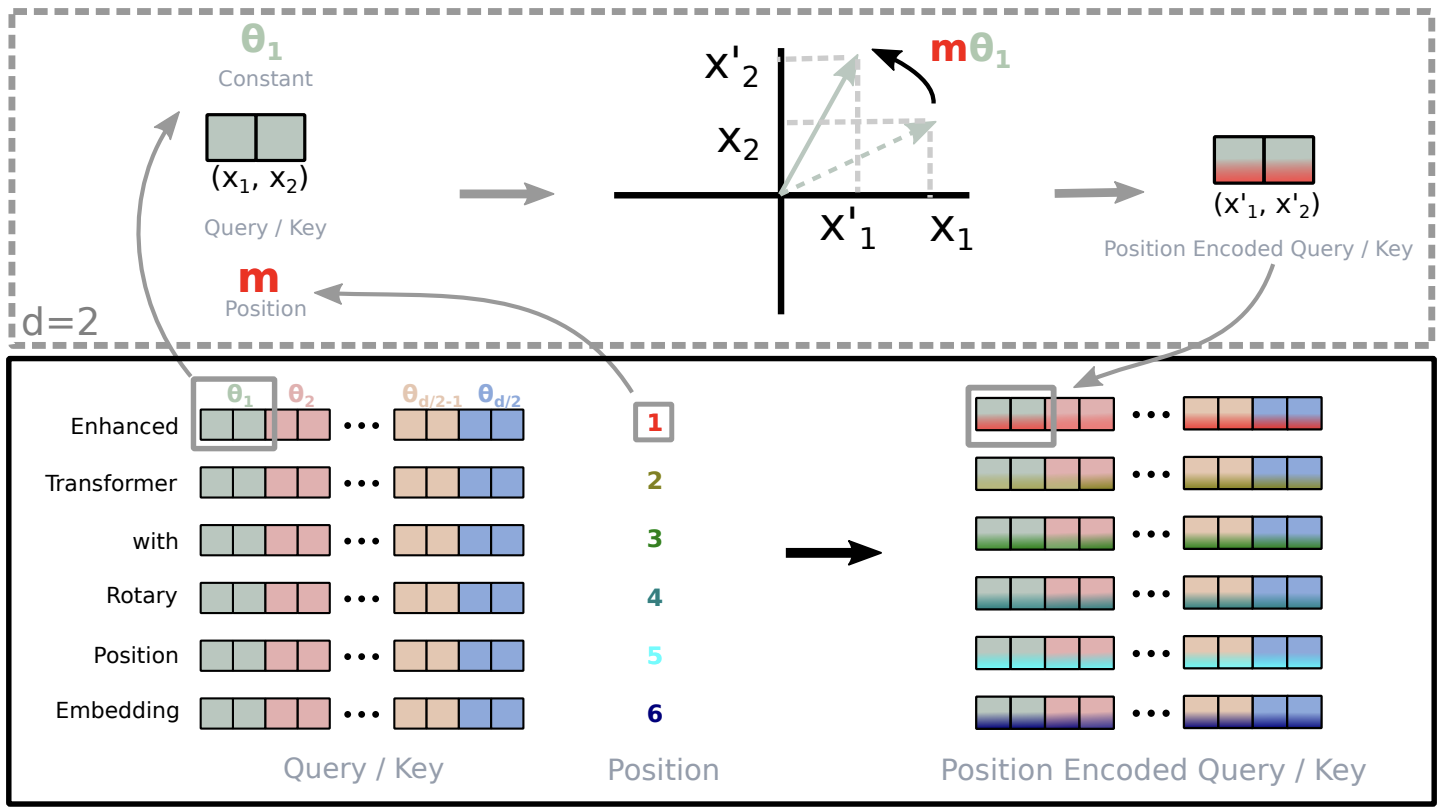
この回転により、ウィンドウサイズやステップサイズが動的に変化する場合でも、モデルはどのトークンが時間的に近く、どのトークンが遠いのかを正確に判別できます。 その結果、Self-Attention機構は、時間的パターンを高い感度で検出できるようになります。これは、単にQueryとKeyの内容を比較するだけでなく、トークン間の位相差も考慮するためです。 こうして、Multi-Head AttentionとFeed-Forwardの各層を通過したトークンは、豊かな文脈情報を持つ表現へと変換されます。
RoPEの数学的・概念的な基礎を詳しく見てきたところで、次は実装の詳細に踏み込み、これらの仕組みをOpenCLのプログラムコードにどのように落とし込むかを確認していきましょう。 すでにトークンは用意されています。それぞれがD次元を持つベクトルの配列です。 さらに、各位置に対応する正弦・余弦のテーブルも事前に計算しておきます。 目標は、パイプライン全体のスループットを損なうことなく、埋め込み空間内で各ベクトルを回転させ、その位相がタイムスタンプを反映するようにすることです。 そのために、3次元のタスク空間で動作するRoPEカーネルを作成します。 第1の次元は、ベクトル内の座標ペアのインデックスに対応し、 そのサイズはベクトルの次元数の半分となります。 第2の次元は系列の長さ(トークン数)を表し、 第3の次元は系列の数を表します。
なお、値のペアを扱いやすくするため、float2ベクトル型を使用します。
__kernel void RoPE(__global const float2* __attribute__((aligned(8))) inputs,
                   __global const float2* __attribute__((aligned(8))) position_emb,
                   __global float2* __attribute__((aligned(8))) outputs
                  )
  {
   const size_t id_d = get_global_id(0);     // dimension
   const size_t id_u = get_global_id(1);     // unit
   const size_t id_v = get_global_id(2);     // variable
   const size_t dimension = get_global_size(0);
   const size_t units = get_global_size(1);
   const size_t variables = get_global_size(2);
カーネル本体では、まず3次元のタスク空間における現在のワークアイテムの座標を特定します。 これにより、各ワークアイテムは、自分が処理するデータ断片を正確に把握できます。つまり、処理対象となるベクトルの座標ペア、そのベクトルが属するトークン、そして対象となる変数(またはチャネル)を特定します。
ワークアイテムの座標が確定したら、次にOpenCLバッファのフラット配列におけるオフセットを計算します。 論理的には多次元構造であっても、OpenCLではすべてのデータが線形に格納されるため、対象要素のメモリ上の位置を手動で正確に計算する必要があります。
   const int shift_in = (id_v * units + id_u) * dimension + id_d;
   const int shift_pos = id_u * dimension + id_d;
   const float2 inp = inputs[shift_in];
   const float2 pe = position_emb[shift_pos];
グローバルメモリへの高コストなアクセスを最小限に抑えるため、最初に座標ペアと、それに対応する正弦・余弦の係数を読み込み、カーネル内で実質的にレジスタ上に保持されるローカルなベクトル変数に格納します。 何しろ、グローバルメモリのバッファにアクセスする処理は、すでにローカルに保持されているベクトルを操作する処理に比べて、はるかに大きなコストがかかります。 これにより、グローバルメモリからのデータの繰り返し読み出しをほぼ完全に排除し、頻繁に使用するデータをレジスタまたはGPUのローカルメモリに保持できます。その結果、トークンを回転させる処理全体が大幅に高速化され、カーネルの実行効率が最大限に高まります。
必要な材料(入力データとsin/cosの値)がすべて揃ったら、いよいよ本題である位相シフトに進みます。 このシフトによってトークンに時間の感覚が与えられ、Attentionメカニズムが適切に機能するようになります。
   float2 result = 0;
   result.s0 = inp.s0 * pe.s0 - inp.s1 * pe.s1;
   result.s1 = inp.s0 * pe.s1 + inp.s1 * pe.s0;
//---
   outputs[shift_in] = result;
  }
ここでは、ローカル変数に対して単純な算術演算をおこないます。値のペアごとに、乗算を4回、加算を2回実行します。 データはあらかじめ読み込まれているため、この処理はほぼ瞬時に完了します。
その後、回転させた座標ペアを直ちに結果バッファに書き込みます。
仕組みはこれだけです。事前に計算したcos値とsin値を乗算するだけで、新たなパラメータを一つも追加することなく、各トークンに位相と相対時間の情報を与えられます。 その結果、このカーネルには次のような特徴があります。
- 最大限の並列性:各ワークアイテムが独立して実行される。
- 学習時のオーバーヘッドはゼロ:位置エンコーディングに学習可能なパラメータは含まれない。
- 後続のAttentionモジュールとのシームレスな統合:埋め込みには、トークンの内容だけでなく、トークン間の位相差も反映される。
RoPEはモデルに学習可能なパラメータを一つも追加しませんが、この層を通じて勾配が正しく伝播し、入力データまで戻ることが重要です。 そのため、ベクトルの逆回転を実行する専用の逆伝播カーネルCalcHiddenGradRoPEを作成します。
考え方は単純です。順伝播カーネルでは、入力データ(x、y)に回転行列を乗算しました。 逆伝播では、その転置行列を適用する必要があります。つまり、−θだけ回転させます。ここで、cos(−θ) = cosθ、sin(−θ) = −sinθが成り立ちます。
逆伝播カーネルのアルゴリズムは、先ほど説明した順伝播カーネルとほぼ同じです。 同じタスク空間を使用し、グローバルデータバッファ内のオフセットも同様の方法で定義します。 唯一の違いは、ベクトルの回転方向です。 また、演算の入力データとして、出力側で計算された誤差勾配を使用します。
__kernel void CalcHiddenGradRoPE(__global float2* __attribute__((aligned(8))) inputs_gr,
                                 __global const float2* __attribute__((aligned(8))) position_emb,
                                 __global const float2* __attribute__((aligned(8))) outputs_gr
                                )
  {
   const size_t id_d = get_global_id(0);     // dimension
   const size_t id_u = get_global_id(1);     // unit
   const size_t id_v = get_global_id(2);     // variable
   const size_t dimension = get_global_size(0);
   const size_t units = get_global_size(1);
   const size_t variables = get_global_size(2);
//---
   const int shift_in = (id_v * units + id_u) * dimension + id_d;
   const int shift_pos = id_u * dimension + id_d;
   const float2 grad = outputs_gr[shift_in];
   const float2 pe = position_emb[shift_pos];
//---
   float2 grad_x;
   grad_x.s0 = grad.s0 * pe.s0 + grad.s1 * pe.s1;
   grad_x.s1 = grad.s1 * pe.s0 - grad.s0 * pe.s1;
//---
   inputs_gr[shift_in] = grad_x;
  }
条件分岐も複雑な計算式も必要ありません。乗算が4回、加算が2回あるだけです。 そのため、RoPE層の勾配も、順伝播でトークンを回転させたときと同じように、迅速かつ効率的に逆方向へ伝播します。
このように、CalcHiddenGradRoPEによって、RoPE層は学習プロセスに本格的に組み込めるようになります。ネットワークの任意の深さに配置でき、実行速度と並列性を維持しながら、入力テンソルへ勾配を損失なく伝播させることができます。
RoPE用のOpenCLカーネルが完成したので、次はこの機能をMQL5の世界に持ち込み、自動売買ロボットに統合します。 GPU上でトークンを回転させるための仕組みはすでに完成しています。残る作業は、MQL5エキスパートアドバイザー(EA)でおなじみの構造に適合する、軽量なラッパーを作成することだけです。 この目的のために、以下に示す構造を持つCNeuronRoPEクラスを作成します。
class CNeuronRoPE  :  public CNeuronPositionEncoder
  {
protected:
   uint              iWindow;
   uint              iVariables;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)override;

public:
                     CNeuronRoPE(void) : iWindow(0), iVariables(0) {};
                    ~CNeuronRoPE(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint count, uint window, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void) override const {  return defNeuronRoPE; }
  };
CNeuronRoPEクラスは、できる限りシンプルな設計になっています。変数は2つだけです。iWindowは単一のトークンベクトルの次元数を定義し、iVariablesはチャネル数を指定します。 バッファの管理やパラメータの検証といった、その他の負荷の大きい機能はすべてCNeuronPositionEncoderクラスから継承するため、コンストラクタとデストラクタは空になっています。 この層全体の動作の基盤となるのが、Initメソッドです。
bool CNeuronRoPE::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint count, uint window, uint variables,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(window % 2 > 0)
      return false;
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, count * window * variables, optimization_type, batch))
      return false;
メソッドの冒頭では、単純ながらも非常に重要なチェックをおこないます。RoPEは座標ペア単位で処理を行うため、各トークンの次元数が偶数でなければなりません。 この条件を満たさなければ、処理を先に進めることはできません。値のペアを一意に定めて回転させることができないためです。 このチェックを正常に通過したら、親クラスの同名メソッドに処理を引き継ぎます。残りのチェック処理や、継承したインターフェースの初期化アルゴリズムは、すでに親クラスに実装されています。
次に、入力データテンソルのパラメータを内部変数に保存します。
   iWindow = window;
   iVariables = variables;
次に、RoPEの中核となる埋め込み行列を構築します。これは2次元配列で、偶数列にcos(θ)、奇数列にsin(θ)を格納します。
まず、必要なサイズのpe行列を作成します。 この行列は、これから正弦値と余弦値で埋めていくための土台となります。 行列の各列が、対応する時系列のステップにどのように対応するかを理解するため、まず位置ベクトルを構築します。要素がすべて1のベクトルを用意し、その累積和を計算してから1を引くことで、[0, 1, 2, …, count–1]というベクトルを得ます。 このベクトルによって、現在どのステップの位置エンコーディングをおこなっているのかを正確に特定できます。
   matrix<float> pe = matrix<float>::Zeros(count, iWindow);
   vector<float> position = vector<float>::Ones(count);
   position = position.CumSum() - 1;
次に、処理の中心となる部分に進みます。トークンの座標ペアごとに独自の角度が必要となるため、すべての次元ペアを順番に処理します。 各ペアについて、位置ベクトルを、次第に大きくなる分母pow(10000, 2 * i / iWindow)で割ります。これにより、高次元では回転を遅くし、低次元では回転を速くします。 その結果、角度の配列が得られます。個々の数値ではなく、すべての位置に対応する角度ベクトルθです。
   for(uint i = 0; i < iWindow / 2; i++)
     {
      vector<float> temp = position / MathPow(10000.0f, 2.0f * i / window);
      pe.Col(MathCos(temp), i * 2);
      pe.Col(MathSin(temp), i * 2 + 1);
     }
そこで、pe行列の偶数列には計算された角度の余弦を、隣接する奇数列には正弦を書き込みます。 その結果、行列はすぐに使えるテーブルとなり、各列にそれぞれ一組の値[cos(θ), sin(θ)]が格納され、任意のトークンをすぐに回転できるようになります。 これらの計算はすべてCPUコードで一度だけ実行し、その後、すぐに使用できる関数群を GPUカーネルに渡せるようにします。
値を書き込んだ行列をデータバッファに転送し、処理の成否を示す値を呼び出し元のプログラムに返して、メソッドを終了します。
   PositionEncoder.BufferFree();
   if(!PositionEncoder.AssignArray(pe))
      return false;
   SetActivationFunction(None);
//---
   return PositionEncoder.BufferCreate(open_cl);
  }
このアプローチにより、私たちのOpenCLカーネルは、事前計算された正弦・余弦テーブルを入力として受け取り、不要な数学演算に煩わされることなく、最大限の性能で動作できます。
その結果、初期設定のすべてが単一のメソッドに集約されます。windowまたはvariablesパラメータを変更するだけで、層は新しい条件に即座に適応します。 このアプローチにより、コードの厳密さと明瞭さを保ちながら、RoPEモジュールの動作を完全に制御できます。
順伝播が始まったら、トークンがすでに格納されているソースデータオブジェクトへのポインタを渡して、feedForwardメソッドを呼び出すだけです。 内部では、このメソッドが細部にまで注意を払って処理をおこないます。受け取ったポインタが有効かどうかを確認し、適切なワークグループサイズでRoPEカーネルをキューに投入して、その完了を待ってから制御を返します。 その結果、回転済みトークンのバッファが得られ、Attentionモジュールに渡せる状態になります。
学習時には、calcInputGradientsメソッドが使用されます。 このメソッドは、CalcHiddenGradRoPEカーネルを起動します。 そのロジックは順伝播のほぼ鏡像となっています。座標もオフセットも同じですが、勾配を元の表現に戻すため、回転は逆方向におこなわれます。 最終結果は入力勾配バッファに適切に格納され、モデルの前段の層へとスムーズに渡されます。
どちらのメソッドも、本質的には対応するカーネルのラッパーであり、すでにおなじみのアルゴリズムに従っています。 したがって、本記事ではこれらについて詳しく説明しません。 ここで紹介したクラスと、そのすべてのメソッドの完全なコードは、添付ファイルに含まれています。
トークンがRoPEの位相フィルタを通過したことで、モデルの中核であるAttentionモジュールに進む準備が整いました。 デフォルトでは、LightGTSフレームワークは従来のEncoder–Decoderアーキテクチャを基盤としてロジックを構築しているため、車輪の再発明をする必要はありません。必要なコンポーネントはすべて、すでにライブラリに用意されています。 必要なのは、回転済みトークンを既存のSelf-Attentionモジュールのいずれかに入力することだけです。そこでMulti-Head Attentionが非常に効果的に機能し、局所的なパターンと時系列の全体的な文脈を結びつけます。
LightGTSのオリジナル版では、著者らは、Encoderの処理後に最後の隠れトークンを取り出し、指定された予測ホライズンをカバーするために必要な回数だけ、それを正確に複製することを提案しています。これにより、Decoderは出力シーケンス全体を一度に生成できます。 一方、私たちは簡素化に向けて大胆な一歩を踏み出しました。複製は必要ありません。 第一に、私たちの目標は極めて高精度な数値を得ることではなく、潜在表現から価値ある情報をすべて抽出し、それを取引の意思決定に利用するエージェントに提供することです。 第二に、私たちは新しいバーが形成されるたびに計算を実行しますが、その間隔は常に市場サイクル全体よりも短くなります。 そのため、各単位系列につき、最後のトークンが1つあれば十分です。
したがって、複数のコピーを作成することなく、この最終埋め込みをメインパイプライン経由でDecoderに送ります。 そこでは、同じMulti-Head AttentionとFeed-Forwardを通過しますが、不要な繰り返しはありません。モデルは、最新の市場動向に関する関連情報をすべて含む、純粋で凝縮された表現に基づいて処理をおこないます。 このアプローチは、リソースを節約し、ロジックを簡素化するとともに、エージェントが可能な限り迅速に行動できるようにします。何しろ、各バーに対して即座に応答する必要があるのです。私たちに必要なのは、トークンを1,000個複製したものではなく、利益につながる行動を導く準備のできた、単一の強力なシグナルなのです。
モデルアーキテクチャ
最後に、私たちは集大成となる段階、つまり、入念にデバッグされたすべてのモジュールが一体となり、滑らかに機能する単一のシステムへと統合される瞬間にたどり着きます。 私たちのMQL5プロジェクトでは、これはCreateDescriptions関数内でおこなわれます。ここでは、ニューラルネットワークの7つのブランチを段階的に構築します。具体的には、Encoder、3つの予測ストリーム、そしてエージェントを構成する3つのコンポーネント、すなわちActor、Director、Criticです。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
まず、各コンテナ内の動的配列へのポインタが有効であることを確認します。 まだ作成されていない動的配列があれば、新しい動的配列用のメモリを慎重に確保します。 これらのコンテナは、モデルのニューラル層の記述を順につなぎ合わせていくための枠組みとなります。
Encoderでは、基本的な全結合層からすべてが始まります。この層は、生の入力データ、つまり、それぞれが一連の特徴量によって記述された過去のバーの系列を受け取ります。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、ノイズを加えたバッチ正規化を導入し、活性化の分布を滑らかに均一化します。 その後、入力データに対する最初の演算に進み、系列内の隣接する点どうしの差分を抽出します。 これにより、変化の動態を際立たせることができます。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次の層では、生データにタイムスタンプの高調波成分を追加します。これにより、各バーは単なる価格と出来高の特徴量の集合ではなく、タイムライン上の一点へと変換されます。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
次に、適応型畳み込みCNeuronAdaptConvへの入力に備えて、結果を転置します。 一見すると、これはありふれた技術的処理に思えるかもしれませんが、ここで重要な転換が起こります。データを再構成し、各単位系列を適応型パッチに分割できるようにします。適応型パッチとは、時系列の局所的なパターンを含む、コンパクトな局所区間のことです。
これにより、CNeuronAdaptConvは入力データの特性に柔軟に適応できるようになります。あるパッチは急激な変動を捉え、別のパッチは安定した期間や振動を捉えます。 つまり、単に値を並べた平坦な配列をモデルに与えるのではなく、明確な時空間階層を備えた構造化表現を提供します。 これにより、Encoderは短期的な文脈を保持すると同時に、複雑な時系列に潜む深層の隠れたパターンを明らかにできます。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronAdaptConv;
   descr.count = Segments;
   descr.window = 2*prev_out/Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
次のステップはRoPE(回転位置エンコーディング)です。ソースデータにはすでにタイムスタンプが追加されているため、一見すると、この仕組みは冗長に思えるかもしれません。 しかし、ここでの重要な違いは、適用されるレベルにあります。
追加されたタイムスタンプが対応するのは、個々のバー、つまり生のソースデータです。 これらは、構造的な処理が始まる前に、各観測値の絶対的な時間座標を記録する役割を果たします。
その後、データはパッチ化の段階に進み、この処理で連続する複数のバーがセグメントにまとめられます。 次に、このセグメントは単一のトークン、すなわち局所的な時間区間を集約した表現へと変換されます。 この段階で、生成されたトークンに対してRoPEが適用されます。
したがって、RoPEはパッチ内の位置をエンコードするわけではありません。というのも、この段階では、パッチ内の情報はすでに単一の表現へと集約されているからです。 その代わりに、系列全体におけるパッチの位置に関する情報を埋め込みます。 つまり、RoPEによって、モデルはパッチ同士の相対的な出現順序を理解できるようになります。これは、対象となる時系列の全体構造を分析するうえで極めて重要です。
このようなRoPEの位置づけにより、RoPEは理想的な補完手段となります。バー単位のタイムスタンプと組み合わせることで、バー単位の詳細な値から、集約されたブロックの相対位置に至るまで、階層的な時間認識を実現します。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRoPE;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = prev_var;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
RoPEを適用した後、データを再び転置します。今回は、後続のMulti-Head Self-Attentionモジュールが、トークンベクトルの配列を時系列順序を考慮しながら効果的に読み取れるようにするためです。 これは純粋に技術的な処理ですが、重要なステップです。Attentionがデータを正しい形状で受け取らなければ、トークンを重み付けして比較するどころか、混乱を招くだけになってしまいます。
次に、4つのAttentionヘッドと3つの連続層で構成されたSelf-Attentionが機能します。 このアーキテクチャにより、モデルはトークン間の関係のさまざまな側面を並列に分析できます。各ヘッドは、それぞれ独自の特徴部分空間に注目します。 これは、4人の専門家がそれぞれ独自の視点からパッチ間のつながりの重要性を評価するようなものです。
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronComplexMLMHAttentionOCL;
   descr.count = prev_count;
   descr.window = prev_out / 2 * prev_var;
   descr.window_out = descr.window / 4;
   descr.layers = 3;
   descr.step = 4;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
ここで強調しておきたいのは、RoPEの仕組みは、単に位置情報を追加するための手法ではないということです。 これは、複素数領域の数学的手法を用いて、複素平面上でトークンベクトルを回転させます。 このアプローチでは、埋め込みに位相シフトを組み込むことで、トークン間の相対位置を明示的に考慮できます。
まさにその理由から、標準的なSelf-Attentionを使用していたLightGTSフレームワークの著者の実装とは異なり、私たちは意図的に複素数版のAttentionモジュールであるCNeuronComplexMLMHAttentionOCLを採用しました。 これにより、数学的な整合性が確保されます。位置エンコーディングを複素数領域でおこなうのであれば、Attention層も複素数値を扱える必要があるからです。
その結果、モデルはトークン間の関係を認識するだけでなく、それらの位相シフトも考慮できるようになります。これは、金融時系列における周期的な構造や波状の構造を扱う際に、極めて重要です。 3層のAttentionによって処理に深みが生まれ、モデルは時系列における局所的な依存関係と、より離れた依存関係の両方を捉えることができます。 このようにして、文脈情報が豊富な表現が形成されます。これは、系列全体を凝縮して概観したようなものであり、モデルの次の処理段階に向けて準備されます。
Decoderには、Multi-Head Attentionの能力と、スパース混合エキスパート(Sparse MoE)の洗練された仕組みを組み合わせたCNeuronTimeMoEAttentionモジュールを使用します。 このモジュールは、時系列の効率的な分析と表現力豊かな潜在表現の構築を目的として特別に設計されています。これは、時間的な動態のあらゆる細部が重要となる金融分野のアプリケーションにおいて、特に重要です。
重要な革新の1つは、従来のfeedForwardブロックを、スパース混合エキスパートブロックであるCNeuronTimeMoESparseExpertsに置き換えたことです。 このアプローチにより、計算リソースを複数のエキスパート間で柔軟かつ効率的に配分できます。各エキスパートはそれぞれ独自の特徴量サブセットを分析するため、処理品質の向上と冗長性の削減が可能になります。
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * prev_count, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 3;
   descr.step = 4;                                                // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }//---
   CLayerDescription *latent = descr;
Environment State Encoder(環境状態エンコーダ)の出力として、分析対象のデータをコンパクトかつ表現力豊かに表した潜在表現が得られます。
この表現は、単なるベクトルの集合ではありません。 市場の動態、季節性、短期的な異常の重要な特徴をすべて保持した、現在の市場状況を詳細かつ慎重に精緻化した記述です。 Encoderは、市場のふるまいを吸収し、ノイズを取り除き、その本質を抽出して、コンパクトなトークンとして渡すかのようです。
これらのトークンは、履歴全体をそのまま保持するわけではありません。その代わりに、意味を蓄積し、因果関係を集約し、最も重要な要因を特定します。 そして、これらのトークンこそが、その後、システム内の他のすべてのコンポーネント、すなわち予測ブロック、意思決定モジュール(Actor)、評価器(DirectorとCritic)にとって、普遍的な知識源となります。
実際、私たちのアーキテクチャにおいて、Encoderは、過去および現在の市場情報がすべて通過する唯一の意味圧縮チャネルです。 その処理結果は、複雑な情景を高品質な写真に収めたものにたとえられます。圧縮されていても焦点は明確であり、さらなる分析や意思決定に重要な細部が豊富に含まれています。
学習時には、豊かで安定した潜在空間を形成するために、予測ホライズンがそれぞれ異なる3つの予測モデルを並列に使用します。 このアプローチにより、Encoderは汎化能力を失うことなく、短期的な衝動的変動と長期的な市場トレンドの両方を捉えることができます。
これらのモデルはそれぞれ、同じEncoderの出力を利用しますが、特定の予測ホライズンに対応する独自のターゲットを用いて学習します。 逆伝播では、3つのモデルすべてからの勾配が集約されるため、Encoderを次のような多次元の目的に対して同時に学習させることができます。
- 短期的には高速かつ正確であること。
- 市場ノイズに対する頑健性を維持すること。
- 戦略的な方向性を失わないこと。
このように、学習段階から潜在空間にさまざまなレベルの市場ロジックを吸収させることで、その後、システム内の他のすべてのコンポーネントに大きな優位性をもたらします。 このEncoderが生成する状態表現は、取引判断の生成(Actor)にも、その品質の評価(CriticとDirector)にも、同じように適しています。
予測モデルのアーキテクチャは、以前の研究から一切変更せず、そのまま引き継ぎました。 すでにさまざまなタスクで有効性が実証されているため、本記事ではその詳細に立ち入る必要はありません。
一方、Actorのアーキテクチャには、方策の適応性と表現力を高めることを目的とした大幅な改良を加えました。更新された構造は7層で構成され、それぞれがモデルに特定の機能を追加します。 まず、従来どおり基本的な全結合層を使用し、現在の口座状態とポジションに関する情報を入力します。
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
続いて、学習を安定させ、異なるソースから得られた特徴量のスケールを揃えるために、バッチ正規化を適用します。
Multi-Head Cross-Attention層により、モデルは現在の口座状態を、Environment State Encoderから得られた分析対象の市場状況のコンテキストと対応づけることができます。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,           // Input window
                    latent.windows[0]        // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                      // Input units
                    latent.units[0]          // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 8;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
2層・4ヘッドのAttentionアーキテクチャにより、モデルは行動を生成するために、コンテキストの中から関連する側面を選択できます。
次に、3層構成の意思決定用MLPが続きます。 ここでは、各層がそれぞれ独自の活性化関数を使用します。 双曲線正接関数(tanh)により、トークンをコンパクトな連続空間に圧縮し、境界付近での感度を高めることができます。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
続いて、正の値を保持する滑らかな非線形関数を適用します。 これは、行動パラメータを生成するうえで重要です。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
この層は、後続の行動サンプリングに使用するロジットも生成します。 出力数が2倍になっているのは、確率的方策の考え方に基づき、平均と分散をパラメータ化していることに関係している可能性があります。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = 2 * NActions;
   descr.activation = SoftPlus;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
変分層を導入することで、分布を制御しながら確率的に行動を生成することが可能になります。 これにより、エージェントの探索能力が向上します。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronVAEOCL;
   descr.count = NActions;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
最後のステップは、すでに生成された行動に対して畳み込みを適用することです。 これにより、行動パラメータ間の局所的な依存関係を強化するとともに、行動パラメータを [0, 1] の範囲に写像するソフトな確率的フィルタを導入できます。
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = NActions / 3;
   descr.window = 3;
   descr.step = 3;
   descr.window_out = 3;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
全体として、新しいActorモジュールのアーキテクチャは、コンテキストとのより深い相互作用、行動のばらつきの大きさ、そして取引判断を下す際に過去の依存関係を考慮する能力を備えています。
評価モデルであるDirectorとCritic、および予測コンポーネントは、以前の研究から変更せずに引き継ぎました。 アーキテクチャのこの部分は、長期間にわたる検証を経ており、エージェントの学習において有効であることが実証されています。 学習可能なすべてのコンポーネントの完全なアーキテクチャは、添付ファイルに含まれています。
テスト
モデルの学習プロセスは2つのフェーズに分けて実施しました。これにより、システムを一貫性と信頼性を保ちながら、焦ることなく構築することができました。
まず、オフライン学習を実施しました。 そのために、M1時間足における通貨ペアEURUSDの過去15年分のデータを使用しました。 このデータ量は、長期間のレンジ相場から急激なトレンドまで、また、安定した期間から高ボラティリティの期間まで、さまざまな市場状況を網羅しています。 モデルには、多種多様な状況下で市場がどのように振る舞うかを観察する、またとない機会が与えられました。 Encoderは規則性を認識し、意味のあるパターンを特定し、市場状態をコンパクトで情報量豊かな特徴ベクトルにエンコードすることを学習しました。 このベクトルは、その後エージェントがおこなうすべての意思決定の基盤となります。 学習中、ActorはCriticとDirectorからのフィードバック信号に基づいて行動戦略を学習し、これによって安定した論理的な行動モデルを形成できました。
続いて、第2フェーズである、2024年の過去データを使用したモデルのオンライン微調整へと進みました。 ここでは、実際のリアルタイム取引に近い条件下で学習をおこないました。モデルはローソク足ごとに市場と相互作用し、市場ノイズ、ランダムな変動、時間的な歪みに直面しました。 これにより、モデルを微調整するだけでなく、市場のリアルタイムな動態に合わせて行動を適応させ、戦略を調整し、不確実性に対する耐性を高めることができました。
学習完了後、新しいデータ、すなわち2025年1月から3月までのレートを使用して、本格的なテストを実施しました。 すべての設定は事前に固定され、テスト期間を通じて変更されませんでした。 これにより、評価の客観性と透明性が確保され、カーブフィッティングや介入が入り込む余地を排除しました。 テスト結果を以下に示します。
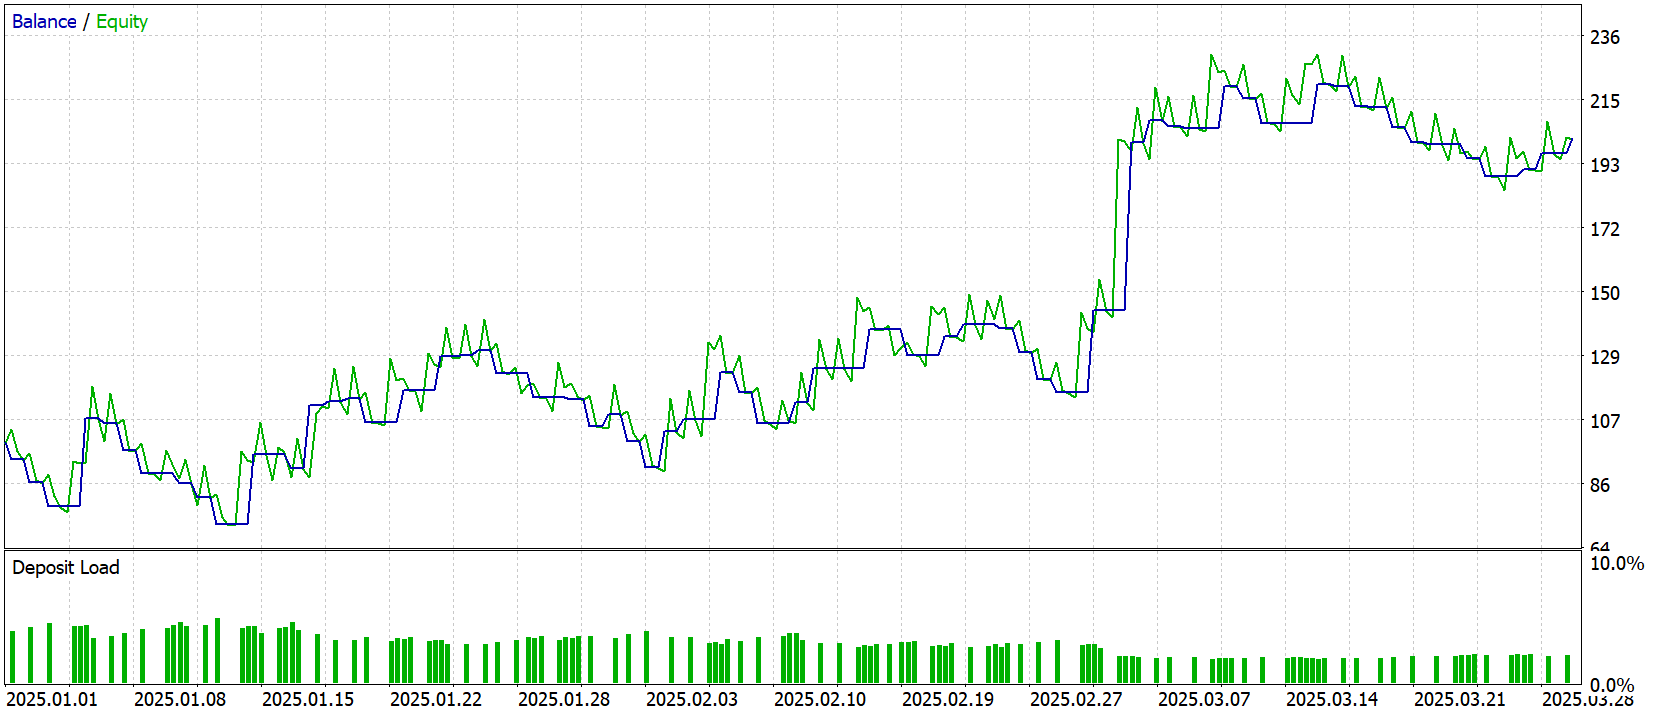
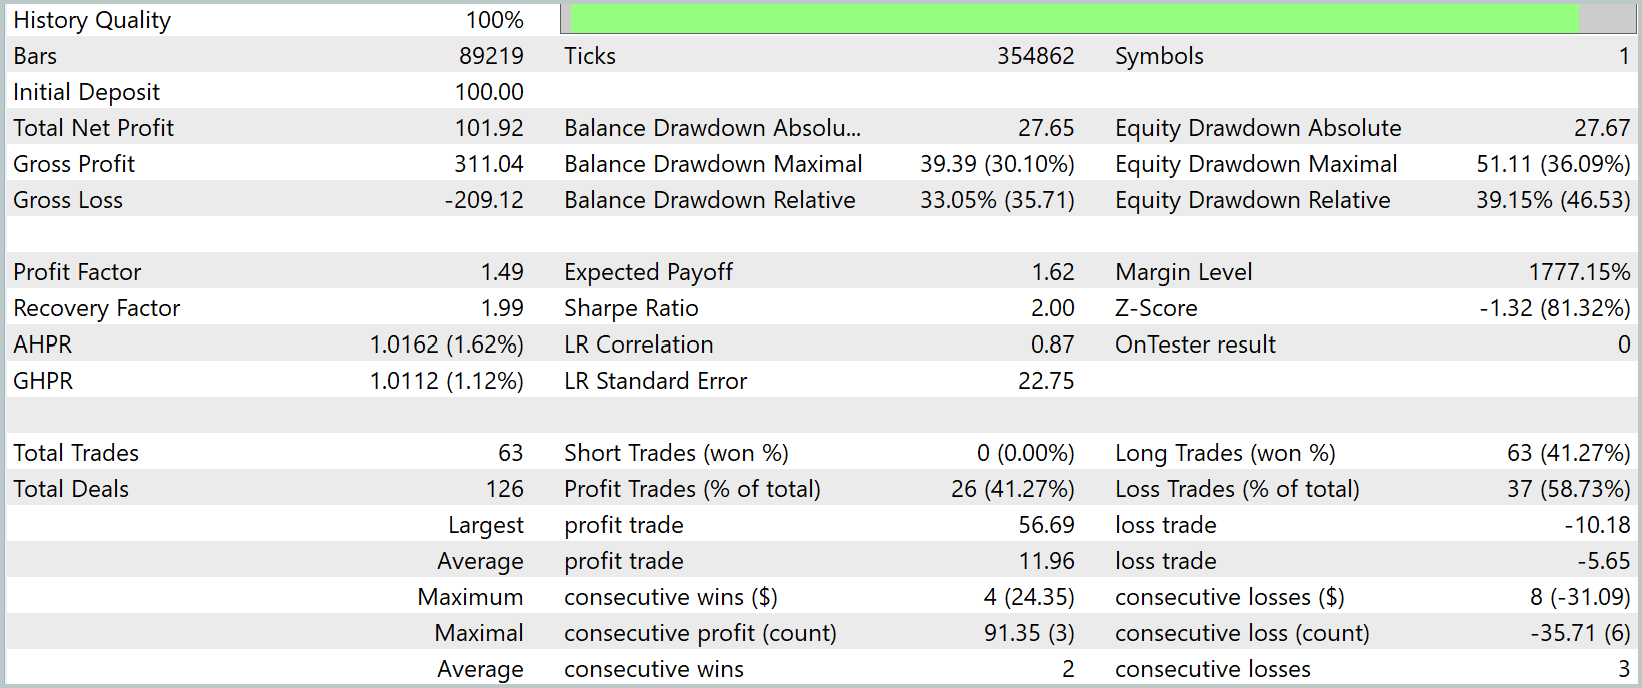
1分足(M1)チャートを用いた3か月間のテストで、モデルは資金を100米ドルから約202米ドルへと増加させ、資金を2倍以上にするという目覚ましい成果を示しました。 一方、利益となった取引は全体の約41%にとどまりましたが、平均利益の12米ドルは平均損失の5.6米ドルを大きく上回り、その結果、プロフィットファクターは1.49となりました。 エクイティカーブを見ると、ドローダウンの後に急激な上昇が繰り返されていることが明確にわかります。また、最大ドローダウン36%からの迅速な回復は、リカバリーファクターがほぼ2であることからも確認できます。
しかし、こうした肯定的な結果にもかかわらず、1つの重大な偏りが際立っています。モデルは一貫してロングポジションのみを取り、より大きな上昇トレンドに乗り続けているのです。 これは特に1分足の時間軸で顕著です。価格が上昇している間、Agentは利益を確保しますが、反転の兆しが少しでも現れると、ショートポジションによって利益を得る機会を逃してしまいます。
この戦略を真に汎用性の高いものにするには、さらなる最適化に取り組む必要があります。
結論
今回の取り組みでは、適応型パッチ化やRoPEから、Time‑MoEAttentionやActor–Director–Criticといった複雑なモジュールに至るまで、柔軟なニューラルネットワークアーキテクチャを開発しました。 このシステムは、短期的な衝動的変動と長期的なトレンドの両方を検出でき、異なる予測ホライズンに対する3つの予測によって、市場ノイズに対する頑健性を備えています。 次のステップは、ロングポジションとショートポジションの両方への対応を追加し、両方向のリスク管理を微調整することで、双方向取引に向けて戦略を最適化することです。 実データに基づく大規模なテストと微調整を十分に完了して初めて、真に競争力のある自動取引システムを開発できるでしょう。
参考文献
- LightGTS: A Lightweight General Time Series Forecasting Model
- RoFormer: Enhanced Transformer with Rotary Position Embedding
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18686
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:確率的時系列予測(K2VAE)
 取引におけるニューラルネットワーク:適応的周期セグメンテーション(LightGTS)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:インテリジェントな予測パイプライン(スパース混合エキスパート)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索