

Neuronale Netze im Handel: Heterogenitätsgestütztes Metaparameterlernen (Fazit)
 17
 0

Einleitung
Der algorithmische Handel verzeiht selten übermäßige Komplexität oder ungerechtfertigt vereinfachte Lösungen. Jedes Modell – sei es nun ein hochkomplexes Ensemble neuronaler Netze oder ein minimalistischer autoregressiver Filter – muss sich letztendlich im Laufe der Zeit und auf dem Markt bewähren. Genau aus dieser Perspektive heraus wurde HimNet konzipiert – ein Framework, das nicht darauf abzielt, durch die Anzahl der trainierbaren Parameter oder die Exotik seiner Berechnungen zu beeindrucken. Im Gegenteil: Der Schwerpunkt liegt auf der Erzielung stabiler, reproduzierbarer und wirtschaftlich aussagekräftiger Ergebnisse.
Von Anfang an zeichnet sich HimNet durch drei Eigenschaften aus, die es von vielen anderen Ansätzen unterscheiden. Da ist zunächst einmal die Rationalität der Architektur: Sie enthält keine überladenen Schichten, die lediglich den Anschein einer tiefgreifenden Analyse erwecken. Jedes Modul erfüllt hier einen Zweck und hat seine Berechtigung. Zweitens zeichnet sich das Framework durch eine wohldosierte Anpassungsfähigkeit aus: Anstatt sich gedankenlos an das Rauschen jeder Marktschwankung anzupassen, schafft es ein Gleichgewicht zwischen Flexibilität und Stabilität. Und drittens: Minimalismus bei der Parameterverwaltung. HimNet ist so konzipiert, dass die Anzahl der trainierbaren Koeffizienten auf das notwendige Minimum reduziert wird. Dies hilft, eine übermäßige Anpassung an historische Daten zu vermeiden und die Vorhersagekraft auch in weit entfernten Abschnitten von Zeitreihen zu erhalten.
In unseren früheren Arbeiten haben wir die internen Mechanismen dieses Frameworks systematisch untersucht. Ausgehend von den theoretischen Grundlagen haben wir die Methoden zur Erzeugung von Embeddings eingehend untersucht und analysiert, wie sich rekurrente und konvolutionelle Komponenten gegenseitig ergänzen. Die HimNet-Architektur gleicht einem gut abgestimmten Mechanismus, in dem jedes Rädchen – sei es ein Block für Tschebyscheff-Polynome oder der GCRU-Mechanismus – seine eigene, genau definierte Aufgabe erfüllt. Hierbei handelt es sich nicht um eine bloße Aneinanderreihung von Technologien, sondern um ein sorgfältig durchdachtes Konzept, das eine aussagekräftige Darstellung des Marktes ermöglicht, ohne die Verarbeitungsgeschwindigkeit zu beeinträchtigen oder die Rechenkette übermäßig zu verkomplizieren.
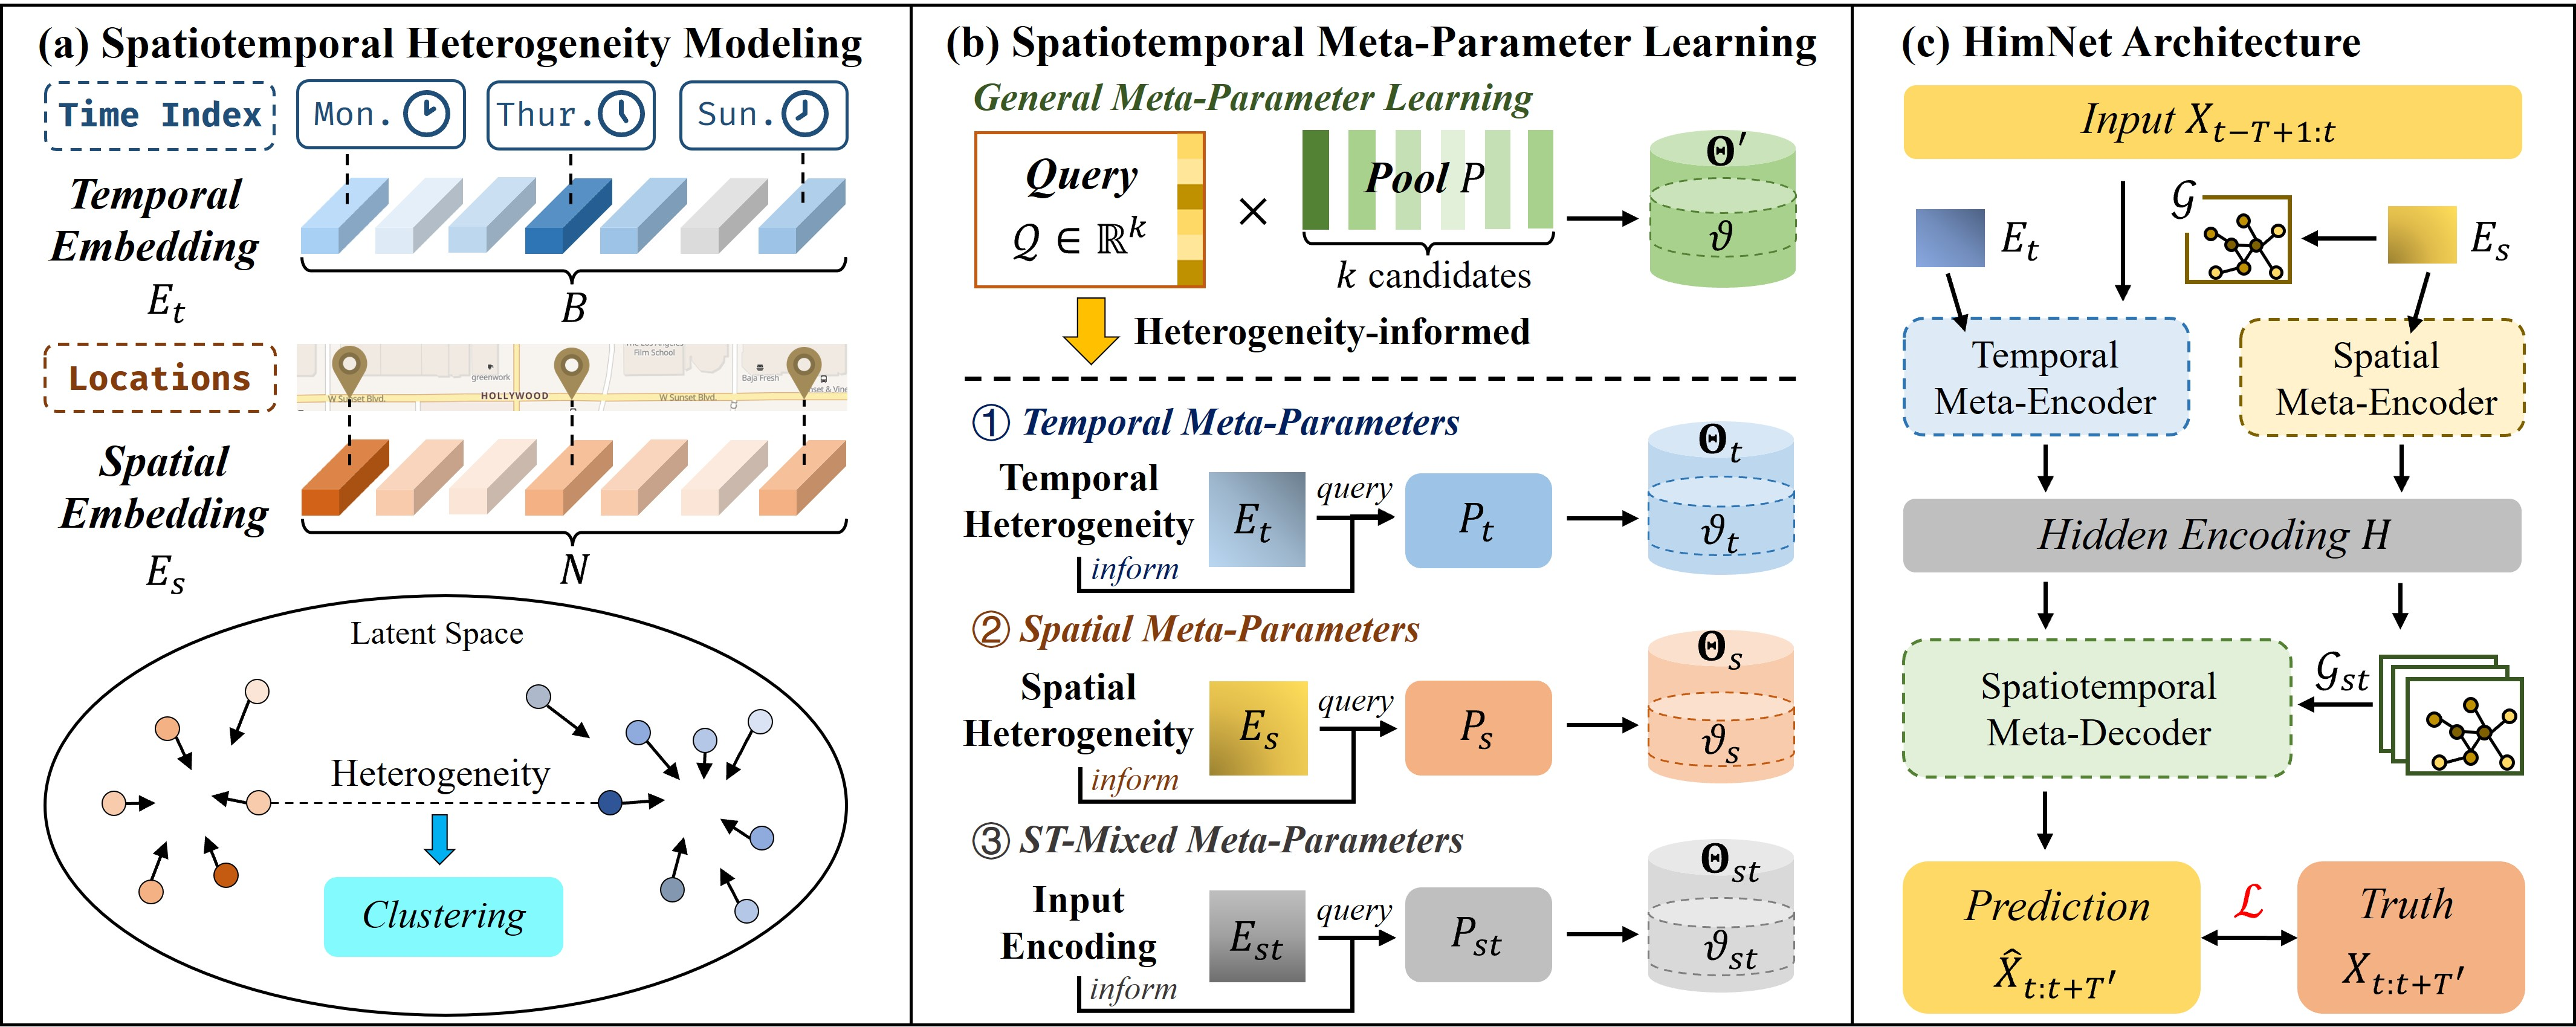
Das HimNet-Framework basiert auf der klassischen und in vielerlei Hinsicht bewährten Encoder–Decoder-Architektur. Dieses Schema hat sich bei Aufgaben zur Verarbeitung komplexer Sequenzen bewährt, bei denen es nicht nur darauf ankommt, den aktuellen Zustand des Marktes zu erfassen, sondern auch stabile Muster daraus zu extrahieren, um darauf aufbauende Prognosen zu erstellen. Der Encoder und der Decoder basieren auf derselben Grundlage: Beide nutzen trainierbare Embeddings und rekurrente Graphblöcke (GCRU). Es gibt jedoch einen subtilen, aber wichtigen Unterschied zwischen ihnen – nämlich in der Art und Weise, wie die Embeddings gebildet werden.
Im Encoder werden temporale und räumliche Embeddings direkt aus vordefinierten Mengen extrahiert und als eine Art Abfrage an Metaparameterpools verwendet. Dadurch kann sich der Encoder an den Kontext anpassen.
Der Decoder hingegen erzeugt Embeddings indirekt – auf der Grundlage einer latenten Repräsentation, die aus den Ausgaben des Encoders synthetisiert wird. Er projiziert die verborgene Repräsentation in ein räumlich-zeitliches Embedding, das als Abfrage an das ST-Metaparametermodell dient und es dem Decoder ermöglicht, Gewichte zu generieren.
Wir haben bereits umfangreiche Vorarbeiten geleistet: Wir haben die grundlegenden Komponenten des Modells implementiert, darunter rekurrente Graphblöcke, die in der Lage sind, räumlich-zeitliche Abhängigkeiten in den Daten effektiv zu berücksichtigen. Nun ist es an der Zeit, zur nächsten Ebene der Hierarchie überzugehen – dem Aufbau einer vollwertigen Struktur für den Encoder und den Decoder. Diese Phase wird als Brücke zwischen den einzelnen Elementen des Frameworks und dessen praktischer Anwendung dienen. An dieser Stelle werden abstrakte Blöcke miteinander verknüpft, und der Datenfluss beginnt, eine aussagekräftige Darstellung zukünftiger Marktzustände zu bilden.
Encoder
Die Autoren des HimNet-Frameworks haben einen zweisträngigen Datenverarbeitungsmechanismus vorgesehen, bei dem für räumliche und zeitliche Abhängigkeiten jeweils ein eigener Encoder zuständig ist. Dieser Ansatz ermöglicht es, eine Vermischung verschiedener Signalstrukturen zu vermeiden und diese stattdessen in parallelen Zweigen zu untersuchen, wodurch eine genauere und klarere Identifizierung von Schlüsselmustern gewährleistet wird. Anknüpfend an die vorgestellten Ideen werden wir heute damit beginnen, einen temporalen Encoder zu erstellen. Schließlich ist die Zeit der Faden, aus dem die gesamte Marktdynamik gewoben ist.
Temporaler Encoder
Das Objekt CNeuronHimNetTempEncoder ist eine Art zeitlicher Filter innerhalb des Frameworks, der dazu dient, in Folgen von Kursdaten und in Marktmustern verborgene Muster zu extrahieren. Dabei arbeitet es auf mehreren Skalen gleichzeitig.
class CNeuronHimNetTempEncoder   : public CNeuronBaseOCL
  {
protected:
   uint              aTimeframes[2];
   CCircleParams     caEmbeddings[2];
   CNeuronBaseOCL    cConcatEmbeddings;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;

public:
                     CNeuronHimNetTempEncoder(void) {};
                    ~CNeuronHimNetTempEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support,
                                 int label);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetTempEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
//---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
Die Schlüsselelemente sind zwei Embedding-Mengen, die durch das Array caEmbeddings repräsentiert werden. Jedes dieser Embedding-Wörterbücher speichert keine vollständigen Daten, sondern lediglich kompakte Repräsentationen einzelner Zeitschritte – Embeddings, die als Abfragen an die Parameterpools des Modells dienen. Das bedeutet: Jeder Zeitschritt greift effektiv auf seinen eigenen Parameterunterraum zu, ruft den erforderlichen Wert ab und konfiguriert dadurch den nachfolgenden Datenfluss.
Es ist wichtig zu betonen, dass beide Embedding-Mengen koordiniert und dennoch unabhängig voneinander arbeiten – dies ermöglicht es dem Modell, zwei Zeitskalen gleichzeitig zu betrachten und kurzfristiges Rauschen nicht mit langfristiger Trägheit zu verwechseln. Im Zuge der Implementierung der Methoden werden wir im Detail untersuchen, wie diese Abfragen mit dem Datenstrom interagieren und welche Aufgaben die anderen Komponenten des temporalen Encoders übernehmen.
Alle internen Objekte werden statisch deklariert, sodass Konstruktor und Destruktor auf ein Minimum beschränkt bleiben. Die eigentliche Initialisierung aller deklarierten Komponenten und geerbten Objekte erfolgt zentral in der Methode Init.
bool CNeuronHimNetTempEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint units, uint window, uint window_out, uint cheb_k,
                                    uint layers, uint embed_dim, uint period1,
                                    uint timeframe1, uint period2, uint timeframe2,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(layers <= 0)
      return false;
Der Algorithmus beginnt mit einem kleinen Steuerblock – wir prüfen die Anzahl der internen Schichten im Encoder. Ist der Wert des Parameters layers kleiner oder gleich 0, beendet sich die Methode sofort mit einem Fehler. Dadurch werden sinnlose Konfigurationen vermieden: Wenn keine Schichten vorhanden sind, gibt es nichts zu lernen.
Anschließend wird die gleichnamige Methode in der übergeordneten Klasse aufgerufen, wobei die Basisparameter des Objekts an sie übergeben werden. In diesem Schritt definieren wir die Form des Tensors für die Ausgabe des Encoders und reservieren die erforderlichen Ressourcen. Wenn die grundlegende Initialisierung fehlschlägt, macht es keinen Sinn, die Vorgänge fortzusetzen – die Methode gibt false zurück.
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
Anschließend werden die Embedding-Mengen vorbereitet, und die Zeitschrittgröße wird sofort in den entsprechenden Elementen des Arrays aTimeframes gespeichert.
   int index = 0;
   if(!caEmbeddings[0].Init(0, index, OpenCL, embed_dim, period1, optimization, iBatch))
      return false;
   aTimeframes[0] = MathMax(1, timeframe1);
   index ++;
   if(!caEmbeddings[1].Init(0, index, OpenCL, embed_dim, period2, optimization, iBatch))
      return false;
   aTimeframes[1] = MathMax(1, timeframe2);
   if(!cConcatEmbeddings.Init(numOutputs, myIndex, open_cl, 2 * embed_dim, optimization_type, batch))
      return false;
Jedes Embedding-Wörterbuch ist auf eine eigene zeitliche Granularität konfiguriert: Die Embedding-Größe und die Periode legen fest, welche zeitbezogenen Abfragen an den Parameterpool gesendet werden. Sollte eine dieser Initialisierungen fehlschlagen, bricht die Methode ab – ein nur teilweise aufgebauter Encoder ist nicht zulässig.
Nachdem die Wörterbücher definiert wurden, wird cConcatEmbeddings erstellt – ein Objekt, das die beiden Embeddings zu einem einzigen Vektor zusammenführt.
Als Nächstes beginnt der Aufbau der GRCU-Schichten. Zunächst leeren wir den cGRCUs-Container und binden den OpenCL-Kontext explizit.
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
      return false;
Anschließend wird das erste CNeuronHimNetGCRU-Objekt erstellt und mit den Parametern der ersten Schicht initialisiert: Für diese Schicht wird die Anzahl der Eingabemerkmale auf die entsprechende Dimension der zu analysierenden Zeitreihe gesetzt, und die Ausgabedimension wird auf die der latenten Repräsentation festgelegt. Diese erste Schicht bildet die unterste Ebene des Stapels.
Wenn die Initialisierung erfolgreich verläuft, wird die Schicht dem cGRCUs-Container hinzugefügt. Wenn das Hinzufügen oder die Initialisierung fehlschlägt, geben wir false zurück.
Bei allen nachfolgenden Schichten wird die Logik etwas einfacher. In der Schleife werden weitere CNeuronHimNetGCRU-Objekte erstellt, doch nun weisen die Eingabe- und Ausgabetensoren dieselben Dimensionen auf. Dies ist eine gängige Vorgehensweise: Die erste Schicht erweitert und bündelt den Kontext, während die nachfolgenden Schichten diesen Kontext in der Tiefe weiter verfeinern. Im Falle eines Fehlers – sei es bei der Erstellung, der Initialisierung oder dem Hinzufügen – beenden wir den Vorgang ordnungsgemäß, indem wir aus der Methode den Wert false zurückgeben, um sicherzustellen, dass das System nicht in einem inkonsistenten Zustand verbleibt.
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
         return false;
     }
Sobald der GRCU-Stack gebildet wurde, initialisieren wir den Hilfspuffer bSupportAccum, der dazu dient, die aus den verschiedenen Schichten des Encoders stammenden Fehlergradienten der Tschebyscheff-Polynome zu akkumulieren.
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(units * units * cheb_k, 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
Als Nächstes folgt ein wichtiger praktischer Schritt: Die Ausgabe des Encoders ist die Ausgabe des letzten Objekts im cGRCUs-Container. Um unnötiges Kopieren großer Tensoren zu vermeiden, synchronisieren wir sowohl die Aktivierungsfunktionen als auch die Zeiger auf die Ergebnis- und Gradientenpuffer. Mit anderen Worten: Der Encoder übernimmt die Aktivierungssemantik der letzten Schicht und verbindet seine externen Schnittstellen direkt mit deren internen Puffern GRCU. Dies führt zu erheblichen Einsparungen bei Speicherplatz und Zeit.
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
Nach der Initialisierung des Objekts wenden wir uns der Kernfunktionalität des temporalen Encoders zu: der Erstellung der Methode feedForward für den Vorwärtsdurchlauf.
bool CNeuronHimNetTempEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support, int label)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
     {
      int position = (label / int(aTimeframes[i])) % caEmbeddings[i].GetPeriod();
      if(!caEmbeddings[i].SetPosition(position) ||
         !caEmbeddings[i].FeedForward())
         return false;
     }
   if(!Concat(caEmbeddings[0].getOutput(), caEmbeddings[1].getOutput(),
              cConcatEmbeddings.getOutput(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
Der Algorithmus beginnt damit, Embeddings aus unseren Wörterbüchern abzurufen. Der Vorgang ist als Schleife organisiert, die nacheinander alle Wörterbücher im Array durchläuft. Für jedes Wörterbuch berechnen wir die aktuelle Position anhand des Zeitstempels, den wir von einem externen Programm erhalten haben. Anschließend erzeugen wir ein spezifisches zeitliches Embedding, indem wir die Methode FeedForward des entsprechenden Wörterbuchs aufrufen.
Im Grunde ist dies die Stelle, an der Zeit in eine Adresse zum Abrufen spezialisierter Gewichte umgewandelt wird. Um eine Analogie aus dem Handel zu verwenden: Wenn ein bestimmtes Zeitfenster eintritt, wählen wir die passende Konfiguration des Modells aus, ohne es neu zu trainieren – wir verwenden einfach eine andere Abfrage.
Sobald beide Embeddings ermittelt wurden, werden ihre Ergebnisse zu einem einzigen Tensor zusammengefasst.
Dann kommt der entscheidende Schritt: das Durchlaufen des GRCU-Containers. Die lokale Variable inputs wird mit einem Zeiger auf das Quelldatenobjekt initialisiert. In der Schleife über die Elemente des Containers cGRCUs durchlaufen wir nacheinander jede Schicht und rufen deren Methode für den Vorwärtsdurchlauf auf.
   CNeuronBaseOCL *inputs = NeuronOCL;
   CNeuronHimNetGCRU *current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
Es ist wichtig, den Schnittstellenvertrag zu verstehen: Die erste GRCU erhält die Rohdaten der zu analysierenden Sequenz sowie eine gemeinsame Embedding-Abfrage. Sie bildet ihre eigene verborgene Repräsentation. Danach wird der Zeiger in inputs durch das aktuelle Objekt ersetzt – die Ausgabe der ersten Schicht wird zur Eingabe für die nächste. So entsteht ein Stapel aufeinanderfolgender Transformationen: Die erste Schicht erweitert den Kontext, während die nachfolgenden Schichten die Darstellung verfeinern und komprimieren. In der Handelspraxis entspricht dies einem ersten Analysedurchlauf, bei dem alle Details erfasst werden, während die nachfolgenden Schichten – ähnlich wie erfahrenere Manager – das Signal filtern, aggregieren und für die Ausgabe aufbereiten.
Der Puffer für die Tschebyscheff-Polynome (Support) bildet den Kern der Graphaggregation (K-Hop). Indem dasselbe Objekt an jede Schicht übergeben wird, wird eine einheitliche Sicht auf die Beziehungsstruktur zwischen den einzelnen Sequenzen über den gesamten Stapel hinweg gewährleistet, während jede GRCU ihre eigenen Metaparameter (die aus dem Embedding generiert werden) verwendet, um diesen Support zu interpretieren.
Nachdem wir nun den Vorwärtsdurchlauf behandelt haben, ist es sinnvoll, zum Rückwärtsdurchlauf überzugehen – zu dem Punkt, an dem das Modell ausgewertet wird und wir die Verantwortung für den Fehler sorgfältig allen seinen Komponenten zuweisen. Die Methode calcInputGradients ist genau das Verfahren, bei dem die am Encoder-Ausgang akkumulierten Fehler durch den Stapel aus GRCU und die Embedding-Mengen zurückpropagiert werden, wodurch das Verhalten der einzelnen Komponenten angepasst wird.
bool CNeuronHimNetTempEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   if(!NeuronOCL || !Support)
      return false;
Zunächst prüft die Methode, ob gültige Zeiger übergeben wurden. Als Nächstes wird die Eingangsquelle für die letzte Schicht festgelegt. Wenn der Stapel aus mehr als einer Schicht besteht, nehmen wir die vorletzte GRCU; andernfalls nehmen wir das Quelldatenobjekt. Wir beginnen die Verteilung der Fehlergradienten bei der letzten GRCU – also genau jenem Objekt, dessen Ergebnis wir bei der Initialisierung als externe Ausgabe des Encoders festgelegt haben. Das ist sinnvoll: Der Gradient erreicht zunächst die Spitze des Stapels und breitet sich von dort aus nach unten aus.
   CNeuronBaseOCL *inputs = (cGRCUs.Total() > 1 ? cGRCUs[-2] : NeuronOCL);
   CNeuronHimNetGCRU* current = cGRCUs[-1];
   if(!current ||
      !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
      return false;
   if(!DeConcat(caEmbeddings[0].getGradient(), caEmbeddings[1].getGradient(),
                cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
Hier findet der Großteil der lokalen Berechnungen statt: Die letzte GRCU verteilt den empfangenen Gradienten auf ihre Eingabe, ihre internen Metaparameter und den Gradientenpuffer für die Tschebyscheff-Polynome (Support). Es ist wichtig zu verstehen, dass Support an dieser Stelle als gemeinsame Verbindungskarte dient und jede Schicht im Stapel dazu beitragen kann. Deshalb brauchen wir einen Akkumulationsmechanismus.
Der nächste Schritt besteht darin, den Gradienten des kombinierten Embeddings wieder in zwei Teile aufzuteilen – nämlich in die Gradienten der beiden Embedding-Mengen. Wir geben jedem Zweig seinen eigenen Beitrag zum Fehler zurück, damit die Wörterbücher später ihre Abfragen an die Parameterpools anpassen können.
Wenn der Stack mehr als eine Schicht enthält, beginnt ein sorgfältiger Prozess zur Akkumulation der Gradienten für Support. Zunächst speichern wir einen Zeiger auf den aktuellen Gradientenpuffer in der lokalen Variablen temp, damit wir den vorherigen Puffer mit den zuvor akkumulierten Werten nicht verlieren. Als Nächstes leiten wir die Fehlergradienten vorübergehend in den vorab reservierten Puffer bSupportAccum um.
   if(cGRCUs.Total() > 1)
     {
      CBufferFloat *temp = Support.getGradient();
      if(!Support.SetGradient(GetPointer(bSupportAccum), false))
         return false;
      for(int i = cGRCUs.Total() - 2; i >= 0; i--)
        {
         current = cGRCUs[i];
         inputs = (i > 0 ? cGRCUs[i - 1] : NeuronOCL);
         if(!current ||
            !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
            return false;
         if(!SumAndNormilize(temp, Support.getGradient(), temp, 1, false, 0, 0, 0, 1))
            return false;
         if(!DeConcat(caEmbeddings[0].getPrevOutput(), caEmbeddings[1].getPrevOutput(),
                      cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
            return false;
         for(uint i = 0; i < caEmbeddings.Size(); i++)
            if(!SumAndNormilize(caEmbeddings[i].getGradient(), caEmbeddings[i].getPrevOutput(),
                                caEmbeddings[i].getGradient(), 1, false, 0, 0, 0, 1))
               return false;
        }
      if(!Support.SetGradient(temp, false))
         return false;
     }
//---
   return true;
  }
In einer Schleife, die die Stack-Objekte in umgekehrter Reihenfolge durchläuft, rufen wir für jede Schicht die Methode zur Weiterleitung der Fehlergradienten auf. Als Nächstes addieren wir den neuen Beitrag zu dem bereits im Puffer temp akkumulierten Beitrag. Danach teilen wir den Gradienten des kombinierten Embeddings erneut in zwei Informationsströme auf. Abschließend addieren wir für jedes Wörterbuch die erhaltenen Werte zu den bisher akkumulierten Werten.
Nachdem wir alle Schichten durchlaufen haben, setzen wir die Zeiger auf die Datenpuffer wieder auf ihren Ausgangszustand zurück. Das ist wichtig: Nur so erhalten externe Optimierer das richtige Signal für die Aktualisierung der Parameter, die der Graphaggregation zugrunde liegen.
Nach erfolgreichem Abschluss aller Iterationen gibt die Methode true zurück, was bedeutet, dass der Gradient erfolgreich durch alle Komponenten des Encoders bis zur Ebene der Quelldaten weitergeleitet wurde.
Nachdem die Gradienten sorgfältig erfasst wurden, besteht der nächste Schritt darin, die Parameter zu aktualisieren. Die Methode updateInputWeights ist vom Aufbau her einfach, aber inhaltlich wichtig: Sie übergibt die Steuerung nacheinander an die internen Komponenten, die trainierbare Gewichte enthalten. Dies geschieht in derselben Reihenfolge, in der die Berechnungen ausgeführt werden.
bool CNeuronHimNetTempEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
      if(!caEmbeddings[i].UpdateInputWeights())
         return false;
Zunächst werden beide Embedding-Mengen in der Schleife aktualisiert. Bei jedem Aufruf von UpdateInputWeights werden die im vorherigen Schritt akkumulierten Gradienten auf die Parameter des entsprechenden Wörterbuchs angewendet.
Die Methode durchläuft dann den GRCU-Stack in Vorwärtsrichtung: Jede Schicht ist dafür zuständig, die Parameter ihrer Embeddings und Metaparameterpools lokal zu aktualisieren.
   CNeuronBaseOCL* inputs = NeuronOCL;
   CNeuronHimNetGCRU* current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current.updateInputWeights(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
Der vollständige Quellcode für diese Klasse, einschließlich der Implementierung aller Methoden, ist im Anhang beigefügt; er enthält alle oben besprochenen Details. Damit können wir unsere Analyse des temporalen Encoders als abgeschlossen betrachten und zum nächsten Thema übergehen.
Räumlicher Encoder
Bevor wir fortfahren, wollen wir erläutern, was der räumliche Encoder ist und wie er sich vom temporalen Encoder unterscheidet; schließlich ist das Verständnis dieses Unterschieds wichtig für die korrekte Integration in die Gesamtarchitektur von HimNet.
Der temporale Encoder arbeitete mit mehreren Embedding-Mengen, die als Abfragen an Parameterpools für unterschiedliche zeitliche Granularitäten dienten. Der räumliche Encoder benötigt dagegen keine große Anzahl periodischer Schlüssel – die Struktur der räumlichen Daten ist bei dieser Problemstellung stabil. Daher verwenden wir anstelle von Wörterbüchern einen einzigen Satz trainierbarer Parameter, die im cEmbedding-Objekt gekapselt sind. Dadurch verfügt das Modell über eine einzige, zentralisierte Darstellung des Marktraums, die während des Trainings verfeinert und anschließend als kontinuierliche Quelle für kontextbezogene Abfragen für GRCU genutzt wird.
class CNeuronHimNetSpatEncoder   :     public CNeuronBaseOCL
  {
protected:
   CParams           cEmbedding;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;
   CBufferFloat      bEmbeddingAccum;

public:
                     CNeuronHimNetSpatEncoder(void) {};
                    ~CNeuronHimNetSpatEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetSpatEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
   //---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
In seiner Architektur ähnelt das CNeuronHimNetSpatEncoder-Objekt stark dem temporalen Encoder. Es umfasst denselben Stapel rekurrenter Graphblöcke cGRCUs, einen ähnlichen Akkumulator für die Gradienten der Tschebyscheff-Polynome und eine Reihe von Methoden für Vorwärts- und Rückwärtsdurchläufe. Der Hauptunterschied besteht darin, dass wir anstelle von zwei Embedding-Mengen ein einzelnes parametrisiertes cEmbedding-Modul und einen zusätzlichen bEmbeddingAccum-Puffer haben. Dieser Puffer wird benötigt, um die Beiträge aller Schichten im Stapel zum Embedding-Gradienten zu akkumulieren.
Da sich der räumliche Encoder nur in geringfügigen Details vom temporalen Encoder unterscheidet, trägt die Konzentration auf die architektonische Logik und den Datenfluss dazu bei, den Text frei von unnötigen Wiederholungen zu halten. Der vollständige Code für die Klasse und alle ihre Methoden, der im Anhang bereitgestellt wird, ermöglicht es dem Leser, die feinen Unterschiede selbstständig nachzuvollziehen und genau zu verstehen, wie die Embedding-Parameter und Gradienten innerhalb der GRCU-Schichten aktualisiert werden.
Kombinierter Encoder
An dieser Stelle wenden wir uns dem Schlüsselmodul zu, das die Arbeit der beiden parallelen Encoder zu einer einzigen, einheitlichen Darstellung zusammenführt. Die Klasse CNeuronHimNetEncoder fungiert als Koordinator und gewährleistet die Integration räumlicher und zeitlicher Darstellungen. Der temporale Encoder erfasst Veränderungen im Zeitverlauf und identifiziert dabei kurz- und langfristige Trends, während der räumliche Encoder die Beziehungen zwischen verschiedenen Objekten analysiert. Die Ausgabedaten beider Ströme werden innerhalb der Klasse sorgfältig zusammengeführt und bilden so eine vollständige latente Repräsentation des Systemzustands.
class CNeuronHimNetEncoder    :  public CNeuronBaseOCL
  {
protected:
   CParams                    cEmbedding;
   CNeuronTransposeOCL        cEmbeddingT;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CNeuronHimNetTempEncoder   cTempEncoder;
   CNeuronHimNetSpatEncoder   cSpatEncoder;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetEncoder(void) {};
                    ~CNeuronHimNetEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
Architektonisch gesehen enthält das Objekt einen eigenen Satz trainierbarer Parameter (cEmbedding), die als Grundlage für die Erzeugung eines Tschebyscheff-Polynoms dienen.
Wie bereits in früheren Modulen des Frameworks ist die Klassenstruktur darauf ausgelegt, den Overhead zu minimieren und unnötige dynamische Operationen zu vermeiden. Alle internen Objekte werden hier statisch deklariert, sodass der Konstruktor und der Destruktor leer bleiben. Ihr Zweck besteht lediglich darin, den Lebenszyklus eines Objekts formal zu definieren, ohne dabei in die Logik der Ressourcenzuweisung einzugreifen. Die gesamte eigentliche Arbeit bei der Vorbereitung der Komponenten konzentriert sich auf die Methode Init, die als eine Art Dirigent fungiert: Sie konfiguriert nacheinander jedes interne Element, verteilt die Rollen unter den Encodern und verknüpft diese zu einer einzigen Rechenkette.
bool CNeuronHimNetEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out, uint cheb_k,
                                uint layers, uint embed_dim, uint period1,
                                uint timeframe1, uint period2, uint timeframe2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
Die Initialisierung beginnt damit, dass die Kontrolle an die übergeordnete Klasse übergeben wird, die bereits den Algorithmus zur Erstellung der Basis-Schnittstellen enthält. Anschließend wird eine Abfolge miteinander verknüpfter Komponenten gebildet: die trainierbaren Embedding-Parameter, die Schicht, die diese transponiert, sowie die Objekte zur Erstellung der diagonalen Korrelationsmatrix und zur Normalisierung der daraus resultierenden Abhängigkeiten. Hinzu kommt ein Objekt zur Erzeugung von Tschebyscheff-Polynomen für Graphentransformationen.
   int index = 0;
   if(!cEmbedding.Init(0, index, OpenCL, units * embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cEmbeddingT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
Jedem Element wird in der Berechnungspipeline ein eigener Index zugewiesen, und die Aktivierungsfunktionen werden streng anhand ihrer Position definiert. Für das Objekt zur Erzeugung von Embeddings verwenden wir den hyperbolischen Tangens, mit dem direkte und inverse Abhängigkeiten auf normalisierte Weise definiert werden können.
Besonderes Augenmerk wird auf die Synchronisation der beiden Datenströme gelegt: des temporalen Datenstroms (cTempEncoder) und des räumlichen Datenstroms (cSpatEncoder). Der erste dient der Ermittlung zeitlicher Muster unter Berücksichtigung von Perioden verschiedener Skalen und Prognosefenstern; der zweite dient der Abbildung der Beziehungen zwischen den Analyseeinheiten. Schließlich werden ihre Gradientenpuffer synchronisiert, was eine übermäßige Datenduplizierung verhindert und eine reibungslose Fehlerfortpflanzung während des Rückwärtsdurchlaufs gewährleistet.
   index++;
   if(!cTempEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, (embed_dim + 1) / 2,
                                           period1, timeframe1, period2, timeframe2, optimization, iBatch))
      return false;
   index++;
   if(!cSpatEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, embed_dim, optimization,
                                                                                                      iBatch))
      return false;
//---
   if(!SetGradient(cTempEncoder.getGradient(), true))
      return false;
//---
   return true;
  }
Somit dient die Init-Methode als Integrationspunkt für das gesamte Modul und verbindet separate Komponenten zu einer einheitlichen, in sich stimmigen Architektur, die für das Training und den Einsatz mit realen Finanzdaten bereit ist.
Sobald wir die Initialisierung des Objekts abgeschlossen haben, fahren wir mit der Entwicklung des Algorithmus für den Vorwärtsdurchlauf fort.
bool CNeuronHimNetEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
Beginnen wir mit den Grundlagen: Wir prüfen, ob ein gültiger Zeiger auf das Quelldatenobjekt des zweiten Informationsstroms übergeben wurde. In diesem Objekt erwarten wir den Zeitstempel der analysierten Sequenz. Wenn kein Zeiger vorhanden ist, beenden wir die Funktion sofort, um eine Beschädigung des Graphen und der Puffer zu vermeiden.
Als Nächstes folgt eine wichtige Verzweigung. Im Trainingsmodus erstellen wir den adaptiven Graphen von Grund auf neu. Zunächst generieren wir das Embedding. Als Nächstes erstellen wir seine transponierte Darstellung.
   if(bTrain)
     {
      if(!cEmbedding.FeedForward())
         return false;
      if(!cEmbeddingT.FeedForward(cEmbedding.AsObject()))
         return false;
      if(!MatMul(cEmbedding.getOutput(), cEmbeddingT.getOutput(), cSupport.getOutput(),
                 cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
         return false;
      if(!cNormSupport.FeedForward(cSupport.AsObject()))
         return false;
      if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
         return false;
     }
Die Operation „MatMul“ multipliziert das resultierende Embedding mit seiner transponierten Kopie und bildet so eine rohe Korrelationsmatrix zwischen den Knoten. Im Handelskontext bedeutet dies, dass Instrumentenpaare mit ähnlichen Verhaltensmustern enger miteinander verknüpft sind.
Wir normalisieren den Rohgraphen mithilfe der SoftMax-Funktion und wenden dabei eine stabile Nachbearbeitung an. Als Ergebnis dieser Operation erhalten wir eine stochastische Adjazenzmatrix, die für die Graphkonvolution geeignet ist.
Als Nächstes bilden wir Tschebyscheff-Polynome. Das ist unser K-Hop-Teleskop, mit dem wir den Einfluss von Nachbarn in einer Entfernung von bis zu K Kanten aufsummieren können, ohne den Laplace-Operator zu diagonalisieren – schnell, numerisch stabil und vollständig auf der GPU.
Im Inferenzmodus wird dieser Abschnitt übersprungen. Wir verwenden die Embeddings und Polynome, die wir bereits während des Trainings ermittelt haben, um keine Nanosekunden zu verschwenden und den Determinismus zu wahren.
Als Nächstes kommen die beiden Encoder. Zunächst speisen wir die zu analysierende multimodale Datenfolge, eine Menge von Tschebyscheff-Polynomen sowie einen Zeitstempel in den temporalen Verarbeitungszweig ein.
   if(!cTempEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject(), int(SecondInput[0])))
      return false;
Der Encoder verbindet das, was gerade geschieht, mit dem genauen Zeitpunkt, zu dem es geschieht, und überlagert dabei die Graphdynamik mit einem temporalen Regime.
Parallel dazu starten wir den räumlichen Encoder.
   if(!cSpatEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
Er benötigt keine zeitliche Kennzeichnung – hier kommen stationäre Knoten-Embeddings zum Einsatz. Das räumliche Grundgerüst sorgt für eine stabile Marktkarte. Beide Verarbeitungszweige erhalten dieselbe K-Hop-Basis, betrachten sie jedoch aus unterschiedlichen Blickwinkeln – aus zeitlicher und aus räumlicher Sicht.
Den letzten Schliff bildet die sorgfältige Zusammenstellung der Ergebnisse. Wir summieren die Ausgaben der Encoder.
   if(!SumAndNormilize(cTempEncoder.getOutput(), cSpatEncoder.getOutput(), Output,
                       cTempEncoder.GetWindowOut(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
In der Praxis funktioniert dies als einfaches, aber zuverlässiges Ensemble: Der temporale Kanal erfasst die Regime der Handelssitzungen und Kalendereffekte, während der räumliche Kanal stabile Cluster erfasst. Das Ergebnis ist eine latente Repräsentation, die sowohl unter ruhigen Marktbedingungen als auch bei nachrichtenbedingten Kurssprüngen gleichermaßen gut funktioniert – das Modell wird nicht an einen einzigen Signaltyp überangepasst, da das Signal aus zwei aufeinander abgestimmten Quellen stammt.
Wenn jeder Schritt fehlerfrei ausgeführt wird, gibt die Methode true zurück. Andernfalls verlassen wir die Methode sofort, ohne unsaubere Zustände in den Puffern zu hinterlassen. Diese Art der konservativen Kontrollflusssteuerung ist im realen Handel besonders wichtig: Wenn Sie ein Modell mit Tickdaten oder 1-Minuten-Bars betreiben, können Sie es sich nicht leisten, teilweise beschädigte Daten erst wiederherstellen zu müssen – entweder ist die Prognose genau und rechtzeitig verfügbar, oder es sollte sie gar nicht geben.
Nachdem der Vorwärtsdurchlauf abgeschlossen ist, geht das Modell zu einer der entscheidenden Phasen über – der Verteilung der Fehlergradienten. Hier entscheidet sich, wie genau jedes architektonische Element das Rückkopplungssignal interpretiert und wie gut es seine Gewichte anpassen kann. Die Methode calcInputGradients dieser Klasse ist so konzipiert, dass dieser Vorgang sequenziell abläuft, ohne unnötigen Rechenaufwand und mit minimalem Datenkopieraufwand.
bool CNeuronHimNetEncoder::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!cTempEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()))
      return false;
Zunächst werden die Gradienten aus dem temporalen Encoder extrahiert und sorgfältig in die Polynom-Support-Puffer sowie in die vorherige Schicht übertragen.
Hier wird der Vorgang für den räumlichen Encoder wiederholt, doch zunächst müssen wir sicherstellen, dass die bereits gewonnenen Daten erhalten bleiben. Und dabei geht es nicht nur um interne Komponenten, sondern auch um das Quelldatenobjekt. Da beide Encoder während des Vorwärtsdurchlaufs dieselben Quelldaten verarbeiten, sichern wir zunächst die bereits ermittelten Gradienten
   CBufferFloat* temp = cPolinomSupport.getGradient();
   CBufferFloat* prev = prevLayer.getGradient();
   if(!cPolinomSupport.SetGradient(cPolinomSupport.getPrevOutput(), false) ||
      !prevLayer.SetGradient(prevLayer.getPrevOutput(), false) ||
      !cSpatEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()) ||
      !SumAndNormilize(temp, cPolinomSupport.getGradient(), temp,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(prev, prevLayer.getGradient(), prev,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !cPolinomSupport.SetGradient(temp, false) ||
      !prevLayer.SetGradient(prev, false))
      return false;
   if(prevLayer.Activation() != None)
      if(!DeActivation(prevLayer.getOutput(), prev, prev, prevLayer.Activation()))
         return false;
Wir summieren die Daten aus den beiden Informationsströmen sorgfältig.
Als Nächstes setzt sich die Rückpropagierung entlang der Kette fort – wir müssen die Fehlergradienten von den Tschebyscheff-Polynomen bis hinunter auf die Embedding-Ebene verteilen und dabei die Kontinuität des Informationsflusses gewährleisten.
//---
   if(!cNormSupport.CalcHiddenGradients(cPolinomSupport.AsObject()))
      return false;
   if(!cSupport.CalcHiddenGradients(cNormSupport.AsObject()))
      return false;
   if(!MatMulGrad(cEmbedding.getOutput(), cEmbedding.getPrevOutput(),
                  cEmbeddingT.getOutput(), cEmbeddingT.getGradient(),
                  cSupport.getGradient(),
                  cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
      return false;
   if(!cEmbedding.CalcHiddenGradients(cEmbeddingT.AsObject()))
      return false;
   if(!SumAndNormilize(cEmbedding.getGradient(), cEmbedding.getPrevOutput(), cEmbedding.getGradient(),
                       cEmbeddingT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEmbedding.Activation() != None)
      if(!DeActivation(cEmbedding.getOutput(), cEmbedding.getGradient(),
                       cEmbedding.getGradient(), cEmbedding.Activation()))
         return false;
//---
   return true;
  }
Im Ergebnis folgt die Methode einem sorgfältig aufgebauten Rückkopplungspfad, bei dem jede Schicht genau den ihr zugewiesenen Anteil des Korrektursignals erhält. Dadurch wird das Risiko einer Gradientendivergenz verringert, die Trainingsstabilität verbessert und der Optimierungsprozess besser steuerbar.
Die Methode zur Aktualisierung der Parameter ist äußerst prägnant umgesetzt, und genau darin liegt ihre Stärke. Sie versucht nicht, in die Berechnungen der einzelnen Blöcke einzugreifen, sondern überträgt die Verantwortung einfach an die entsprechenden Komponenten.
bool CNeuronHimNetEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cEmbedding.UpdateInputWeights())
      return false;
   if(!cTempEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
   if(!cSpatEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
//---
   return true;
  }
Für alle, die sich eingehender mit den Details befassen möchten, ist der vollständige Code für die Klasse und alle ihre Methoden im Anhang enthalten – Sie können ihn in Ihrem eigenen Tempo durcharbeiten.
Decoder
Zum Abschluss unserer Arbeit an der Umsetzung der Ansätze des HimNet-Frameworks wenden wir uns nun der letzten – und ebenso wichtigen – Komponente zu: dem Decoder. Während der Encoder als Informationssammler fungierte, der Daten komprimierte und zu einer kompakten Darstellung strukturierte, agiert der Decoder wie ein erfahrener Restaurator: Schicht für Schicht rekonstruiert er die ursprüngliche Darstellung aus dem latenten Raum und versetzt die Daten wieder in ihre vertraute Form – nun jedoch angereichert und von überflüssigem Rauschen befreit.
class CNeuronHimNetDecoder    :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL             cProjection;
   CNeuronTransposeOCL        cProjectionT;
   CNeuronConvOCL             cEmbedding;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CLayer                     cGRCUs;
   CBufferFloat               bSupportAccum;
   CBufferFloat               bEmbeddingAccum;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetDecoder(void) {};
                    ~CNeuronHimNetDecoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out,
                          uint cheb_k, uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetDecoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
  };
In seiner Architektur wahrt der Decoder die Kontinuität und Symmetrie zum Encoder, wodurch die gesamte Netzwerkstruktur ausgewogen und leicht nachvollziehbar ist. Im Gegensatz zum Encoder, bei dem räumliche und zeitliche Embeddings separat generiert werden konnten und sich gegenseitig ergänzten, verwendet der Decoder jedoch ein einziges räumlich-zeitliches Embedding, das auf der Grundlage der am Ausgang des Encoders erhaltenen latenten Repräsentation generiert wird. Dieselbe latente Repräsentation dient als Grundlage für die Bildung von Tschebyscheff-Polynomen, die bei der Rekonstruktion von Zeitreihen zur Approximation komplexer Dynamiken verwendet werden.
Nachdem man sich mit der Architektur des Decoders vertraut gemacht hat, besteht der nächste Schritt in der schrittweisen Initialisierung aller seiner internen Komponenten. Die Methode Init übergibt zunächst die Kontrolle an die übergeordnete Klasse, die die Basisschnittstellen initialisiert.
bool CNeuronHimNetDecoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out,
                                uint cheb_k, uint layers, uint embed_dim,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
Anschließend werden die Projektionsschicht für die Quelldaten cProjection und das Transpositionsobjekt für die resultierende Projektion cProjectionT erstellt.
   int index = 0;
   if(!cProjection.Init(0, index, OpenCL, window, window, embed_dim, units, 1, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cProjectionT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
Der Projektionsschicht wird die Aktivierungsfunktion TANH zugewiesen, wodurch sich auf der Grundlage der vom Encoder empfangenen latenten Repräsentation korrekte räumlich-zeitliche Repräsentationen bilden lassen.
Als Nächstes wird die Schicht zur Erzeugung von Embeddings cEmbedding erstellt, deren Dimensionen der Anzahl der Neuronen und der Merkmalsdimensionalität entsprechen. Diese Embeddings werden für nachfolgende Berechnungen in rekurrenten Blöcken verwendet.
   index++;
   if(!cEmbedding.Init(0, index, OpenCL, units, units, 1, 1, embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(SIGMOID);
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
Die Objekte cSupport und cNormSupport spielen eine zentrale Rolle bei der Aufbereitung von Daten für Tschebyscheff-Polynome. Zunächst generiert cSupport eine diagonale Korrelationsmatrix, die die Beziehungen zwischen verschiedenen Merkmalen oder zeitlichen Datenströmen widerspiegelt. Anschließend normalisiert cNormSupport die Werte dieser Matrix auf eine einheitliche Skala, um die Stabilität der Berechnungen und die Korrektheit der nachfolgenden Operationen zu gewährleisten. Diese normalisierte Matrix dient als Grundlage für den Block cPolinomSupport, in dem daraus Tschebyscheff-Polynome gebildet werden, die anschließend bei den Berechnungen der rekurrenten GCRU-Blöcke verwendet werden. Dieser Ansatz ermöglicht es, komplexe Beziehungen zwischen Merkmalen zu modellieren und dabei die Genauigkeit und Konsistenz im Berechnungsprozess zu gewährleisten.
Der nächste Schritt besteht darin, einen Container cGRCUs für die rekurrenten GCRU-Blöcke zu erstellen. Blöcke werden nacheinander hinzugefügt: Dem ersten Block wird eine Merkmalsraumgröße zugewiesen, die den Eingabedaten entspricht, während alle nachfolgenden Blöcke eine feste Tensorgröße verwenden.
//---
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
     {
      DeleteObj(temp);
      return false;
     }
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
        {
         DeleteObj(temp);
         return false;
        }
     }
Alle Blöcke sind an den OpenCL-Kontext gebunden, was die Berechnungen beschleunigt.
Die Puffer bSupportAccum und bEmbeddingAccum werden bereitgestellt, um die Zwischenergebnisse der Fehlergradienten zu speichern.
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(cPolinomSupport.Neurons(), 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
   bEmbeddingAccum.BufferFree();
   bEmbeddingAccum.Clear();
   if(!bEmbeddingAccum.BufferInit(cEmbedding.Neurons(), 0) ||
      !bEmbeddingAccum.BufferCreate(OpenCL))
      return false;
//---
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
Der Initialisierungsprozess wird abgeschlossen, indem die Aktivierungsfunktionen des letzten Blocks über den gesamten Decoder hinweg sowie die Zeiger auf die Ausgabepuffer und Fehlergradienten synchronisiert werden. Dadurch wird unnötiges Kopieren von Daten vermieden und sichergestellt, dass das Modell für das Training und den Vorwärtsdurchlauf bereit ist. Jeder Schritt wird gründlich überprüft: Tritt ein Fehler auf, gibt die Methode false zurück, wodurch verhindert wird, dass das Modell in einen fehlerhaften Zustand gerät, und die Stabilität der nachfolgenden Berechnungen gewährleistet wird.
Nachdem wir alle Komponenten des Decoders erfolgreich initialisiert haben, wenden wir uns nun der Implementierung der Methode für den Vorwärtsdurchlauf zu, die das Herzstück der Signalverarbeitung bildet. In dieser Phase durchlaufen die zu analysierenden Informationen nacheinander mehrere miteinander verbundene Blöcke, von denen jeder eine bestimmte Funktion erfüllt, wodurch sichergestellt wird, dass das Modell präzise und koordiniert arbeitet.
bool CNeuronHimNetDecoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjection.FeedForward(NeuronOCL))
      return false;
   if(!cProjectionT.FeedForward(cProjection.AsObject()))
      return false;
   if(!MatMul(cProjection.getOutput(), cProjectionT.getOutput(), cSupport.getOutput(),
              cProjectionT.GetCount(), cProjectionT.GetWindow(), cProjectionT.GetCount(), 1, false))
      return false;
   if(!cNormSupport.FeedForward(cSupport.AsObject()))
      return false;
In der Anfangsphase wird das Signal von den Modulen cProjection und cProjectionT verarbeitet, die die Quelldaten in eine latente Repräsentation der angegebenen Dimensionalität umwandeln. Die resultierenden Tensoren werden einer Matrixmultiplikation unterzogen, wodurch eine diagonale Korrelationsmatrix entsteht. Anschließend wird diese Matrix mithilfe der SoftMax-Funktion normalisiert. Diese Normalisierung ist für die Erzeugung von Tschebyscheff-Polynomen im Block cPolinomSupport von entscheidender Bedeutung, da sie die Stabilität der Berechnungen und die korrekte Skalierung des Einflusses jedes Elements auf nachfolgende Schichten gewährleistet.
   if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
      return false;
//---
   if(!cEmbedding.FeedForward(cProjectionT.AsObject()))
      return false;
Anschließend werden im cEmbedding-Block Embeddings generiert, die eine kompakte und aussagekräftige Darstellung der verborgenen Merkmale der Daten liefern.
Nachdem die Daten aufbereitet wurden, wird das Signal an den ersten GCRU-Block aus dem cGRCUs-Container gesendet, wo die rekurrente Verarbeitung der Graphdaten stattfindet. Jeder nachfolgende GCRU-Block erhält die Ausgabe des vorherigen Blocks als Eingabe, wodurch der Decoder zeitliche und räumliche Abhängigkeiten erfassen und komplexe Muster in historischen Daten identifizieren kann.
   CNeuronHimNetGCRU* current = NULL;
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(NeuronOCL, cPolinomSupport.AsObject(), cEmbedding.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
Als Ergebnis dieser aufeinanderfolgenden Transformationen entsteht die endgültige Ausgabe des Decoders. Dieser Ansatz gewährleistet, dass das Modell konsistent arbeitet und die Rechenressourcen optimal genutzt werden, was insbesondere bei der Verarbeitung großer Finanzdatensätze und beim Training anhand historischer Zeitreihen von Bedeutung ist.
Ihnen ist wahrscheinlich bereits aufgefallen, wie nahtlos die Verarbeitungsalgorithmen des Decoders die Logik der oben beschriebenen Encoder übernehmen. Daher schlage ich vor, dass Sie sich selbst eingehend mit den Methoden des Rückwärtsdurchlaufs beschäftigen. Der vollständige Klassencode samt allen Methoden ist im Anhang enthalten.
Tests
Nachdem wir nun alle wesentlichen Komponenten des HimNet-Frameworks zusammengestellt haben, ist es an der Zeit, zur spannendsten Phase überzugehen – dem Trainieren und Testen des Modells. Unser Ziel bleibt unverändert: ein Handelssystem zu entwickeln, das in der Lage ist, den Markt eigenständig zu analysieren und Entscheidungen zu treffen. In diesem Schema fungiert HimNet als Encoder für den Umgebungszustand und erzeugt eine kompakte und zugleich aussagekräftige Darstellung der aktuellen Marktsituation. Der Actor stützt sich bei der Auswahl seiner Handlungen auf diese Darstellung, während der Critic deren Qualität bewertet, Feedback gibt und so Strategieanpassungen ermöglicht.
Das Training gliedert sich in zwei sich ergänzende Phasen, die sowohl eine solide Grundlage als auch die nötige Flexibilität für den Einsatz unter realen Marktbedingungen schaffen. In der ersten Phase, dem Offline-Training, führten wir ein umfassendes Training anhand historischer Daten für das Währungspaar EURUSD im H1-Zeitrahmen für das gesamte Jahr 2024 durch. Dieser Zeitraum umfasste die gesamte Bandbreite an Marktbedingungen – ruhige Seitwärtsbewegungen, stetige Trends, starke Volatilitätssprünge und Phasen mit erhöhtem Rauschen –, was ihn zu einer hervorragenden Trainingsgrundlage für das Modell machte.
Die zweite Phase ist die Online-Feinabstimmung. Das Modell verarbeitete die Folge der Kerzen sequenziell im Strategietester von MetaTrader 5, der den realen Handel so genau wie möglich simuliert. In dieser Phase zeigen sich Eigenschaften, die sich grundlegend von denen des Offline-Trainings unterscheiden: die Fähigkeit, Rauschen zu tolerieren, angemessen auf Liquiditätsveränderungen zu reagieren und Verzögerungen sowie Slippage zu berücksichtigen. Wir haben die realen Ausführungsbedingungen sorgfältig simuliert, damit das Verhalten des Modells auch bei der Übertragung auf reale Marktbedingungen vorhersehbar bleibt.
Die abschließende und strengste Validierungsphase wurde anhand einer vollständig externen Stichprobe durchgeführt – Kursdaten aus dem Zeitraum Januar bis März 2025. Alle Modellparameter blieben während dieses Vorgangs unverändert. Diese Art von Test liefert ein objektives Bild der praktischen Wirksamkeit, also der Fähigkeit des Algorithmus, unter neuen Bedingungen stabil und vorhersehbar zu bleiben.
Die Testergebnisse sind unten aufgeführt.
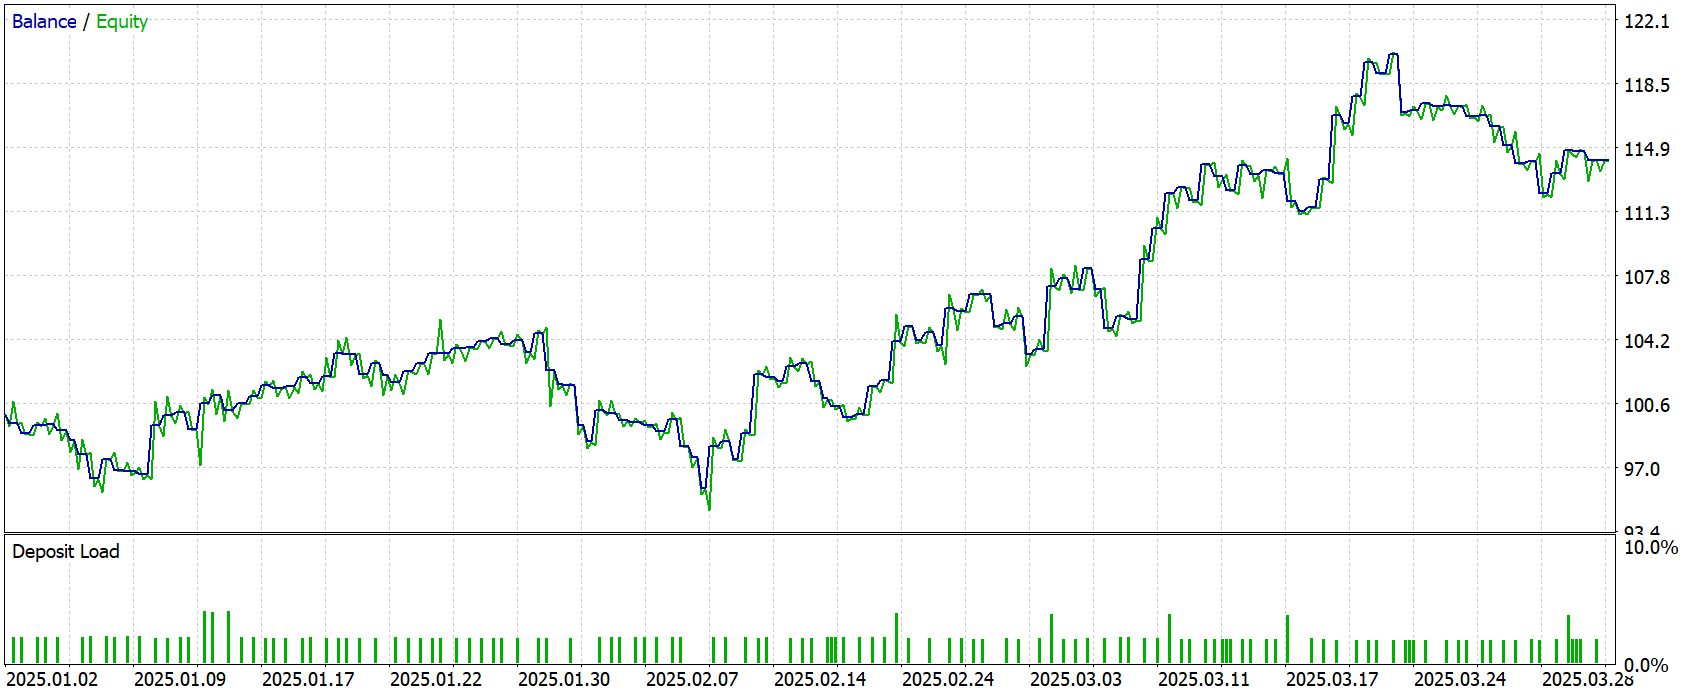
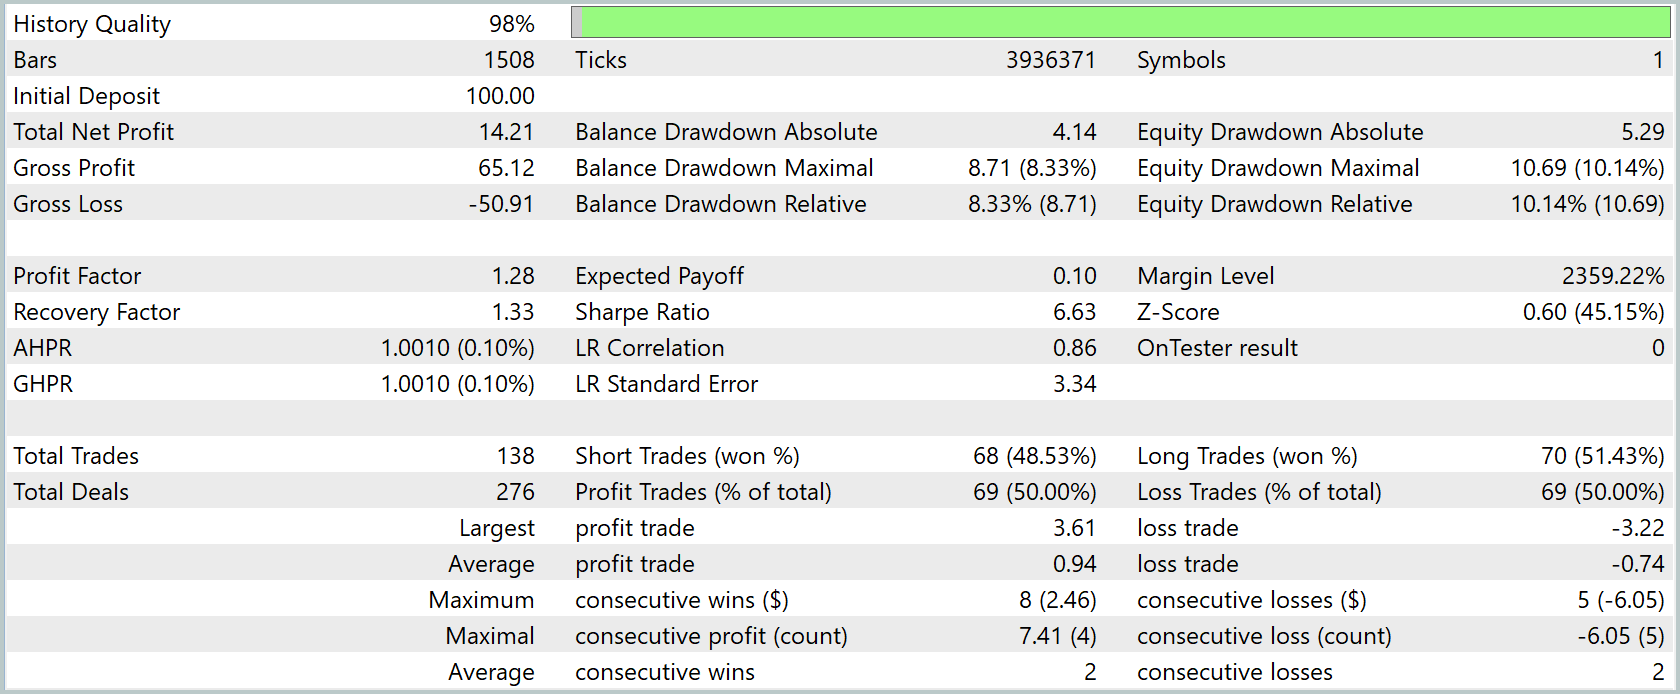
Während des dreimonatigen Testzeitraums belief sich der Nettogewinn auf 14,21 % des Anfangskapitals. Der Gewinn pro Dollar Verlust betrug 1,28 US-Dollar, während der durchschnittliche Erwartungswert pro Trade nur 0,10 US-Dollar betrug. Ein Erholungsfaktor von 1,33 bedeutet, dass der Gesamtgewinn den maximalen Drawdown des Kontostands überstieg.
Die Drawdowns fielen moderat aus: Der absolute Drawdown betrug 4,14 US-Dollar bezogen auf den Kontostand und 5,29 US-Dollar bezogen auf die Equity, während der maximale relative Drawdown bei 8,33 % bzw. 10,14 % lag. Gleichzeitig stieg die Gewinnkurve stetig an, was durch eine zeitbasierte Trendkorrelation von 0,86 bestätigt wurde.
Im Verlauf des gesamten Tests führte der Expert Advisor 138 Trades durch, die sich fast gleichmäßig auf Kauf- und Verkaufstrades verteilten, wobei der Anteil der gewinnbringenden Trades in beiden Richtungen bei fast 50 % lag. Der durchschnittliche Gewinn pro gewinnbringendem Trade betrug 0,94 US-Dollar, der durchschnittliche Verlust 0,74 US-Dollar, der größte Gewinn belief sich auf 3,61 US-Dollar und der größte Verlust auf 3,22 US-Dollar. Im Durchschnitt wurden die Positionen etwas mehr als eine Stunde lang gehalten, wobei die Haltedauer zwischen 57 Minuten und zwei Stunden lag, was auf einen eindeutig kurzfristigen Intraday-Handelsstil hindeutet.
Insgesamt deuten die Ergebnisse auf eine recht stabile, aber mäßig rentable Strategie hin. Zu ihren Stärken zählen kontrollierte Drawdowns, eine konstante Performance in beiden Marktrichtungen und ein positiver Erwartungswert pro Trade. Zu ihren Schwächen zählen ein begrenzter Spielraum beim Profitfaktor und ein geringer durchschnittlicher Gewinn pro Trade, wodurch die Strategie auf einem Realkonto empfindlich auf Spreads und Provisionen reagieren kann.
Fazit
Mit diesem Artikel wird die Arbeit zur Umsetzung der Ansätze des HimNet-Frameworks mithilfe von MQL5 abgeschlossen. Die wichtigsten Vorteile des Frameworks sind seine architektonische Flexibilität und seine Fähigkeit, sich an eine Vielzahl von Aufgaben im Zusammenhang mit der Prognose und Analyse von Zeitreihen anzupassen.
Die Ergebnisse der abschließenden Tests mit neuen Kursdaten, die nicht im Trainingsdatensatz enthalten waren, zeigten eine positive Entwicklung. Der Kontostand des Modells wies ein stetiges Wachstum auf, was auf dessen Fähigkeit hindeutet, sich effektiv an veränderte Marktbedingungen anzupassen.
Links
- Heterogenitätsgestütztes Metaparameterlernen für die räumlich-zeitliche Zeitreihenprognose
- Andere Artikel dieser Serie
Im Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19286
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



