

取引におけるニューラルネットワーク:異質性を考慮したメタパラメータ学習(HimNet)
 15
 0

はじめに
ストリーミングデータを収集するさまざまなツールの普及に伴い、人間の活動に関わる幅広い分野で、時空間時系列データが大量に蓄積されるようになりました。 金融取引システムも例外ではありません。さまざまな取引所、銘柄、金融商品に関する気配値、注文、約定のデータが、絶え間なく生成されています。 データ量が増加するなか、時系列データを高精度に予測することは、コスト削減、リスク管理、取引戦略の執行品質の向上に欠かせない手段となっています。 局所的な流動性やボラティリティの予測誤差は、スリッページの拡大、利益の損失、取引戦略のパフォーマンス指標の歪みなどに直結します。 したがって、高品質な予測モデルには、市場全体の傾向を捉えるだけでなく、特定の状況に固有の違い、すなわち、いつ、どこで市場の流動性が逼迫し、いつ、どこで流動性に余裕があるのかを考慮することが求められます。
最大の課題は、データの時空間的不均一性です。 市場における空間的な異質性とは、異なる取引所や金融商品が、同じ時点でも異なる値動きや市場特性を示すことです。 たとえば、ある取引所では流動性が十分に確保されている一方、別の取引所では、特にボラティリティが高い局面で、裁定取引の機会となる価格差が生じることがあります。 このような状況で、すべての取引所の動きを単純に平均化すると、重要な局所的特徴が平滑化され、予測精度が低下してしまいます。
時間的な異質性も、見た目以上に顕著です。 同じ金融商品であっても、時間帯や暦日によって、その動きは大きく変化します。 典型的な例が、取引セッションの開始時と終了時です。取引開始直後の数分間には、出来高とボラティリティが急増する一方、夜遅い時間帯には取引活動が低調になることがあります。 また、ニュースやマクロ経済指標の発表は、短期間に極端なボラティリティをもたらすことがあります。 休日や週末には、取引活動が大幅に減少する場合もあります。す。。 つまり、同じパターンを時間的に定常とみなすことはできません。データの統計的性質は変化するため、モデルはこの変化を考慮する必要があります。
従来の手法も、この問題をさまざまな方法で解決しようとしてきました。しかし、実際の取引環境への適用には、それぞれ課題が残されています。 グラフベースの手法は、データ間の関係を表すグラフ構造や、事前に計算された類似度指標に依存していました。これは、あらかじめ作成した流動性マップだけを頼りに取引戦略を立てるトレーダーに似ています。 しかし、実際の市場では、マーケットメイカーの構成が変わり、新たな取引所が登場し、一時的な流動性不足も発生します。そのため、事前に作成したマップは、すぐに実態と合わなくなる可能性があります。
メタ学習の手法では、市場の異なるレジームごとに複数のパラメータセットを保持するという考え方が導入されました。しかし、こうした手法の多くは、外部情報に依存していました。 金融分野では、各取引所や金融商品について、正確で利用可能なメタデータを用意する必要があることを意味します。 しかし、そのような情報をリアルタイムで入手できるとは限りません。 さらに、多くの手法はメモリ消費量が大きく、計算コストも高いという問題を抱えています。
表現学習に基づく手法は、生データから有用な情報を含む埋め込み表現を抽出することを学習します。 これは強力なアプローチですが、その後の埋め込み表現の処理が単純化されすぎることも少なくありません。その結果、優れた表現を獲得しても、後続の処理でその価値が十分に活かされない場合があります。自己教師あり学習では、補助的なタスクを導入することで、より豊かな埋め込み表現を獲得します。これも有効な方法ですが、単一の学習サイクルで、最終的な予測タスクに対してモデル全体を最適化できるとは限りません。
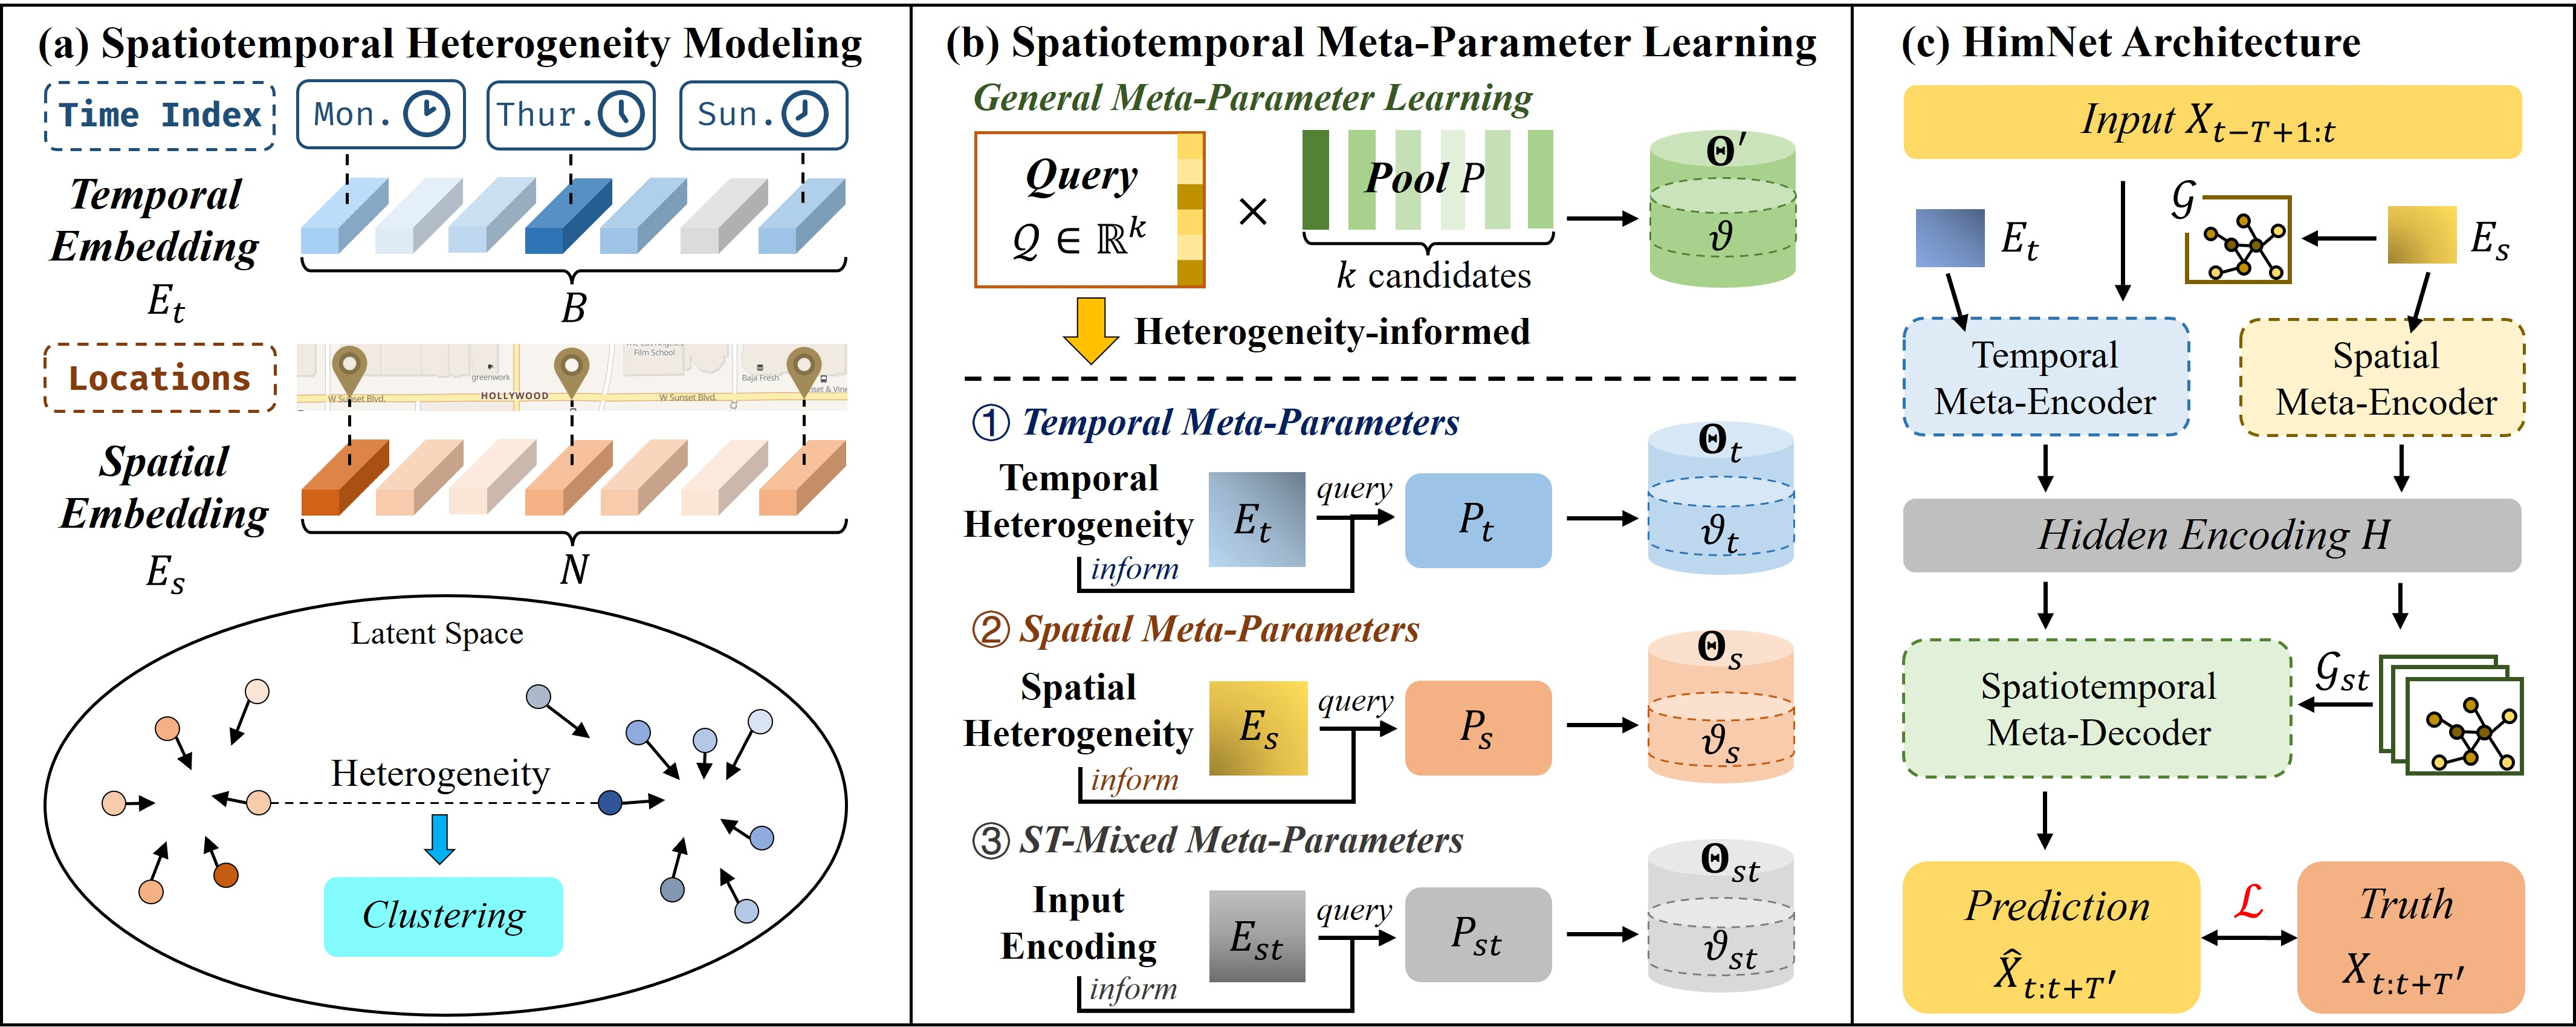
こうした背景から、論文「Heterogeneity-Informed Meta-Parameter Learning for Spatiotemporal Time Series Forecasting」の著者らは、新たなアプローチとしてHimNetフレームワークを提案しました。 この手法は、2つの重要な要素を組み合わせています。 まず、学習可能な空間埋め込みと時間埋め込みを用いて、データの異質性を明示的なラベルに頼らずに捉えます。次に、そこで得られた情報を、モデルのパラメータを生成・選択するためのメタパラメータ学習に活用します。 簡単に言えば、HimNetはデータの各部分に見られる違いを識別するだけではありません。それぞれの状況に適したパラメータを選択・生成できるよう、モデルそのものを学習させるのです。
取引データの集合に、次のような情報が含まれていると考えてみましょう。
- 通常の取引時間帯に、主要取引所で取引される大手発行体の株式
- 局所的なニュースによる急変動の後、店頭(OTC)市場で取引される同じ銘柄の株式
- 流動性の低い小型株
- 注文板の厚さが市場ごとに異なる暗号資産市場
空間埋め込みによって、これらのデータは、それぞれ異なる特徴を持つクラスタに分類されます。 その後、システムはメタパラメータの集合(メタパラメータプール)から、各クラスターに適したパラメータセットを取得します。たとえば、主要市場にはスリッページの抑制を重視した積極的な設定、OTC市場には執行時の安全余裕を確保する保守的な設定、小型株にはノイズへの過学習を防ぐための正則化を強めた設定、暗号資産市場には高いノイズ水準や頻繁に生じる裁定機会につながる価格差を考慮した設定を適用できます。 これらの処理は、単一の学習サイクルのなかでまとめて学習されます。そのため、モデルは、データの状況を識別する能力と、それぞれの状況に適したパラメータを選択する能力を同時に獲得できます。
時間的な違いについても、同様の考え方が当てはまります。 市場の寄り付き直後には、素早い反応と短期的な出来高予測が求められることがあります。 重要なマクロ経済指標の発表後には、ボラティリティが高まるレジームが訪れます。 一方、夜遅い時間帯には、取引活動が低調になることがあります。 HimNetが採用するメタパラメータの仕組みでは、こうした時間帯や市場状況に応じたレジームごとに、異なるパラメータセットを割り当てることが可能です。 これは、経験豊富なトレーダーが時間帯や取引カレンダーに応じて取引スタイルを調整することに似ています。
技術的な観点から見ると、この手法の核心は、埋め込み表現をクラスタリングし、少数のメタパラメータからなる計算効率の高いプールを用いて、モデルのパラメータを動的に量子化することにあります。 この仕組みによって、従来の手法が抱えていた複数の課題に対処できます。 第一に、外部の補助特徴量に厳密に依存する必要がありません。モデルは、データから関連する状況やパターンを自ら学習します。 第二に、メタパラメータプールをコンパクトに保つことで、メモリ消費量と計算コストを管理可能な範囲に抑えられます。これは、取引の執行遅延を小さく抑える必要があるシステムにとって重要です。 第三に、HimNetは、異質性を単に検出するだけでなく、その情報をモデルの動作に直接反映させます。クラスターに応じて適用するパラメータが決まるため、データの違いを予測処理に積極的に活用できます。 その結果、予測精度の向上と、取引執行の品質改善が期待できます。
特に注目すべき点として、解釈可能性が挙げられます。 メタパラメータやクラスタは可視化できます。クラスタの分布を示すマップを作成すれば、どの取引所や時間帯が同じレジームに分類されているかを確認できます。また、メタパラメータのヒートマップを使えば、低ボラティリティのレジームと高ボラティリティのレジームで、パラメータ設定がどのように異なるかを把握できます。 実務者にとって、こうした可視化は、単に見栄えのよい図表ではありません。モデルの状態を監視するための実用的なツールにもなります。例えば、本来は特性が大きく異なる取引所が予期せず同じクラスターに分類された場合、データの追加検証や前処理方法の見直しが必要である可能性を示すシグナルとなります。
最後に、頑健性と転用可能性についても触れておきましょう。 HimNetフレームワークの重要な特徴の一つは、異なる分野やデータ環境にも柔軟に適用できることです。 メタパラメータと埋め込み表現は、他の金融商品や取引所に対しても、少量の追加学習(ファインチューニング)で適用できるように学習されます。
総じて、HimNetは、時空間的なレジームを識別し、コンパクトなメタパラメータプールを構築するとともに、そこから得られる情報を予測モデルに活用させる、実用的かつ効率的なフレームワークです。 これにより、トレーダーや予測システムの開発者は、予測精度の向上、計算効率の維持、モデルの解釈可能性の確保という3つの課題に、同時に取り組むことができます。
HimNetアルゴリズム
時空間的な異質性をモデル化するうえで重要なのは、時間軸と空間軸の両方に沿って、入力データがどのような状況(コンテキスト)に属するのかを正しく識別し、区別することです。 HimNetフレームワークの著者らは、外部の参照データに頼るのではなく、学習可能な埋め込み表現を作成し、それぞれの時空間コンテキストに固有の表現を割り当てます。 これにより、モデルは実際の金融市場の問題に対応するための柔軟性と適応能力を獲得します。
時間軸について、著者らは次の2つの埋め込み辞書を用意します。
- 時刻辞書 Dtod ∈ RNd × dtod;
- 曜日辞書 Ddow ∈ RNw × ddow。
ここで、dtodおよびddowはそれぞれのベクトルの次元数、Ndは1取引日内のステップ数、Nwは1週間の日数です。
履歴長をTとする入力データのミニバッチXb ∈ RB×T×Nに対し、著者らは各サンプルの最終時刻のタイムスタンプを使って、各辞書から時間埋め込みEtod ∈ RB×dtodおよびEdow ∈ RB×ddowを選択する方法を提案しています。 次に、この2つの埋め込みを連結し、共通の時間埋め込みを生成します。
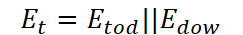
このように時間情報を分けて扱うことには、明確な実用上の理由があります。 時刻別の埋め込みは、市場の寄り付き直後の急激な変動、昼間の取引活動の停滞、夕方の取引セッションなど、時間分解能の高い周期的なパターンを捉えます。 一方、曜日別の埋め込みは、平日と週末の違いや、決算発表日、経済指標の発表日などに繰り返し現れるパターンといった、より長い周期の変動を捉えます。 この2つの辞書を組み合わせることで、モデルは複数の時間スケールにわたる市場のレジームを識別し、それぞれに適した予測パラメータを選択できるようになります。
空間軸については、著者らは空間埋め込み行列Es ∈ RN*dsを使用します。ここで、Nは時系列または観測地点の数、dsは各地点に対応するベクトルの次元数です。 時間埋め込み辞書とは異なり、空間埋め込みでは、各対象にそれぞれ固有の学習可能なベクトルが直接割り当てられます。これらのベクトルはランダムに初期化されます。 その目的は、時系列のパターンに影響を与える取引環境の機能的な違いを捉えることです。具体的には、注文板の厚さ、注文執行の速度、市場参加者の構成、金融商品の種類、取引インフラの特性などが挙げられます。 この仕組みにより、補助的な特徴量を明示的に入力しなくても、空間的な異質性をモデルに反映できます。
このような埋め込みの学習は、実質的に動的なクラスタリングとして機能します。 学習が進むにつれて、行列内の表現は入力データに応じて変化し、互いに離れたり、クラスタを形成したりします。 時空間コンテキストが異なっていても、似た挙動を示すものは潜在空間内で近づき、 動態が異なるものは互いに離れていきます。 その結果、市場の典型的な挙動を表す自然なクラスタ、すなわち代表的なレジームが形成されます。 これは、言語モデルにおいてkingとqueenが意味的に近い位置に配置されることに似ています。 ただし、ここでの近さは、単語の意味ではなく、市場レジームの類似性を表します。 重要なのは、このクラスタリングが、外部から厳密な制約を課したり、人手でラベルを付与したりすることなく、学習の過程で自然に形成される点です。 どのコンテキスト同士が似ており、どのコンテキストが異なるのかを、モデル自身が学習します。
実際の市場でどのように機能するのか、いくつかの典型的な金融取引の状況を例に、 もう少し詳しく見てみましょう。
- 主要株式市場の取引開始時: 取引が活発で、出来高が大きく、価格が急速に変動する状況です。 このような時間と取引場所の組み合わせに対して、モデルは固有の埋め込み表現を学習し、短い予測期間と迅速な反応を重視したパラメータを選択します。これは、高速執行をおこなうアルゴリズムやスリッページの抑制にとって重要です。
- 夜間における同じ銘柄の店頭取引: 出来高が少なく、約定頻度も低い一方、単発の注文によって価格が急変するリスクが高まります。 この場合、時間埋め込みは主要市場の取引開始時とは異なるものになります。メタパラメータも、より保守的な設定を選択することで、モデルの頑健性を高め、ノイズへの過学習を抑えます。
- 注文板の厚さが異なる暗号資産取引所: ある取引所は流動性が豊富である一方、別の取引所は流動性が乏しく、裁定取引の機会が生じやすい場合があります。 空間埋め込みは、こうした取引所間の違いを捉え、取引所ごとに異なる価格や出来高の予測方法を適用します。これは、裁定取引システムにとって有用です。
- 重要なマクロ経済指標の発表日や四半期決算の発表日: 曜日別の時間埋め込みと時刻別の時間埋め込みを組み合わせることで、こうした特定の時間帯や日付に対応するコンテキストを識別します。そして、短期的なシグナルへの感度を高め、予測の不確実性をより広い区間で表現するレジームへと切り替えます。
その核心となる考え方は、シンプルでありながら効果的です。 目指すのは、異質性を捉えることだけではありません。 異質性をどのように制御し、市場の予測や取引執行に役立てるかを学習することです。 すべての時刻、すべての取引所に対して個別のパラメータセットを維持しようとすれば、コスト面でも技術面でも現実的ではありません。そこで、HimNetの著者らは、時間軸と空間軸に沿ってモデルのパラメータ空間を拡張し、その拡張部分を少数のメタパラメータプールとしてコンパクトに表現します。 特定の時空間クエリに対する最終的なパラメータは、プール内の候補を重み付きで組み合わせることによって生成されます。Θ = Q · P。 このアプローチでは、膨大な数の個別パラメータを最適化する代わりに、少数のパラメータ候補からなるコンパクトな集合を利用します。その結果、メモリ消費量と計算コストを大幅に削減できます。 つまり、すべての時刻と観測地点に個別のパラメータを用意するためにコストをかけるのではなく、少数の候補を使って適応性を実現するのです。
実際の仕組みとしては、まず、小規模な時間メタパラメータプールを用意し、時間埋め込みEtを使って必要なメタパラメータを取得します。 同様に、空間埋め込みEsは空間メタパラメータプールを参照し、個々の時系列に対応するメタパラメータを取得します。 ただし、時間と空間が組み合わさって生じる特徴も無視できません。時間と空間のすべての組み合わせについて個別のプールを構築するのは非効率です。そこで著者らは、入力データXtを時空間埋め込みEst = Fenc(Xt)に符号化し、それを比較的小規模なプールへのクエリとして用いて、時空間メタパラメータを生成します。 このように役割を分担することで、モデルは管理可能な規模と実行性能を維持しながら、特定の時刻、特定の取引所、さらには複数の事象が同時に発生する特定の状況に応じて、パラメータを柔軟に調整できます。
このアプローチには、ビジネス上の実用的な利点もあります。 プールが小規模であるため、推論時のメタパラメータ生成にかかる計算コストを低く抑えられます。これは、厳しいレイテンシ要件が課されるタスクにおいて特に重要です。 また、メタパラメータプールと本体のモデルを同時に学習させることで、プールへのクエリを通じて勾配を伝播させることができます。その結果、埋め込みとパラメータを相互に連携させながら最適化できます。 一方、学習の安定性には注意が必要です。クエリの重み分布をエントロピー制約や温度パラメータによる平滑化で制御し、特定の候補だけに重みが集中しないようにすることが重要です。そうしなければ、単一の候補がすべての入力を独占するような状態に陥り、モデルが過度に複雑化して汎化性能が低下するおそれがあります。
プールのサイズを決める際には、適応性の高さと過学習のリスクとのバランスを取る必要があります。実際には、対象市場で観測される典型的なレジームの数を考慮しながら、検証用データを使って適切なサイズを調整します。
HimNetのアーキテクチャは、グラフ畳み込みと再帰的な計算機構を組み合わせています。これらのブロックは、入力データの過去の推移を処理すると同時に、個々の時系列間の関係も考慮できます。 市場の取引情報をリアルタイムで確認しながら、市場間の関係を示すマップも参照して意思決定するトレーダーを想像してみてください。 モデルの基本セルは、まさにこのような役割を果たします。 グラフ上で隣接するノードから得られる情報を集約し、時間の経過に応じて隠れ状態を更新します。
技術的には、基本ブロックとして、修正されたグラフ畳み込み再帰ユニット(GCRU)が採用されています。 内部には、通常のリセットゲートと更新ゲート、候補状態、そして過去の隠れ表現と新しい隠れ表現を混合する仕組みが備わっています。 ただし、重要な違いがあります。それは、グラフ畳み込みのパラメータが固定されていないことです。 これらのパラメータは、メタパラメータ生成機構によって動的に生成されます。 つまり、隣接ノードの情報をどのように重み付けして集約するか、言い換えれば、ある時系列が別の時系列にどの程度影響を与えるかは、コンテキストに応じて変化します。 これは、金融市場において特に重要です。市場間の関係は常に一定ではありません。 主要取引所で広範な市場反応が起きている局面では、複数の市場が強く連動することがあります。 一方、特定の取引所で一時的に取引が停止したり、取引活動が途絶えたりすると、それまで存在していた関係が弱まることもあります。
HimNetは、古典的なEncoder–Decoderアーキテクチャを採用しています。 HimNetのEncoderは、2つの並列経路で処理をおこない、最後にそれらの出力を加算します。 一方の経路は時間軸に沿った適応を担当します。 時間埋め込みを受け取り、それを使って時間メタパラメータを生成します。 もう一方の経路は空間軸に沿った適応を担当します。各時系列の空間埋め込みを利用し、それぞれの観測対象に対応するメタパラメータを出力します。 この2チャネルの構成により、モデルは今何が起きているかとそれがどこで起きているかを同時に考慮できます。 しかし、著者らはそこで終わりません。 時間と空間の相互作用を考慮するため、Decoderは潜在状態を受け取り、それを時空間埋め込みへと変換します。 この埋め込みは、STメタパラメータプールに対するクエリとして機能します。 その結果、現在の時刻、取引場所、市場の動態の組み合わせに適した再帰計算用の重みが生成されます。
もう一つの重要な構成要素が、適応的隣接行列です。 一般的なモデルでは、ノード間の接続関係を表す行列を固定しておくことがあります。しかし、HimNetでは、空間埋め込みから隣接行列を生成します。具体的には、埋め込み同士の内積にReLUとSoftMaxを適用します。 こうして得られる行列は、その時点における市場間の関係を反映します。 たとえば、ある取引所で取引活動が急増すると、モデルはその取引所の情報が隣接ノードに与える影響を自動的に強めます。 反対に、特定の取引所から流動性が失われると、その取引所の影響は弱まります。 これにより、モデルはすぐに古くなる固定的な市場構造図ではなく、市場の実際の状態に応じて動作できるようになります。
HimNetのDecoderは将来の時点に対する予測を反復的に生成します。 初期の隠れ状態を受け取り、STメタパラメータを適用したGCRUセルで処理し、各将来時点の予測値を出力します。 この方法は、すべての時系列に対して平均的な予測を出すだけではありません。局所的なレジームや時間帯の違いを考慮した予測を生成します。
学習はエンドツーエンドでおこなわれます。 著者らは、すべての予測ステップと取引所にわたる評価指標として、シンプルで解釈しやすい平均絶対誤差(MAE)を採用しています。 MAEは予測対象と同じ単位で誤差を表すため、予測精度を実務的な観点から評価しやすいという利点があります。 学習時には、安定性の監視も重要です。メタパラメータプールへのL2正則化、重み生成時の温度パラメータによる平滑化、パラメータ更新幅の制限などが有効です。 プールのサイズは、次のようなトレードオフを考慮して決定します。
- 小さすぎる場合: すべてのレジームを十分に表現できず、必要な適応性が得られません。
- 大きすぎる場合: 特定の状況への過度な特化によって過学習のリスクが高まり、計算負荷も増加します。
実用の観点から見ると、HimNetには具体的なメリットがあります。 局所的な流動性を高精度に評価できれば、大口注文の執行時に発生するスリッページを抑制できます。また、HimNetは、裁定取引システムに対しては、見せかけの価格差を除外し、取引所間で継続的に存在する価格乖離を識別するためのコンテキスト情報を提供できます。
最後に、実装面の工夫によって、HimNetは実運用環境への導入にも適した構成となっています。 メタパラメータの生成は、小規模な行列の乗算によって実行されるため、メモリ消費量が急激に増大することはありません。 コンパクトなプールを利用することで、レイテンシを低く抑えることができ、厳しい時間的制約のあるタスクにも対応できます。 これらの特徴により、HimNetを注文執行パイプラインやリスク管理システムに組み込みやすくなります。
以下に、著者らによるHimNetフレームワークの構成図を示します。
MQL5での実装
HimNetフレームワークの理論的基礎について詳細に分析した後、次の論理的なステップは、これらの考え方を実際に動作するMQL5コードとして実装する方法を示すことです。 実践的な実装とは、単に数式をそのまま書き写すことではなく、実際の取引プラットフォームの制約と機能に合わせてアーキテクチャを具現化することです。 ここでは、体系的かつ綿密なアプローチを採用します。熟練した時計職人が時計を組み立てるように、大きなアーキテクチャを独立した、明確に定義されたオブジェクトに分解し、一つずつモデルを構築していきます。あらゆる歯車に細心の注意を払い、予測可能な動作を確保し、それぞれの部品の役割を尊重しながら進めていきます。 このアプローチにより、テストが容易になり、デバッグが迅速化され、さまざまな市場や時間足への対応も容易になります。
MQL5のインフラレベルでは、これは前処理ブロック、埋め込み表現、メタパラメータ、再帰セルを、それぞれ独立したコンポーネントとして構成することを意味します。 ローソク足のデータ列と、分析対象のインジケーターから得られる値は、整然とした固定長のデータウィンドウに変換されます。 時間的埋め込み表現と単変量系列の埋め込み表現は、重み生成モジュールに入力されます。 GCRUセルは、市場のグラフ構造を入力として受け取り、更新された隠れ状態を返します。 すべてが首尾一貫しているように見えます。しかし、HimNetの優位性を維持するために欠かせない要素が一つあります。それは、グラフ上で複数のエッジを隔てた近傍ノードの情報を、迅速かつ確実に取り込む能力です。 金融の観点から言えば、これは系列間の直接的な影響だけでなく、二次・三次の影響も捉えることを意味します。たとえば、あるノードで発生した流動性の急増がネットワーク内に波及し、時間差と減衰を伴って分析対象の金融商品に到達するような現象です。
ここで登場するのがチェビシェフ多項式です。 チェビシェフ多項式を用いることで、計算負荷の大きいスペクトル分解をおこなうことなく、グラフ上に局所的なKホップフィルタを構築することができます。 固有ベクトルを計算する代わりに、フレームワークの著者らは単純な漸化式を利用し、隣接行列から行列の基底T0, T1, …, TK-1を生成します。 それぞれの行列は、ノード自身からK次近傍までの、近傍の各階層を担います。 その結果、一つの畳み込み演算は、あらかじめ計算された複数の変換を線形結合する、シンプルな演算へと置き換えられます。 これは取引において極めて重要です。レイテンシの低減、メモリ負荷の軽減、そして系列が長い場合やノード数Nが大きい場合でも、数値計算の安定性を確保できるからです。 市場にノイズが多い場合、このフィルターは安定した関係性を識別し、ランダムな急騰・急落に過剰反応することを避けるのに役立ちます。
この考え方を本番環境で機能させるには、現在の隣接行列から、指定された次数のチェビシェフ多項式行列を高速に構築する専用オブジェクトが必要です。 このオブジェクトは、グラフ層全体を支える静かなエンジンとして機能します。埋め込み表現から構築された適応型のサポート行列を入力として受け取り、GCRUでそのまま利用できる、コンパクトなTkの集合を返します。
実装作業の最初のステップは、OpenCLプログラムに変更を加えることです。 GPUは、この処理に理想的に適しています。並列処理とベクトル演算を活用することで、大規模な隣接行列をCPUよりもはるかに高速に処理できるからです。 これは、グラフが非常に大きく、豊かで分岐の多い接続構造を持つことのある金融データにおいて、とりわけ重要となります。
ChebStepの順伝播カーネルのアルゴリズムは、ある意味で、チェビシェフ多項式の生成機構の中核をなすものであり、OpenCLの内部深くで動作します。 そして、その動作は、証券取引所のマッチングエンジンが円滑に稼働する様子によく似ています。そこでは、あらゆるティックとあらゆる注文が、一つの統一されたロジックの中に織り込まれているのです。
__kernel void ChebStep(__global const float* support,
                       __global float* outputs,
                       const int step
                      )
  {
   const size_t l = get_local_id(0);
   const size_t r = get_global_id(1);
   const size_t c = get_global_id(2);
   const size_t total_l = get_local_size(0);
   const size_t total_r = get_global_size(1);
   const size_t total_c = get_global_size(2);
プログラムは、まず問題空間における座標を取得することから始まります。 ローカルおよびグローバルのスレッドIDは、私たちの「取引所のトレーダー」に相当し、それぞれが行列の個別の領域を担当します。 これらのスレッドは並列に動作するため、従来の手作業による取引のようにデータセット全体を順番に処理するのではなく、自動化された高頻度取引システムと同じように、すべての処理を同期的に進めることができます。 ローカルのTempバッファは、一時的な清算機関のような役割を果たします。ここに中間的な合計値が格納され、その後、同期処理を経て最終結果が生成されます。
   __local float Temp[LOCAL_ARRAY_SIZE];
//---
   if(step <= 0 || total_r != total_c)
      return;
このアルゴリズムでは、まず重要な制約条件が適用されます。ステップサイズがゼロ以下である場合、または行列が正方行列でない場合、それ以上計算を続けても意味がありません。 これは、相場の状況が戦略のルールを満たしていない場合に、トレーダーが取引を見送るのとまったく同じ考え方です。
次に、チェビシェフ多項式の各次数を、段階的な階層構造に従って構築していきます。 最初のステップはシンプルです。対角成分に1を配置した単位行列を生成します。 これは、すべての始まりとなる基盤、つまり元手となる資金のようなものです。
if(step <= 3)
  {
   const float diag = (r == c ? 1.0f : 0.0f);
   if(l == 0)
      outputs[RCtoFlat(r, c, total_r, total_c, 0)] = diag;
2番目のステップでは、元の隣接行列が登場します。これは、グラフの頂点間のつながりを示す、まさに接続マップであり、市場の実際の構造を反映しています。 この行列を出力配列に追加することで、実際の価格変動に対する近似が始まります。
if(step < 2)
   return;
if(l == 0)
  {
   const float s = IsNaNOrInf(support[RCtoFlat(r, c, total_r, total_c, 0)], 0);
   outputs[RCtoFlat(r, c, total_r, total_c, 1)] = s;
  }
3ステップでは、行列の2乗を求めます。 ループ内のコードでは、行列の各行と各列を掛け合わせ、それぞれの積を注意深く加算していきます。 これは、資産間の相互相関を分析する作業に似ています。直接的な関係だけでなく、中間のつながりを介した間接的な関係も探し出すのです。
こうして得られる行列は、より複雑な相互作用を反映します。影響は直接的な接続にとどまらず、近傍のノードを経由して伝播します。 加算後には、重複を取り除くために正規化と調整が適用されます。これは、トレーダーが気配値からノイズを取り除き、意味のあるシグナルだけを残す作業によく似ています。
 if(step < 3)
    return;
 float out = 0;
 for(int t = 0; t < total_c; t += total_l)
   {
    const float s1 = IsNaNOrInf(support[RCtoFlat(r, t + l, total_r, total_c, 0)], 0);
    const float s2 = IsNaNOrInf(support[RCtoFlat(t + l, c, total_r, total_c, 0)], 0);
    out += IsNaNOrInf(s1 * s2, 0);
   }
 out = 2 * LocalSum(out, 0, Temp);
 if(l == 0)
   {
    out -= diag;
    outputs[RCtoFlat(r, c, total_r, total_c, 2)] = IsNaNOrInf(out, 0);
   }
 return;
}
ステップ数が3を超えると、アルゴリズムはチェビシェフ多項式の一般的な漸化式へと移行します。 ここでは、新しい行列をゼロから構築するのではなく、それまでに得られた行列を組み合わせて構築します。 コードでは、隣接行列に前のステップで得られた結果を掛け合わせ、さらに、それよりも前のステップで得られた行列を減算することで調整します。 この処理は、複雑な取引インジケータを構築する作業に似ています。たとえば、EMAは過去の状態を考慮することで、急激な変動を平滑化しながらも、過去の情報を保持します。
   float out = 0;
   for(int t = 0; t < total_c; t += total_l)
     {
      if((t + l) >= total_c)
         continue;
      const float s1 = IsNaNOrInf(support[RCtoFlat(r, t + l, total_r, total_c, 0)], 0);
      const float s2 = IsNaNOrInf(outputs[RCtoFlat(t + l, c, total_r, total_c, step - 2)], 0);
      out += IsNaNOrInf(s1 * s2, 0);
     }
   out = 2 * LocalSum(out, 0, Temp);
   if(l == 0)
     {
      out -= IsNaNOrInf(outputs[RCtoFlat(r, c, total_r, total_c, step - 3)], 0);
      outputs[RCtoFlat(r, c, total_r, total_c, step - 1)] = IsNaNOrInf(out, 0);
     }
   return;
  }
このようにして、モデルは段階的に、グラフのスペクトル特性をより深く近似していきます。
カーネル内の各反復処理は、データの同期と妥当性チェックで終了します。 コードでは、NaNや無限大の値から処理を保護する関数が多用されています。これは、市場ではミスが許されないことを思い起こさせます。 リスク管理によって損失の上限を管理するのと同じように、ここでも異常値を早い段階で除外し、全体の計算結果を歪めないようにしています。
このような段階的な処理の結果、チェビシェフ多項式が階段状に連なる一連の行列として得られます。これらは、グラフニューラルネットワークにおけるスペクトルフィルタの構成要素となります。 実際には、これはアルゴリズムが現在の関係性だけを通して市場を捉えるのではなく、金融商品間の局所的な依存関係から長距離の依存関係まで捉えられる、多層的な視点を構築することを意味します。 これは、経験豊富なアナリストが、金の値動きから外国為替市場の間接的なシグナルを読み取ったり、債券の値動きから株式市場の変化の兆候を察知したりすることに似ています。
ここまで、チェビシェフ多項式を直接構築するアルゴリズムを検討し、その計算構造が段階的にどのように組み立てられるかを見てきました。次に、自然な流れとして、誤差逆伝播の仕組みに進みます。 ここで登場するのが、専用のカーネルです。このカーネルは、チェビシェフ多項式全体にわたって勾配を正確に配分し、さらに隣接行列へと勾配を伝播させる役割を担います。これにより、モデル全体が正しく学習できるようになります。
__kernel void ChebStepGrad(__global const float* support,
                           __global float* support_g,
                           __global const float* outputs,
                           __global float* outputs_g,
                           const int step
                          )
  {
   const size_t l = get_local_id(0);
   const size_t r = get_global_id(1);
   const size_t c = get_global_id(2);
   const size_t total_l = get_local_size(0);
   const size_t total_r = get_global_size(1);
   const size_t total_c = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
//---
   if(step < 1 || total_r!=total_c)
      return;
実行開始時に、アルゴリズムはローカルおよびグローバルのスレッドIDも初期化します。これらは市場の気配値と同じように、膨大な並列スレッドのグリッド内における各計算ユニットの位置を決定します。 リダクション処理を高速化するために一時配列用のローカルメモリが確保され、初期チェックによって、ステップが有効であり、行列が正方行列であることが確認されます。 不完全な注文板をトレーダーが決して分析しないのと同じように、ここでもプログラムは条件が無効であれば、直ちに実行を停止します。
誤差勾配の計算ステップが2以上になると、最も興味深い処理が始まります。 まず、次のステップから渡された勾配を取り出し、直前の出力レベルから直接減算します。 これは、予測の修正に例えることができます。ある時間ステップで戦略が誤差を生じさせた場合、その誤差の影響が一つ前の時間ステップにも引き継がれるのです。
if(step >= 2)
  {
   float grad = IsNaNOrInf(outputs_g[RCtoFlat(r, c, total_r, total_c, step)], 0);
   if(l == 0)
      outputs_g[RCtoFlat(r, c, total_r, total_c, step - 2)] -= grad;
次に、アルゴリズムは隣接行列に関する勾配を計算します。 各スレッドは担当するデータを取り出し、出力側の誤差と直前のステップにおける対応する値を掛け合わせます。そして、ローカルメモリを使用して、それらの値を慎重に加算していきます。 その結果得られるのは、修正のためのシグナルです。これは、ポートフォリオのリバランスに似ています。特定の資産の比重が過大になっている場合、その影響力が徐々に再配分されていくのです。
//--- support grad
grad = 0;
for(int t = 0; t < total_c; t += total_l)
  {
   if((t + l) >= total_c)
      continue;
   const float s2 = IsNaNOrInf(outputs[RCtoFlat(c, t + l, total_r, total_c, step - 2)], 0);
   grad += IsNaNOrInf(outputs_g[RCtoFlat(r, t + l, total_r, total_c, step)] * s2, 0);
  }
grad = LocalSum(grad, 0, Temp);
if(l == 0)
   outputs_g[RCtoFlat(r, c, total_r, total_c, 1)] += grad;
BarrierLoc;
スレッドの同期が完了したら、次は多項式Tk-1に関する勾配を計算します。 ここでも、同じ原則が適用されます。各スレッドは隣接行列の一部を取り出し、次のステップから渡された誤差と掛け合わせ、自身の計算結果を慎重に合計値へ加算します。 その結果、レベルk-1における多項式の勾配に対する修正値が生成されます。 この処理は、アナリストがモデルを一段階さかのぼり、その段階でリスクを過大評価していなかったかを確認し、対応する修正を加える作業に似ています。
 //--- T(k-1) grad
 grad = 0;
 for(int t = 0; t < total_c; t += total_l)
   {
    if((t + l) >= total_c)
       continue;
    const float s2 = IsNaNOrInf(support[RCtoFlat(t + l, r, total_r, total_c, 0)], 0);
    grad += IsNaNOrInf(outputs_g[RCtoFlat(t + l, c, total_r, total_c, step)] * s2, 0);
   }
 grad = LocalSum(grad, 0, Temp);
 if(l == 0)
    outputs_g[RCtoFlat(r, c, total_r, total_c, step - 1)] += grad;
}
ここで注意していただきたいのは、チェビシェフ多項式に対応するテンソルに、すべての誤差勾配を慎重に集約している点です。 バックワードパスの各ステップで計算される隣接行列の中間勾配も、同じテンソルに含めます。 重要なのは、隣接行列そのものが1次の多項式に格納されているということです。つまり、このレベルがデータの流れが交差する重要なポイントになります。 累積された誤差勾配を隣接行列のバッファに転送するのは、このレベルに到達したときだけです。これは、一連の中間調整を経て、最終的な収支を確定させる作業に似ています。
このように、このカーネルは計算処理の一種の「監査役」として機能し、バックワードパスを通じて誤差が失われたり、分散してしまったりするのを防ぎます。 それぞれの値は、ローカルな加算処理を経て、調整されたうえで、より正確な予測に向けて重みを変化させることができる場所へと送られます。 市場では、わずか0.1パーセントの差が重要な役割を果たすことがありますが、ここでも同様に、各ステップにわたって勾配を慎重に配分することが、モデルの安定した学習と適切な方向性の維持につながります。
行列の生成と勾配の配分という基盤が整ったところで、次に自然と浮かぶ疑問があります。メインプログラム側では、誰がこの一連の処理全体を管理するのでしょうか。 そこで必要となるのが、一種のディスパッチャーとして機能するオブジェクトです。このオブジェクトは、低レベルのOpenCLカーネルを整理してラップし、モデル内のほかのモジュールと連携するための使いやすいインターフェースを提供します。 これを実現するのが、全結合層オブジェクトCNeuronBaseOCLから基本インターフェースを継承するクラスCChebPolinomです。
class CChebPolinom   :  public CNeuronBaseOCL
  {
protected:
   uint              iDimension;
   uint              iSteps;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return true; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CChebPolinom(void)   {};
                    ~CChebPolinom(void)   {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint dimension,
                          uint steps, ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defChebPolinom; }
   virtual uint      GetDimension(void) const { return iDimension; }
   virtual uint      GetSteps(void) const { return iSteps; }
  };
このクラスは、グラフの空間次元と、チェビシェフ多項式展開に必要なステップ数という、重要なパラメータを内部に保持します。 これらのパラメータによって計算の対象範囲が定まり、グラフ構造を扱う際にモデルが到達できる深さが決まります。
オブジェクトの初期化はInitメソッドでおこない、必要なパラメータをすべて指定できるようになっています。
bool CChebPolinom::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint dimension,
                        uint steps, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, dimension * dimension * steps,
                                                              optimization_type, batch))
      return false;
//---
   iDimension = dimension;
   iSteps = steps;
//---
   return true;
  }
このメソッドのアルゴリズムは非常にシンプルです。 まず、親クラスにある同名のメソッドに処理を引き継ぎ、必要なすべてのチェビシェフ多項式を連結したテンソルを格納するのに十分なオブジェクトの次元を指定します。 次に、オブジェクト内部に2つの主要なパラメータ、すなわち次元iDimensionとステップ数iStepsを保持します。 これらの値は、クラスの一種の「仕様」として機能し、他のすべてのメソッドが参照する基準となります。 つまり、ここで作業領域を最終的に確定させるのです。キャンバスの幅と、情報が通過する層の数の両方を指定します。
メソッドの最後にtrueを返すことで、オブジェクトが正常に動作できる状態に準備されたことを確認します。 実装自体は簡潔ですが、この段階で、アルゴリズムがGPU上で多項式近似を効率的に実行できるかどうかという根本的な問題が解決されます。
順伝播メソッドfeedForwardは、基本的にディスパッチャーとして機能し、対応するOpenCLプログラムのカーネル呼び出しをラップして整理します。 その構造は非常に典型的です。入力データを確認し、実行パラメータを準備したうえで、順番にカーネルを呼び出します。 ただし、チェビシェフ多項式の生成と適用というタスク固有の性質によって、ここには独自の工夫が加わります。
bool CChebPolinom::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL || NeuronOCL.Neurons() != (iDimension * iDimension))
      return false;
まず、このメソッドは有効なオブジェクトが入力として渡されていること、そしてニューロン数が隣接行列のサイズiDimension * iDimensionと一致していることを確認します。 この条件が満たされていなければ、それ以上の処理を進めても意味がありません。
次に、処理範囲を準備します。計算グリッドのグローバルな次元は、GPUが実際にサポートするローカルワークグループサイズの上限を考慮するとともに、問題の行列構造を反映するように設定されます。つまり、3つの次元によって、行列の各軸に沿って計算グリッドが配置されることになります。
   uint global_work_offset[3] = { 0 };
   uint global_work_size[3] = { MathMin(iDimension, uint(OpenCL.GetMaxLocalSize(0))),
                                iDimension, iDimension
                              };
   uint local_work_size[3] = { global_work_size[0], 1, 1 };
ここで重要な要素となるのが、ステップを繰り返し処理するループです。 このループは、チェビシェフ多項式の構築が再帰的な性質を持つことを反映しています。つまり、レベルkにおける多項式の値を求めるには、それ以前の値を利用する必要があります。 最小の有効なステップ(通常は2番目のステップです。最初の2つは初期条件によって定義されるためです)から開始し、このメソッドはステップ番号をカーネルに順次渡して、実行を開始します。 こうして各反復で、GPUに新たなタスクが与えられ、多項式近似の次のレベルが構築されます。次の多項式の値を求めるには、それ以前の値を使う必要があります。
//---
   uint kernel = def_k_ChebStep;
   setBuffer(kernel, def_k_cheb_support, NeuronOCL.getOutputIndex())
   setBuffer(kernel, def_k_cheb_outputs, getOutputIndex())
   for(int step =::MathMin(2, MathMax(int(iSteps) - 1, 0)); step < int(iSteps); step++)
     {
      setArgument(kernel, def_k_cheb_step, step + 1)
      kernelExecuteLoc(kernel, global_work_offset, global_work_size, local_work_size)
     }
//---
   return true;
  }
その結果、計算は一種の計算のマトリョーシカのような構造になります。各ステップは前のステップに依存していますが、同時に、行列の各要素に対する計算全体は並列化されています。 金融市場において、このアプローチはローリングホライズンに基づく予測戦略に似ています。新しい予測をゼロから構築するのではなく、前の予測を引き継ぎながら、分析をさらに精緻化し、深めていくのです。
まさにここに、このメソッドの強みがあります。簡潔な形式でありながら、ディスパッチ処理のロジックのシンプルさと、数学的な再帰構造の深さを兼ね備えています。
誤差勾配の伝播を担当するメソッドも、同様の原理に基づいています。 順伝播の場合と同じく、このメソッドの主な目的は、チェビシェフ多項式の計算が持つ再帰構造を考慮しながら、対応するOpenCLプログラムのカーネル呼び出しを適切に整理することです。 蓄積されたすべての勾配は慎重に合算され、対応する各ステップに分配されます。その際、隣接行列と中間多項式に特に注意が払われます。
このメソッドの詳細な行単位の分析は、ご自身でおこなってください。 すべてのメソッドを含むクラスの完全なソースコードが添付ファイルに含まれており、フレームワークのこの部分がどのように機能するのかを包括的に把握できます。
ここまで多くの内容を扱ってきました。ここで少し休憩し、これまでに得た情報を整理して振り返るとよいでしょう。 詳細を一つずつ確認することで、システムの仕組みや、各コンポーネントが互いにどのように関連しているのかを、より深く理解できるようになります。 次回の記事では、HimNetフレームワークのアルゴリズム開発を続け、すべてのモジュールを実際に統合する方法についても取り上げます。
結論
本記事では、HimNetフレームワークの理論的な側面を検討したうえで、提案した手法をMQL5とOpenCLを使用して実装する実践的な段階へと進みました。 時空間メタパラメータの概念について詳しく解説しました。 また、グラフ畳み込み型の再帰ブロックが時間的依存関係と空間的依存関係をどのように考慮できるのかに焦点を当て、さらに、計算の高速化とモデルの堅牢性向上を目的として、GPU上でチェビシェフ多項式を生成し、適用するためのアルゴリズムについても検討しました。
次回の記事では、HimNetフレームワークのアルゴリズム開発を引き続き進めていきます。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19233
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。
 MetaTrader 5における取引銘柄の時間帯別値動きと銘柄間スプレッドの分析
 市場シミュレーション:ポジション表示(VI)
 市場シミュレーション:MQL5でのSQL入門(I)
 線形自己回帰モデルの残差を用いた非線形U-Transformerの学習

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索