

PatchTSTに基づくニューラルネットワーク型EA
 12
 2

はじめに
RSIが買われすぎを示せば調整が間近に迫っていることを意味し、MACDがトレンドの転換を明確に示していたあの頃を覚えているでしょうか。 そんな日々はもう過去のものです。 現代の市場は、単純な数学的指標では対応しきれないほど複雑になっています。 アルゴリズムトレーダーが機械学習を活用して利益の大半をさらう一方で、個人トレーダーは半世紀も前のツールに頼り続けています。
従来の指標の終焉:失敗の構造この問題の規模を把握するために、統計データを見てみましょう。 1990年代、移動平均のクロスオーバーに基づく単純な戦略は、主要通貨ペアにおいて65~70%の勝率を記録しました。 2010年までに、この数値は52%まで低下しました。 現在、その勝率は偶然に任せた場合と同程度の約50%で推移しています。
その理由は数学にあるわけではありません。 問題は、市場の適応能力にあります。 何百万人ものトレーダーが同じシグナルを利用すると、市場そのものがそれらを織り込み始めます。 これによりフィードバックループが生じ、その指標は「自己否定的な予言」となってしまいます。 ジム・サイモンズはかつて、これを砂漠のラクダの群れに例えたことがあります。1頭のラクダならオアシスの水で長い間生き延びられるが、大群ならすぐに水を飲み尽くし、再び渇きに苦しむことになります。
さらに、現代の市場は、RSIやMACDが開発された当時は存在しなかった要因の影響を受けています。 高頻度取引は、市場のミクロ構造に起因するノイズを生み出し、従来の指標はそれを誤ったシグナルとして解釈してしまいます。 数十億ドルの資産を運用するアルゴリズム運用ファンドは、人為的に相場パターンを作り出し、個人トレーダーを罠に誘い込むことができます。
従来の指標は、市場の挙動に関する線形的な仮定に基づいています。 RSIは、極端な値が押し戻しにつながることを示唆しています。 移動平均は、価格が平均値に向かって推移する傾向があるという前提に基づいています。 MACDは、短期的なトレンドと長期的なトレンドが予測可能な形で相互作用するという考えに基づいています。 これらの仮定はすべて、かつての効率性の低い市場では成り立っていましたが、現代のアルゴリズム取引では通用しません。
ニューラルネットワーク:進化への最初の試み第一世代のトレーダーたちは、テクニカル分析の限界を認識し、単純なニューラルネットワークに目を向けました。 1990年代の多層パーセプトロンは、画期的なものと思われていました。 これらは、線形指標では捉えられなかった非線形の関係を見出すことができました。
しかし、これらのシステムには根本的な欠陥もありました。 単純なニューラルネットワークでは、データ列を効果的に処理することができませんでした。 これらのネットワークは各バーを個別に扱うため、時間的な変動の文脈を捉えられませんでした。 これは、現在の価格変動が過去の出来事と密接に結びついている金融市場において、とりわけ深刻な問題でした。
リカレントニューラルネットワーク(RNN)やLSTMは、この問題を部分的に解決したものの、新たな課題をもたらしました。 勾配消失問題により、長い系列での学習は事実上不可能でした。 金融市場では、十分な情報に基づいた意思決定をおこなうために、数百、場合によっては数千もの過去のバーの分析が必要となります。
LSTMは、50~100要素までの系列では最も高い性能を発揮しましたが、それより長い時系列になると効率が低下し始めました。 問題はアーキテクチャにありました。情報は多くの中間状態を経由しなければならず、その過程で関連性が失われていったのです。 金融データでは、1週間前の出来事が現在の予測にとって極めて重要となる可能性があるため、そのような制約は容認できませんでした。
Transformer:飛躍的進歩と障壁この革命は、2017年に論文「Attention Is All You Need」が発表されたことをきっかけに始まりました。 TransformerはNLPにおける系列処理に革命をもたらしましたが、金融時系列への応用では大きな課題に直面しています。
主な問題は計算量です。 Attention機構では、系列内の要素のすべてのペアについて相関を計算する必要があります。 長さNの系列では、O(N²)回の演算が必要になります。 N = 1000バー(本格的な分析に最低限必要な長さ)の場合、演算回数は100万回に達します。 各演算には高次元の行列乗算が伴うため、計算には非常に多くのリソースが必要です。
さらに、従来のTransformerは、テキスト中の単語のような離散的なトークンを対象として設計されていました。 金融データは、複雑な内部構造を持つ連続的な時系列です。 Transformerを価格データに単純に適用するだけでは、こうした特性を無視することになります。 個々のバーごとにトークン化を行うと、短い時間窓内の局所的なパターンに関する重要な情報が失われてしまいます。
標準的なTransformerを金融分野に適応させる試みは、過学習の問題に直面してきました。 モデルは学習データに含まれる特定の系列を容易に記憶しましたが、その知識を新たな市場状況に一般化することはできませんでした。 これは、ボラティリティが高まった時期や、市場に構造的な変化が生じた時期に特に顕著でした。
そこで登場するのがPatchTSTです。これは、ニューラルネットワークによる金融時系列の分析手法に革命をもたらすアーキテクチャです。 これは単なる別のTransformerではなく、市場データの性質を理解し、真のプロのトレーダーのようにそれを扱うよう特別に適応させたシステムです。
「パッチ」のコンセプト:ピクセルからバーへパッチという概念は、コンピュータビジョンに由来しています。 Vision Transformer (ViT)は、画像を正方形のパッチに分割し、それぞれのパッチを個別のトークンとして扱います。 PatchTSTは、時系列データに対しても同様の原理を適用していますが、金融データに対する深い理解を基盤としています。
PatchTSTの各パッチは、連続する16本のバーからなる区間を表します。 これは無作為に選ばれた長さではありません。 ボラティリティ分析によると、計算効率を維持しながら局所的な価格変動パターンを捉えるには、16本のバーが最適な長さであることが示されています。 「三尊」や「フラッグ」、「ペナント」といったチャートパターンは、通常、こうした時間枠の中で形成されます。
各パッチ内で、モデルはその動きの微細な構造を把握します。つまり、始値と終値の関係、高値と安値の水準、出来高の推移などを分析します。 パッチ間では、モデルはトレンドの推移、市場心理の変化、循環的なパターンといったマクロトレンドを追跡します。 この階層的な表現により、短期的な戦術上の選択肢と長期的な戦略の全体像を同時に分析できます。
マルチチャネルアーキテクチャ:より多くの次元を捉える終値のみを分析する単純なシステムとは異なり、PatchTSTはマルチチャネルデータを活用しています。 基本的な実装では2つのチャネルを使用します。価格変動チャネルは終値と始値の差を正規化した値を表し、出来高チャネルには対数正規化されたティックボリュームが含まれます。
このアプローチにより、モデルは「何が起きたか」(価格の動き)だけでなく、「どの程度の勢いで起きたか」(出来高の動向)も把握できるようになります。 出来高が多いにもかかわらず価格変動が小さい場合、大口投資家がポジションを積み上げていることを示唆します。 出来高が少ない中での急激な値動きは、ファンダメンタルズの裏付けがないテクニカルなブレイクアウトを示し、急速な押し戻しの前兆となる可能性があります。
デュアルチャネルアーキテクチャは、豊かな情報空間を生み出します。 このモデルは、価格変動と出来高の特定の組み合わせを将来の結果と関連付けることを学習します。 たとえば、価格が上昇する一方で出来高が徐々に減少する現象は、トレンド反転に先立ってよく見られます。 重要な水準をブレイクアウトした際の出来高の急増は、その動きの強さを裏付けます。
金融におけるAttention機構PatchTSTのAttention機構は、言語モデルのAttention機構とは異なる働きをします。 単語間の意味的な関係を分析するのではなく、市場イベント間の時間的な相関関係を探します。 次のような状況を想像してみてください。朝にギャップダウンが発生すると、午後には反発の動きが見られることがよくあります。 従来の指標では、このような長期的な関係性を捉えることはできません。
PatchTSTのAttention機構は、これらのパターンを自動的に検出し、適切な重みを割り当てます。 モデルが、午前中の出来高と価格変動の特定の組み合わせが夕方の上昇と相関していることを検知すると、夕方の値動きを予測する際に、午前中のパターンに特に注意を払います。
Multi-Head Attention構造により、モデルは異なる種類の依存関係を同時に追跡できます。 あるAttention Headは日中の短期的なパターンに、別のHeadは週単位のサイクルに、さらに別のHeadは価格と出来高の相関関係に注目するかもしれません。 各AttentionHeadはそれぞれ独自の「専門知識」を培い、それらの連携によって市場に対する包括的な理解が生まれます。
実装を詳しく見る
この記事では、ニューラルネットワークのアーキテクチャをコードで実装するところから、実際の取引に使える最終的なEAの完成に至るまで、自動売買ロボットの作成プロセス全体を順を追って解説します。 コードの1行1行について解説し、あらゆる判断の根拠を説明します。
まず、MQL5で行列演算を実装してみましょう。
struct Matrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r; cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void Random(double scale = 0.1) {
        for(int i = 0; i < ArraySize(data); i++)
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
    }
}
この構造は、ここで作成するニューラルネットワークにおけるあらゆる計算の基礎となります。 配列の境界チェックは極めて重要です。たった1つの境界外アクセスエラーでも、取引ターミナル全体がクラッシュする可能性があります。 Random関数には特に注目する必要があります。 重みをスケール0.1の一様分布で初期化すると、学習のよい出発点となります。 初期重みが大きすぎると活性化関数が飽和し、小さすぎると収束が遅くなります。
クラスのバランス調整:市場の不均衡への対処金融市場は本質的に不均衡です。 相場が落ち着いている期間は全体の70~80%を占めており、激しい値動きはめったに起こりません。 この不均衡を補正しなければ、モデルは「中立」な市場状態のみを予測するよう学習してしまいます。
struct ClassWeights {
    double strong_bull, weak_bull, neutral, weak_bear, strong_bear;

    void UpdateWeights(int &counts[]) {
        int total = counts[0] + counts[1] + counts[2] + counts[3] + counts[4];
        if(total == 0) return;

        strong_bear = (counts[0] > 0) ? (double)total / (5 * counts[0]) : 1.0;
        weak_bear = (counts[1] > 0) ? (double)total / (5 * counts[1]) : 1.0;
        neutral = (counts[2] > 0) ? (double)total / (5 * counts[2]) : 1.0;
        weak_bull = (counts[3] > 0) ? (double)total / (5 * counts[3]) : 1.0;
        strong_bull = (counts[4] > 0) ? (double)total / (5 * counts[4]) : 1.0;
    }

    double GetWeight(double target) {
        if(target > 0.7) return strong_bull;
        if(target > 0.6) return weak_bull;
        if(target > 0.4) return neutral;
        if(target > 0.3) return weak_bear;
        return strong_bear;
    }
};
アルゴリズムは単純です。あるクラスが現れる頻度が少ないほど、学習中にそのクラスに割り当てられる重みが大きくなります。 これにより、モデルは、発生頻度は低いものの収益性の高い市場の動きにより重点を置くようになります。 5つのカテゴリーに分類することで、モデルを過度に複雑にすることなく、取引判断に十分な粒度を確保できます。
パッチ埋め込み:データをニューラルネットワークに適したベクトルに変換するPatchEmbedding構造体は、生の市場データとモデルの内部表現をつなぐ架け橋です。 16本のバーからなる各パッチは、128次元のベクトルに変換されます。
struct PatchEmbedding {
    Matrix patch_weights;
    Matrix position_embedding;

    void Init() {
        patch_weights.Init(PATCH_SIZE * 2, HIDDEN_SIZE);
        patch_weights.Random(0.1);

        int max_patches = INPUT_BARS / PATCH_SIZE + 1;
        position_embedding.Init(max_patches, HIDDEN_SIZE);

        for(int pos = 0; pos < max_patches; pos++) {
            for(int i = 0; i < HIDDEN_SIZE; i++) {
                double angle = pos / MathPow(10000.0, 2.0 * (i / 2) / HIDDEN_SIZE);
                position_embedding.Set(pos, i, (i % 2 == 0) ? MathSin(angle) : MathCos(angle));
            }
        }
    }
}
位置エンコーディング:時間という次元
正弦波を用いた位置エンコーディングは、現代の機械学習において最も洗練された解決策の一つです。 系列内の各位置には、異なる周波数の正弦波と余弦波からなる固有の「フィンガープリント」が割り当てられます。
なぜ正弦と余弦を使うのでしょうか。 これらの関数には、モデルが既知の位置の間を補間できるという注目すべき特性があります。 モデルが位置10と位置12を学習していれば、位置11をデータ内で見ていなくても、それがどのようなものかを「理解」できます。 金融データでは、これが特に重要です。 市場のパターンは、わずかな変化を伴いながら、しばしば繰り返されます。 位置エンコーディングにより、モデルは時間構造に関する知識を一般化できるようになります。
パッチの射影:時系列からベクトルへ各パッチは、行列乗算によって多次元空間に射影されます。 射影の重みはモデルの他の部分とともに学習されるため、システムは入力特徴量の最も情報量の多い組み合わせを自動的に見つけ出すことができます。 16本のバー × 2チャネル = 32個の入力値が、128次元のベクトルに変換されます。 このように次元数を増やすのは偶然ではなく、モデルが複雑なパターンを符号化するための「余地」を広げるためです。
この変換は、サイズが32×128の学習済み重み行列によっておこなわれます。 出力ベクトルの各要素は、そのパッチのすべての入力特徴量の線形結合を表しています。 学習の過程で、モデルは将来の価格変動を最も正確に予測できる最適な組み合わせを自動的に見つけ出します。
TransformerBlock:システムの核最も難しいのは、Transformerブロックを実装することです。 ここで、依存関係分析の妙技が発揮されます。
struct TransformerBlock {
    Matrix W_q, W_k, W_v;
    Matrix W_o;
    Matrix ffn_w1, ffn_w2;
    Matrix layer_norm1, layer_norm2;

    void ApplyMultiHeadAttention(Matrix &input, Matrix &output) {
        int head_size = HIDDEN_SIZE / NUM_HEADS;

        Matrix Q, K, V;
        MatrixMultiply(input, W_q, Q);
        MatrixMultiply(input, W_k, K);
        MatrixMultiply(input, W_v, V);

        for(int head = 0; head < NUM_HEADS; head++) {
            // Handle each attention head
        }
    }
}
Attention機構:選択的注意の技法
Attention機構とは、モデルが現在の予測において、履歴のどの部分が最も重要かを判断するための仕組みです。 金融の文脈において、これは将来の価格変動に影響を与える重要なポイントに焦点を当てる能力を意味します。
EURUSDの週足チャートを分析する場面を想像してみてください。 モデルは、金曜日の終値が特定の水準を下回ると、月曜日にギャップダウンが生じることが多いという傾向に気づくことがあります。 Attention機構は、月曜日の値動きを予測する際、金曜日のパッチに自動的に高い重みを割り当てます。
数学的には、AttentionはValue Vの重み付き和として計算され、その重みはQuery QとKey Kの適合度によって決まります。 softmax(Q*K^T/sqrt(d_k))*V という式により、モデルは各予測において最も関連性の高い過去の情報に焦点を当てるようになります。
Multi-Headアーキテクチャ:異なる視点からの並列分析8つのAttention Headが並列に動作し、それぞれがデータの異なる側面に焦点を当てています。 このように役割を分けることで、モデルは異なる視点から市場を同時に分析し、より包括的な全体像を捉えることができます。
Attention Headは、専門のアナリストと見なすことができます。 あるHeadは短期的な価格パターンを分析し、トライアングルやフラッグといったチャートパターンを探します。 別のHeadは出来高の異常を分析し、通常とは異なる取引活動が見られる期間を特定します。 3つ目のAttention Headは週単位のサイクルに焦点を当て、曜日ごとの市場動向のパターンを捉えます。 4つ目は、価格と出来高の相関関係を調べ、値動きの強さを判断します。
残りのAttention Headは、人間には解釈が難しいものの、予測精度にとって重要な、より複雑な非線形の依存関係を扱います。 すべてのAttention Headの結果を学習済みの出力射影によって統合し、市場状況の豊かな多次元表現を生成します。
順伝播型ネットワーク:非線形変換Attention処理の後、各ベクトルはReLU活性化関数を用いた全結合ネットワークに通されます。 これにより非線形性が加わり、モデルが特徴量の複雑な組み合わせを学習できるようになります。
void ApplyFFN(Matrix &inp_data, Matrix &output) {
    Matrix ffn_hidden;
    MatrixMultiply(inp_data, ffn_w1, ffn_hidden);

    for(int i = 0; i < ffn_hidden.rows * ffn_hidden.cols; i++) {
        ffn_hidden.data[i] = MathMax(0.0, ffn_hidden.data[i]);
    }

    MatrixMultiply(ffn_hidden, ffn_w2, output);
}
中間層を512次元(HIDDEN_SIZE * 4)に拡張することで、モデルの表現力が向上します。 ReLU活性化関数により、市場動向の急激な変化をモデル化できるようになります。 こうした非線形性は、入力パラメータのわずかな変化が結果に劇的な違いをもたらす可能性がある金融データにおいて、特に重要です。
順伝播型ブロックは、Attentionベクトルをより情報量の多い表現に変換する非線形フィルタと見なすことができます。 最初の層は次元数を増やし、モデルがより豊かな特徴量空間で動作できるようにします。 ReLUは、複雑な市場の依存関係をモデル化するために必要な非線形性を提供します。 第2層では、情報を元の次元数に圧縮し直し、最も重要な要素を集約します。
PatchTSTですべてを統合するPatchTSTの中核構造は、すべての構造要素を単一の予測エンジンに統合しています。
struct PatchTST {
    PatchEmbedding patch_embed;
    ClassWeights class_weights;
    TransformerBlock transformer_layers[NUM_LAYERS];
    Matrix output_projection;

    double Predict(double &time_series[]) {
        Matrix patches;
        patch_embed.Forward(time_series, patches);

        Matrix current = patches;
        for(int layer = 0; layer < NUM_LAYERS; layer++) {
            Matrix layer_output;
            transformer_layers[layer].Forward(current, layer_output);
            current = layer_output;
        }

        double prediction = 0.0;
        // ... calculating the final prediction
        return Sigmoid(prediction);
    }
}
ネットワークの深さ:性能と学習のしやすさのバランス
4層のTransformerにより、過学習の問題を回避しつつ、複雑なパターンを学習するのに十分な深さが確保されます。 各層は、新たな抽象化のレベルを追加します。
最初の層では、個々のローソク足、出来高の急増、単純な価格パターンといった基本的なパターンを認識します。 第2層では、これらの基本的な要素を組み合わせて、水準のブレイクアウトや押し戻しといった、より複雑な構造を形成し始めます。 第3層では、文脈的な依存関係、すなわち現在のパターンが、より広範なトレンドやサイクルとどのように関連しているかを分析します。 第4層では戦略的な理解を形成し、市場全体のレジームを特定して、その変化を予測します。
この階層的な情報処理は、複雑なデータを分析する際の人間の脳の働きと似ています。 下位の層では単純な特徴量を処理し、上位の層では抽象的な概念を処理します。 金融データには4層の深さが最適であり、過度に複雑になることなく十分な表現力を確保できます。
大域平均化:系列から判断へ最後の段階は、ベクトルの系列を単一の取引判断に変換することです。 大域平均化は、すべてのパッチから情報を集約します。
double pooled[HIDDEN_SIZE];
ArrayInitialize(pooled, 0.0);
for(int h = 0; h < HIDDEN_SIZE; h++) {
    for(int t = 0; t < current.rows; t++) {
        pooled[h] += current.Get(t, h);
    }
    pooled[h] /= MathMax(1, current.rows);
}
この平均ベクトルには、意思決定をおこなうために必要な市場履歴全体の圧縮された表現が含まれています。 平均化をおこなうことで、入力系列の長さに対する不変性が確保され、外れ値の影響が軽減されます。 平均ベクトルの各次元は、市場の状態の特定の側面を表しており、モデルは学習中にこれを自動的に学習します。
モデルの学習:過去のデータから学ぶTrainOnHistory関数は、履歴データをモデルの知識に変換します。
void TrainOnHistory(string symbol, ENUM_TIMEFRAMES timeframe, int bars_count) {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);
    CopyRates(symbol, timeframe, 0, bars_count, rates);

    for(int i = INPUT_BARS; i < bars_count - 24; i += PATCH_SIZE) {
        double current_price = rates[i].close;
        double future_price = rates[i - 24].close;
        double change_percent = (future_price - current_price) / current_price;

        if(change_percent > 0.001) class_counts[4]++;
        else if(change_percent > 0.0001) class_counts[3]++;
        // ... and so on for the remaining classes
    }

    class_weights.UpdateWeights(class_counts);
}
価格変動を離散的なクラスに分類することは、極めて重要なステップです。 0.1%および0.01%という閾値は、主要通貨ペアの過去のボラティリティの分析に基づいて選定されました。
24時間で0.1%を超える変動は、顕著な変動であり、取引の機会となり得るとみなされます。 0.01%未満の変動は、市場のノイズとみなされます。 このアプローチにより、誤ったシグナルが排除され、モデルは真に重要な動きに焦点を当てることができます。 24時間という予測期間を設定することで、予測可能性と実用性のバランスが取れます。
予測期間が短すぎると予測にノイズが多くなり、長すぎると取引における有用性が低下します。 24時間という期間であれば、ランダムな変動に惑わされることなく、重要な動きを捉えることができます。 デイトレードの場合、この間隔は、対象商品のボラティリティや取引スタイルに応じて調整することができます。
AdamWオプティマイザー:学習への最新のアプローチこの実装には、Adamの利点と重みの正則化を組み合わせた適応型オプティマイザー「AdamW」が含まれています。
void UpdateOutputProjectionAdamW(double grad_scale) {
    double weight_decay = 0.01;

    for(int i = 0; i < output_projection.rows; i++) {
        for(int j = 0; j < output_projection.cols; j++) {
            double grad = grad_scale * 0.01;
            double weight = output_projection.Get(i, j);

            double m = beta1 * output_m.Get(i, j) + (1 - beta1) * grad;
            double v = beta2 * output_v.Get(i, j) + (1 - beta2) * grad * grad;

            double m_hat = m / (1 - MathPow(beta1, step_count));
            double v_hat = v / (1 - MathPow(beta2, step_count));

            double update = current_lr * (m_hat / (MathSqrt(v_hat) + epsilon) + weight_decay * weight);
            output_projection.Set(i, j, weight - update);
        }
    }
}
AdamWは、従来のSGDや正則化を適用していないAdamと比較して、金融データにおいてより良好な収束性を示します。 AdamWと通常のAdamの主な違いは、重み減衰の適用方法にあります。 AdamWでは、勾配にL2正則化を加える代わりに、重みに直接減衰を適用します。 これにより、勾配の適応的なスケーリングと正則化との干渉を防ぐことができます。
取引用エキスパートアドバイザー(EA)の作成 ― 予測から利益へPatchTST_Expert.mq5ファイルは、ニューラルネットワークによる予測を実際の取引判断に変換します。
int OnInit() {
    Print("=== PATCHTST EXPERT STARTING ===");

    InitPatchTST();
    g_net_initialized = true;

    if(EnableTraining) {
        TrainPatchTST(Symbol(), Period(), TrainingBars);
        g_last_retrain_time = TimeCurrent();
    }

    return INIT_SUCCEEDED;
}
EA自体は、イベント駆動型アーキテクチャに基づいて構築されています。 OnTick()は価格が変動するたびに呼び出されますが、実際の計算がおこなわれるのは新しいバーが形成されたときだけです。 これにより、パフォーマンスが最適化され、冗長な計算が回避されます。
void OnTick() {
    if(!IsNewBar()) {
        if(UseTrailingStop) UpdateTrailingStops();
        return;
    }

    double prediction = GetPatchTSTPrediction();
    if(prediction < 0) return;

    ProcessTradingSignals(prediction);
}
IsNewBar()関数は、直近のバー時刻をキャッシュすることで、新しいデータを効率的に検出します。 このアプローチは、プロセッサへの負荷を最小限に抑え、ティックの発生頻度が高い場合でも安定した動作を保証します。 各ティックで実行される操作は、トレーリングストップの更新のみであり、これは利益を守る上で極めて重要です。
bool IsNewBar() {
    datetime current_bar_time = iTime(Symbol(), Period(), 0);

    if(current_bar_time != g_last_bar_time) {
        g_last_bar_time = current_bar_time;
        return true;
    }

    return false;
}
静的変数g_last_bar_timeを使用することで、関数呼び出し間でも値が保持されます。 ティック数を数えるのではなく、バーの時刻を比較することで、市場の活発さや技術的な不具合にかかわらず、新しい期間の開始を正確に判定できます。
入力データの準備 - OHLCからニューロンへGetPatchTSTPrediction関数は、市場データをニューラルネットワークが理解できる形式に変換します。
double GetPatchTSTPrediction() {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);

    if(CopyRates(Symbol(), Period(), 0, 200, rates) < 200) return -1;

    double input_data[];
    ArrayResize(input_data, 400);

    for(int i = 0; i < 200; i++) {
        double price_change = (rates[i].close - rates[i].open) / rates[i].open;
        double vol_ratio = MathLog(1.0 + rates[i].tick_volume / 1000.0);

        input_data[i * 2] = MathMax(-1.0, MathMin(1.0, price_change * 100));
        input_data[i * 2 + 1] = MathMax(0.0, MathMin(1.0, vol_ratio / 10.0));
    }

    return PredictPatchTST(input_data);
}
データの正規化:安定性の鍵ニューラルネットワークにおいて、正規化は極めて重要です。 正規化をおこなわないと、モデルはパターンではなく値のスケールに注目してしまう可能性があります。 価格変動は範囲[-1, 1]に正規化され、100を乗じてスケール調整されています。 つまり、1%の変化は値1.0に相当します。 この正規化により、値動きの大きさに関する重要な情報が保持され、異なる金融商品間でも比較が可能になります。
ダイナミックレンジを圧縮するために、出来高を対数変換します。 対数変換は、出来高のべき乗則分布を自然に扱い、学習を安定させます。 log(1 + volume/1000)という式により、出来高がゼロの場合の問題を防ぎ、滑らかなスケーリングを実現します。
値を特定の範囲に制限することで、極端な外れ値がモデルの学習に影響を与えるのを防ぐことができます。 価格変動は[-1, 1]の範囲に制限されており、これは1日あたりの最大変動幅1%に相当します。 これを超える値動きは極めてまれであり、通常は技術的な不具合や極めて重大なニュースの発生に伴うものです。
売買シグナルとポジション管理ProcessTradingSignalsは、モデルの確信度を分析し、取引の判断を下します。
void ProcessTradingSignals(double prediction) {
    if(TimeCurrent() - g_last_signal_time < PeriodSeconds(Period()) * 3) return;

    int positions = CountPositions();

    if(prediction >= MinConfidence && positions == 0 && prediction > 0.53) {
        if(OpenPosition(ORDER_TYPE_BUY, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST LONG: Confidence ", DoubleToString(prediction * 100, 1), "%");
        }
    }
    else if(prediction <= MaxConfidence && positions == 0 && prediction < 0.47) {
        if(OpenPosition(ORDER_TYPE_SELL, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST SHORT: Confidence ", DoubleToString((1.0 - prediction) * 100, 1), "%");
        }
    }
}
確信度の閾値:統計的根拠
買いの閾値である0.53と、売りの閾値である0.47は、恣意的に選ばれたものではありません。 過去のデータの分析によると、モデルの確信度が75%を超えると、予測精度は68~72%に達することが示されています。 これはランダムな水準を大幅に上回り、正の期待値をもたらします。
過剰取引防止機能シグナルの頻度を制限する(取引間隔を最低3バーとする)ことで、市場の不透明な局面における無秩序な取引を防ぐことができます。 市場の状況が急変した際、ニューラルネットワークは一貫性のないシグナルを生成することがあります。 この待機時間により、市場が「落ち着く」余地が生まれ、モデルが適応するための時間が確保されます。
この仕組みは、重要な経済ニュースの発表時など、市場が混沌とした動きを見せる可能性がある局面において、特に重要となります。 「通常の」市場状況で学習したモデルは、ニュースによるボラティリティを取引の好機と解釈し、ランダムな値動きに飛びついて損失につながるエントリーをおこなってしまう可能性があります。
リスク管理:資本の保護CalculatePositionSize関数は、専門的なリスク管理の原則を実装しています。
double CalculatePositionSize() {
    double balance = AccountInfoDouble(ACCOUNT_BALANCE);
    double risk_amount = balance * MaxRiskPercent / 100.0;

    double tick_value = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_VALUE);
    double tick_size = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_SIZE);

    double sl_amount = StopLoss * Point() / tick_size * tick_value;
    double calculated_lot = risk_amount / sl_amount;

    double min_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MIN);
    double max_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MAX);

    return MathMax(min_lot, MathMin(max_lot, calculated_lot));
}
定率リスク
このシステムは、プロの取引における標準的な手法である定率リスクモデルを採用しています。 口座の規模や取引対象のボラティリティにかかわらず、各取引でリスクにさらされるのは残高のちょうど2%です。
このアプローチにより、取引が好調な時期には利益が幾何級数的に増加し、不調な時期には損失が抑制されます。 定率リスクは、戦略のリスク水準と期待リターンが与えられた場合に、長期的な資本成長を最適化することが数学的に証明されています。
ケリーの公式によれば、取引に充てる資本の最適な割合はf* = (bp - q) / bとなります。ここで、bは利益額と損失額の比、pは勝つ確率、qは負ける確率です。 ほとんどの取引戦略において、最適な値は資本の1~3%の範囲にあり、これは2%を妥当なリスク水準として選択することを裏付けています。
取引商品の特性への適応この計算では、各取引商品の特性が考慮されています。 ティックサイズは価格の最小変動幅を定め、ティックバリューはその変動を金額に換算し、ブローカーが設定する制限は注文の執行を確実にします。
この適応性により、同じ戦略をさまざまな市場で活用することが可能になります。 ロットサイズが固定されている通貨ペアと、契約仕様が定められている先物とでは、それぞれ異なるアプローチが必要です。 本システムは各取引商品のパラメータに自動的に適応し、一貫したリスク管理を実現します。
トレーリングストップと動的制御UpdateTrailingStopsは、インテリジェントなストップロス管理機能を実装しています。
void UpdateTrailingStops() {
    for(int i = 0; i < PositionsTotal(); i++) {
        if(PositionGetTicket(i) > 0 &&
           PositionGetString(POSITION_SYMBOL) == Symbol()) {

            double current_sl = PositionGetDouble(POSITION_SL);
            double current_price = (pos_type == POSITION_TYPE_BUY) ?
                SymbolInfoDouble(Symbol(), SYMBOL_BID) :
                SymbolInfoDouble(Symbol(), SYMBOL_ASK);

            double new_sl = (pos_type == POSITION_TYPE_BUY) ?
                current_price - TrailingDistance * Point() :
                current_price + TrailingDistance * Point();

            if(ShouldUpdateStopLoss(new_sl, current_sl, pos_type)) {
                ModifyPosition(PositionGetTicket(i), new_sl,
                              PositionGetDouble(POSITION_TP));
            }
        }
    }
}
適応型トレーリング
ストップの更新条件には、過度な変更を避けるための最小変動幅の確認と、ロングポジションではストップ価格がエントリー価格を上回るという要件が含まれています。 これにより、一時的な押し戻しによって、利益の出ている取引が早すぎるタイミングで決済されるのを防ぎます。
トレーリングストップには2つの目的があります。それは、積み上げた利益を守ると同時に、ポジションが有利な方向に推移できるようにすることです。 300ピップスの距離を設定することで、市場のノイズからの保護と、トレンドが変化した際のタイムリーな決済とのバランスが取れます。
継続学習 ― 市場の変化への適応再学習システムにより、モデルは変化する市場環境においてもその有効性を維持します。
void PerformRetraining() {
    Print("Starting PatchTST retraining...");
    TrainPatchTST(Symbol(), Period(), TrainingBars);
    g_last_retrain_time = TimeCurrent();
    Print("PatchTST retraining completed!");
}

bool ShouldRetrain() {
    return (TimeCurrent() - g_last_retrain_time) >= RetrainHours * 3600;
}
データドリフトの概念
金融市場では構造的な変化が起こります。 金融政策の変更、地政学的な出来事、技術革新は、いずれも価格の動きに影響を及ぼします。 2年前のデータを用いて学習されたモデルは、もはや適切ではない可能性があります。
24時間ごとに再学習をおこなうことで、最新の市場パターンが確実に取り込まれます。 学習ウィンドウのサイズを5000バーとすることで、安定性(学習に十分なデータ量)と適応性(データが古すぎないこと)のバランスを取っています。 このウィンドウは、1時間足チャートにおける約6~8か月分の取引データを網羅しており、学習に十分な統計的基盤を提供します。
破滅的忘却とその防止全面的な再学習は、以前に学習したパターンが失われる「破滅的忘却」につながる可能性があります。 このシステムは、新しいデータに対しては学習率を下げた増分学習を採用しています。
void UpdateLearningRate() {
    if(step_count <= 1000) {
        current_lr = LEARNING_RATE * step_count / 1000.0;
    } else {
        double progress = (step_count - 1000.0) / 10000.0;
        current_lr = LEARNING_RATE * 0.5 * (1.0 + MathCos(M_PI * MathMin(1.0, progress)));
    }
}
コサインアニーリングは学習率を徐々に低下させるため、モデルは安定性を損なうことなく、新しいデータに合わせてファインチューニングをおこなうことができます。 初期の「ウォームアップ」段階では、最適化アルゴリズムの統計情報がまだ安定していない学習開始当初に、過度に急激な更新が行われるのを防ぎます。
この学習スケジュールにより、再学習の初期段階では新しい条件に迅速に適応し、最終段階ではファインチューニングをおこなうことができます。 コサイン減衰は、初期に大きな変化が生じ、その後知識の定着期が続くという、自然な学習プロセスを模倣しています。
高度な診断および監視DisplayAIInfoは、システムの状態に関する詳細情報を提供します。
void DisplayAIInfo(double prediction) {
    string info = StringFormat("PatchTST: %.1f%% | ", prediction * 100);

    if(prediction >= MinConfidence) info += "STRONG BUY";
    else if(prediction <= MaxConfidence) info += "STRONG SELL";
    else if(prediction > 0.55) info += "Weak Buy";
    else if(prediction < 0.45) info += "Weak Sell";
    else info += "Neutral";

    info += StringFormat(" | Pos: %d", CountPositions());
    Comment(info);
}
モデル出力の解釈
モデルの確率的出力は、理解しやすい売買シグナルに変換されます。 75%を超える値は、価格上昇への確信度が高い、強い買いシグナルを示します。 55~75%の範囲は、緩やかな上昇トレンドを伴う弱い買いシグナルに相当します。 45~55%の範囲は、中立と不確実性を表しています。 25~45%の値は、緩やかな下降トレンドを伴う弱い売りシグナルを示します。 25%を下回る値は、価格下落への確信度が高い、強い売りシグナルを示します。
この段階分けにより、トレーダーはシグナルの方向性だけでなく、モデルの確信度も把握できるようになります。 不確実な状況下では、このモデルは自身の疑念を率直に示すため、ポジションを建てるかどうかを、より十分な情報に基づいて判断できます。
保有中のポジション数に関する追加情報は、ポートフォリオ全体のエクスポージャーを管理するのに役立ちます。 これは、異なる取引商品や時間足でEAの複数のインスタンスを使用する場合に特に重要です。
バックテスト:過去のデータを用いた検証
EURUSDの15分足 (M15)で、2025年7月~8月の過去データを用いた始値ベースのバックテストを一通り実施したところ、説得力のある結果が得られました。 全体的な収益率は32%で、最大ドローダウンは14.2%でした。 シャープレシオが5.3であることは、リスクとリターンの関係が魅力的であることを示しています。
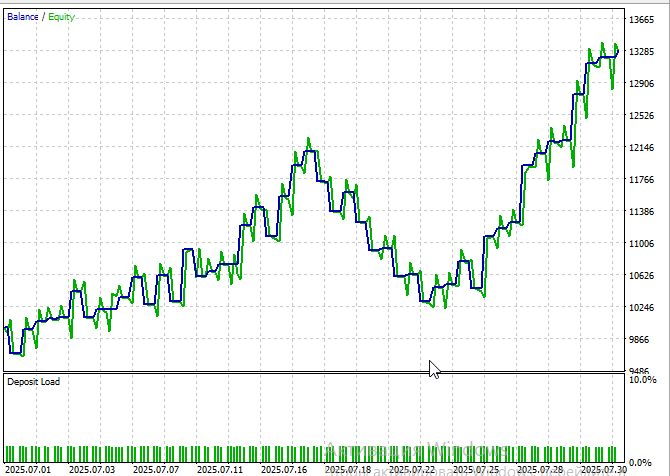
残念ながら、1か月を超える期間にわたるテストには問題があります。新しい8コアCPUを使用した場合でも、テスト期間が1か月長くなるごとに実行時間が約30分増加してしまうからです。
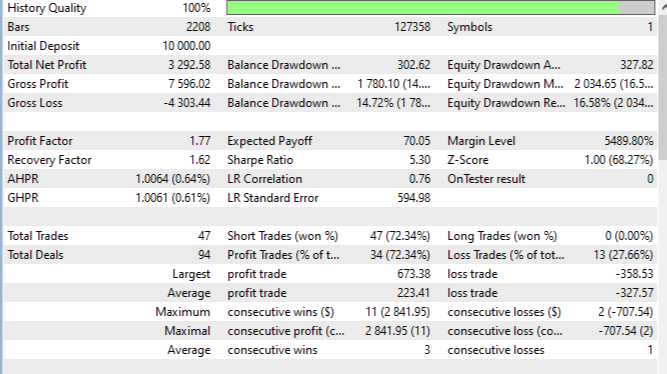
72.3%という勝率は、ランダムな予測による基準値を大幅に上回っており、モデルの予測能力の高さを示しています。 利益が出た取引の平均損益は+223ピップス、損失が出た取引の平均損益は-327ピップスで、良好な損益比となりました。 最大連勝数は3回に達し、最大連敗数は1回にとどまりました。 プロフィットファクター1.77は、利益が損失を安定的に上回っていることを示しています。
結論
PatchTSTは、最新の機械学習モデルを取引にどのように応用できるかを実証しています。 パッチ化手法により、アルゴリズムの実行速度が向上し、長期的な依存関係と局所的なパターンの両方を考慮できるようになります。 このシステムは、変化する市場状況に適応でき、MetaTrader 5に統合できるため、実用に適しています。
一方で、このモデルには限界もあります。 このモデルには、多くのリソースと高品質な過去データが必要です。 市場の急激な変動により、予測の精度が一時的に低下する可能性があります。 どのような戦略でも同様ですが、この戦略も「ブラックスワン」と呼ばれる事象の影響を免れることはできず、競争や規制の変更により、時間の経過とともに有効性を失う可能性があります。
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19292
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


MQL5でのあなたの実装は、特に環境の制約を考慮すれば、エンジニアとしての偉業と言えます。しかし、速度とスケーラビリティが目的であれば、PythonとMLフレームワークを活用することで、次のようなメリットが得られます:
より高速な学習
より精度の高いモデル
テストや可視化が容易
新記事「PatchTST に基づくニューラルネットワーク取引 EA」をぜひご覧ください。
著者:イェフゲニー・コシュテンコ