

取引におけるニューラルネットワーク:クロスドメイン時系列予測フレームワーク(最終回)
 12
 0

はじめに
過去数十年にわたり、金融取引は根本的な変化を遂げ、ハイテク化と高度な規律が求められる分野へと進化してきました。 かつてトレーダーの成功は、直感や経験、個人的な観察に大きく依存していました。しかし今日では、膨大な量のデータを迅速かつ効率的に処理し、精度の高い予測を生成するとともに、高度なアルゴリズムに基づいて意思決定をおこなう能力が重視されています。 計算能力の向上と最新の機械学習手法の登場により、トレーダーや研究者は、一見混沌としている市場データの中からパターンやトレンドを見いだすための新たなツールを手にするようになりました。 それでもなお、金融市場の時系列を短中期的に予測することは、依然として非常に困難な課題です。
その理由は、金融市場が持つ独特で複雑な性質にあります。 金融市場はノイズの多いシステムであり、真のシグナルが大量のランダムな変動やアーティファクトに埋もれてしまうことも少なくありません。 また、市場データは非定常的であり、その統計的性質は時間とともに変化します。これは、穏やかな局面からボラティリティの高い局面へ、あるいはその逆へといった、市場レジームの移行として現れます。 さらに、市場はニュースや危機、規制当局の介入など、通常の価格パターンを乱す突発的な出来事の影響も受けます。 こうした要因が重なることで、従来の時系列モデルは根本的な限界に直面しています。
古典的な統計手法は、定常過程の分析において有効性が実証されています。しかし、現代の市場データに適用する際には限界があります。 一方、LSTMやGRUをはじめとするニューラルネットワークは、複雑な時間的依存関係をモデル化するための、より柔軟な手法として広く利用されるようになりました。 ただし、これらのモデルも学習に大量のデータを必要とします。また、新たな金融資産や市場環境に適用すると、予測精度や安定性が低下することも少なくありません。 その背景には、多くのモデルが特定のデータ構造やパターンに依存しており、それらが必ずしも普遍的ではないという問題があります。
ここで重要となるのが、追加学習をおこなわずに汎化し、新たなデータにも適応できるモデルをどのように構築するかという課題です。これはゼロショット予測と呼ばれます。 さまざまな分野の多様な時系列データを用いて学習したモデルは、これまでに見たことのない新しいデータに対しても、類似するパターンや規則性を認識できる内部表現を備えている必要があります。 これにより、予測に対する考え方は根本的に変わります。モデルはもはや特定の市場に特化した専門家ではなく、異なるタスク間で知識を転移できる汎用的なアナリストとなるのです。
前回の記事で検討を始めたTimeFoundフレームワークは、まさにこの考え方に基づいて開発されました。TimeFoundは、Transformer(トランスフォーマー)アーキテクチャを基盤とする、強力で汎用性の高いクロスドメイン時系列モデルです。Transformerは、もともと自然言語処理のために提案された革新的な手法であり、系列内の長距離依存関係を効果的に捉える能力によって広く普及しました。 TimeFoundでは、この能力を金融時系列の分析に活用しています。さらに、重要な要素としてマルチ解像度パッチ化機構を組み込んでいます。
マルチ解像度パッチ化の基本的な考え方は、元の時系列を、異なる時間スケールを表す長さの異なるパッチ(区間)に分割することです。 たとえば、短いパッチは局所的かつ急速な変動を捉え、長いパッチはより緩やかで大局的なトレンドを捉えます。 この多層的なアプローチにより、モデルは異なる階層の情報を同時に考慮できるようになります。これは、さまざまな時間軸にわたってシグナルが現れる金融データにとって、特に重要です。
技術的な観点から見ると、TimeFoundのアーキテクチャは、独立した複数の射影モジュールで構成されています。それぞれのモジュールは、特定のスケールに属するパッチ群を担当します。 各モジュールは、残差接続を備えた小規模な2層パーセプトロンで構成されています。 入力としてパッチと、有効なデータ点を示すバイナリマスクを受け取るため、パディングによって追加された値や、人為的に補完された欠損値を効果的に無視できます。 独立した射影モジュールとパッチ反復の仕組みにより、モデルは各時間スケールの寄与を区別できます。その結果、位相のずれ、入力データ長の変動、欠損値に対する頑健性が得られます。
TimeFoundの学習には、マクロ経済指標や市場相場から物理現象に至るまで、幅広い分野の時系列データを集め、入念に整備した大規模なデータセットが使用されました。 これにより、モデルは汎化能力を獲得し、学習時には見ていなかった新たなデータに対しても良好な性能を発揮できるようになりました。
以下に、TimeFoundフレームワークを独自に可視化した図を示します。
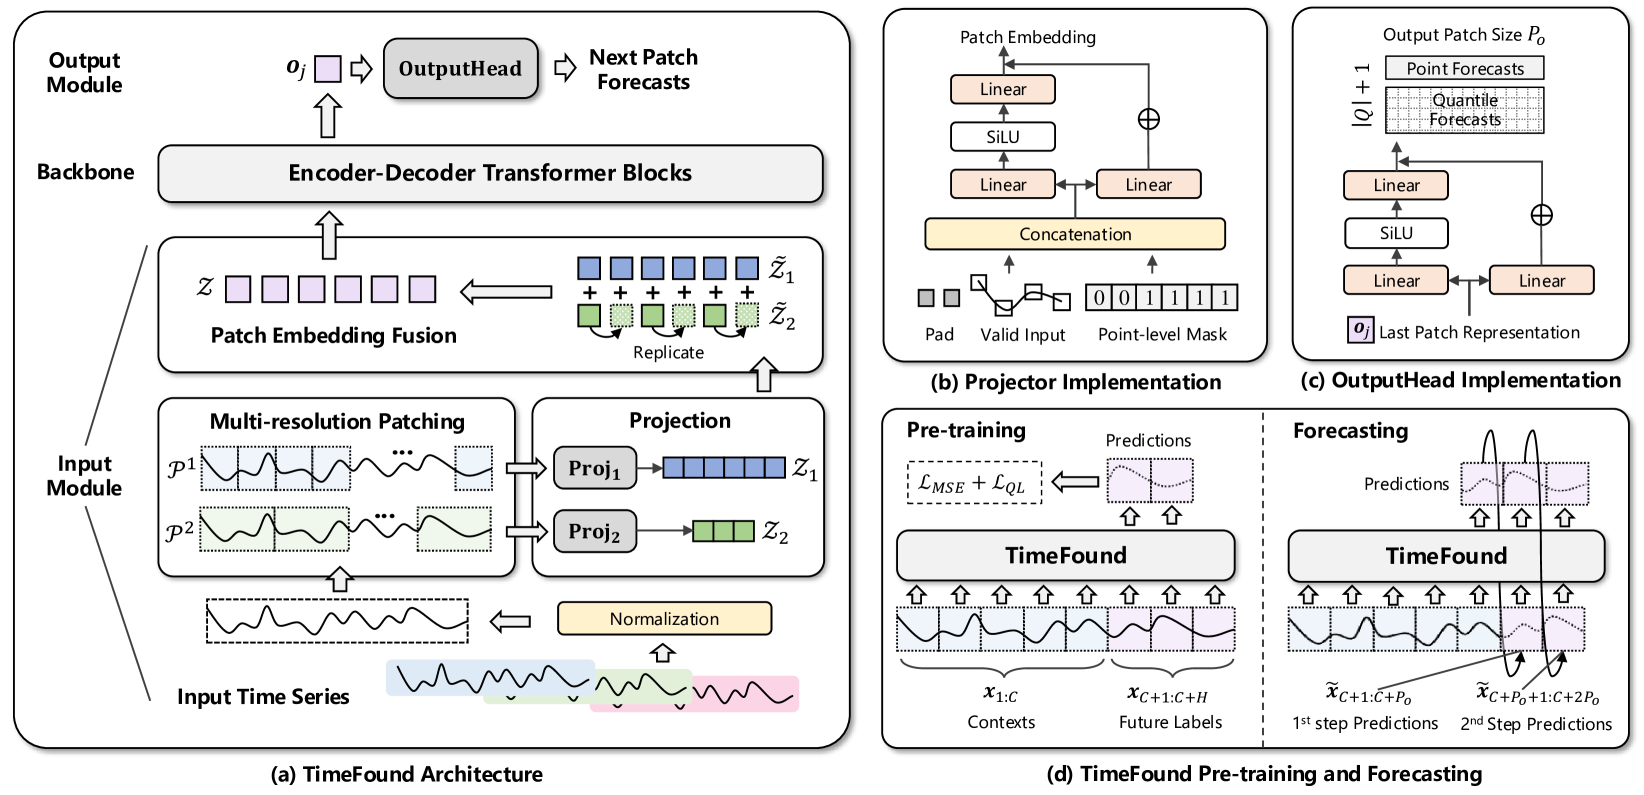
前回の記事の実践編では、TimeFoundフレームワークのデータ準備ブロックを構成する重要な要素である、マルチスケール・パッチ化モジュールの実装について詳しく解説しました。 このモジュールは、さまざまな長さとスケールのパッチに分割された時系列の各断片から、有益なトークンを効率的に生成する役割を担います。 まさにこの仕組みによって、モデルは市場の局所的な特性と大局的な特性の両方を考慮しながら、データを捉えて処理できるようになります。
今回は、前回から進めてきた作業を引き続き進めていきます。
TimeFound Encoder–Decoder
パッチ化段階で形成されたトークンテンソルは、さらなる分析のためにTransformerブロックへ渡されます。 ここから、データの高度な処理が始まります。具体的には、隠れたパターンの特定、動態の予測、シグナルの生成などがおこなわれます。
TimeFoundフレームワークの著者らは、アーキテクチャのこの部分に、機械翻訳や系列解析モデルで広く知られている古典的なEncoder–Decoderアーキテクチャを採用することを提案しています。 ただし、時系列データに適用するにあたり、データ固有の特性を考慮するため、いくつかの機能を追加して構成を改良しています。
Encoder(エンコーダ)では、Bidirectional Self-Attention(双方向自己注意)を使用します。 つまり、各トークンを、時間軸上で前方と後方の両方に位置する、他のすべてのトークンとの関係において分析します。 これにより、モデルは現時点までに起きたことだけでなく、それ以降に発生する事象との潜在的な依存関係も考慮できます。 この仕組みは、すでに完了した過去のデータ区間を分析する際に特に有効です。 このアプローチにより、より深い相互関係を特定できます。
一方、Decoder(デコーダ)では、可視性が意図的に制限されています。各トークンが参照できるのは、時間的にそれより前に位置するトークンだけです。 Decoderの主要な構成要素の一つがCross-Attention(クロスアテンション)モジュールです。 ここでは、Encoderから受け取ったデータをコンテキストとして利用し、Decoderが入力トークンとこのコンテキスト情報との関連性を分析します。 これにより、より精度の高い出力予測が可能になります。
EncoderとDecoderの役割分担に、Attention機構を組み合わせることで、TimeFoundアーキテクチャは高い柔軟性を実現しています。 直近の価格変動に反応するだけでなく、広範な過去の履歴を踏まえて資産の値動きを分析し、市場のパターンを考慮しながら、通常のノイズと意味のあるシグナルを区別することができます。
私たちのライブラリには、基本的なものから、マスキングやAttention Head(アテンションヘッド)の動的選択に対応した高度なものまで、Self-AttentionおよびCross-Attentionモジュールのさまざまな実装がすでに用意されています。 もちろん、TimeFoundモデルの実装にあたっても、これまでの成果を活用していきます。 ただし、ここで重要な概念上のポイントがあります。このフレームワークの著者は、予測値の生成に自己回帰型アプローチを採用することを提案しています。
このモデルは、対象期間全体の予測を一度に生成するわけではありません。 代わりに、反復的な処理をおこないます。 各反復ステップでは、Transformerが過去のデータを入力として受け取ります。このデータは、市場のパターンをさまざまな時間スケールで表現したトークンのテンソルです。そして、次の区間に対応する単一のトークンを生成します。 このトークンは、次区間に対する予測表現(予測状態)として解釈されます。 生成された結果を過去のデータに追加し、同じ処理を繰り返します。 このようにして、対象とする予測期間全体の予測を段階的に構築していきます。
今回の目的は、遠い将来まで予測することではありません。 占いのような予測をしているのではなく、体系的なポジション管理アルゴリズムを構築しようとしています。 モデルは新しいバーが追加されるたびに実行され、その時点ですでに判明している実データに基づいて状態を再計算し、ポジションを維持する、決済する、反転する、あるいはポジションサイズを増やすといった判断を出力します。 もちろん、実際に取引をおこなう際には、一定の予測期間を想定します。しかし、新しいバーが追加されるたびに、更新された現実に合わせて予測を修正します。
それでも、自己回帰という原理そのものが、アーキテクチャ上の要件をもたらします。 各ステップでは、同一の過去データをEncoderとDecoderの両方に入力する必要があります。 Encoderは、履歴全体を考慮しながらデータを分析し、全般的なパターンを特定します。一方、Decoderは、同じ過去の系列に含まれる現在の状態を利用し、Encoderによって抽出された過去の依存関係を踏まえて分析をおこない、予測値を生成します。 このようにして、同一のデータを対象に並行して処理をおこなう、2つの情報処理経路が形成されます。
この同期を確保するために、CNeuronTimeFoundTransformerUnitオブジェクトを作成します。 その役割は、情報の流れを一元的に管理することです。 これにより、クリーンなアーキテクチャを維持し、将来的な拡張やコンポーネントの置き換えも容易になります。 新しいオブジェクトの構造を以下に示します。
class CNeuronTimeFoundTransformerUnit  :  public CNeuronCrossDMHAttention
  {
protected:
   CNeuronMVMHAttentionMLKV   cSelfAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                                                              { return feedForward(NeuronOCL); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None)
                                        override
                                        { return calcInputGradients(NeuronOCL); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                                        { return updateInputWeights(NeuronOCL); }

public:
                     CNeuronTimeFoundTransformerUnit(void) {};
                    ~CNeuronTimeFoundTransformerUnit(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint window_key, uint heads, uint heads_kv, uint units_count,
                          uint layers, uint layers_to_one_kv, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const { return defNeuronTimeFoundTransformerUnit; }
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
  };
新しいクラスの構造を見ると、内部オブジェクトとして存在するのは、作成するモデルのEncoderとして機能するSelf-Attentionモジュールだけであることがわかります。 一方、Decoderの機能は、Cross-Attentionモジュールである親クラスによって実装されています。
しかし、この一見単純に見える構造の背後には、綿密に設計されたアルゴリズムが存在します。 Encoderの役割を担うのは、独立チャネル分析ブロックであるCNeuronMVMHAttentionMLKVです。 このブロックの最大の特徴は、各単変量系列、つまり各変数や指標を、それぞれ独立して分析できることです。 たとえば、価格、出来高、ボラティリティをモデルに入力した場合、CNeuronMVMHAttentionMLKVは、初期段階でそれぞれのシグナルを混合することなく、各時系列内の因果関係を確立します。 これにより、シグナル間のノイズを最小限に抑え、各データソースの構造をモデルがより深く理解できるようになります。その結果、得られる分析結果の解釈可能性も大幅に向上します。
さらに、Transformerの計算量を最適化するための、洗練された手法の一つであるMulti-Layer Key-Value (MLKV)機構を採用することで、効率性を高めています。 従来の実装では、各Self-Attention層がそれぞれ独自のKeyとValueを使用します。しかし、 この実装では、これらのテンソルを複数の層にわたって保持し、再利用する一方で、Queryは各層で段階的に精緻化されます。 このアプローチにより、計算負荷を軽減すると同時に、表現を段階的に洗練させることができます。これは、慣れ親しんだ文章を何度も読み返し、そのたびに新たな細部に気づく過程に似ています。 この特性は、取引において特に有用です。最初の処理では局所的なパターンを検出し、その後の処理を通じて、より一般的な市場構造を次第に認識できるようになります。
したがって、この実装におけるEncoderは、次の2つの役割を兼ね備えています。
- 一方では、従来型のBi-Directional Self-Attentionによって、時間軸上の前後両方向からトークン間の関係を特定します。
- 他方では、各単変量系列をモジュール単位で分析することで、その構造を多層的に理解できるようにします。
次に、Decoderについて見ていきましょう。 この部分では、多様化されたMulti-Head Cross-Attention(マルチヘッドクロスアテンション)を実装するCNeuronCrossDMHAttentionモジュールを使用します。 このモジュールにも、アーキテクチャ上の利点がいくつかあります。
まず、Decoderは、標準的なTransformerアーキテクチャに従い、2種類のAttentionモジュールを含みます。
- Self-Attention:主たるデータストリーム内のトークン間の関係を分析します。
- Cross-Attention:Encoderから得られたコンテキスト情報を用いて、これらのトークンに情報を付加します。
どちらの場合も、相対位置エンコーディングモジュールを使用します。 つまり、Attentionブロックは、トークンの絶対位置だけでなく、他のトークンに対する相対的な位置も考慮します。 さらに、このAttention機構には、次の3種類のバイアスが組み込まれています。
- コンテンツ依存型の位置バイアス
- グローバルコンテキストバイアス
- グローバル位置バイアス
これにより、イベント間の距離だけでなく、イベント同士の質的な関係も、より正確に考慮できるようになります。これは、時系列の市場データを分析するうえで極めて重要です。
Attentionモジュールの後には、マルチヘッドのFeedForwardブロックが続きます。 このブロックの役割は、さまざまな特徴部分空間において、それぞれ独立した非線形処理をおこなうことです。 これにより、系列の重要な構造要素を見失うことなく、幅広い市場パターンを検出できるようになります。
ここで、アーキテクチャを構成する各要素の重要な違いについても触れておきましょう。 Encoderとは異なり、Decoderでは単変量系列を分離しません。 Encoderでは各変数を個別に分析し、単変量系列の独立性を維持します。一方、Decoderでは、すべてのトークンが一つのストリームに統合されます。 この段階では、個々の単変量系列を区別する境界はなくなり、モデルはそれらを一つのまとまったデータとして認識します。
その結果、Decoderは異なる系列・特徴量間の依存関係を分析できるようになります。 つまり、個別に分析しただけでは明らかにならない、変数間の関係を捉えられるのです。 価格の動きは、価格自身の過去の推移だけでなく、ボラティリティ、出来高、あるいはニュースの流量といった要因によっても説明できる可能性があります。 こうした依存関係が明らかになるのが、まさにCross-Attentionブロックです。ここでは、現在の状態を表すトークンに、Encoderによって符号化された情報が付加されます。
このようにして、コンパクトで洗練されたEncoderモジュールCNeuronMVMHAttentionMLKVと、柔軟かつ適応性の高い、CNeuronCrossDMHAttentionをベースとするDecoderを組み合わせた、強力で解釈可能なアーキテクチャが実現します。 このモデルは拡張性に優れ、さまざまな種類の市場データに適用できると同時に、高い計算効率も維持します。
Encoderは静的に宣言されているため、クラスのコンストラクタとデストラクタは空のままにできます。 継承されたコンポーネントと新たに宣言されたコンポーネントは、Initメソッド内で一元的に初期化されます。 このメソッドのパラメータには、作成するオブジェクトのアーキテクチャを明確かつ一意に定義するための定数群が用意されています。
bool CNeuronTimeFoundTransformerUnit::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                                           uint window_key, uint heads, uint heads_kv, uint units_count,
                                           uint layers, uint layers_to_one_kv, uint variables,
                                           ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronCrossDMHAttention::Init(numOutputs, myIndex, open_cl, window, window_key, variables, window,
                                      units_count * variables, heads, layers, optimization_type, batch))
      return false;
   SetActivationFunction(None);
メソッド本体では、まず親クラスの同名メソッドを呼び出します。このメソッドには、継承されたオブジェクトやインターフェースを初期化するアルゴリズムがすでに実装されています。
ここで、親クラスのメソッドに渡す初期化パラメータについて、もう少し詳しく見ておきましょう。 まず、作成するオブジェクトとは異なり、親クラスのオブジェクトは2つの入力データストリームを必要とする点に注意する必要があります。すなわち、分析対象のデータとコンテキストです。 しかし、今回作成するオブジェクトでは、入力として受け取るストリームは1つだけです。 コンテキストは、モジュール内部のEncoderによって生成されます。
さらに、分析対象となる過去のデータウィンドウを表す、マルチモーダルなトークン系列が入力データとしてオブジェクトに渡されます。 各単変量系列は複数のトークンで表現され、各トークンは時系列の局所的な区間である1つのパッチに対応します。 これらのパッチによって、モデルは局所的な変化やパターンに焦点を当て、各変数内の短期的な依存関係を特定できます。
オブジェクトの出力には、各単変量系列につき1つのトークンだけが含まれることを想定しています。それぞれのトークンは、分析対象のマルチモーダル時系列における次の区間の予測を符号化したものです。 一方、Transformerアーキテクチャでは、主要な情報ストリームの次元を維持するように設計されています。
以上を踏まえ、Decoderのメイン経路には、環境状態の最後の区間を表すトークンだけを入力することにしました。つまり、各単変量系列につき1つのトークンです。 同時に、Encoder内で系列間の内部依存関係に関する情報が付加された、受け取ったデータ全体は、別の情報ストリームを通じて処理されます。
親クラスのメソッドが正常に実行されたら、次にEncoderの初期化をおこないます。 ここでは、分析対象となる系列の全長に関する情報を指定します。
   if(!cSelfAttention.Init(0, 0, OpenCL, window, window_key, heads, heads_kv, units_count, layers, layers_to_one_kv,
                           variables, optimization, iBatch))
      return false;
   cSelfAttention.SetActivationFunction(None);
//---
   return true;
  }
今回の実装では、EncoderとDecoderの両方に、多層構造を持つオブジェクトを使用している点に注意してください。 また、両モジュールのレイヤー数は同じにしています。
次に、オブジェクトの順伝播アルゴリズムを実装します。 このアルゴリズムは非常にシンプルです。Encoder、続いてDecoderの対応するメソッドを呼び出すだけです。 ただし、情報ストリームの扱いには、いくつか注意すべき点があります。 メソッドのパラメータとして、入力元のデータオブジェクトへのポインタを受け取ります。 このオブジェクトには、3次元テンソル[系列長 × 変数 × トークンサイズ]の形式でデータが格納されていることを想定しています。 このデータの並び順は、Encoderが必要とする形式と一致しているため、そのままオブジェクトへのポインタを渡します。
bool CNeuronTimeFoundTransformerUnit::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cSelfAttention.FeedForward(NeuronOCL))
      return false;
Decoderのメイン情報ストリームへの入力には、最新の環境状態を含む区間のトークンを使用することにしました。 ここで、分析対象のデータは時系列を逆順にしてモデルに入力されることを思い出してください。つまり、最も新しいデータが先頭に配置されています。 したがって、必要なトークンは入力元のデータバッファの先頭にあります。 この特性を利用すれば、必要なデータ部分をコピーする処理を省略できます。そこで、メイン情報ストリームには入力元のデータオブジェクトへのポインタをそのまま渡し、補助情報ストリームにはEncoderの出力を渡します。
   if(!CNeuronCrossDMHAttention::feedForward(NeuronOCL, cSelfAttention.getOutput()))
      return false;
//---
   return true;
  }
続いて、メソッドの最後に、各処理の実行結果を表すブール値を呼び出し元のプログラムに返して、メソッドを終了します。
逆伝播に関する各メソッドのアルゴリズムについては、ぜひご自身で確認してみてください。 CNeuronCrossDMHAttentionクラスと、そのすべてのメソッドの完全なソースコードは、添付ファイルに記載されています。
モデルアーキテクチャ
モデルを構成するすべての必要なオブジェクトを作成したら、次の段階である整合的なアーキテクチャの構築へと進みます。 ここで重要なのは、これまでの開発と同様に、強化学習の枠組みで動作する取引エージェントを構築しているという点です。
今回の課題において、TimeFoundフレームワークは、環境状態の分析、すなわち市場データの前処理と、過去の時系列データに潜むパターンの特定のみを担います。 この役割を果たすコンポーネントをEnvironment Encoder(環境エンコーダ)のアーキテクチャに組み込むことで、モデルの他の部分に対し、整理・ノイズ除去された、解釈可能な現在の市場状況の表現を提供します。
取引エージェント全体では、Actor–Director–Critic構造を採用し、各コンポーネントに明確に定義された役割を割り当てます。 現在の実装では、次の4つの独立したモデルが連携して動作します。
- Environment State Encoder(環境状態エンコーダ):入力された市場データを詳細に分析します。 分析対象の時系列から安定したパターンを抽出し、現在の取引状況を豊かに表現する情報を生成します。 この表現は、次にActorに渡されます。
- Actor:エージェントの中心的な構成要素です。 Encoderから受け取った入力データに基づいて、具体的な取引判断を生成します。
- DirectorとCritic:これらは評価を担当するサブシステムです。 内部的な未来予測モデルを用いてActorの判断を評価し、起こり得る結果を予測します。 さらに、Directorは、より厳格な二値評価、すなわち「その行動をそもそも検討する価値があるかどうか」を判定します。一方、Criticは、期待報酬を定量的な指標として算出します。 両者が連携することで、エージェントの学習と変化する市場環境への適応に必要なフィードバック信号が生成されます。
このアプローチにより、システムのモジュール性と柔軟性が確保されます。各コンポーネントを独立して改良したり、特定の種類の取引戦略に合わせて適応させたりすることができます。
各モデルのアーキテクチャは、CreateDescriptionsメソッドで定義します。このメソッドは、4つの動的配列へのポインタをパラメータとして受け取ります。 各配列はそれぞれ1つのモデルに対応し、作成するモデルの構造全体を表現する、固有のオブジェクト列を格納します。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
まずはEncoderから始めましょう。 時系列の履歴を含むテンソルをモデルに入力し、そのデータを十分な次元数を持つ全結合層に直接渡すことを想定しています。 この層は、モデルにおける一種のゲートとして機能します。 この層のニューロン数は、過去のバーの本数と、各バーに含まれる特徴量の数との積に設定します。これにより、価格変動、出来高、その他の指標に関する情報をすべて保持できるようになります。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   int prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次にBatchNormWithNoise層を配置します。 この層は、学習プロセスを安定させるとともに、わずかな確率的要素を導入するように設計されています。これにより、最適化の過程でモデルが局所最適解に陥ることを防ぎやすくなります。 ここで、ノイズの制御を導入します。正規化処理の過程でランダムな変動を加えることで、ノイズが多く含まれる実際の市場データに対しても、モデルの汎化性能を高めます。
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
データの正規化が完了したら、ConcatDiffモジュールを使用して、データの変動に関する情報を追加しましょう。 この層は、時間軸に沿って1階差分を計算し、その結果を新たなチャネルとして元のデータに追加します。これにより、各指標の変化率をモデルがより適切に捉えられるようになります。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次にMamba4CastEmbeddingを配置します。ここでは、過去の各バーに時間情報を符号化します。 時間周期として、1時間周期と1日周期の2種類の周期性に対応する高調波を指定します。これにより、モデルは日次のパターンや日中の細かな変動を捉えられるようになります。 その後、各バーの埋め込み表現を統合し、全体を表す一つの表現を生成します。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   int prev_out = descr.window_out = NSkills;
     {
      int temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
埋め込み表現の生成が完了したら、次にTimeFoundPatchingへ進みます。 このモジュールは、生成されたテンソルをあらかじめ指定した数の等しいサイズの区間(パッチ)に分割し、それらを1つの行列にまとめます。 各パッチには局所的な値動きに関する情報が含まれており、これらをまとめてTransformerブロックへの入力とします。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeFoundPatching;
   descr.count = prev_count;
   prev_count=descr.window = Segments;
   descr.variables = prev_out;
   descr.window_out = EmbeddingSize;
   descr.step = 8;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
そしてここで、中核となる層、TimeFoundTransformerUnitが登場します。 このオブジェクトにより、モデルは各単変量系列を個別に分析すると同時に、異なるドメイン間の依存関係を検出できます。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeFoundTransformerUnit;
   descr.count = prev_count;
   descr.window = EmbeddingSize;
   descr.window_out =descr.window/4;
   {
      int temp[]={4,2};
      if(ArrayCopy(descr.heads,temp)<ArraySize(temp))
        return false;
   }
   descr.layers=3;
   descr.step=3;
   descr.variables=prev_out;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Transformerの出力として、分析対象の各チャネルについて、次のパッチを予測するトークンを取得します。 前処理の段階で、チャネル数が大幅に増加したことを思い出してください。 現在は、各チャネルに対して1つずつ新しいトークンが生成され、次の時間区間におけるそのチャネルの挙動予測を表します。
このコンパクトなスライスを、指定した予測期間全体をカバーする予測系列に展開するために、畳み込み層を使用します。 この層は、予測トークンの集合を受け取り、複数のフィルターを通して処理することで、必要な長さの要素列に変換します。こうして得られた系列は、自動売買ロボットでさらに利用できる状態になります。 このアプローチにより、トークン単位の自己回帰型予測の利点を維持しながら、取引戦略で利用できる完全な時系列を生成できます。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.step = EmbeddingSize;
   prev_count=descr.layers = prev_out;
   descr.window = EmbeddingSize;
   prev_out=descr.window_out = NForecast;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
畳み込み層の出力として、指定した長さの単変量系列の集合が得られます。 それぞれの系列は、対応するチャネルの予測を表しています。 しかし、実際のデータと比較する際に必要なのは、個別の時系列の集合ではなく、隣接する要素が同じ時点における異なる情報源に対応する、単一の多変量系列です。 そのため、次のステップでは出力結果を転置します。 これにより、次元が[計画期間×チャネル数]の行列が得られます。
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.window=prev_out;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、得られた行列にもう1つの畳み込み層を適用します。この層の目的は、チャネル数を元の次元数に戻すことです。
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_out;
   descr.window = prev_count;
   descr.step = prev_count;
   descr.layers = 1;
   prev_out=descr.window_out = BarDescr;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count=descr.count;
最後に、予測値を実際の値に変換するため、非正規化層に通します。 この層は、得られた各多変量系列に対して、入力時と同じチャネルの元の統計パラメータ、すなわち平均と分散を復元します。 これにより、標準化されたトークンを、元の使い慣れた測定単位の値に戻すことができます。
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
したがって、Encoderの出力は、多変量系列全体に対する予測値の集合となります。これらの値は、トレーダーにとって馴染みのある測定単位、すなわち価格、出来高、各種指標の単位で表されます。 このデータは、可視化したり、実際の相場データと比較したり、エージェントの行動を解釈するために利用したりできます。
さらに、ラベルの付いていない大量の過去データを用いて将来の値動きを予測することで、自己教師あり学習モードでEncoderを学習させることも可能になります。 これにより、予測トークンから情報量の豊富な潜在表現を生成できるようになります。 私たちは、これらの表現をActor、Director、Criticに渡すことを計画しています。これによって、モデルの安定性、適応性、汎化能力を確保します。
CLayerDescription *latent = encoder. At(LatentLayer);
次に、Actorのアーキテクチャの定義に進みます。 先に述べたように、このモデルは市場環境を踏まえて口座の現在の状態を分析し、取引判断を下します。 モデルの主要なデータ経路には、残高、エクイティ、保有中のポジションを表す口座情報のテンソルを入力する予定です。
入力データの取得と前処理には、全結合層とバッチ正規化層を組み合わせて使用します。 ただし、Encoderとは異なり、ここではノイズを追加しません。金融資産の状態に人為的な変動を加えるわけにはいかないためです。 まず、口座状態を表すテンソルを十分な次元数を持つ全結合層に通し、その後、正規化をおこないます。これにより、安定した決定論的な表現が得られます。
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- Layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
前処理済みのデータは、多様化されたMulti-Head Cross-Attentionモジュールによって市場情報のコンテキストが付加されます。これにより、口座の状態と市場全体のパターンとの関係を考慮できるようになり、より適切な取引戦略を選択できるようになります。
//--- Layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      int temp[] = {AccountDescr,    // Input window
                    latent.window    // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      int temp[] = {1,                 // Input units
                    latent.variables    // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 3;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
最終的な判断をおこなうために、3層のMLPを使用します。各層の間には異なる活性化関数を適用し、必要な非線形性を導入します。 第1層では双曲線正接関数(tanh)を適用し、信号の影響を正方向と負方向に分けて表現できるようにします。 第2層の後にはSoftPlusを適用し、正の応答を強調するとともに、小さな値を滑らかに変化させます。 最後に、出力層をシグモイド関数で制御します。これにより、Actorの行動空間が正規化され、出力値が[0, 1]の範囲に制限されます。そのため、取引パラメータのスケーリングに適した出力が得られます。
//--- Layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- Layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- Layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
DirectorとCriticのモデルも、基本的には同様のアーキテクチャを採用しています。ただし、口座状態を表すテンソルがActorの行動ベクトルに置き換えられ、出力層のサイズが変更されています。 そのため、本記事ではこれらのモデルの詳細な説明は省略し、独自に学習していただくことにします。 すべてのモデルの完全なアーキテクチャは、添付ファイルに記載されています。
Environment Encoderの学習プログラム
ここからは、モデルの学習について説明します。 このプロセスは3つの段階に分けられています。 まず、Environment State Encoderの学習を独立した段階として切り分けました。 利用可能なデータを可能な限り多く活用して学習をおこなうため、明示的な学習データセットは作成せず、必要なデータをすべて取引ターミナルからリアルタイムで直接取得する方式を採用しています。
この学習段階は、エキスパートアドバイザー(EA)「…\Experts\TimeFound\StudyEncoder.mq5」に実装されています。 ここでは、CreateBuffersメソッドがバッファの管理を担当します。パラメータには、開始状態のインデックスと2つのバッファへのポインタが含まれます。1つは分析対象の入力データ用、もう1つは値動きの予測における目標値用です。 この方法により、過去の時系列データにラベルを付与するための追加コストをかけることなく、自己教師あり学習によってEncoderの学習を実施できます。
bool CreateBuffers(const int start_bar, CBufferFloat* state, CBufferFloat *time, CBufferFloat* forecast)
  {
   if(!state || !time || start_bar < 0 ||
      (start_bar + HistoryBars + NForecast) >= int(Rates.Size()))
      return false;
//---
   vector<float> vState = vector<float>::Zeros(HistoryBars * BarDescr);
   vector<float> vForecast = vector<float>::Zeros(NForecast * BarDescr);
   time.Clear();
   time.Reserve(HistoryBars);
メソッド本体では、事前に読み込んだデータに十分な情報が含まれているかを確認し、値を格納するための内部バッファを準備します。 次に、データを準備するためのループを設定します。 取引ターミナルから事前に読み込んだ元の時系列データは、時系列の順序を維持したまま、最新のデータポイントが先頭に、古いデータポイントが末尾に配置されています。 Encoderのパラメータを調整するには、各学習ステップで、過去のデータウィンドウと指定された予測期間の両方を含む、完全な時間区間を取得する必要があります。
まず、分析対象の状態を表すベクトルを構築します。パラメータで指定されたインデックスから予測期間分だけ過去にさかのぼり、その位置以降のすべての要素を入力データ用バッファにコピーします。 この一連の処理では、時系列の時間的な順序が維持されるため、データ準備に伴うオーバーヘッドを最小限に抑え、モデルがリアルタイムで効率的に動作できるようにします。
int bar = start_bar + NForecast;
for(int b = 0; b < (int)HistoryBars; b++)
  {
   float open = (float)Rates[b + bar].open;
   float rsi = (float)RSI.Main(b + bar);
   float cci = (float)CCI.Main(b + bar);
   float atr = (float)ATR.Main(b + bar);
   float macd = (float)MACD.Main(b + bar);
   float sign = (float)MACD.Signal(b + bar);
   if(rsi == EMPTY_VALUE || cci == EMPTY_VALUE || atr == EMPTY_VALUE ||
      macd == EMPTY_VALUE || sign == EMPTY_VALUE)
      return false;
   //---
   int shift = b * BarDescr;
   vState[shift] = (float)(Rates[b + bar].close - open);
   vState[shift + 1] = (float)(Rates[b + bar].high - open);
   vState[shift + 2] = (float)(Rates[b + bar].low - open);
   vState[shift + 3] = (float)(Rates[b + bar].tick_volume / 1000.0f);
   vState[shift + 4] = rsi;
   vState[shift + 5] = cci;
   vState[shift + 6] = atr;
   vState[shift + 7] = macd;
   vState[shift + 8] = sign;
   if(!time.Add(float(Rates[b + bar].time)))
      return false;
  }
次に、目標値の準備に進みます。 これらは将来の予測値であるため、値の並び順を反転させて、目標値用バッファに正しく格納する必要があります。 そのため、データを転送する際に逆方向のインデックス指定を使用します。予測期間内の最後の要素をバッファの先頭に配置し、残りの要素も順番に格納していきます。 この手法により、各学習ステップで、現在の入力データと対応する将来の目標値が正しく対応付けられるようになります。
bar--;
for(int b = 0; b < (int)NForecast; b++)
  {
   float open = (float)Rates[bar - b].open;
   float rsi = (float)RSI.Main(bar - b);
   float cci = (float)CCI.Main(bar - b);
   float atr = (float)ATR.Main(bar - b);
   float macd = (float)MACD.Main(bar - b);
   float sign = (float)MACD.Signal(bar - b);
   if(rsi == EMPTY_VALUE || cci == EMPTY_VALUE || atr == EMPTY_VALUE ||
      macd == EMPTY_VALUE || sign == EMPTY_VALUE)
      return false;
   //---
   int shift = (NForecast - b - 1) * BarDescr;
   vForecast[shift] = (float)(Rates[bar - b].close - open);
   vForecast[shift + 1] = (float)(Rates[bar - b].high - open);
   vForecast[shift + 2] = (float)(Rates[bar - b].low - open);
   vForecast[shift + 3] = (float)(Rates[bar - b].tick_volume / 1000.0f);
   vForecast[shift + 4] = rsi;
   vForecast[shift + 5] = cci;
   vForecast[shift + 6] = atr;
   vForecast[shift + 7] = macd;
   vForecast[shift + 8] = sign;
  }
準備した時系列データをデータバッファに格納し、各処理の実行結果を表すブール値を呼び出し元のプログラムに返して、メソッドを終了します。
   if(!state.AssignArray(vState))
      return false;
   if(!forecast.AssignArray(vForecast))
      return false;
   if(time.GetIndex() >= 0)
      if(!time.BufferWrite())
         return false;
//---
   return true;
  }
学習プロセス自体は、Trainメソッドで構成されています。 このメソッドでは、まず、ユーザーが指定した学習期間の開始日と終了日に基づいて、学習データセット用バッファのサイズを決定します。
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
これらの期間の境界に基づいてバーの本数を計算し、データバッファに必要なメモリを確保します。
if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
   !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   ExpertRemove();
   return;
  }
次に、指定された銘柄と時間足の過去データを、取引ターミナルから動的に読み込みます。
   int count = -1;
   bool load = false;
   do
     {
      RSI.Refresh();
      CCI.Refresh();
      ATR.Refresh();
      MACD.Refresh();
      count++;
      load = (RSI.BarsCalculated() >= bars &&
              CCI.BarsCalculated() >= bars &&
              ATR.BarsCalculated() >= bars &&
              MACD.BarsCalculated() >= bars
             );
      Sleep(100);
      count++;
     }
   while(!load && count < 100);
   if(!load)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
学習データの準備が完了したら、学習プロセスそのものに進み、入れ子構造のループを用いて処理を実行します。 外側のループは、学習の反復回数を管理します。 反復の総回数は、プログラムのパラメータを通じてユーザーが指定します。
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter ++)
     {
      int posit = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * bars);
      if(!CreateBuffers(posit + end, GetPointer(bState), GetPointer(bTime), Result))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
外側の学習ループ内では、学習データセットから1つの状態のインデックスをサンプリングし、入力データと目標データを構成する際の基準として使用します。 このインデックスと対応するバッファへのポインタをCreateBuffersメソッドに渡すことで、各反復において、過去の系列と予測対象の系列が正しく対応付けられ、効果的な自己教師あり学習が可能になります。
次に、内側のループを設定します。このループの反復回数は、ユーザーがRepeatsパラメータで指定します。 ここでは、特に注意が必要です。このループ内では、同じ入力データと目標データを繰り返し使ってモデルを学習させます。 Encoderに組み込まれた、ノイズを付加する正規化層が、必要なデータ拡張の役割を果たします。これにより、モデルは個々の値そのものではなく、データの内部構造に注目して学習できるようになります。 ただし、反復回数が多すぎると、目標値が変わらないまま学習が繰り返されるため、モデルが入力データを無視し、毎回同じ結果を出力するようになるリスクがあります。 そのため、Repeatsパラメータは5回程度に設定することを推奨します。
for(int r = 0; r < Repeats; r++)
  {
   //--- Feed Forward
   if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   //--- Study
   if(!cEncoder.backProp(Result, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
ループ本体では、モデルの順伝播と逆伝播を実行します。 その後、学習の進捗状況をユーザーに通知し、ループ構造の次の反復へと進みます。
    if(GetTickCount() - ticks > 500)
      {
       double percent = double(iter) * 100.0 / (Iterations);
       string str = StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Encoder",
                                   percent, cEncoder.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
すべての反復が完了したら、学習結果をログに出力し、プログラムを終了します。
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Encoder", cEncoder.getRecentAverageError());
   ExpertRemove();
//---
  }
Actor、Director、Criticのオフライン学習およびオンラインのファインチューニング用プログラムは、以前のプロジェクトから一切変更せず、そのまま引き継ぎました。 さらに、学習データセットの構築や、学習済みモデルのテストには、実績のある手法を採用しました。これにより、補助的なコンポーネントの再設計にリソースを費やすことなく、アーキテクチャの革新に集中できました。
本記事の作成に使用したプログラムのソースコードは、すべて添付ファイルに含まれています。
テスト
先に述べたように、モデルの学習プロセスは3つの段階に分けて順番に実施しました。これにより、システム全体を論理的かつ段階的に構築し、高い信頼性を確保することができました。
最初の段階では、1分足のEURUSDペアの過去5年分のデータを使用してEncoderを学習させました。 このデータ量と詳細度により、現在の市場状態を深く捉えた、情報量の豊富な潜在表現を生成できます。 Encoderは、重要なパターンを識別し、規則性を見いだし、市場状況をコンパクトでありながら情報量の豊富なベクトルとして符号化することを学習します。このベクトルは、その後、他のすべてのモジュールで使用されます。
続く第2段階では、アーキテクチャの主要な動作コンポーネントであるActor、Director、Criticのオフライン学習を実施します。 このために、Encoderの学習時に使用したすべてのパラメータを変更せずに維持したまま、2024年の市場データを用いてデータセットを作成しました。 学習プロセスでは、「ほぼ完全な軌跡」という考え方を採用しました。つまり、エージェントの行動を任意に選択するのではなく、その後の値動きを分析したうえで決定しました。 言い換えれば、価格の推移全体を利用できるため、どのような行動が最良の結果につながったかを事前に把握し、その行動を学習に使用したのです。 このアプローチにより、エージェントを地図も持たずに環境内をさまよわせ、試行錯誤を通じて有効な戦略を探させるのではなく、取引の方法そのものをモデルに学習させることができます。 その結果、エージェントは、過去に検証された事例、すなわち結果の面で理想に近い、明確で根拠のある事例から学習します。 これにより、学習プロセスが簡素化されるだけでなく、目的が明確になり、経済的な合理性も高まります。
最終段階は、ストラテジーテスター上で直接実施するオンラインのファインチューニングです。 ここでは、実際の取引にできるだけ近い条件でモデルに過去の市場データを与え、市場の動的な変化に合わせてパラメータを適応させます。 これは特に重要な段階です。学習データセットには現れない市場環境の変化や市場ノイズ、ランダムな変動を考慮しながら、エージェントの行動を改善できるためです。
一連の学習プロセスがすべて完了した後、2025年1月の新しい価格データを使用してモデルをテストしました。 評価の客観性と公平性を確保するため、学習時に使用したパラメータと設定は一切変更せず、そのまま維持しました。 テストの結果を以下に示します。
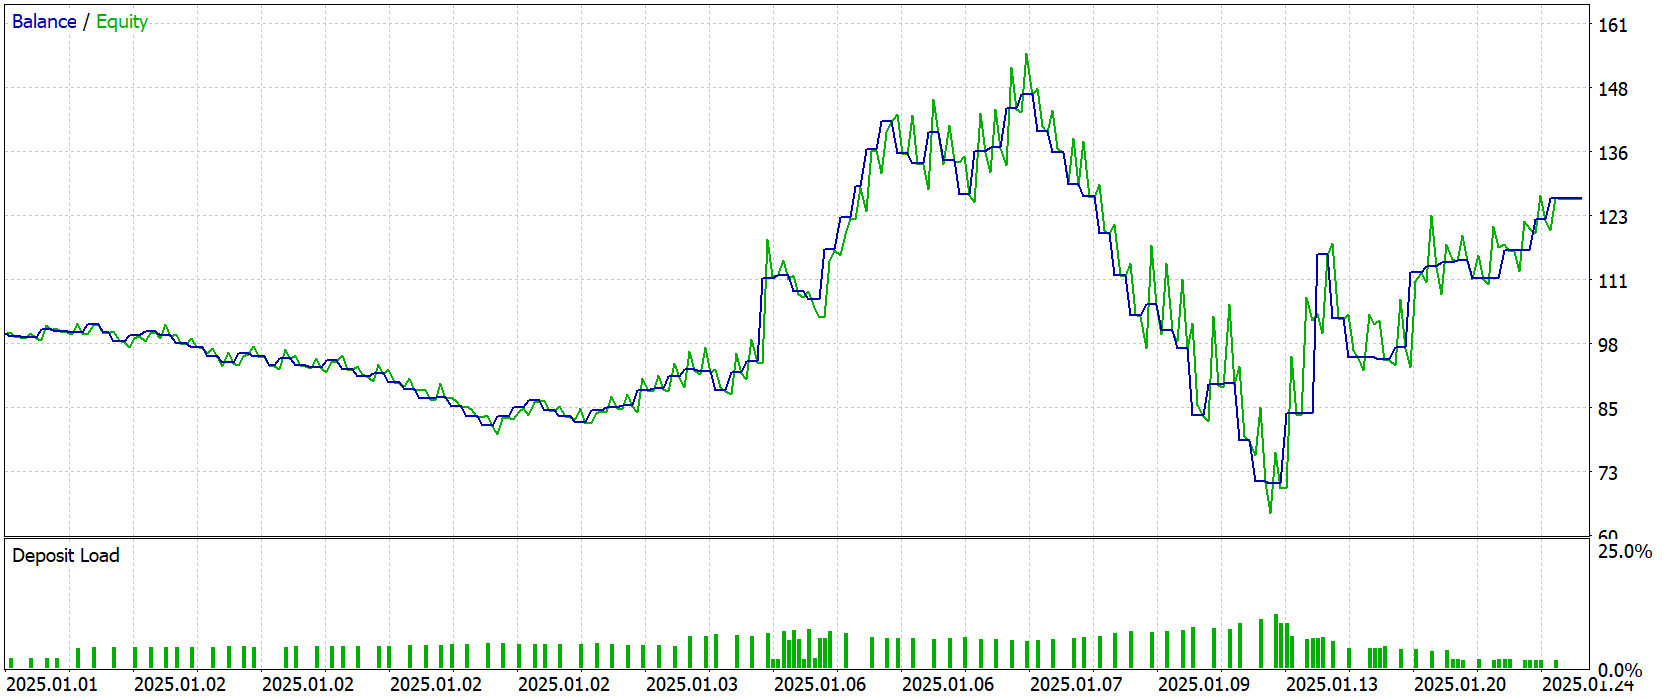
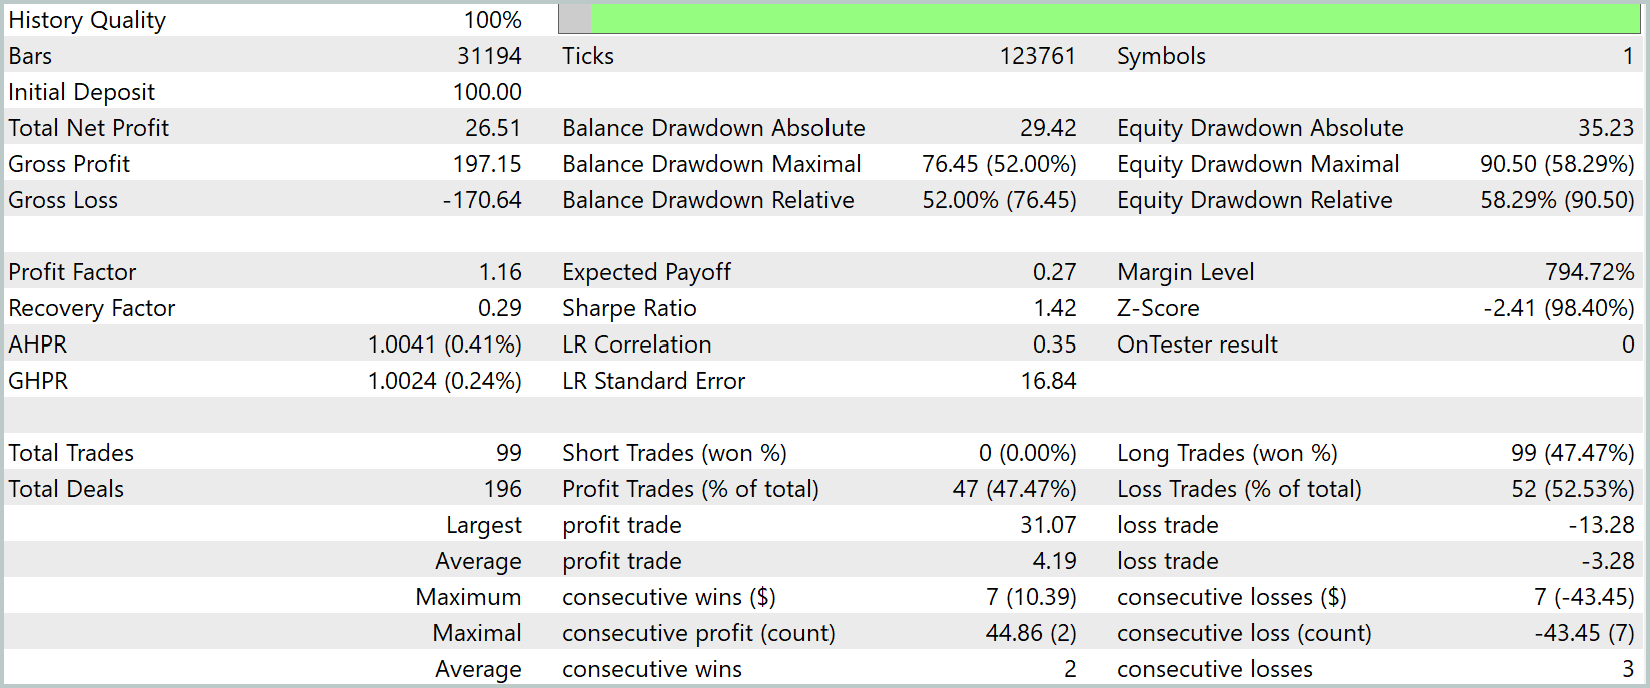
テスト結果は期待の持てるものですが、いくつかの注意点もあります。 月間の総リターンは+26.5%でしたが、残高の推移を見ると、持続的な上昇傾向は確認できません。 むしろ、大半の期間では横ばいの動きが続き、不安定な局面や大幅なドローダウンが発生しています。 最大ドローダウンは58%に達しており、ボラティリティが高く、特定の市場状況では判断が不安定であることを示しています。
この結果から、モデルはまだ一貫した取引スタイルを確立している段階にはなく、明確で収益性の高い取引パターンを形成する途上にあると考えられます。 それでも、プラスの結果が得られたこと自体は期待の持てる兆候です。基盤はすでに構築されており、今後の課題は安定性を高めることです。
結論
本研究では、汎用的なクロスドメイン時系列予測という概念から出発し、MetaTrader 5環境での実用化に取り組みました。 Encoderの構造を詳しく検討し、マルチスケール・パッチ化の仕組みを理解したうえで、得られた潜在表現をActor–Director–Criticアーキテクチャに統合しました。 データの前処理から、Encoderの自己教師あり学習、さらに主要モジュールのオフライン学習とオンラインのファインチューニングに至るまで、各段階を通じて、最先端の研究成果と実践的なエンジニアリング手法を適切に組み合わせることで、市場動向の分析精度を向上させられることを示しました。
2025年1月の市場価格データを用いたテストでは、システムが利益を生み出せることが確認されましたが、一方で大幅なドローダウンも発生しました。 この結果は、リスク管理と損失を制限する適応的な仕組みを、さらに改善する必要性を示しています。 その一方で、追加のパラメータ最適化をおこなわずにプラスのリターンを達成できたという事実は、採用したアーキテクチャが堅牢な基盤を備えており、すでに獲得した知識を再利用して予測をおこなえることを示しています。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Research.mq5 | EA | サンプル収集用EA |
| 2 | ResearchRealORL.mq5 | EA | サンプル収集用EA(Real-ORL手法) |
| 3 | StudyEncoder.mq5 | EA | 環境エンコーダの学習用EA |
| 4 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 5 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 6 | Test.mq5 | EA | モデルテスト用EA |
| 7 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 8 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 9 | NeuroNet.cl | ライブラリ | OpenCLプログラムコードのライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18447
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:インテリジェントな予測パイプライン(Time-MoE)
 取引におけるニューラルネットワーク:クロスドメイン時系列予測フレームワーク「TimeFound」
 初級から中級まで:オブジェクトイベント(II)
 取引におけるニューラルネットワーク:高精度分類のための効果的な特徴抽出(オブジェクトの実装)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索