

Redes neuronales en el trading: Entrenamiento de metaparámetros basado en la heterogeneidad (Final)
 16
 0

Introducción
El trading algorítmico rara vez perdona la complejidad excesiva ni la excesiva simplicidad de las soluciones cuando no está justificada. Cualquier modelo, ya sea un ensamble neuronal de gran complejidad o un filtro autorregresivo minimalista, debe, en última instancia, superar la prueba del tiempo y del mercado. Precisamente desde esta perspectiva se concibió HimNet, un framework que no pretende impresionar por la cantidad de parámetros entrenables ni por lo exótico de sus cálculos. Por el contrario, se centra en ofrecer un resultado estable, reproducible y económicamente justificado.
Desde sus primeros pasos, HimNet manifiesta tres cualidades que lo distinguen favorablemente de muchos otros enfoques. En primer lugar, está la racionalidad de la arquitectura: no contiene capas sobrecargadas que solo crean la ilusión de profundidad en el análisis. Aquí, cada módulo es funcional y está justificado. En segundo lugar, se trata de una adaptabilidad moderada: en lugar de ajustarse sin pensar al ruido de cada fluctuación del mercado, el framework establece un equilibrio entre flexibilidad y estabilidad. Y, en tercer lugar, el minimalismo en la gestión de parámetros. HimNet está diseñado de tal forma que el número de coeficientes entrenables se reduce al mínimo necesario. Esto permite evitar el sobreajuste a los datos históricos y mantener la capacidad predictiva incluso en tramos alejados de las series temporales.
En artículos anteriores hemos ido revelando paso a paso la mecánica interna de este framework. Partiendo de los fundamentos teóricos, hemos estudiado en detalle los métodos de formación de embeddings y hemos analizado cómo los elementos recurrentes y convolucionales se complementan entre sí. La arquitectura de HimNet es como un mecanismo bien engranado, en el que cada engranaje —ya sea el bloque de polinomios de Chebyshev o el mecanismo GCRU— desempeña una función concreta. No se trata de una acumulación de tecnologías, sino de una construcción cuidadosamente calculada que permite obtener una representación informativa del mercado sin pérdida de velocidad de procesamiento ni una complicación excesiva de la cadena de cálculo.
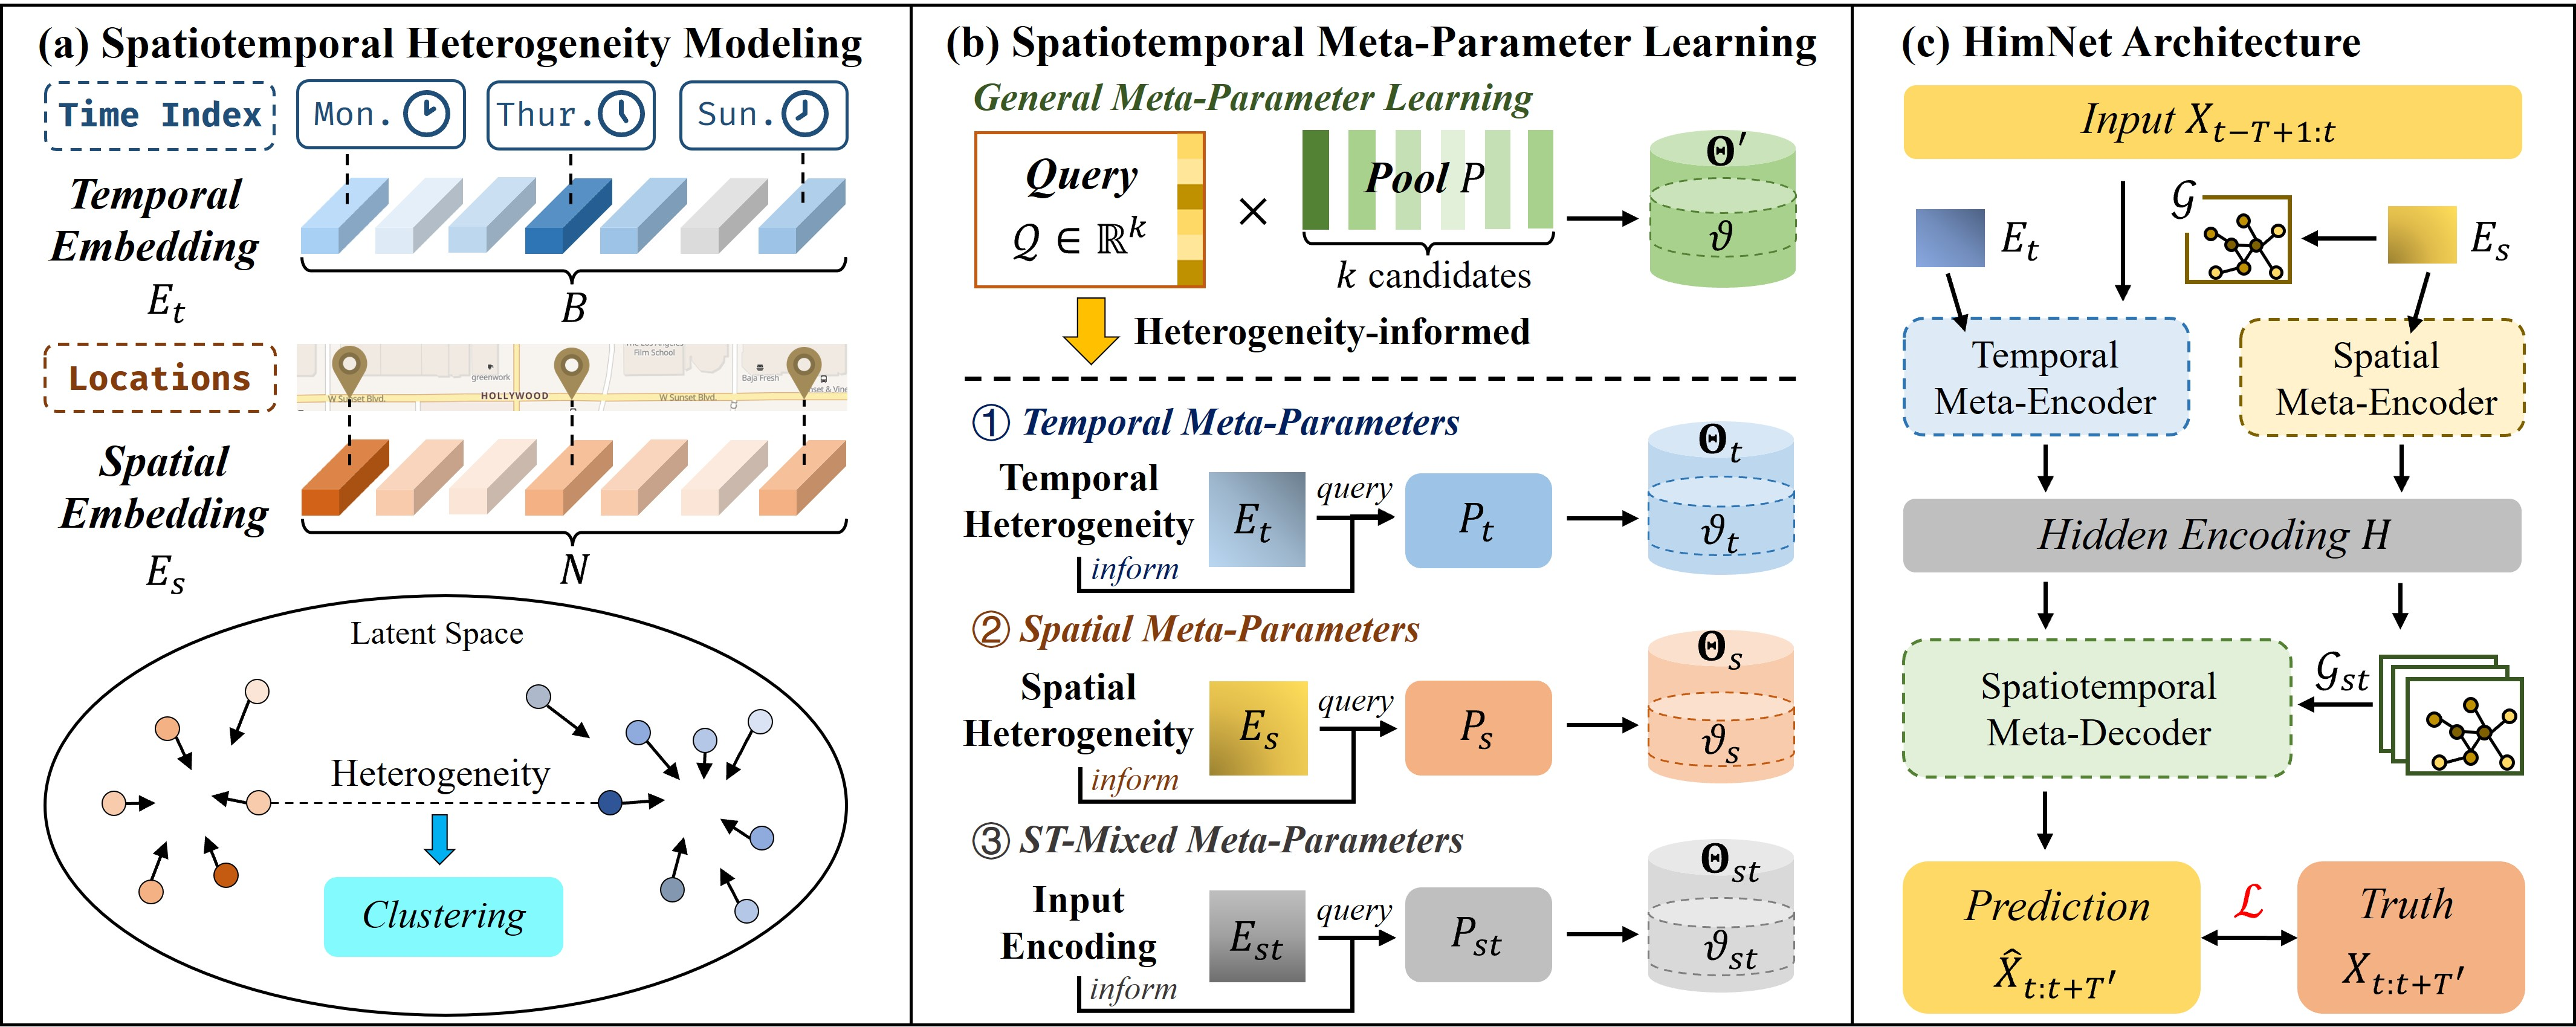
El framework HimNet se basa en la arquitectura clásica y, en gran medida, probada por el tiempo de tipo codificador-decodificador. Este esquema ha demostrado su eficacia en tareas de procesamiento de secuencias complejas, en las que no solo es importante registrar el estado actual del mercado, sino también extraer de él patrones estables para realizar pronósticos posteriores. El codificador y el decodificador se basan en una misma base: ambos utilizan embeddings entrenables y bloques recurrentes de grafos (GCRU). Sin embargo, existe una diferencia sutil, pero importante, entre ambos: la propia forma en que se crean los embeddings.
En el codificador, los embeddings temporales y espaciales se extraen directamente de diccionarios preparados previamente, y se aplican como una especie de consultas a pools de metaparámetros. Esto permite que el codificador se adapte al contexto.
El decodificador, por el contrario, genera los embeddings de forma indirecta: a partir de una representación latente combinada a partir de los resultados del codificador. Proyecta una representación oculta en un embedding espaciotemporal, que se convierte en una consulta al modelo ST de metaparámetros, lo que permite al decodificador generar pesos.
Ya hemos realizado un trabajo preparatorio considerable: hemos implementado los componentes fundamentales del modelo, incluidos los bloques recurrentes de grafos, capaces de tener en cuenta de forma eficaz las dependencias espaciotemporales de los datos. Ahora ha llegado el momento de pasar al siguiente nivel de la jerarquía: la construcción de una estructura completa para el codificador y el decodificador. Esta etapa servirá de nexo entre los distintos elementos del framework y su aplicación práctica. Es precisamente aquí donde los bloques abstractos establecen vínculos entre sí y el flujo de datos comienza a formar una representación coherente de los futuros estados del mercado.
Codificador
Los autores del framework HimNet han previsto un mecanismo de procesamiento de datos de doble flujo, en el que cada tipo de dependencia (espacial y temporal) cuenta con un codificador independiente. Este enfoque permite no mezclar entre sí las diferentes estructuras de las señales, sino analizarlas en ramas paralelas, lo que proporciona una identificación más precisa y limpia de las regularidades clave. Siguiendo las ideas propuestas, hoy comenzaremos a trabajar en la construcción del codificador de dependencias temporales. Y es que el tiempo es precisamente el hilo conductor sobre el que se construye cualquier dinámica de mercado.
Codificador temporal
El objeto CNeuronHimNetTempEncoder es una especie de filtro temporal del framework, diseñado para extraer las regularidades ocultas en las secuencias de cotizaciones y los patrones de mercado. Y lo hace en varias escalas a la vez.
class CNeuronHimNetTempEncoder   : public CNeuronBaseOCL
  {
protected:
   uint              aTimeframes[2];
   CCircleParams     caEmbeddings[2];
   CNeuronBaseOCL    cConcatEmbeddings;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;

public:
                     CNeuronHimNetTempEncoder(void) {};
                    ~CNeuronHimNetTempEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support,
                                 int label);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetTempEncoder;   }
   //--- métodos para trabajar con archivos
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
//---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
Los elementos clave son dos diccionarios de embeddings, representados por el array caEmbeddings. Cada uno de estos diccionarios no almacena datos completos, sino solo representaciones compactas de pasos temporales individuales: embeddings que actúan como consultas a los pools de parámetros del modelo. Esto significa que, de hecho, cada paso temporal consulta su propio subespacio de parámetros, extrayendo el valor necesario y configurando así el flujo de datos posterior.
Es importante destacar que ambos diccionarios de embeddings funcionan de forma coordinada, pero independiente; gracias a ello, el modelo capta simultáneamente dos escalas temporales y no mezcla el ruido transitorio con la inercia a largo plazo. A lo largo de la implementación de los métodos, analizaremos en detalle cómo interactúan estas consultas con el flujo de datos y qué tareas asume el resto de componentes del codificador temporal.
Todos los objetos internos se declaran de forma estática, por lo que el constructor y el destructor se mantienen minimalistas. La inicialización efectiva de todo el conjunto de componentes declarados y objetos heredados se lleva a cabo de forma centralizada en el método Init.
bool CNeuronHimNetTempEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint units, uint window, uint window_out, uint cheb_k,
                                    uint layers, uint embed_dim, uint period1,
                                    uint timeframe1, uint period2, uint timeframe2,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(layers <= 0)
      return false;
El algoritmo del método comienza con un pequeño bloque de control: comprobamos el número de capas internas del codificador. Si el valor del parámetro layers es menor o igual que «0», el método rechaza inmediatamente la configuración. Esto evita configuraciones sin sentido: si no hay capas, no hay nada que entrenar.
A continuación, se invoca el método homónimo de la clase base, al que se pasan los parámetros básicos del objeto. En este paso, definimos la forma del tensor de resultados del codificador y reservamos los recursos básicos. Si la inicialización básica falla, no tiene sentido continuar con las operaciones: el método devuelve false.
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
Luego se preparan los diccionarios de embeddings y se registra de inmediato la duración del paso temporal en los elementos correspondientes del array aTimeframes.
   int index = 0;
   if(!caEmbeddings[0].Init(0, index, OpenCL, embed_dim, period1, optimization, iBatch))
      return false;
   aTimeframes[0] = MathMax(1, timeframe1);
   index ++;
   if(!caEmbeddings[1].Init(0, index, OpenCL, embed_dim, period2, optimization, iBatch))
      return false;
   aTimeframes[1] = MathMax(1, timeframe2);
   if(!cConcatEmbeddings.Init(numOutputs, myIndex, open_cl, 2 * embed_dim, optimization_type, batch))
      return false;
Cada diccionario de embeddings se configura según su propia granularidad temporal: el tamaño del embedding y el periodo determinan qué consultas temporales concretas se dirigirán al pool de parámetros. Si cualquiera de estas inicializaciones falla, el método se interrumpe: no permitimos que el codificador quede parcialmente ensamblado.
Una vez definidos los diccionarios, se crea cConcatEmbeddings, un objeto que combinará dos embeddings en un único vector.
A continuación, se inicia la construcción de las capas GRCU. Primero, vaciamos el contenedor cGRCUs y vinculamos explícitamente el contexto de OpenCL.
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
      return false;
Luego se crea el primer objeto CNeuronHimNetGCRU y se inicializa con los parámetros de la primera capa: en su caso, el tamaño de las características en la entrada se establece igual a la dimensión correspondiente de la serie temporal analizada, y en la salida, igual a la representación latente. Esta primera capa es la parte inferior de la pila.
Si la inicialización se ha realizado correctamente, la capa se añade al contenedor cGRCUs. Y, en caso de que la adición o la inicialización fallen, devolvemos false.
Para todas las capas siguientes, el procedimiento se simplifica ligeramente. En el ciclo se crean objetos adicionales de tipo CNeuronHimNetGCRU, pero ahora los tensores de entrada y salida tienen las mismas dimensiones. Es una técnica habitual: la primera capa amplía y recoge el contexto, mientras que las siguientes lo refinan en profundidad. Ante cualquier fallo —ya sea en la creación, la inicialización o la adición—, finalizamos correctamente el método devolviendo false, para no dejar el sistema en un estado incoherente.
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
         return false;
     }
Una vez formada la pila GRCU, inicializamos el búfer auxiliar bSupportAccum, que se utilizará para acumular los gradientes de error de los polinomios de Chebyshev obtenidos de las distintas capas del codificador.
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(units * units * cheb_k, 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
A continuación, un paso práctico importante: el resultado del funcionamiento del codificador es la salida del último objeto del contenedor cGRCUs. Para evitar copias innecesarias de tensores grandes, sincronizamos las funciones de activación, así como los punteros a los búferes de resultados y gradientes. Es decir, el codificador adopta la semántica de activación de la última capa y dirige sus interfaces externas directamente a los búferes internos del último objeto GRCU. Esto supone un ahorro considerable de memoria y tiempo.
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
Tras la inicialización del objeto, pasamos a la funcionalidad principal del codificador temporal: vamos a crear el método de pasada directa feedForward.
bool CNeuronHimNetTempEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support, int label)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
     {
      int position = (label / int(aTimeframes[i])) % caEmbeddings[i].GetPeriod();
      if(!caEmbeddings[i].SetPosition(position) ||
         !caEmbeddings[i].FeedForward())
         return false;
     }
   if(!Concat(caEmbeddings[0].getOutput(), caEmbeddings[1].getOutput(),
              cConcatEmbeddings.getOutput(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
Su algoritmo comienza con la obtención de embeddings de nuestros diccionarios. El procesamiento se organiza en un ciclo que recorre sucesivamente los diccionarios del array. Para cada diccionario, calculamos la posición actual a partir de la marca de tiempo recibida de un programa externo. A continuación, generamos un embedding temporal concreto llamando al método FeedForward del diccionario correspondiente.
En esencia, este es el punto en el que el tiempo se convierte en una dirección para obtener pesos especializados. En términos de trading: cuando se produce una ventana temporal determinada, seleccionamos la configuración adecuada del modelo sin necesidad de volver a entrenarlo; simplemente utilizamos otra consulta.
Una vez obtenidos ambos embeddings, sus resultados se combinan en un único tensor.
A continuación comienza la parte clave: la pasada a través del contenedor GRCU. La variable local inputs se inicializa con un puntero al objeto de datos de origen. En el ciclo que recorre los elementos del contenedor cGRCUs, tomamos sucesivamente cada capa y llamamos a su método de pasada directa.
   CNeuronBaseOCL *inputs = NeuronOCL;
   CNeuronHimNetGCRU *current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
Es importante comprender el contrato: el primer GRCU recibe los datos sin procesar de la secuencia analizada y la consulta de embedding común. Este forma su representación oculta. A continuación, el puntero de inputs se sustituye por el objeto actual: la salida de la primera capa se convierte en la entrada de la siguiente. De este modo se construye una pila de transformaciones sucesivas: la primera capa amplía el contexto, mientras que las siguientes precisan y comprimen la representación. En la práctica de trading, esto se asemeja a una primera pasada analítica en la que se recopilan todos los detalles, mientras que las capas posteriores —como gestores más experimentados— filtran, agregan y preparan la señal para su emisión.
El búfer de polinomios de Chebyshev (Support) sirve como núcleo de la agregación en grafo (K-hop). Pasar el mismo objeto a cada capa garantiza una visión unificada de la estructura de relaciones entre las secuencias unitarias en toda la pila, mientras que cada GRCU utiliza sus propios metaparámetros, generados a partir del embedding, para interpretar este soporte.
Una vez analizada la pasada directa, lo lógico es pasar a la pasada inversa: el momento en que el modelo se somete al examen, y se distribuye cuidadosamente la responsabilidad del error entre todas sus partes. El método calcInputGradients es precisamente el procedimiento en el que los errores acumulados en la salida del codificador se propagan hacia atrás a través de la pila de GRCU y de los diccionarios de embeddings, corrigiendo así el comportamiento de cada componente.
bool CNeuronHimNetTempEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   if(!NeuronOCL || !Support)
      return false;
En primer lugar, mediante una comprobación protegida, el método se asegura de que se le hayan pasado punteros válidos como parámetros de entrada. A continuación, se determina la fuente de entrada para la última capa. Si hay más de una capa en la pila, tomaremos el penúltimo GRCU; en caso contrario, el objeto de datos de origen. Y comenzaremos a distribuir los gradientes de error desde el último GRCU: el mismo objeto cuyo resultado asignamos durante la inicialización como salida externa del codificador. Es lógico: el gradiente llega primero a la parte superior de la pila y, desde allí, comienza a propagarse hacia abajo.
   CNeuronBaseOCL *inputs = (cGRCUs.Total() > 1 ? cGRCUs[-2] : NeuronOCL);
   CNeuronHimNetGCRU* current = cGRCUs[-1];
   if(!current ||
      !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
      return false;
   if(!DeConcat(caEmbeddings[0].getGradient(), caEmbeddings[1].getGradient(),
                cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
Aquí se lleva a cabo el trabajo local principal: el último GRCU distribuye el gradiente recibido entre su entrada, sus metaparámetros internos y el búfer de gradientes de los polinomios de Chebyshev (Support). Es importante comprender que Support actúa en este punto como un mapa de conexiones compartido, y que cada capa de la pila puede aportar su contribución a él. Por eso necesitamos un mecanismo de acumulación.
El siguiente paso consiste en descomponer el gradiente del embedding combinado de nuevo en dos partes: los gradientes de los dos diccionarios de embeddings. Devolvemos a cada rama su propia contribución al error, para que los diccionarios puedan corregir posteriormente sus consultas a los pools de parámetros.
Si hay más de una capa en la pila, se inicia un proceso minucioso de acumulación de gradientes respecto al soporte. En primer lugar, guardamos un puntero al búfer actual de gradientes en la variable local temp, para no perder el búfer anterior con los valores acumulados hasta ese momento. A continuación, redirigimos temporalmente los gradientes de error al búfer bSupportAccum, que hemos asignado previamente.
   if(cGRCUs.Total() > 1)
     {
      CBufferFloat *temp = Support.getGradient();
      if(!Support.SetGradient(GetPointer(bSupportAccum), false))
         return false;
      for(int i = cGRCUs.Total() - 2; i >= 0; i--)
        {
         current = cGRCUs[i];
         inputs = (i > 0 ? cGRCUs[i - 1] : NeuronOCL);
         if(!current ||
            !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
            return false;
         if(!SumAndNormilize(temp, Support.getGradient(), temp, 1, false, 0, 0, 0, 1))
            return false;
         if(!DeConcat(caEmbeddings[0].getPrevOutput(), caEmbeddings[1].getPrevOutput(),
                      cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
            return false;
         for(uint i = 0; i < caEmbeddings.Size(); i++)
            if(!SumAndNormilize(caEmbeddings[i].getGradient(), caEmbeddings[i].getPrevOutput(),
                                caEmbeddings[i].getGradient(), 1, false, 0, 0, 0, 1))
               return false;
        }
      if(!Support.SetGradient(temp, false))
         return false;
     }
//---
   return true;
  }
En el ciclo que recorre los elementos de la pila en orden inverso, llamamos al método de distribución de gradientes de error para cada capa. A continuación, agregamos el nuevo aporte a lo ya acumulado en el búfer temp. A continuación, volvemos a dividir el gradiente del embedding combinado en dos flujos de información. Y, por último, para cada diccionario, sumamos los valores obtenidos a los acumulados anteriormente.
Una vez recorridas todas las capas, restablecemos los punteros a los búferes de datos a su estado inicial. Esto es importante: solo así los optimizadores externos verán la señal correcta para actualizar los parámetros en los que se basa la agregación de grafos.
Y, después de completar con éxito todas las iteraciones, el método devuelve true, lo que significa que el gradiente se ha distribuido correctamente por todos los componentes del codificador hasta el nivel de los datos originales.
Tras recopilar minuciosamente los gradientes, llega la fase de actualización de los parámetros. El método updateInputWeights es sencillo en su forma, pero importante por su significado: transfiere de forma secuencial el control a aquellos componentes internos que contienen pesos entrenables. Y lo hace en el mismo orden en que se ejecuta la secuencia de cálculo.
bool CNeuronHimNetTempEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
      if(!caEmbeddings[i].UpdateInputWeights())
         return false;
En primer lugar, en el ciclo se actualizan ambos diccionarios de embeddings. Cada llamada a UpdateInputWeights aplica los gradientes acumulados en el paso anterior a los parámetros del diccionario correspondiente.
A continuación, el método recorre la pila GRCU en orden directo: cada capa se encarga de actualizar localmente los parámetros de sus embeddings y de sus pools de metaparámetros.
   CNeuronBaseOCL* inputs = NeuronOCL;
   CNeuronHimNetGCRU* current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current.updateInputWeights(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
El código fuente completo de esta clase, con la implementación de todos los métodos, se incluye como archivo adjunto; en él se pueden ver todos los detalles a los que se ha hecho referencia. Con esto, podemos dar por concluido el análisis del codificador temporal y estamos listos para seguir adelante.
Codificador espacial
Antes de continuar, veamos qué es el codificador espacial y en qué se diferencia del temporal, ya que comprender esta diferencia es importante para una integración correcta en la arquitectura general de HimNet.
El codificador temporal operaba con un conjunto de diccionarios de embeddings que actuaban como consultas a pools de parámetros para diferentes granularidades temporales. El codificador espacial, por el contrario, no necesita múltiples claves periódicas, ya que la estructura de los datos espaciales en el problema considerado es estable. Por eso, en lugar de diccionarios, utilizamos un conjunto único de parámetros entrenables, encapsulado en el objeto cEmbedding. Esto permite que el modelo disponga de una representación centralizada del espacio de mercado, que se ajusta durante el proceso de entrenamiento y luego se utiliza como fuente permanente de consultas contextuales para la GRCU.
class CNeuronHimNetSpatEncoder   :     public CNeuronBaseOCL
  {
protected:
   CParams           cEmbedding;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;
   CBufferFloat      bEmbeddingAccum;

public:
                     CNeuronHimNetSpatEncoder(void) {};
                    ~CNeuronHimNetSpatEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetSpatEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
   //---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
Desde el punto de vista arquitectónico, el objeto CNeuronHimNetSpatEncoder es muy similar al codificador temporal. La misma pila de bloques recurrentes de grafos cGRCUs, un acumulador análogo de gradientes de polinomios de Chebyshev y un conjunto de métodos para la pasada directa y la pasada inversa. La principal diferencia es que, en lugar de dos diccionarios de embeddings, tenemos un único módulo parametrizado, cEmbedding, y un búfer adicional, bEmbeddingAccum. Este búfer es necesario para acumular las contribuciones al gradiente del embedding procedentes de todas las capas de la pila.
Dado que el codificador espacial solo se diferencia del temporal en algunos matices, centrarse en la lógica arquitectónica y en el flujo de datos permite no sobrecargar el texto con repeticiones innecesarias. El código completo de la clase y de todos sus métodos, incluido en el anexo, permite al lector apreciar por sí mismo las sutiles diferencias y comprender cómo se actualizan exactamente los parámetros de embedding y los gradientes dentro de las capas GRCU.
Codificador combinado
En esta fase pasamos al módulo clave que integra el funcionamiento de dos codificadores paralelos en una representación única y coherente. La clase CNeuronHimNetEncoder actúa como coordinador, garantizando la integración de las representaciones espaciales y temporales. El codificador temporal registra la dinámica de los cambios a lo largo del tiempo, identificando tendencias a corto y largo plazo, mientras que el espacial analiza las relaciones entre los distintos objetos. Los resultados del trabajo de ambos flujos se consolidan cuidadosamente dentro de la clase, formando una representación latente completa del estado del sistema.
class CNeuronHimNetEncoder    :  public CNeuronBaseOCL
  {
protected:
   CParams                    cEmbedding;
   CNeuronTransposeOCL        cEmbeddingT;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CNeuronHimNetTempEncoder   cTempEncoder;
   CNeuronHimNetSpatEncoder   cSpatEncoder;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetEncoder(void) {};
                    ~CNeuronHimNetEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
Desde el punto de vista arquitectónico, el objeto contiene su propio conjunto de parámetros entrenables (cEmbedding), que sirven de base para formar polinomios de Chebyshev.
Al igual que en los módulos anteriores del framework, la estructura de la clase está diseñada para minimizar los sobrecostes y evitar operaciones dinámicas innecesarias. Todos los objetos internos se declaran aquí de forma estática, por lo que el constructor y el destructor permanecen vacíos. Su función consiste únicamente en definir de manera formal el ciclo de vida del objeto, sin interferir en la lógica de asignación de recursos. Todo el trabajo real de preparación de los componentes se concentra en el método Init, que actúa como una especie de director de orquesta: configura secuencialmente cada elemento interno, distribuye los roles entre los codificadores y los une en una única cadena de cálculo.
bool CNeuronHimNetEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out, uint cheb_k,
                                uint layers, uint embed_dim, uint period1,
                                uint timeframe1, uint period2, uint timeframe2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
La inicialización comienza con la transferencia del control a la clase padre, en la que ya se ha definido el algoritmo de creación de las interfaces básicas. A continuación, se forma una secuencia de componentes vinculados: los parámetros entrenables del embedding, la capa de transposición correspondiente, los objetos para crear la matriz de correlación y normalizar las dependencias obtenidas. Y también el objeto para generar polinomios de Chebyshev para las transformaciones de grafos.
   int index = 0;
   if(!cEmbedding.Init(0, index, OpenCL, units * embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cEmbeddingT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
Cada elemento recibe su propio índice en el pipeline de cálculo, y las funciones de activación se establecen exactamente donde corresponde. Para el objeto de generación de embeddings utilizamos la tangente hiperbólica, que permite definir de forma normalizada las relaciones directas e inversas.
Se presta especial atención a la sincronización de dos flujos: el temporal (cTempEncoder) y el espacial (cSpatEncoder). El primero se encarga de extraer las regularidades temporales teniendo en cuenta los periodos multiescala y las ventanas de predicción; el segundo, de mapear las interrelaciones entre las unidades de análisis. Al final, los búferes de sus gradientes se sincronizan, lo que permite evitar el copiado redundante de datos y garantiza una propagación fluida del error durante la pasada inversa.
   index++;
   if(!cTempEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, (embed_dim + 1) / 2,
                                           period1, timeframe1, period2, timeframe2, optimization, iBatch))
      return false;
   index++;
   if(!cSpatEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, embed_dim, optimization,
                                                                                                      iBatch))
      return false;
//---
   if(!SetGradient(cTempEncoder.getGradient(), true))
      return false;
//---
   return true;
  }
De este modo, el método Init actúa como punto de ensamblaje de todo el módulo, transformando los componentes dispersos en una arquitectura única y coherente, lista para el entrenamiento y el uso con datos financieros reales.
Una vez finalizado el proceso de inicialización del objeto, pasamos a la construcción del algoritmo de pasada directa.
bool CNeuronHimNetEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
Empezamos por lo más básico: comprobamos que se haya recibido un puntero válido al objeto de datos de origen del segundo flujo de información. En él esperamos obtener la marca temporal de la secuencia analizada. Si no hay puntero, salimos inmediatamente, sin arriesgarnos a alterar el estado del grafo y de los búferes.
A continuación se produce una bifurcación importante. En el modo de entrenamiento, reconstruimos el grafo adaptativo desde cero. Primero generamos el embedding. A continuación, preparamos su representación transpuesta.
   if(bTrain)
     {
      if(!cEmbedding.FeedForward())
         return false;
      if(!cEmbeddingT.FeedForward(cEmbedding.AsObject()))
         return false;
      if(!MatMul(cEmbedding.getOutput(), cEmbeddingT.getOutput(), cSupport.getOutput(),
                 cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
         return false;
      if(!cNormSupport.FeedForward(cSupport.AsObject()))
         return false;
      if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
         return false;
     }
La operación MatMul realiza la multiplicación matricial del embedding obtenido por su copia transpuesta, generando una matriz de correlación entre los nodos. En el contexto del trading, esto significa que los pares de instrumentos con huellas de comportamiento similares estarán más estrechamente relacionados.
Normalizamos el gráfico sin procesar mediante la función SoftMax, aplicando un posprocesamiento estable. Como resultado de la operación, obtenemos una matriz de adyacencia estocástica, apta para la convolución sobre grafos.
A continuación, construimos los polinomios de Chebyshev. Este es nuestro telescopio K-hop, que permite acumular la influencia de los vecinos a una distancia de hasta K aristas sin necesidad de diagonalizar el laplaciano: de forma rápida, numéricamente estable y por completo en la GPU.
En el modo de inferencia, esta sección se omite. Utilizamos los embeddings y los polinomios que ya hemos obtenido durante el entrenamiento para no desperdiciar nanosegundos y mantener el determinismo.
A continuación, es el turno de dos codificadores. En primer lugar, enviamos al flujo temporal la secuencia multimodal de los datos que se van a analizar, el conjunto de polinomios de Chebyshev y la marca de tiempo.
   if(!cTempEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject(), int(SecondInput[0])))
      return false;
El codificador combina lo que está ocurriendo en este momento con el momento exacto en que ocurre, superponiendo un régimen temporal a la dinámica del grafo.
Al mismo tiempo, ponemos en marcha el codificador espacial.
   if(!cSpatEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
No necesita una etiqueta temporal: aquí operan embeddings nodales estacionarios. La rama espacial se encarga de un mapa del mercado estable. Ambos flujos ven la misma base K-hop, pero la captan desde distintos ángulos: a través del tiempo y a través del espacio.
El toque final: un ensamblaje cuidadoso de los resultados. Sumamos las salidas de los codificadores.
   if(!SumAndNormilize(cTempEncoder.getOutput(), cSpatEncoder.getOutput(), Output,
                       cTempEncoder.GetWindowOut(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
En la práctica, funciona como un ensemble sencillo pero fiable: el canal temporal capta los regímenes de sesión y los efectos de calendario, mientras que el espacial capta los clústeres estables. A la salida obtenemos una representación latente que se comporta con la misma solidez tanto en un mercado tranquilo como durante los picos asociados a noticias: el modelo no se sobreajusta a un único tipo de señal, porque la señal procede de dos fuentes coordinadas.
Si cada paso se ejecuta sin errores, el método devuelve true. De lo contrario, salimos inmediatamente, sin dejar estados sucios en los búferes. Este control conservador del flujo resulta especialmente importante en el trading real: cuando ejecutas el modelo con datos por tick o en gráficos de 1 minuto, no puedes permitirte el lujo de recuperarte a partir de datos parcialmente dañados; o bien el pronóstico es correcto y oportuno, o bien no debe existir en absoluto.
Una vez finalizada la pasada directa, el modelo pasa a una de las etapas más importantes: la distribución de los gradientes de error. Es precisamente aquí donde se determina en qué medida cada elemento de la arquitectura percibirá correctamente la señal de retroalimentación y podrá ajustar sus pesos. El método calcInputGradients de esta clase está diseñado para que este proceso se desarrolle de forma secuencial, sin costes computacionales innecesarios y con un coste mínimo de copia de datos.
bool CNeuronHimNetEncoder::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!cTempEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()))
      return false;
En primer lugar, los gradientes se extraen del codificador temporal y se transfieren cuidadosamente a los búferes de soporte polinómico y de la capa anterior.
Aquí se repite el procedimiento para el codificador espacial, pero antes debemos asegurarnos de que los datos ya obtenidos se conserven. Y aquí no solo nos referimos a los componentes internos, sino también al objeto de datos de origen. Y es que ambos codificadores analizan un mismo pool de datos de origen durante la pasada directa
   CBufferFloat* temp = cPolinomSupport.getGradient();
   CBufferFloat* prev = prevLayer.getGradient();
   if(!cPolinomSupport.SetGradient(cPolinomSupport.getPrevOutput(), false) ||
      !prevLayer.SetGradient(prevLayer.getPrevOutput(), false) ||
      !cSpatEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()) ||
      !SumAndNormilize(temp, cPolinomSupport.getGradient(), temp,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(prev, prevLayer.getGradient(), prev,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !cPolinomSupport.SetGradient(temp, false) ||
      !prevLayer.SetGradient(prev, false))
      return false;
   if(prevLayer.Activation() != None)
      if(!DeActivation(prevLayer.getOutput(), prev, prev, prevLayer.Activation()))
         return false;
Sumamos cuidadosamente los datos de los dos flujos de información.
A continuación, la retropropagación avanza por la cadena hacia abajo: debemos distribuir los gradientes de error desde los polinomios de Chebyshev hasta el nivel de los embeddings, manteniendo la continuidad del flujo de información.
//---
   if(!cNormSupport.CalcHiddenGradients(cPolinomSupport.AsObject()))
      return false;
   if(!cSupport.CalcHiddenGradients(cNormSupport.AsObject()))
      return false;
   if(!MatMulGrad(cEmbedding.getOutput(), cEmbedding.getPrevOutput(),
                  cEmbeddingT.getOutput(), cEmbeddingT.getGradient(),
                  cSupport.getGradient(),
                  cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
      return false;
   if(!cEmbedding.CalcHiddenGradients(cEmbeddingT.AsObject()))
      return false;
   if(!SumAndNormilize(cEmbedding.getGradient(), cEmbedding.getPrevOutput(), cEmbedding.getGradient(),
                       cEmbeddingT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEmbedding.Activation() != None)
      if(!DeActivation(cEmbedding.getOutput(), cEmbedding.getGradient(),
                       cEmbedding.getGradient(), cEmbedding.Activation()))
         return false;
//---
   return true;
  }
En definitiva, el método sigue una ruta de retroalimentación cuidadosamente estructurada, en la que cada capa recibe exactamente la porción de señal correctora que le corresponde. Esto reduce el riesgo de divergencia de los gradientes, mejora la estabilidad del entrenamiento y hace que el proceso de optimización sea más controlable.
El método de actualización de parámetros se ha implementado de forma extremadamente concisa, pero ahí radica precisamente su fuerza. No intenta intervenir en los cálculos de cada bloque, sino que simplemente delega la responsabilidad en los componentes correspondientes.
bool CNeuronHimNetEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cEmbedding.UpdateInputWeights())
      return false;
   if(!cTempEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
   if(!cSpatEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
//---
   return true;
  }
Para quienes quieran profundizar en los detalles, se adjunta el código completo de la clase y de todos sus métodos; pueden estudiarlo a su propio ritmo.
Decodificador
Al concluir nuestro trabajo de implementación de los enfoques del framework HimNet, pasamos al componente final, no por ello menos importante: el decodificador. Si el codificador desempeñaba el papel de recopilador de información, comprimiendo y estructurando los datos para una representación compacta, el decodificador actúa como un hábil restaurador: capa a capa, recupera el contenido original del espacio latente oculto, devolviendo a los datos su forma habitual, pero ahora enriquecida y depurada de ruido superfluo.
class CNeuronHimNetDecoder    :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL             cProjection;
   CNeuronTransposeOCL        cProjectionT;
   CNeuronConvOCL             cEmbedding;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CLayer                     cGRCUs;
   CBufferFloat               bSupportAccum;
   CBufferFloat               bEmbeddingAccum;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetDecoder(void) {};
                    ~CNeuronHimNetDecoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out,
                          uint cheb_k, uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetDecoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
  };
Desde el punto de vista arquitectónico, el decodificador mantiene la continuidad y la simetría con el codificador, lo que hace que la estructura general de la red sea equilibrada y fácil de interpretar. Sin embargo, a diferencia del codificador, en el que los embeddings espaciales y temporales podían formarse por separado y complementarse entre sí, en el decodificador se aplica un único embedding espaciotemporal, que se forma a partir de la representación latente obtenida a la salida del codificador. Esta misma representación latente sirve de base para la construcción de los polinomios de Chebyshev, que se utilizan para aproximar dinámicas complejas en la reconstrucción de series temporales.
Una vez que nos hemos familiarizado con la arquitectura del decodificador, el siguiente paso consiste en inicializar de forma secuencial todos sus componentes internos. El método Init comienza su ejecución cediendo el control a la clase padre, que se encarga de inicializar las interfaces básicas.
bool CNeuronHimNetDecoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out,
                                uint cheb_k, uint layers, uint embed_dim,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
A continuación, se crea una capa de proyección de los datos de origen, cProjection, y un objeto de transposición de la proyección obtenida, cProjectionT.
   int index = 0;
   if(!cProjection.Init(0, index, OpenCL, window, window, embed_dim, units, 1, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cProjectionT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
Al primero se le asigna la función de activación TANH, lo que permite generar correctamente representaciones espaciotemporales a partir de la representación latente recibida del codificador.
Luego se crea la capa de generación de embeddings cEmbedding, cuyas dimensiones se corresponden con el número de neuronas y la dimensionalidad de las características. Estos embeddings se utilizan para los cálculos posteriores en los bloques recurrentes.
   index++;
   if(!cEmbedding.Init(0, index, OpenCL, units, units, 1, 1, embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(SIGMOID);
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
Los objetos cSupport y cNormSupport desempeñan un papel fundamental en la preparación de los datos para los polinomios de Chebyshev. En primer lugar, cSupport genera una matriz de correlación diagonal que refleja las relaciones entre las distintas características o flujos temporales. A continuación, cNormSupport lleva los valores de esta matriz a una escala común, lo que garantiza la estabilidad de los cálculos y la corrección de las operaciones posteriores. Es precisamente esta matriz normalizada la que sirve de base para el bloque cPolinomSupport, sobre cuya base se construyen los polinomios de Chebyshev, que posteriormente intervienen en los cálculos de los bloques recurrentes GCRU. Este enfoque permite modelar relaciones complejas entre las características, manteniendo la precisión y la coherencia en el proceso de cálculo.
El siguiente paso es crear el contenedor cGRCUs para los bloques recurrentes GCRU. En él se añaden bloques de forma secuencial: el primero recibe el tamaño del espacio de características correspondiente a los datos de origen, mientras que todos los siguientes utilizan un tamaño fijo de tensores.
//---
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
     {
      DeleteObj(temp);
      return false;
     }
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
        {
         DeleteObj(temp);
         return false;
        }
     }
Todos los bloques se vinculan al contexto de OpenCL, lo que permite acelerar los cálculos.
Para almacenar los resultados intermedios de los gradientes de error, se reservan los búferes bSupportAccum y bEmbeddingAccum.
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(cPolinomSupport.Neurons(), 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
   bEmbeddingAccum.BufferFree();
   bEmbeddingAccum.Clear();
   if(!bEmbeddingAccum.BufferInit(cEmbedding.Neurons(), 0) ||
      !bEmbeddingAccum.BufferCreate(OpenCL))
      return false;
//---
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
El proceso de inicialización concluye con la sincronización de las funciones de activación del último bloque para todo el decodificador, así como de los punteros a los búferes de salida y los gradientes de error. Esto evita copias innecesarias de datos y garantiza que el modelo esté listo para el entrenamiento y la pasada directa. Cada etapa se comprueba minuciosamente: en caso de que se produzca cualquier error, el método devuelve false, lo que evita que el modelo entre en un estado incorrecto y garantiza la estabilidad de los cálculos posteriores.
Tras inicializar correctamente todos los componentes del decodificador, pasamos a desarrollar el método de pasada directa, que constituye el núcleo del proceso de procesamiento de la señal. En esta fase, la información analizada pasa sucesivamente por varios bloques interrelacionados, cada uno de los cuales desempeña una función específica, lo que garantiza un funcionamiento preciso y coordinado del modelo.
bool CNeuronHimNetDecoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjection.FeedForward(NeuronOCL))
      return false;
   if(!cProjectionT.FeedForward(cProjection.AsObject()))
      return false;
   if(!MatMul(cProjection.getOutput(), cProjectionT.getOutput(), cSupport.getOutput(),
              cProjectionT.GetCount(), cProjectionT.GetWindow(), cProjectionT.GetCount(), 1, false))
      return false;
   if(!cNormSupport.FeedForward(cSupport.AsObject()))
      return false;
En la fase inicial, la señal se procesa en los módulos cProjection y cProjectionT, que transforman los datos de origen en una representación latente de la dimensionalidad especificada. Los tensores resultantes se someten a una multiplicación matricial, lo que da lugar a una matriz diagonal de correlación. A continuación, esta matriz se normaliza utilizando la función SoftMax. Esta normalización es fundamental para la formación de los polinomios de Chebyshev en el bloque cPolinomSupport, ya que garantiza la estabilidad de los cálculos y el escalado correcto de la influencia de cada elemento en las capas posteriores.
   if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
      return false;
//---
   if(!cEmbedding.FeedForward(cProjectionT.AsObject()))
      return false;
A continuación, se generan los embeddings en el bloque cEmbedding, que ofrecen una representación compacta e informativa de las características ocultas de los datos.
Tras la preparación de los datos, la señal llega al primer bloque GCRU desde el contenedor cGRCUs, donde se lleva a cabo el procesamiento recurrente sobre grafos de la información. Cada bloque GCRU posterior recibe como entrada la salida del anterior, lo que permite al decodificador acumular dependencias temporales y espaciales e identificar patrones complejos en los datos históricos.
   CNeuronHimNetGCRU* current = NULL;
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(NeuronOCL, cPolinomSupport.AsObject(), cEmbedding.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
Como resultado de estas transformaciones sucesivas, se obtiene la salida final del decodificador. Este enfoque garantiza un funcionamiento coordinado del modelo y la optimización de los recursos computacionales, lo cual resulta especialmente importante a la hora de procesar grandes conjuntos de datos financieros y de realizar el entrenamiento con series temporales históricas.
Probablemente ya habrá observado hasta qué punto los algoritmos de funcionamiento del decodificador heredan de forma natural la lógica demostrada en los codificadores analizados anteriormente. Por lo tanto, propongo dejar el estudio detallado de los métodos de pasada inversa para una revisión independiente. El código completo de la clase, junto con todos sus métodos, se incluye en el archivo adjunto.
Pruebas
Una vez que hemos reunido todos los componentes clave del framework HimNet, llega el momento de pasar a la fase más interesante: el entrenamiento y las pruebas del modelo. Nuestro objetivo sigue siendo el mismo: crear un sistema de trading capaz de analizar el mercado y tomar decisiones de forma autónoma. En este esquema, HimNet actúa como codificador del estado del entorno, formando una representación compacta pero informativa de la situación actual del mercado. El actor se apoya en esta representación al elegir acciones, mientras que el crítico evalúa su calidad, proporcionando retroalimentación y ajustando la estrategia.
El entrenamiento se estructura en dos fases complementarias, lo que proporciona a la vez una base sólida y la flexibilidad necesaria para trabajar en condiciones reales de mercado. En la primera fase offline, llevamos a cabo un entrenamiento exhaustivo con datos históricos del par EURUSD en el marco temporal H1 correspondiente a todo el año 2024. Este periodo abarcó todo el abanico de regímenes de mercado —mercados laterales tranquilos, tendencias sostenidas, picos bruscos de volatilidad y periodos de mayor ruido—, por lo que se convirtió en una excelente escuela para el modelo.
La segunda fase consiste en un ajuste fino online. El modelo procesaba el flujo de velas de forma secuencial en el Probador de Estrategias de MetaTrader 5, lo más cercano posible al trading real. Esta fase pone de manifiesto propiedades totalmente distintas a las del entrenamiento offline: la capacidad de soportar el ruido, reaccionar adecuadamente ante los cambios en la liquidez, y tener en cuenta las latencias y el efecto del deslizamiento. Simulamos minuciosamente las condiciones reales de ejecución para que el comportamiento del modelo siguiera siendo predecible al trasladarlo a condiciones reales de mercado.
La fase final y más rigurosa de la verificación se llevó a cabo sobre una muestra totalmente externa: las cotizaciones comprendidas entre enero y marzo de 2025. Todos los parámetros del modelo permanecieron congelados. Esta comprobación ofrece una visión objetiva de la eficacia práctica: la capacidad del algoritmo para mantener la estabilidad y la previsibilidad en nuevas condiciones.
A continuación se muestran los resultados de las pruebas.
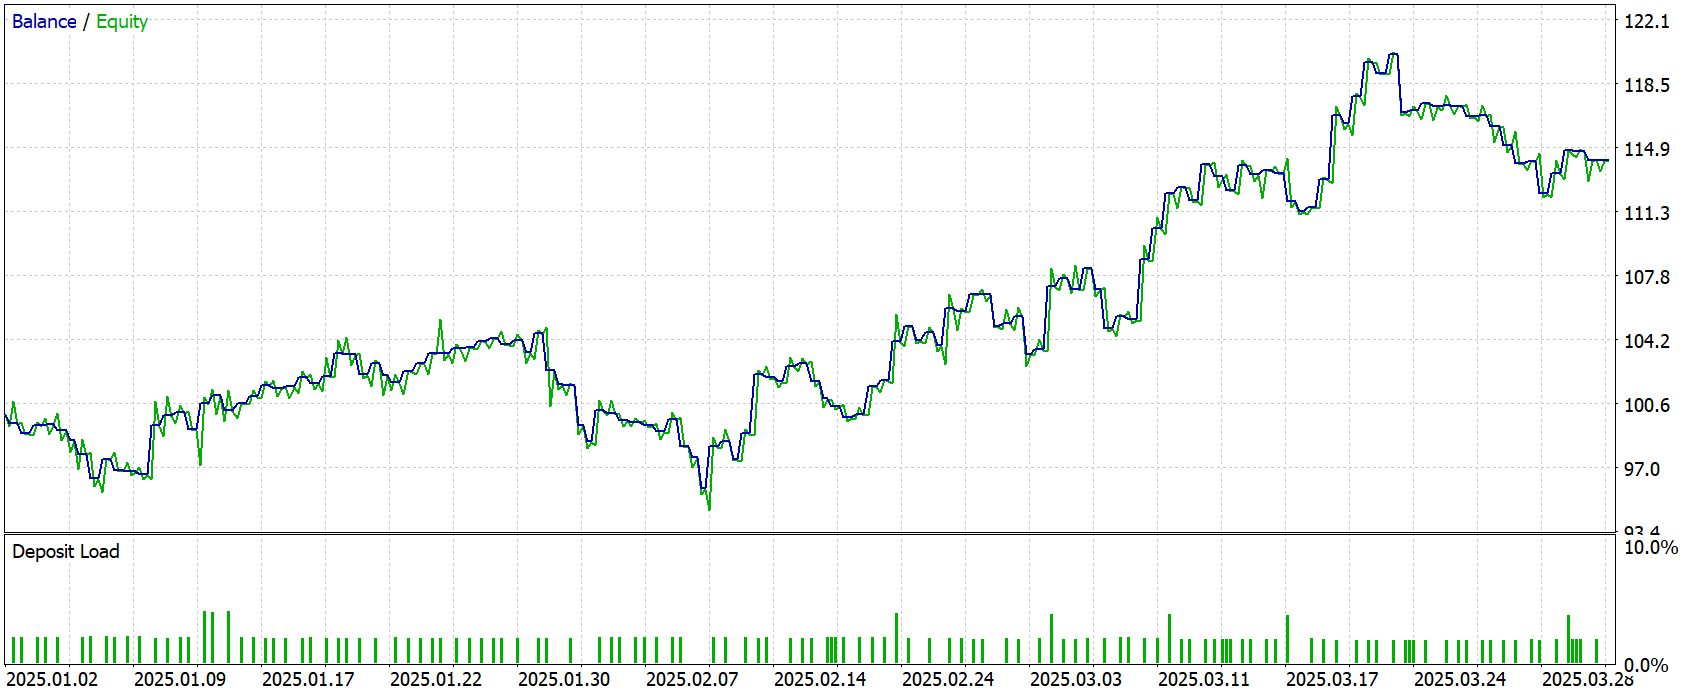
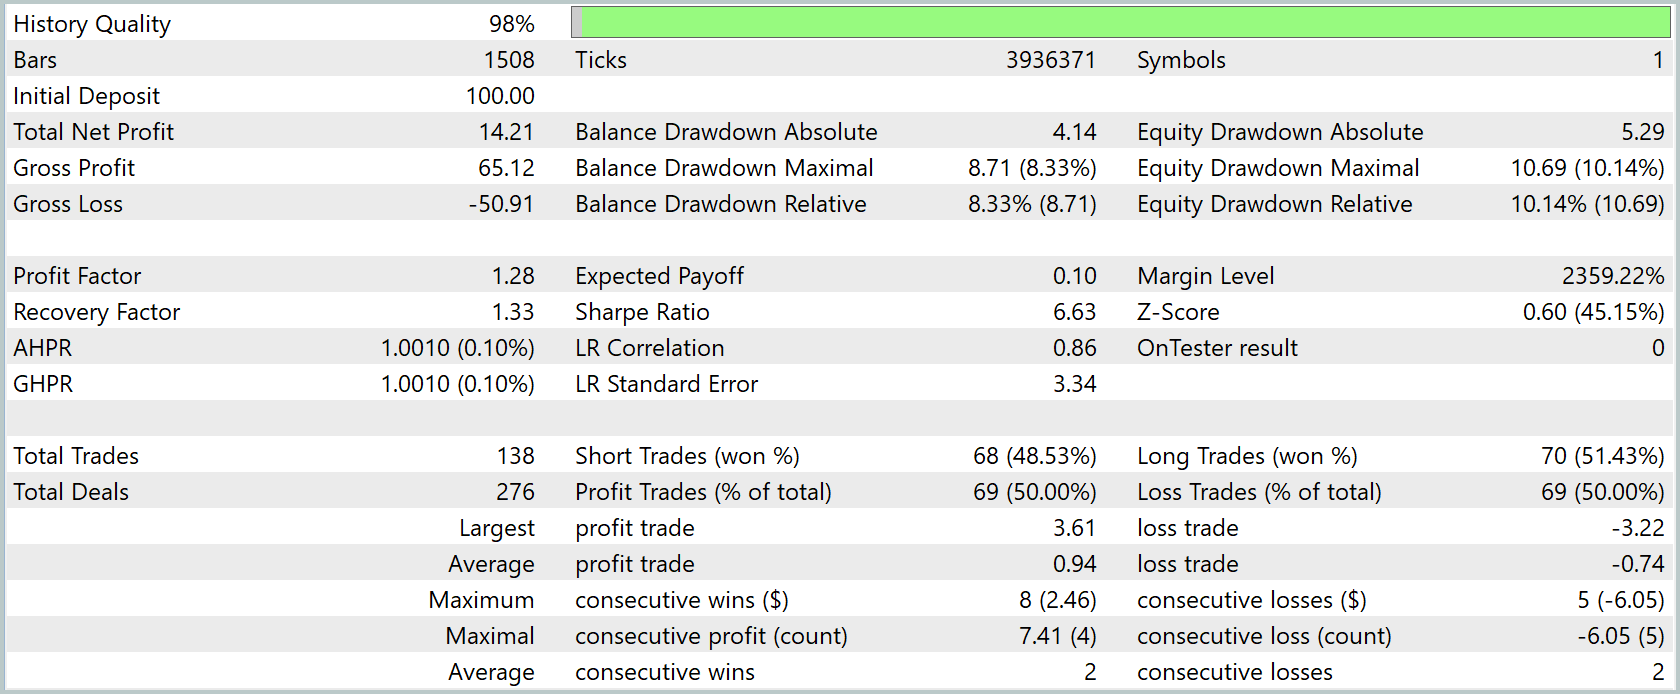
Durante los tres meses que duró el periodo de prueba, el beneficio neto alcanzó el 14,21 % del capital inicial. El beneficio por cada dólar de pérdida ascendía a 1,28 $, mientras que la esperanza matemática media de la operación era de tan solo 0,10 dólares. El coeficiente de recuperación de 1,33 indica que la ganancia final superó la caída máxima del balance.
Las caídas fueron moderadas: la absoluta fue de 4,14 $ en el balance y de 5,29 $ en el equity, mientras que la relativa máxima fue del 8,33 % y del 10,14 %, respectivamente. Al mismo tiempo, la línea de beneficio mostró un crecimiento sostenido, lo que confirma la correlación de la tendencia con el tiempo, situada en 0,86.
A lo largo de toda la prueba, el asesor experto realizó 138 operaciones, repartidas casi a partes iguales entre compras y ventas, y el porcentaje de operaciones rentables se situó cerca del 50 % en ambos sentidos. El beneficio medio por operación ganadora fue de 0,94 dólares, la pérdida media de 0,74 $, la ganancia máxima alcanzó los 3,61 $ y la pérdida máxima fue de 3,22 $. De media, las posiciones se mantuvieron algo más de una hora, y el tiempo de mantenimiento osciló entre 57 minutos y dos horas, lo que indica un estilo de negociación claramente a corto plazo e intradía.
En conjunto, los resultados apuntan a una estrategia bastante estable, aunque moderadamente rentable. Sus puntos fuertes son las caídas controladas, una operativa uniforme en ambas direcciones del mercado y una esperanza matemática positiva. Sus puntos débiles son un escaso margen en el factor de beneficio y un beneficio medio por operación bajo, lo que puede hacer que sea sensible a los spreads y a las comisiones en una cuenta real.
Conclusión
En este artículo se da por concluido el trabajo de implementación de los enfoques del framework HimNet mediante MQL5. Las principales ventajas del framework son su flexibilidad arquitectónica y su capacidad para adaptarse a diversas tareas relacionadas con la predicción y el análisis de series temporales.
Los resultados de las pruebas finales realizadas con cotizaciones nuevas que no formaban parte de la muestra de entrenamiento mostraron una dinámica positiva. El balance del modelo mostró un crecimiento estable, lo que demuestra su capacidad para adaptarse eficazmente a las condiciones cambiantes del mercado.
Enlaces
- Heterogeneity-Informed Meta-Parameter Learning for Spatiotemporal Time Series Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19286
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Asesor experto de trading neuronal basado en PatchTST
 Redes neuronales en el trading: Entrenamiento de metaparámetros basado en la heterogeneidad (Componentes principales)
 Particularidades del trabajo con números del tipo double en MQL4
 Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 10): Factorización de matrices

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso