Desenvolvimento de EAs auto-otimizáveis em MQL5 (Parte 14): Transformações de dados como parâmetros de ajuste de um controlador com realimentação
 32
 0

O pré-processamento é um poderoso parâmetro de ajuste, mas frequentemente subestimado em qualquer ambiente ou pipeline de aprendizado de máquina.
Trata-se de um importante parâmetro de ajuste do sistema, que muitas vezes fica em segundo plano diante de componentes considerados mais relevantes. Em geral, a maior parte da atenção e dos esforços de pesquisa se concentra nos otimizadores e nas arquiteturas avançadas de modelos, áreas às quais a comunidade científica dedica recursos consideráveis. Em contrapartida, o impacto das técnicas de pré-processamento ainda recebe relativamente pouca atenção.
Embora nem sempre seja evidente, o pré-processamento aplicado aos dados pode exercer uma influência surpreendentemente significativa sobre o desempenho do modelo. Mesmo uma pequena melhoria percentual obtida nessa etapa pode gerar resultados expressivos ao longo do tempo, com efeitos relevantes sobre a rentabilidade e os riscos das nossas aplicações de negociação.
Muitas vezes, avançamos rapidamente pela etapa de pré-processamento sem dedicar o tempo e a atenção necessários para verificar se realmente escolhemos a melhor transformação para os dados de entrada.
Os otimizadores modernos e as arquiteturas de aprendizado de máquina dos quais dependemos atualmente podem ter seu desempenho limitado ou, pelo contrário, potencializado pelas transformações de dados, muitas vezes sem que esse efeito seja percebido. Infelizmente, até o momento da elaboração deste artigo, não existe uma metodologia consolidada capaz de demonstrar que determinada transformação é a melhor possível. Além disso, não temos como garantir que não exista uma alternativa mais eficaz. Na realidade, poucos estudos investigam a possibilidade de combinar diferentes transformações em soluções híbridas, justamente uma área que ainda apresenta potencial inexplorado para melhorar o desempenho.
Por isso, nosso objetivo é melhorar o desempenho do controlador com realimentação que desenvolvemos cuidadosamente ao longo da discussão anterior (link disponível aqui).
Além de buscar a rentabilidade, queremos reduzir os riscos e tornar o comportamento da nossa aplicação de negociação mais robusto e, até certo ponto, mais maduro. Em essência, essa abordagem trata o próprio pré-processamento como um parâmetro de ajuste independente que, quando utilizado adequadamente, pode influenciar significativamente os resultados das aplicações de negociação.
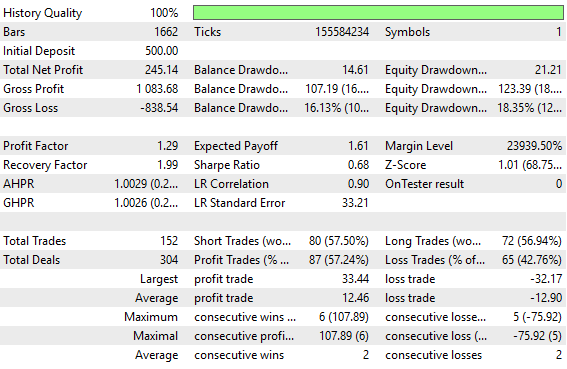
Figura 1: Configurações anteriores das estatísticas do backtest, definidas na versão original do nosso controlador com realimentação
O desempenho do nosso controlador com realimentação anterior era, sem dúvida, aceitável em todos os critérios avaliados. No entanto, vamos demonstrar que o tempo dedicado à identificação das transformações de dados mais adequadas pode revelar um potencial de retorno alfa ainda não realizado em sua estratégia devido ao aproveitamento insuficiente do sinal.
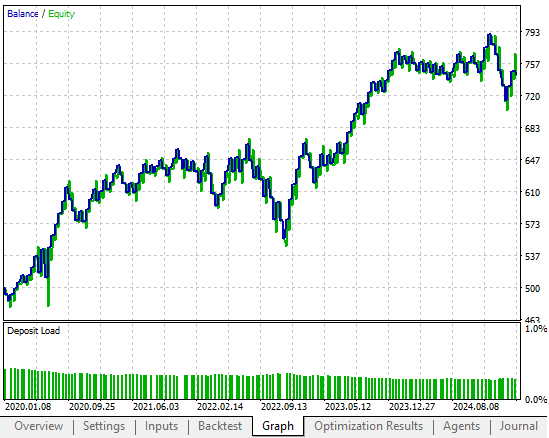
Figura 2: Curva de capital anterior que pretendemos superar ao identificar a transformação adequada para aplicar aos nossos dados de entrada
A incapacidade de identificar padrões complexos nos dados pode, ao longo do tempo, resultar em perdas de capital investido. Para investigar esse problema, testamos três transformações diferentes dos dados de entrada fornecidos ao nosso controlador com realimentação. Como referência para comparação, realizamos inicialmente um teste de benchmark utilizando os dados brutos, sem qualquer transformação, apresentados anteriormente. Em seguida, avaliamos cada transformação com o mesmo conjunto de dados históricos, mantendo todas as demais variáveis constantes. O desempenho foi medido por indicadores como rentabilidade, índice de Sharpe, número de operações executadas, perdas totais acumuladas e percentual de operações lucrativas. Dessa forma, conseguimos isolar o impacto do pré-processamento e preservar a objetividade da comparação entre os três testes.
A primeira transformação avaliada foi a padronização estatística pelo escore Z (z-score), também conhecida como normalização Z. O cálculo consiste em subtrair de cada valor a média da respectiva coluna e dividir a diferença pelo desvio-padrão dessa mesma coluna. Observamos que essa transformação reduziu nossa rentabilidade em 30% em relação ao resultado original, algo evidentemente pouco atraente. Além disso, o índice de Sharpe caiu expressivos 10% em comparação com o valor de referência.
Portanto, a padronização pelo z-score não se mostrou a melhor opção para nossa aplicação. Em seguida, utilizamos uma transformação baseada em álgebra linear, conhecida como normalização para norma unitária, que consiste em dividir uma matriz por sua norma. Neste caso específico, escolhemos a norma L1 da matriz como divisor. Após aplicar essa normalização, observamos um aumento de 12% na rentabilidade da aplicação em relação ao resultado de referência, um avanço bastante promissor. Além disso, o índice de Sharpe apresentou uma melhoria de 30% com a normalização para norma unitária.
Outro sinal importante de competência na negociação é a capacidade de nossa estratégia gerar retornos mais elevados com um número menor de operações. Foi exatamente o que observamos neste teste: após a normalização para norma unitária, o número total de operações necessárias diminuiu 8%, enquanto as perdas totais acumuladas caíram 15%. Por fim, o percentual de operações lucrativas aumentou 5%. Esses resultados nos deram plena confiança de que a normalização para norma unitária contribuiu positivamente para o desempenho do nosso controlador com realimentação.
Por fim, testamos uma abordagem híbrida que combina a padronização pelo z-score com a normalização para norma unitária. Infelizmente, essa combinação anulou todas as melhorias obtidas exclusivamente com a normalização para norma unitária. Nossa rentabilidade caiu 58% em relação ao valor de referência, enquanto o índice de Sharpe diminuiu 19%. Portanto, apesar de nossa forte intuição de que a combinação seria benéfica, a integração dessas duas transformações em um modelo híbrido teve um efeito devastador sobre o desempenho e não revelou nenhuma estrutura adicional nos dados da qual pudéssemos extrair informações úteis.
Diante desses resultados, fica claro que o pré-processamento de dados não é apenas uma etapa auxiliar na construção de modelos de aprendizado de máquina para negociação. Na realidade, o próprio pré-processamento constitui uma estratégia independente. A escolha do método de transformação influencia o desempenho dos nossos modelos de aprendizado de máquina, muitas vezes sem que percebamos. Ela influencia a geração de lucros, distorce as perdas e altera involuntariamente nossa exposição ao risco de maneiras que não conseguimos compreender diretamente.
O aprendizado estatístico clássico oferece pouquíssima orientação nesse sentido. Não existem padrões universais amplamente aceitos, além da busca exaustiva entre diferentes alternativas, utilizando validação cruzada com diferentes divisões dos dados. Isso significa que precisamos dedicar tempo à comparação de diferentes pipelines de pré-processamento e reconhecê-los pelo que realmente são: parâmetros de ajuste com influência significativa sobre o desempenho do nosso pipeline de aprendizado de máquina.
Esses resultados também devem incentivar outros pesquisadores e autores a investigar uma variedade maior de transformações aplicáveis à nossa área. Em campos como reconhecimento de imagens e reconhecimento de fala, os especialistas em aprendizado de máquina frequentemente utilizam pipelines de transformação robustos e abrangentes antes mesmo de iniciar qualquer tentativa de previsão. No entanto, no aprendizado de máquina aplicado às finanças, ainda dedicamos relativamente pouco tempo ao desenvolvimento de pipelines robustos de transformação de dados na etapa de pré-processamento.
Diante desse cenário, realizar uma busca exaustiva entre diferentes alternativas é uma estratégia sensata. Quanto mais transformações investigamos, melhor compreendemos as características de cada uma quando aplicada ao mercado em questão. Esse conhecimento nos ajuda a identificar qual das transformações avaliadas pode ser a mais adequada.
Análise do desempenho de referência atual
Antes de prosseguirmos, é importante conhecer a configuração do controlador cujo desempenho pretendemos superar. É difícil avaliar qualquer otimização sem um resultado de referência ou um nível básico de desempenho com o qual possamos comparar os resultados. Por isso, começaremos com uma breve análise do controlador com realimentação que implementamos anteriormente. Os leitores que acompanham esta série já estarão familiarizados com o código a seguir. Para quem está lendo este artigo pela primeira vez, apresentarei um breve resumo das principais conclusões obtidas com a aplicação que desenvolvemos e com a discussão anterior.
A aplicação utiliza um pequeno conjunto de parâmetros do sistema que permanecem constantes durante toda a sua execução. Entre eles estão o período utilizado no cálculo dos indicadores técnicos, o número de dias de negociação cujos dados devem ser considerados antes que o controlador com realimentação possa emitir um sinal de entrada e a quantidade total de atributos que o controlador recebe como dados de entrada. Neste caso, o controlador com realimentação utiliza 12 atributos de entrada. É importante destacar que, no exemplo anterior, não aplicamos nenhuma transformação, padronização ou técnica de escalonamento a qualquer um desses 12 valores.
Durante a execução, a aplicação também utiliza variáveis globais e bibliotecas, incluindo uma biblioteca de negociação para abrir e fechar operações, uma biblioteca de tempo para acompanhar a formação das velas e uma biblioteca trade-info, que fornece informações como o tamanho mínimo do lote e os preços atuais de compra (Ask) e venda (Bid).
Na inicialização, a aplicação cria novas instâncias das classes disponibilizadas pelas bibliotecas personalizadas, configura os indicadores técnicos e inicializa a maioria das variáveis globais com seus valores padrão. Quando a aplicação é encerrada, os objetos alocados dinamicamente são liberados, assim como os recursos associados aos indicadores técnicos.
A cada chamada da função OnTick(), o sistema primeiro verifica se uma nova vela foi formada. Quando isso acontece, os buffers das médias móveis são atualizados com base no preço de fechamento mais recente. Se não houver posições abertas, o sistema aplica a seguinte lógica de negociação: utiliza um canal formado por duas médias móveis, uma superior e outra inferior, ambas calculadas com o mesmo período. Sempre que o preço rompe o limite superior do canal, abrimos uma posição de compra. Por outro lado, quando o preço rompe o limite inferior do canal, abrimos uma posição vendida. Caso nenhuma dessas condições seja atendida, aguardamos.
Durante os primeiros 90 dias, o sistema pode executar operações de compra e venda praticamente de imediato. Após esse período, porém, a execução de novas operações passa a depender de uma previsão do controlador com realimentação. Se o controlador apresentar confiança de que a operação será lucrativa, ele autoriza sua execução. Caso contrário, suspende temporariamente o funcionamento do sistema.
Esse é o princípio fundamental do controlador com realimentação: ele aguarda os primeiros 90 dias antes de começar a fornecer sinais ao sistema. Em seguida, definimos o método take_snapshots, responsável pela coleta periódica de dados sobre o desempenho do sistema, e o método fit_snapshots, que utiliza esses dados para encontrar soluções lineares. Depois que essas soluções são obtidas, o sistema pode começar a gerar previsões.
Essa é a versão básica da nossa estratégia de negociação.
//+------------------------------------------------------------------+
//|                                         Closed Loop Feedback.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

/**
Closed Loop Feedback Control allows us to learn how to control our
system's dynamics.

It is challenging to perform in action, but worth every effort made
towards it.

Certain tasks, such as deciding when to increase your lot size,
are not always easy to plan explicitly.

We can rather observe our average loss size after say, 20 trades at
minimum lot.

From there, we can calculate how much on average, we expect to lose
on any trade. And then set meaningful profit targets to accumulate,
before increasing out lot size. We do not always know these numbers
ahead of time.


Additionally, we can train predictive models, that attempt to learn
when our system is loosing and keep us out of loosing trades.

The models we desire are not directly predicting the market per say.

Rather, they are observing the relationship between a fixed strategy
and a dynamic market.

After allowing a certain number of observations, the predictive model
may be permitted to give inputs that override the original strategy
only if the model expects the strategy to lose, yet again.

These family of algorithms may one day make it possible for us to
truly design strategies that require no tuning parameters at all!

I am excited to present this to you, but there is a long road ahead.
Let us begin.
**/

//+------------------------------------------------------------------+
//| System definitions                                               |
//+------------------------------------------------------------------+
#define MA_PERIOD    10
#define OBSERVATIONS 90
#define FEATURES     12
#define ACCOUNT_STATES 3

//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int    ma_h_handler,ma_l_handler,atr_handler,scenes,b_matrix_scenes;
double ma_h[],ma_l[],atr[];
matrix snapshots,OB_SIGMA,OB_VT,OB_U,b_vector,b_matrix;
vector S,prediction;
vector account_state;
bool predict,permission;

//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade      Trade;

Time        *DailyTimeHandler;
TradeInfo   *TradeInfoHandler;

//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   DailyTimeHandler  = new Time(Symbol(),PERIOD_D1);
   TradeInfoHandler  = new TradeInfo(Symbol(),PERIOD_D1);
   ma_h_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_HIGH);
   ma_l_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_LOW);
   atr_handler       = iATR(Symbol(),PERIOD_D1,14);
   snapshots         = matrix::Ones(FEATURES,OBSERVATIONS);
   scenes            = 0;
   b_matrix_scenes   = 0;
   account_state     = vector::Zeros(3);
   b_matrix          = matrix::Zeros(1,1);
   prediction        = vector::Zeros(2);
   predict           = false;
   permission        = true;
//---
   return(INIT_SUCCEEDED);
  }
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   delete DailyTimeHandler;
   delete TradeInfoHandler;
   IndicatorRelease(ma_h_handler);
   IndicatorRelease(ma_l_handler);
   IndicatorRelease(atr_handler);
  }
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(DailyTimeHandler.NewCandle())
     {
      CopyBuffer(ma_h_handler,0,0,1,ma_h);
      CopyBuffer(ma_l_handler,0,0,1,ma_l);
      CopyBuffer(atr_handler,0,0,1,atr);
      double c = iClose(Symbol(),PERIOD_D1,0);

      if(PositionsTotal() == 0)
        {
         account_state = vector::Zeros(ACCOUNT_STATES);

         if(c > ma_h[0])
           {
            if(!predict)
              {
               if(permission)
                  Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");
              }

            account_state[0] = 1;
           }

         else
            if(c < ma_l[0])
              {
               if(!predict)
                 {
                  if(permission)
                     Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
                 }

               account_state[1] = 1;
              }

            else
              {
               account_state[2] = 1;
              }
        }

      if(scenes < OBSERVATIONS)
        {
         take_snapshots();
        }

      else
        {
         matrix temp;
         temp.Assign(snapshots);
         snapshots = matrix::Ones(FEATURES,scenes+1);

         //--- The first row is the intercept and must be full of ones
         for(int i=0;i<FEATURES;i++)
            snapshots.Row(temp.Row(i),i);

         take_snapshots();
         fit_snapshots();

         predict = true;
         permission = false;
        }
      scenes++;
     }
  }

//+------------------------------------------------------------------+
//| Record the current state of our system                           |
//+------------------------------------------------------------------+
void take_snapshots(void)
  {
   snapshots[1,scenes] = iOpen(Symbol(),PERIOD_D1,1);
   snapshots[2,scenes] = iHigh(Symbol(),PERIOD_D1,1);
   snapshots[3,scenes] = iLow(Symbol(),PERIOD_D1,1);
   snapshots[4,scenes] = iClose(Symbol(),PERIOD_D1,1);
   snapshots[5,scenes] = AccountInfoDouble(ACCOUNT_BALANCE);
   snapshots[6,scenes] = AccountInfoDouble(ACCOUNT_EQUITY);
   snapshots[7,scenes] = ma_h[0];
   snapshots[8,scenes] = ma_l[0];
   snapshots[9,scenes] = account_state[0];
   snapshots[10,scenes] = account_state[1];
   snapshots[11,scenes] = account_state[2];
  }
//+------------------------------------------------------------------+

//+------------------------------------------------------------------+
//| Fit our linear model to our collected snapshots                  |
//+------------------------------------------------------------------+
void fit_snapshots(void)
  {
   matrix X,y;
   X.Reshape(FEATURES,scenes);
   y.Reshape(FEATURES-1,scenes);

   for(int i=0;i<scenes;i++)
     {
      X[0,i] = snapshots[0,i];
      X[1,i] = snapshots[1,i];
      X[2,i] = snapshots[2,i];
      X[3,i] = snapshots[3,i];
      X[4,i] = snapshots[4,i];
      X[5,i] = snapshots[5,i];
      X[6,i] = snapshots[6,i];
      X[7,i] = snapshots[7,i];
      X[8,i] = snapshots[8,i];
      X[9,i] = snapshots[9,i];
      X[10,i] = snapshots[10,i];
      X[11,i] = snapshots[11,i];

      y[0,i] = snapshots[1,i+1];
      y[1,i] = snapshots[2,i+1];
      y[2,i] = snapshots[3,i+1];
      y[3,i] = snapshots[4,i+1];
      y[4,i] = snapshots[5,i+1];
      y[5,i] = snapshots[6,i+1];
      y[6,i] = snapshots[7,i+1];
      y[7,i] = snapshots[8,i+1];
      y[8,i] = snapshots[9,i+1];
      y[9,i] = snapshots[10,i+1];
      y[10,i] = snapshots[11,i+1];
     }

//--- Find optimal solutions
   b_vector = y.MatMul(X.PInv());
   Print("Day Number: ",scenes+1);
   Print("Snapshot");
   Print(snapshots);
   Print("Input");
   Print(X);
   Print("Target");
   Print(y);
   Print("Coefficients");
   Print(b_vector);
   Print("Prediciton");
   Print(y.Col(scenes-1));
   prediction = b_vector.MatMul(snapshots.Col(scenes-1));

   if(prediction[4] > AccountInfoDouble(ACCOUNT_BALANCE))
      permission = true;

   else
      if((account_state[0] == 1) && (prediction[6] > ma_h[0]))
         permission = true;

      else
         if((account_state[1] == 1) && (prediction[7] < ma_l[0]))
            permission = true;

         else
            permission = false;

   if(permission)
     {
      if(PositionsTotal() == 0)
        {
         if(account_state[0] == 1)
            Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");

         else
            if(account_state[1] == 1)
               Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
        }
     }

   Print("Current Balabnce: ",AccountInfoDouble(ACCOUNT_BALANCE)," Predicted Balance: ",prediction[4]," Permission: ",permission);
  }
//+------------------------------------------------------------------+
O período de teste da aplicação é outro parâmetro importante que deve permanecer inalterado em todas as avaliações. Na discussão anterior, realizamos o backtest da estratégia de 1º de janeiro de 2020 até 2025. Portanto, manteremos esse mesmo intervalo em todos os testes.
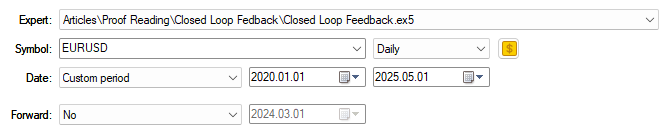
Figura 3: Período de teste utilizado na discussão inicial sobre controladores com realimentação
A captura de tela abaixo apresenta os resultados de desempenho obtidos anteriormente pelo controlador com realimentação. No início da nossa discussão, incluímos essa imagem para que o leitor pudesse comparar os resultados anteriores com os níveis de desempenho que pretendemos alcançar neste artigo.
Na introdução, já apresentamos uma análise detalhada das principais diferenças entre os resultados obtidos anteriormente e aqueles que buscamos alcançar agora. A captura de tela é reproduzida aqui para permitir que o leitor interprete os resultados por conta própria.
Figura 4: Análise detalhada dos indicadores de desempenho obtidos durante o backtest de cinco anos da nossa estratégia de referência
A curva de capital apresentada abaixo demonstrou um potencial promissor durante nossa discussão inicial. No entanto, como o leitor poderá observar, um dos exemplos analisados neste artigo permitiu acelerar o crescimento do capital e alcançar uma rentabilidade consideravelmente superior à obtida anteriormente.
Figura 5: A curva de capital obtida com a versão original do controlador com realimentação já atendia aos nossos requisitos
Padronização pelo escore Z (transformação estatística padrão)
A padronização pelo escore Z (z-score) é um método estatístico amplamente utilizado e geralmente considerado um bom ponto de partida para o tratamento de qualquer conjunto de dados. Seu objetivo é colocar os atributos em escalas comparáveis, preservando as diferenças relativas entre as observações. Isso permite que o modelo realize comparações significativas e consistentes entre os indicadores de crescimento.Sem levar em conta as diferenças de escala, o modelo pode produzir estimativas desproporcionais do crescimento em cada coluna e de sua influência sobre a variável-alvo. A padronização pelo z-score resolve esse problema subtraindo a média de cada coluna dos respectivos valores e dividindo os resultados pelo desvio-padrão dessa coluna. Com isso, cada coluna passa a apresentar média zero e desvio-padrão igual a um.
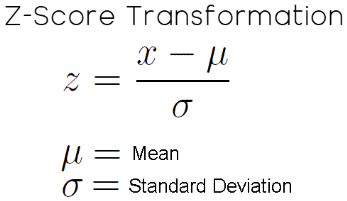
Figura 6: Fórmula matemática da padronização estatística pelo escore Z aplicada aos dados de entrada do nosso controlador com realimentação
   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- Z-Score
       X = ((X - X.Mean())/X.Std());
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
Conforme indicado na introdução deste artigo, manteremos o mesmo período em todas as avaliações. Como mostra a Figura 3 acima, utilizaremos os dados de 1º de janeiro de 2020 a maio de 2025.
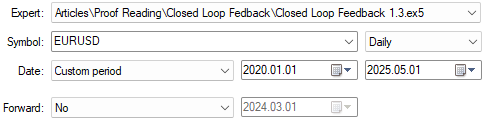
Figura 7: O período de backtest indicado acima será mantido em todos os testes
Como mencionado anteriormente, a padronização pelo z-score não melhorou nossos resultados durante o período de teste de aproximadamente cinco anos. Na realidade, essa transformação afetou negativamente todos os nossos principais indicadores de desempenho.
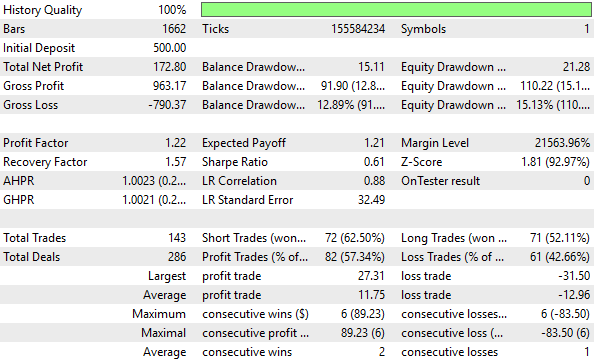
Figura 8: A análise detalhada dos indicadores de desempenho obtidos com a transformação z-score não revelou melhorias significativas
O modelo de referência analisado anteriormente apresenta rentabilidade superior à observada na curva de capital abaixo, obtida após a aplicação dessa transformação. Portanto, podemos concluir que a transformação pelo z-score provocou a perda do sinal presente nos dados originais.
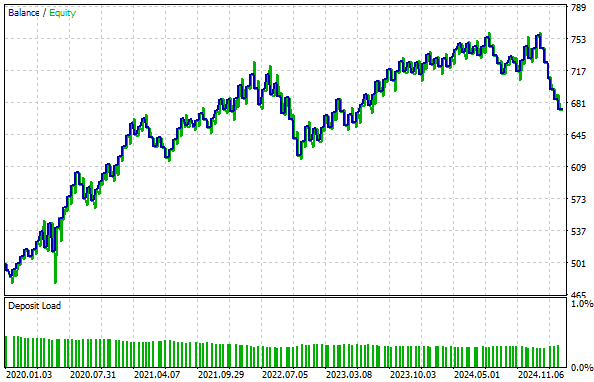
Figura 9: A curva de capital obtida com a transformação pelo z-score não conseguiu superar a curva de capital da configuração de referência
Normalização para norma unitária (transformação padrão de álgebra linear)
O conceito de normalização para norma unitária tem origem na álgebra linear. Para compreendê-lo plenamente, é necessário apresentar alguns fundamentos, pois, nesta análise, utilizaremos essa técnica de uma maneira diferente de sua aplicação convencional. Por isso, começaremos com uma breve explicação para os leitores que talvez estejam entrando em contato com esse conceito pela primeira vez.
Quando temos uma lista de números, por exemplo, um array simples em MQL5 contendo 10 valores, existem várias maneiras de avaliar o quanto esse array é "grande". Na álgebra linear, essa medida é chamada de norma de um objeto. Esse objeto pode ser um vetor ou uma matriz, mas, neste exemplo, consideraremos apenas um array de números. Daqui em diante, utilizarei os termos "array" e "vetor" como sinônimos, pois, neste contexto, representam o mesmo conceito.
Existem várias maneiras de determinar o tamanho de um array:
- Podemos considerar a quantidade de elementos que ele contém atualmente.
- Outra possibilidade é avaliar sua capacidade máxima de armazenamento, ou seja, quantos elementos ele pode comportar quando estiver completamente preenchido.
- Por fim, também podemos medir seu tamanho somando os valores de todos os elementos que contém.
Para evitar esse problema, podemos aplicar transformações aos valores antes de somá-los. Por exemplo, podemos calcular o valor absoluto de cada número ou elevar os valores ao quadrado antes da soma. Essas diferentes abordagens fazem parte de uma família de normas conhecida como normas Lp.
Uma norma importante dessa família é a norma L1, definida simplesmente como a soma dos valores absolutos de todos os elementos do array. Sua representação matemática é apresentada na Figura 10 abaixo.
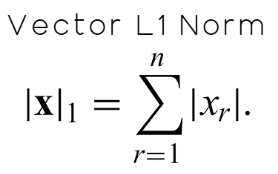
Figura 10: Definimos a norma L1 de um vetor como a soma dos valores absolutos de todos os seus elementos.
Depois de calcular a norma L1, podemos dividir cada elemento do array por esse valor. Na álgebra linear, esse procedimento é chamado de normalização e produz um vetor normalizado cuja norma passa a ser igual a 1. Isso significa que, ao calcular novamente a norma desse vetor, obteremos exatamente uma unidade.
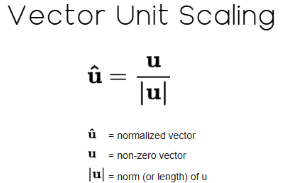
Figura 11: A multiplicação de um vetor por um fator de escala constante é uma transformação padrão da álgebra linear.
Para vetores, esse procedimento é relativamente simples. No entanto, nosso caso é um pouco diferente, pois estamos trabalhando com uma matriz, e não apenas com um vetor. Vale lembrar que, conforme mencionamos no início da discussão, nossa matriz de dados X contém 12 atributos. Nesse contexto, precisamos utilizar a norma L1 da matriz, que difere da norma L1 de um vetor, embora os dois conceitos estejam relacionados.
De acordo com a documentação do MQL5 vigente na época da elaboração deste artigo, a norma L1 de uma matriz é definida da seguinte maneira: "MATRIX_NORM_P1 é a maior norma p1 entre os vetores-linha da matriz".
Embora essa definição seja precisa, ela pode não parecer muito intuitiva à primeira vista, especialmente para leitores que estão entrando em contato com o assunto pela primeira vez. Por isso, podemos traduzi-la em um procedimento mais prático. Primeiro, calculamos a norma L1 de cada linha da matriz. Em seguida, identificamos a linha que apresenta a maior norma L1. Esse valor máximo corresponde à norma L1 da matriz. Essa definição consta da documentação do MQL5 e pode ser expressa matematicamente pela notação apresentada na Figura 12 abaixo:
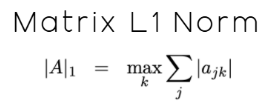
Figura 12: A norma L1 de uma matriz difere da norma L1 de um vetor, embora os dois conceitos estejam relacionados
Após calcular a norma L1, dividimos cada coluna do conjunto de dados por esse valor, aplicando assim uma forma de normalização para norma unitária aos dados.
   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- We Must Take The Additional Steps Needed To Standardize & Scale Our Inputs
       X = X/X.Norm(MATRIX_NORM_P1);
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
Conforme mencionado anteriormente, utilizaremos o mesmo período em todos os testes para garantir a objetividade da comparação.
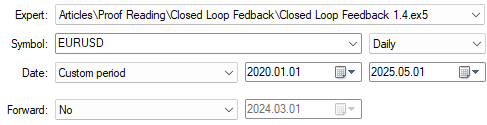
Figura 13: O número de dias utilizados nos backtests permaneceu inalterado em todos os exemplos
Como o leitor já sabe, a alteração do escalonamento dos blocos de dados melhorou significativamente nossos indicadores de desempenho em relação aos valores de referência, levando-os a níveis que não havíamos alcançado anteriormente. Essa transformação claramente permitiu extrair mais informações úteis dos dados, ajudando nosso modelo a identificar padrões mais relevantes. Nem todas as transformações produzirão esse resultado, mas, quando isso acontece, os ganhos são concretos. E são justamente essas melhorias mensuráveis que realmente importam.
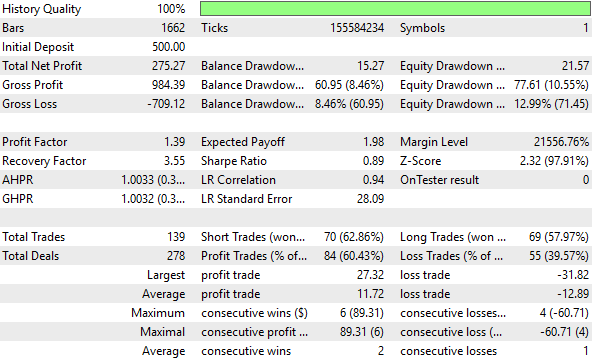
Figura 14: Análise detalhada dos indicadores de desempenho alcançados pelo nosso controlador com realimentação aprimorado
Ao analisar a curva de capital obtida, podemos observar que nossa rentabilidade agora atinge máximos de 800, níveis que não conseguíamos alcançar com a estratégia anterior. Além disso, conforme mencionado na introdução, o tempo necessário para aumentar o saldo da conta de 500 para 700 diminuiu quase um terço, representando uma aceleração significativa do crescimento.
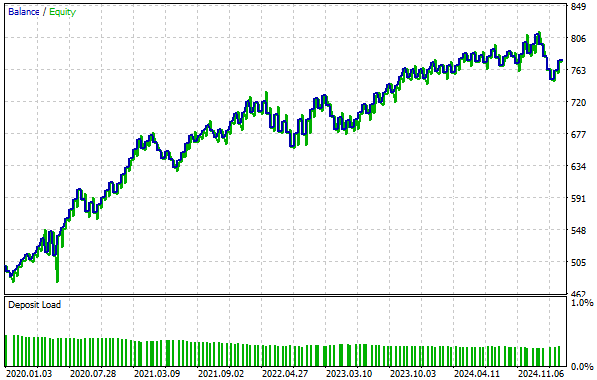
Figura 15: A nova curva de capital apresenta um crescimento ainda mais rápido do que o controlador com realimentação original utilizado como referência
Abordagem híbrida (normalização para norma unitária e padronização pelo escore Z)
Nesta etapa do artigo, conforme já destacamos na introdução, ainda não existem regras formalizadas para a escolha das transformações de dados. Nesse campo, a busca exaustiva entre diferentes alternativas é uma abordagem plenamente justificável, pois praticamente não temos outra opção além de experimentar diferentes transformações e avaliar seu desempenho. Partindo dessa premissa, tentamos combinar as duas técnicas na expectativa de obter resultados ainda mais expressivos.
  if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- We Must Take The Additional Steps Needed To Standardize & Scale Our Inputs
       X = X/X.Norm(MATRIX_NORM_P1);
       X = ((X-X.Mean())/X.Std());
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
Infelizmente, essa abordagem híbrida não se mostrou rentável em termos gerais. Embora inicialmente parecesse promissora, a combinação das duas transformações prejudicou todos os nossos principais indicadores de desempenho.
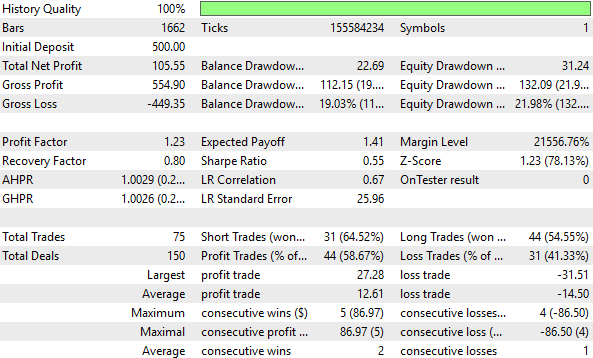
Figura 16: Nossa abordagem híbrida apresentou os piores indicadores de desempenho entre todos os resultados observados durante este teste
Embora o percentual de operações lucrativas do modelo híbrido tenha aumentado ligeiramente, de 57,24% para 58,67%, essa diferença não representa uma melhoria significativa. Além disso, a curva de capital da estratégia híbrida permaneceu restrita à faixa de 500 a 600, sem apresentar crescimento sustentado do saldo da conta ao longo do tempo. Portanto, podemos concluir que essa transformação distorceu o sinal presente nos dados de entrada, impedindo que nosso modelo continuasse a identificar relações significativas.
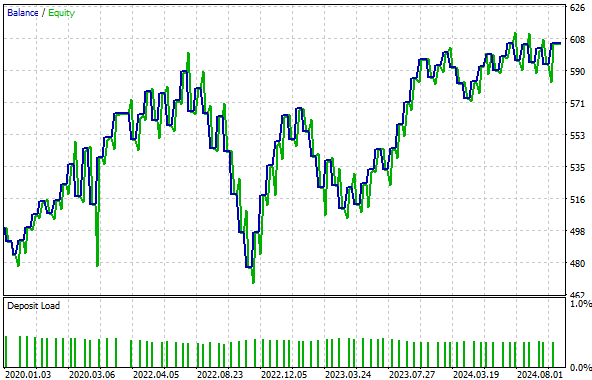
Figura 17: A curva de capital obtida deixou de crescer e parece ter ficado estagnada em um regime de perdas
Conclusão
Ao final desta discussão, esperamos que o leitor tenha desenvolvido uma nova compreensão das técnicas de pré-processamento aplicadas aos dados fornecidos aos nossos modelos de aprendizado de máquina. Espero que, a partir de agora, o leitor reconheça essa etapa do pipeline de aprendizado de máquina como um parâmetro de ajuste extremamente importante, que deve ser explorado com especial atenção e persistência para que seja possível aproveitar plenamente seu potencial.
Existem inúmeras transformações que podem ser aplicadas a um conjunto de dados e, infelizmente, muitas vezes não sabemos qual delas será a mais adequada, nem sempre conseguimos determinar se determinada transformação realmente traz benefícios. No entanto, ao estabelecer um nível de desempenho de referência e avaliar sistematicamente novas abordagens em relação a ele, podemos identificar estruturas e padrões que talvez estivessem ocultos nos dados originais.
Por isso, também é importante que o leitor conheça o maior número possível de transformações, experimente diferentes abordagens e identifique aquelas que realmente melhoram os resultados.
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19382
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.