EAs com auto-otimização em MQL5 (Parte 12): Construção de classificadores lineares por meio da fatoração de matrizes
 21
 0

A fatoração de matrizes é uma ferramenta importante para profissionais de trading algorítmico interessados em desenvolver aplicações baseadas em métodos numéricos. Ela permite implementar diferentes tipos de algoritmos de machine learning, entre outras aplicações. Até agora, nossa discussão se concentrou em problemas de regressão. Vamos passar à classificação. Neste artigo, tentaremos desenvolver um classificador capaz de distinguir movimentos de alta e de baixa do mercado. A ideia é usar essas informações para orientar a abertura de posições. Com base no histórico de comportamento do mercado, o classificador deverá indicar qual decisão tomar em determinado dia de negociação.
Nossa estratégia de negociação funciona da seguinte maneira. Queremos prever os movimentos do mercado a partir do comportamento esperado de uma média móvel. Além disso, esperamos que o preço acompanhe a direção desse indicador. Assim, se nosso modelo de classificação prever uma queda da média móvel, também queremos observar os preços caindo abaixo dela. Quando a previsão indicar queda tanto da média móvel quanto do preço, abriremos posições de venda. A média móvel indica a direção do movimento do preço, mas, antes de abrir uma posição, também queremos que o preço caia rapidamente para abaixo da média móvel.
A mesma lógica se aplica às posições compradas. Queremos que a média móvel comece a subir e que a alta dos preços se acelere acentuadamente, levando-os para níveis bem acima da média móvel. Só então abriremos uma posição de compra.
Como podemos observar, nosso modelo fará previsões simultâneas para duas variáveis categóricas. No entanto, isso não deve ser confundido com um modelo de classificação multiclasse. Cada uma das duas variáveis previstas pelo modelo representa um resultado binário. Em outras palavras, o modelo acompanha dois resultados binários distintos. A arquitetura que apresentaremos aqui não é adequada para classificar simultaneamente mais de duas classes.
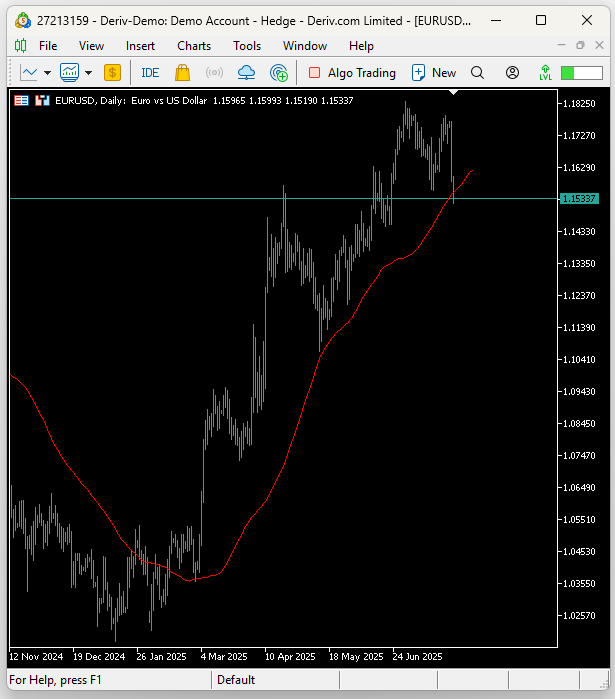
Figura 1: Visualização da nossa estratégia de negociação em ação
Fatoração de matrizes para a construção de classificadores lineares
Como na maioria das nossas aplicações de trading, começaremos definindo os parâmetros do sistema. Neste caso específico, teremos seis valores de entrada, que acompanharemos na nossa matriz de dados de entrada X.
//+------------------------------------------------------------------+
//|                                            Linear Regression.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"
//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
#define TOTAL_INPUTS 6
Prosseguindo, depois de definir as configurações do sistema, vamos especificar os parâmetros que o usuário final poderá ajustar. Em particular, queremos permitir que ele escolha o período gráfico e o tamanho do stop-loss.
//+------------------------------------------------------------------+
//| System Inputs                                                    |
//+------------------------------------------------------------------+
int bars = 200;//Number of historical bars to fetch
int horizon = 1;//How far into the future should we forecast
int MA_PERIOD = 50; //Moving average period
ENUM_TIMEFRAMES TIME_FRAME = PERIOD_D1;//User Time Frame
input ENUM_TIMEFRAMES RISK_TIME_FRAME = PERIOD_D1;
input double sl_size = 2;
Também precisaremos incluir algumas bibliotecas essenciais ao funcionamento do sistema, como a biblioteca de negociação e duas bibliotecas personalizadas que desenvolvi para acompanhar o tempo e obter informações importantes para as operações.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
Além disso, precisaremos declarar algumas variáveis globais essenciais para o funcionamento do nosso exemplo. Algumas delas armazenarão os handles dos indicadores técnicos, enquanto outras permitirão acompanhar os dados de entrada e saída à medida que forem recebidos do mercado. Também precisaremos de buffers para obter os valores atuais dos indicadores técnicos.
//+------------------------------------------------------------------+
//| Global Variables                                                 |
//+------------------------------------------------------------------+
int        ma_close_handler;
double     ma_close[];
Time       *Timer;
TradeInfo  *TradeInformation;
vector     bias,temp,Z1,Z2;
matrix     X,y,prediction,b;
int        time;
CTrade Trade;
int state;
int atr_handler;
double atr[];
Na primeira execução do sistema, será chamado o método especial initialize, responsável por inicializar todas as variáveis do sistema.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   initialize();
//---
   return(INIT_SUCCEEDED);
  }
Quando o sistema deixar de ser utilizado, liberaremos a memória alocada para os indicadores técnicos.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   IndicatorRelease(atr_handler);
   IndicatorRelease(ma_close_handler);
  }
Sempre que surgirem novas velas com preços atualizados, chamaremos dois componentes específicos. primeiro, o método setup e, depois, o módulo findSetup. Examinaremos ambos em detalhes mais adiante.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(Timer.NewCandle())
     {
      setup();
      find_setup();
     }
  }
Durante a inicialização do sistema, criaremos novas instâncias dos objetos auxiliares e as associaremos aos respectivos identificadores. Por exemplo, criaremos dinamicamente um objeto da nossa biblioteca de tempo, responsável por acompanhar a formação das velas. Também criaremos um objeto da classe de informações de negociação. Vale lembrar que essa classe acompanha dados importantes, como o lote mínimo permitido para negociação no mercado atual e os preços Bid e Ask. Além disso, a função initialize é responsável por atribuir os valores padrão às nossas matrizes e aos identificadores associados.
//+------------------------------------------------------------------+
//| Initialize our system variables                                  |
//+------------------------------------------------------------------+
void initialize(void)
  {
   Timer                   = new Time(Symbol(),TIME_FRAME);
   TradeInformation        = new TradeInfo(Symbol(),TIME_FRAME);
   ma_close_handler        = iMA(Symbol(),TIME_FRAME,MA_PERIOD,0,MODE_SMA,PRICE_CLOSE);
   atr_handler             = iATR(Symbol(),RISK_TIME_FRAME,14);
   bias = vector::Ones(TOTAL_INPUTS);
   Z1 = vector::Ones(TOTAL_INPUTS);
   Z2 = vector::Ones(TOTAL_INPUTS);
   X = matrix::Ones(TOTAL_INPUTS,bars);
   y = matrix::Ones(1,bars);
   time = 0;
   state = 0;
  }
A função "find_setup()" é bem mais complexa do que as outras funções que examinamos até agora. Primeiro, findSetup acompanhará o preço de fechamento atual. Em seguida, copiaremos os valores atuais dos indicadores ATR e média móvel para os respectivos buffers. Depois disso, se não houver posições abertas, redefiniremos o estado do sistema. Agora, precisamos analisar a previsão gerada pelo nosso classificador linear.
Vale lembrar que nosso classificador modela dois sinais de saída simultaneamente. A primeira previsão indica a direção esperada do movimento futuro da média móvel, enquanto a segunda se refere à diferença entre o preço e a média móvel. Queremos, portanto, que essas duas previsões sejam coerentes entre si. Se a previsão indicar que a média móvel cairá, também queremos observar os preços caindo para níveis abaixo da média móvel. Da mesma forma, se a previsão indicar uma alta da média móvel, queremos que os preços subam acima dela.
Esses dois parâmetros constituem a base da nossa estratégia de negociação. Para abrir uma posição de compra, ambas as previsões precisam ser superiores a 0,5. Da mesma forma, para abrir uma posição de venda, ambas devem ser inferiores a 0,5. Caso essas condições não sejam atendidas e já existam posições abertas, apenas acompanharemos o estado dessas posições e as previsões do nosso classificador linear. Se tivermos uma posição de venda aberta, mas o modelo passar a prever uma alta da média móvel, fecharemos essa posição. A mesma lógica se aplica às posições de compra quando o modelo indicar uma queda da média móvel.
Se as condições permanecerem favoráveis, simplesmente ajustaremos o stop-loss para um nível mais vantajoso e manteremos a posição aberta.
//+------------------------------------------------------------------+
//| Find a trading setup for our linear classifier model             |
//+------------------------------------------------------------------+
void find_setup(void)
  {
   double c =  iClose(Symbol(),TIME_FRAME,0);
   CopyBuffer(atr_handler,0,0,1,atr);
   CopyBuffer(ma_close_handler,0,0,1,ma_close);

   if(PositionsTotal() == 0)
     {
      state = 0;
      if((prediction[0,0] > 0.5) && (prediction[1,0] > 0.5))
        {
         Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),(TradeInformation.GetBid() - (sl_size * atr[0])),0);
         state = 1;
        }
      if((prediction[0,0] < 0.5) && (prediction[1,0] < 0.5))
        {
         Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),(TradeInformation.GetAsk() + (sl_size * atr[0])),0);
         state = -1;
        }
     }

   if(PositionsTotal() > 0)
     {
      if(((state == -1) && (prediction[0,0] > 0.5)) || ((state == 1)&&(prediction[0,0] < 0.5)))
         Trade.PositionClose(Symbol());
      if(PositionSelect(Symbol()))
        {
         double current_sl = PositionGetDouble(POSITION_SL);

         if((state == 1) && ((ma_close[0] - (2 * atr[0]))>current_sl))
           {
            Trade.PositionModify(Symbol(),(ma_close[0] - (2 * atr[0])),0);
           }

         else
            if((state == -1) && ((ma_close[0] + (2 * atr[0]))<current_sl))
              {
               Trade.PositionModify(Symbol(),(ma_close[0] + (2 * atr[0])),0);
              }
        }
     }
  }
Dispomos de métodos específicos para treinar nosso classificador linear. O método de ajuste, apresentado a seguir, permite ajustar o modelo aos nossos dados, relacionando os dados de entrada dos preços históricos às duas variáveis-alvo que queremos acompanhar. Vale lembrar que utilizamos a decomposição em valores singulares (SVD), disponível na biblioteca OpenBLAS, para fatorar rapidamente nosso modelo, permitindo calcular os coeficientes ótimos e armazená-los no array B.
//+------------------------------------------------------------------+
//| Fir our classification model                                     |
//+------------------------------------------------------------------+
void fit(void)
  {
//--- Fit the model
   matrix OB_U,OB_VT,OB_SIGMA;
   vector OB_S;
   X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
   OB_SIGMA.Diag(OB_S);
   b = y.MatMul(OB_VT.Transpose().MatMul(OB_SIGMA.Inv()).MatMul(OB_U.Transpose()));
  }
Como sempre, a extração e o armazenamento de dados são etapas importantes de qualquer modelo de machine learning. Para cada registro dos nossos dados, subtrairemos a média e dividiremos o resultado pelo desvio-padrão.
Por exemplo, queremos acompanhar os preços de abertura, máxima e mínima, além dos valores dos indicadores técnicos. Antes de armazenar esses valores na matriz de dados X, precisamos subtrair a média de cada um deles e dividir o resultado pelo desvio-padrão.
Em seguida, depois de copiar e transformar nossa matriz Y, precisamos armazenar os resultados como zeros, para representar quedas dos preços, ou como uns, para representar altas. É assim que construímos nosso modelo de classificação.
//+------------------------------------------------------------------+
//| Prepare the data needed for our classifier                       |
//+------------------------------------------------------------------+
void fetch_data(void)
  {
//--- Reshape the matrix
   X = matrix::Ones(TOTAL_INPUTS,bars);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,horizon,bars);
   Z1[0] = temp.Mean();
   Z2[0] = temp.Std();
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,horizon,bars);
   Z1[1] = temp.Mean();
   Z2[1] = temp.Std();
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,horizon,bars);
   Z1[2] = temp.Mean();
   Z2[2] = temp.Std();
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,horizon,bars);
   Z1[3] = temp.Mean();
   Z2[3] = temp.Std();
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

//--- Store the Z-scores
   temp.CopyIndicatorBuffer(ma_close_handler,0,horizon,bars);
   Z1[4] = temp.Mean();
   Z2[4] = temp.Std();
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

//--- Reshape the output target
   y.Reshape(2,bars);
   vector temp_2,temp_3,temp_4;

//--- Prepare to label the target accordingly
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,horizon,bars);
   temp_4.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,bars);

   temp_2.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,bars);
   temp_3.CopyIndicatorBuffer(ma_close_handler,0,0,bars);

   for(int i=0;i<bars;i++)
     {
      //--- Record if price levels appreciated or depreciated
      if(temp[i] > temp_4[i])
         y[0,i] = 0;
      else
         if(temp[i] < temp_4[i])
            y[0,i] = 1;

      //--- Record if price levels remained above the moving average indicator, or fell beneath it.
      if(temp_2[i] < temp_3[i])
         y[1,i] = 0;
      if(temp_2[i] > temp_3[i])
         y[1,i] = 1;
     }

   Print("Training Input Data: ");
   Print(X);

   Print("Training Target");
   Print(y);
  }
Agora estamos prontos para gerar previsões com nosso modelo de classificação. Para isso, basta utilizar a última linha da matriz de dados de entrada X. Podemos entendê-la como uma representação das condições atuais do mercado. Multiplicamos esses dados pelos coeficientes calculados a partir do histórico e obtemos a previsão.
//+------------------------------------------------------------------+
//| Obtain a prediction from our classification model                |
//+------------------------------------------------------------------+
void predict(void)
  {
//--- Prepare to get a prediction
//--- Reshape the data
   X = matrix::Ones(TOTAL_INPUTS,1);

//--- Get a prediction
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,0,1);
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,0,1);
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,0,1);
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,1);
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

   temp.CopyIndicatorBuffer(ma_close_handler,0,0,1);
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

   Print("Prediction Inputs: ");
   Print(X);

//--- Get a prediction
   prediction = b.MatMul(X);
   Print("Prediction");
   Print(prediction);
  }
No entanto, chamar cada um desses métodos separadamente pode ser trabalhoso. Por isso, desenvolvemos um método setup específico, que chama os três métodos na sequência necessária. Primeiro, carregamos os dados. Depois, ajustamos o modelo a esses dados. Por fim, geramos a previsão.
Esse método simples de configuração permite executar as três etapas, sempre na ordem correta.
//+------------------------------------------------------------------+
//| Obtain a prediction from our model                               |
//+------------------------------------------------------------------+
void setup(void)
  {
   fetch_data();
   fit();
   predict();
  }
//+------------------------------------------------------------------+
Por último, precisamos padronizar as definições do sistema que estabelecemos no início do desenvolvimento da nossa aplicação.
#undef TOTAL_INPUTS Nosso backtest começará em janeiro de 2020 e abrangerá um período de cinco anos, até 2025, no período gráfico diário. Testaremos nossa aplicação no par EURUSD.
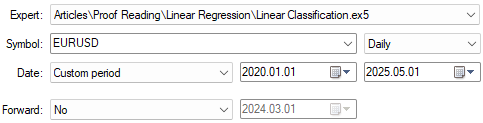
Figura 2: Seleção dos dias para o backtest e a otimização
Além disso, para obter resultados tão precisos quanto possível, sempre utilizamos atrasos aleatórios, buscando reproduzir no teste condições próximas às do mercado real que esperamos encontrar no futuro.
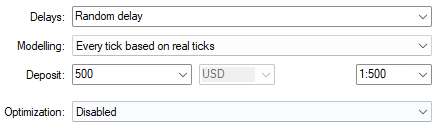
Figura 3: Também é importante escolher corretamente as condições do backtest
Fiz uma captura de tela mostrando os indicadores de desempenho da nossa aplicação durante o backtest. Como podemos observar, a aplicação exibe os dados de entrada utilizados para gerar as previsões. Vale lembrar que o primeiro atributo é sempre igual a um e representa o termo independente do modelo (intercept). No entanto, nosso principal interesse está nas previsões geradas pelo modelo.
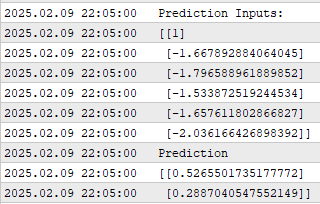
Figura 4: Resultado obtido ao executar nosso algoritmo de classificador linear
Como já mencionamos, nosso modelo produz duas previsões. A primeira se refere à direção esperada do movimento futuro da média móvel, enquanto a segunda se refere à mudança na posição relativa do preço em relação à média móvel. Vale lembrar que queremos que ambos os movimentos ocorram na mesma direção.
Também podemos examinar a curva de capital gerada pela nossa estratégia de negociação. Como podemos observar, essa curva apresenta uma tendência de alta ao longo do tempo, embora com algumas oscilações.
É importante observar que o gráfico apresenta duas linhas. A linha azul representa a evolução do saldo da conta (balance), enquanto a linha verde mostra a evolução do patrimônio líquido da conta (equity). Em vários momentos, podemos ver a linha verde subir acentuadamente acima da linha azul.
Pela minha experiência, isso indica oportunidades de lucro não aproveitadas ou sinais que nossa estratégia de negociação ainda não consegue identificar. Em outras palavras, a estratégia deixa passar oportunidades que poderiam gerar resultados positivos. Isso mostra que ainda há espaço para aprimorá-la.
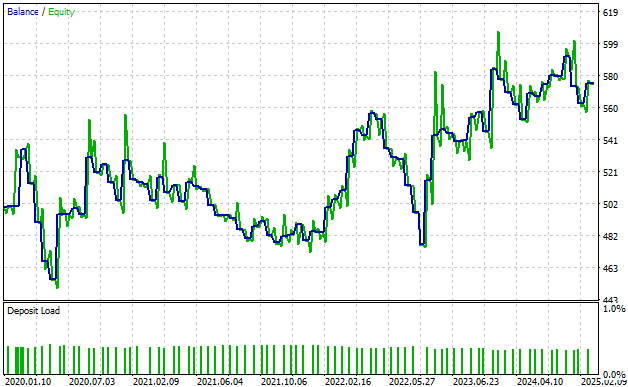
Figura 5: Nossa curva de capital indica que ainda estamos deixando escapar algum sinal importante.
Por fim, podemos examinar as estatísticas detalhadas dos resultados obtidos durante o período analisado. Como podemos observar, o lucro médio das operações vencedoras supera o prejuízo médio das operações perdedoras. O maior lucro obtido com a estratégia também supera sua maior perda, o que é um resultado animador.
Entretanto, quando analisamos a proporção de operações vencedoras, vemos que ela é de apenas 43%, ou seja, menos da metade. Isso reforça a observação feita anteriormente ao examinarmos a curva de capital, quando observamos picos de lucro que o sistema não conseguiu aproveitar.
Esses resultados reforçam nossa convicção de que ainda podemos melhorar o sistema, pois existem informações que ainda não estamos conseguindo captar. Embora seja um bom começo, ainda há muitos sinais que podemos identificar e analisar.
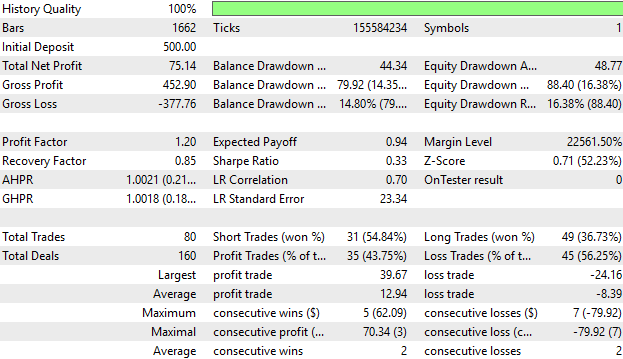
Figura 6: As estatísticas detalhadas do nosso desempenho confirmam as conclusões anteriores de que o sistema precisa ser aprimorado
Conclusão
Ao longo deste artigo, demonstramos diversas possibilidades de aplicação da fatoração de matrizes que nós, profissionais de trading algorítmico, podemos aproveitar em nossas aplicações MQL5. Quando começamos a estudar a fatoração de matrizes, tratamos essa técnica como uma ferramenta para análise de regressão. Agora, vimos que ela também pode ser utilizada em problemas de classificação.
Mas faço apenas uma promessa ao leitor: ainda temos muito a explorar. O que vimos até aqui são apenas os fundamentos. Na minha avaliação, esses exemplos simples demonstram rapidamente a utilidade prática da fatoração de matrizes. Se você acompanhou esta série de artigos, agora sabe como construir um modelo de regressão, um modelo de classificação ou combinar ambos usando fatoração de matrizes. Também já sabe como desenvolver modelos que não se limitam a prever uma única variável por vez, mas conseguem gerar previsões para várias variáveis-alvo simultaneamente.
E posso garantir a você, leitor, que a fatoração de matrizes oferece muitas outras vantagens que ainda não abordamos. Antes de explorá-las, porém, precisamos dominar os fundamentos. Você também pôde perceber como tudo isso se torna simples graças às funções específicas disponíveis na API MQL5 e como é fácil integrar esses poderosos métodos matriciais às suas aplicações de trading.
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18987
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.