MQL5自优化智能交易系统(第十四部分):将数据变换视为反馈控制器的可调参数
 23
 0

在任意机器学习框架与流水线中,数据预处理都是功能强大、却常常被忽略的调参项。
它是流水线中一个重要的控制旋钮,却总是淹没在其他模块的光环之中。研究重心大多落在优化器或者新潮的模型架构上,大量学术资源都投入到这些方向。而针对预处理技术效果的研究却寥寥无几。
我们施加在数据上的预处理操作,会以超乎想象的方式潜移默化地影响模型性能。哪怕预处理带来的提升幅度很小,效果也会随时间不断累积,实质性改变交易程序的盈利水平与风险表现。
很多时候我们仓促地完成预处理工作,不愿花足够精力去验证:当前输入数据采用的变换方案,是否真的是最优选择。
我们当下依赖的各类先进优化器与机器学习架构,其上限或潜力,其实都默默受制于数据变换方式(也可以被合适的变换赋能)。遗憾的是,在撰写本文时,还没有成熟的框架能够证明某一种数据变换就是最优方案。不仅如此,我们也没有办法量化置信度,证明不存在效果更好的替代变换。事实上,很少有研究尝试把多种变换组合成混合方案 —— 而这里恰恰蕴藏着尚未被挖掘的性能提升空间。
因此,我们的目标是提高此前讨论中共同搭建的反馈控制器的效率(链接见此处)。
除了单纯提升盈利水平之外,我们还希望观察风险的下降,以及交易程序表现出更稳健、某种意义上更成熟的交易行为。本质上,本次研究将数据预处理本身视作一个独立调参项 —— 如果处理得当,它能够显著改变交易系统的最终结果。
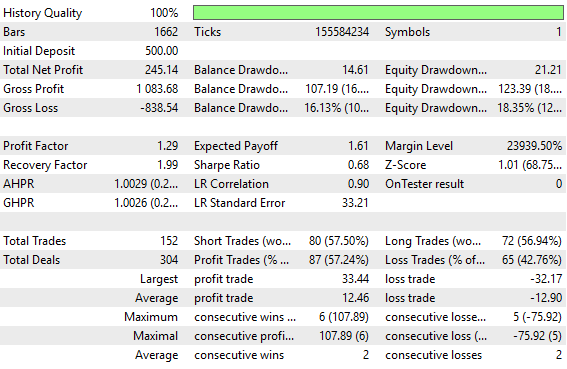
图1:旧版反馈控制器对应的历史回测统计面板
旧版反馈控制器在各项指标上的表现固然尚可,但本文将证明:花时间筛选合适的数据变换方式,有可能挖掘出策略中原本蛰伏的阿尔法收益 —— 这些信号此前一直未被有效提取出来。
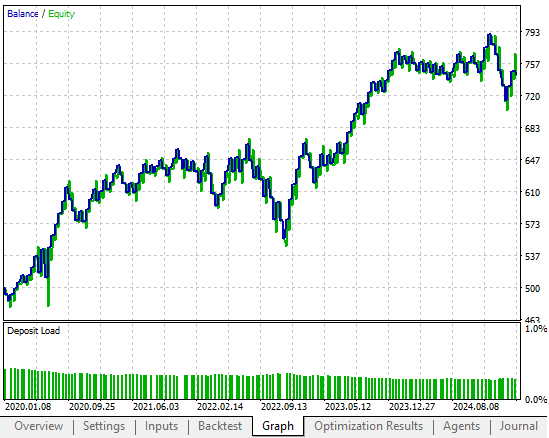
图2:我们计划超越的旧权益曲线,手段是为输入数据找到适配的变换方案
如果无法充分挖掘数据集内丰富的模式,资金就会随时间持续损耗。我们对输入反馈控制器的数据测试了三种不同的变换方法。同时设置对照组,直接采用前文原始未做变换的数据作为基准。后续对于每一种待评估变换,都在完全相同的历史数据上测试,其余所有变量保持不变。评估指标包含:盈利水平、夏普比率、交易总次数、总毛亏损和总胜率。这样可以隔离预处理带来的影响,保证三组测试公平对比。
第一种测试的变换是标准统计Z分数(z-score)。Z分数计算方式:每一列减去该列均值,再除以该列标准差。我们研究发现,该变换让盈利相比基准下降30%,从任何角度看都不理想。同时夏普比率相比基准大幅下滑10%。
因此,Z分数变换并不适合本场景。接下来我们采用一种源自线性代数的变换,也就是单位缩放(unit scaling),做法是矩阵除以其范数。在本示例中,选用矩阵的L1范数作为除数。经过L1范数缩放后,系统盈利相比基准提升12%,表现亮眼。除此之外,单位缩放还让夏普比率提升30%。
优质交易能力的标志之一,就是用更少的交易达成更高的收益。本次实验也符合这一点:单位缩放后,总交易次数下降8%,总亏损下降15%,最终,胜率提升5%。因此,这些结果让我们有充分的信心认为,单位缩放改善了反馈控制器的性能。
最后一组测试为Z分数与单位缩放的混合变换。遗憾的是,该组合抹除了单位缩放带来的全部增益。盈利相比基准暴跌58%,夏普比率下降19%。由此可见,尽管直觉上该组合似乎可行,但二者混合会破坏性能,也无法挖掘出可供模型学习的额外结构特征。
综上不难看出,在构建交易机器学习模型时,预处理不只是达成目标的附属手段。恰恰相反,预处理本身就是一套策略。变换方式的选择会潜移默化地影响机器学习模型的表现:重塑盈利、改变亏损,还会以不易察觉的方式改变风险敞口。
传统统计学习领域对此几乎没有成熟指导方案。除了基于数据划分做交叉验证的穷举试错之外,不存在公认的通用标准。这意味着我们需要投入精力对预处理链路做基准测试,并认清它的定位:它是机器学习流程里高杠杆的调参项。
这也鼓励其他研究者与撰稿人在本领域探索更多可用的数据变换方案。因为在图像识别和语音识别等领域中,从业者往往在预测前就搭建好一套稳健且广泛的转换流程,但在金融机器学习这类方向,我们常常很少花精力搭建稳健的预处理变换流水线。
在当前条件下,穷举测试是可行的研究思路。探索得越多,我们越能理解每一种变换在对应市场上的特性,从而有助于筛选出最优变换方案。
回顾当前基准版本
在开始之前,我们首先要回顾这套准备被超越的对照组系统。如果没有基准参照,任何优化工作都很难评估效果。因此,我们先快速回顾之前实现的初始反馈控制器。老读者应该对下面这段代码逻辑很熟悉,对于新读者,我会提炼这套程序以及前文讨论中的核心要点。
该应用依赖少量在整个运行周期内固定不变的系统参数定义,例如所用技术指标的周期、反馈控制器允许输出信号前需要观测的交易日数量和控制器接收的输入特征总数。在本案例中,反馈控制器一共接收12项输入特征。重要的是,在前一版示例中,这12个输入项没有做任何变换、标准化或者缩放处理。
该应用还依赖若干全局变量与库模块,包括:交易库(负责开平仓)、时间库(负责检测新 K 线)、交易信息库(读取最小手数、当前买卖价等信息)。
首次初始化时,应用会实例化自定义类库、创建技术指标,并为绝大多数全局变量赋予默认值。当停止使用时,应用会释放动态对象与技术指标资源。
调用OnTick函数时,系统首先判断是否已经形成一根完整K线。如果是,则用最新收盘价更新均线缓冲区。在无持仓的状态下,执行交易逻辑:由周期相同的上轨均线、下轨均线构成均线通道。价格向上突破通道上轨,执行买入;价格向下跌破通道下轨,执行卖出。如果未检测到信号,则保持观望,等待下一次信号。
在前90天内,系统几乎可以立即开始买卖。90天之后,所有交易必须拿到反馈控制器的预测许可。如果控制器确信这笔交易会盈利,就允许开仓;否则,便阻止系统交易。
这就是反馈控制器的核心逻辑:先采集90天数据,之后才向交易系统输出判断。在此基础上,我们定义了take_snapshots方法,周期性采集系统运行观测样本,以及fit_snapshots方法,基于样本求解线性解。求解完成后,系统就可以开展预测。
以上就是本交易策略的基准版本。
//+------------------------------------------------------------------+
//|                                         Closed Loop Feedback.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

/**
闭环反馈控制能够让我们学习如何管控系统的动态特性。

落地实操难度不小,但所有投入都很有价值。

有些任务,例如判断何时加大交易手数,很难用显式规则预先规划。

我们可以先在最小手数下完成比如20笔交易,再观察平均亏损规模。

以此估算单笔交易的预期平均亏损,再设定合理的盈利累积目标,达标之后再提升手数。这类数值我们往往无法提前预知。


除此之外,我们可以训练预测模型,让模型学习识别系统容易亏损的场景,避开亏损交易。

我们想要的这类模型,本质上并不是直接预测市场行情。

而是去捕捉固定策略与动态市场之间的关联关系。

在积累一定数量观测样本之后,只有当模型预判该策略接下来还会亏损时,才允许它输出信号,覆盖原有策略的决策。

这类算法未来或许可以帮我们实现真正无需调参的策略!

很高兴把这套思路分享给大家,但前路还有很多工作要做。
让我们展开具体实践。
**/

//+------------------------------------------------------------------+
//| System definitions                                               |
//+------------------------------------------------------------------+
#define MA_PERIOD    10
#define OBSERVATIONS 90
#define FEATURES     12
#define ACCOUNT_STATES 3

//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int    ma_h_handler,ma_l_handler,atr_handler,scenes,b_matrix_scenes;
double ma_h[],ma_l[],atr[];
matrix snapshots,OB_SIGMA,OB_VT,OB_U,b_vector,b_matrix;
vector S,prediction;
vector account_state;
bool predict,permission;

//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade      Trade;

Time        *DailyTimeHandler;
TradeInfo   *TradeInfoHandler;

//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   DailyTimeHandler  = new Time(Symbol(),PERIOD_D1);
   TradeInfoHandler  = new TradeInfo(Symbol(),PERIOD_D1);
   ma_h_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_HIGH);
   ma_l_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_LOW);
   atr_handler       = iATR(Symbol(),PERIOD_D1,14);
   snapshots         = matrix::Ones(FEATURES,OBSERVATIONS);
   scenes            = 0;
   b_matrix_scenes   = 0;
   account_state     = vector::Zeros(3);
   b_matrix          = matrix::Zeros(1,1);
   prediction        = vector::Zeros(2);
   predict           = false;
   permission        = true;
//---
   return(INIT_SUCCEEDED);
  }
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   delete DailyTimeHandler;
   delete TradeInfoHandler;
   IndicatorRelease(ma_h_handler);
   IndicatorRelease(ma_l_handler);
   IndicatorRelease(atr_handler);
  }
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(DailyTimeHandler.NewCandle())
     {
      CopyBuffer(ma_h_handler,0,0,1,ma_h);
      CopyBuffer(ma_l_handler,0,0,1,ma_l);
      CopyBuffer(atr_handler,0,0,1,atr);
      double c = iClose(Symbol(),PERIOD_D1,0);

      if(PositionsTotal() == 0)
        {
         account_state = vector::Zeros(ACCOUNT_STATES);

         if(c > ma_h[0])
           {
            if(!predict)
              {
               if(permission)
                  Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");
              }

            account_state[0] = 1;
           }

         else
            if(c < ma_l[0])
              {
               if(!predict)
                 {
                  if(permission)
                     Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
                 }

               account_state[1] = 1;
              }

            else
              {
               account_state[2] = 1;
              }
        }

      if(scenes < OBSERVATIONS)
        {
         take_snapshots();
        }

      else
        {
         matrix temp;
         temp.Assign(snapshots);
         snapshots = matrix::Ones(FEATURES,scenes+1);

         //--- The first row is the intercept and must be full of ones
         for(int i=0;i<FEATURES;i++)
            snapshots.Row(temp.Row(i),i);

         take_snapshots();
         fit_snapshots();

         predict = true;
         permission = false;
        }
      scenes++;
     }
  }

//+------------------------------------------------------------------+
//| Record the current state of our system                           |
//+------------------------------------------------------------------+
void take_snapshots(void)
  {
   snapshots[1,scenes] = iOpen(Symbol(),PERIOD_D1,1);
   snapshots[2,scenes] = iHigh(Symbol(),PERIOD_D1,1);
   snapshots[3,scenes] = iLow(Symbol(),PERIOD_D1,1);
   snapshots[4,scenes] = iClose(Symbol(),PERIOD_D1,1);
   snapshots[5,scenes] = AccountInfoDouble(ACCOUNT_BALANCE);
   snapshots[6,scenes] = AccountInfoDouble(ACCOUNT_EQUITY);
   snapshots[7,scenes] = ma_h[0];
   snapshots[8,scenes] = ma_l[0];
   snapshots[9,scenes] = account_state[0];
   snapshots[10,scenes] = account_state[1];
   snapshots[11,scenes] = account_state[2];
  }
//+------------------------------------------------------------------+

//+------------------------------------------------------------------+
//| Fit our linear model to our collected snapshots                  |
//+------------------------------------------------------------------+
void fit_snapshots(void)
  {
   matrix X,y;
   X.Reshape(FEATURES,scenes);
   y.Reshape(FEATURES-1,scenes);

   for(int i=0;i<scenes;i++)
     {
      X[0,i] = snapshots[0,i];
      X[1,i] = snapshots[1,i];
      X[2,i] = snapshots[2,i];
      X[3,i] = snapshots[3,i];
      X[4,i] = snapshots[4,i];
      X[5,i] = snapshots[5,i];
      X[6,i] = snapshots[6,i];
      X[7,i] = snapshots[7,i];
      X[8,i] = snapshots[8,i];
      X[9,i] = snapshots[9,i];
      X[10,i] = snapshots[10,i];
      X[11,i] = snapshots[11,i];

      y[0,i] = snapshots[1,i+1];
      y[1,i] = snapshots[2,i+1];
      y[2,i] = snapshots[3,i+1];
      y[3,i] = snapshots[4,i+1];
      y[4,i] = snapshots[5,i+1];
      y[5,i] = snapshots[6,i+1];
      y[6,i] = snapshots[7,i+1];
      y[7,i] = snapshots[8,i+1];
      y[8,i] = snapshots[9,i+1];
      y[9,i] = snapshots[10,i+1];
      y[10,i] = snapshots[11,i+1];
     }

//--- Find optimal solutions
   b_vector = y.MatMul(X.PInv());
   Print("Day Number: ",scenes+1);
   Print("Snapshot");
   Print(snapshots);
   Print("Input");
   Print(X);
   Print("Target");
   Print(y);
   Print("Coefficients");
   Print(b_vector);
   Print("Prediciton");
   Print(y.Col(scenes-1));
   prediction = b_vector.MatMul(snapshots.Col(scenes-1));

   if(prediction[4] > AccountInfoDouble(ACCOUNT_BALANCE))
      permission = true;

   else
      if((account_state[0] == 1) && (prediction[6] > ma_h[0]))
         permission = true;

      else
         if((account_state[1] == 1) && (prediction[7] < ma_l[0]))
            permission = true;

         else
            permission = false;

   if(permission)
     {
      if(PositionsTotal() == 0)
        {
         if(account_state[0] == 1)
            Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");

         else
            if(account_state[1] == 1)
               Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
        }
     }

   Print("Current Balabnce: ",AccountInfoDouble(ACCOUNT_BALANCE)," Predicted Balance: ",prediction[4]," Permission: ",permission);
  }
//+------------------------------------------------------------------+
程序的测试时间区间是另一项关键参数,在全部测试过程中必须保持固定不变。在前文中,我们对程序开展的回测时间范围为2020年1月1日至2025年。因此本次所有测试都沿用该时间区间。
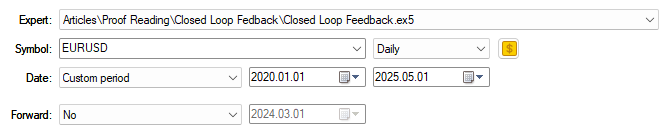
图3:反馈控制器开篇讨论中使用的测试时间区间
将截图附在下方,记录该反馈控制器此前得到的绩效结果。在开篇的文章中,我们提供这张截图,方便读者对比我们本次想要达成的目标绩效。
本文引言部分已经完整对比了旧绩效与本次目标绩效之间的核心差异。同样附上截图,也方便读者自行对照分析。
图4:基准版本在五年回测周期下各项绩效指标的详细分析
下方展示的权益曲线,在开篇的文章中就体现出不错的发展潜力。然而,正如读者之后所见,本文给出的其中一组实验案例,收益增长速度相比旧版本有大幅提升。
图5:反馈控制器初始版本生成的权益曲线,该结果已经可以满足我们的使用要求
Z‑分数(标准统计变换)
Z‑分数变换是一种标准统计处理方法,通常被视作各类数据集预处理的首选基础手段。该变换的目标是保留各列可能具有的不同尺度和量纲,以及它们之间的比例关系。以此保证模型对数据增长幅度的对比具备实际意义且逻辑自洽。 如果不去处理量纲差异,模型会对各列的变化幅度,以及该变化对预测目标的影响做出失衡的判断。Z‑分数变换可以解决该问题:每一列数据减去该列均值,再除以该列标准差。经过变换之后,每一列数据的均值变为0,标准差变为1。
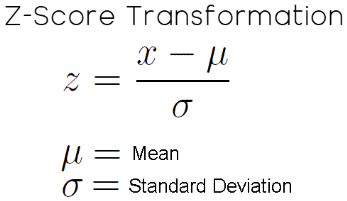
图6:反馈控制器输入数据所使用的统计Z‑分数变换数学公式
   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- Z-Score
       X = ((X - X.Mean())/X.Std());
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
正如本文引言所述,所有测试采用的时间区间保持一致。如上图3所示,测试区间为2020年1月1日至2025年5月。
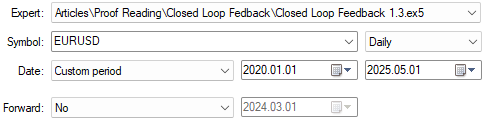
图7:全部测试统一使用上述回测时间区间
之前已经提到,在这五年的测试周期里,Z‑分数变换并没有提升绩效。事实上,它对所有核心绩效指标都产生了负面影响。
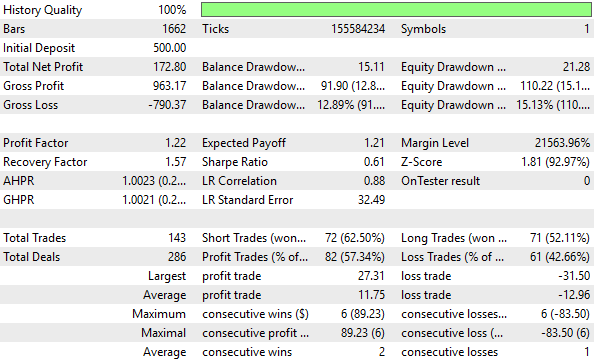
图8:Z‑分数变换对应的详细绩效分析显示,未出现显著改善
与基准对照组相比,经过该变换得到的权益曲线收益水平更低。由此我们可以得出结论:这种变换破坏了原始数据中自带的信号。
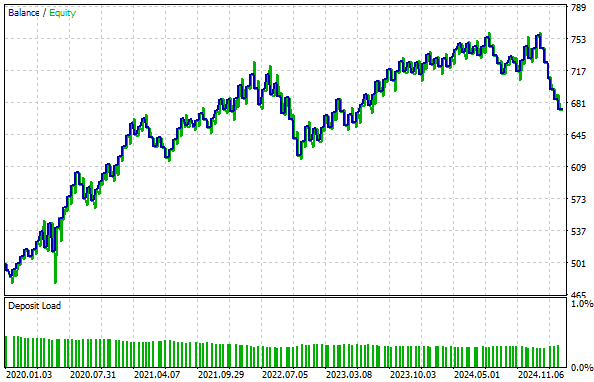
图9:Z‑分数变换生成的权益曲线,未能超越基准对照组的权益曲线
单位缩放(标准线性代数变换)
单位缩放的思路取自线性代数领域。想要完整理解这个概念需要一点铺垫,因为本文中的用法并不是标准范式。因此,有必要给初次接触该概念的读者做简要介绍。
假设我们有一组数值,比如MQL5里一个简单数组,里面包含10个数字,衡量这个数组“大小”的方式有很多种。在线性代数中,这种大小度量被称为范数(norm)。被度量的对象可以是向量或者矩阵,而在这个简单示例里,我们只讨论数值数组。后文我会交替使用“数组”和“向量”两个词,二者在这里指代同一概念。
定义数组大小的方式有很多:
- 可以统计它当前包含多少个元素;
- 也可以看它最大容量最多能存放多少元素;
- 更直观的一种方式,是把现有所有元素的值相加。
为了避免这个问题,可以在求和之前先做变换。例如先取每个数的绝对值,或者先平方再求和。这类不同的度量方式,共同构成Lp范数家族。
该范数家族里很重要的一种是L1范数,定义就是数组全部元素绝对值之和。对应的数学公式如下方图10所示。
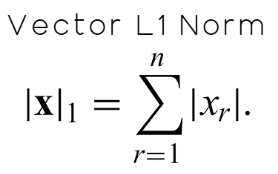
图10:将向量的L1‑范数定义为其全部元素的绝对值之和
计算得到L1范数之后,把数组中每一个元素都除以该范数。在线性代数中该操作称为单位缩放,处理后会得到归一化向量,其范数等于1。也就是说,如果对处理后的向量再次计算范数,结果将恰好等于1。
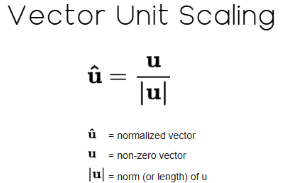
图11:向量的单位缩放是线性代数中的标准变换
对向量做单位缩放逻辑简单直接。然而,本文场景略有区别:我们处理的是矩阵,而不只是向量。回顾前文,我们的数据矩阵X包含12个特征。此时需要使用矩阵的L1范数,矩阵L1范数和向量L1范数并不等同,但二者存在关联。
根据撰写本文时的MQL5官方文档,矩阵L1范数定义为“MATRIX_NORM_P1代表矩阵所有行向量中,p1‑范数的最大值”。
这一定义虽然严谨,但对初次接触的读者而言并不直观。因此,我将文档转述为更通俗易懂的实操步骤:首先分别求出矩阵每一行的L1范数;之后,找出其中L1范数最大的那一行;该最大值即为整个矩阵的L1范数。以上就是MQL5文档给出的定义,对应的数学符号表达如下方图12所示:
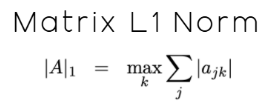
图12:矩阵L1范数不等同于向量L1范数,尽管二者有关联
计算出矩阵L1范数之后,将数据集的每一列全部除以这个数值,以此对数据执行一种变体形式的单位缩放。
   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- We Must Take The Additional Steps Needed To Standardize & Scale Our Inputs
       X = X/X.Norm(MATRIX_NORM_P1);
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
正如之前所述,为保证对比公平,全部测试的回测时间区间保持统一不变。
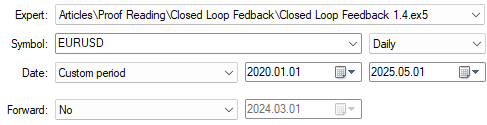
图13:所有实验案例均采用同一套固定回测时间
读者已经了解,这种变体单位缩放相比基准版本显著提升了各项绩效指标,达到以往未曾实现的新高度。该变换明显挖掘出数据中更多有效信号,帮助模型识别出更有价值的规律模式。并非每一种数据变换都能取得这样的效果,但只要某一种变换生效,就会带来可量化的提升 —— 而只有能够量化的提升,才具备实际意义。
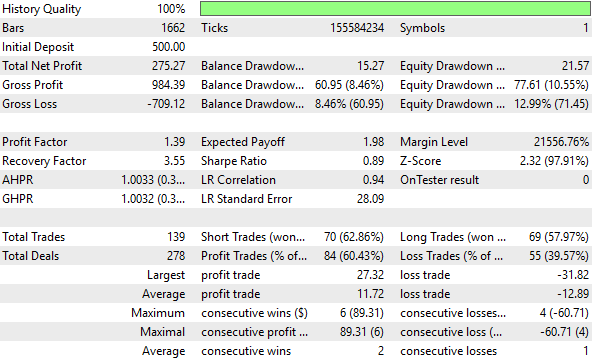
图14:经过优化后的反馈控制器所取得绩效指标的详细分析
观察生成的权益曲线可以看到,盈利最高达到800,这是旧版系统无法企及的水平。另外正如引言中提到,账户资金从500增长至700所用时间几乎缩短三分之一,资金增长速度得到大幅提升。
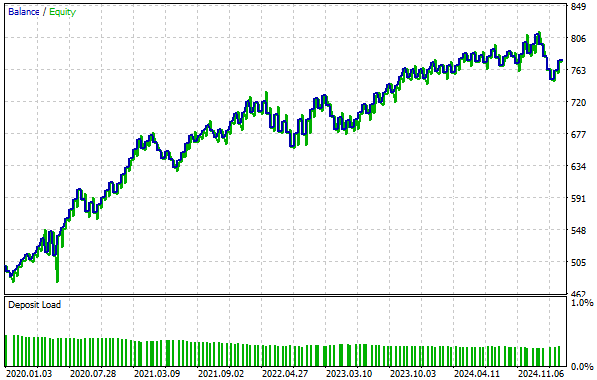
图15:新生成的权益曲线,上涨速度比旧版本的反馈控制器更快
混合方案(单位缩放 + Z‑分数)
正如本文引言所述,目前数据变换还没有一套成熟规范的既定规则。在该研究领域,穷举试错测试是合理可行的手段,因为除了尝试各类思路并观察性能表现之外,几乎没有别的办法。基于这样的设想,我们尝试将两种变换结合,期待获得更强的效果。
  if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- We Must Take The Additional Steps Needed To Standardize & Scale Our Inputs
       X = X/X.Norm(MATRIX_NORM_P1);
       X = ((X-X.Mean())/X.Std());
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
遗憾的是,这套混合方案最终几乎无法盈利。尽管初期看上去尚有希望,但两种变换叠加之后,所有核心绩效指标均受到负面影响。
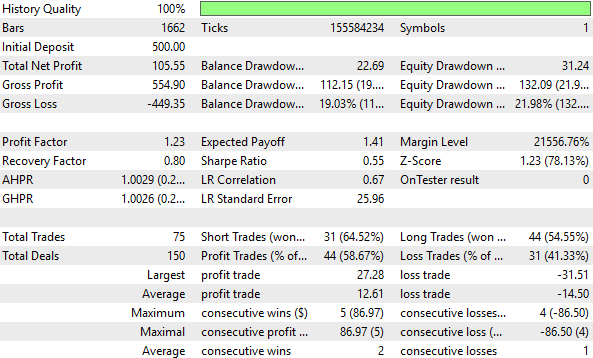
图16:混合方案得到的绩效,是本组全部测试里表现最差的一组
虽然混合方案下的盈利交易占比从57.24%小幅升至58.67%,但这一提升并不显著。除此之外,混合策略生成的权益曲线始终在500至600区间徘徊,账户资金无法实现长期增长。因此,我们可以得出结论:该组合变换破坏了输入数据内的有效信号,无法再向模型暴露有价值的数据关联。
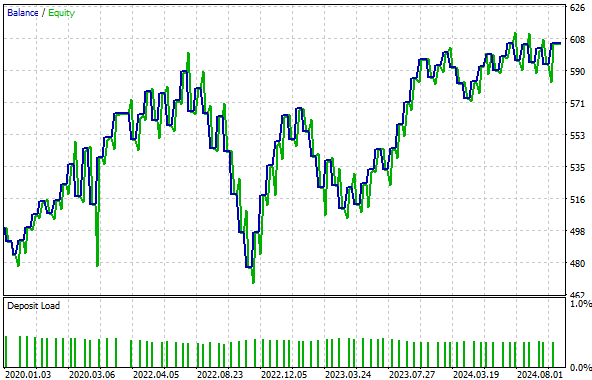
图17:本次得到的权益曲线不再向上增长,陷入难以盈利的状态
结论
阅读完本文,读者能够对机器学习模型输入数据的预处理建立全新认知。希望读者可以将机器学习流程中的预处理视作高影响力调参项,因为只有认真且持续地开展调试,才能够真正从中获益。
针对同一数据集,可供选择的数据变换手段种类繁多。但现实情况是,我们往往无从得知哪一种变换最优,也难以直接判断某一种变换是否起到正向作用。然而,可以采用本文演示的对照实验框架:先确立基准性能,所有新思路都和基准做对比测试。借助这套方式,我们就有可能挖掘原始数据中潜藏的结构与模式。
因此,读者应当尽可能多接触各类数据变换方法,测试不同方案,从中找出真正能够提升系统性能的手段。
本文由MetaQuotes Ltd译自英文
原文地址: https://www.mql5.com/en/articles/19382
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。