

Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 14): cómo considerar las transformaciones de datos como parámetros de ajuste de nuestro controlador de realimentación
 17
 0

El preprocesamiento es un parámetro de ajuste muy eficaz, aunque con frecuencia se pasa por alto, en cualquier framework o pipeline de aprendizaje automático.
Supone un elemento de control importante dentro del pipeline que suele quedar oculto a la sombra de sus hermanos mayores. Por lo general, los optimizadores o las arquitecturas de modelos llamativas acaparan la mayor parte de la atención y de la labor investigadora, y se dedican grandes recursos académicos a esas áreas. No obstante, se dedica poco tiempo al estudio de los efectos de las técnicas de preprocesamiento.
De forma inadvertida, el preprocesamiento que aplicamos a los datos de que disponemos influye en el rendimiento del modelo de maneras que pueden tener un impacto sorprendentemente grande. Incluso pequeñas mejoras porcentuales en el preprocesamiento pueden acumularse con el tiempo y afectar de manera sustancial a la rentabilidad y al riesgo de nuestras aplicaciones de trading.
Con demasiada frecuencia, nos apresuramos a realizar el preprocesamiento sin dedicar mucho tiempo ni reflexión a comprobar si realmente hemos identificado la mejor transformación posible para los datos de entrada.
Los optimizadores avanzados y las arquitecturas de aprendizaje automático de los que dependemos en nuestra era moderna se ven silenciosamente limitados —o potenciados— por las transformaciones que aplicamos a los datos de que disponemos. Desafortunadamente, en el momento de redactar este texto, no existe un marco establecido que permita demostrar que una transformación concreta sea óptima. Y no solo eso: tampoco tenemos certeza alguna de que no exista una transformación alternativa mejor. De hecho, son pocos los estudios que analizan la combinación de diferentes transformaciones en soluciones híbridas, y es precisamente aquí donde podría liberarse un potencial de rendimiento aún sin explotar.
Por lo tanto, nuestro objetivo es mejorar la eficiencia de un controlador de realimentación que hemos diseñado cuidadosamente juntos en un debate anterior (enlace disponible aquí).
Más allá de la rentabilidad ordinaria, aspiramos a lograr una reducción del riesgo y un comportamiento de trading más sólido —y, en cierta medida, más maduro— por parte de nuestra aplicación de trading. En esencia, este ejercicio considera el propio preprocesamiento como un parámetro de ajuste en sí mismo, capaz de modificar sustancialmente los resultados de las aplicaciones de trading si se gestiona correctamente.
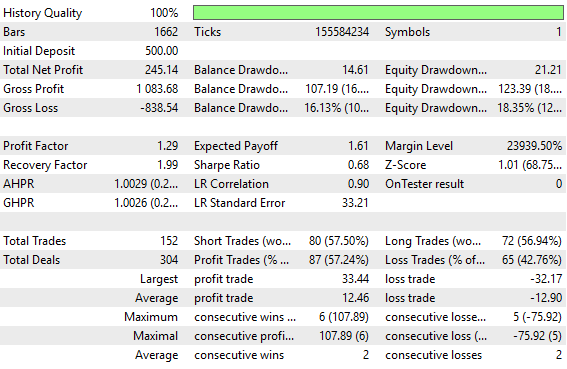
Figura 1: La antigua configuración de estadísticas de backtest de la versión anterior de nuestro controlador de realimentación
El rendimiento de nuestro antiguo controlador de realimentación era, sin duda, aceptable desde todos los puntos de vista; sin embargo, huelga decir que demostraremos que dedicar tiempo a probar las transformaciones adecuadas puede llegar a liberar alfa en su estrategia que permanecía latente porque la señal no se estaba exponiendo de forma eficaz.
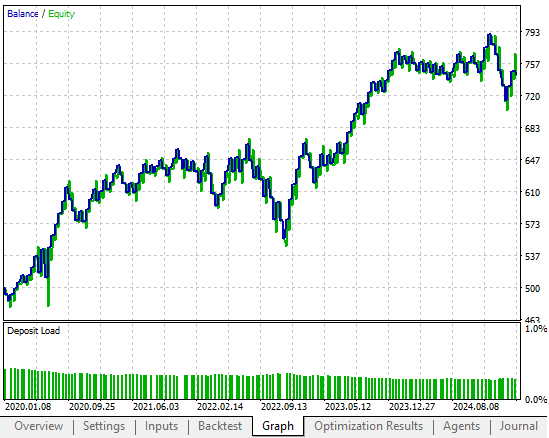
Figura 2: La antigua curva de equity que pretendemos superar identificando una transformación adecuada que aplicar a nuestros datos de entrada
No sacar a la luz la rica estructura de su conjunto de datos erosiona el capital de los inversores con el tiempo. Probamos tres transformaciones distintas en los datos de entrada que introdujimos en nuestro controlador de realimentación. Para disponer de una configuración de referencia, ejecutamos una prueba de referencia con entradas en bruto y sin transformar procedentes de nuestra explicación anterior. Después, cada transformación que evaluamos se probó sobre datos históricos idénticos, manteniendo constantes todas las demás variables. El rendimiento se midió en términos de rentabilidad, ratio de Sharpe, número de operaciones realizadas, pérdida bruta total acumulada y proporción total de operaciones rentables. Esto nos permitió aislar los efectos del preprocesamiento y mantener al mismo tiempo una comparación justa entre las tres pruebas.
La primera transformación que probamos fue la z-score estadística estándar. La z-score se calcula restando la media de cada columna y dividiendo cada columna por su desviación típica. Observamos que esta transformación redujo nuestros niveles de rentabilidad en un 30 % con respecto a la base de referencia. Esto no resulta atractivo en absoluto. Además, hizo que nuestro ratio de Sharpe cayera nada menos que un 10 % con respecto al nivel de rendimiento de la base de referencia.
Por consiguiente, la transformación mediante z-score no resultó ideal para nosotros. A continuación, aplicamos una transformación tomada del campo del álgebra lineal. Esta transformación se conoce como «escalado unitario» y se realiza dividiendo una matriz por su norma. En este caso concreto, elegimos la norma L1 de la matriz como divisor. Tras el escalado con la norma L1, observamos que los niveles de rentabilidad de nuestra aplicación mejoraron un 12 % con respecto a la base de referencia, lo cual resulta atractivo. Además, el ratio de Sharpe mejoró un 30 % gracias al escalado unitario.
Otro claro indicio de habilidad en el trading es que nuestra aplicación pueda alcanzar mayores niveles de rentabilidad con un menor número total de operaciones. Esta vez volvió a ocurrir lo mismo: tras el escalado unitario, el número total de operaciones necesarias se redujo en un 8 %, y la pérdida total acumulada también disminuyó en un 15 %. Por último, la proporción total de operaciones ganadoras aumentó un 5 %. Por lo tanto, esto nos dio una gran confianza en que el escalado unitario había mejorado el rendimiento de nuestro controlador de realimentación.
Después de ello, probamos una combinación de z-score y escalado unitario. Por desgracia, esto echó por tierra todas las mejoras que habíamos conseguido con el escalado unitario por sí solo. Nuestra rentabilidad cayó un 58 % por debajo de la base de referencia, y nuestro ratio de Sharpe disminuyó un 19 %. Así que, a pesar de nuestra sólida intuición, combinar estas dos transformaciones en un híbrido resultó perjudicial para el rendimiento y no reveló ninguna estructura adicional de la que pudiéramos aprender.
Por ello, de todo esto se desprende claramente que el preprocesamiento no es simplemente un medio más para alcanzar un fin a la hora de crear modelos de aprendizaje automático para el trading. Más bien, el preprocesamiento constituye, por sí mismo, una estrategia. La elección de la transformación influye de forma sutil en el rendimiento de nuestros modelos de aprendizaje automático: condiciona los beneficios, distorsiona las pérdidas y modifica inadvertidamente nuestra exposición al riesgo de formas que no comprendemos directamente.
El aprendizaje estadístico clásico ofrece poca o ninguna orientación en este sentido. No existen estándares universales y consensuados más allá de la exploración por fuerza bruta mediante validación cruzada sobre particiones. Esto implica dedicar tiempo a realizar pruebas comparativas de pipelines de preprocesamiento y tratarlos como lo que son: parámetros de ajuste de gran impacto en nuestro pipeline de aprendizaje automático.
Esto también debería servir de incentivo para que otros investigadores y autores de artículos exploren cada vez más transformaciones que podrían aplicarse en nuestro ámbito. Porque en ámbitos como el reconocimiento de imágenes y de voz, los profesionales del aprendizaje automático suelen emplear pipelines sólidos y extensos de transformaciones antes incluso de intentar realizar cualquier predicción. Y, sin embargo, en campos como el nuestro, el aprendizaje automático financiero, a menudo dedicamos muy poco tiempo a crear pipelines sólidos de transformaciones de preprocesamiento.
Dadas las circunstancias actuales a las que nos enfrentamos, las pruebas de fuerza bruta constituyen una estrategia acertada. Cuanto más exploramos, mejor comprendemos las características de cada transformación que aplicamos a este mercado concreto. Esto nos ayuda a identificar qué transformación podría ser la mejor de entre todas las que hemos observado.
Revisión de la base de referencia actual
Antes de empezar, es importante revisar primero la configuración de control que queremos superar. Cualquier proceso de optimización resulta difícil de interpretar sin una referencia o un nivel base de rendimiento con el que compararlo. Por lo tanto, comenzaremos por repasar brevemente el controlador de realimentación inicial que implementamos. Para los lectores habituales, el siguiente código ya les resultará familiar. Para quienes lean esto por primera vez, destacaré los puntos clave de la aplicación que creamos y de nuestro análisis anterior.
La aplicación se basa en un pequeño número de definiciones del sistema que mantenemos constantes durante toda su vida útil. Por ejemplo, el periodo de los indicadores técnicos que se utilizan, el número de días de negociación observados antes de que el controlador de realimentación pueda aportar señales y el número total de características que el controlador toma como entrada. En este caso, el controlador de realimentación toma 12 características de entrada. Es importante destacar que, en el ejemplo anterior, no aplicamos ninguna transformación, estandarización ni técnica de escalado a ninguna de las 12 entradas.
La aplicación también depende de algunas variables globales y bibliotecas durante todo su funcionamiento, como la aplicación de trading para abrir y cerrar operaciones, la biblioteca «time» para el seguimiento de la formación de velas y la biblioteca «trade-info» para datos como el tamaño mínimo del lote y los precios bid y ask actuales.
Al inicializarse por primera vez, la aplicación crea nuevas instancias de las bibliotecas personalizadas, configura los indicadores técnicos e inicializa la mayoría de las variables globales con valores por defecto. Cuando la aplicación deja de utilizarse, se liberan los objetos dinámicos y los indicadores técnicos.
Si se invoca la función OnTick, el sistema comprueba primero si se ha formado una vela completa. En ese caso, actualiza los búferes de la media móvil con el último precio de cierre. Cuando no hay posiciones abiertas, se aplica entonces la lógica de trading: un canal de medias móviles formado por una media móvil de máximos y otra de mínimos con el mismo periodo. Cada vez que los niveles de precio rompen por encima del canal, compramos. Por el contrario, cuando rompen por debajo, vendemos. Si no, esperaremos.
Durante los primeros 90 días, el sistema puede comprar y vender casi de inmediato. Sin embargo, una vez transcurrido ese periodo, las operaciones requieren una previsión del controlador de realimentación. Si el controlador está convencido de que la operación será rentable, concede el permiso; de lo contrario, frena el sistema.
Esa es la esencia del controlador de realimentación: espera los primeros 90 días antes de emitir señales para el sistema. A partir de ahí, definimos un método llamado «take_snapshots» para recopilar periódicamente observaciones del rendimiento del sistema, y otro método llamado «fit_snapshots» para hallar soluciones lineales a dichas observaciones. Una vez obtenidas las soluciones, el sistema puede realizar predicciones.
Esta es la versión base de nuestra estrategia de trading.
//+------------------------------------------------------------------+
//|                                         Closed Loop Feedback.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

/**
Closed Loop Feedback Control allows us to learn how to control our
system's dynamics.

It is challenging to perform in action, but worth every effort made
towards it.

Certain tasks, such as deciding when to increase your lot size,
are not always easy to plan explicitly.

We can rather observe our average loss size after say, 20 trades at
minimum lot.

From there, we can calculate how much on average, we expect to lose
on any trade. And then set meaningful profit targets to accumulate,
before increasing out lot size. We do not always know these numbers
ahead of time.


Additionally, we can train predictive models, that attempt to learn
when our system is loosing and keep us out of loosing trades.

The models we desire are not directly predicting the market per say.

Rather, they are observing the relationship between a fixed strategy
and a dynamic market.

After allowing a certain number of observations, the predictive model
may be permitted to give inputs that override the original strategy
only if the model expects the strategy to lose, yet again.

These family of algorithms may one day make it possible for us to
truly design strategies that require no tuning parameters at all!

I am excited to present this to you, but there is a long road ahead.
Let us begin.
**/

//+------------------------------------------------------------------+
//| System definitions                                               |
//+------------------------------------------------------------------+
#define MA_PERIOD    10
#define OBSERVATIONS 90
#define FEATURES     12
#define ACCOUNT_STATES 3

//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int    ma_h_handler,ma_l_handler,atr_handler,scenes,b_matrix_scenes;
double ma_h[],ma_l[],atr[];
matrix snapshots,OB_SIGMA,OB_VT,OB_U,b_vector,b_matrix;
vector S,prediction;
vector account_state;
bool predict,permission;

//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade      Trade;

Time        *DailyTimeHandler;
TradeInfo   *TradeInfoHandler;

//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   DailyTimeHandler  = new Time(Symbol(),PERIOD_D1);
   TradeInfoHandler  = new TradeInfo(Symbol(),PERIOD_D1);
   ma_h_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_HIGH);
   ma_l_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_LOW);
   atr_handler       = iATR(Symbol(),PERIOD_D1,14);
   snapshots         = matrix::Ones(FEATURES,OBSERVATIONS);
   scenes            = 0;
   b_matrix_scenes   = 0;
   account_state     = vector::Zeros(3);
   b_matrix          = matrix::Zeros(1,1);
   prediction        = vector::Zeros(2);
   predict           = false;
   permission        = true;
//---
   return(INIT_SUCCEEDED);
  }
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   delete DailyTimeHandler;
   delete TradeInfoHandler;
   IndicatorRelease(ma_h_handler);
   IndicatorRelease(ma_l_handler);
   IndicatorRelease(atr_handler);
  }
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(DailyTimeHandler.NewCandle())
     {
      CopyBuffer(ma_h_handler,0,0,1,ma_h);
      CopyBuffer(ma_l_handler,0,0,1,ma_l);
      CopyBuffer(atr_handler,0,0,1,atr);
      double c = iClose(Symbol(),PERIOD_D1,0);

      if(PositionsTotal() == 0)
        {
         account_state = vector::Zeros(ACCOUNT_STATES);

         if(c > ma_h[0])
           {
            if(!predict)
              {
               if(permission)
                  Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");
              }

            account_state[0] = 1;
           }

         else
            if(c < ma_l[0])
              {
               if(!predict)
                 {
                  if(permission)
                     Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
                 }

               account_state[1] = 1;
              }

            else
              {
               account_state[2] = 1;
              }
        }

      if(scenes < OBSERVATIONS)
        {
         take_snapshots();
        }

      else
        {
         matrix temp;
         temp.Assign(snapshots);
         snapshots = matrix::Ones(FEATURES,scenes+1);

         //--- The first row is the intercept and must be full of ones
         for(int i=0;i<FEATURES;i++)
            snapshots.Row(temp.Row(i),i);

         take_snapshots();
         fit_snapshots();

         predict = true;
         permission = false;
        }
      scenes++;
     }
  }

//+------------------------------------------------------------------+
//| Record the current state of our system                           |
//+------------------------------------------------------------------+
void take_snapshots(void)
  {
   snapshots[1,scenes] = iOpen(Symbol(),PERIOD_D1,1);
   snapshots[2,scenes] = iHigh(Symbol(),PERIOD_D1,1);
   snapshots[3,scenes] = iLow(Symbol(),PERIOD_D1,1);
   snapshots[4,scenes] = iClose(Symbol(),PERIOD_D1,1);
   snapshots[5,scenes] = AccountInfoDouble(ACCOUNT_BALANCE);
   snapshots[6,scenes] = AccountInfoDouble(ACCOUNT_EQUITY);
   snapshots[7,scenes] = ma_h[0];
   snapshots[8,scenes] = ma_l[0];
   snapshots[9,scenes] = account_state[0];
   snapshots[10,scenes] = account_state[1];
   snapshots[11,scenes] = account_state[2];
  }
//+------------------------------------------------------------------+

//+------------------------------------------------------------------+
//| Fit our linear model to our collected snapshots                  |
//+------------------------------------------------------------------+
void fit_snapshots(void)
  {
   matrix X,y;
   X.Reshape(FEATURES,scenes);
   y.Reshape(FEATURES-1,scenes);

   for(int i=0;i<scenes;i++)
     {
      X[0,i] = snapshots[0,i];
      X[1,i] = snapshots[1,i];
      X[2,i] = snapshots[2,i];
      X[3,i] = snapshots[3,i];
      X[4,i] = snapshots[4,i];
      X[5,i] = snapshots[5,i];
      X[6,i] = snapshots[6,i];
      X[7,i] = snapshots[7,i];
      X[8,i] = snapshots[8,i];
      X[9,i] = snapshots[9,i];
      X[10,i] = snapshots[10,i];
      X[11,i] = snapshots[11,i];

      y[0,i] = snapshots[1,i+1];
      y[1,i] = snapshots[2,i+1];
      y[2,i] = snapshots[3,i+1];
      y[3,i] = snapshots[4,i+1];
      y[4,i] = snapshots[5,i+1];
      y[5,i] = snapshots[6,i+1];
      y[6,i] = snapshots[7,i+1];
      y[7,i] = snapshots[8,i+1];
      y[8,i] = snapshots[9,i+1];
      y[9,i] = snapshots[10,i+1];
      y[10,i] = snapshots[11,i+1];
     }

//--- Find optimal solutions
   b_vector = y.MatMul(X.PInv());
   Print("Day Number: ",scenes+1);
   Print("Snapshot");
   Print(snapshots);
   Print("Input");
   Print(X);
   Print("Target");
   Print(y);
   Print("Coefficients");
   Print(b_vector);
   Print("Prediciton");
   Print(y.Col(scenes-1));
   prediction = b_vector.MatMul(snapshots.Col(scenes-1));

   if(prediction[4] > AccountInfoDouble(ACCOUNT_BALANCE))
      permission = true;

   else
      if((account_state[0] == 1) && (prediction[6] > ma_h[0]))
         permission = true;

      else
         if((account_state[1] == 1) && (prediction[7] < ma_l[0]))
            permission = true;

         else
            permission = false;

   if(permission)
     {
      if(PositionsTotal() == 0)
        {
         if(account_state[0] == 1)
            Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");

         else
            if(account_state[1] == 1)
               Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
        }
     }

   Print("Current Balabnce: ",AccountInfoDouble(ACCOUNT_BALANCE)," Predicted Balance: ",prediction[4]," Permission: ",permission);
  }
//+------------------------------------------------------------------+
Las fechas de prueba de nuestra aplicación de trading son otro parámetro importante que debe mantenerse fijo en todas las pruebas que realicemos. En el análisis anterior, realizamos un backtest de nuestra aplicación de trading desde el 1 de enero de 2020 hasta mayo de 2025. Por lo tanto, mantendremos estas fechas iguales en todas las pruebas.
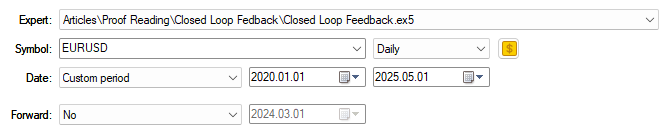
Figura 3: Las fechas de prueba que utilizamos en el análisis inicial de los controladores de realimentación
A continuación, adjuntamos una captura de pantalla de los niveles de rendimiento anteriores establecidos por el controlador de realimentación. En nuestra discusión inicial, incluimos esta captura de pantalla para que el lector pudiera compararla con los niveles de rendimiento que pretendemos alcanzar hoy.
En la introducción del artículo ya ofrecimos un resumen exhaustivo de las diferencias clave entre los niveles de rendimiento alcanzados anteriormente y los niveles de rendimiento a los que aspiramos ahora. Se incluye la captura de pantalla para que el lector también pueda sacar sus propias conclusiones.
Figura 4: Análisis detallado de los niveles de rendimiento que nuestra referencia estableció durante su backtest de 5 años
La curva de equity que se muestra a continuación demostró un potencial prometedor en nuestro análisis inicial. Sin embargo, como podrá comprobar el lector, uno de los ejemplos que se presentan hoy aceleró el crecimiento a un ritmo considerablemente más rentable que el alcanzado en el pasado.
Figura 5: La curva de equity que obtuvimos con la versión inicial del controlador de realimentación ya resultaba aceptable para nuestras necesidades
z-score (transformación estadística estándar)
La transformación mediante la z-score es una técnica estadística estándar que, por lo general, se considera un buen primer paso para cualquier conjunto de datos. El objetivo de esta transformación es conservar las diferentes escalas y dimensiones que puede adoptar cada columna, así como las proporciones entre ellas. Esto garantiza que su modelo pueda realizar comparaciones de crecimiento que sean a la vez significativas y coherentes. Si no se tiene en cuenta la escala, el modelo podría extraer conclusiones desproporcionadas sobre el crecimiento en cada columna y su efecto sobre el objetivo. La transformación mediante la z-score resuelve este problema restando la media (el valor medio de cada columna) y dividiendo después el resultado por la desviación típica. Como resultado, cada columna presenta un valor medio de cero y una desviación típica de uno.
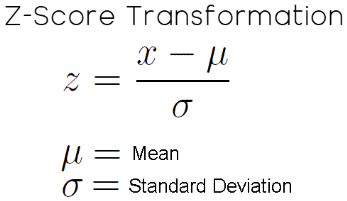
Figura 6: Fórmula matemática de la transformación estadística mediante la z-score que aplicamos a los datos de entrada de nuestro controlador de realimentación
   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- Z-Score
       X = ((X - X.Mean())/X.Std());
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
Tal y como se indica en la introducción de nuestro artículo, las fechas de las pruebas que utilizamos serán las mismas en todas las pruebas. Tal y como se muestra en la figura 3 anterior, usaremos el periodo comprendido entre el 1 de enero de 2020 y mayo de 2025.
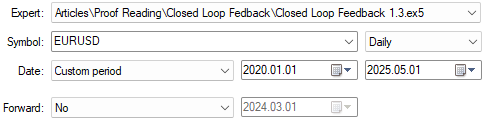
Figura 7: Los días de backtest que hemos indicado anteriormente se mantendrán iguales en todas las pruebas
Como ya hemos mencionado, la transformación mediante la z-score no contribuyó a mejorar nuestros niveles de rendimiento a lo largo de la prueba de cinco años. De hecho, tuvo un impacto negativo en todos nuestros indicadores clave de rendimiento.
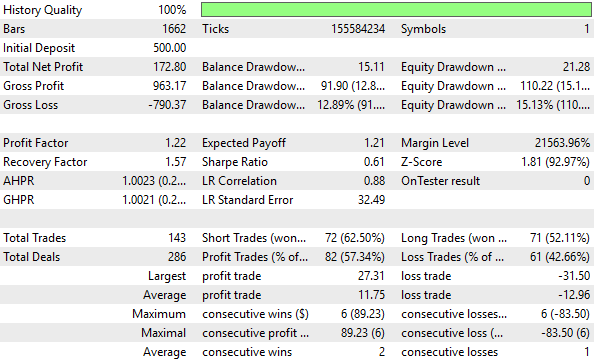
Figura 8: Un análisis detallado de los indicadores de rendimiento obtenidos mediante la transformación de z-score no muestra mejoras significativas
Nuestra configuración de control del análisis anterior resulta más rentable que la curva de equity generada por la transformación que hemos aplicado y que se muestra a continuación. Por lo tanto, podemos concluir que esta transformación destruyó la señal que estaba presente en los datos sin procesar.
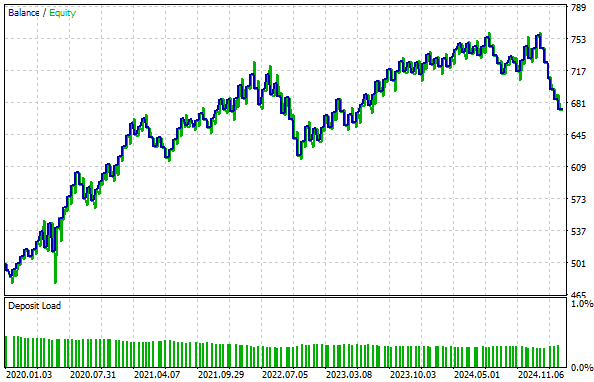
Figura 9: La curva de equity resultante de la transformación mediante la z-score no logró superar la curva de equity que obtuvimos con la configuración de control
Escalado unitario (transformación estándar de álgebra lineal)
El concepto de escalado unitario procede del campo del álgebra lineal. Es necesario aportar un poco de contexto para comprender plenamente este concepto, ya que en nuestro análisis no lo estamos aplicando de la forma habitual. Por consiguiente, es necesario ofrecer una breve introducción para aquellos lectores que quizá se encuentren con este concepto por primera vez.
Siempre que tenemos una lista de números —piense, por ejemplo, en un array sencillo en MQL5 con, digamos, 10 números—, hay muchas formas de medir lo «grande» que es ese array. En álgebra lineal, esta magnitud se denomina norma de un objeto. Ese objeto podría ser un vector o una matriz, pero en este sencillo ejemplo solo consideraremos un array de números. A partir de ahora, es posible que utilice los términos «array» y «vector» indistintamente, ya que ambos se refieren a la misma idea.
Hay muchas formas de determinar el tamaño de un array:
- Podríamos medirlo en función del número de elementos que tiene actualmente.
- Además, podríamos medirlo en función del número máximo de elementos que puede contener.
- Para que quede bien claro, también podríamos plantearnos medirlo sumando todos los valores de sus elementos actuales.
Para evitarlo, podemos aplicar transformaciones antes de sumar. Por ejemplo, podríamos calcular el valor absoluto de cada número o elevar cada uno al cuadrado antes de sumarlos. Estos diferentes enfoques conforman una familia de normas conocida como normas Lp.
Una norma importante que hay que conocer de esta familia es la norma L1, que no es más que la suma de los valores absolutos de todos los elementos del array. Desde el punto de vista matemático, esto se ilustra en la figura 10 que aparece a continuación.
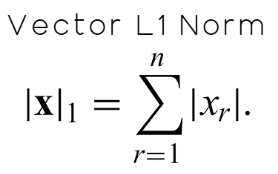
Figura 10: Definición de la norma L1 de un vector como la suma de los valores absolutos de todos sus elementos.
Tras calcular la norma L1, podemos dividir cada valor del array por dicha norma. Este proceso se denomina «escalado unitario» en álgebra lineal y produce un vector normalizado de norma 1. Esto significa que, si vuelve a calcular la norma del vector, el resultado será exactamente uno.
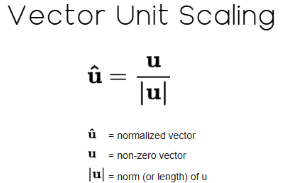
Figura 11: El escalado unitario de un vector es una transformación estándar en álgebra lineal.
Esto resulta sencillo cuando se trata de vectores. Sin embargo, nuestro caso es ligeramente diferente, ya que estamos trabajando con una matriz, no solo con un vector. Recordemos, tal y como se ha mencionado al principio de nuestro análisis, que nuestra matriz de datos, X, tiene 12 características. En este caso, debemos utilizar la norma L1 de una matriz, que no es la misma que la norma L1 de un vector, aunque ambas están relacionadas.
Según la documentación actual de MQL5, en el momento de redactar este texto, la norma L1 de una matriz se define así: «MATRIX_NORM_P1 es la norma p1 vectorial máxima entre los vectores fila de la matriz».
Aunque esta definición es precisa, puede que al principio no resulte muy intuitiva, sobre todo para los lectores que se enfrentan a todo esto por primera vez. Por lo tanto, puedo parafrasear la documentación para el lector y convertirla en instrucciones más prácticas que comienzan calculando primero la norma L1 de cada fila de la matriz. A continuación, identifique la fila con la norma L1 más grande. Entonces, ese valor más grande se convierte en la norma L1 de la matriz. Esta es la idea tal y como se define en la documentación de MQL5, y se expresa matemáticamente mediante la notación que se muestra en la figura 12 a continuación:
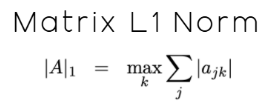
Figura 12: La norma L1 de una matriz no es la misma que la norma L1 de un vector, aunque ambas están relacionadas
Una vez calculada la norma L1, dividimos finalmente cada columna del conjunto de datos por este valor, aplicando así una variante del escalado unitario a los datos.
   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- We Must Take The Additional Steps Needed To Standardize & Scale Our Inputs
       X = X/X.Norm(MATRIX_NORM_P1);
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
Como ya hemos indicado anteriormente, mantendremos los mismos días de backtest en todas las pruebas para garantizar que las comparaciones sean equitativas.
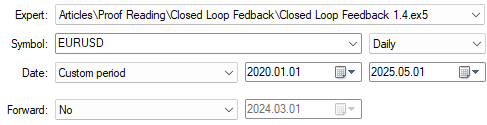
Figura 13: Los días de backtest que hemos utilizado para nuestras pruebas se han mantenido fijos en todos los ejemplos
Como el lector ya sabe, la variante de escalado unitario mejoró sustancialmente nuestros niveles de rendimiento frente a la referencia, llevándolos a nuevas cotas que no habíamos alcanzado antes. Esta transformación hizo aflorar claramente más señal en los datos, lo que ayudó a nuestro modelo a detectar patrones más significativos. No todas las transformaciones funcionarán de esta manera, pero cuando una lo hace, genera una mejora cuantificable, y la mejora cuantificable es la única que realmente importa.
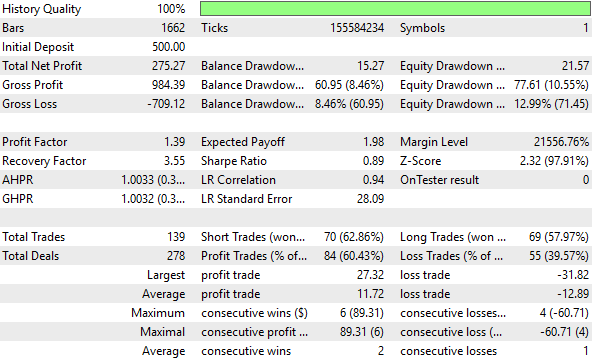
Figura 14: Análisis detallado de los niveles de rendimiento alcanzados por nuestro controlador de realimentación mejorado
Al analizar la curva de equity obtenida, observamos que nuestra rentabilidad alcanza ahora máximos de 800, unos niveles que no podíamos alcanzar con nuestra configuración anterior. Además, como mencionamos en la introducción, el tiempo que tardó nuestra cuenta en crecer de 500 a 700 se ha reducido casi en un tercio, lo que supone un notable aumento de la velocidad de crecimiento.
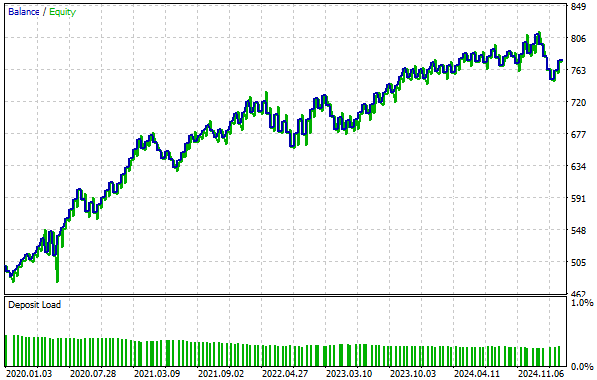
Figura 15: La nueva curva de equity que hemos obtenido crece incluso más rápido que la del antiguo controlador de realimentación con el que empezamos
Enfoque híbrido (escalado unitario y z-score)
Llegados a este punto del artículo, tal y como indicamos en la introducción, no existen reglas formalizadas para las transformaciones. En este ámbito, las pruebas de fuerza bruta son razonablemente justificables, ya que no hay mucho más que podamos hacer aparte de probar ideas y observar su rendimiento. Partiendo de esa intuición, intentamos combinar dos transformaciones, con la esperanza de lograr un resultado aún más potente.
  if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      //--- We Must Take The Additional Steps Needed To Standardize & Scale Our Inputs
       X = X/X.Norm(MATRIX_NORM_P1);
       X = ((X-X.Mean())/X.Std());
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);
Por desgracia, este enfoque híbrido resultó ser, en gran medida, poco rentable. Aunque en un principio parecía prometedor, las transformaciones combinadas afectaron negativamente a todos nuestros indicadores clave de rendimiento.
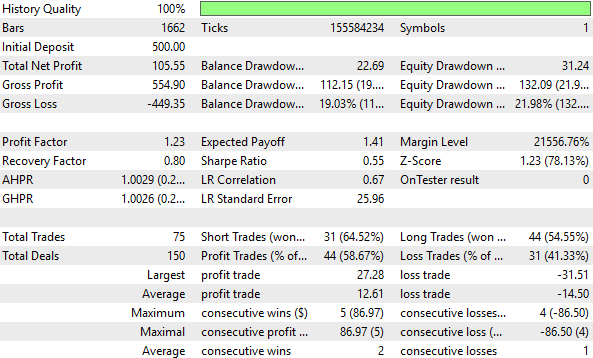
Figura 16: Nuestro enfoque híbrido arrojó los peores niveles de rendimiento que observamos a lo largo de esta prueba
Aunque la proporción total de operaciones rentables aumentó ligeramente —del 57,24 % al 58,67 % en la configuración híbrida—, no se trata de una mejora significativa. Además, la curva de equity generada por la estrategia híbrida se mantiene estancada entre 500 y 600, sin que la cuenta consiga crecer con el paso del tiempo. Así, podemos concluir que esta transformación ha destruido la señal presente en nuestros datos de entrada y ya no revela relaciones valiosas para nuestro modelo.
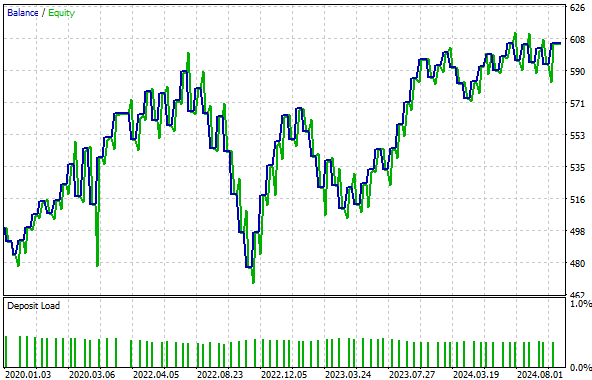
Figura 17: La curva de equity que hemos obtenido ya no crece, sino que parece haberse estancado en una situación no rentable
Conclusión
Tras esta explicación, el lector debería quedarse con una nueva comprensión del preprocesamiento que aplicamos a los datos que introducimos en nuestros modelos de aprendizaje automático. Espero que el lector considere ahora esta etapa del pipeline de aprendizaje automático como un parámetro de ajuste de gran impacto, que debe emplearse con diligencia y perseverancia para obtener beneficios reales.
Hay muchas transformaciones que podemos aplicar a un conjunto de datos determinado y, por desgracia, a menudo no sabemos cuál es la mejor, ni siempre podemos determinar si una transformación concreta resulta útil. Sin embargo, al emplear un marco controlado —tal y como se muestra en este artículo—, partiendo de un nivel de rendimiento de referencia y contrastando constantemente las ideas con respecto a él, podemos descubrir estructuras y patrones que podrían haber quedado ocultos en los datos originales.
Por lo tanto, también es importante que el lector se familiarice continuamente con el mayor número posible de transformaciones, para probar distintos enfoques y descubrir qué es lo que realmente mejora el rendimiento.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19382
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Automatización de estrategias de trading en MQL5 (Parte 28): Creación de un patrón armónico «Bat» basado en la acción del precio con retroalimentación visual
 Desarrollo de un indicador personalizado de sentimiento del mercado
 Particularidades del trabajo con números del tipo double en MQL4
 Arbitraje estadístico mediante acciones cointegradas (Parte 3): Configuración de la base de datos

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso