Arbitragem estatística com ações cointegradas (Parte 4): Atualização dos parâmetros do modelo em tempo real
 28
 0

Introdução
Chegou o momento de começar a atualizar nosso modelo de cointegração em tempo real. Mais precisamente, vamos ajustar os pesos relativos de cada ação em nossa carteira de negociação com base nos cálculos mais recentes, enquanto o EA estiver em execução. Até agora, utilizamos pesos iguais para os ativos da carteira em nossas explicações e testes com dados históricos. Essa simplificação facilitou a compreensão da metodologia, bem como do significado e dos princípios de funcionamento dos testes estatísticos utilizados. Na prática, porém, os pesos da carteira mudam praticamente a cada nova observação, o que, em nosso caso, corresponde ao fechamento de cada nova barra.
Antes disso, vamos recapitular brevemente o contexto para garantir que todos estejam acompanhando o desenvolvimento do projeto.
Estamos desenvolvendo uma espécie de plataforma "simplificada", estruturada como um pipeline de arbitragem estatística desenvolvido para o trader de varejo comum, que utiliza um notebook convencional e dispõe de uma conexão de rede com largura de banda padrão. Ao longo desta série de artigos, apresentamos e explicamos os testes estatísticos utilizados para identificar ativos altamente correlacionados para negociação de pares, ações cointegradas para a composição de carteiras e testes destinados a avaliar a estacionariedade dos spreads relativos entre esses ativos, uma condição necessária para estratégias de reversão à média como a nossa.
No artigo anterior desta série (Parte 3), descrevemos a configuração do banco de dados e apresentamos algumas considerações sobre nossas decisões de projeto. Este artigo dá continuidade direta àquele trabalho. Com o banco de dados devidamente configurado e atualizado regularmente, podemos separar a análise dos dados das atividades de negociação.
Agora, vamos examinar:
- como modificamos nossos scripts Python com base na experiência adquirida, passando a executar todos os testes em uma única passagem, o que simplifica a seleção dos ativos;
- como reformulamos completamente o código do nosso EA para que ele possa utilizar o banco de dados atualizado durante a execução e como transferimos quase todas as funções para um arquivo de cabeçalho MQL5, facilitando a gestão e a manutenção do código e deixando no arquivo principal apenas as funções de tratamento de eventos propriamente ditas;
- Por fim, analisaremos as alterações realizadas no banco de dados para que ele possa funcionar como interface entre o sistema de análise de dados em tempo real e o ambiente de negociação online.
Vamos começar pelo último item, o terceiro, para facilitar a compreensão dos outros dois pontos que abordaremos em seguida.
O banco de dados como fonte única da verdade
No artigo anterior, começamos definindo de maneira simples qual resposta nosso banco de dados deveria fornecer ao EA para permitir a atualização do modelo em tempo real. Esse é um tipo de atalho frequentemente utilizado em abordagens de desenvolvimento de baixo para cima (bottom-up). Primeiro, identificamos a necessidade imediata e, em seguida, desenvolvemos uma solução para atendê-la. Isso evita complexidade desnecessária na arquitetura e facilita eventuais ajustes de direção. A seguir, reproduzimos o trecho correspondente do artigo anterior.
Em última análise, nosso banco de dados deve responder a uma pergunta muito simples: quais ativos devemos negociar agora para obter o maior lucro possível?
Retomando o artigo anterior desta série, no qual determinamos a direção e o volume das ordens com base nos pesos das ações na carteira, uma possível resposta seria semelhante à seguinte:
| Símbolos | Pesos | Timeframe |
|---|---|---|
| "MU", "NVDA", "MPWR", "MCHP" | 2,699439, 1,000000, -1,877447, -2,505294 | D1 (timeframe diário) |
Tabela 1. Exemplo de resposta esperada à consulta para atualização do modelo em tempo real (artigo anterior)
Para obter essa resposta, adicionamos uma nova tabela ao esquema do nosso banco de dados, chamada "strategy". Ela contém quatro campos do tipo TEXT:- Nome (PRIMARY KEY)
- Símbolos
- Pesos
- Timeframe
-- strategy definition

CREATE TABLE strategy (
        name TEXT CHECK(LENGTH(name) <= 20) NOT NULL,
        symbols TEXT CHECK(LENGTH(symbols) <= 255) NOT NULL,
        weights TEXT CHECK(LENGTH(weights) <= 255),
        timeframe TEXT CHECK (
        timeframe IN (
            'M1',
            'M2',
            'M3',
            'M4',
            'M5',
            'M6',
            'M10',
            'M12',
            'M15',
            'M20',
            'M30',
            'H1',
            'H2',
            'H3',
            'H4',
            'H6',
            'H8',
            'H12',
            'D1',
            'W1',
            'MN1'
        )
    ),CONSTRAINT strategy_pk PRIMARY KEY (name)
) WITHOUT ROWID, STRICT;
Definimos essa tabela como WITHOUT ROWID. No SQLite, as tabelas convencionais utilizam ROWID, inclusive aquelas que possuem uma coluna declarada como INTEGER PRIMARY KEY. As tabelas WITHOUT ROWID constituem uma modalidade distinta, enquanto as tabelas virtuais seguem regras próprias. Nas tabelas ROWID, uma chave primária que não seja do tipo INTEGER PRIMARY KEY não funciona necessariamente como uma chave primária verdadeira.
Portanto, ao definir a tabela como WITHOUT ROWID, impedimos a inserção de valores NULL na chave primária, preservando a integridade relacional. A desvantagem é que essa definição é específica do SQLite, o que significa que nosso esquema deixa de ser totalmente portável para outros sistemas gerenciadores de bancos de dados (SGBDs). Caso desejemos utilizar o mesmo esquema em outro SGBD, precisaremos adaptá-lo. Ainda assim, considero que as vantagens de impedir a inserção de valores NULL no campo da chave primária justificam esse custo adicional.
Como você deve ter percebido, "symbols" e "weights" são arrays. Entretanto, o SQLite não possui um tipo de dados ARRAY. Diante dessa limitação, armazenaremos esses dados como texto, utilizando a formatação de arrays JSON. Essa escolha facilitará uma eventual migração para outro SGBD que ofereça suporte ao tipo de dados ARRAY.
| Nome | Símbolos | Pesos | Timeframe |
|---|---|---|---|
| Nasdaq_NVDA_Coint | ["MU", "NVDA", "MPWR", "MCHP"] | ["2,699439", "1,000000", "-1,877447", "-2,505294"] | D1 |
Tabela 2. Os dados de símbolos e pesos são inseridos na tabela "strategy" como texto do tipo TEXT, formatado em arrays JSON
Para recuperar esses dados, utilizaremos a função json_extract() do SQLite.
Assim, o esquema do nosso banco de dados, atualizado para a versão statarb-0.2, agora inclui a tabela adicional "strategy". Seu diagrama entidade-relacionamento é apresentado a seguir:
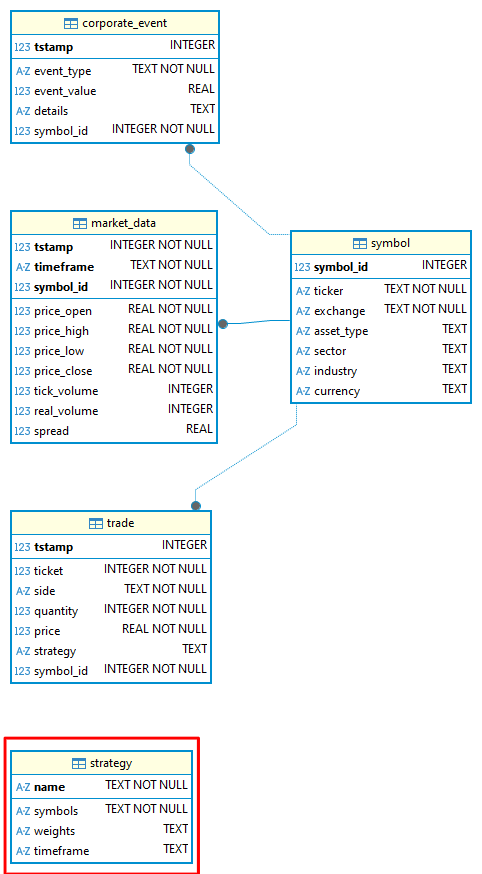
Figura 1. Diagrama entidade-relacionamento (ERD) do banco de dados statarb-0.2
DICA: Ao desenvolver soluções com SQLite, normalmente NÃO excluo as versões anteriores dos arquivos de banco de dados nem dos arquivos de esquema. Como o banco de dados é armazenado em um único arquivo, basta copiá-lo, renomear a cópia para identificar a nova versão e manter ambas as versões em um sistema de controle de versão (VCS). Essa prática oferece uma maneira simples de reverter para uma versão anterior, caso seja necessário.

Figura 2. Navegador do MetaEditor exibindo diferentes versões dos arquivos SQLite (bancos de dados) e seus respectivos arquivos de esquema
Como podemos observar no diagrama ERD acima, nossa nova tabela "strategy" ainda não está relacionada a nenhuma outra tabela. Isso mudará quando começarmos a realizar backtests ou negociar com essa nova versão do EA, estabelecendo uma relação com a tabela "trade". Como estamos seguindo uma abordagem de desenvolvimento de baixo para cima (bottom-up), faremos alterações no banco de dados apenas quando houver necessidade. Por enquanto, a tabela "strategy" funciona exclusivamente como uma interface, permitindo a comunicação entre nosso sistema de análise de dados e as plataformas de negociação.
O banco de dados funcionará como interface entre nosso sistema de análise de dados e o EA, bem como entre o sistema de seleção de ativos, responsável por aplicar os resultados dessa análise, e o EA. O fluxo será aproximadamente o seguinte:
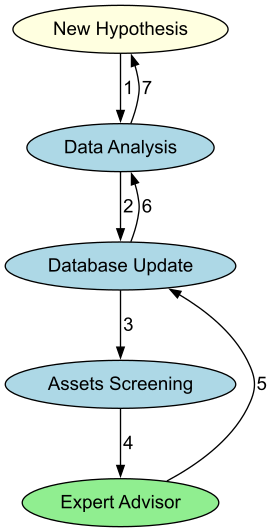
Figura 3. Fluxograma que ilustra o funcionamento cíclico do nosso pipeline de arbitragem estatística
Lado Python
Passamos de tarefas individuais executadas no Jupyter para um único script Python, responsável por executar um pipeline completo de arbitragem estatística com ações cointegradas. Esse script realizará as seguintes etapas:
Verificar se o banco de dados SQLite existe.
def CheckForDb(db_path: str | Path) -> bool:
    """Return True if the SQLite database file exists on disk."""
    exists = Path(db_path).is_file()
    logger.info("Database exists: %s (%s)", exists, db_path)
    return exists
Caso o banco de dados não seja encontrado, um novo será criado. Isso é especialmente útil para quem não acompanha esta série de artigos e deseja apenas experimentar o pipeline de arbitragem estatística. Nesse caso, basta fornecer o esquema do banco de dados (disponibilizado abaixo).
def CreateDbIfMissing(db_path: str | Path, schema_path: Optional[str | Path] = None) -> None:
    """
    If the database does not exist and a schema is provided, create it from SQL.
    Otherwise, create an empty file (SQLite creates DB on first connection).
    """
    db_path = Path(db_path)
    if db_path.exists():
        logger.info("DB already present: %s", db_path)
        return
    logger.info("DB missing; creating: %s", db_path)

    with sqlite3.connect(db_path) as conn:
        if schema_path:
            schema_sql = Path(schema_path).read_text(encoding="utf-8")
            conn.executescript(schema_sql)
            logger.info("Applied schema from: %s", schema_path)
Conectar-se ao terminal MetaTrader 5.
def InitMT5(login: Optional[int] = None, password: Optional[str] = None,
            server: Optional[str] = None, path: Optional[str] = None) -> None:

    """Initialize connection to the running MetaTrader 5 terminal."""

    if mt5 is None:
        raise RuntimeError("MetaTrader5 package not available.")

    # if not mt5.initialize(path=path, login=login, password=password, server=server):
    if not mt5.initialize():
        raise RuntimeError(f"MT5 initialize() failed: {mt5.last_error()}")
    logger.info("MetaTrader5 initialized.")
Baixar os dados de mercado do MetaTrader 5.
def DownloadMarketData(symbols: List[str], timeframes: List[str], bars: int = 5000
                       ) -> Dict[Tuple[str, str], pd.DataFrame]:
    """
    Download OHLCV data from MT5 for each (symbol, timeframe).
    Returns dict with keys (symbol, timeframe) -> DataFrame columns:
    ['tstamp','timeframe','open','high','low','close','tick_volume','real_volume','spread']
    """
    if mt5 is None:
        raise RuntimeError("MetaTrader5 package not available.")
    out: Dict[Tuple[str, str], pd.DataFrame] = {}

    for sym in symbols:
        for tf in timeframes:
            tf_const = _mt5_timeframe_constant(tf)
            rates = mt5.copy_rates_from_pos(sym, tf_const, 0, bars)

            if rates is None or len(rates) == 0:
                logger.warning("No data for %s %s", sym, tf)
                continue

            df = pd.DataFrame(rates)

            # Rename & select
            df = df.rename(columns={
                "time": "tstamp",
                "open": "price_open",
                "high": "price_high",
                "low": "price_low",
                "close": "price_close",
                "real_volume": "real_volume",
            })

            df["timeframe"] = tf

            cols = ["tstamp","timeframe","price_open","price_high","price_low","price_close",
                    "tick_volume","real_volume","spread"]
            df = df[cols].copy()
            out[(sym, tf)] = df
            logger.info("Downloaded %d bars for %s %s", len(df), sym, tf)
    return out
Armazenar esses dados de mercado no banco de dados SQLite.
def StoreMarketData(db_path: str | Path, data: Dict[Tuple[str, str], pd.DataFrame]) -> None:

    """Upsert market data into SQLite according to the provided schema."""
    with sqlite3.connect(db_path) as conn:
        for (sym, tf), df in data.items():
            symbol_id = _ensure_symbol(conn, sym)

            df = df.copy()
            df["symbol_id"] = symbol_id

            # Use executemany for performance
            sql = """
            INSERT OR REPLACE INTO market_data
            (tstamp, timeframe, price_open, price_high, price_low, price_close,
             tick_volume, real_volume, spread, symbol_id)
            VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
            """

            rows = list(df[["tstamp","timeframe","price_open","price_high","price_low","price_close",
                            "tick_volume","real_volume","spread","symbol_id"]].itertuples(index=False, name=None))
            conn.executemany(sql, rows)
            conn.commit()

            logger.info("Stored %d rows for %s %s", len(rows), sym, tf)
Verificar o coeficiente de correlação de Pearson para os símbolos selecionados.
def RunCorrelationTest(prices: pd.DataFrame, plot: bool = True) -> Tuple[pd.DataFrame, Tuple[str, str], float]:

    """Compute Pearson correlation matrix and return the most correlated pair (off-diagonal)."""
    corr = prices.corr(method="pearson")

    # Mask diagonal, find max
    corr_values = corr.where(~np.eye(len(corr), dtype=bool))
    idxmax = np.unravel_index(np.nanargmax(corr_values.values), corr_values.shape)
    symbols = corr.columns.tolist()
    pair = (symbols[idxmax[0]], symbols[idxmax[1]])
    value = corr_values.values[idxmax]

    logger.info("Most correlated pair: %s ~ %s (r=%.4f)", pair[0], pair[1], value)

    if plot:
        plt.figure(figsize=(10, 7))
        sns.heatmap(corr, annot=False, vmin=-1, vmax=1, cmap="coolwarm", square=True)
        plt.title("Pearson Correlation Heatmap")
        plt.tight_layout()
        plt.show()

    print(f"Most correlated pair: {pair[0]} ~ {pair[1]} (r={value:.4f})")

    return corr, pair, float(value)
Calcular o coeficiente de cointegração de Engle-Granger para os símbolos selecionados e identificar o par com a maior correlação.
def RunEngleGrangerTest(prices: pd.DataFrame, plot: bool = True ) -> Tuple[Tuple[str, str], float, float, pd.Series]: """ Loop over all symbol pairs, run statsmodels.coint (Engle-Granger). Return: best_pair, best_pvalue, hedge_ratio (y_on_x), spread series (y - beta*x) """ best_pair, best_p, best_beta, best_spread = None, 1.0, np.nan, None cols = list(prices.columns) for y_sym, x_sym in itertools.combinations(cols, 2): y = prices[y_sym].dropna() x = prices[x_sym].dropna() join = pd.concat([y, x], axis=1).dropna() if len(join) < 50: continue score, pvalue, _ = coint(join.iloc[:,0], join.iloc[:,1]) if pvalue < best_p: beta = _ols_hedge_ratio(join.iloc[:,0], join.iloc[:,1]) spread = join.iloc[:,0] - beta * join.iloc[:,1] best_pair, best_p, best_beta, best_spread = (y_sym, x_sym), pvalue, beta, spread if best_pair is None: raise ValueError("No cointegrated pairs found (Engle-Granger) with sufficient data.") print(f"Most cointegrated pair (Engle-Granger): {best_pair[0]} ~ {best_pair[1]} (p={best_p:.6f}, beta={best_beta:.4f})") if plot: fig, ax = plt.subplots(figsize=(10, 5)) ax.plot(prices.index, prices[best_pair[0]], label=best_pair[0]) ax.plot(prices.index, prices[best_pair[1]]*best_beta, label=f"{best_pair[1]} * beta") ax.set_title(f"Best EG Pair Overlay (beta={best_beta:.4f})") ax.legend() fig.tight_layout() plt.show()fig2, ax2 = plt.subplots(figsize=(10, 4)) ax2.plot(best_spread.index, best_spread.values, label="Spread") ax2.axhline(0, line) ax2.set_title("Spread (y - beta*x)")
ax2.legend() fig2.tight_layout()
plt.show()
return best_pair, float(best_p), float(best_beta), best_spread
Executar os testes de estacionariedade ADF e KPSS para o spread de Engle-Granger.
def RunADFTest(series: pd.Series) -> Tuple[float, float, dict]:
    """Augmented Dickey-Fuller test on a univariate series."""
    series = pd.Series(series).dropna()
    adf_stat, pvalue, usedlag, nobs, crit, icbest = adfuller(series, autolag="AIC")

    print(f"ADF: stat={adf_stat:.4f}, p={pvalue:.6f}, lags={usedlag}, nobs={nobs}, crit={crit}")

    return float(adf_stat), float(pvalue), crit
def RunKPSSTest(series: pd.Series, regression: str = "c") -> Tuple[float, float, dict]:

    """KPSS stationarity test on a univariate series (regression='c' or 'ct')."""
    series = pd.Series(series).dropna()
    stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")

    print(f"KPSS({regression}): stat={stat:.4f}, p={pvalue:.6f}, lags={lags}, crit={crit}")

    return float(stat), float(pvalue), crit
Executar o teste de cointegração de Johansen, utilizando os pesos da carteira obtidos do primeiro autovetor quando o posto for >= 1.
def RunJohansenTest(prices: pd.DataFrame, det_order: int = 0, k_ar_diff: int = 1, plot: bool = True
                    ) -> Tuple[int, np.ndarray, np.ndarray, Optional[pd.Series]]:
    """
    Johansen cointegration test on a set of symbols (>=2).
    Returns: (rank, eigenvectors (beta), eigenvalues, spread_from_first_vector or None)
    - Significant rank determined by trace statistics vs 95% critical values.
    - First eigenvector provides portfolio weights (normalized s.t. min(|w|)=1 or w[-1]=1).
    """

    data = prices.dropna().values

    if data.shape[1] < 2:
        raise ValueError("Johansen requires at least two series.")

    joh = coint_johansen(data, det_order, k_ar_diff)

    # Significant rank by trace statistic > crit value (95% = column index 1)
    trace_stats = joh.lr1  # trace stats
    crit_vals = joh.cvt[:, 1]  # 95%
    rank = int(np.sum(trace_stats > crit_vals))
    print("Johansen trace stats:", trace_stats)

    print("Johansen 95% crit vals:", crit_vals)

    print(f"Johansen inferred rank: {rank}")

    weights = None
    spread = None

    if rank >= 1:

        # Beta columns are cointegrating vectors; take the first (associated with largest eigenvalue)
        beta = joh.evec  # shape (k, k)
        eigvals = joh.eig  # shape (k,)

        # Sort by eigenvalue desc to be explicit
        order = np.argsort(eigvals)[::-1]
        beta_sorted = beta[:, order]
        eig_sorted = eigvals[order]
        first_vec = beta_sorted[:, 0]

        # Normalize such that the weight of the last symbol is 1 (common in practice)
        if first_vec[-1] == 0:
            norm = np.max(np.abs(first_vec))
        else:
            norm = first_vec[-1]

        weights = first_vec / norm

        print("First Johansen eigenvector (portfolio weights):")

        for sym, w in zip(prices.columns, weights):
            print(f"  {sym:>12s}: {w:+.6f}")

        # Spread = P * weights
        spread = pd.Series(prices.values @ weights, index=prices.index, name="JohansenSpread")

        if plot:
            fig, ax = plt.subplots(figsize=(10, 4))
            ax.plot(spread.index, spread.values, label="Johansen Spread")
            ax.axhline(0, linestyle="--")
            ax.set_title("Johansen Spread (1st eigenvector)")
            ax.legend()
            fig.tight_layout()

            plt.show()

        return rank, beta_sorted, eig_sorted, spread, weights

    return rank, joh.evec, joh.eig, weights, None
Se algum posto no teste de cointegração de Johansen apresentar significância estatística, o script também executará os testes ADF e KPSS para o spread de Johansen e, por fim, armazenará os parâmetros da estratégia (símbolos, pesos e timeframe) na tabela "strategy", conforme mencionado na seção anterior.
def StoreJohansenStrategy(db_path: str | Path, name: str, symbols: List[str],
                          weights: np.ndarray, timeframe: str) -> None:
    """
    Store Johansen eigenvector (portfolio weights) and symbols into the strategy table.
    Symbols and weights are stored as JSON arrays (text).
    """

    import json

    with sqlite3.connect(db_path) as conn:
        cur = conn.cursor()
        cur.execute("""
            INSERT OR REPLACE INTO strategy (name, symbols, weights, timeframe)
            VALUES (?, ?, ?, ?)
        """, (
            name,
            json.dumps(symbols),
            json.dumps([float(w) for w in weights]),
            timeframe
        ))
        conn.commit()

    logger.info("Stored Johansen strategy '%s' with symbols=%s timeframe=%s",
                name, symbols, timeframe)
Para facilitar a análise, o programa fará pausas durante a execução e gerará gráficos para o timeframe correspondente em cada etapa relevante, por exemplo, para visualizar a dispersão dos dados. Assim, você poderá avaliar se os símbolos selecionados merecem uma análise mais aprofundada e, se necessário, alterar sua ordem na lista (para o teste de Engle-Granger) ou ajustar o intervalo de tempo. Esse script funciona como uma ferramenta de seleção manual de ativos, antes de avançarmos, na próxima etapa, para um pipeline totalmente automatizado. Cada tarefa foi implementada em uma função independente, permitindo sua importação e reutilização em outros scripts.
ATENÇÃO: Este script é o ponto de entrada do nosso sistema. Assim que uma nova lista de símbolos for definida nele, será necessário adicioná-la ao serviço de atualização do banco de dados. Isso permitirá que o banco de dados continue sendo atualizado normalmente, mesmo que o EA não esteja em execução por algum motivo. Por enquanto, essa etapa precisa ser realizada manualmente.
Para executar o script, chame-o pela linha de comando, informando os parâmetros necessários. Por exemplo:
PS C:\Users\your\path\to\JupyterNotebooks\StatArb\coint> python py/stat_arb_pipeline_mt5.py --db $env:STATARB_DB_PATH --schema sql/schema-0.2.sql --symbols "MU,NVDA,MPWR,MCHP" --timeframes "D1" --bars 1000 --run
Como podemos observar, utilizamos uma variável de ambiente para definir o caminho do banco de dados. Se a execução for bem-sucedida e o teste de Johansen não identificar cointegração, a saída deverá ser semelhante à seguinte:
03.09.2025 15:35:24,588 [INFO] Banco de dados existente: True (C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db)
03.09.2025 15:35:24,589 [INFO] Utilizando o banco de dados existente em C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db.
03.09.2025 15:35:24,605 [INFO] MetaTrader 5 inicializado.
03.09.2025 15:35:24,613 [ИНФО] Carregadas 1000 barras para MU D1
03.09.2025 15:35:24,618 [ИНФО] Carregadas 1000 barras para NVDA D1
03.09.2025 15:35:24,625 [ИНФО] Carregadas 1000 barras para MPWR D1
03.09.2025 15:35:24,633 [ИНФО] Carregadas 1000 barras para MCHP D1
03.09.2025 15:35:24,997 [INFO] Armazenadas 1000 linhas para MU D1
03.09.2025 15:35:25,261 [ИНФО] Armazenadas 1000 linhas para NVDA D1
03.09.2025 15:35:25,514 [INFO] Armazenadas 1000 linhas para MPWR D1
03.09.2025 15:35:25,870 [INFO] Armazenadas 1000 linhas para MCHP D1
03.09.2025 15:35:25,871 [INFO] MetaTrader 5 encerrado.
03.09.2025 15:35:25,961 [INFO] ReadMarketData: Timeframe D1, 1000 linhas, 4 instrumentos
03.09.2025 15:35:25,964 [INFO] Par com maior correlação: MPWR ~ NVDA (r = 0,8335)
Par com maior correlação: MPWR ~ NVDA (r = 0,8335)
Par com maior cointegração (segundo Engle-Granger): MPWR ~ MU (p = 0,010558, beta = 5,4940)
Testes ADF e KPSS para o spread de Engle-Granger:
ADF: stat=-3.8778, p=0.002204, lags=16, nobs=983, crit={'1%': np.float64(-3.4370198458812156), '5%': np.float64(-2.864484708707697), '10%': np.float64(-2.568337912084273)}
C:\Users\your\path\to\JupyterNotebooks\StatArb\coint\py\stat_arb_pipeline_mt5.py:321: InterpolationWarning: A estatística do teste está fora do intervalo de valores-p disponível na tabela. O valor-p real é menor do que o valor-p retornado.
stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")
KPSS(c): stat=0,9279, p=0,010000, lags=19, crit={'10%': 0,347, "5 %": 0,463, "2,5 %": 0,574, "1 %": 0,739}
Teste de cointegração de Johansen para todos os símbolos informados:
Estatísticas do traço de Johansen: [34.26486877 18.91156161 8.04865462 0.11018312]
Valores críticos do teste de Johansen (95%): [47,8545 29,7961 15,4943 3,8415]
Posto estimado pelo teste de Johansen: 0
Como mencionado anteriormente, quando o teste de Johansen identificar um posto estatisticamente significativo (>= 1), ou seja, quando houver pelo menos um vetor de cointegração entre os símbolos selecionados, o script armazenará os valores do primeiro autovetor (pesos da carteira) na tabela "strategy" do banco de dados. Além disso, executará os testes ADF e KPSS para o spread correspondente.
PS C:\Users\your\path\to\JupyterNotebooks\StatArb\coint> python py/stat_arb_pipeline_mt5.py --db $env:STATARB_DB_PATH --schema sql/schema-0.2.sql --symbols "MU,NVDA,MPWR,MCHP" --timeframes "H4" --bars 90 --run
Nesse caso, a saída exibida no Windows PowerShell ou no terminal deverá ser semelhante à seguinte:
03.09.2025 15:50:43,168 [INFO] Banco de dados existente: True (C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db)
03.09.2025 15:50:43,169 [INFO] Utilizando o banco de dados existente em C:\Users\your\path\to\Files\StatArb\statarb-0.2.db.
03.09.2025 15:50:43,188 [ИНФО] MetaTrader 5 inicializado.
03.09.2025 15:50:44,297 [ИНФО] Carregadas 90 barras para MU H4
03.09.2025 15:50:44,357 [ИНФО] Carregadas 90 barras para NVDA H4
03.09.2025 15:50:46,322 [ИНФО] Carregadas 90 barras para MPWR H4
03.09.2025 15:50:46,732 [ИНФО] Carregadas 90 barras para MCHP H4
03.09.2025 15:50:49,148 [ИНФО] Armazenadas 90 linhas para MU H4
03.09.2025 15:50:49,160 [ИНФО] Armazenadas 90 linhas para NVDA H4
03.09.2025 15:50:49,171 [ИНФО] Armazenadas 90 linhas para MPWR H4
03.09.2025 15:50:49,276 [INFO] Armazenadas 90 linhas para MCHP H4
03.09.2025 15:50:49,277 [ИНФО] MetaTrader 5 encerrado.
03.09.2025 15:50:49,617 [ИНФО] ReadMarketData: Timeframe H4, 90 linhas, 4 símbolos
03.09.2025 15:50:49,622 [ИНФО] Par com maior correlação: MPWR ~ NVDA (r = 0,6115)
Par com maior correlação: MPWR ~ NVDA (r = 0,6115)
Par com maior cointegração (segundo Engle-Granger): MU ~ NVDA (p = 0,072055, β = −0,2391)
Testes ADF e KPSS para o spread de Engle-Granger:
ADF: stat=-3.1693, p=0.021831, lags=0, nobs=89, crit={'1%': np.float64(-3.506057133647011), '5%': np.float64(-2.8946066061911946), '10%': np.float64(-2.5844100201994697)}
C:\Users\your\path\to\JupyterNotebooks\StatArb\coint\py\stat_arb_pipeline_mt5.py:321: InterpolationWarning: A estatística do teste está fora do intervalo de valores-p disponível na tabela. O valor-p real é maior do que o valor-p retornado.
stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")
KPSS(c): stat=0,1793, p=0,100000, lags=5, crit={'10%': 0,347, "5 %": 0,463, "2,5 %": 0,574, "1 %": 0,739}
Teste de cointegração de Johansen para todos os símbolos informados:
Estatísticas do traço de Johansen: [63.23695088 32.35462044 16.63904745 5.4295422 ]
Valores críticos do teste de Johansen (95%): [47,8545 29,7961 15,4943 3,8415]
Posto estimado pelo teste de Johansen: 4
Primeiro autovetor de Johansen (pesos da carteira):
MCHP: +0,273652
MPWR: -0,148092
MU: +2,256498
NVDA: +1,000000
Testes ADF e KPSS para o spread de Engle-Granger:
ADF: stat=-4.1427, p=0.000823, lags=1, nobs=88, crit={'1%': np.float64(-3.506944401824286), '5%': np.float64(-2.894989819214876), '10%': np.float64(-2.584614550619835)}
KPSS(c): stat=0,4009, p=0,076784, lags=4, crit={'10%': 0,347, "5 %": 0,463, "2,5 %": 0,574, "1 %": 0,739}
03.09.2025 15:50:50,051
[ИНФО] Estratégia de Johansen "Nasdaq_NVDA_Coint" armazenada com símbolos=['MCHP', 'MPWR', 'MU', 'NVDA'] e timeframe=H4
Mas o que significam os avisos de interpolação mencionados anteriormente?
Esses avisos estão relacionados ao teste de estacionariedade KPSS aplicado ao spread de Engle-Granger. Eles indicam que obtivemos resultados extremos, fora do intervalo de valores contemplado pela tabela de referência do teste. Em termos práticos, os avisos indicam que o spread de Engle-Granger é:
- fortemente estacionário (o valor-p real é maior do que o valor-p retornado);
- ou fortemente não estacionário (o valor-p real é menor do que o valor-p retornado).
Como nosso foco atual é a atualização dos parâmetros do modelo em tempo real, podemos ignorar esses avisos por enquanto. Voltaremos a analisá-los com mais atenção na próxima etapa, quando abordarmos a seleção dos ativos.
Lado MQL5
No arquivo principal, mantivemos apenas os manipuladores de eventos do EA. Todas as demais funções foram transferidas para o arquivo de cabeçalho Nasdaq_NVDA_Coint.mqh.
Anteriormente, os parâmetros da estratégia eram definidos diretamente no código, com valores fixos. Agora, são armazenados em variáveis globais.
// Global variables
string symbols[] = {}; // Asset symbols
double weights[] = {}; // Portfolio weights
ENUM_TIMEFRAMES timeframe = PERIOD_CURRENT; // Strategy cointegrated timeframe
Essas variáveis globais são verificadas diretamente no manipulador de eventos OnInit().
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+

int OnInit()
  {
   ResetLastError();

// Check if all symbols are available
   for(int i = 0; i < ArraySize(symbols); i++)
     {
      if(!SymbolSelect(symbols[i], true))
        {
         Print("Error: Symbol ", symbols[i], " not found!");
         return(INIT_FAILED);
        }
     }
// Initialize spread buffer
   ArrayResize(spreadBuffer, InpLookbackPeriod);

// Set a timer for spread, mean, and stdev calculations
   EventSetTimer(InpUpdateFreq * 60); // min one minute

// Load strategy parameters from database
   if(!LoadStrategyFromDB(InpDbFilename,
                                InpStrategyName,
                                symbols,
                                weights,
                                timeframe))
     {
      // Handle error - maybe use default values
      printf("Error at " + __FUNCTION__ + " %s ",
             getUninitReasonText(GetLastError()));
      return INIT_FAILED;
     }
   return(INIT_SUCCEEDED);
  }
A função LoadStrategyFromDB() está localizada no arquivo de cabeçalho.
//+------------------------------------------------------------------+
//|          Load strategy parameter from database                   |
//+------------------------------------------------------------------+

bool LoadStrategyFromDB(string db_name,
                        string strat_name,
                        string &symbols_arr[],
                        double &weights_arr[],
                        ENUM_TIMEFRAMES &tf)
  {

// Open the database (Metatrader's integrated SQLite)
   int db = DatabaseOpen(db_name, DATABASE_OPEN_READONLY);
   if(db == INVALID_HANDLE)
     {
      Print("Failed to open database: %s", GetLastError());
      return false;
     }
// Prepare the SQL query with json_extract
   string query = StringFormat(
                     "SELECT "
                     "json_extract(symbols, '$') as symbols_json, "
                     "json_extract(weights, '$') as weights_json, "
                     "timeframe "
                     "FROM strategy WHERE name = '%s'",
                     strat_name
                  );

// Execute the query
   int result = DatabasePrepare(db, query);

   if(result <= 0)
     {
      Print("Failed to prepare query: ", GetLastError());
      DatabaseClose(db);
      return false;
     }

// Read the results
   if(DatabaseRead(result))
     {
      // Get symbols_arr JSON array and parse it
      string symbolsJson;
      DatabaseColumnText(result, 0, symbolsJson);
      ParseJsonArray(symbolsJson, symbols_arr);

      // Get weights_arr JSON array and parse it
      string weightsJson;
      DatabaseColumnText(result, 1, weightsJson);
      ParseJsonDoubleArray(weightsJson, weights_arr);

      // Get tf string and convert to ENUM_TIMEFRAMES
      string timeframeStr;
      DatabaseColumnText(result, 2, timeframeStr);
      tf = StringToTimeframe(timeframeStr);

      Print("Successfully loaded strategy: ", strat_name);

      Print("Symbols JSON: ", symbolsJson);
      Print("Weights JSON: ", weightsJson);
      Print("Timeframe: ", timeframeStr);
     }
   else
     {
      Print("Strategy not found: ", strat_name);

      DatabaseFinalize(result);
      DatabaseClose(db);
      return false;
     }
// Clean up

   DatabaseFinalize(result);
   DatabaseClose(db);
   return true;
  }
Como mencionado anteriormente, utilizaremos a função json_extract() do SQLite para ler os arrays de símbolos e pesos da carteira. Sua assinatura é a seguinte:
json_extract(json, path)
Onde:
- "json" é uma coluna de texto ou uma string que contém dados no formato JSON.
- "path" é uma expressão de caminho JSON que indica a localização do valor a ser extraído. Normalmente, começa com o símbolo $, que representa a raiz do documento JSON, seguido pela notação de pontos para acessar chaves de objetos ($.key) ou pela notação de colchetes para acessar índices de arrays ($[index]). É essa última forma que utilizaremos para ler os elementos dos arrays.
As duas funções auxiliares a seguir fazem o parsing dos arrays JSON. Elas processam os dados removendo os colchetes e as aspas e, em seguida, dividindo o texto pelas vírgulas.
ParseJsonArray()
Faz o parsing de arrays JSON de strings, como ["MU", "NVDA", "MPWR", "MCHP"].
// Helper function to parse JSON array of strings
void ParseJsonArray(string json, string &array[])
  {
// Remove brackets and quotes from JSON array
   string cleaned = StringSubstr(json, 1, StringLen(json) - 2); // Remove [ and ]
   StringReplace(cleaned, "\"", ""); // Remove quotes

// Split by commas
   StringSplit(cleaned, ',', array);

// Trim whitespace from each element
   for(int i = 0; i < ArraySize(array); i++)
     {
      array[i] = StringTrim(array[i]);
     }
  }
ParseJsonDoubleArray()
Faz o parsing de arrays JSON de números, como [2.699439, 1.000000, -1.877447, -2.505294].
// Helper function to parse JSON array of doubles
void ParseJsonDoubleArray(string json, double &array[])
  {
// Remove brackets from JSON array
   string cleaned = StringSubstr(json, 1, StringLen(json) - 2); // Remove [ and ]

// Split by commas
   string stringArray[];
   int count = StringSplit(cleaned, ',', stringArray);

// Convert to double array
   ArrayResize(array, count);

   for(int i = 0; i < count; i++)
     {
      array[i] = StringToDouble(StringTrim(stringArray[i]));
     }
  }
Também adicionamos a função:
StringTrim()
Responsável por remover os espaços em branco que possam estar presentes nos valores JSON.
// Helper function to trim whitespace
string StringTrim(string str)
  {

// Trim leading whitespace
   while(StringLen(str) > 0 && str[0] == ' ')
     {
      str = StringSubstr(str, 1);
     }

// Trim trailing whitespace
   while(StringLen(str) > 0 && str[StringLen(str) - 1] == ' ')
     {
      str = StringSubstr(str, 0, StringLen(str) - 1);
     }

   return str;
  }
Existem bibliotecas para manipulação de JSON disponíveis na MQL5 CodeBase. Se você passar a trabalhar com objetos JSON com mais frequência, pode valer a pena conhecer essas bibliotecas e avaliar suas vantagens. Neste caso simples, porém, considero que os benefícios não são suficientes para justificar a inclusão de uma dependência externa.
A função auxiliar
StringToTimeframe()
converte uma string que representa um timeframe armazenado no banco de dados no valor correspondente da enumeração ENUM_TIMEFRAMES do MQL5.
// Helper function to convert tf string to ENUM_TIMEFRAMES
ENUM_TIMEFRAMES StringToTimeframe(string tfStr)
  {
   if(tfStr == "M1")
      return PERIOD_M1;
   if(tfStr == "M2")
      return PERIOD_M2;
.
.
.
   if(tfStr == "MN1")
      return PERIOD_MN1;
   return PERIOD_CURRENT; // Default if not found
  }
Além de verificar os parâmetros da estratégia na função OnInit(), executada quando o EA é iniciado ou reiniciado, também atualizamos os parâmetros em intervalos regulares no manipulador de eventos OnTimer(), utilizando uma função que chama a mesma rotina de leitura do banco de dados. O intervalo de atualização é configurável pelo usuário.
// Set a timer for spread, mean, and stdev calculations
// and strategy parameters update (check DB)
   EventSetTimer(InpUpdateFreq * 60); // min one minute

void OnTimer(void)
  {
   ResetLastError();
// Wrapper around LoadStrategyFromDB: for clarity
   if(!UpdateModelParams(InpDbFilename,
                         InpStrategyName,
                         symbols,
                         weights,
                         timeframe))
     {
      printf("%s failed: %s", __FUNCTION__, GetLastError());
     }
A função UpdateModelParams() é apenas um wrapper da função LoadStrategyFromDB().
//+------------------------------------------------------------------+
//|          Wrapper to load strategy from db                        |
//+------------------------------------------------------------------+

// Load strategy parameters from database
bool UpdateModelParams(string db_name,
                       string strat_name,
                       string &symbols_arr[],
                       double &weights_arr[],
                       ENUM_TIMEFRAMES tf)
  {
   return LoadStrategyFromDB(db_name, strat_name, symbols_arr, weights_arr, tf);
  }
Essa abordagem torna mais clara a finalidade da função.
Conclusão
Em uma cesta equilibrada de ações cointegradas utilizada em estratégias de reversão à média, os pesos da carteira precisam ser atualizados continuamente. Neste artigo, vimos como garantir o acesso aos parâmetros atualizados da estratégia, incluindo os próprios símbolos que compõem a cesta.
Explicamos como utilizar o banco de dados SQLite integrado ao MetaTrader 5 como interface entre nosso sistema de análise de dados e o ambiente de negociação, mantendo essas duas atividades separadas.
Para facilitar a implementação por leitores que não acompanham esta série de artigos, disponibilizamos um único script Python que reúne todo o pipeline de arbitragem estatística com ações cointegradas. O script executa os testes de correlação, cointegração e estacionariedade em uma única passagem e prepara o banco de dados com os parâmetros atualizados da estratégia, deixando-os disponíveis para utilização pelo EA.
Referências
Daniel P. Palomar (2025). Portfolio Optimization: Theory and Application. Cambridge University Press.
| Nome do arquivo | Descrição |
|---|---|
| StatArb/db-setup.mq5 | Script MQL5 para criar e inicializar o banco de dados SQLite a partir do arquivo de esquema schema-0.2.sql. |
| StatArb/db-update-statarb-0.2.mq5 | Serviço MQL5 responsável por atualizar o banco de dados SQLite com os dados das velas mais recentes, incluindo os preços de fechamento. |
| StatArb/Nasdaq_NVDA_Coint.mql5 | Arquivo que contém um exemplo de EA. |
| StatArb/Nasdaq_NVDA_Coint.mqh | Arquivo de cabeçalho de exemplo do EA. |
| StatArb/schema-0.2.sql | Arquivo de esquema SQL (DDL) utilizado para inicializar o banco de dados, criando tabelas, campos e restrições. |
| stat_arb_pipeline_mt5.py | Script Python que executa um pipeline completo de análise estatística de ações cointegradas, utilizando o teste de correlação de Pearson, o teste de cointegração de Johansen e os testes de estacionariedade ADF e KPSS. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19428
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.