Superando as limitações do aprendizado de máquina (Parte 3): Uma nova perspectiva sobre o erro irredutível
 16
 0

Este artigo apresenta ao leitor determinadas limitações dos modelos modernos de aprendizado de máquina sobre as quais os próprios instrutores não recebem formação explícita antes da implantação desses modelos. O campo do aprendizado de máquina é marcado por uma extensa literatura técnica e pelo uso intensivo de notação matemática. Como existem diferentes níveis de abstração nos quais um profissional pode estudar essa área, as abordagens de aprendizado variam consideravelmente. Por exemplo, alguns profissionais aprendem a utilizar modelos de aprendizado de máquina exclusivamente por meio de bibliotecas de alto nível, como o scikit-learn, que oferecem uma interface simples e intuitiva, ao mesmo tempo que abstraem os conceitos matemáticos subjacentes.
Entretanto, dependendo do nível de conhecimento e do grau de controle desejado pelo profissional, pode ser necessário ultrapassar essas camadas de abstração para compreender o que realmente acontece nos mecanismos internos dos modelos. Em qualquer projeto que utilize modelos de aprendizado de máquina, existe uma parcela de erro irredutível, embora ela raramente seja mencionada de maneira explícita.
Considere a fórmula de uma regressão linear simples. Em geral, podemos representar a variável-alvo que desejamos prever, Y, como uma função f de determinados dados de entrada mensuráveis, X. Esses dados são transformados por meio de um conjunto de coeficientes, B, para produzir a variável-alvo Y, considerando também uma parcela de ruído aleatório que não podemos observar nem controlar, representada por e. Nossa discussão de hoje se concentra justamente nesse termo de erro, e, que está presente em todos os modelos de aprendizado de máquina, embora muitas vezes passe despercebido. Nosso objetivo é demonstrar ao leitor que esse erro talvez não seja tão aleatório quanto sugere a literatura clássica. A suposição de que ele seja completamente aleatório e irredutível pode estar equivocada.
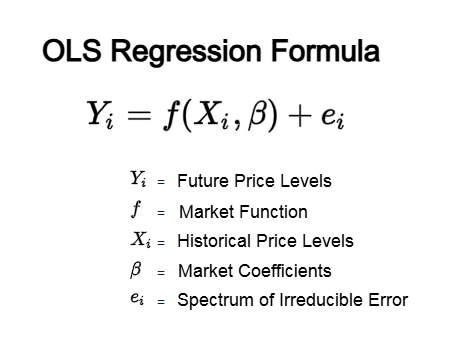
Figura 1: As explicações matemáticas da regressão por mínimos quadrados ordinários oferecem poucos detalhes sobre os erros irredutíveis e suas causas
Nosso único objetivo é oferecer ao leitor uma nova perspectiva sobre o erro irredutível, mostrando que aquilo que normalmente é tratado como uma única grandeza, o chamado "erro irredutível", pode, na verdade, ser decomposto em diferentes fontes independentes de erro. As duas primeiras são amplamente reconhecidas pela comunidade científica:
- Variabilidade intrínseca ou aleatoriedade natural do verdadeiro processo subjacente.
- Viés do próprio modelo.
Neste artigo, portanto, concentraremos nossa análise no terceiro componente do erro irredutível, que é menos conhecido. A principal conclusão é que podemos controlar essa terceira fonte de erro para melhorar os resultados de nossas operações de trading.
Os modelos de aprendizado de máquina podem ser estudados sob diferentes perspectivas, o que torna difícil para qualquer leitor dominar todas elas. Frequentemente, estudamos esses modelos sob a perspectiva estatística. No entanto, poucos leitores os analisam sob a perspectiva geométrica. É justamente nessa perspectiva que se encontra a terceira fonte de erro irredutível, que passa despercebida pelos profissionais que trabalham em níveis mais altos de abstração.
O terceiro tipo de erro não é apenas difícil de corrigir, daí o termo "irredutível", mas, acima de tudo, é difícil até mesmo de identificar. Muitas vezes, ele fica oculto em notações matemáticas concisas, o que dificulta ainda mais sua identificação.
O objetivo deste artigo não é reduzir esse erro a zero, mas demonstrar como podemos utilizar os modelos de aprendizado de máquina de maneira mais criteriosa e eficaz depois de reconhecer sua existência.
Sob a perspectiva geométrica, é importante compreender que os modelos de aprendizado de máquina não "aprendem" propriamente uma função que mapeia os parâmetros de entrada para as saídas. Na realidade, o modelo não realiza nenhuma tentativa efetiva de aproximar diretamente a função que gera a variável-alvo.
Imagine um artista desenhando em uma folha de papel. O papel funciona como uma tela na qual o artista reproduz a imagem de sua musa inspiradora. De maneira semelhante, os modelos de aprendizado de máquina utilizam os parâmetros de entrada que fornecemos para criar uma nova "tela", denominada variedade (manifold). Agora, imagine que seguramos uma moeda de modo que ela projete uma sombra sobre a "tela" criada pelo nosso modelo de aprendizado de máquina a partir dos dados fornecidos. O ponto em que essa sombra incide sobre a tela corresponde à previsão gerada pelo modelo. Entretanto, nosso verdadeiro alvo é a própria moeda, e não sua sombra. O conceito fundamental que queremos transmitir ao leitor é que nossos modelos de aprendizado de máquina, essencialmente, embutem representações do objeto-alvo em uma combinação ou variedade formada pelos dados de entrada que receberam.
Entretanto, o objeto-alvo que estamos tentando prever não necessariamente pertence à variedade que podemos construir a partir dos parâmetros de entrada, pois ele existe em sua própria variedade. Consequentemente, sempre haverá algum desvio irredutível entre a variedade formada pelos parâmetros de entrada e aquela à qual pertence o verdadeiro objeto-alvo. Essa é uma das fontes de erro. Acrescente a isso a aleatoriedade natural do processo (segunda fonte) e o viés do modelo (terceira fonte), e teremos uma visão completa do problema.
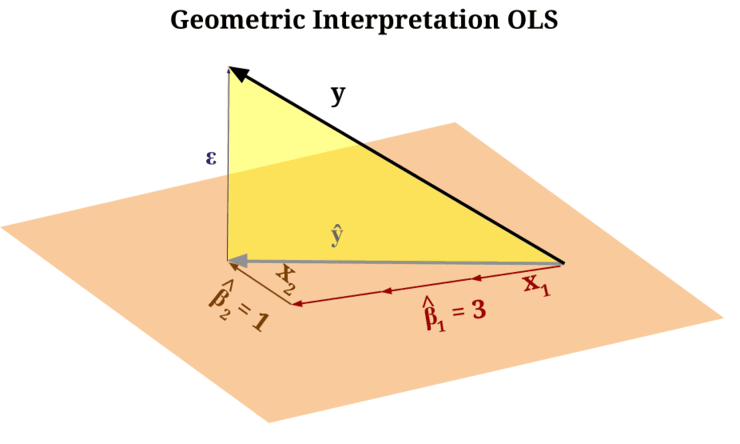
Figura 2: O "plano laranja" representa a "tela" criada pelo modelo com base nos parâmetros de entrada fornecidos, enquanto o "triângulo amarelo" representa o erro irredutível entre a tela e o verdadeiro valor-alvo
Os leitores que já conhecem geometria analítica compreenderão que o espaço linear gerado pelos parâmetros de entrada fornecidos ao modelo de aprendizado de máquina define um novo sistema de coordenadas. Em seguida, o modelo tenta descrever o objeto-alvo utilizando esse novo sistema de coordenadas, aprendido a partir dos dados de entrada. Mas lembre-se: o objeto-alvo existe em um sistema de coordenadas próprio, independente daquele definido pelos parâmetros de entrada!
Os leitores mais experientes, que já conhecem a perspectiva geométrica do aprendizado de máquina, talvez considerem a discussão a seguir evidente e possam decidir se desejam continuar acompanhando nossa análise. Já para aqueles que ainda não tiveram contato com essa forma de compreender o problema, o restante deste artigo foi escrito especialmente para vocês.
A principal conclusão é que podemos exercer certo controle sobre esse erro em nossas operações de trading, utilizando os modelos de aprendizado de máquina de forma mais consciente, deliberada e criteriosa.
Nossa análise parte do desempenho de referência estabelecido na discussão anterior sobre controladores com realimentação, cujo link está disponível aqui. Nosso controlador com realimentação melhorou significativamente os resultados em relação ao ponto de partida daquela análise. Após aplicarmos os ajustes propostos neste artigo, conseguimos superar o desempenho do controlador anterior, que já estava próximo de alcançar resultados aceitáveis.
Nossa metodologia consistiu em abandonar as comparações diretas ponto a ponto. Em vez de solicitar ao modelo uma previsão do nível futuro de preços e compará-la com o preço atual, modelamos os níveis de preços em dois intervalos de tempo e realizamos operações com base na inclinação ou tendência prevista. Em outras palavras, nossas operações seguiram a inclinação estimada pelo modelo entre os dois intervalos, em vez de depender de uma comparação direta entre os preços previstos e os preços observados.
Realizamos um backtest de cinco anos com o par de moedas EUR/USD, utilizando estratégias idênticas. A única diferença estava na configuração dos modelos utilizados para estimar os preços. Os resultados mostraram melhorias nos seguintes indicadores de desempenho:
Rentabilidade das operações
Nosso lucro líquido total aumentou de US$ 245 para US$ 253, representando uma melhora de 3% na rentabilidade. Ao mesmo tempo, o índice de Sharpe passou de 0,68 para 0,84, um aumento de 23%. Esse é um resultado expressivo para operações em um mercado financeiro tão desafiador quanto o do par EUR/USD.
Ainda mais surpreendente foi a redução do total de perdas durante os cinco anos do backtest, de US$ 838 para US$ 721, o que representa uma diminuição de 13% no risco total assumido pelo nosso sistema de trading. Além disso, o número total de operações caiu de 152 para 139, uma redução de 8% na quantidade de operações necessárias. Isso significa que nosso sistema conseguiu gerar mais lucro assumindo menos risco.Precisão das operações
Por fim, a proporção de operações lucrativas aumentou aproximadamente 4%, passando de 57,24%, registrado pelo controlador com realimentação original utilizado como referência, para 59,71% após a aplicação dos ajustes propostos. Isso significa que, de modo geral, nosso sistema se tornou mais lucrativo e menos arriscado, uma combinação ideal para qualquer aplicação de trading.
Todos os profissionais da área devem prestar muita atenção a essas mudanças. Mas, antes de avançarmos, vamos examinar os resultados de desempenho anteriores, obtidos com o primeiro controlador com realimentação que implementamos na discussão precedente.
O primeiro backtest abrangeu o período de 1º de janeiro de 2020 a 1º de maio de 2025. Manteremos exatamente o mesmo período neste segundo teste.
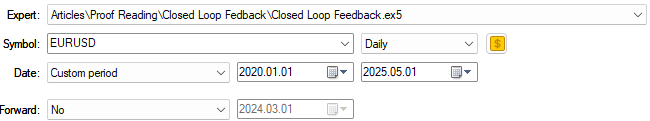
Figura 3: Revisão dos resultados de referência estabelecidos em nossa primeira discussão
O controlador com realimentação anterior já apresentava resultados bastante satisfatórios, mas ainda podemos obter um desempenho melhor. Mantivemos aqui os resultados anteriores para que o leitor possa compará-los com os novos resultados que iremos apresentar. Por isso, a Figura 4 abaixo mostra os resultados do nosso controlador com realimentação original, que servirão como referência para avaliar as melhorias.
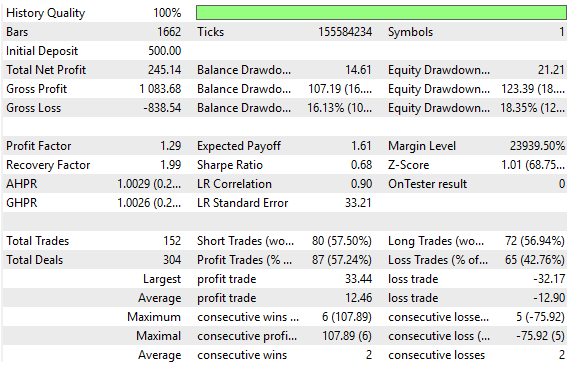
Figura 4: Resultados anteriores obtidos na primeira implementação do controlador com realimentação
A curva de capital (equity) gerada pelo controlador com realimentação anterior era promissora. Conseguimos aumentar a rentabilidade dessa estratégia ao introduzir algumas alterações na versão original, que acabaram tendo um impacto significativo no desempenho financeiro do sistema como um todo. Como podemos observar na Figura 5 abaixo, o controlador anterior só conseguiu atingir um lucro de US$ 700 em 2023. Entretanto, como veremos em breve, nosso controlador com realimentação atualizado alcançou esse mesmo patamar de lucro já em 2021. Embora a rentabilidade tenha caído acentuadamente pouco depois de 2021, as melhorias obtidas são evidentes.
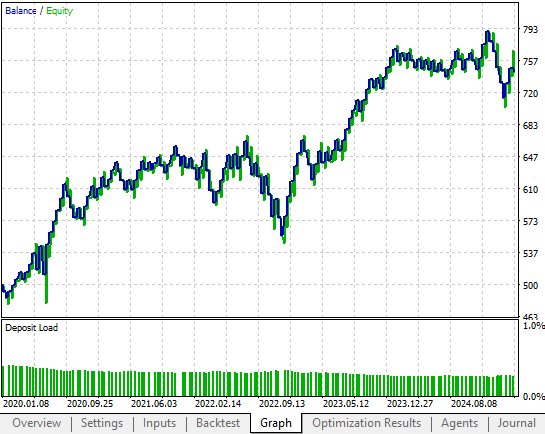
Figura 5: Curvas de lucro e de capital (equity) obtidas com a versão de referência da nossa estratégia de trading
Começando com MQL5
Como em todas as nossas aplicações de trading, começamos definindo os principais parâmetros do sistema, preservados sem alterações em relação à versão original da nossa estratégia. Vale lembrar que essas definições são importantes para garantir testes justos e comparações consistentes.//+------------------------------------------------------------------+ //| Closed Loop Feedback 1.2.mq5 | //| Gamuchirai Ndawana | //| https://www.mql5.com/ru/users/gamuchiraindawa | //+------------------------------------------------------------------+ #property copyright "Gamuchirai Ndawana" #property link "https://www.mql5.com/ru/users/gamuchiraindawa" #property version "1.00" //+------------------------------------------------------------------+ //| System definitions | //+------------------------------------------------------------------+ #define MA_PERIOD 10 #define FEATURES 12 #define TARGETS 15 #define HORIZON 10 #define OBSERVATIONS 90 #define ACCOUNT_STATES 3
Em seguida, definimos as principais variáveis globais utilizadas pela estratégia de trading. Essas variáveis permitem acompanhar os indicadores técnicos, as condições e o estado da nossa conta de negociação, o valor do stop-loss e a configuração que determina se a estratégia deve operar sem utilizar previsões ou gerar uma previsão antes de iniciar as operações. As variáveis globais nos permitem configurar e controlar o comportamento da aplicação, garantindo que seu funcionamento seja previsível e reproduzível.
//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int    ma_h_handler,ma_l_handler,atr_handler,scenes,b_matrix_scenes;
double ma_h[],ma_l[],atr[];
double padding;
matrix snapshots,OB_SIGMA,OB_VT,OB_U,b_vector,b_matrix;
vector S,prediction;
vector account_state;
bool predict,permission;
Todas as aplicações de trading também utilizam dependências para evitar a necessidade de reescrever repetidamente o mesmo código padronizado. Por isso, carregamos as bibliotecas necessárias, incluindo a biblioteca de negociação, responsável pela abertura e pelo fechamento de posições, além de duas bibliotecas personalizadas desenvolvidas para esta série de artigos: a biblioteca de tempo e a biblioteca de informações de negociação. A biblioteca de tempo permite identificar a formação de uma nova vela, enquanto a biblioteca de informações de negociação fornece dados essenciais, como o tamanho mínimo de lote permitido e os preços bid e ask atuais.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade      Trade;

Time        *DailyTimeHandler;
TradeInfo   *TradeInfoHandler;
Após a inicialização, criamos novas instâncias de todas as classes personalizadas desenvolvidas até este ponto. Também definimos as instâncias dos indicadores técnicos, como a média móvel e o ATR, além das matrizes e dos vetores necessários. Os sinalizadores booleanos são inicializados, e o contador de passos transcorridos é reiniciado em zero sempre que a aplicação é iniciada.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   DailyTimeHandler  = new Time(Symbol(),PERIOD_D1);
   TradeInfoHandler  = new TradeInfo(Symbol(),PERIOD_D1);
   ma_h_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_HIGH);
   ma_l_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_LOW);
   atr_handler       = iATR(Symbol(),PERIOD_D1,14);
   snapshots         = matrix::Ones(FEATURES,OBSERVATIONS);
   scenes            = 0;
   b_matrix_scenes   = 0;
   account_state     = vector::Zeros(3);
   b_matrix          = matrix::Zeros(1,1);
   prediction        = vector::Zeros(2);
   predict           = false;
   permission        = true;
//---
   return(INIT_SUCCEEDED);
  }
Quando a aplicação deixa de ser utilizada, recomenda-se adotar boas práticas de gestão de memória em MQL5. Por isso, excluímos as instâncias dos objetos personalizados e liberamos os recursos associados aos indicadores técnicos que não estão mais em uso.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   delete DailyTimeHandler;
   delete TradeInfoHandler;
   IndicatorRelease(ma_h_handler);
   IndicatorRelease(ma_l_handler);
   IndicatorRelease(atr_handler);
  }
Quando novas cotações são recebidas do servidor de negociação, nosso EA também executa a função OnTick. Nessa configuração, a primeira verificação consiste em determinar se uma nova vela foi formada. Isso acelera a execução dos backtests, pois as ações são executadas apenas uma vez por vela.
Após essa confirmação, atualizamos os valores dos indicadores técnicos e da variável pageant, que determina a distância a ser utilizada para o nosso stop-loss. Em seguida, verificamos o preço de fechamento mais recente. Se houver uma ou mais posições abertas, selecionamos seus respectivos tickets e ajustamos os níveis de stop-loss para que acompanhem o movimento favorável dos preços à medida que o lucro aumenta.
Para configurar o trailing stop, primeiro recuperamos os valores atuais de stop-loss e take-profit. Em seguida, comparamos esses valores com os novos níveis propostos para decidir se devemos atualizá-los. Se o nível proposto for mais vantajoso, efetuamos a atualização; caso contrário, mantemos os valores existentes. É importante destacar que, antes de realizar qualquer ajuste, precisamos identificar o tipo de posição que estamos modificando.
Se não houver posições abertas, inicializamos o vetor de estado da conta. Vale lembrar que esse vetor identifica o tipo de posição que pretendemos abrir. Se o preço de fechamento estiver acima da média móvel superior, abrimos uma posição de compra. Se estiver abaixo da média móvel inferior, abrimos uma posição de venda.
As operações são abertas diretamente quando o sinalizador booleano predict está definido como false e o sinalizador booleano permission está definido como true. Caso contrário, o sistema registra todas as variáveis e gera uma previsão antes de abrir as posições.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(DailyTimeHandler.NewCandle())
     {
      CopyBuffer(ma_h_handler,0,0,1,ma_h);
      CopyBuffer(ma_l_handler,0,0,1,ma_l);
      CopyBuffer(atr_handler,0,0,1,atr);
      padding = atr[0]*2;
      double c = iClose(Symbol(),PERIOD_D1,0);

      if(PositionsTotal() > 0)
        {
         ulong ticket = PositionSelectByTicket(PositionGetTicket(0));
         if(ticket)
           {
            double sl,tp;

            sl = PositionGetDouble(POSITION_SL);
            tp = PositionGetDouble(POSITION_TP);

            if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY)
              {
               double new_sl = TradeInfoHandler.GetBid()-padding;
               double new_tp = TradeInfoHandler.GetBid()+padding;

               if(new_sl > sl)
                  Trade.PositionModify(ticket,new_sl,new_tp);
              }

            else
               if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL)
                 {
                  double new_sl = TradeInfoHandler.GetAsk()+padding;
                  double new_tp = TradeInfoHandler.GetAsk()-padding;

                  if(new_sl < sl)
                     Trade.PositionModify(ticket,new_sl,new_tp);
                 }
           }
        }

      if(PositionsTotal() == 0)
        {
         account_state = vector::Zeros(ACCOUNT_STATES);

         if(c > ma_h[0])
           {
            if(!predict)
              {
               if(permission)
                  Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(padding)),(TradeInfoHandler.GetBid()+(padding)),"");
              }

            account_state[0] = 1;
           }

         else
            if(c < ma_l[0])
              {
               if(!predict)
                 {
                  if(permission)
                     Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(padding)),(TradeInfoHandler.GetAsk()-(padding)),"");
                 }

               account_state[1] = 1;
              }

            else
              {
               account_state[2] = 1;
              }
        }

      if(scenes < OBSERVATIONS)
        {
         take_snapshots();
        }

      else
        {
         matrix temp;
         temp.Assign(snapshots);
         snapshots = matrix::Ones(FEATURES,scenes+1);

         //--- The first row is the intercept and must be full of ones
         for(int i=0;i<FEATURES;i++)
            snapshots.Row(temp.Row(i),i);

         take_snapshots();
         fit_snapshots();

         predict = true;
         permission = false;
        }
      scenes++;
     }
  }
O método utilizado para capturar o estado do sistema é bastante simples. Ele registra informações importantes do mercado em uma matriz que armazena os registros instantâneos do estado do sistema. Entre essas informações estão os preços de abertura, máxima, mínima e fechamento, além do equity da conta. Os leitores que acompanharam os artigos anteriores reconhecerão esse código, pois ele é idêntico ao utilizado no início da série.
//+------------------------------------------------------------------+
//| Record the current state of our system                           |
//+------------------------------------------------------------------+
void take_snapshots(void)
  {
   snapshots[1,scenes] = iOpen(Symbol(),PERIOD_D1,1);
   snapshots[2,scenes] = iHigh(Symbol(),PERIOD_D1,1);
   snapshots[3,scenes] = iLow(Symbol(),PERIOD_D1,1);
   snapshots[4,scenes] = iClose(Symbol(),PERIOD_D1,1);
   snapshots[5,scenes] = AccountInfoDouble(ACCOUNT_BALANCE);
   snapshots[6,scenes] = AccountInfoDouble(ACCOUNT_EQUITY);
   snapshots[7,scenes] = ma_h[0];
   snapshots[8,scenes] = ma_l[0];
   snapshots[9,scenes] = account_state[0];
   snapshots[10,scenes] = account_state[1];
   snapshots[11,scenes] = account_state[2];
  }
Entretanto, a partir deste ponto, começamos a identificar as melhorias introduzidas em relação à versão original. Até aqui, tudo deve parecer familiar aos leitores que já acompanharam o conteúdo anterior. Agora, estamos preparando os parâmetros de entrada e os dados de saída do sistema responsável por modelar a evolução dos registros instantâneos do estado do sistema. Vale lembrar que esses registros instantâneos acompanham informações importantes sobre a interação da nossa estratégia com o mercado, como a evolução do saldo e do equity da conta ao longo do tempo.
A matriz X armazena os parâmetros de entrada, enquanto a matriz Y contém os dados de saída. Ao examinar atentamente a matriz Y, o leitor perceberá que suas linhas 4, 5, 6 e 7 foram copiadas das linhas 5, 6, 7 e 8 da matriz X. Em seguida, essas mesmas linhas da matriz X são duplicadas novamente, mas deslocadas para períodos futuros. Isso significa que estamos solicitando ao modelo que preveja o saldo da conta não apenas um passo à frente, mas também dez passos à frente.
Com base na tendência prevista para esses dois horizontes, decidimos se devemos abrir uma operação. Assim que a solução ótima é encontrada pelo método da pseudoinversa, discutido anteriormente, nosso modelo gera duas previsões:
- Saldo esperado da conta para a próxima vela [4].
- Saldo esperado da conta no horizonte de dez velas [8].
Em seguida, o modelo toma decisões de negociação com base nessas previsões. Se houver expectativa de crescimento do saldo da conta, as operações são autorizadas. Se a previsão indicar uma queda, a autorização para operar não é concedida.
Essa abordagem representa uma melhoria significativa em relação ao método anterior. Nas discussões anteriores, comparávamos diretamente o saldo previsto pelo modelo com o saldo real atual da conta, como se ambos fossem equivalentes. Com a nova abordagem, evitamos esse erro.
//+------------------------------------------------------------------+
//| Fit our linear model to our collected snapshots                  |
//+------------------------------------------------------------------+
void fit_snapshots(void)
  {
   matrix X,y;
   X.Reshape(FEATURES,scenes);
   y.Reshape(TARGETS,scenes);

   for(int i=0;i<scenes-HORIZON;i++)
     {
      X[0,i] = snapshots[0,i];
      X[1,i] = snapshots[1,i];
      X[2,i] = snapshots[2,i];
      X[3,i] = snapshots[3,i];
      X[4,i] = snapshots[4,i];
      X[5,i] = snapshots[5,i];
      X[6,i] = snapshots[6,i];
      X[7,i] = snapshots[7,i];
      X[8,i] = snapshots[8,i];
      X[9,i] = snapshots[9,i];
      X[10,i] = snapshots[10,i];
      X[11,i] = snapshots[11,i];

      y[0,i] = snapshots[1,i+1];
      y[1,i] = snapshots[2,i+1];
      y[2,i] = snapshots[3,i+1];
      y[3,i] = snapshots[4,i+1];
      y[4,i] = snapshots[5,i+1];
      y[5,i] = snapshots[6,i+1];
      y[6,i] = snapshots[7,i+1];
      y[7,i] = snapshots[8,i+1];
      y[8,i] = snapshots[5,i+HORIZON];
      y[9,i] = snapshots[6,i+HORIZON];
      y[10,i] = snapshots[7,i+HORIZON];
      y[11,i] = snapshots[8,i+HORIZON];
      y[12,i] = snapshots[9,i+1];
      y[13,i] = snapshots[10,i+1];
      y[14,i] = snapshots[11,i+1];
     }

   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);

      permission = false;

      if(prediction[4] < prediction[8])
        {
         Print("Account size expected to grow, permission granted");
         permission = true;
        }

      else
         permission = false;

      if(permission)
        {
         if(PositionsTotal() == 0)
           {
            if(account_state[0] == 1)
               Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");

            else
               if(account_state[1] == 1)
                  Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
           }
        }
     }
  }
//+------------------------------------------------------------------+
Assim como na análise anterior, precisamos manter as mesmas datas de teste para garantir comparações justas e consistentes em todas as etapas.
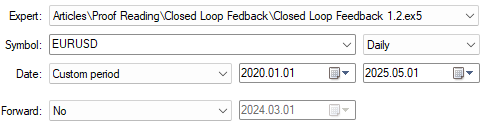
Figura 6: Backtest da versão aprimorada do nosso controlador com realimentação durante o mesmo período
Nossas estatísticas detalhadas mostram melhorias claras e mensuráveis em relação à versão original da estratégia de trading. De modo geral, essa versão aprimorada nos expõe a menos riscos do que a estratégia inicial. Outro resultado interessante é o aumento significativo da proporção de posições vendidas lucrativas, que se aproximou de 70%.
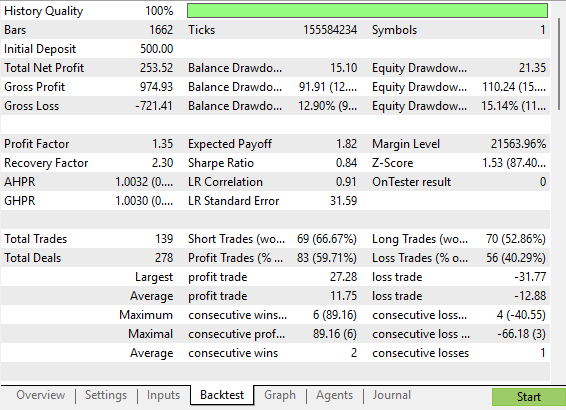
Figura 7: Análise detalhada das melhorias introduzidas no nosso sistema de trading
Nossa nova estratégia produziu uma curva de equity com menos períodos de drawdown em comparação com a versão original. Além disso, apresenta um crescimento consistente, com menor volatilidade e ritmo de valorização superior ao da versão inicial, que envolvia riscos mais elevados.
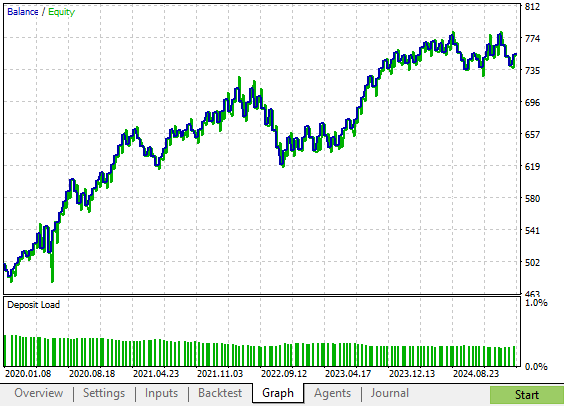
Figura 8: Curva de equity da versão aprimorada da estratégia de trading, mostrando um crescimento mais rápido em comparação com a estratégia original
Conclusão
Imagine que você segura uma bola de golfe com o braço estendido, posicionando-a contra o céu, e pede ao seu modelo de inteligência artificial que compare visualmente o tamanho da bola com o da Lua. Em alguns dias, o modelo poderia concluir que a Lua é ligeiramente maior do que a bola de golfe. Em outros, poderia determinar que a bola de golfe parece um pouco maior do que a Lua. Como seres humanos, sabemos que esse tipo de comparação apresenta uma falha fundamental e chega a ser, até certo ponto, engraçado. Mas a graça termina aí.
Em essência, nossos modelos de aprendizado de máquina podem cometer silenciosamente o mesmo erro ao operar nos mercados financeiros. No experimento descrito, o erro ocorre porque o modelo não reconhece que está comparando a bola de golfe com uma imagem da Lua projetada no céu, e não diretamente com a Lua real.
Nos mercados financeiros, nossos modelos de aprendizado de máquina também não preveem diretamente o preço futuro "real". Em vez disso, criam representações do objeto-alvo, sobrepondo-as aos atributos de entrada. Portanto, não devemos comparar diretamente as previsões geradas pelo modelo com os preços reais como se fossem grandezas equivalentes. Precisamos reconhecer que nossos modelos tentam construir uma representação do objeto-alvo utilizando um sistema de coordenadas derivado dos parâmetros de entrada. Entre essa representação e a realidade, porém, sempre existe algum desvio irredutível. Como diversos fatores podem distorcer essa representação, devemos evitar fazer previsões diretas.
Com essa compreensão, o leitor ganhará confiança ao compreender por que deve utilizar diferentes horizontes de previsão para reduzir o impacto do erro decorrente da diferença entre a representação produzida pelo modelo e a realidade, uma fonte de erro que normalmente passa despercebida.
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19371
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.