

取引におけるニューラルネットワーク:データ固有の依存性なしに時系列を一般化する(結論)
 16
 1

はじめに
金融市場は、生き物のようなものです。 そのリズムは、何百万もの取引、数百に及ぶ経済指標の発表、そして絶え間なく流れ込むニュースによって形作られます。 このような環境で利益を上げるのは、迅速に対応できるだけでなく、トレンドがいつ転換するかを先読みできる人々です。 こうした背景から開発されたのが、Mamba4Castです。これは、ニューラルネットワークのアーキテクチャに関する最新の研究成果に着想を得て、高頻度時系列の特性に合わせて設計された時系列予測フレームワークです。
このフレームワークの解説も、いよいよ最終段階に入りました。 まず、理論的な枠組みと特徴量処理の基本的なアプローチを検討しました。 続く第2部では、その仕組みをさらに詳しく掘り下げました。 今回は、これまでの内容を総合し、このモデルが理論上の構想にとどまらず、実際の市場環境でも機能することを示します。
このフレームワークは、それぞれが特定の役割を担う複数のモジュールを連結した構造になっています。 最初のブロックは、特徴量抽出を担当します。 ここでは、始値、終値、高値、安値、出来高といった生データをモデルが処理します。 これらのデータは、局所的なパターンを識別するコンパクトな層を通過します。 いわば、チャートの複雑な値動きの中からパターンを見抜く、熟練したトレーダーの目のようなものです。
続いて、畳み込み層が処理を引き継ぎます。 これらのブロックは市場をフィルタリングする役割を果たし、安定したシグナルを抽出するとともに、ノイズを取り除きます。 ボラティリティの急上昇、トレンドの勢いの衰え、新たな保ち合い局面の形成などをすべて検出し、処理します。 ここではマルチウィンドウ構造を採用しており、それぞれの畳み込み処理が異なる時間軸を対象とします。 これにより、短期的な価格変動と、より長期にわたる周期的な値動きの両方を同時に捉えられるよう、モデルを学習させます。
中核となるモジュールが、SSM(状態空間モデル)です。このモジュールは、長期記憶を保持する能力をモデルに与えます。 これは金融データにおいて特に重要です。パターンはすぐに現れるとは限らず、数十本のローソク足にわたって初めて明らかになることもあるためです。 たとえば、何度もブレイクアウトに失敗した後、最終的に強い値動きが発生するケースがあります。モデルは、こうした展開にも対応できなければなりません。 まさにSSMによって、モデルは過去の情報を踏まえた文脈を保持し、市場が不確実な状況でも、根拠のある予測をおこなえるようになります。
Mamba4Castの特に優れた点は、予測対象となる期間全体を見据えて予測を行う仕組みにあります。 これは、トレーダーが実際の市場で直面する課題にも合致しています。 このアプローチは、車を運転する場面に例えられます。運転手は目の前の道路に注意を払いながら、同時に遠く先の状況を見渡し、周囲の交通の流れも読み取ります。 同じように、短期的な変化と先々の展開を組み合わせて捉えることで、より安定的で包括的な行動方策を導き出します。
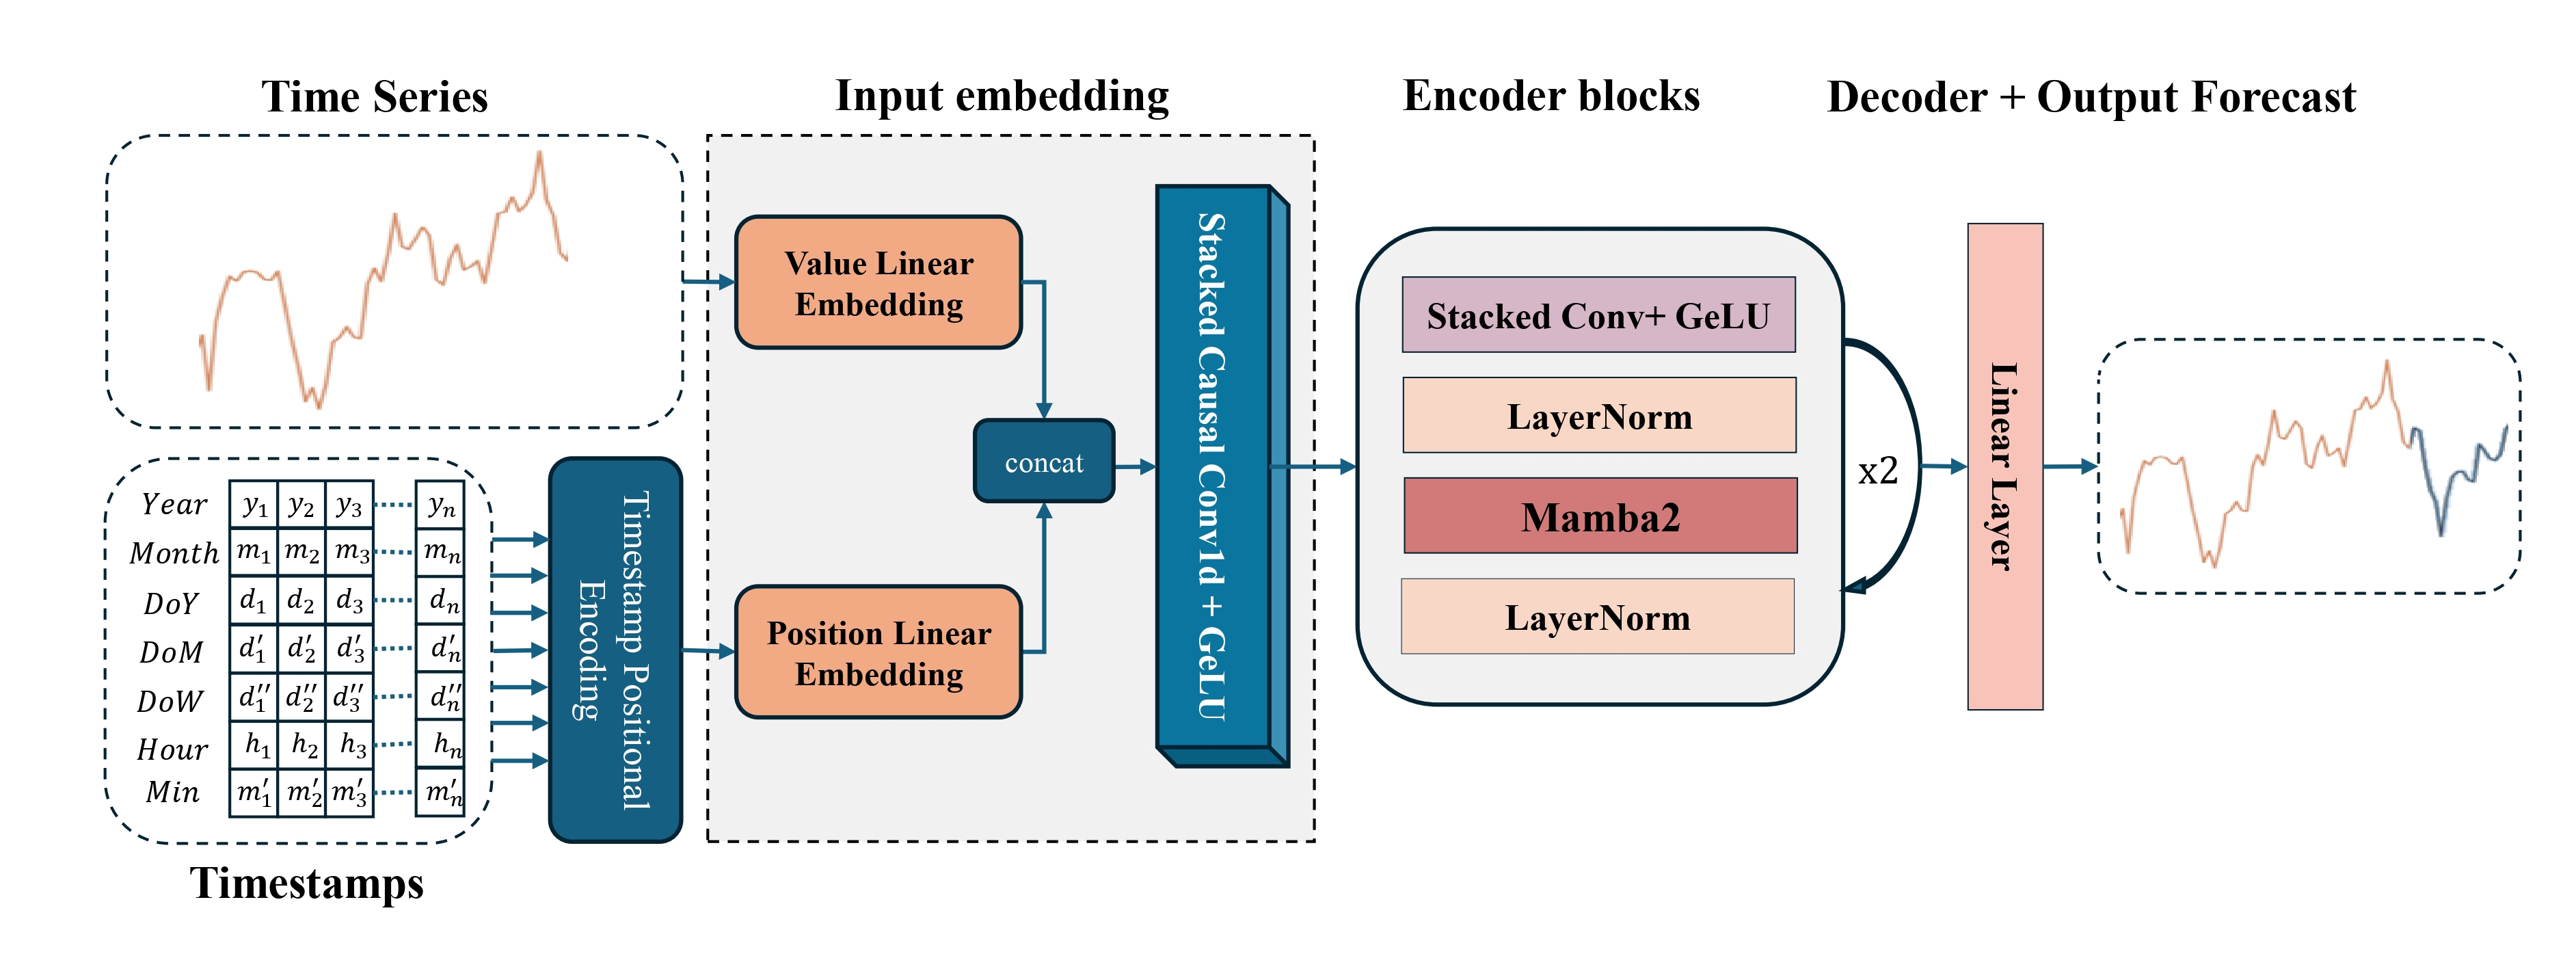
この記事では、モデルの完成形となるアーキテクチャ、学習プロセス、そして実際の市場環境で得られた結果を紹介します。 理論と実践がどのように結びつくのか、また、抽象的なモデルが市場分析に役立つ実用的なツールへとどのように発展するのかを見ていきましょう。
モデルアーキテクチャ
今回は、学習可能なモデルのアーキテクチャを構築するところから始めます。目指すのは、リアルタイムで意思決定をおこない、実際に取引を実行できる、実運用可能な取引エージェントです。 現在の市場状況を注意深く分析し、価格の動きや出来高、市場センチメントを評価したうえで、ポジションを取るかどうかを判断するトレーダーと同じように、私たちのエージェントも、市場を自ら捉えて理解できなければなりません。シグナルに盲目的に従うだけでは不十分です。 そのため、私たちの目標は、次の価格を1つ予測することにとどまりません。市場の値動きに潜むパターンを認識し、急速に変化する状況に対応し、市場サイクルのさまざまな局面に適応できるモデルを構築することです。
この枠組みにおいて、Mamba4Castフレームワークは、システム全体を構成する主要な要素の1つである環境状態エンコーダ(Environment State Encoder)として実装されます。 ここからモデルの市場認識が形を取り始め、一連の数値が、市場で何が起きているのかを示す意味のある全体像へと変換されます。エンコーダは、エージェントにとってのいわば取引の目となります。チャート上で明確に確認できるようになる前から、重要な値動きや隠れたパターン、エントリーの候補となるポイントを認識できるように学習します。
この記事でも引き続き、Actor-Director-Critic学習フレームワークに沿って解説します。 学習対象となるシステムは、次の4つの主要なモデルで構成され、それぞれが取引の意思決定における特定の役割を担います。
- 環境状態エンコーダ:エージェントの目に相当し、市場状態を表す埋め込み表現を生成します。
- Actor(アクター):受け取った埋め込み表現に基づいて、具体的な取引行動を提案するモデルです。
- Director(ディレクター):Actorが提案した行動を良いものか悪いものかに分類し、学習プロセスを導くとともに、誤った判断を防ぐモデルです。
- Critic(クリティック):市場状態を踏まえてActorのアクションの価値を評価し、戦略の最適化に向けたフィードバック信号を生成するモデルです。
すべてのモデルのアーキテクチャは、CreateDescriptionsメソッドを使って定義します。このメソッドは、動的配列へのポインタを4つ引数として受け取ります。 これらの配列には、エンコーダからCriticまで、上記の各モデルについて、層の構成を表す記述とパラメータが順番に格納されます。これにより、モデルの構造を柔軟に制御できるとともに、新たな要件に合わせてフレームワークを容易に拡張・調整できます。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
CreateDescriptionsメソッドの本体では、まず、受け取った4つの動的配列へのポインタが有効かどうかを確認します。 必要に応じて新しいオブジェクトを作成し、メモリの競合を避けながら、後続の処理でアーキテクチャの記述を正しく格納できるようにします。
次に、環境状態エンコーダのアーキテクチャを定義します。 入力データを受け取るために、十分な規模の全結合層を使用します。 この層には、取引端末から取得した生データを、前処理を行わずに直接入力します。データには、始値と終値、高値と安値、出来高、テクニカル指標の値などが含まれます。
これらのデータは統計的な特性や値のスケールが異なるため、モデルの学習を安定させるには、それぞれの分布を整える必要があります。 そこで使用するのが、バッチ正規化層です。 この層は入力ベクトルを変換し、各特徴量の平均がゼロに近く、分散が1に近くなるように調整します。これにより、学習の収束が速まり、学習プロセスの安定性が向上します。 ここでは、標準的な実装ではなく、ノイズを付加した正規化層という改良版を採用します。 学習データに人工的な多様性を持たせることで、モデルの汎化性能の向上を図ります。
この一連の層を通過すると、エンコーダには、後続の処理に利用できるよう標準化された特徴量が渡されます。//--- Encoder encoder.Clear(); //--- Input layer if(!(descr = new CLayerDescription())) return false; descr.type = defNeuronBaseOCL; int prev_count = descr.count = (HistoryBars * BarDescr); descr.activation = None; descr.optimization = ADAM; if(!encoder.Add(descr)) { delete descr; return false; } //--- Layer 1 if(!(descr = new CLayerDescription())) return false; descr.type = defNeuronBatchNormWithNoise; descr.count = prev_count; descr.batch = 1e4; descr.activation = None; descr.optimization = ADAM; if(!encoder.Add(descr)) { delete descr; return false; }
次に、CMamba4CastEmbeddingモジュールを使用して、時間ステップの埋め込み表現を生成します。 この段階では、特徴量ベクトルに、2つの主要な時間足であるH1(1時間足)とD1(日足)に対応する周期成分を付加します。 正弦関数と余弦関数の成分を加えることで、モデルは、時間帯ごとに見られる典型的な価格変動や、日々繰り返される値動きのリズムに関する情報を取得します。 これにより、エージェントは、市場に特有の周期的な動き、たとえば朝方の取引が活発化し始める局面、日中のトレンド、夕方に値動きが落ち着く局面などを考慮できるようになります。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = BarDescr;
   int prev_out = descr.window_out = NSkills;
     {
      int temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
3つの畳み込みウィンドウを備えたマルチウィンドウ畳み込みブロックを使用することで、埋め込み表現をより豊かなものにします。 重要なのは、畳み込み処理が時間軸に沿っておこなわれるのではなく、1本のローソク足の内部で横方向に行われる点です。これにより、同一のローソク足に含まれる特徴量同士の関係性を分析します。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.window_out * descr.windows.Size());
入力信号のエンコード処理の最後に、正規化層を追加します。 この層の目的は、特徴量の分布の偏りを抑え、分析対象のデータをより均質な状態に整え、学習中のモデルの動作を安定させることです。 この処理により、勾配の偏りを防ぎ、モデルの性能を損なうことなく、学習の収束を速めることができます。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、エンコーダのアーキテクチャの構築に進みます。 ここでは、個々の特徴量を対象とした単変量時系列を扱う予定です。 そのため、まず特徴量テンソルの転置をおこないます。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   prev_out = descr.count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
ただし、ここで扱う特徴量は、先ほど取引端末から取得した特徴量と同じものではない点に注意が必要です。 この段階では、すでに特徴量が拡張され、まったく異なる特徴量群が形成されています。それぞれの特徴量は、取引端末から取得したローソク足の記述を構成する特定の要素に対応しています。
Mamba4Castのエンコーダブロックは、畳み込み層を積み重ねた構造と、(SSM)SSMモジュールで構成されます。 各モジュールの間には、特徴量のスケールをそろえるための正規化層を配置します。 畳み込み層のスタックには、マルチウィンドウ畳み込みモジュールを使用します。 各フィルターはそれぞれ異なる時間ウィンドウに着目し、対応する市場パターンを検出します。 データの次元を維持するため、各マルチウィンドウ畳み込みモジュールの後には、最大値プーリング層を適用します。この層は各ウィンドウ内でフィルター出力の最大値を選択することで、データ表現の整合性を保ちながら、各ウィンドウで代表的な値を抽出します。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   int filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 10
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
SSMには、Mamba4Castフレームワークの開発者が採用したオリジナルのMamba2をそのまま使用するのではなく、Chimeraモジュールを採用しました。Chimeraは、2次元平面上でデータを分析し、時間方向と空間方向の要素間に存在する相互依存関係を考慮できるためです。
//--- layer 11
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronChimera;
//--- Window
     {
      int temp[] = {prev_out, prev_out/2}; //In, Out
      if(ArrayCopy(descr.windows, temp) < int(temp.Size()))
         return false;
     }
//--- Units
     {
      int temp[] = {prev_count, prev_count*2}; //In, Out
      if(ArrayCopy(descr.units, temp) < int(temp.Size()))
         return false;
     }
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.windows[1];
   prev_count=descr.units[1];
//--- layer 12
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
このモジュールの最後には、バッチ正規化層を配置します。 この手法の利点については、すでに前述したとおりです。
エンコーダのアーキテクチャは、2つのブロックを順番に接続した構造になっています。各ブロックは、マルチウィンドウ畳み込み層のスタック、最大値プーリング層、およびChimeraをベースとするSSMモジュールで構成されます。これにより、特徴量を段階的に拡張しながら、文脈情報を保持します。
//--- layer 13
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 14
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 15
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 16
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 17
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 18
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronChimera;
//--- Window
     {
      int temp[] = {prev_out, prev_out/2}; //In, Out
      if(ArrayCopy(descr.windows, temp) < int(temp.Size()))
         return false;
     }
//--- Units
     {
      int temp[] = {prev_count, prev_count*2}; //In, Out
      if(ArrayCopy(descr.units, temp) < int(temp.Size()))
         return false;
     }
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.windows[1];
   prev_count=descr.units[1];
//--- layer 19
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
予測対象期間全体にわたって、各単変量時系列を個別に予測するデコーダとして、2つの畳み込み層を連続して配置します。その間には、必要な非線形性を導入するためにSoftPlusを挿入します。 デコーダの出力には双曲正接(tanh)を適用します。この関数の出力範囲が正規化されたデータのスケールに対応しているため、モデルの入力と出力の整合性を保つのに役立ちます。
//--- layer 20
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = 4 * NForecast;
   descr.layers = prev_count;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 21
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = NForecast;
   descr.layers = prev_count;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
ただし、ここで注意すべき点があります。単変量時系列を扱えるようにするため、先ほど分析対象の特徴量テンソルを転置しました。 そのため、デコーダの出力を後続の処理に渡す前に、逆転置をおこない、テンソルを元の形状に戻す必要があります。
//--- layer 22
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   prev_out = descr.count;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
データ構造を復元する次のステップでは、埋め込み表現の生成時に増加した次元数を削減します。 これは、結果を格納したテンソルを、元のデータと互換性のある形状に変換するために必要な処理です。
//--- layer 23
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.layers = 1;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
エンコーダの処理の最終段階は、逆正規化です。 この段階では、すべての変換処理を経て得られた値を元のデータのスケールに戻し、モデルの出力を正しく解釈できるようにします。
//--- layer 24
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、Actorのアーキテクチャの説明に移ります。 Actorの主な役割は、分析対象となる市場環境の状態を踏まえて、現在の口座状態と保有中のポジションを評価することです。 受け取った情報に基づき、Actorは取引判断を下します。すなわち、リスクを最小限に抑えながら、最大のリターンを得られる可能性のある取引を決定します。
このため、Actorには、現在の口座状態を表すテンソルが入力されます。 このテンソルには、残高、保有中のポジションの数量、売買方向、その他、取引エージェントの財務状況を示す重要なパラメータに関する情報が集約されています。
   CLayerDescription *latent = encoder.At(LatentLayer-1);
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
これらの入力データは、まずバッチ正規化層で処理されます。これにより、特徴量の分布が安定し、モデルの学習を効率化できます。
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
次に、クロスアテンション層を適用し、現在の口座状態と市場の状況を関連付けます。 この処理では、先にエンコーダによって生成された環境の潜在表現をコンテキストとして利用します。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      int temp[] = {AccountDescr,     // Inputs window
                    latent.windows[1] // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      int temp[] = {1,              // Inputs units
                    latent.units[1] // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
今回の実験では、2つのクロスアテンションモジュールを直列に接続した構成を採用しました。 この構成により、口座の内部状態と市場の動向との対応関係をより深く捉え、現在のポジションと外部環境との因果関係を特定するモデルの能力を高めます。
ここで重要なのは、クロスアテンション層のコンテキストとして、現在の環境状態を一般的に表現したものではなく、入力信号を個々の単変量特徴量時系列の埋め込み表現として処理した後に得られる、エンコーダの潜在表現を使用するという点です。 簡単に言えば、環境状態エンコーダを構成するブロックの1つであるエンコーダは、各特徴量をそれぞれ固有のコンパクトなベクトル表現に変換します。これらのベクトルが、コンテキストとしてクロスアテンションモジュールに入力されます。
クロスアテンションモジュールを指揮者に例えてみましょう。 指揮者の手元には、各楽器の旋律(特徴量の埋め込み表現)と、現在の口座残高を記した楽譜があります。 指揮者は、その瞬間にどの楽器を強調すべきか、つまり取引判断においてどの特徴量が最も重要なのかを判断し、それらに重点を置きます。
このように、クロスアテンション機構は、市場に潜むパターンと現在のポジションを照らし合わせ、効果的な取引判断に役立つシグナルを選び出します。
文脈分析の結果は、3つの全結合層(MLP)を通過します。各層は、取引アクションの表現を段階的に精緻化します。 最終層の出力として、取引判断が生成されます。これは、現在の口座状態と市場環境を考慮し、ポジションを新規に建てる、保有し続ける、または決済するための具体的な提案です。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = 1e4;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
DirectorとCriticは、よく似たアーキテクチャを採用しています。どちらも、現在の市場状況を踏まえて、Actorが提案した行動のテンソルを分析します。 そして、戦略とリスクの観点から、その行動を承認するか、却下するかを評価します。
これらのコンポーネントのアーキテクチャの詳細な実装については、ぜひご自身で調べてみてください。 DirectorやCriticを含む、学習対象となるすべてのモデルのアーキテクチャを記述した完全なソースコードは、添付ファイルに含まれています。
モデルの学習
モデルのアーキテクチャを確認したところで、いよいよ学習段階に進みましょう。 ここで重要なのは、Mamba4Castフレームワークの開発者が、モデルの検証と学習に合成時系列データを使用したという点です。 このアプローチには、特に深層学習アーキテクチャの開発やデバッグにおいて、いくつもの利点があります。
まず、合成データを使えば、データのパラメータを完全に制御できます。振幅、周波数、トレンド、季節性、ノイズレベルをあらかじめ指定できるほか、まれな事象や異常事象を組み込むことも可能です。 これにより、時系列のさまざまな特性に対するモデルの反応を狙いどおりに検証し、厳密に管理された環境でモデルの弱点を特定できます。
第二に、人工的に生成された時系列データを使えば、品質に問題のあるデータや不完全なデータの影響を排除できます。これは、学習の初期段階では特に重要です。 実際の市場データとは異なり、合成データには、モデル本来の誤りを覆い隠す原因となる欠損やデータ収集時のアーティファクト、歪みが含まれません。
第三の利点は、スケーラビリティです。 合成データを生成すれば、過去データの収集・保存にかかるコストを抑えられ、どのような複雑さの問題に対しても、必要な規模の学習用データセットを迅速に作成できます。 これは、豊富でバランスの取れた学習環境を必要とする、計算資源を大量に消費するモデルを扱う場合に特に重要です。
最後に、合成データはストレステストにも有効です。 現実の市場で極端な状況が発生するのを待つことなく、そうした状況をシミュレーションできます。 このようなシナリオを用いることで、予期せぬ変動に対するモデルの頑健性を検証できます。
一方、実際の市場は無菌の実験室ではありません。むしろ、その場その場でルールが変わることもある、荒れ狂う海のようなものです。 だからこそ、合成データには多くの利点があるものの、合成データだけでモデルの学習と検証を行うのは、一面的であり、潜在的な危険を伴うアプローチなのです。
第一に、実際の市場データには、ノイズや欠損、一見しただけでは分からない相関関係、データ品質に問題のある領域などが必ず含まれています。こうした要素は、人工的に生成された環境には存在しません。 そのため、これらの特徴量を含むデータで学習していないモデルは、実際の市場に初めて直面したときに、うまく機能しない可能性があります。特に、流動性の低い資産やボラティリティが高い時期には、そのリスクが高まります。
第二に、市場には予想外の事態がつきものです。ニュース、制裁、企業合併、地政学的な動向、大口市場参加者の行動など、さまざまな要因が価格に影響を与えます。しかし、こうした要因を合成データで確実にモデル化することは、事実上不可能です。 そのため、モデルが不完全な情報のもとでも適応し、機能できることが特に重要になります。
第三に、恐怖から貪欲まで、市場参加者の行動パターンは、データ生成器では再現しにくい独特の市場ダイナミクスを生み出します。 こうしたパターンに触れずに学習したモデルは、クリーンな環境に過剰適合し、実際の取引で重要なシグナルを認識できなくなるおそれがあります。
こうした理由から、最も効果的と考えられるのがハイブリッドアプローチです。初期段階では、アーキテクチャの調整、ハイパーパラメータの選定、学習プロセスのデバッグに合成データを使用します。 その後、実際の市場データを導入し、モデルが実運用環境で機能できるように学習させます。不安定な環境で失敗を経験し、状況に適応し、意思決定をおこなえるようにするのです。
現時点では、金融時系列を合成するための本格的な生成器は手元にありません。 しかし、ことわざにもあるように、「山がムハンマドのもとに来ないのであれば……」。
そこで、学習の第1段階では、実際の過去データに前処理を施し、合成データの特性を近似することを試みます。 前述のとおり、合成時系列には通常、アーティファクトや欠損、その他の市場ノイズが含まれていません。 実データでも同程度にクリーンな状態を実現するため、分析対象の各特徴量に、短いウィンドウ幅の単純移動平均を適用します。 これにより、次の効果が期待できます。
- 局所的な異常や急激なスパイクを平滑化する
- 単発の外れ値による影響を軽減する
- 学習段階におけるモデルの頑健性を高める
ここで重要なのは、信号の変動や形状を保つため、意図的に短い平均化ウィンドウを選んでいる点です。 すべての変動を消して平坦な線にすることが目的ではありません。モデルを誤った方向に導きかねないノイズを抑えることが狙いです。 このロジックを、エキスパートアドバイザー「…\MQL5\Experts\Mamba4Cast\StudyMA.mq5」に実装します。 この記事では、モデルの学習プロセスを実装する「Train」メソッドだけに焦点を当てます。
アルゴリズムはまず、経験再生バッファから個々の軌跡を選択するための確率分布ベクトルを作成します。
void Train(void)
  {
//---
   vector<float> probability = vector<float>::Full(Buffer.Size(), 1.0f / Buffer.Size());
初期段階では、すべての軌跡に同じ確率を割り当てます。これにより、履歴全体をより幅広く探索できるようになります。
次に、モデルの学習中にデータを一時的に保存するためのローカル変数を初期化します。
   vector<float> result, target, state;
   matrix<float> fstate = matrix<float>::Zeros(1, NForecast * BarDescr);
   matrix<float> hstate = matrix<float>::Zeros(1, HistoryBars * BarDescr);
   bool Stop = false;
   int average = 5;
//---
   uint ticks = GetTickCount();
準備作業が完了したら、モデルの学習ループの構造を設定します。 外側のループでは、学習の総反復回数を制御します。
for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter += Batch)
  {
   int tr = SampleTrajectory(probability);
   int start = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * (Buffer[tr].Total - 2 - NForecast - Batch));
   if(start <= 0)
     {
      iter -= Batch;
      continue;
     }
   if(
      !cEncoder.Clear()
      || !cActor.Clear()
      || !cDirector.Clear()
      || !cCritic.Clear()
   )
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   result = vector<float>::Zeros(NActions);
ここでは、経験再生バッファから1つの軌跡をサンプリングし、学習バッチの開始状態を設定します。 続いて、無関係な過去の記憶が新しい軌跡のデータに影響しないよう、すべてのモデルの内部状態をリセットします。 次に、学習バッチ内でモデルを学習させるための内側のループを初期化します。
for(int i = start; i < MathMin(Buffer[tr].Total, start + Batch); i++)
  {
   if(!hstate.Assign(Buffer[tr].States[i].state) ||
      MathAbs(hstate).Sum() == 0 ||
      !hstate.Reshape(HistoryBars, BarDescr))
     {
      iter -= Batch + start - i;
      break;
     }
内側のループでは、まず、分析対象となる環境状態を記述した過去のデータを経験再生バッファから読み込みます。次に、移動平均によってデータを平滑化するためのループを設定します。
for(int h = HistoryBars - 1; h > 0; h--)
  {
   state = vector<float>::Zeros(BarDescr);
   for(int a = MathMax(h - average + 1, 0); a <= h; a++)
      state += hstate.Row(a);
   if(!hstate.Row(state / MathMin(average, h + 1), h))
     {
      iter -= Batch + start - i;
      break;
     }
  }
平滑化した値を、分析対象の環境状態を記述するデータバッファに格納します。
if(!hstate.Reshape(1, HistoryBars * BarDescr) ||
   !bState.AssignArray(hstate.Row(0)))
  {
   iter -= Batch + start - i;
   break;
  }
次に、Mamba4Castフレームワークを正しく動作させるには、各バーのタイムスタンプが必要であることを覚えておいてください。 しかし、先ほど作成した経験再生バッファの構造では、各環境状態について、最後のバーに対応するタイムスタンプしか保持していません。 必要なタイムスタンプバッファを作成するため、経験再生バッファ内の環境状態を現在の状態からさかのぼり、指定された分析深度に達するまでタイムスタンプを収集します。
bTime.Clear();
bTime.Reserve(HistoryBars);
double time = (double)Buffer[tr].States[i].account[7];
for(int t = i; t >= MathMax(0, i - HistoryBars + 1); t--)
   if(!bTime.Add((float)(double)Buffer[tr].States[t].account[7]))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
if(bTime.Total() < HistoryBars)
  {
   float period = MathMin(Buffer[tr].States[i + 1].account[7] - Buffer[tr].States[i].account[7],
                          Buffer[tr].States[i + 2].account[7] - Buffer[tr].States[i + 1].account[7]);
   do
     {
      if(!bTime.Add(bTime[-1] - period))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         Stop = true;
         break;
        }
     }
   while(bTime.Total() < HistoryBars);
  }
if(bTime.GetIndex() >= 0)
   if(!bTime.BufferWrite())
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
口座状態を記述するバッファへのデータ格納アルゴリズムについては、類似のプログラムで使用しているものを変更せずに移植します。
//--- Account
float PrevBalance = Buffer[tr].States[MathMax(i - 1, 0)].account[0];
float PrevEquity = Buffer[tr].States[MathMax(i - 1, 0)].account[1];
float profit = float(bState[0] / _Point * (result[0] - result[3]));
bAccount.Clear();
bAccount.Add(1);
bAccount.Add((PrevEquity + profit) / PrevEquity);
bAccount.Add(profit / PrevEquity);
bAccount.Add(MathMax(result[0] - result[3], 0));
bAccount.Add(MathMax(result[3] - result[0], 0));
bAccount.Add((bAccount[3] > 0 ? profit / PrevEquity : 0));
bAccount.Add((bAccount[4] > 0 ? profit / PrevEquity : 0));
bAccount.Add(0);
double x = time / (double)(D'2024.01.01' - D'2023.01.01');
bAccount.Add((float)MathSin(x != 0 ? 2.0 * M_PI * x : 0));
x = time / (double)PeriodSeconds(PERIOD_MN1);
bAccount.Add((float)MathCos(x != 0 ? 2.0 * M_PI * x : 0));
x = time / (double)PeriodSeconds(PERIOD_W1);
bAccount.Add((float)MathSin(x != 0 ? 2.0 * M_PI * x : 0));
x = time / (double)PeriodSeconds(PERIOD_D1);
bAccount.Add((float)MathSin(x != 0 ? 2.0 * M_PI * x : 0));
if(bAccount.GetIndex() >= 0)
   if(!bAccount.BufferWrite())
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
必要な入力データの準備が整ったら、すべてのモデルの順伝播を実行します。 最初に順伝播をおこなうのは、環境状態エンコーダです。 このモデルには、平滑化した市場状態の記述データとタイムスタンプバッファを入力します。
//--- Feed Forward
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
次に、Actorが処理をおこないます。 Actorは、口座状態バッファと、エンコーダの潜在状態から得られる環境コンテキストを分析します。
if(!cActor.feedForward((CBufferFloat*)GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
環境状態エンコーダは、将来の状態を予測するように学習させます。 ここで特に重要なのは、教師データを手作業で生成したり、入力データの準備段階で行ったように移動平均で平滑化したりしない、という点です。 その代わりに、経験再生バッファにすでに格納されている、準備済みの環境状態データを読み込みます。その際、指定された予測対象期間の分だけ先のデータを使用します。
//--- Look for target
target = vector<float>::Zeros(NActions);
bActions.AssignArray(target);
if(!state.Assign(Buffer[tr].States[i + NForecast].state) ||
   !state.Resize(NForecast * BarDescr) ||
   MathAbs(state).Sum() == 0)
  {
   iter -= Batch + start - i;
   break;
  }
if(!fstate.Resize(1, NForecast * BarDescr) ||
   !fstate.Row(state, 0) ||
   !fstate.Reshape(NForecast, BarDescr))
  {
   iter -= Batch + start - i;
   break;
  }
for(int j = 0; j < NForecast / 2; j++)
  {
   if(!fstate.SwapRows(j, NForecast - j - 1))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
  }
教師データを構成したら、逆伝播メソッドを呼び出して、エンコーダのパラメータを調整します。
//--- State Encoder
Result.AssignArray(fstate);
if(!cEncoder.backProp(Result, (CBufferFloat*)NULL, NULL))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
次に、将来の価格変動に関する実際のデータを利用して、「ほぼ完璧な」取引判断を導き出します。
target = fstate.Col(0).CumSum();
if(result[0] > result[3])
  {
   float tp = 0;
   float sl = 0;
   float cur_sl = float(-(result[2] > 0 ? result[2] : 1) * MaxSL * Point());
   int pos = 0;
   for(int j = 0; j < NForecast; j++)
     {
      tp = MathMax(tp, target[j] + fstate[j, 1] - fstate[j, 0]);
      pos = j;
      if(cur_sl >= target[j] + fstate[j, 2] - fstate[j, 0])
         break;
      sl = MathMin(sl, target[j] + fstate[j, 2] - fstate[j, 0]);
     }
   if(pos > 0 && tp > 0)
     {
      sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
      tp = float(MathMin(tp / (MaxTP * Point()), 1));
      result[0] = MathMax(result[0] - result[3], 0.011f);
      result[5] = result[1] = tp;
      result[4] = result[2] = sl;
      result[3] = 0;
      bActions.AssignArray(result);
     }
  }
else
  {
   if(result[0] < result[3])
     {
      float tp = 0;
      float sl = 0;
      float cur_sl = float((result[5] > 0 ? result[5] : 1) * MaxSL * Point());
      int pos = 0;
      for(int j = 0; j < NForecast; j++)
        {
         tp = MathMin(tp, target[j] + fstate[j, 2] - fstate[j, 0]);
         pos = j;
         if(cur_sl <= target[j] + fstate[j, 1] - fstate[j, 0])
            break;
         sl = MathMax(sl, target[j] + fstate[j, 1] - fstate[j, 0]);
        }
      if(pos > 0 && tp < 0)
        {
         sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
         tp = float(MathMin(-tp / (MaxTP * Point()), 1));
         result[3] = MathMax(result[3] - result[0], 0.011f);
         result[2] = result[4] = tp;
         result[1] = result[5] = sl;
         result[0] = 0;
         bActions.AssignArray(result);
        }
     }
   else
     {
      ulong argmin = target.ArgMin();
      ulong argmax = target.ArgMax();
      float max_sl = float(MaxSL * Point());
      while(argmax > 0 && argmin > 0)
        {
         if(argmax < argmin && target[argmax] / 2 > MathAbs(target[argmin]) &&
                               MathAbs(target[argmin]) < max_sl)
            break;
         if(argmax > argmin && target[argmax] < MathAbs(target[argmin] / 2) && target[argmax] < max_sl)
            break;
         target.Resize(MathMin(argmax, argmin));
         argmin = target.ArgMin();
         argmax = target.ArgMax();
        }
      if(argmin == 0 || (argmax < argmin && argmax > 0))
        {
         float tp = 0;
         float sl = 0;
         float cur_sl = - float(MaxSL * Point());
         ulong pos = 0;
         for(ulong j = 0; j < argmax; j++)
           {
            tp = MathMax(tp, target[j] + fstate[j, 1] - fstate[j, 0]);
            pos = j;
            if(cur_sl >= target[j] + fstate[j, 2] - fstate[j, 0])
               break;
            sl = MathMin(sl, target[j] + fstate[j, 2] - fstate[j, 0]);
           }
         if(pos > 0 && tp > 0)
           {
            sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
            tp = (float)MathMin(tp / (MaxTP * Point()), 1);
            result[0] = float(MathMax(Buffer[tr].States[i].account[0] / 100 * 0.01, 0.011));
            result[5] = result[1] = tp;
            result[4] = result[2] = sl;
            result[3] = 0;
            bActions.AssignArray(result);
           }
        }
      else
        {
         if(argmax == 0 || argmax > argmin)
           {
            float tp = 0;
            float sl = 0;
            float cur_sl = float(MaxSL * Point());
            ulong pos = 0;
            for(ulong j = 0; j < argmin; j++)
              {
               tp = MathMin(tp, target[j] + fstate[j, 2] - fstate[j, 0]);
               pos = j;
               if(cur_sl <= target[j] + fstate[j, 1] - fstate[j, 0])
                  break;
               sl = MathMax(sl, target[j] + fstate[j, 1] - fstate[j, 0]);
              }
            if(pos > 0 && tp < 0)
              {
               sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
               tp = (float)MathMin(-tp / (MaxTP * Point()), 1);
               result[3] = float(MathMax(Buffer[tr].States[i].account[0] / 100 * 0.01, 0.011));
               result[2] = result[4] = tp;
               result[1] = result[5] = sl;
               result[0] = 0;
               bActions.AssignArray(result);
              }
           }
        }
     }
  }
ここで注意したいのは、この取引判断が、直前のステップで実行された取引に基づいているという点です。エージェントは、互いに独立したシグナルを個別に処理するのではなく、一連の行動を組み立てていきます。 そして、その後の判断はすべて、すでに実行された取引を踏まえておこなわれます。 このアプローチにより、個々の注文がばらばらに集まったものではなく、それぞれの判断が前の判断から論理的につながる、本格的な戦略を構築できます。 こうして得られたほぼ完璧な取引を、Actorの学習に使用します。
//--- Actor Policy
bActions.GetData(result);
if(!cActor.backProp(GetPointer(bActions), (CNet*)GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
同じ取引を使って、Criticを学習させます。 その目標は、Actorが実際に採用している方策を忠実に反映する、行動評価関数を構築することです。 Criticにも、先ほどと同じほぼ完璧な一連の取引を入力し、次のバーにおける価格変動に基づいて報酬を決定します。
//--- Critic
if(!cCritic.feedForward(GetPointer(bActions), 1, false, (CNet*)GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
float reward = float((bActions[0] - bActions[3]) * fstate[0, 0] / Point());
Result.Clear();
if(!Result.Add(reward)
   || !cCritic.backProp(Result, (CNet*)GetPointer(cEncoder), LatentLayer)
   || !cEncoder.backPropGradient((CBufferFloat*)NULL, (CBufferFloat*)NULL, LatentLayer, true)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
このようにして、Criticは実際の価格変動に基づいてActorの行動を正確に評価する方法を学習し、より精密で頑健な戦略の構築を支援します。
一方、Directorの学習方法は少し異なります。 肯定的な例だけを与えても、良い行動と悪い行動を区別できるようにはなりません。 そのため、各ステップで、どのような学習サンプルを使用するかをランダムに選択します。
- 肯定的: 実際のデータから先ほど算出したほぼ完璧な行動を入力し、ラベル「1」(成功)を割り当てます。
- 否定的: 行動空間と同じ次元数を持つランダムな値のベクトルを生成し、ラベル「0」(失敗)を割り当てます。
その後、Directorの順伝播メソッドと逆伝播メソッドを呼び出します。
//--- Director
Result.Clear();
if((MathRand() / 32767.0) > 0.5)
   Result.Add(1);
else
  {
   target = vector<float>::Zeros(NActions);
   for(int i = 0; i < NActions; i++)
      target[i] = float(MathRand() / 32767.0);
      bActions.AssignArray(target);
      Result.Add(0);
  }
if(!cDirector.feedForward(GetPointer(bActions), 1, false, (CNet*)GetPointer(cEncoder), LatentLayer)
   || !cDirector.backProp(Result, (CNet*)GetPointer(cEncoder), LatentLayer)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
このアプローチにより、Directorは、良い判断を促すだけでなく、悪い判断に潜む問題点も認識できるようになります。その結果、Actorが効果の低い行動を避けられるようにします。
後は、学習の進捗状況をユーザーに通知し、ループの次の反復処理に進むだけです。
    if(GetTickCount() - ticks > 500)
      {
       double percent = double(iter + i - start) * 100.0 / (Iterations);
       string str = StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Encoder",
                                     percent, cEncoder.getRecentAverageError());
       str += StringFormat("%-14s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                cActor.getRecentAverageError());
       str += StringFormat("%-14s %6.2f%% -> Error %15.8f\n", "Director",
                                    percent, cDirector.getRecentAverageError());
       str += StringFormat("%-16s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                               cCritic.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
モデルの学習が完了したら、結果をログに記録し、EAの終了処理を開始します。
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Encoder", cEncoder.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor", cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Director", cDirector.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic", cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
実際の過去データを用いたオフライン学習プログラムとオンライン学習プログラムには、タイムスタンプバッファの作成に関する部分を中心に、必要最小限の変更を加えました。 ここでは、それらの詳細な検討はおこないません。 完全なソースコードは添付ファイルに含まれてされているので、ぜひご自身で確認してください。 環境との相互作用を行うプログラムも、同じ添付ファイルに含まれています。
本システムの学習は、実際の市場環境にモデルを段階的に適応させるため、3つのステージに分けて構成しています。
まず、前述の平滑化手法を用いて、実際の過去データによる初期のオフライン学習をおこないます。 この段階では、学習データセットを更新せずに学習を進めます。 環境状態エンコーダで使用する、ノイズを加えたバッチ正規化層によって、入力データに十分な拡張効果がもたらされます。その結果、モデルの視点から見た学習データセットの規模を大幅に拡大できます。
各ローソク足やインジケーターが、わずかな歪みを加えるフィルターを通過する様子を想像してみてください。これにより、同じ状況からさまざまなバリエーションが生まれ、モデルが同じパターンを何度も単純に記憶してしまうのを防ぐことができます。 その結果、エンコーダは、多少の歪みがあっても値動きの本質を捉えられるようになります。
第2段階のオフライン学習では、平滑化していない過去データを使用します。これにより、モデルは急激なスパイクや下落、ノイズを含む変動など、市場のありのままの姿にさらされます。 理想化された市場から生データへ移行することで、エージェントは実際の市場変動に適応し、予測の安定性を維持しながら、突発的な異常値に振り回されないよう学習します。 予測誤差の推移を注意深く監視し、誤差指標が連続する複数回のパスで狭い範囲内に収まった時点で学習を終了します。これは、モデルがデータにうまく適合したことを示すサインです。
最後の第3段階では、エージェントをストラテジーテスターに投入し、オンライン学習をおこないます。 ここでは、残高曲線の推移を観察します。 連続する複数回のパスを経ても残高が停滞し、期待される伸びが見られない場合は、オフライン学習に戻して調整をおこないます。具体的には、ほぼ理想的な軌跡を用いてActorの方策を調整し、再びファインチューニングを実施します。
この段階的なアプローチにより、高い予測精度と、あらゆる市場環境における取引判断の頑健性を両立させることを目指します。
テスト
ここまで、Mamba4Castフレームワークの開発者が提案した手法を適応させ、実装するために多くの作業をおこなってきました。 いよいよ、実際のデータを用いて、実装した手法の有効性を検証する段階です。
学習データセットには、2024年通年の1分足EURUSDデータを使用しました。 実験の客観性を保つため、最終テストには、学習に使用していない2025年1月から3月までの過去データを使用しました。 戦略の評価を公平に行えるよう、それ以外のパラメータはすべて変更していません。
テスト結果を以下に示します。
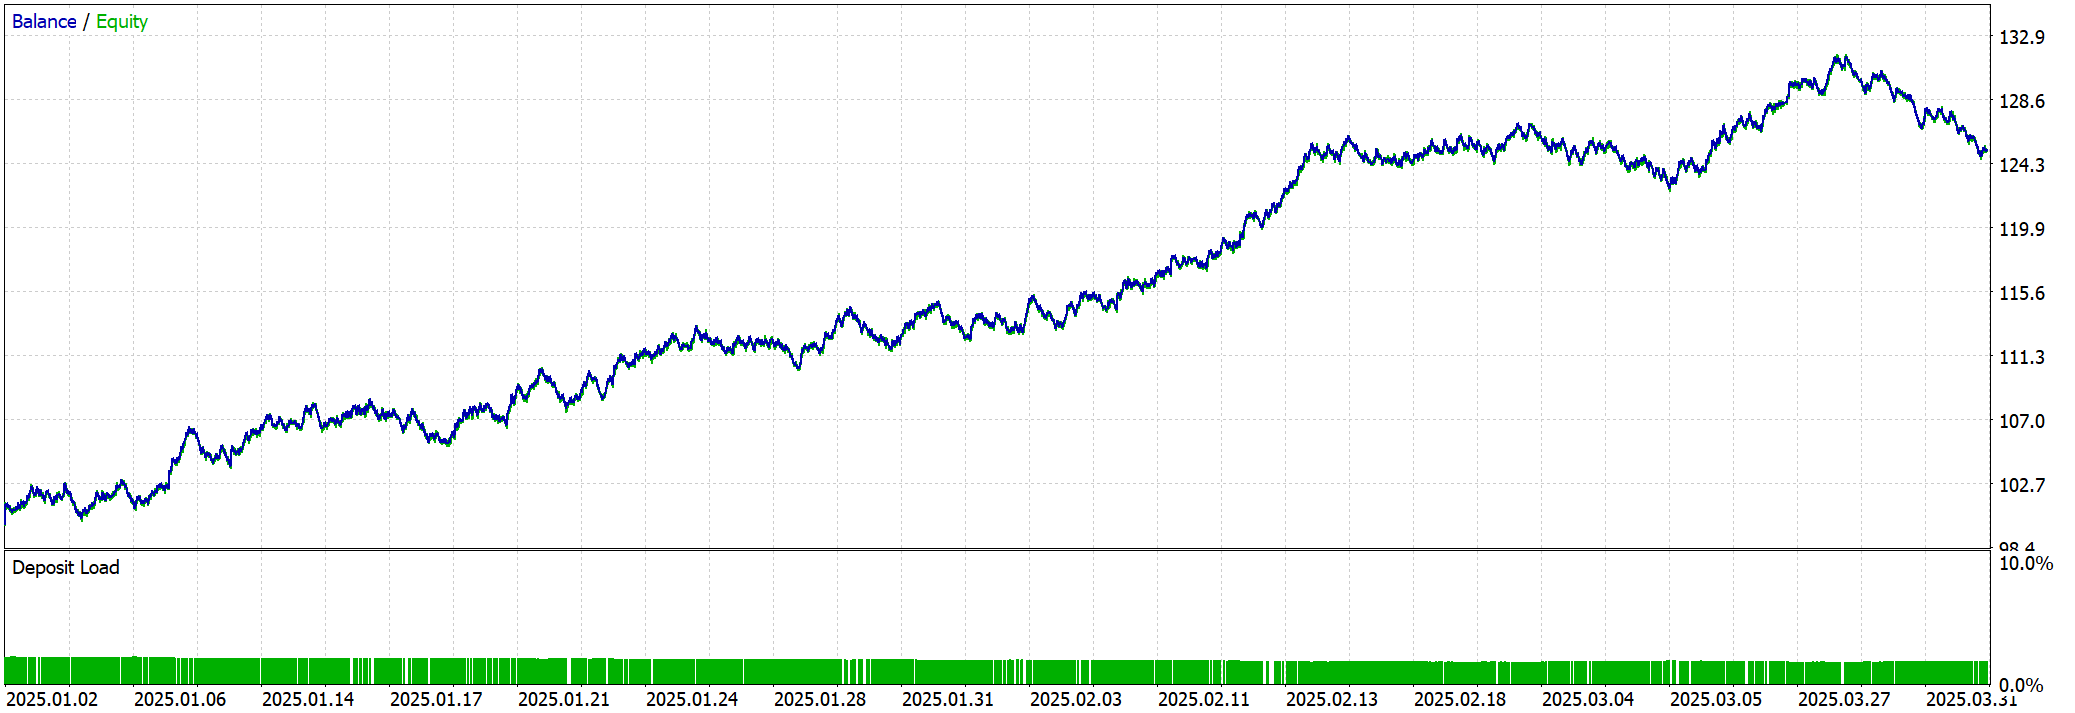
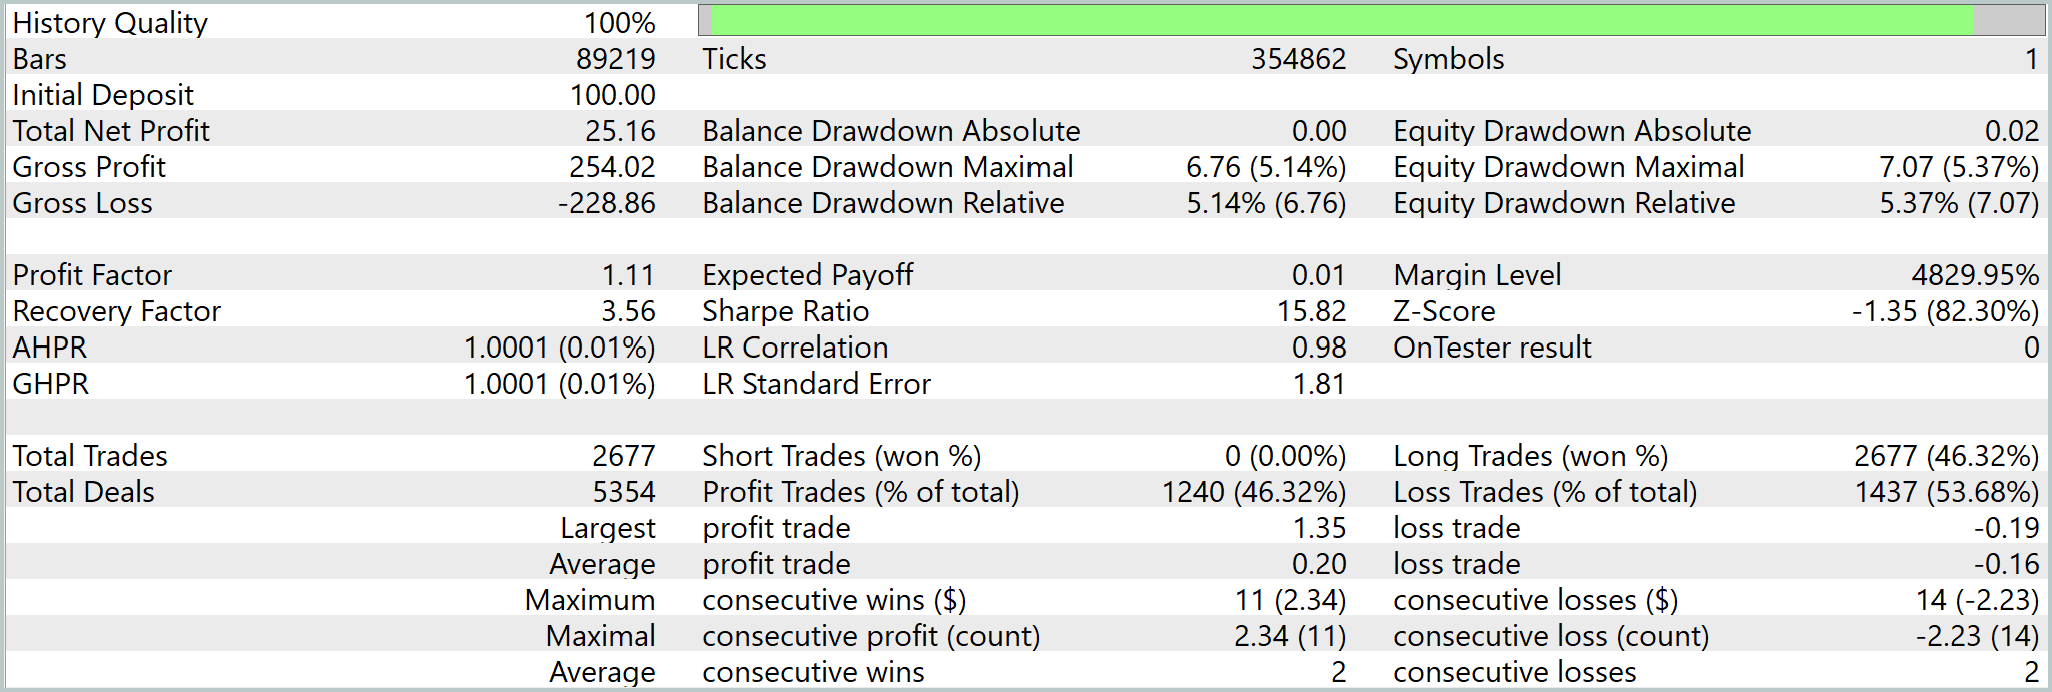
見てのとおり、取引頻度はかなり高くなっています。 ポジションの平均保有時間は3分強です。 テスト期間中、モデルは合計2,677回の取引を実行し、そのうち1,240回が利益で決済されました。 負けトレードの数は勝ちトレードをやや上回っていますが、それでもテスト期間全体では利益を上げており、残高曲線も比較的安定して上昇しています。 この結果の一因として、比較的狭いストップロスを設定してポジションを建て、その後も管理を続けていることが考えられます。 平均損失額と最大損失額の差が小さいことも、この見方を裏付けています。 一方、最大利益を記録した取引の利益額は、1取引当たりの平均利益の約7倍に達しています。
結論
本記事では、Mamba4Castフレームワークの着想とアーキテクチャから、実際の実装、学習、そして実際の過去データを用いた厳密なテストまで、一連の過程をたどってきました。 エンコーダには市場を感じ取る能力を、Actorにはリスクを考慮して判断する能力を、Directorには良いシグナルと悪いシグナルを選別する能力を、そしてCriticには実際の結果に基づいて行動を評価する能力を学習させました。
2025年1月から3月までのEURUSDM1(1分足)を用いたテストでは、Mamba4Castが予測をおこなうだけでなく、ノイズの影響を抑え、予期せぬ事象に適応し、長期的に利益を維持できる可能性が示されました。
ただし、本記事で紹介したプログラムは、あくまでもデモンストレーションを目的としたものであり、Mamba4Castフレームワークの機能を示すためのものです。 提案した手法を実際の取引に適用する前に、十分に代表性のあるデータセットを用いてモデルを学習させ、包括的なテストを実施する必要があります。取引戦略の信頼性と安全性を確保するには、こうした検証が不可欠です。
リンク
この記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Research.mq5 | EA | サンプル収集用EA |
| 2 | ResearchRealORL.mq5 | EA | Real-ORL手法を用いたサンプル収集用EA |
| 3 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 4 | StudyMA.mq5 | EA | 平均化データを用いたモデルのオフライン学習用EA |
| 5 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 6 | Test.mq5 | EA | モデルテスト用EA |
| 7 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 8 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 9 | NeuroNet.cl | ライブラリ | OpenCLプログラムコードのライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18219
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 初級から中級まで:オブジェクト(I)
 市場シミュレーション(第21回):SQL入門(IV)
 市場シミュレーション(第22回):SQL入門(V)
 初級から中級まで:インジケーター(V)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索