

市場シミュレーション(第21回):SQL入門(IV)
 22
 1

はじめに
今回も、レプリケーション/シミュレーションシステムについて解説していきます。
前回の「市場シミュレーション(第20回):SQL入門(III)」では、SELECTコマンドについて簡単に説明しました。 SQLをより効果的に使うためには、より正確に言えば、SQLができることを十分に活用するためには、もう一つ理解しておくべき概念があります。 これは、同じ役割を果たすアプリケーション、つまりデータベースを管理し、データベースを操作できるようにするアプリケーションを作成するよりも、はるかに優れた代替手段です。 その概念とは、データベースにおいて重要な「キー」です。 主キー(Primary Key)と外部キー(Foreign Key)のことです。
MetaEditorでもSQLiteを操作できますが、SQLの操作をより体系的に学びたい初心者の方には、より高度なツールが必要になるでしょう。 ここで重要なのは、MetaEditorが機能的ではないと言っているわけではない、ということです。 ただ、MetaEditorは一部の概念を理解するには適していません。これは、MetaEditorの目的が異なり、MQL5で記述されたコードの編集やコンパイルにあるからです。 SQLiteを利用するためにMetaEditorが提供してくれる手厚いサポートも、SQLを学ぶという目的には十分ではありません。
そこで今回は、別のツールを提案したいと思います。 SQLiteを操作することを目的として設計されたツールだからです。 MySQLなど、SQLを扱う他のプラットフォームを使用しても、実際には同じ結果を得ることができます。 前回までの記事でも説明したように、QLを使ってデータベースにアクセスする際、どのシステムを使うかは本質的な問題ではありません。 もちろん、その実装固有の機能に頼らず、SQLの構文だけを使う限り、どのシステムでも同じことができます。
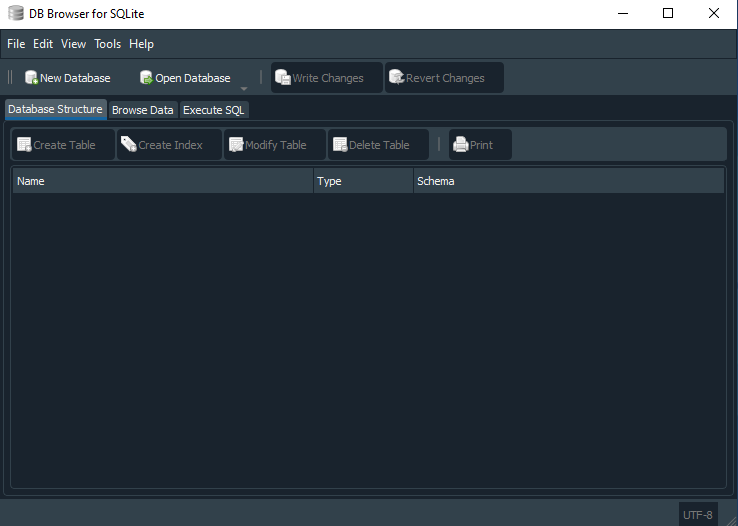
そこで、ここではDB Browserを使用することをお勧めします。 DB Browserはオープンソースのツールで、C++で記述されており、GitHubから無料でダウンロードできます。 この記事の最後に、GitHubからツールをダウンロードするためのリンクを掲載しています。 DB Browserの利点の一つは、さまざまな概念を理解しやすくなることです。多言語化されているため、英語を話さない多くの方にとって非常に役立つでしょう。
もう一つ重要なのは、MetaEditorでは、SQLスクリプトを編集して保存し、そのまま利用することはできないが、DB Browserではできるということです。 このような機能は、学習を始めたばかりの段階では非常に役立ちます。 一方、すでにSQLを理解しており、データベースへのクエリにのみSQLを使用しているのであれば、どちらのツールを使っても同じです。 したがって、どのツールを使用するかはご自身の判断にお任せします。
下の画像は、DB Browserのインターフェースを示しています。 もちろん、今回学習する内容には必要のない項目もあるため、この画像では一部のオプションを省略しています。
しかし、主キーと外部キーについて見ていく前に、特にSQLについての知識をさらに深めたいと考えている方が疑問に思うかもしれない点について、一つ説明しておきたいと思います。
なぜ方針を変えたのか?
特定のSQL実装を使ってSQLを学ぼうとすると、少し戸惑ったり、場合によっては失望したりするかもしれません。 データベースの専門家を採用する際に、特定のSQL実装を扱えることを条件として求める管理者も少なくありません。 たとえば、SQL Serverを勉強しても、実際にはMySQLが使われているために仕事に就けない、といったことが起こります。 また、Oracleは他のSQL実装より優れている、といった意見を耳にすることもあるでしょう。 これまでの記事で示してきたように、このような考え方をする人は、実際にはデータベースについて何も理解していません。 単に、あるものが別のものより優れている、あるいは劣っていると思い込んでいるだけです。 実際の仕組みを詳細に理解しておらず、理解していないものを評価しようとして、そこで思考が止まってしまっています。
データベース、あるいはサーバーを利用するデータベース実装を使用するのであれば、データベースにアクセスするための方法が必要になります。 最も一般的なのは、ソケットを利用する方法です。 SQLについて説明する前に、これまでいくつかの記事で、ソケットの扱い方について説明してきました。 ソケットの仕組みを説明するだけでなく、ExcelとMetaTrader 5の間で双方向通信を確立する方法も紹介しました。 つまり、ExcelとMetaTrader 5の双方でデータを相互にやり取りできるということです。 RTDやDDEを使ったデータ転送だけに頼る必要はありません。その場合、データを受け取れるのはExcel側だけだからです。 しかし、ソケットの使い方を知っていれば、さらに多くのことが可能になります。
そこで示した知識は、MQL5、あるいはMetaTrader 5上で実行される実行ファイルからSQLを利用し、データベースにアクセスする場合にも応用できます。 必要なのは、SQLコマンドの使い方と、ソケットを介して情報を送受信する方法を知っていることだけです。 そこから先は、それほど難しくありません。情報のやり取りという点では、サーバー上のデータベースのほうがはるかに実用的だからです。 分かりやすくするために、もう少し説明しましょう。SQLサーバー上でホストされるデータベースは、ファイルに保存されたデータベースよりもはるかにスケーラブルです。
一方、SQLiteを使用する場合、基本的にはデータベースをファイルとして配置することを前提とします。 もちろん、ファイル以外の方法が使えないという意味ではありません。 SQLiteサーバーを利用することも可能です。しかし、通常SQLiteを使用する場合は、ファイルを利用します。 これによって、いくつかの制限や不便が生じます。 こうした制限の一部は許容できるものです。というのも、データベースが特定のアプリケーションだけから利用されるケースは多いからです。 しかし、別のケースでは、こうした制限によって方針を変更し、SQLサーバーを利用せざるを得なくなることもあります。
ただし、この記事の目的は教育であり、何よりもまず、本来プログラミングする必要のないものは自分でプログラムせず、可能な限り既存のツールを利用すべきであるということを皆さんに示すことにあります。 そのため、データベースをファイルに格納することで生じるこうした制限は、ここでは実際には問題になりません。 ただし、覚えておいてください。データベースをファイルに保存する実装と比較すると、SQLサーバーには、さまざまな点で常に優れたところがあります。
この点を説明したところで、ここではしばらくMySQLから離れることにしましょう。 私はMySQLがとても気に入っていますが、まずは本当に必要なことに集中する必要があります。 将来的には、別の記事で、ソケットを利用してデータベースをプログラミングする方法について説明するかもしれません。 しかし今は、別のことに目を向けることにしましょう。話題が混ざらないように、ここからは新しいテーマとして説明していきます。
主キーと外部キーはなぜ存在するのか
データベースに詳しくない人にとって理解するのが難しいことを説明するには、まず、プログラミングにまったくなじみのない人にとっても少し難しい概念を説明する必要があります。 つまり、一つのことを理解するためには、別のことを理解しておく必要があるということです。 それでは、主キーと外部キーがなぜ存在するのか、説明していきましょう。 ただし、プログラミングについて何も知らない場合は、この説明で使用する概念を理解するためにも、まずは何らかのプログラミング言語の基礎を学んでおくことをお勧めします。
私が主キーと外部キーを常にセットで扱うのは、それらが存在する理由が、リレーショナルデータベースと非リレーショナルデータベースの違いに関係しているからです。 ここで話が少し複雑になります。というのも、多くの人はデータベースには一種類しかないと思っているからです。 つまり、「データベース」という言葉を聞くと、すぐにキーと値の関係を思い浮かべる人が大半なのです。 しかし、これは完全に正しくはありません。 問題は、いくつかの概念が正しく使われていないことにあります。 「キーと値」という概念は、それだけでデータベースがリレーショナルであるかどうかを意味するものではありません。 実際、この概念は、単純なデータベースの分類だけでは説明できないものです。 これを理解するために、いったんデータベースのことは忘れて、そもそも「データベース」という言葉が登場する以前の状況を考えてみましょう。
「キーと値」という概念を最も簡単に実現する方法の一つが、配列を使うことです。 配列とは何かをご存じなら、配列の各インデックス、つまり位置に、値やレコードを格納できることをご存じでしょう。 ここで、 そのインデックスをキーに、そこに格納されているレコードを値に相当するものと考えることができます。そして、そのインデックスを使えば、対応する位置にあるレコードを取得できます。 これがわかれば、そのデータを変更したり、削除したり、自由に操作したりすることができます。 これが、最も基本的な考え方です。
次に、メモリ上にある配列をファイルに保存するとしましょう。ファイルを読み込んだときに、元の配列を簡単に再構築できる形式で保存すればよいのです。 ここでも、これが最も基本的な考え方です。 この段階で、次のように考えるかもしれません。「プログラマーである私が、配列内の任意のレコードを変更、検索、並べ替え、削除するための一連の処理やサブルーチンを作ればよいのではないでしょうか?」実は、この時点で、あなたはすでにデータベースを作っています。 なぜなら、データベースと同じ基本的な仕組みを利用しているからです。
この場合、レコードにアクセスするには、まずファイルを読み込んでメモリ上の配列に復元します。必要な処理を実行したら、配列を再びファイルに保存します。 このような方法は、プログラミングの学習を始めたばかりの頃によく実践され、説明されるものです。 しかし、私の知る限り、このような仕組みをデータベースとして扱う人はあまりいません。 なぜでしょうか。 それはともかく、 実際には、あなたは知らないうちに、自分専用のデータベースを作っていたことになります。
ただし、このような方法には、拡張性に乏しいという問題があります。 つまり、異なるアプリケーション間で情報をやり取りすることが簡単ではありません。 そこで、まさにこの時点で、データベースという仕組みの重要性が見えてきます。SQLのように、他の人も利用できる仕組みを使えば、さまざまなアプリケーションから利用できるデータベースを構築できるからです。 これが、最初からすべてを自分で作ることもできるが、すでに存在する仕組みを利用したほうがよい場合もあると言った理由です。
しかし、ここまでの説明だけでは、まだこのトピックの冒頭で提起された疑問に答えられていません。 その点については、後ほど改めて触れます。 まず、データベースとは何かについて基本的なイメージができたところで、次の問題に進みましょう。 リレーショナルデータベースと非リレーショナルデータベースは、何が違うのでしょうか。そして、なぜその違いが存在するのでしょうか。 簡単な質問ですが、答えはそれほど単純ではありません。 ある程度の経験がある人なら、すぐに「リレーショナルデータベースはSQLを使い、非リレーショナルデータベースはSQLを使わない」と答えるかもしれません。 私も答えがそれほど単純であればいいのですが、そうはいかないのです。 リレーショナルデータベースと非リレーショナルデータベースの違いは、「キーと値」の組をデータベース内でどのように配置するかにあります。
「いったいどういうことでしょうか。 ここまで難しかったのに、さらに難しくなってしまいました。 どうしてでしょう。 キーと値の組み合わせをデータベース内に配置する方法に違いがあるとは、どういう意味なのでしょうか?」最初は意味がわからないかもしれません。しかし、データベースについて学び、実際に扱うようになると、いずれ理解できるようになります。 ここでは、たとえ荒唐無稽に思えても、少なくとも何を説明しようとしているのかがわかるように、できるだけ詳しく説明していきます。
リレーショナルデータベースの大きな特徴の一つは、データの整合性です。より正確に言えば、データの整合性を損なうような操作を行おうとしても、データベースがその整合性を維持できることです。 データベース全体が、一つのまとまりとして整合性を保っていると考えてみてください。 しかし、データの整合性が重視されない場合もあります。 そのような場合、望ましくない結果が生じることがあります。本来、データベースは整合性を維持すべきだからです。 その結果、同じ「キーと値」の組み合わせが重複してしまうことがあります。 「ちょっと待ってください。 そんな重複は起こらないはずです。各インデックス、つまりキーには、それぞれ一つのレコード、つまり値が対応しているのですから」実際、そのように考えるのは正しいことです。 ただし、そう考えたのであれば、まだ配列の仕組みを前提にしているということです。 ここから話が少し複雑になります。 配列では、それぞれの位置が一つの値に対応しています。 そのため、同じ位置に、異なる二つの値を同時に格納することはできません。 基本的には、そのとおりです。
では、インデックスや位置の代わりに、別のものを使うとしたらどうでしょうか。たとえば、値や文字列をインデックス、つまりキーとして使うのです。 そうすると、話が少し身近なものになってきます。 これを理解するために、近年、広く使われるようになったPythonによるプログラミングについて考えてみましょう。 なぜ、ここでPythonを使うのでしょうか。 それは、Pythonには、リレーショナルデータベースと非リレーショナルデータベースの違いを説明するのに適した概念があるからです。 さらに、Pythonでは配列も扱えるため、両者を比較することで、より論理的に説明できます。
Pythonには、「辞書」と呼ばれる概念があります。 辞書とは、一般的に、各要素がキーと値の組み合わせで構成されるデータ構造です。 つまり、配列のように、数値のインデックスによって値との対応関係が決まるわけではありません。 キーを任意の位置に配置でき、キーを指定して検索すれば、それに対応する値を取得できます。 この例えが役立つのは、キーと値がそれぞれ明示的な項目として扱われ、その対応関係が数値の配列インデックスに縛られなくなることを理解できるからです。 Pythonでこのようなことができるのと同じように、SQLを使っても、同様の仕組みを実現できます。 具体的には、キーとして使用する値を格納する列を作成します。
そして、別の列に、それぞれのキーと対応するレコードの値を格納するのです。 適切な制約や仕組みを設けなければ、SQLで構築したデータベースであっても、非リレーショナルデータベースになってしまいます。 ここまでの説明は単純に思えるかもしれません。しかし、さまざまな要素を理解することで、いくつかの概念をより深く理解できるようになることがおわかりいただけたでしょうか。 ただし、ここまでの説明は、あくまでもデータベースをどのように捉えるかを説明するためのものです。 また、SQLで実現できる処理を、わざわざ一連のサブルーチンや手続きを自分でプログラミングする必要があるのか、という点についても考えていただきたいのです。 そもそも、この目的のために、SQLを使ってPythonの辞書と同じような仕組みを構築することはできないとお考えでしょうか。
リレーショナルデータベースの基本に進む前に、ここで一つ、興味深い点に触れておきましょう。 プログラミング経験の少ない愛好家を中心に、Pythonを使って人工知能システムを構築するための、実にさまざまな方法が考案されてきました。 私は、そうした人たちを批判したいわけでも、間違っていると言いたいわけでもありません。 ただ、次のことを考えてみてください。 そのような人工知能システムでは、基本的にデータベースが使われています。 それは、ここまで説明してきたような非リレーショナルデータベースの場合もあれば、これから説明するリレーショナルデータベースの場合もあります。 そこで、一つ疑問が生じます。同じことがSQLでもできるのであれば、なぜPythonでそのようなデータベースを作るのでしょうか?
GPTをはじめとする技術への関心が高まり、それに似たものを作ろうとしたり、少なくとも特定の目的を満たすシステムを開発しようとしたりして、多くの人がPythonを学び始めています。しかし、同じことをSQLでも実現できるのです。 重要なのは、ある処理をどちらの言語で実現するにしても、どれほどの労力が必要になるのか、という点です。 以前、私は、自動的に動作するエキスパートアドバイザー(EA)の作り方について、連載記事を書きました。その際、なぜそのようなものを作ったのかと質問されたことがあります。 しかし、個人的には、そのようなものを作ること自体に、特別な難しさがあるとは思っていません。実装すること自体は、非常に簡単だからです。
一方、市場での取引を学習するために、SQLで構築・管理されたデータベースを利用するEAとなると、話は別です。 このようなものは、実装自体が難しいわけではありませんが、相応の知識と労力が必要になります。特に、EAが適切に学習し、自らデータベースを構築できるようにするには、それなりの知識と工夫が求められます。 おそらく、すでにこのような仕組みは存在しているでしょう。つまり、MetaTrader 5とSQLを組み合わせ、人間のように主観的な判断を行うロボットです。取引を行うべきか、買うべきか売るべきか、あるシグナルが別のシグナルよりも優れているか、といったことを判断するのです。 結局のところ、正しい概念を学べば、このような仕組みも実現できるようになるのです。
それでは、リレーショナルデータベースとは実際にどのようなものなのか、見ていきましょう。 プログラミングについてある程度の知識があれば、非リレーショナルデータベースがどのように生まれるのかは、おわかりいただけると思います。 しかし、リレーショナルデータベースを理解しなければ、非リレーショナルデータベースについても十分に理解することはできません。 SQLを使うかどうかは、ここでも関係ありません。 違いは、あくまでもデータベースの基礎となる構造をどのように作るかにあります。
リレーショナルデータベースを理解するために、少し前の話に戻りましょう。 具体的には、データベース内のレコードを変更したり削除したりする方法について説明した前回の記事に戻る必要があります。 以前の記事を読んでいただければ、ここで何を説明しようとしているのか、おわかりいただけるはずです。 前回の記事では、特定のレコードを検索するためには、何らかの手掛かりが必要であることを明確に説明しました。 この手掛かりがなければ、目的のレコードがどこにあるのかを特定できません。この手掛かりとなるものが、キーです。 では、リレーショナルデータベースで使われるキーと非リレーショナルデータベースで使われるキーとでは、何が違うのでしょうか。 一つの違いは、非リレーショナルデータベースでは、キーが一意であるとは限らないということです。 ただし、違いはそれだけではありません。 とりあえず、このことを覚えておいてください。
リレーショナルデータベースでは、このキーが重複しないようにします。 そのために、通常は主キーを定義します。 ただし、ある列を主キーとして扱うからといって、その値が自動的に重複しなくなるわけではありません。 SQLでは、ある列の値が重複しないように制約を設定することもできます。 しかし、それだけで、その列のデータやレコードが主キーになるわけではありません。
では、何によって列が主キーになるのでしょうか。それは、外部キーの存在です。 これこそが、データベースをリレーショナルなものとして定義し、その関係性を保証するものなのです。 なぜなら、これによって、あるテーブルに存在するキーと、別のテーブルに存在するキーとの間に関係が生まれるからです。 この方法は、すべてのレコードを一意に識別する必要があるデータベースを構築する際によく使われます。 しかし、それ以上に重要なのは、すべてのレコードが何らかの形で互いに関連付けられていることです。その結果、下の画像に示されているように、データベース全体が、グラフのように相互につながった構造を形成します。
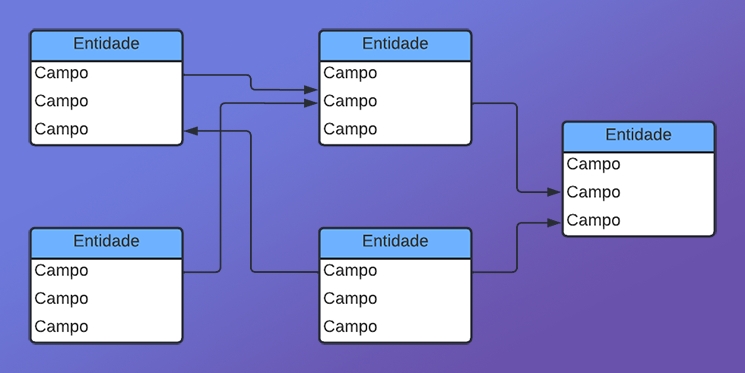
この画像を見ただけでは、「主キー」と「外部キー」という概念が、まだはっきりと理解できないかもしれません。 そこで、私たちの日常生活に関するデータベースを作ると想像してみてください。 このデータベースには、主キーも外部キーも必要ないでしょう。 しかし、そこにSNS上の知り合いや、身近な人たちの連絡先を追加していくとしたらどうでしょうか。それぞれの連絡先には、主キーとなるキーを設定することになります。 ただし、こうしたレコードには、共通する情報が含まれることがあります。 同じデータベースを管理する際に、こうした共通情報をそれぞれのレコードに重複して登録してしまうと、複数のテーブルや項目を突き合わせて問い合わせる際に、処理が遅くなり、複雑になってしまいます。
一方、こうした共通情報を専用のテーブルにまとめておけば、別のキー(ここでは外部キー)を使って情報を簡単に対応付けることができます。その結果、検索が速くなるだけでなく、後からデータベースの内容を変更する必要が生じた場合にも、変更を容易に行えるようになります。 このようにして、リレーショナルデータベースが生まれます。 つまり、ある場所に保存されている情報を、別の場所に保存されている情報と関連付けて管理するということです。
まとめ
今回の記事の内容は、抽象的で理解しにくいと感じられるかもしれません。 しかし、現在のような形で定義され、利用されているデータベースは、一夜にして登場したものではないということを強調しておきたいと思います。 データベースは、長い年月をかけて少しずつ構築され、実装されてきたものです。 私よりもデータベースを扱った経験がはるかに豊富で、そのため異なる見解をお持ちの方も多いかもしれません。
データベースがなぜ現在のような設計になっているのか、そしてなぜSQLが現在のような形式になっているのか、特に、なぜ主キーや外部キーという仕組みが生まれたのかを説明する必要があったため、一部の説明は、どうしてもやや抽象的なままにせざるを得ませんでした。 繰り返しになりますが、説明という観点だけからこのテーマを見ると、抽象的で、根拠がわかりにくいと感じられるかもしれません。
しかし、私が目指しているのは、SQLについて深く掘り下げなくても、皆さんが特定の処理を実現できるように、このテーマの基礎を紹介することです。そのためには、主キーや外部キーとは何か、そして、それらが実際にどのように機能するのかを理解する必要があります。 たとえ学習目的でデータベースを作る場合であっても、これらの概念を正しく理解しておくことが、非常に重要になるからです。
何かを使い始めるのであれば、正しく使わなければなりません。 よく理解できていない考え方をあれこれ学んでも、専門家としての成長にはつながりません。 すでに説明したように、SQLを使っているからといって、そのファイルやファイル群がリレーショナルデータベースになるわけではありません。 既存のデータベースを操作するだけでなく、新しいデータベースを作るために、独自の処理や命令、サブルーチンを組み合わせて、自分で仕組みを構築することもできます。 しかし、関連する概念を十分に理解していなければ、時間がたつにつれて不安定になるシステムを作ってしまうことになります。
私自身、このことを身をもって理解しました。長い間、SQLや既存の実装を利用することを避け、常に自分独自の解決策を作ろうとしていたからです。 たとえ最初は問題なく動作しても、しばらくすると、結局はSQLですでに実現されていることを、自分で実装しなければならなくなりました。 最初から既存の仕組みを利用していれば、その労力と時間を、もっと生産的なことに使えたはずです。
次回の記事では、データベースの中で主キーと外部キーを実際にどのように使用するのかを見ていきます。 実例を通して説明することで、現時点では抽象的に感じられるこれらの概念も、より具体的で理解しやすいものになるでしょう。
| ファイル | 説明 |
|---|---|
| Experts\Expert Advisor.mq5 | Chart TradeとEAの連携を実演します。操作にはMouse Studyが必要です。 |
| Indicators\Chart Trade.mq5 | 送信する注文を設定するためのウィンドウを作成します。操作にはMouse Studyが必要です。 |
| Indicators\Market Replay.mq5 | 市場のレプリケーション/シミュレーションサービスを操作するためのコントロールを作成します。操作にはMouse Studyが必要です。 |
| Indicators\Mouse Study.mq5 | グラフィカルなコントロールとユーザーとの対話を実現します。市場のレプリケーションシステムと実際の市場の両方で必要です。 |
| Services\Market Replay.mq5 | 市場のレプリケーション/シミュレーションサービスを作成し、管理します。システム全体の中核となるファイルです。 |
| Code VS C++\Servidor.cpp | C++で開発されたサーバーソケットを作成し、管理します(ミニチャット版)。 |
| Code in Python\Server.py | MetaTrader 5とExcelの間で通信するためのPythonソケットを作成し、管理します。 |
| Indicators\Mini Chat.mq5 | インジケータを通じてミニチャットを実装できるようにします。サーバーが必要です。 |
| Experts\Mini Chat.mq5 | EAを通じてミニチャットを実装できるようにします。サーバーが必要です。 |
| Scripts\SQLite.mq5 | MQL5でSQLスクリプトを使用する方法を実演します。 |
| Files\Script 01.sql | 外部キーを持つシンプルなテーブルの作成方法を示します。 |
| Files\Script 02.sql | テーブルへの値の追加方法を示します。 |
リンク
MetaQuotes Ltdによりポルトガル語から翻訳されました。
元の記事: https://www.mql5.com/pt/articles/12985
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


 初級から中級まで:インジケーター(V)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 市場シミュレーション:ポジション表示(V)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索