

市場シミュレーション(第22回):SQL入門(V)
 58
 0

はじめに
今回も、レプリケーション/シミュレーションシステムの構築について解説していきます。
前回の「市場シミュレーション(第21回):SQL入門(IV)」では、リレーショナルデータベースと非リレーショナルデータベースの違いについて、概念的な説明を行いました。 しかし、何よりも伝えたかったのは、データベースがどのような仕組みで動作するのかを理解するための考え方です。これこそが、前回の記事を書いた主な理由でもあります。 特定の機能を自分でプログラミングするのが合理的に思える場合でも、既存の実装を利用することで、アプリケーションに求められる結果を実現できることがあります。その点を理解してもらうことが、前回の記事の目的でした。
だからこそ、MQL5でプログラミングを進める代わりに、SQLの解説に時間を割いているのです。 同じ機能を実現するためにルーチンを次々と作成することもできますが、それでもSQLを使う理由を、誰もが理解できるようにしておきたいと考えています。
今回のケースでは、SQLを利用することで、レプリケーション/シミュレーションシステムにコマンド機構を実現するための、シンプルで適切な方法を実現できます。 つまり、このシステムを使って検証を行うために、注文およびポジション管理の構造を保存しておく必要があるのです。 そのために多数のルーチンを作成する必要があるとは思いません。MQL5ではSQLiteを利用してSQLの機能を活用できるからです。 ただし、コードを次々と書いて実装を重ねたいという方のために、より優れた代替手段も紹介していきます。 データベースのような仕組みを構築するために、処理を実装し、テストし、設定することに時間を費やすよりも、その時間をほかの作業に充てたほうが、はるかに生産的だからです。
こうすることで、レプリケーション/シミュレーションシステムを、売買戦略の検証に使うデモ口座の実質的な代替手段として機能させるための開発に着手した際も、作業を大幅に効率化でき、正常な動作を確保するうえでの問題も減らせるでしょう。 SQLを利用することで、注文管理機構の構築に必要な基盤を整えられるからです。
ただし、前回の記事の説明だけでは、内容が抽象的なまま、理論にとどまってしまいます。 このテーマはほかの分野にも応用できます。たとえば、データベースを利用して取引判断を学習するエキスパートアドバイザー(EA)を作成したい場合にも、前回説明した内容を実際に試してみる必要があります。 ここで、一つ重要な点を先にお伝えしておきます。少なくとも現時点では、MQL5で作成したEAが特定の銘柄の取引方法を学習できるようにするためのデータベースの構築方法については、解説する予定はありません。
そのような内容を説明するには、データベースの動作に関するほかの多くの概念や原則についても解説する必要があるからです。 本格的に学びたいのであれば、ゲームアルゴリズムを詳しく研究することをお勧めします。 データベースを作成すること自体は、MQL5でEAをプログラミングするのと同様、難しい作業ではありません。 しかし、データベースを本当に役立つものにし、EAが市場でどのように取引すべきかを文字どおり「学習」できるようにするには、作成したデータベースに、どのようなデータをどのように追加すればよいのかを理解する必要があります。 そうしたデータの作り方を学ぶうえで、最も手軽な方法の一つが、ゲームアルゴリズムを学ぶことです。
もちろん、波動や熱の分布といった概念を研究する、より複雑なアプローチもあります。 ただし、こうした方法はかなり難しいにもかかわらず、得られる結果はゲームアルゴリズムを用いた場合とほとんど変わりません。
それでは、前回の記事で説明した内容を、実際に試してみましょう。 理解しやすいように、今回もテーマごとに分けて解説していきます。まずは、この記事の最初のテーマから始めましょう。
簡単なデータベースの作成
このテーマについては、ここでは詳しく説明しません。 SQLを扱ったこれまでの記事ですでに取り上げているからです。 ただし、前回の記事では、MQL5から利用するSQLiteを直接操作するために、別のプログラムを使用することを提案しました。そのため、SQLiteを使ううえで知っておくべき、いくつかの特徴について説明しておく必要があります。
まず、SQLiteのデータ型と、データベースに格納するデータとの関係を見ていきましょう。 SQLiteのデータ型について特に注目したいのは、その種類が少ないことです。 しかし、これは欠点ではありません。開発するものによっては、ほかの実装にはない利点と相まって、大きな強みになります。
先ほど触れたもう一つの利点は、ほかの多くのデータベース実装とは異なり、SQLiteではデータ型の扱いが動的であるという点です。 「ちょっと待ってください。 SQLiteではデータ型が動的だというのは、どういう意味でしょうか? それはなぜ利点になるのでしょうか?」これを理解するために、まずは次の表をご覧ください。
| SQLiteのデータ型 | 説明 |
|---|---|
| NULL | NULL値を表します。 |
| INTEGER | 値の大きさに応じて、1、2、3、4、6、または8バイトで格納される符号付き整数です。 |
| REAL | 8バイトの浮動小数点数として格納される実数です。 |
| TEXT | データベースのエンコーディング(UTF-8、UTF-16BE、UTF-16LEのいずれか)を使用して格納されるテキスト文字列です。 |
| BLOB | 任意のバイナリデータです。挿入されたデータは、そのままの形で格納されます。 |
ここに示したのは、SQLiteのデータ型です。 では、参考までに、他のSQLデータベースではどうなっているのかも見てみましょう。 まずはMySQLです。以下に、MySQLで使用される主なデータ型をまとめました。
| MySQLのデータ型 | 説明 |
|---|---|
| TINYINT | 非常に小さな整数です。 符号付きの場合は-128~127、符号なしの場合は0~255の範囲を取ります。 |
| SMALLINT | 小さな整数です。 符号付きの場合は-32768~32767、符号なしの場合は0~65535の範囲を取ります。 |
| MEDIUMINT | 中程度の大きさの整数です。 符号付きの場合は-8388608~8388607、符号なしの場合は0~16777215の範囲を取ります。 |
| INTEGER | 標準的なサイズの整数です。 符号付きの場合は-2147483648~2147483647、符号なしの場合は0~4294967295の範囲を取ります。 |
| BIGINT | 大きな整数です。 符号付きの場合は-9223372036854775808~9223372036854775807、符号なしの場合は0~18446744073709551615の範囲を取ります。 |
| FLOAT | 単精度の浮動小数点数です。 |
| DOUBLE | 倍精度の浮動小数点数です。 |
| DECIMAL | パック形式の固定小数点数です。 このデータ型のレコードの表示長は列の作成時に定義され、各レコードはその長さに合わせて調整されます。 |
| BOOLEAN | trueまたはfalseを表す論理値です。 |
| BIT | 1~64ビットの値を扱う型です。 |
| DATE | YYYY-MM-DD形式で表される日付です。 |
| DATETIME | YYYY-MM-DD HH:MM:SS形式で表される日付と時刻です。 |
| TIMESTAMP | Unixエポック(1970年1月1日 00:00:00)からの経過時間を示すタイムスタンプです。 |
| TIME | HH:MM:SS形式で表される時刻です。 |
| YEAR | 2桁または4桁で表される年です。標準は4桁です。 |
| CHAR | 固定長の文字列です。この型の値は、保存時に指定された長さに合わせるため、右側がスペースで埋められます。 |
| VARCHAR | 可変長の文字列です。 |
| BINARY | CHAR型と似ていますが、通常の文字の文字列ではなく、指定された長さのバイナリバイト列を表します。 |
| VARBINARY | VARCHAR型と似ていますが、通常の文字の文字列ではなく、可変長のバイナリバイト列を表します。 |
| BLOB | 最大長が65535(2^16 − 1)バイトのバイナリ文字列です。 |
| TINYBLOB | 最大長が255(2^8 − 1)バイトのBLOB列です。 |
| MEDIUMBLOB | 最大長が16777215(2^24 − 1)バイトのBLOB列です。 |
| LONGBLOB | 最大長が4294967295(2^32 − 1)バイトのBLOB列です。 |
| TEXT | 最大長が65535(2^16 − 1)文字の文字列です。 |
| TINYTEXT | 最大長が255(2^8 − 1)文字のテキスト列です。 |
| MEDIUMTEXT | 最大長が16777215(2^24 − 1)文字のテキスト列です。 |
| LONGTEXT | 最大長が4294967295(2^32 − 1)文字のテキスト列です。 |
| ENUM | テーブルの作成時に宣言された値のリストから1つの値を取る、文字列形式のオブジェクトです。 |
| SET | ENUM型と似た文字列オブジェクトですが、0個以上の値を持つことができます。各値は、テーブルの作成時に指定された許容値のリストから選択されます。 |
MySQLには、ここで紹介したもの以外にも多くのデータ型があります。将来的な問題を避けるためにも、用途に合ったデータ型を適切に選ぶことが重要です。 PostgreSQLにも独自のデータ型が数多く用意されています。主なものを以下に示します。
| PostgreSQLのデータ型 | 説明 |
|---|---|
| BIGINT | 8バイトの符号付き整数です。 |
| BIGSERIAL | 8バイトの自動採番用整数です。 |
| DOUBLE PRECISION | 8バイトの倍精度浮動小数点数です。 |
| INTEGER | 4バイトの符号付き整数です。 |
| NUMERIC | 精度を指定できる数値型です。金額など、数値の正確さが重要な場合に適しています。 |
| REAL | 4バイトの単精度浮動小数点数です。 |
| SMALLINT | 2バイトの符号付き整数です。 |
| SMALLSERIAL | 2バイトの自動採番用整数です。 |
| SERIAL | 4バイトの自動採番用整数です。 |
| CHARACTER | 指定した長さの固定長文字列です。 |
| VARCHAR | 最大長を指定できる可変長文字列です。 |
| TEXT | 長さの上限を指定しない可変長文字列です。 |
| DATE | 年、月、日で表される日付です。 |
| INTERVAL | 時間の間隔や期間を表す型です。 |
| TIME WITHOUT TIME ZONE | タイムゾーンを指定しない時刻です。 |
| TIME WITH TIME ZONE | タイムゾーン情報を伴う時刻です。 |
| TIMESTAMP WITHOUT TIME ZONE | タイムゾーンを指定しない日付と時刻です。 |
| TIMESTAMP WITH TIME ZONE | タイムゾーン情報を伴う日時と時刻です。 |
| BOX | 平面上の長方形を表します。 |
| CIRCLE | 平面上の円を表します。 |
| LINE | 平面上の無限直線を表します。 |
| LSEG | 平面上の線分を表します。 |
| PATH | 平面上の幾何学的な経路を表します。 |
| POINT | 平面上の幾何学的な点を表します。 |
| POLYGON | 平面上の閉じた多角形を表します。 |
| CIDR | IPv4またはIPv6のネットワークアドレスを表します。 |
| INET | IPv4またはIPv6のホストアドレスを表します。 |
| MACADDR | メディアアクセス制御(MAC)アドレスを表します。 |
| BIT | 固定長のビット列です。 |
| BIT VARYING | 可変長のビット列です。 |
| TSQUERY | テキスト検索用の検索文字列です。 |
| TSVECTOR | テキスト検索用のドキュメントです。 |
| JSON | JSON形式のテキストデータです。 |
| JSONB | 分解済みのバイナリJSONデータです。 |
| BOOLEAN | trueまたはfalseを表す論理値です。 |
| BYTEA | バイナリデータを格納する型です。名称は「byte array(バイト配列)」に由来します。 |
| MONEY | 金額を表す型です。 |
| PG_LSN | PostgreSQLのログシーケンス番号を表します。 |
| TXID_SNAPSHOT | ユーザーレベルのトランザクションIDのスナップショットを表します。 |
| UUID | 世界的に一意な識別子を表します。 |
| XML | XMLデータです。 |
PostgreSQLにも、このほか多くのデータ型があります。 こうした一覧を見ると、「SQLを使いたい人にとって、これだけ多くのデータ型を覚えるのは悪夢のようなものではないか」と思うかもしれません。 しかし、実際にはそうとも限りません。 SQLを使えば、用途に応じて適切なデータ型を選択できます。 これは、データベースをSQLを利用するほかのアプリケーションからも活用できるようにするうえで重要です。 データ型の数が多いか少ないかによって、データ型の選択の難しさも変わってきます。 適切でない型を選んでしまうと、後から変更する際に、データベース全体を再構築しなければならないこともあるからです。 専用のスクリプトを使えば、こうした作業自体はそれほど難しくありません。しかし、SQLを学び始めたばかりで、何から手をつければよいのかわからない人にとっては、大きな負担になりかねません。
一方、これらの表を比較すると、SQLiteではデータ型の種類が少ないため、扱うべき型も少なく、管理の負担を抑えられることがわかります。 もちろん、データ型が少ないことに伴う別の問題もありますが、ここでは触れません。 現時点で私たちが本当に注目したいのは、SQLiteではデータ型の種類が少ない一方で、動的な型が採用されているという点です。つまり、格納する情報に応じて柔軟に扱われます。
では、これは実際にはどのように適用されるのでしょうか。 これを理解するために、異なる2つのデータベースを作成する必要があります。 一方はMySQLを使用して作成し、もう一方はSQLiteを使用して作成します。 どちらも基本言語としてSQLを使用しています。 それでは、その方法を見てみましょう。 以下のアニメーションでは、MySQLでこの処理を行う手順を示しています。
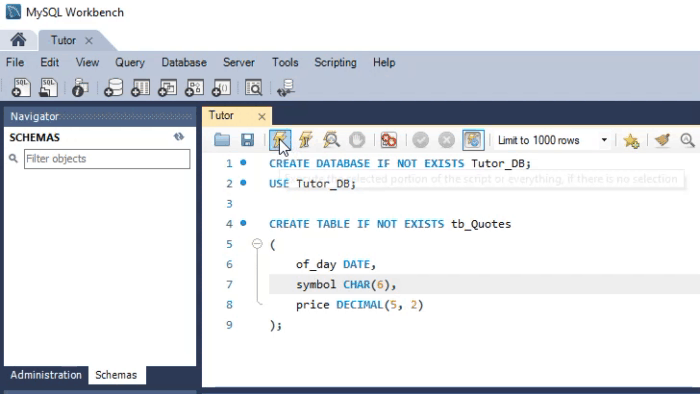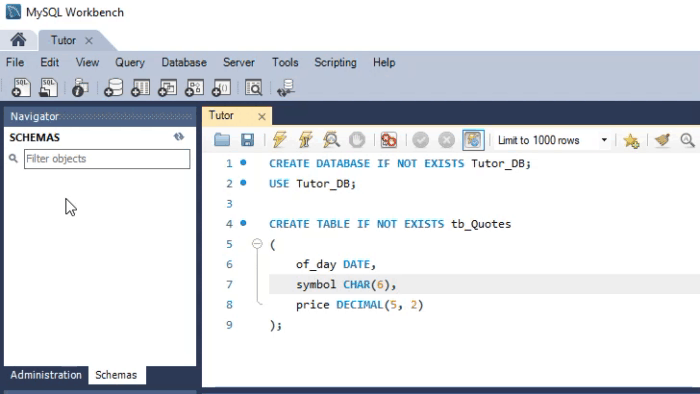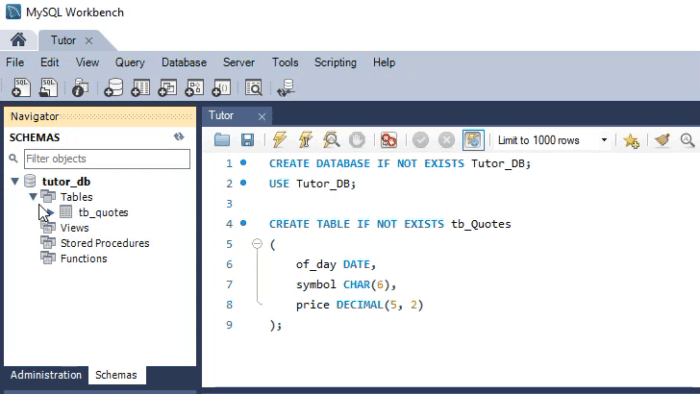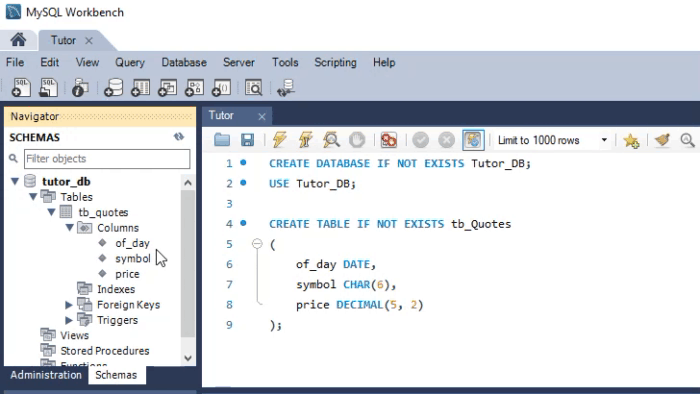
使用されているデータ型に注目してください。 次のアニメーションでも、ほぼ同じ手順を実行していますが、こちらではSQLiteを使用しています。
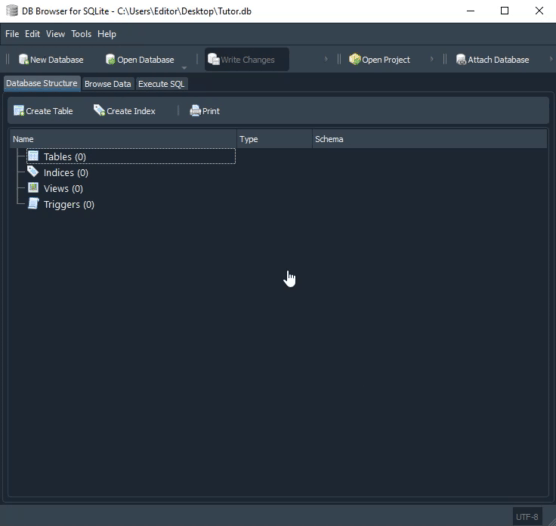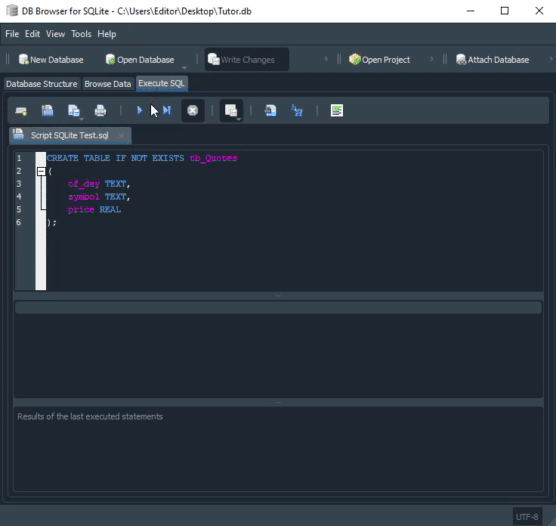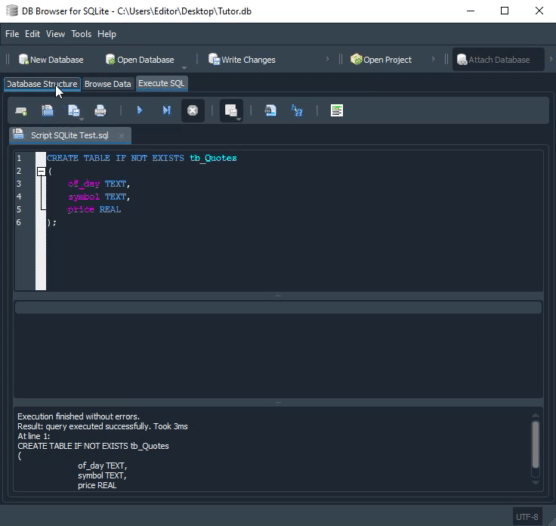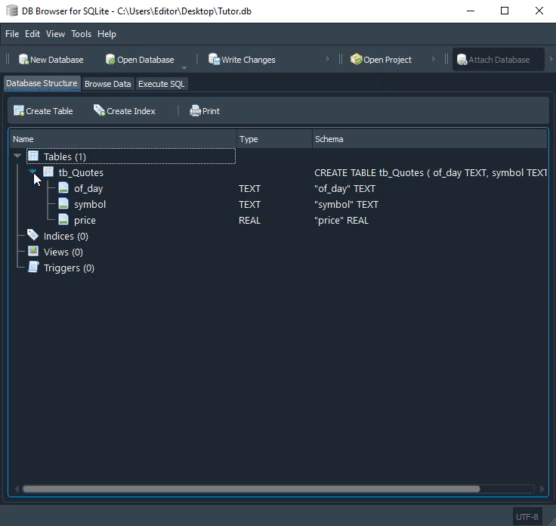
2つ目のアニメーションで定義されているデータ型に注目してください。 MySQLのアニメーションではスクリプトによってデータベースが作成されていますが、SQLiteではそうなっていません。 この場合、あらかじめデータベースを作成し、DB Browserで開いておく必要があります。 ここで「データ型が違うのだから、コードは両方では動作しないだろう」と思っているかもしれません。もしそう思うなら、それはこの記事に偶然出くわしたということでしょう。 MySQLとSQLiteの両方で同じコードを使用する方法を説明した以前の記事を読むことをお勧めします。 ただし、そのときはMetaEditorを使用してSQLiteを実行しました。
しかし、今回注目したいのは、MySQLのコードでは列を作成する際に、そのサイズも定義しているという点です。 一方、SQLiteではそのような指定をしていません。 このような動的な仕組みは、MySQLでも実装できます。 しかし、SQLite以外の実装では、一般的にあまり見られません。 その理由は、SQLプログラマーが、データベースの特定の特性を最適化するために、フィールドの型や、場合によってはサイズまで指定することを好むからです。 そのため、異なる実装間でデータベースを維持管理するには、より多くの作業が必要になります。
ここで、次のような疑問が生じるかもしれません。SQLiteで作成した列をMySQLは理解できるのでしょうか。あるいは、その逆はどうでしょうか。 この点について心配する必要はありません。 どのSQL実装でも、列に指定されたサイズや桁数の概念は理解できます。 このため、データ型には一定の共通性があることを理解しやすくする目的で、先ほどの表を示しました。 ただし、データベースの実装によっては、プログラマーがデータベースの特定の側面を最適化するために、あるデータ型を別のデータ型に変更することがあります。
さて、 必要な要素を説明したところで、主キーと外部キーがこの仕組みの中でどのような役割を果たすのか、実際に見ていきましょう。
実践における主キーと外部キー
上記のアニメーションでは、非常にシンプルなデータベースを作成する様子を確認できます。 その目的は、銘柄名を、その気配値および気配値を取得した日付とともに保存することです。 しかし実際には、データベースプログラマーがこのような方法でデータベースを作成することはほとんどないでしょう。 というのも、データベースには複数の銘柄を登録したり、テーブルに表示されている銘柄に対応する会社の商号など、追加の情報を格納したりする必要が生じることがあるためです。
また、銘柄の名称が変わることもあります。 これはかなり珍しいことですが、それでも時折起こります。 その一例が、B3で見られます。VIA VAREJOという企業は、ある期間、VVAR3というティッカーを使用していましたが、 何らかの理由で、そのティッカーはVIIA3に変更されました。 さて、過去のすべてのレコードについて、銘柄名を「VVAR3」から「VIIA3」に変更するために、どれほどの作業が必要になるか想像してみてください。 しかし、データベースの基礎となる設計を別の方法で構築していれば、こうした変更は非常に簡単に行えたはずです。
この例は非常に単純ですが、データベースについてさらに多くのことを理解するうえで、十分に実用的です。 データベースの作成や保守管理は簡単な作業だと考える人は少なくありません。しかし、実際に取り組んでみると、さまざまなミスを犯し、後になってそれらを修正するために多大な労力を費やすことになります。
まずは、SQLiteを使って基本的な解決策を作成する方法を見ていきましょう。 作業と説明を簡潔にするため、すぐ下に示すSQLスクリプトのコードを参照してください。 このコードでは、これから実装する仕組みを使用します。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY,
06.     symbol TEXT
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT,
12. --    symbol TEXT,
13.     price NUMERIC,
14.     fk_id INTEGER,
15.     FOREIGN KEY (fk_id) REFERENCES tb_Symbol (id)
16. );
SQLiteのコード
なお、このコードには、SQLに属していない要素がすでにいくつか含まれている点にご注意ください。 ここで該当するのは01行目で、SQLite独自の命令を使用しています。 では、なぜここでこの命令を使うのでしょうか。 その理由は、この記事の末尾にある参考文献セクションに掲載したSQLiteのドキュメントに記載されています。それによると、バージョン3.6.19より前のSQLiteでは、外部キーがデフォルトで有効になっていなかったため、明示的に指定する必要がありました。 指定しなければ、外部キーは使用されません。 前述のバージョンはかなり古いものですが、何らかの理由で今も使用している人がいるかもしれません。 この点はさておき、このスクリプトで何が起こるのかを確認しましょう。 SQLiteでスクリプトを正しく実行するには、DB Browserでデータベースを開いておく必要があることを忘れないでください。
03行目では、tb_Symbolsという名前のテーブルを、まだ存在しない場合に作成します。 このテーブルの05行目では主キーを定義し、 06行目では銘柄名を定義しています。 現時点では、このテーブルに格納するレコード数に制限は設けていません。 より適切なデータベース構築モデルにどのようにたどり着くのかを、これから説明したいからです。 したがって、idの値は常に一意ですが、同じ銘柄を複数のidで定義することができます。 しかし、これは簡単に解決できる問題です。 ただし、その方法を確認する前に、まず、ここでキーがどのように機能するのかを理解しましょう。
tb_Symbolsテーブルを作成した後、新しいテーブルを変更することができます。より正確に言えば、新しいテーブルを作成します。 これは09行目から始まり、tb_Quotesテーブルを作成することを指定しています。 ここで、12行目は上のアニメーションに示されている元の行であることに注意してください。 ただし、アニメーションで示したものとは異なり、ここではコメントとして記述されています。 これは、銘柄名がこのテーブルには含まれなくなるためです。 そのため、コードに14行目と15行目を追加しました。 ここからの説明は非常に重要なので、注意して読んでください。 14行目では、tb_Symbolsテーブルの主キーと同じ型でなければならない値を定義しています。 SQLiteを使用するプログラマーの中には、型を定義せず、プログラム側に任せる人もいます。 しかし、コード全体で一定の標準を維持したいため、ここでは型を明示的に定義します。
この値が、tb_Quotesテーブルの外部キーとなります。 そして、上のスクリプトにおける本当に重要なポイントは、ここからです。 15行目では、どの列が外部キーなのか、そしてその外部キーが何を参照するのかを指定しています。 ここでは、参照先のテーブル名だけでなく、使用するキー名、つまり列名も指定する必要があることに注意してください。 このキーは、tb_Symbolsテーブルにあるものです。
このようにして、気配値の情報を銘柄名から切り離した参照システム、すなわちリレーショナルな仕組みを構築します。 ただし、この分離は完全に独立したものではありません。気配値のレコードと銘柄名の間には、依然として関係があるからです。 そして、その関係は、まさに主キーと外部キーを作成することによって成立します。 この関係を理解すれば、異なる情報同士を関連付けることで、本格的なデータベースを構築できることがわかるでしょう。情報同士につながりを持たせながら、同じレコードに格納するデータを増やしたり減らしたりすることもできます。 これらすべてを、元のデータベースの保守や変更にかかるコストを最小限に抑えながら実現できるのです。
上記のコードは、以下に示すように記述することもできます。この形のほうが、実際に起こり得る状況により近いものになります。 ただし、tb_Symbolsテーブル内で銘柄名が複数の場所に重複して記載されるという問題は、まだ解決されていません。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY,
06.     symbol TEXT
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT,
12.     price NUMERIC,
13.     fk_id INTEGER REFERENCES tb_Symbol (id)
14. );
SQLiteのコード
ここで、小さな変更を加えたことに注意してください。 変更したのは13行目で、その目的はこれまでと同じです。つまり、外部キーを使ってtb_Quotesテーブルとtb_Symbolsテーブルをリンクすることです。 もう1点、補足しておきます。これまでテーブル同士をリンクすると説明してきましたが、より正確には、tb_Quotesテーブルの1つのレコードを、tb_Symbolsテーブルの別の1つのレコードとリンクすると言うべきでしょう。 さて、ここでよく注意してください。それぞれのテーブルに何を格納するかは問題ではありません。 テーブルにフィールドやデータ列を増やしたり減らしたりしても、検索や検索結果に直接影響することはありません。
ただし、必要に応じて、いずれかのテーブルに追加情報を加えることができます。 同時に、このテーブルにリンクされている他のすべてのテーブルも、その恩恵を受けることになります。それでも、データベース全体を書き直す必要はありません。 このことが持つ意味の大きさを、まだ十分に実感できていないかもしれません。 しかし、SQLを使い始めれば、データベースを拡張したり、異なる種類の情報の間にリレーショナルな仕組みを構築したりする際に、SQLが大いに役立つことがすぐにわかるでしょう。
では、データベース内で重複データが発生する可能性があるという問題は、どうすれば解決できるのでしょうか。 これはとても簡単です。 テーブルを作成する際に、特定の値を含めてはならない、あるいは値を重複させてはならないという条件を指定します。 たとえば、上記のコードを修正し、各列にNULL値が含まれないようにしてみましょう。 さらに、同じ列内で銘柄名が複数のレコードに重複して現れることも避けたいと考えています。 したがって、修正後のコードは次のようになります。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY NOT NULL,
06.     symbol TEXT NOT NULL UNIQUE
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT NOT NULL,
12.     price NUMERIC NOT NULL,
13.     fk_id INTEGER NOT NULL,
14.     FOREIGN KEY (fk_id) REFERENCES tb_Symbol (id)
15. );
SQLiteのコード
さて、このスクリプトを実行すると、上記の説明どおり、2つのテーブルが期待どおりに作成されていることが確認できます。 しかし、以前とは異なり、今度は重複するレコードが発生しなくなります。 レコードを重複させようとしても、SQLはそれを許可しません。 同様に、テーブルにはNULL値も含まれなくなります。 この処理を実現するコードが非常にシンプルで分かりやすいことにも注目してください。
最後のスクリプトを理解する方法
新しい内容に進む前に、最後のスクリプトがどのように機能するのかを理解しておくことが非常に重要です。 ここで何が起きているのかを、しっかり理解する必要があります。 そうしなければ、まったく理解できなくなってしまうでしょう。 そこで、上記に示した最後のSQLスクリプトを実行すると、DB Browserには次のような結果が表示されます。
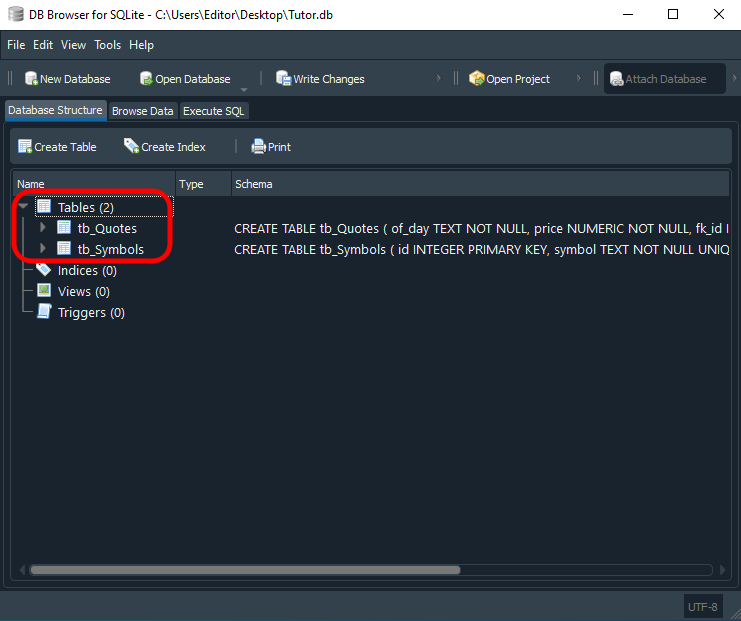
ここでは、表示されている2つのテーブルを強調表示しています。 では、実際にはどのように使うのでしょうか。 何か複雑なことで、コンピュータ技術に精通した達人にしかできないように思えるかもしれません。 しかし、そんなことはありません。 このスキーマを使うこと自体は、思っているより簡単です。 スクリプトを使ってテーブルに情報を追加する方法については、すでに説明しました。 これは、SQLに関する以前の記事で取り上げた内容です。 ここでは、これまでに見てきたものと非常によく似た方法を使います。
実際にどのように処理が進むのかを確認するため、この種のモデリングとのやり取りを示す例として、いくつかのデータを追加してみましょう。 また、基本的なSELECTコマンドについてもすでに説明したので、ここでも利用できます。 ただし、その前に、まずデータベースにいくつかのレコードを追加しましょう。 上記のスクリプトを、それとは少し異なる別のスクリプトに置き換えてみます。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. DROP TABLE IF EXISTS tb_Quotes;
04. DROP TABLE IF EXISTS tb_Symbols;
05.
06. CREATE TABLE IF NOT EXISTS tb_Symbols
07. (
08.     id INTEGER PRIMARY KEY,
09.     symbol TEXT NOT NULL UNIQUE
10. );
11.
12. CREATE TABLE IF NOT EXISTS tb_Quotes
13. (
14.     of_day TEXT NOT NULL,
15.     price NUMERIC NOT NULL,
16.     fk_id INTEGER NOT NULL,
17.     FOREIGN KEY (fk_id) REFERENCES tb_Symbols(id)
18. );
19.
20. INSERT INTO tb_Symbols (id, symbol) VALUES(1, 'BOVA11');
21. INSERT INTO tb_Symbols (id, symbol) VALUES(3, 'PETR4');
22. INSERT INTO tb_Symbols (id, symbol) VALUES(2, 'WDOQ23');
23. INSERT INTO tb_Symbols (id, symbol) VALUES(4, 'VALE3');
24. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('17-07-2023', 12.90, 4);
25. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('14-07-2023', 118.12, 2);
26. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('13-07-2023', 119.53, 1);
27. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('12-07-2023', 117.45, 2);
28. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('11-07-2023', 119.30, 3);
29. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('10-07-2023', 120.59, 1);
30.
31. SELECT * FROM tb_Quotes;
SQLiteのスクリプト
これを見て、「なんて複雑なコードなんだ。自分には到底理解できそうにない。 もう諦めて、すべて別の方法でやろう」と思っているかもしれません。 でも、ここでお伝えしたいことがあります。今、諦めてしまうのですか。 まさに今、すべてが面白くなってきたところなのに。 実際のところ、上記のコードには複雑な点は何もありません。 コードに含まれる内容はすべて、SQL言語の使い方について説明してきたこの初期段階ですでに解説しています。
おそらく、少し混乱する可能性があるのは03行目と04行目でしょう。ここでは、tb_Quotesテーブルとtb_Symbolsテーブルが存在する場合、それらを削除するようSQLに指示しています。 しかし、まだ使う前なのに、なぜテーブルを削除するのでしょうか。 そして、そもそもなぜ削除する必要があるのでしょうか。 テーブルをそのまま残して、データベースに新しいデータを追加するだけではいけないのでしょうか。
これらの疑問に対する答えは、どれも同じです。 テーブルを削除する必要があるのは、20行目から29行目までの間で、これらのテーブルに値を追加するからです。 しかし、この同じスクリプトを実行するたびに、テーブルに値を追加する際、SQLはエラーを報告します。 このエラーが発生するのは、まさにデータベース内の特定のフィールドで値を重複させることができないためです。
このスクリプトを実行すると、次のような結果が得られます。
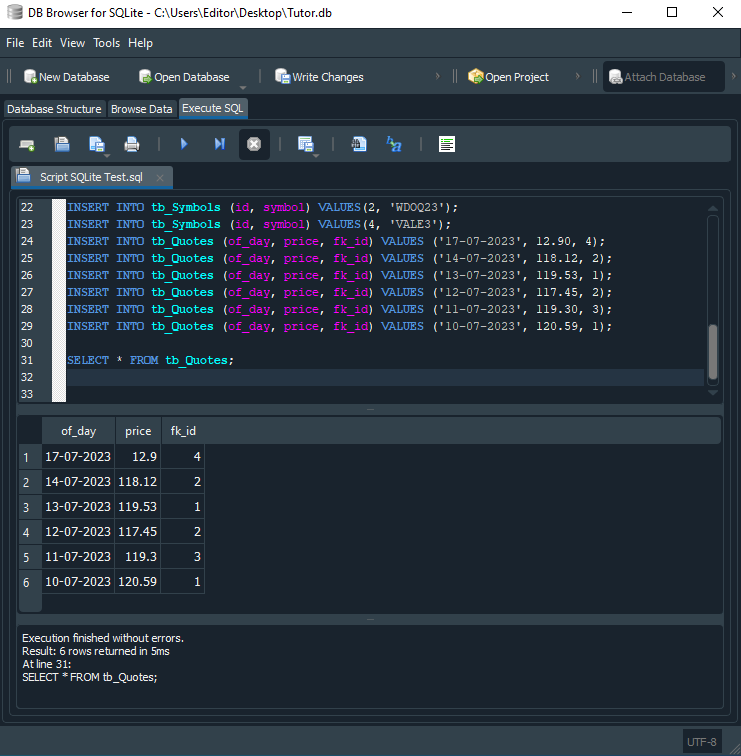
ここで得られる結果は、tb_Quotesテーブルの内容そのものであることに注意してください。 これは、31行目でSQLにこの情報を返すよう指示しているためです。 しかし、この結果を見ると、少し気が滅入るかもしれません。 さまざまな銘柄の気配値を収録した非常に大規模なデータベースを扱う場合、クエリの結果には銘柄名も、データベース内で何を探しているのかをよりよく理解するためのその他の情報も含まれていません。そのため、それぞれのデータがどの銘柄のものなのかを把握するのが難しくなります。 しかし、31行目でSELECTコマンドを使用している箇所のコードを少し変更するだけで、この問題をどのように改善できるかがすぐにわかるでしょう。
まとめ
SQLの学習をあきらめ、やめてしまおうと決める前に、ここで扱っているのは、まだ最も基本的な要素だけであることを改めてお伝えしておきます。 SQLには、まだ紹介していない機能もあります。 それらを理解すれば、SQLが想像以上に実用的なものであることがわかるでしょう。 もっとも、開発は進めながら変化していくものなので、最終的には、現在の取り組みの方向性を変えることになるかもしれません。 SQLを使ってさまざまなものを作る方法についても、もう少し紹介していく予定です。これらは、皆さんにとって本当に重要で、役に立つ知識だからです。 プログラマーや開発者のコミュニティ全体よりも自分のほうが優れていると考えるだけでは、時間と機会を無駄にするだけです。 ご安心ください。この先は、さらに興味深い内容になっていきます。
先ほど述べたように、SQLiteを使うのか、それとも別のSQL実装を使うのか、私はまだ決めかねています。 これは、レプリケーション/シミュレーションシステムに必要な要素の開発が、完全に流動的なプロセスだからです。 今後、実際にどの方向へ進むのかは、まだ決まっていません。 しかし、今後どのような展開になろうとも、次にMQL5を再び取り上げる際には、さまざまな課題を解決するために、間違いなくSQLを活用することになるでしょう。 SQLで実現でき、SQLが助けとなる処理を行うために、独自のルーチンプロシージャを作成するつもりはありません。 ただし、実際にSQLをどのように活用するかについては、まだ最終的な結論には至っていません。
次の記事では、SQLでほかの操作を行う方法について見ていきます。 今や、ようやく本格的に話が進み始めたところです。そして、これから検討し、解説していく内容も、すでにほぼ完全に決まっています。 ただし、これらの記事はSQLの講座ではないということを、強調しておきたいと思います。 私がしたいのは、将来役立つかもしれないポイントをいくつか紹介することにすぎません。SQL自体でできることを、わざわざMQL5やその他の言語で行う意味はないからです。 そして、ここで話しているのは、データベースの作成や保守だけではありません。 プログラミングそのものについて話しているのです。
多くの人は、SQLコマンドをほんの少ししか知らず、それらを忘れてしまったり、この分野の知識を深めることに十分な関心を持たなかったりしています。その結果、本当に強力なツールを活用する機会を逃しています。というのも、SQLと連携する言語を使って作成される処理の多くは、SQLで直接実行できるからです。こうした処理を実行する方法を知っていれば、自分の開発作業に大いに役立つでしょう。 そして、そうしたことを行う方法を知っておけば、開発作業において大いに役立つでしょう。 ですから、このテーマについて、ぜひさらに知識を深めてください。 これらの記事はあくまでガイドとして活用し、唯一の情報源、あるいは決定版と考えないでください。 皆さんにハグを。次の記事でお会いしましょう。
| ファイル | 説明 |
|---|---|
| Experts\Expert Advisor.mq5 | Chart TradeとEAの連携を示します。操作にはMouse Studyが必要です。 |
| Indicators\Chart Trade.mq5 | 送信する注文を設定するためのウィンドウを作成します。操作にはMouse Studyが必要です。 |
| Indicators\Market Replay.mq5 | 市場のレプリケーション/シミュレーションサービスを操作するためのコントロールを作成します。操作にはMouse Studyが必要です。 |
| Indicators\Mouse Study.mq5 | グラフィカルなコントロールとユーザーとの対話を実現します。市場のレプリケーションシステムと実際の市場の両方で必要です。 |
| Services\Market Replay.mq5 | 市場のレプリケーション/シミュレーションサービスを作成し、管理します。システム全体の中核となるファイルです。 |
| Code VS C++\Servidor.cpp | C++で開発されたサーバーソケットを作成し、管理します(ミニチャット版)。 |
| Code in Python\Server.py | MetaTrader 5とExcelの間で通信するためのPythonソケットを作成し、管理します。 |
| Indicators\Mini Chat.mq5 | インジケータを通じてミニチャットを実装できるようにします。サーバーが必要です。 |
| Experts\Mini Chat.mq5 | EAを通じてミニチャットを実装できるようにします。サーバーが必要です。 |
| Scripts\SQLite.mq5 | MQL5でSQLスクリプトを使用する方法を実演します。 |
| Files\Script 01.sql | 外部キーを持つシンプルなテーブルの作成方法を示します。 |
| Files\Script 02.sql | テーブルへの値の追加方法を示します。 |
参考資料
MetaQuotes Ltdによりポルトガル語から翻訳されました。
元の記事: https://www.mql5.com/pt/articles/12986
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。
 初級から中級まで:オブジェクト(II)
 初級から中級まで:オブジェクト(I)
 取引におけるニューラルネットワーク:高精度分類のための効果的な特徴抽出(オブジェクトの実装)
 取引におけるニューラルネットワーク:データ固有の依存性なしに時系列を一般化する(結論)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索