

Neuronale Netze im Handel: Generalisierung von Zeitreihen ohne Abhängigkeit von spezifischen Datensätzen (Fazit)
 21
 1

Einleitung
Die Finanzmärkte sind ein lebendiger Organismus. Ihr Rhythmus wird von Millionen von Trades, Hunderten von Wirtschaftsberichten und einem ständigen Nachrichtenstrom bestimmt. In einem solchen Umfeld profitieren vor allem diejenigen, die nicht nur schnell reagieren, sondern auch vorhersehen können, wann sich Trends ändern werden. Genau aus diesem Grund wurde Mamba4Cast entwickelt – ein Framework zur Prognose von Zeitreihen, das von den neuesten Entwicklungen in der Architektur neuronaler Netze inspiriert und auf die Besonderheiten hochfrequenter Sequenzen zugeschnitten ist.
Wir sind nun in der letzten Phase unserer Einführung in dieses Framework angelangt. Zunächst haben wir das theoretische Framework und den allgemeinen Ansatz zur Feature-Verarbeitung untersucht. Im zweiten Teil haben wir uns eingehender mit der Mechanik befasst. Lassen Sie uns nun alles zusammenführen, um zu zeigen, dass das Modell nicht nur auf dem Papier existiert, sondern auch in einem realen Marktumfeld funktioniert.
Das Framework selbst ist als Kette von Modulen aufgebaut, von denen jedes eine bestimmte Funktion erfüllt. Der erste Block ist für die Feature-Extraktion zuständig. Hier verarbeitet das Modell die Rohdaten: Eröffnungskurs, Schlusskurs, Hoch/Tief und Volumen. Sie alle durchlaufen eine kompakte Schicht, die lokale Muster erkennt. Man könnte sagen, sie ist wie das geschulte Auge eines Traders, das inmitten des Chaos des Charts Muster erkennt.
Als Nächstes folgen die Faltungsschichten. Diese Blöcke fungieren als Marktfilter, indem sie stabile Signale extrahieren und Rauschen herausfiltern. Volatilitätsspitzen, nachlassende Trends und sich abzeichnende Konsolidierungsphasen – all dies wird erkannt und verarbeitet. In diesem Fall kommt eine Mehrfenster-Architektur zum Einsatz, bei der jede Faltung auf unterschiedliche Zeithorizonte abzielt. Auf diese Weise lernt das Framework, sowohl kurzfristige Schwankungen als auch längere Schwingungszyklen gleichzeitig zu erfassen.
Das Kernmodul – SSM (State-Space-Modell) – stellt Langzeitgedächtnis-Fähigkeiten bereit. Dies ist besonders bei Finanzdaten von Bedeutung, bei denen sich Muster oft nicht sofort, sondern erst über einen Zeitraum von Dutzenden Bars hinweg abzeichnen. Beispielsweise kann eine Reihe von Fehlausbrüchen in einer starken Impulsbewegung gipfeln – und das Modell muss auf ein solches Szenario vorbereitet sein. Gerade dank des SSM kann das Modell den Kontext beibehalten und auch bei Marktunsicherheit fundierte Prognosen aufrechterhalten.
Was Mamba4Cast besonders wertvoll macht, ist sein Prognosemechanismus über den gesamten Planungshorizont hinweg. Dies entspricht den Herausforderungen, denen Trader in der Praxis gegenüberstehen. Dieser Ansatz lässt sich mit dem Verhalten eines Autofahrers vergleichen: Er behält die Straße direkt vor sich im Blick, schaut aber gleichzeitig weit nach vorn und schätzt den Verkehrsfluss ein. Dieser Hybridmodus führt zu einer stabileren und umfassenderen Handlungsstrategie.
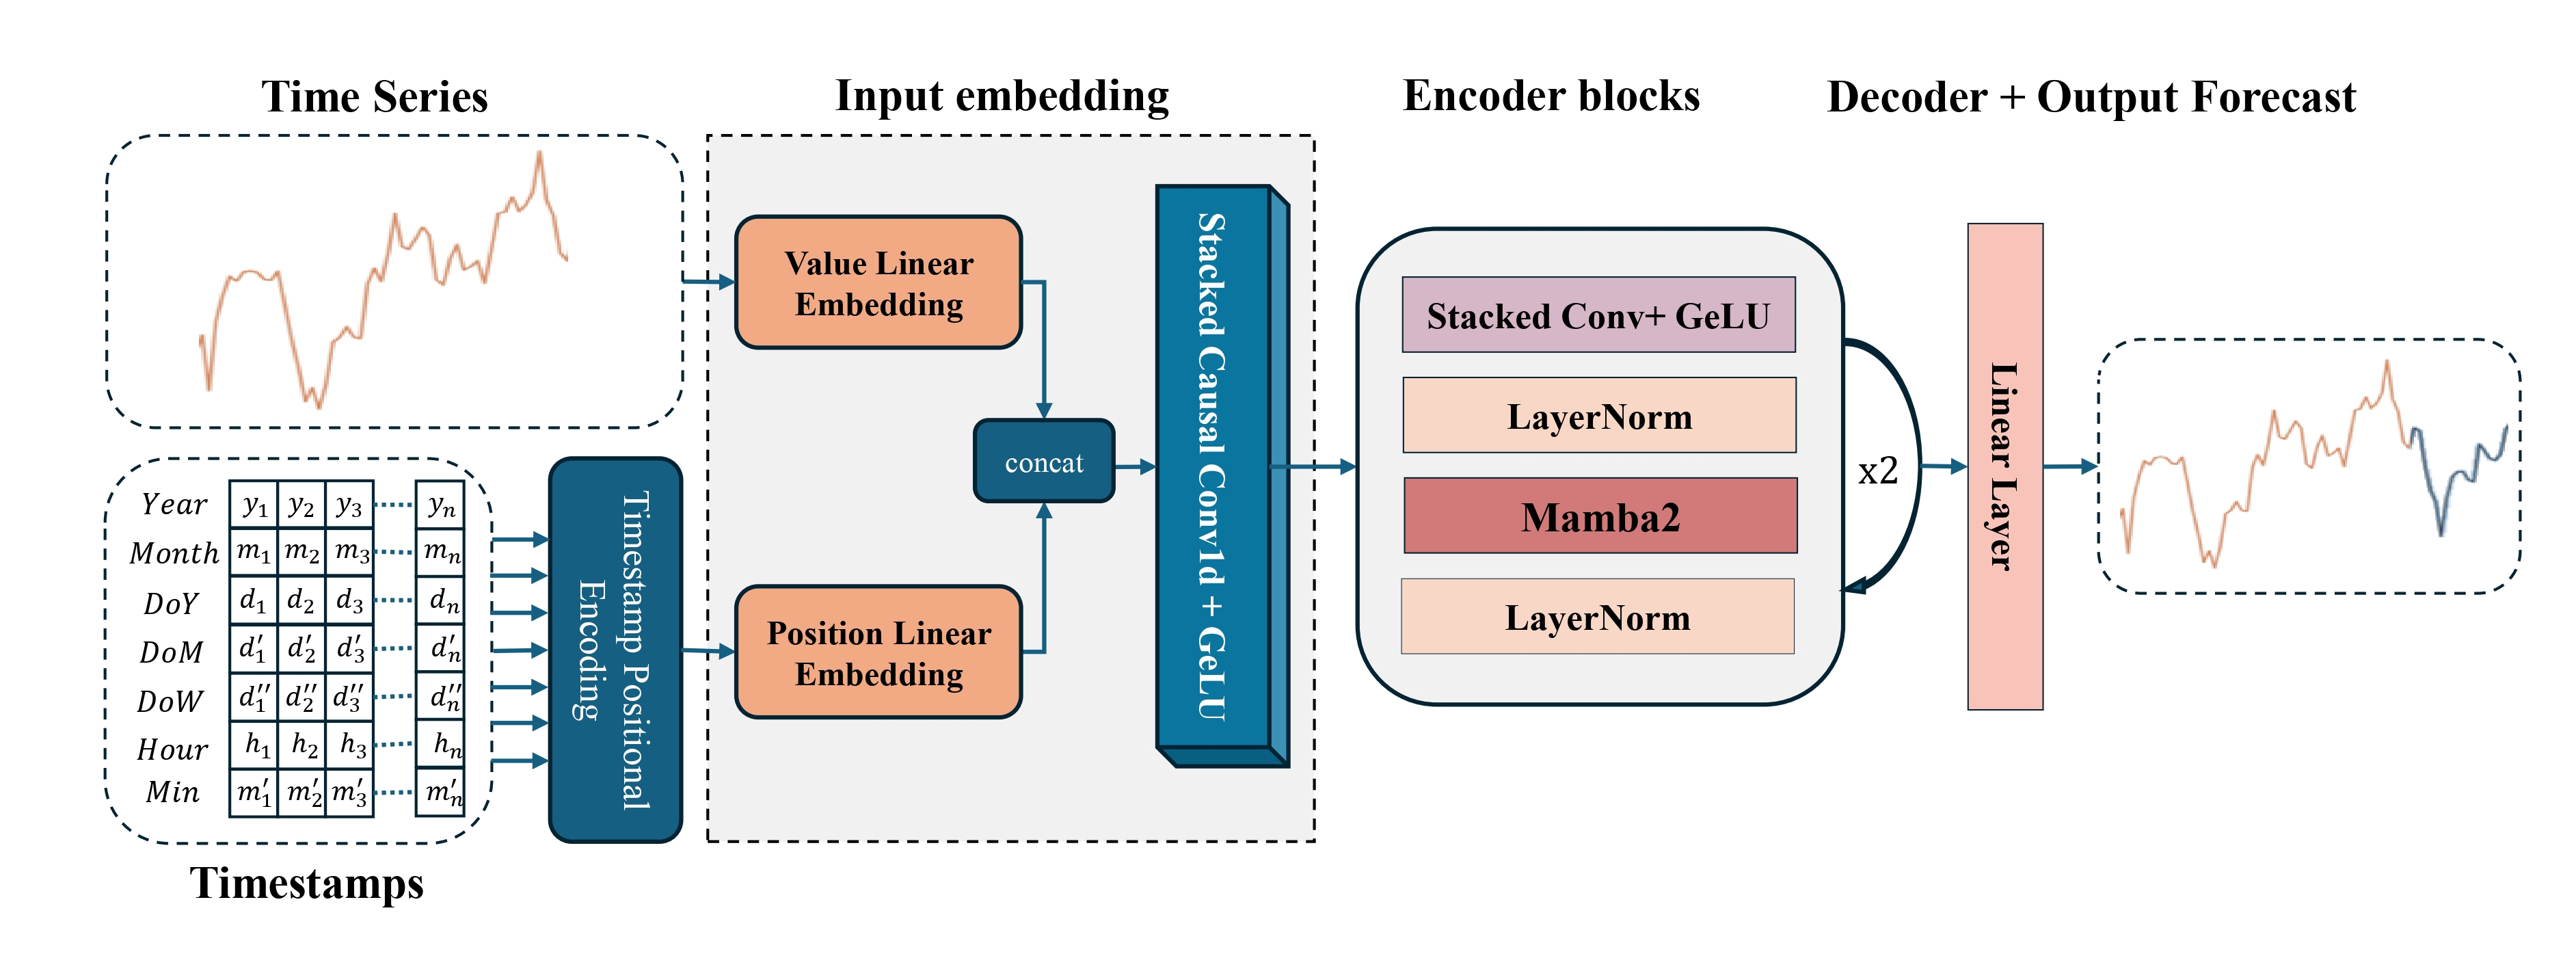
In diesem Artikel sehen Sie die endgültige Form des Modells: seine Architektur, die Trainingsprozesse und die Ergebnisse aus der Praxis. Wir werden aufzeigen, wie Theorie und Praxis zusammenwirken und wie aus einem abstrakten Modell ein praktisches Instrument zur Marktanalyse wird.
Modellarchitektur
Heute beginnen wir damit, die Architektur eines trainierbaren Modells aufzubauen – eines vollwertigen Trading-Agenten, der in der Lage ist, Entscheidungen zu treffen und Trades in Echtzeit auszuführen. Genau wie ein Trader, der die aktuelle Marktsituation sorgfältig analysiert, das Kursverhalten, das Handelsvolumen und die Marktstimmung bewertet – und erst dann entscheidet, ob er eine Position eingeht –, muss auch unser Agent in der Lage sein, den Markt zu sehen und zu verstehen, anstatt blind Signalen zu folgen. Deshalb beschränken wir uns nicht darauf, einen einzigen zukünftigen Kurs vorherzusagen – unser Ziel ist ehrgeiziger: Wir wollen ein Modell entwickeln, das Muster im Marktverhalten erkennt, auf sich rasch ändernde Bedingungen reagiert und sich an verschiedene Phasen des Marktzyklus anpasst.
In diesem Zusammenhang wird das Mamba4Cast-Framework als eine der Schlüsselkomponenten des Gesamtsystems implementiert – der Environment-State-Encoder. An dieser Stelle nimmt die Marktwahrnehmung des Modells Gestalt an und verwandelt eine Reihe von Zahlen in ein aussagekräftiges Bild des Marktgeschehens.. Der Encoder fungiert dabei als eine Art Trading-Auge für den Agenten und ist darauf trainiert, wesentliche Bewegungen, verborgene Muster und potenzielle Einstiegspunkte zu erkennen, lange bevor diese im Chart bestätigt werden.
In diesem Artikel folgen wir weiterhin dem Actor-Director-Critic-Lern-Framework. Das System, das wir trainieren, umfasst vier Schlüsselmodelle, von denen jedes für einen bestimmten Aspekt der Entscheidungsfindung beim Trading zuständig ist:
- Environment-State-Encoder – die Augen des Agenten – generiert Marktzustands-Embeddings;
- Actor (Actor) – ein Modell, das auf Grundlage des erhaltenen Embeddings konkrete Handelsaktionen vorschlägt;
- Director (Director) – ein Modell, das die vom Actor vorgeschlagenen Aktionen als gut oder schlecht einstuft, den Lernprozess steuert und fehlerhafte Entscheidungen verhindert;
- Critic (Critic) – bewertet den Wert der Aktionen des Actors im Kontext des Marktzustands und erzeugt ein Feedback-Signal zur Strategieoptimierung.
Die Architektur aller Modelle wird mithilfe der Methode CreateDescriptions definiert, der vier Zeiger auf dynamische Arrays als Parameter übergeben werden. In diese Arrays werden die Schichtbeschreibungen und Parameter für jedes der aufgeführten Modelle – vom Encoder bis zum Critic – nacheinander geschrieben, was eine flexible Steuerung der Struktur ermöglicht und die Anpassung des Frameworks an neue Anforderungen erleichtert.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Im Rumpf der Methode CreateDescriptions wird zunächst die Gültigkeit der übergebenen Zeiger auf die vier dynamischen Arrays überprüft. Falls erforderlich, werden neue Objekte angelegt, um sicherzustellen, dass die Architekturbeschreibung später korrekt geschrieben werden kann, ohne dass die Gefahr von Speicherkonflikten besteht.
Als Nächstes wenden wir uns der Beschreibung der Architektur des Environment-State-Encoder zu. Für die Eingabedaten verwenden wir zunächst eine ausreichend große voll verbundene Schicht. Wir verwenden Rohdaten – ohne jegliche Vorverarbeitung – direkt aus dem Handelsterminal: Eröffnungs- und Schlusskurse, Hoch/Tief, Volumina sowie die Werte der technischen Indikatoren.
Da diese Daten unterschiedliche statistische Eigenschaften und Skalen aufweisen, müssen ihre Verteilungen angeglichen werden, um den Modelltrainingsprozess zu stabilisieren. An dieser Stelle kommt die Batch-Normalisierungsschicht ins Spiel. Sie transformiert die Eingabevektoren so, dass jedes Feature einen Mittelwert nahe null und eine Varianz nahe 1 aufweist, was eine schnellere Konvergenz begünstigt und die Trainingsstabilität verbessert. Anstelle der Standardimplementierung verwenden wir eine modifizierte Version: eine Normalisierungsschicht mit zusätzlichem Rauschen. Dieser Ansatz trägt dazu bei, die Generalisierungsfähigkeit des Modells zu verbessern, indem die Vielfalt der Trainingsdaten künstlich erhöht wird.
Am Ausgang dieses Stacks erhält der Encoder standardisierte Features, die für die weitere Verarbeitung bereit sind.//--- Encoder encoder.Clear(); //--- Input layer if(!(descr = new CLayerDescription())) return false; descr.type = defNeuronBaseOCL; int prev_count = descr.count = (HistoryBars * BarDescr); descr.activation = None; descr.optimization = ADAM; if(!encoder.Add(descr)) { delete descr; return false; } //--- Layer 1 if(!(descr = new CLayerDescription())) return false; descr.type = defNeuronBatchNormWithNoise; descr.count = prev_count; descr.batch = 1e4; descr.activation = None; descr.optimization = ADAM; if(!encoder.Add(descr)) { delete descr; return false; }
Als Nächstes generieren wir Zeitschritt-Embeddings mithilfe des Moduls CMamba4CastEmbedding. An dieser Stelle werden die Feature-Vektoren um die harmonische Komponente zweier wichtiger Zeitintervalle erweitert – H1 (stündlich) und D1 (täglich). Durch Hinzufügen von Sinus- und Kosinusanteilen erhält das Modell Informationen über typische stündliche Schwankungen und wiederkehrende Tagesrhythmen. Auf diese Weise kann der Agent typische Marktzyklen berücksichtigen – Aufwärmphasen am Morgen, Trends im Tagesverlauf und Flauten am Abend.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = BarDescr;
   int prev_out = descr.window_out = NSkills;
     {
      int temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die Verwendung eines Mehrfenster-Faltungsblocks mit drei Faltungsfenstern führt zu reichhaltigeren Einbettungen. Es ist wichtig zu beachten, dass die Faltungen nicht entlang der Zeitachse, sondern horizontal innerhalb einer einzelnen Bar erfolgen, wobei die Beziehungen zwischen den Features analysiert werden.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.window_out * descr.windows.Size());
In der letzten Phase der Kodierung des Eingangssignals werden wir eine Normalisierungsschicht hinzufügen. Zweck ist es, die Schiefe in der Merkmalsverteilung zu beseitigen, die analysierten Daten homogener zu machen und einen stabilen Betrieb des Modells während des Trainings sicherzustellen. Dieser Schritt trägt dazu bei, Gradientenverzerrungen zu vermeiden und die Konvergenz zu beschleunigen, ohne dass dabei Qualitätseinbußen entstehen.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Nächstes gehen wir direkt zum Aufbau der Encoder-Architektur über. Hier wollen wir mit univariaten Zeitreihen einzelner Features arbeiten. Transponieren wir daher zunächst unseren Feature-Tensor.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   prev_out = descr.count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Es ist jedoch anzumerken, dass es sich bei den Features, mit denen wir es hier zu tun haben, nicht mehr um dieselben Features handelt, die wir zuvor vom Terminal erhalten haben. Zu diesem Zeitpunkt hat sich ein völlig anderer Satz angereicherter Features herausgebildet, von denen jedes einen bestimmten Ausschnitt der zuvor vom Terminal erhaltenen Bar-Beschreibung darstellt.
Der Mamba4Cast-Encoder-Block besteht aus einem Stapel von Faltungsoperationen und einem SSM-Modul. Zwischen den Modulen ist eine Normalisierungsschicht integriert, um die Features aneinander auszurichten. Im Stapel von Faltungsoperationen verwenden wir Faltungsmodule mit mehreren Fenstern. Hier konzentriert sich jeder Filter auf sein eigenes Zeitfenster und identifiziert die entsprechenden Marktmuster. Um die Dimensionalität der Daten zu erhalten, wird nach jedem Multi-Fenster-Faltungsmodul eine Max-Pooling-Schicht angewendet; diese Schicht wählt den maximalen Filterwert in jedem Fenster aus und reduziert so die räumlichen Dimensionen, ohne die Merkmalstiefe zu verändern.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   int filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 10
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Beim SSM haben wir uns gegen das ursprüngliche Mamba2 entschieden, das von den Autoren des Mamba4Cast-Frameworks vorgeschlagen wurde, und stattdessen das Chimera-Modul gewählt, das eine Datenanalyse in einer zweidimensionalen Ebene ermöglicht und es uns erlaubt, Kreuzabhängigkeiten zwischen zeitlichen und räumlichen Komponenten zu berücksichtigen.
//--- layer 11
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronChimera;
//--- Window
     {
      int temp[] = {prev_out, prev_out/2}; //In, Out
      if(ArrayCopy(descr.windows, temp) < int(temp.Size()))
         return false;
     }
//--- Units
     {
      int temp[] = {prev_count, prev_count*2}; //In, Out
      if(ArrayCopy(descr.units, temp) < int(temp.Size()))
         return false;
     }
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.windows[1];
   prev_count=descr.units[1];
//--- layer 12
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Das Modul endet mit einer Batch-Normalisierungsschicht. Wir haben die Vorteile dieses Ansatzes bereits weiter oben erörtert.
Die Architektur unseres Encoders umfasst zwei aufeinanderfolgende Blöcke, die jeweils aus einem Faltungsstapel mit mehreren Fenstern, einer Max-Pooling-Schicht und einem auf Chimera, das auf SSMModul basiert, bestehen, wodurch eine schrittweise Anreicherung der Merkmale und die Erhaltung des Kontexts gewährleistet werden.
//--- layer 13
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 14
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 15
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronMultiWindowsConvWPadOCL;
   descr.step = 3;
   descr.count = (prev_out + descr.step - 1) / descr.step;
   filt=descr.window_out = 5;
     {
      int temp[] = {3, 5, 7};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers = prev_count;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = int(descr.count * descr.windows.Size());
//--- layer 16
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronProofOCL;
   descr.count = prev_count * prev_out;
   descr.window = filt;
   descr.step = filt;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 17
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 18
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronChimera;
//--- Window
     {
      int temp[] = {prev_out, prev_out/2}; //In, Out
      if(ArrayCopy(descr.windows, temp) < int(temp.Size()))
         return false;
     }
//--- Units
     {
      int temp[] = {prev_count, prev_count*2}; //In, Out
      if(ArrayCopy(descr.units, temp) < int(temp.Size()))
         return false;
     }
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.windows[1];
   prev_count=descr.units[1];
//--- layer 19
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count*prev_out;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Decoder für die unabhängige Prognose univariater Zeitreihen über den gesamten Prognosehorizont verwenden wir zwei aufeinanderfolgende Faltungsschichten. SoftPlus wird zwischen ihnen platziert, um die erforderliche Nichtlinearität bereitzustellen. Am Ausgang des Dekoders wird die hyperbolische Tangente (tanh) angewendet, da ihr Wertebereich der normierten Datenskala entspricht, was dazu beiträgt, die Konsistenz zwischen der Eingabe und der Ausgabe des Modells zu gewährleisten.
//--- layer 20
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = 4 * NForecast;
   descr.layers = prev_count;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 21
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = NForecast;
   descr.layers = prev_count;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
An dieser Stelle sei jedoch angemerkt, dass wir zuvor den Tensor der analysierten Features transponiert haben, um auf die Arbeit mit univariaten Zeitreihen umzustellen. Daher müssen die Decoder-Ergebnisse, bevor sie weitergeleitet werden, durch eine inverse Transposition wieder in ihre ursprüngliche Form zurückgeführt werden.
//--- layer 22
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   prev_out = descr.count;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Der nächste Schritt bei der Wiederherstellung der Datenstruktur besteht darin, die Dimensionalität zu reduzieren, die bei der Erzeugung der Embeddings erhöht wurde. Dies ist erforderlich, um den Ergebnistensor in eine Form umzuwandeln, die mit den Originaldaten kompatibel ist.
//--- layer 23
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.layers = 1;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die letzte Phase in der Arbeitsweise des Encoders ist die Denormalisierung. In diesem Schritt werden die nach allen Transformationen erhaltenen Werte wieder auf die Skala der Originaldaten zurückgeführt, wodurch die Modellausgabe korrekt interpretiert werden kann.
//--- layer 24
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Nächstes wenden wir uns der Beschreibung der Actor-Architektur zu. Sein vorrangiges Ziel besteht darin, den aktuellen Kontozustand und die offenen Positionen im Kontext des analysierten Marktzustands zu bewerten. Auf Grundlage der erhaltenen Informationen formuliert der Actor eine Handelsentscheidung – einen Trade, der potenziell maximale Renditen bei minimalem Risiko erzielen kann.
In diesem Zusammenhang wird dem Actor ein Tensor übergeben, der den aktuellen Kontozustand darstellt. Dieser Tensor enthält aggregierte Informationen über den Kontostand, die Volumina offener Positionen, die Handelsrichtung und weitere Schlüsselparameter, die den finanziellen Zustand des Trading-Agents widerspiegeln.
   CLayerDescription *latent = encoder.At(LatentLayer-1);
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Diese Eingaben werden anschließend mithilfe einer Batch-Normalisierungsschicht verarbeitet, die die Verteilung der Features stabilisiert und den Trainingsprozess des Modells beschleunigt.
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = 1e4;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend wird eine Cross-Attention-Schicht angewendet, wodurch der aktuelle Kontozustand mit dem Marktzustand abgeglichen werden kann. Bei diesem Verfahren wird eine latente Darstellung der Umgebung, die zuvor vom Encoder erzeugt wurde, als Kontext verwendet.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      int temp[] = {AccountDescr,     // Inputs window
                    latent.windows[1] // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      int temp[] = {1,              // Inputs units
                    latent.units[1] // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
In diesem Experiment haben wir einen Stack aus zwei in Reihe angeordneten Cross-Attention-Modulen verwendet. Diese Konfiguration ermöglicht eine tiefere Abstimmung zwischen dem internen Kontozustand und der Marktdynamik und verbessert so die Fähigkeit des Modells, kausale Zusammenhänge zwischen der aktuellen Position und externen Bedingungen zu erkennen.
Es ist wichtig zu verstehen, dass wir für die Cross-Attention-Schicht nicht eine allgemeine Darstellung des aktuellen Umgebungszustands als Kontext verwenden, sondern die latente Darstellung des Encoders, die nach der Verarbeitung des Eingangssignals in Form von Embeddings einzelner univariater Feature-Zeitreihen entstanden ist. Einfach ausgedrückt: Der Encoder (ein Block innerhalb des Environment-State-Encoder-Modells) wandelt jedes Feature in einen eigenen kompakten Sensitivitätsvektor um, und genau diese Vektoren werden als Kontext in das Cross-Attention-Modul eingespeist.
Stellen Sie sich das Cross-Attention-Modul als Dirigenten vor. Es hat die Melodien der einzelnen Instrumente (Feature-Embeddings) und die Partitur des aktuellen Kontostands vor sich. Der Dirigent entscheidet, welche Instrumente in diesem Moment lauter spielen sollen – also welche Features für eine Entscheidung am wichtigsten sind – und hebt genau diese besonders hervor.
Dadurch vergleicht der Cross-Attention-Mechanismus verborgene Marktmuster mit der aktuellen Position und wählt Signale aus, die helfen, effektive Handelsentscheidungen zu treffen.
Die Ergebnisse der Kontextanalyse durchlaufen drei voll verbundene Schichten (MLP), von denen jede die Darstellung der Zielaktion schrittweise verfeinert. Am Ausgang der letzten Schicht entsteht eine Handelsentscheidung – eine konkrete Empfehlung, eine Position unter Berücksichtigung des aktuellen Kontozustands und der Marktbedingungen zu eröffnen, zu halten oder zu schließen.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = 1e4;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = 1e4;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Die Modelle Director und Critic haben eine ähnliche Architektur: Sie analysieren den vom Actor vorgeschlagenen Aktionstensor im Kontext des aktuellen Marktzustands. Diese Modelle erzeugen eine entsprechende Bewertung – Zustimmung oder Ablehnung der vorgeschlagenen Aktion aus strategischer und risikobezogener Sicht.
Ich schlage vor, die detaillierte Implementierung der Architekturen dieser Komponenten Ihrer eigenen Erkundung zu überlassen. Der vollständige Quellcode, der die Architektur aller trainierten Modelle – einschließlich des Director und des Critic – beschreibt, ist im Anhang enthalten.
Modelltraining
Nachdem wir nun die Architektur der Modelle betrachtet haben, wollen wir direkt zur Trainingsphase übergehen. An dieser Stelle ist es wichtig zu beachten, dass die Autoren des Mamba4Cast-Frameworks synthetische Zeitreihen verwendet haben, um ihre Modelle zu testen und zu trainieren. Dieser Ansatz bietet eine Reihe von Vorteilen, insbesondere bei der Entwicklung und Fehlerbehebung von Deep-Learning-Architekturen.
Erstens ermöglichen synthetische Daten eine vollständige Kontrolle über die Datenparameter: Sie können Amplitude, Frequenz, Trends, Saisonalität und Rauschpegel im Voraus festlegen und sogar seltene oder anomale Ereignisse einbeziehen. Dies ermöglicht es, gezielt zu testen, wie das Modell auf verschiedene Eigenschaften von Zeitreihen reagiert, und hilft dabei, seine Schwachstellen in einer streng kontrollierten Umgebung zu erkennen.
Zweitens eliminieren künstlich generierte Zeitreihen den Einfluss von unsauberen oder unvollständigen Daten, was insbesondere in den frühen Phasen des Trainings von Bedeutung ist. Im Gegensatz zu realen Marktdaten weisen synthetische Daten keine Lücken, Erfassungsartefakte oder Verzerrungen auf, die tatsächliche Modellfehler verschleiern könnten.
Der dritte Vorteil ist die Skalierbarkeit. Die Generierung synthetischer Daten macht die Erfassung und Speicherung historischer Daten überflüssig und ermöglicht es, schnell Trainingsdatensätze in der erforderlichen Größe für Aufgaben beliebiger Komplexität zu erstellen. Dies ist insbesondere bei der Verwendung ressourcenintensiver Modelle von Bedeutung, die eine vielfältige und ausgewogene Trainingsumgebung erfordern.
Schließlich sind synthetische Daten ein zuverlässiges Instrument für Stresstests. Wir können extreme Marktsituationen simulieren, ohne darauf warten zu müssen, dass sie in der Realität eintreten. Solche Szenarien ermöglichen es, die Robustheit des Modells gegenüber unerwarteten Schwankungen zu testen.
Andererseits ist der reale Markt kein steriles Labor, sondern eher eine stürmische See, in der die Regeln oft spontan festgelegt werden. Genau aus diesem Grund ist es trotz aller Vorteile synthetischer Daten ein einseitiger und potenziell gefährlicher Weg, ein Modell ausschließlich anhand synthetischer Daten zu trainieren und zu validieren.
Erstens enthalten reale Marktdaten stets Rauschen, Lücken, nicht offensichtliche Korrelationen und „unsaubere“ Bereiche – Elemente, die in einer künstlich geschaffenen Umgebung nicht vorkommen. Ein Modell, das nicht auf solche Features trainiert wurde, könnte bei seiner ersten Begegnung mit der Realität ins Straucheln geraten – insbesondere bei wenig liquiden Assets oder in Phasen hoher Volatilität.
Zweitens unterliegt der Markt dem Überraschungseffekt: Nachrichten, Sanktionen, Fusionen, geopolitische Entwicklungen und das Verhalten wichtiger Akteure – all diese Faktoren beeinflussen die Kurse, doch es ist praktisch unmöglich, sie anhand synthetischer Daten zuverlässig zu modellieren. Hier ist es besonders wichtig, dass sich das Modell anpassen kann und unter Bedingungen unvollständiger Informationen funktioniert.
Drittens erzeugen die Verhaltensmuster der Marktteilnehmer (von Angst bis Gier) eine einzigartige Dynamik, die sich mit Generatoren nur schwer nachbilden lässt. Ein Modell, das solchen Mustern nicht ausgesetzt war, läuft Gefahr, sich an eine „saubere“ Umgebung überanzupassen und dadurch wichtige Signale im realen Trading nicht zu erkennen.
Genau aus diesem Grund gilt ein hybrider Ansatz als am effektivsten: In den frühen Phasen werden synthetische Daten verwendet – zur Kalibrierung der Architektur, zur Auswahl der Hyperparameter und zur Fehlerbehebung beim Training. Anschließend werden reale Daten herangezogen, um das Modell für den Einsatz unter realen Bedingungen zu trainieren und ihm beizubringen, Fehler zu machen, sich anzupassen und in einem instabilen Umfeld Entscheidungen zu treffen.
Derzeit steht uns kein vollwertiger Generator für synthetische Finanzsequenzen zur Verfügung. Aber wie heißt es so schön: Wenn der Berg nicht zu Mohammed kommt …
Für die erste Trainingsphase werden wir versuchen, uns den Eigenschaften synthetischer Daten durch die Vorverarbeitung realer historischer Daten anzunähern. Wie bereits erwähnt, enthalten synthetische Zeitreihen in der Regel keine Artefakte, Lücken oder anderes Marktrauschen. Um bei den realen Daten ein ähnliches Maß an Sauberkeit zu erreichen, werden wir auf jedes der analysierten Features einen einfachen gleitenden Durchschnitt mit einem kurzen Zeitfenster anwenden. Dadurch können wir:
- lokale Anomalien und starke Ausschläge ausgleichen,
- die Auswirkungen vereinzelter Ausreißer abmildern,
- die Robustheit des Modells während der Trainingsphase verbessern.
Es ist wichtig zu beachten, dass wir bewusst ein kleines Mittelungsfenster wählen, um die Dynamik und Form des Signals zu erhalten. Unser Ziel ist es nicht, alles zu einer flachen Kurve zu glätten, sondern lediglich das Rauschen zu dämpfen, das das Modell in die Irre führen könnte. Wir werden eine ähnliche Logik im Expert Advisor „…\MQL5\Experts\Mamba4Cast\StudyMA.mq5“ implementieren. In diesem Artikel konzentrieren wir uns ausschließlich auf die Methode „Train“, die den Trainingsprozess des Modells implementiert.
Der Algorithmus beginnt damit, einen Wahrscheinlichkeitsverteilungsvektor zur Auswahl einzelner Trajektorien aus dem Experience-Replay-Puffer zu erstellen.
void Train(void)
  {
//---
   vector<float> probability = vector<float>::Full(Buffer.Size(), 1.0f / Buffer.Size());
In der Anfangsphase werden allen Trajektorien gleiche Wahrscheinlichkeiten zugewiesen, was eine umfassendere Erkundung der gesamten Historie ermöglicht.
Als Nächstes initialisieren wir die lokalen Variablen, die wir zur vorübergehenden Speicherung von Daten während des Trainings der Modelle verwenden werden.
   vector<float> result, target, state;
   matrix<float> fstate = matrix<float>::Zeros(1, NForecast * BarDescr);
   matrix<float> hstate = matrix<float>::Zeros(1, HistoryBars * BarDescr);
   bool Stop = false;
   int average = 5;
//---
   uint ticks = GetTickCount();
Sobald die Vorbereitungsarbeiten abgeschlossen sind, fahren wir mit der Einrichtung der Struktur der Modelltrainingsschleife fort. Die äußere Schleife steuert die Gesamtzahl der Trainingsiterationen.
for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter += Batch)
  {
   int tr = SampleTrajectory(probability);
   int start = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * (Buffer[tr].Total - 2 - NForecast - Batch));
   if(start <= 0)
     {
      iter -= Batch;
      continue;
     }
   if(
      !cEncoder.Clear()
      || !cActor.Clear()
      || !cDirector.Clear()
      || !cCritic.Clear()
   )
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   result = vector<float>::Zeros(NActions);
Hier entnehmen wir dem Experience-Replay-Puffer eine einzelne Trajektorie sowie den Startzustand des Trainingsbatches. Wir setzen den internen Zustand aller Modelle sofort zurück, um den Einfluss irrelevanter Speicherzustände auf die Daten für die neue Trajektorie zu beseitigen. Als Nächstes initialisieren wir eine verschachtelte Modelltrainingsschleife innerhalb des Trainingsbatches.
for(int i = start; i < MathMin(Buffer[tr].Total, start + Batch); i++)
  {
   if(!hstate.Assign(Buffer[tr].States[i].state) ||
      MathAbs(hstate).Sum() == 0 ||
      !hstate.Reshape(HistoryBars, BarDescr))
     {
      iter -= Batch + start - i;
      break;
     }
Im Hauptteil der verschachtelten Schleife laden wir historische Daten, die den analysierten Umgebungszustand beschreiben, aus dem Experience-Replay-Puffer und richten eine Schleife ein, um diese Daten mithilfe eines gleitenden Durchschnitts zu glätten.
for(int h = HistoryBars - 1; h > 0; h--)
  {
   state = vector<float>::Zeros(BarDescr);
   for(int a = MathMax(h - average + 1, 0); a <= h; a++)
      state += hstate.Row(a);
   if(!hstate.Row(state / MathMin(average, h + 1), h))
     {
      iter -= Batch + start - i;
      break;
     }
  }
Wir übertragen die geglätteten Werte in den Datenpuffer, der den analysierten Umgebungszustand beschreibt.
if(!hstate.Reshape(1, HistoryBars * BarDescr) ||
   !bState.AssignArray(hstate.Row(0)))
  {
   iter -= Batch + start - i;
   break;
  }
Beachten Sie außerdem, dass wir, damit das Mamba4Cast-Framework ordnungsgemäß funktioniert, die Zeitstempel für jeden Bar benötigen. In der zuvor erstellten Struktur des Experience-Replay-Puffers wird jedoch für jeden Umgebungszustand nur ein Zeitstempel gespeichert, der dem letzten Bar entspricht. Um den erforderlichen Zeitstempelpuffer zu erstellen, durchlaufen wir die Umgebungszustände aus dem Experience-Replay-Puffer rückwärts, ausgehend vom aktuellen Zustand und bis zur festgelegten Analysetiefe zurück, und sammeln dabei die Zeitstempel.
bTime.Clear();
bTime.Reserve(HistoryBars);
double time = (double)Buffer[tr].States[i].account[7];
for(int t = i; t >= MathMax(0, i - HistoryBars + 1); t--)
   if(!bTime.Add((float)(double)Buffer[tr].States[t].account[7]))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
if(bTime.Total() < HistoryBars)
  {
   float period = MathMin(Buffer[tr].States[i + 1].account[7] - Buffer[tr].States[i].account[7],
                          Buffer[tr].States[i + 2].account[7] - Buffer[tr].States[i + 1].account[7]);
   do
     {
      if(!bTime.Add(bTime[-1] - period))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         Stop = true;
         break;
        }
     }
   while(bTime.Total() < HistoryBars);
  }
if(bTime.GetIndex() >= 0)
   if(!bTime.BufferWrite())
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
Wir werden den Algorithmus zum Füllen des Puffers für die Beschreibung des Kontozustands aus ähnlichen Programmen unverändert übernehmen.
//--- Account
float PrevBalance = Buffer[tr].States[MathMax(i - 1, 0)].account[0];
float PrevEquity = Buffer[tr].States[MathMax(i - 1, 0)].account[1];
float profit = float(bState[0] / _Point * (result[0] - result[3]));
bAccount.Clear();
bAccount.Add(1);
bAccount.Add((PrevEquity + profit) / PrevEquity);
bAccount.Add(profit / PrevEquity);
bAccount.Add(MathMax(result[0] - result[3], 0));
bAccount.Add(MathMax(result[3] - result[0], 0));
bAccount.Add((bAccount[3] > 0 ? profit / PrevEquity : 0));
bAccount.Add((bAccount[4] > 0 ? profit / PrevEquity : 0));
bAccount.Add(0);
double x = time / (double)(D'2024.01.01' - D'2023.01.01');
bAccount.Add((float)MathSin(x != 0 ? 2.0 * M_PI * x : 0));
x = time / (double)PeriodSeconds(PERIOD_MN1);
bAccount.Add((float)MathCos(x != 0 ? 2.0 * M_PI * x : 0));
x = time / (double)PeriodSeconds(PERIOD_W1);
bAccount.Add((float)MathSin(x != 0 ? 2.0 * M_PI * x : 0));
x = time / (double)PeriodSeconds(PERIOD_D1);
bAccount.Add((float)MathSin(x != 0 ? 2.0 * M_PI * x : 0));
if(bAccount.GetIndex() >= 0)
   if(!bAccount.BufferWrite())
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
Nachdem wir die erforderlichen Eingabedaten vorbereitet haben, führen wir für alle Modelle den Vorwärtsdurchlauf durch. Der Environment-State-Encoder führt als Erster einen Vorwärtsdurchlauf durch. Er verwendet geglättete Daten zur Beschreibung des Marktzustands und einen Zeitstempelpuffer.
//--- Feed Forward
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Als Nächstes folgt der Actor. Er analysiert den Kontozustandspuffer und den Umgebungskontext auf Basis des latenten Zustands des Encoders.
if(!cActor.feedForward((CBufferFloat*)GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Wir trainieren den Environment-State-Encoder, damit er nachfolgende Zustände vorhersagt. Es ist von entscheidender Bedeutung zu verstehen, dass wir das Ziel weder manuell generieren noch eine Glättung mittels eines gleitenden Durchschnitts vornehmen, wie dies bei der Aufbereitung der Eingabedaten der Fall ist. Stattdessen laden wir einfach den vorbereiteten Umgebungszustand, der bereits im Experience-Replay-Puffer liegt und um den angegebenen Planungshorizont nach vorn verschoben ist.
//--- Look for target
target = vector<float>::Zeros(NActions);
bActions.AssignArray(target);
if(!state.Assign(Buffer[tr].States[i + NForecast].state) ||
   !state.Resize(NForecast * BarDescr) ||
   MathAbs(state).Sum() == 0)
  {
   iter -= Batch + start - i;
   break;
  }
if(!fstate.Resize(1, NForecast * BarDescr) ||
   !fstate.Row(state, 0) ||
   !fstate.Reshape(NForecast, BarDescr))
  {
   iter -= Batch + start - i;
   break;
  }
for(int j = 0; j < NForecast / 2; j++)
  {
   if(!fstate.SwapRows(j, NForecast - j - 1))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
  }
Nachdem wir die Zielwerte gebildet haben, können wir die Parameter des Encoders anpassen, indem wir die Methode für den Rückwärtsdurchlauf aufrufen.
//--- State Encoder
Result.AssignArray(fstate);
if(!cEncoder.backProp(Result, (CBufferFloat*)NULL, NULL))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Anschließend können wir auf Grundlage der verfügbaren tatsächlichen Daten zur zukünftigen Preisentwicklung eine „nahezu perfekte“ Handelsentscheidung treffen.
target = fstate.Col(0).CumSum();
if(result[0] > result[3])
  {
   float tp = 0;
   float sl = 0;
   float cur_sl = float(-(result[2] > 0 ? result[2] : 1) * MaxSL * Point());
   int pos = 0;
   for(int j = 0; j < NForecast; j++)
     {
      tp = MathMax(tp, target[j] + fstate[j, 1] - fstate[j, 0]);
      pos = j;
      if(cur_sl >= target[j] + fstate[j, 2] - fstate[j, 0])
         break;
      sl = MathMin(sl, target[j] + fstate[j, 2] - fstate[j, 0]);
     }
   if(pos > 0 && tp > 0)
     {
      sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
      tp = float(MathMin(tp / (MaxTP * Point()), 1));
      result[0] = MathMax(result[0] - result[3], 0.011f);
      result[5] = result[1] = tp;
      result[4] = result[2] = sl;
      result[3] = 0;
      bActions.AssignArray(result);
     }
  }
else
  {
   if(result[0] < result[3])
     {
      float tp = 0;
      float sl = 0;
      float cur_sl = float((result[5] > 0 ? result[5] : 1) * MaxSL * Point());
      int pos = 0;
      for(int j = 0; j < NForecast; j++)
        {
         tp = MathMin(tp, target[j] + fstate[j, 2] - fstate[j, 0]);
         pos = j;
         if(cur_sl <= target[j] + fstate[j, 1] - fstate[j, 0])
            break;
         sl = MathMax(sl, target[j] + fstate[j, 1] - fstate[j, 0]);
        }
      if(pos > 0 && tp < 0)
        {
         sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
         tp = float(MathMin(-tp / (MaxTP * Point()), 1));
         result[3] = MathMax(result[3] - result[0], 0.011f);
         result[2] = result[4] = tp;
         result[1] = result[5] = sl;
         result[0] = 0;
         bActions.AssignArray(result);
        }
     }
   else
     {
      ulong argmin = target.ArgMin();
      ulong argmax = target.ArgMax();
      float max_sl = float(MaxSL * Point());
      while(argmax > 0 && argmin > 0)
        {
         if(argmax < argmin && target[argmax] / 2 > MathAbs(target[argmin]) &&
                               MathAbs(target[argmin]) < max_sl)
            break;
         if(argmax > argmin && target[argmax] < MathAbs(target[argmin] / 2) && target[argmax] < max_sl)
            break;
         target.Resize(MathMin(argmax, argmin));
         argmin = target.ArgMin();
         argmax = target.ArgMax();
        }
      if(argmin == 0 || (argmax < argmin && argmax > 0))
        {
         float tp = 0;
         float sl = 0;
         float cur_sl = - float(MaxSL * Point());
         ulong pos = 0;
         for(ulong j = 0; j < argmax; j++)
           {
            tp = MathMax(tp, target[j] + fstate[j, 1] - fstate[j, 0]);
            pos = j;
            if(cur_sl >= target[j] + fstate[j, 2] - fstate[j, 0])
               break;
            sl = MathMin(sl, target[j] + fstate[j, 2] - fstate[j, 0]);
           }
         if(pos > 0 && tp > 0)
           {
            sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
            tp = (float)MathMin(tp / (MaxTP * Point()), 1);
            result[0] = float(MathMax(Buffer[tr].States[i].account[0] / 100 * 0.01, 0.011));
            result[5] = result[1] = tp;
            result[4] = result[2] = sl;
            result[3] = 0;
            bActions.AssignArray(result);
           }
        }
      else
        {
         if(argmax == 0 || argmax > argmin)
           {
            float tp = 0;
            float sl = 0;
            float cur_sl = float(MaxSL * Point());
            ulong pos = 0;
            for(ulong j = 0; j < argmin; j++)
              {
               tp = MathMin(tp, target[j] + fstate[j, 2] - fstate[j, 0]);
               pos = j;
               if(cur_sl <= target[j] + fstate[j, 1] - fstate[j, 0])
                  break;
               sl = MathMax(sl, target[j] + fstate[j, 1] - fstate[j, 0]);
              }
            if(pos > 0 && tp < 0)
              {
               sl = (float)MathMax(MathMin(MathAbs(sl) / (MaxSL * Point()), 1), 0.01);
               tp = (float)MathMin(-tp / (MaxTP * Point()), 1);
               result[3] = float(MathMax(Buffer[tr].States[i].account[0] / 100 * 0.01, 0.011));
               result[2] = result[4] = tp;
               result[1] = result[5] = sl;
               result[0] = 0;
               bActions.AssignArray(result);
              }
           }
        }
     }
  }
Es ist zu beachten, dass diese Handelsentscheidung auf dem im vorherigen Schritt ausgeführten Trade basiert. Der Agent arbeitet nicht mit isolierten Signalen im luftleeren Raum, sondern baut eine Abfolge von Aktionen auf. Und jede weitere Entscheidung basiert auf einem Trade, der bereits ausgeführt wurde. Dank dieses Ansatzes erhalten wir am Ende keine Ansammlung unzusammenhängender Orders, sondern eine vollwertige Strategie, bei der jede Entscheidung logisch aus der vorherigen folgt. Genau diese nahezu perfekten Trades nutzen wir, um den Actor zu trainieren.
//--- Actor Policy
bActions.GetData(result);
if(!cActor.backProp(GetPointer(bActions), (CNet*)GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Wir nutzen dieselben Trades, um den Critic zu trainieren. Das Ziel besteht darin, eine Aktionsbewertungsfunktion zu entwickeln, die die tatsächliche Strategie des Actor möglichst genau widerspiegelt. Wir übergeben dem Critic dieselbe nahezu perfekte Abfolge von Trades und bestimmen die Belohnung anhand der Preisänderung der nächsten Bar.
//--- Critic
if(!cCritic.feedForward(GetPointer(bActions), 1, false, (CNet*)GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
float reward = float((bActions[0] - bActions[3]) * fstate[0, 0] / Point());
Result.Clear();
if(!Result.Add(reward)
   || !cCritic.backProp(Result, (CNet*)GetPointer(cEncoder), LatentLayer)
   || !cEncoder.backPropGradient((CBufferFloat*)NULL, (CBufferFloat*)NULL, LatentLayer, true)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Auf diese Weise lernt der Critic, die Aktionen des Actor anhand tatsächlicher Preisänderungen genau zu bewerten, und trägt so zur Entwicklung einer präziseren und robusteren Strategie bei.
Etwas anders sieht es aus, wenn es um das Training des Directors geht. Man kann ihn nicht einfach nur mit positiven Beispielen füttern – sonst lernt er nie, schlechte Aktionen von guten zu unterscheiden. Daher wählen wir in jedem Schritt zufällig aus, wie das Trainingsbeispiel aussehen soll:
- Positiv. Wir speisen eine nahezu perfekte Aktion ein, die wir gerade anhand der tatsächlichen Daten berechnet haben, und weisen ihr das Label „1“ (Erfolg) zu.
- Negativ. Wir erzeugen einen Vektor aus Zufallswerten mit derselben Dimensionalität wie der Aktionsraum und weisen ihm das Label „0“ (Fehlschlag) zu.
Anschließend rufen wir die Methoden für den Vorwärtsdurchlauf und den Rückwärtsdurchlauf des Director auf.
//--- Director
Result.Clear();
if((MathRand() / 32767.0) > 0.5)
   Result.Add(1);
else
  {
   target = vector<float>::Zeros(NActions);
   for(int i = 0; i < NActions; i++)
      target[i] = float(MathRand() / 32767.0);
      bActions.AssignArray(target);
      Result.Add(0);
  }
if(!cDirector.feedForward(GetPointer(bActions), 1, false, (CNet*)GetPointer(cEncoder), LatentLayer)
   || !cDirector.backProp(Result, (CNet*)GetPointer(cEncoder), LatentLayer)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Dieser Ansatz stellt sicher, dass der Director nicht nur lernt, gute Entscheidungen zu fördern, sondern auch die Schwächen schlechter Entscheidungen zu erkennen, und so dem Actor hilft, ineffektive Aktionen zu vermeiden.
Nun muss der Nutzer nur noch über den Trainingsfortschritt informiert werden, und schon kann zur nächsten Iteration des Schleifensystems übergegangen werden.
    if(GetTickCount() - ticks > 500)
      {
       double percent = double(iter + i - start) * 100.0 / (Iterations);
       string str = StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Encoder",
                                     percent, cEncoder.getRecentAverageError());
       str += StringFormat("%-14s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                cActor.getRecentAverageError());
       str += StringFormat("%-14s %6.2f%% -> Error %15.8f\n", "Director",
                                    percent, cDirector.getRecentAverageError());
       str += StringFormat("%-16s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                               cCritic.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
Nachdem der Modelltrainingsprozess abgeschlossen ist, protokollieren wir die Ergebnisse und leiten das Herunterfahren des Expert Advisors ein.
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Encoder", cEncoder.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor", cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Director", cDirector.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic", cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
An den Programmen für das Offline- und Online-Modelltraining mit realen historischen Daten wurden nur geringfügige, gezielte Änderungen vorgenommen, insbesondere im Hinblick auf die Erstellung eines Zeitstempel-Puffers. Wir werden uns damit jetzt noch nicht im Detail befassen. Der vollständige Code ist im Anhang enthalten, und Sie können ihn selbst durchsehen. Die Programme zur Interaktion mit der Umgebung sind dort ebenfalls enthalten.
Das Training unseres Systems ist in drei Phasen gegliedert, von denen jede das Modell schrittweise auf reale Marktbedingungen vorbereitet.
Zunächst führen wir ein erstes Offline-Training anhand realer historischer Daten unter Verwendung der oben beschriebenen Glättungsmethode durch. Diese Phase wird durchgeführt, ohne den Trainingsdatensatz zu aktualisieren. Die Batch-Normalisierungsschicht mit hinzugefügtem Rauschen, die wir im Environment-State-Encoder verwenden, sorgt für eine ausreichende Augmentation der Eingabedaten und vergrößert den Trainingsdatensatz aus Sicht des Modells erheblich.
Stellen Sie sich vor, jede Bar und jeder Indikator würde einen Filter durchlaufen, der sie leicht verzerrt – dadurch entstehen viele Varianten derselben Situation, und es wird verhindert, dass das Modell einfach immer wieder dieselben Muster auswendig lernt. Dadurch lernt der Encoder, das Wesentliche einer Bewegung trotz geringfügiger Verzerrungen zu erkennen.
In der zweiten Offline-Phase werden historische Daten ohne Glättung verwendet: Das Modell wird dem wahren Gesicht des Marktes ausgesetzt – scharfen Ausschlägen, Einbrüchen und verrauschten Schwankungen. Dieser Übergang von einem idealisierten Markt zu Rohdaten hilft dem Agent, sich an reale Marktschwankungen anzupassen, die Stabilität seiner Prognosen zu wahren und sich nicht durch plötzliche Anomalien aus der Bahn werfen zu lassen. Wir beobachten die Entwicklung des Prognosefehlers genau und brechen das Training ab, sobald die Kennzahl über mehrere aufeinanderfolgende Durchläufe hinweg innerhalb eines engen Bereichs bleibt – dies ist ein Zeichen dafür, dass sich das Modell auf die Daten eingestellt hat.
Schließlich gelangt der Agent in der dritten Phase in den Strategietester zum Online-Lernen. Hier betrachten wir das Verhalten der Saldenkurve. Wenn die Saldenkurve nach mehreren aufeinanderfolgenden Durchläufen stagniert und nicht das erwartete Wachstum zeigt, kehren wir behutsam zum Offline-Training zurück: Wir passen die Strategie des Actor mithilfe einer nahezu idealen Trajektorie an und starten das Fine-Tuning erneut.
Dieser stufenweise Ansatz gewährleistet sowohl eine hohe Prognosegenauigkeit als auch die Robustheit von Handelsentscheidungen unter allen Marktbedingungen.
Tests
Wir haben sehr viel Arbeit geleistet, um die von den Autoren des Mamba4Cast-Frameworks vorgeschlagenen Ansätze anzupassen und umzusetzen. Nun kommt der Moment der Wahrheit – die Überprüfung der Wirksamkeit der implementierten Lösungen anhand realer Daten.
Als Trainingsdatensatz verwendeten wir Ein-Minuten-Kurse für EURUSD über das gesamte Jahr 2024. Um die Aussagekraft des Experiments nicht zu verfälschen, wurden die abschließenden Tests anhand historischer Daten von Januar bis März 2025 durchgeführt – dieser Zeitraum wurde beim Training nicht verwendet. Alle anderen Parameter blieben unverändert, um eine objektive und faire Bewertung der Strategie zu gewährleisten.
Die Testergebnisse sind im Folgenden aufgeführt.
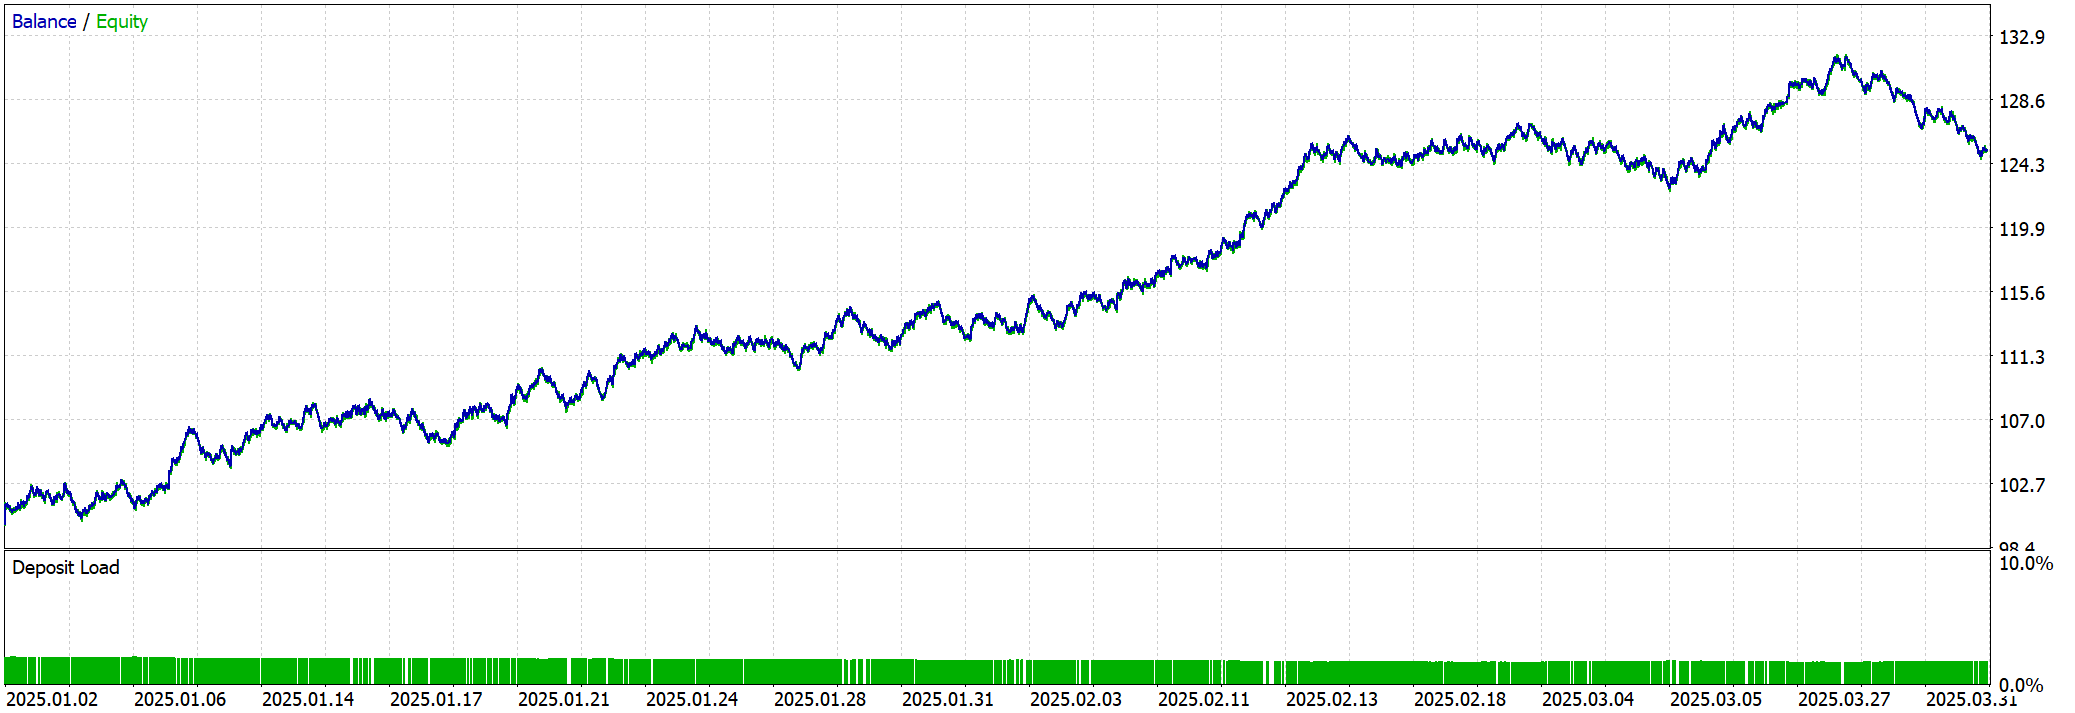
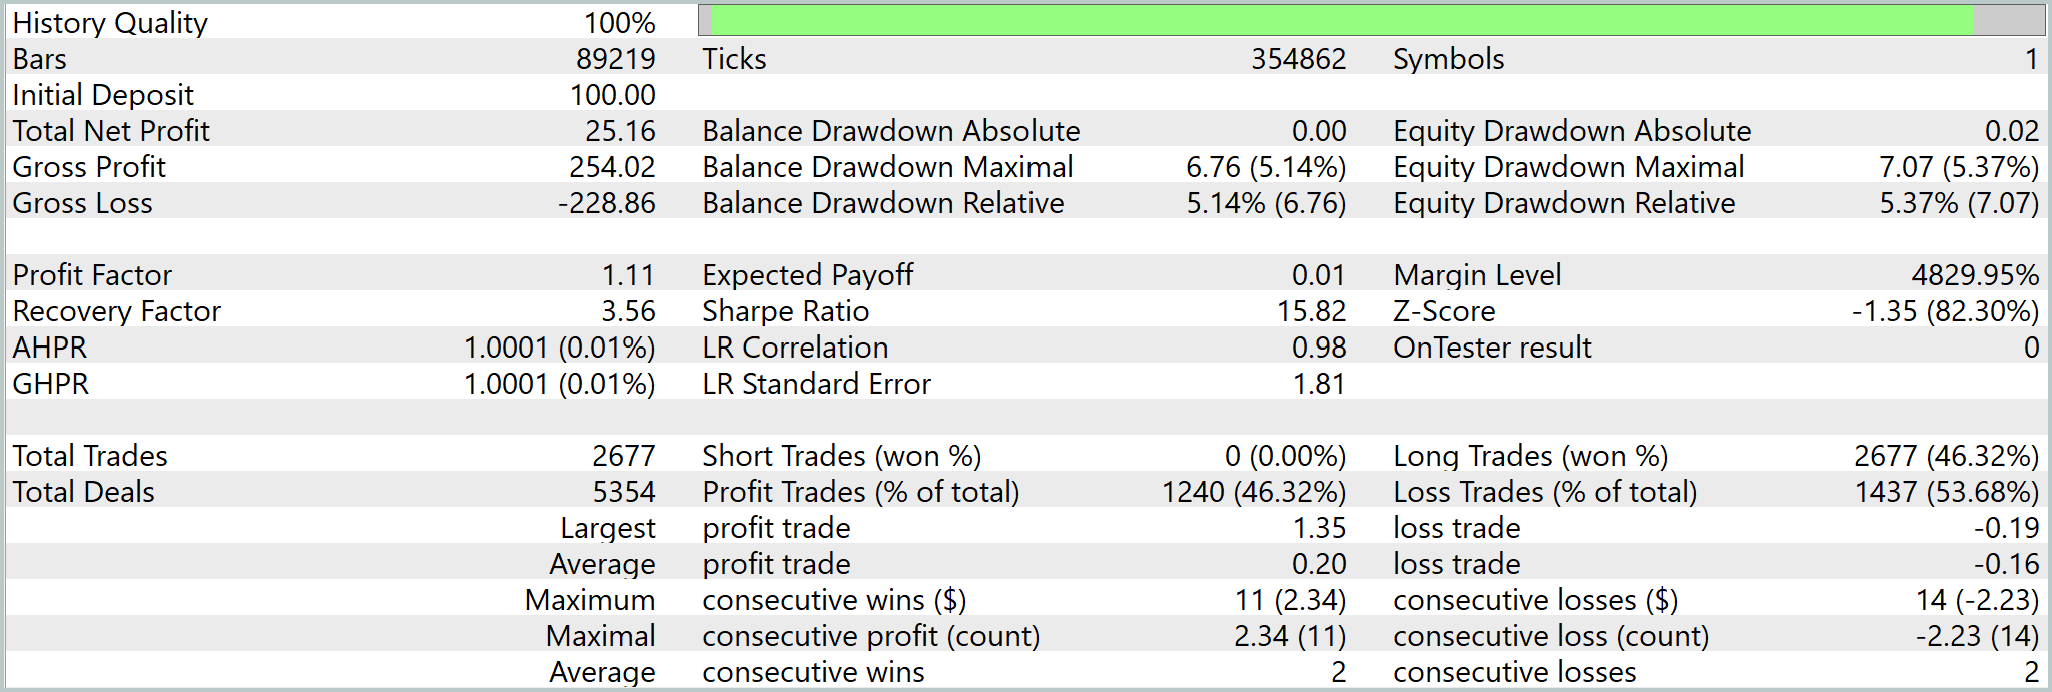
Man muss zugeben, dass hier eine recht hohe Trade-Frequenz zu beobachten ist. Die durchschnittliche Haltedauer einer Position beträgt etwas mehr als 3 Minuten. Insgesamt führte das Modell während des Testzeitraums 2.677 Trades durch, von denen 1.240 mit Gewinn abgeschlossen wurden. Obwohl die Anzahl der verlustbringenden Trades etwas höher war, gelang es dem Modell, im Testzeitraum einen Gewinn zu erzielen, und wir können ein recht stetiges Wachstum der Saldenkurve beobachten. Dies lässt sich teilweise dadurch erklären, dass Positionen mit einem relativ engen Stop-Loss eröffnet und anschließend aktiv verwaltet werden. Diese Annahme wird durch die geringe Differenz zwischen dem durchschnittlichen und dem größten Verlust-Trade gestützt Gleichzeitig ist der Gewinn aus dem erfolgreichsten Trade fast siebenmal so hoch wie der durchschnittliche Gewinn pro Trade.
Fazit
Wir haben den gesamten Weg zurückgelegt – von der Idee und der Architektur des Mamba4Cast-Frameworks bis hin zu seiner praktischen Implementierung, dem Training und gründlichen Tests anhand realer historischer Daten. Wir haben dem Encoder beigebracht, den Markt zu erfassen, dem Actor, Entscheidungen unter Berücksichtigung von Risiken zu treffen, dem Director, die besten und schlechtesten Signale herauszufiltern, und dem Critic, Aktionen anhand der tatsächlichen Ergebnisse zu bewerten.
Tests mit EURUSD M1 für den Zeitraum Januar bis März 2025 haben gezeigt, dass Mamba4Cast nicht nur Prognosen erstellen, sondern sich auch vor Marktrauschen schützen, sich an unerwartete Ereignisse anpassen und langfristig profitabel bleiben kann.
Alle in diesem Artikel vorgestellten Programme dienen jedoch ausschließlich zu Demonstrationszwecken und sollen die Möglichkeiten des Mamba4Cast-Frameworks veranschaulichen. Bevor Sie die vorgeschlagenen Lösungen im realen Handel anwenden, müssen Sie die Modelle anhand eines wirklich repräsentativen Datensatzes trainieren und umfassende Tests durchführen – nur so können Sie die Zuverlässigkeit und Sicherheit Ihrer Handelsstrategie gewährleisten.
Links
- Mamba4Cast: Effiziente Zero-Shot-Zeitreihenprognose mit State-Space-Modellen
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Research.mq5 | Expert Advisor | Beispielsammlung für Expert Advisors |
| 2 | ResearchRealORL.mq5 | Expert Advisor | Expert Advisor für eine Beispielsammlung unter Verwendung der Real-ORL-Methode |
| 3 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 4 | StudyMA.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining anhand gemittelter Daten |
| 5 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für das Online-Training des Modells |
| 6 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 7 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitekturen |
| 8 | NeuroNet.mqh | Klassenbibliothek | Eine Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 9 | NeuroNet.cl | Bibliothek | Bibliothek mit OpenCL-Programmcode |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18219
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.


 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Vom Anfänger zum Fortgeschrittenen: Objekte (II)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Marktsimulation (Teil 22): Erste Schritte mit SQL (V)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.