Métodos de muestreo MCMC: el algoritmo de Metropolis-Hastings
 22
 2

Introducción
Los métodos de Monte Carlo basados en cadenas de Markov (MCMC) son una clase de algoritmos de muestreo que permiten obtener muestras de una distribución objetivo compleja p(x). El objetivo del método MCMC es obtener un conjunto de muestras que representen con precisión esa distribución objetivo, de modo que se puedan estimar las medias, las varianzas y otras características de dicha distribución. La esencia del método MCMC consiste en construir una cadena de Markov especial cuya distribución estacionaria coincida con la distribución objetivo.
Estos métodos se usan ampliamente en la inferencia bayesiana, el aprendizaje automático y otros campos en los que es necesario aproximar las distribuciones a posteriori. A diferencia de los métodos deterministas, como la inferencia variacional o la aproximación de Laplace, los algoritmos MCMC poseen una propiedad única: si se configuran correctamente, garantizan, en el límite, la obtención de muestras que se ajustan exactamente a la distribución objetivo. Entre la gran variedad de algoritmos MCMC, ocupa un lugar especial el algoritmo de Metropolis-Hastings (MH), un método fundamental en el que se basan muchos enfoques actuales.
En este artículo analizaremos el algoritmo de Metropolis-Hastings, partiendo de sus fundamentos teóricos y conceptos clave. A continuación, presentaremos la implementación del algoritmo en MQL5 en forma de la clase MHSampler y analizaremos ejemplos sencillos de su aplicación a distribuciones unidimensionales y multidimensionales, incluidas las variantes de «paseo aleatorio» y «MH independiente».
Cabe señalar que, al usar métodos MCMC, se debe prestar especial atención al diagnóstico y al ajuste del algoritmo, ya que su correcto funcionamiento requiere un análisis minucioso de la convergencia de la cadena mediante herramientas estadísticas y visuales.
El algoritmo de Metropolis
El algoritmo básico de Metropolis (Metropolis, 1953) genera muestras a partir de la distribución objetivo, proponiendo en cada paso una transición del estado actual x a un nuevo estado x′ con una probabilidad q(x′∣x), donde q se denomina distribución auxiliar o distribución de propuesta (proposal distribution). El requisito principal de una distribución auxiliar es que garantice que la cadena no se quede atascada en una sola zona; es decir, debe existir la posibilidad de pasar desde cualquier punto del espacio que ocupa la distribución objetivo a cualquier otro punto. Para ello basta con que la probabilidad q(x′∣x) sea distinta de cero para todos los estados posibles x y x′.
El estado propuesto x' se acepta o se rechaza según un criterio que garantice que, a largo plazo, la cadena visite los estados de forma proporcional a p(x). Si se acepta el estado x', este se convierte en el nuevo estado; en caso contrario, la cadena permanece en el estado actual (se duplica la muestra).
El algoritmo de Metropolis es un caso particular del algoritmo de Metropolis-Hastings, en el que la distribución auxiliar q(x'|x) es simétrica, es decir, la probabilidad de proponer una transición de x a x′ es igual a la probabilidad de proponer la transición inversa: q(x′∣x)=q(x∣x′).
Gracias a esta simetría, el criterio de aceptación del candidato x′ se simplifica considerablemente:
A = min (1, p*(x')/p*(x))
donde p*(x) es la densidad no normalizada de la distribución objetivo, y la propia distribución viene definida como p(x) = p*(x)/Zp.
La constante de normalización Zp puede ser desconocida, lo cual hace que el algoritmo resulte especialmente útil para problemas en los que resulta difícil calcular Zp de forma analítica, como suele ocurrir en la inferencia bayesiana.
Si la densidad en el nuevo punto x′ es mayor que en el punto actual x (es decir, p*(x′) > p*(x)), entonces el coeficiente de aceptación A = 1, y la transición a x′ se produce siempre (con probabilidad 1). Esto permite que la cadena ascienda rápidamente hacia los picos de la distribución, lo que garantiza la exploración de regiones de alta probabilidad.
Si la densidad disminuye (p*(x′) <; p*(x)), la transición a x′ se produce con una probabilidad A = p*(x′)/p*(x). Este mecanismo permite que la cadena descienda desde los puntos máximos de la distribución y explore las laderas y los valles de la misma, lo que garantiza una búsqueda eficaz en todo el espacio y evita que la cadena se quede atascada para siempre en un mismo punto.
Es precisamente este equilibrio entre la aceptación incondicional «hacia arriba» y la aceptación probabilística «hacia abajo» lo que garantiza que la cadena mantenga las proporciones de la distribución objetivo, pasando más tiempo allí donde la densidad es mayor.
La secuencia de muestras obtenida de este modo forma una cadena de Markov, en la que cada estado siguiente depende del anterior. Esto da lugar a una autocorrelación entre las muestras, lo que puede reducir su representatividad (debido a la elevada autocorrelación, las muestras contiguas contienen información casi idéntica).
Por ejemplo, si se han recopilado 1.000 muestras muy correlacionadas, estas pueden contener la misma información que tan solo 50 muestras independientes. Las 1.000 muestras recopiladas no representan 1.000 observaciones únicas de la distribución, sino que solo proporcionan 50 observaciones efectivas. Como consecuencia, las estimaciones de la media, la varianza y otras características de la distribución, basadas en estas muestras correlacionadas, tendrán una mayor varianza (error) que si se hubiera utilizado el mismo número de muestras independientes. Por ello, para reducir la correlación, se aplican el denominado periodo de calentamiento (burn-in), en el que se descartan las iteraciones iniciales, y el adelgazamiento (thinning), que conserva únicamente cada i-ésima muestra.

Fig. 1: Algoritmo de Metropolis
Cadenas de Markov
Los métodos de Monte Carlo basados en cadenas de Markov utilizan cadenas de Markov para generar muestras a partir de distribuciones complejas. Para entender cómo funciona, analizaremos dos propiedades clave de las cadenas de Markov que deben cumplirse para desarrollar un algoritmo MCMC: su «memoria» y su capacidad para encontrar la distribución deseada.
1. Propiedad de Markov
Una cadena de Markov es una secuencia de estados x(1), x(2), … en la que cada estado siguiente x(t+1) depende únicamente del estado actual x(t) y no depende de todo el historial previo de la cadena x(1), …, x(t−1):
P(x(t+1) | x(t), …, x(1)) = P(x(t+1) | x(t))
Esta propiedad significa que, para predecir el estado futuro, basta con conocer únicamente el estado actual.
2. Convergencia hacia la distribución objetivo
El objetivo de los algoritmos MCMC es construir una cadena de Markov que, con el tiempo (tras un periodo inicial de calentamiento, o «burn-in»), genere muestras de la distribución objetivo p(x). Esto se consigue gracias a una regla de transición especial que cumple la condición de equilibrio detallado (Detailed Balance):
p(x)T(x′|x) = p(x′)T(x|x′)
donde:
- p(x) y p(x′) son las densidades de la distribución objetivo,
- T(x′∣x) es la probabilidad total de transición de x a x'.
En el algoritmo de Metropolis-Hastings, esta importante condición se garantiza mediante la elección de un coeficiente de aceptación A adecuado, que asegura que, con el tiempo, la cadena «visite» los estados de forma proporcional a p(x), incluso si la propia distribución solo está definida parcialmente (sin la constante de normalización Zp). En este caso, la probabilidad total de transición T(x′∣x) se calcula como el producto de la probabilidad de propuesta q(x′∣x) y la probabilidad de aceptación A(x′∣x).
El algoritmo de Metropolis-Hastings
El algoritmo de Metropolis-Hastings (Hastings, 1970) generaliza el algoritmo de Metropolis, permitiendo utilizar distribuciones de propuesta asimétricas, es decir, q(x'|x) ≠ q(x|x'). Esto hace que el algoritmo sea más flexible y aplicable a una amplia clase de problemas en los que las distribuciones simétricas no son adecuadas (por ejemplo, cuando se utilizan distribuciones de propuesta lognormales o exponenciales).
Para compensar la asimetría, se introduce en el criterio de aceptación A la corrección de Hastings, que corrige el sesgo generado por una distribución asimétrica. La probabilidad de aceptación del candidato x' se define como:
A = min (1, p*(x')q(x|x') / p*(x)q(x'|x))
donde:
- p*(x) — densidad no normalizada de la distribución objetivo,
- q(x|x') / q(x'|x) — corrección de Hastings, que tiene en cuenta la asimetría de la distribución de propuesta.
Para calcular A, al igual que antes, no es necesario conocer la constante normalizadora Zp en la distribución de probabilidad p(x) = p*(x)/Zp, ya que esta se cancela.
El impacto de la distribución auxiliar en el rendimiento
La elección de q(x'|x) influye considerablemente en la eficacia del algoritmo. En los espacios continuos se suele utilizar una distribución normal centrada en el estado actual x(t), lo que da lugar a un comportamiento conocido como «Metropolis-Hastings con paseo aleatorio» (RWMH). En este sentido, el parámetro de varianza (o paso de la cadena) desempeña un papel fundamental, ya que determina la escala de las transiciones propuestas:
- Baja varianza: la tasa de aceptación será alta, pero la cadena avanzará lentamente. Esto dará lugar a un tiempo de autocorrelación prolongado de las muestras, ya que la cadena explora lentamente el espacio.
- Gran varianza: la tasa de aceptación será baja, ya que la mayoría de los pasos propuestos se situarán en zonas de baja probabilidad. Esto da lugar a rechazos frecuentes y a un uso ineficiente de los recursos de cálculo.
En la práctica, el rendimiento óptimo se alcanza cuando la tasa de aceptación se sitúa entre el 20 % y el 40 %. Esto requiere un ajuste minucioso de los parámetros de q para equilibrar la velocidad de exploración del espacio y la probabilidad de aceptación de los candidatos.
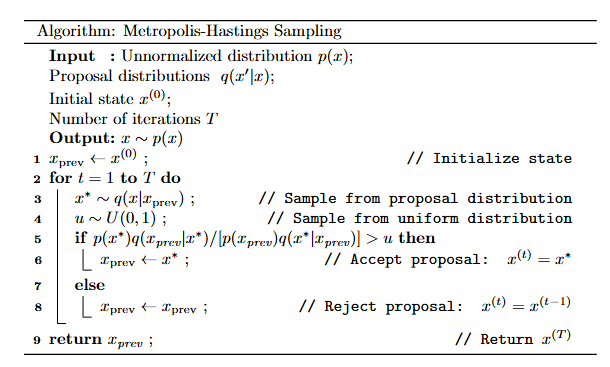
Fig. 2. Algoritmo de Metropolis-Hastings
El algoritmo de Metropolis-Hastings se ha implementado en MQL5 utilizando un enfoque orientado a objetos. La clase principal MHSampler requiere la implementación de tres clases abstractas: LogPDF (logaritmo de la densidad objetivo), PropRND (generador de nuevos estados) y LogPropPDF (logaritmo de la densidad de transición). Gracias a ello, es posible configurar fácilmente el algoritmo para cualquier distribución objetivo y distribución auxiliar.
Clase LogPDF
La clase LogPDF define una interfaz para calcular el logaritmo de la densidad de probabilidad de la distribución objetivo p*(x). El método LogPdf(const vector &x) toma un vector x (un punto en el espacio de estados) y devuelve lnp*(x).
El uso del logaritmo de la densidad es una práctica habitual en MCMC, ya que evita errores numéricos al trabajar con probabilidades pequeñas, especialmente en problemas multidimensionales. La clase se puede implementar para cualquier distribución objetivo, por ejemplo, una distribución normal o una mezcla de distribuciones. En la inferencia bayesiana, esta clase se implementa para calcular el logaritmo de la densidad a posteriori no normalizada, lo que se expresa como la suma de logaritmos: lnp*(x) = ln(verosimilitud) + ln(distribución a priori).
Clase PropRND
La clase PropRND se encarga de generar estados candidatos aleatorios x′ a partir de la distribución auxiliar q(x′∣x). El método PropRnd(const vector &x) toma el estado actual x y devuelve un nuevo vector x′, generado a partir de la distribución q(x′∣x).
Por ejemplo, para el algoritmo MH con paseo aleatorio, el usuario puede implementar PropRND con una distribución gaussiana centrada en el estado actual x, mientras que para el algoritmo MH independiente puede hacerlo con una distribución fija que no dependa de x.
Clase LogPropPDF
La clase LogPropPDF se encarga de calcular el logaritmo de la densidad de la distribución de propuesta q(x'∣x). Esta clase no genera nuevos estados, sino que únicamente calcula la densidad de probabilidad de transición. El método LogPropPdf(const vector &x_to, const vector &x_from) devuelve lnq(x'∣x), donde x' es el nuevo estado propuesto y x es el estado actual.
Esta clase se usa únicamente para distribuciones de propuesta asimétricas. En estos casos, lnq(x'∣x) es necesario para calcular la corrección de Hastings en el criterio de aceptación. En los casos simétricos, esta clase no se utiliza.
Clase MHSampler
El método MHSample ejecuta el algoritmo de Metropolis o de Metropolis-Hastings y recibe los siguientes parámetros:
- start — estado inicial x0 (vector),
- samples— matriz para almacenar las muestras obtenidas,
- accept_rate — variable para almacenar la tasa de aceptación de las propuestas,
- log_pdf — puntero a un objeto de la clase LogPDF para calcular ln p(x),
- prop_rnd — puntero a un objeto de la clase PropRND para generar candidatos,
- log_prop_pdf — puntero a un objeto de la clase LogPropPDF (o NULL en el caso simétrico),
- params — estructura MH_Params que contiene los parámetros:
- nsamples — número de muestras que se guardan,
- burnin — periodo de calentamiento — número de iteraciones iniciales que se descartan para alcanzar una distribución estacionaria,
- thin — intervalo de adelgazamiento — solo se conserva cada i.ª muestra para reducir la correlación,
- symmetric — indicador que especifica si la distribución auxiliar es simétrica; es decir, si se debe utilizar la fórmula simplificada (Metropolis) o la fórmula completa (MH).
En cada iteración, partiendo del estado inicial x0, se llevan a cabo los siguientes pasos:
- Generación de un candidato: x' ∼ q(x'∣x0) mediante el objeto prop_rnd.
- Criterio de aceptación (se calcula el logaritmo de la relación de aceptación r):
- Para el caso simétrico (Metropolis):
r = lnp*(x') − lnp*(x0)
- Para el caso asimétrico (Metropolis-Hastings):
r = [ lnp*(x') + lnq(x0∣x') ] − [ lnp*(x0) + lnq(x'∣x0) ]
3. Aceptación/Rechazo: se genera un número aleatorio uniforme u ∼ U(0,1). Se acepta el paso si se cumple la condición ln u ≤ min (r, 0). Si se cumple la condición, el estado actual se actualiza a x0 = x'; en caso contrario, x0 permanece sin cambios.
4. Recopilación de muestras: tras el periodo de calentamiento burnin y teniendo en cuenta el adelgazamiento (thin), el estado actual x0 se registra en la matriz samples.
Al final del ciclo siempre se calcula la tasa de aceptación (accept_rate), que constituye la principal herramienta de diagnóstico para evaluar la eficacia de la distribución auxiliar seleccionada.
#include <Math\Stat\Uniform.mqh> //+------------------------------------------------------------------+ //| Clase abstracta para el logaritmo de la densidad objetivo P(x) | //+------------------------------------------------------------------+ class LogPDF { public: virtual double LogPdf(const vector &x) = 0; }; //+------------------------------------------------------------------+ //| Clase abstracta para la densidad logarítmica de la distribución de propuesta q(x'|x) | //| (Para el caso asimétrico) | //+------------------------------------------------------------------+ class LogPropPDF { public: // LogPropPdf(x_to, x_from) devuelve q(x_to | x_from) virtual double LogPropPdf(const vector &x_to, const vector &x_from) = 0; }; //+------------------------------------------------------------------+ //| Clase abstracta para un generador de candidatos q(x'|x) | //+------------------------------------------------------------------+ class PropRND { public: virtual vector PropRnd(const vector &x) = 0; }; //+------------------------------------------------------------------+ //| Estructura de los parámetros para MHSampler | //+------------------------------------------------------------------+ struct MH_Params { int nsamples; // número de muestras int burnin; // periodo de calentamiento int thin; // adelgazamiento bool symmetric; // Distribución auxiliar simétrica q(x', x) = q(x, x') }; //+------------------------------------------------------------------+ //| Clase MHSampler, que implementa el algoritmo de Metropolis-Hastings | //+------------------------------------------------------------------+ class MHSampler { public: //+------------------------------------------------------------------+ //| Función principal del muestreo MH | | //+------------------------------------------------------------------+ bool MHSample( const vector &start, matrix &samples, double &accept_rate, LogPDF *log_pdf, PropRND *prop_rnd, LogPropPDF *log_prop_pdf, // Puede ser NULL si symmetric = true const MH_Params ¶ms ) { // --- 1. Comprobaciones e inicialización --- if(params.nsamples <= 0 || params.thin <= 0) { Print("Error: nsamples y thin deben ser > 0"); return false; } if(!params.symmetric && log_prop_pdf == NULL) { Print("Error: Para la distribución auxiliar no simétrica se requiere log_prop_pdf."); return false; } int dim = (int)start.Size(); int total_steps = params.nsamples * params.thin + params.burnin; vector x0 = start; // Valor actual double accepted_count = 0; int sample_idx = 0; // Inicialización de la matriz de muestras samples.Resize(params.nsamples, dim); // --- 2. Bucle principal de Metropolis-Hastings --- for(int i = 1 - params.burnin; i <= params.nsamples * params.thin; i++) { // 2.1. Generación del candidato: x' ~ q(x'| x0) vector x_new = prop_rnd.PropRnd(x0); // 2.2. Cálculo de los logaritmos de las probabilidades double log_pdf_new = log_pdf.LogPdf(x_new); double log_pdf_x0 = log_pdf.LogPdf(x0); // 2.3. Cálculo del logaritmo del coeficiente de aceptación A double r; if(params.symmetric) { // MH de paseo aleatorio (q simétrica: q(x,x')=q(x',x)): r = log(P(x')/P(x0)) r = log_pdf_new - log_pdf_x0; } else { // MH general (q asimétrica): r = log( P(x')q(x₀|x') / P(x₀)q(x'|x₀) ) // q(x_new | x0) - Probabilidad de transición directa double log_prop_x0_to_xnew = log_prop_pdf.LogPropPdf(x_new, x0); // q(x' | x0) // q(x0 | x_new) - Probabilidad de transición inversa double log_prop_xnew_to_x0 = log_prop_pdf.LogPropPdf(x0, x_new); // q(x₀ | x') r = (log_prop_xnew_to_x0 + log_pdf_new) - (log_prop_x0_to_xnew + log_pdf_x0); } // 2.4. Aceptación/Rechazo int err; double U = MathLog(MathRandomUniform(0.0, 1.0,err)); //El paso se acepta si log(U) ≤ min(0, r), lo que equivale a //la condición clásica U ≤ A, donde el coeficiente de aceptación es: A = min(1, exp(r)) if(U <= MathMin(0.0, r)) { // Aceptación: x0 = x' x0 = x_new; accepted_count++; } // Rechazo: x0 permanece sin cambios // 2.5. Muestreo (teniendo en cuenta el periodo de calentamiento y el adelgazamiento) if(i > 0 && i % params.thin == 0) { if(sample_idx < params.nsamples) { samples.Row(x0, sample_idx); sample_idx++; } } } // 3. Cálculo de la tasa de aceptación (Acceptance Rate) accept_rate = accepted_count / total_steps; return true; } };
Caso unidimensional con distribución auxiliar simétrica (Metropolis con paseo aleatorio)
Ejemplo n.º 1
Este ejemplo muestra la implementación del algoritmo de Metropolis con paseo aleatorio (Random Walk Metropolis, RWM), en el que la distribución de propuesta es simétrica.
Hemos elegido como distribución objetivo la distribución normal estándar unidimensional N(0,1). Los candidatos se generan usando una distribución auxiliar simétrica:
x' = x + u, donde u ∼ Uniform(−δ, δ)
Se utilizan los siguientes parámetros:
- punto inicial x0 = 1,
- periodo de calentamiento burnin = 500,
- adelgazamiento thin = 10,
- δ = 4, determina la amplitud de la distribución uniforme U(−δ, +δ).
Si el paso de la cadena δ es demasiado grande, la tasa de aceptación será baja y la cadena se «atascará» con frecuencia debido al rechazo de candidatos. Si el paso de la cadena δ es demasiado pequeño, la tasa de aceptación será elevada, pero la cadena avanzará lentamente, lo que aumenta la correlación entre las muestras.
El ajuste del parámetro δ permite equilibrar la velocidad de exploración del espacio y la probabilidad de aceptación de candidatos. El usuario debe elegir el valor óptimo de delta δ para obtener una muestra independiente (o casi independiente).
#include <Graphics\Graphic.mqh>
#include <MCMC\MH.mqh>

//+------------------------------------------------------------------+
//| Implementación de LogPDF para N(0, 1)                                    |
//+------------------------------------------------------------------+
class NormalLogPDF : public LogPDF
  {
public:
   virtual double    LogPdf(const vector &x) override
     {
      // Log(N(x | 0, 1)) = -0.5*x^2 - 0.5*log(2*pi)
      return -0.5 * x[0] * x[0] - 0.5 * MathLog(2.0 * M_PI);
     }
  };

//+------------------------------------------------------------------+
//| Implementación de PropRND (paseo aleatorio)                                 |
//+------------------------------------------------------------------+
class RndWalkPropRND : public PropRND
  {
public:
   virtual vector    PropRnd(const vector &x) override
     {
      double delta = 4; // Intervalo del «paseo aleatorio» [-4, 4]
      double x0 = x[0];
      int err;
      double u = MathRandomUniform(-delta, delta,err) ; // Uniform(-d, d)
      vector x_new(1);
      x_new[0] = x0 + u; // x' = x + u
      return x_new;
     }
  };

//+------------------------------------------------------------------+
//| Función de inicio del script                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
// Parámetros
   vector start_point(1);
   start_point[0] = 1.0;

// Inicialización de objetos
   NormalLogPDF target_pdf;
   RndWalkPropRND proposal_rnd;

   MH_Params params;
   params.nsamples = 5000;
   params.burnin = 500;
   params.thin = 10;
   params.symmetric = true; // Paseo aleatorio: una propuesta simétrica

   MHSampler sampler;
   matrix samples;
   double accept_rate;

   Print("Iniciando Random Walk MH para N(0, 1)...");

// Ejecución de MH
   if(sampler.MHSample(start_point, samples, accept_rate, &target_pdf, &proposal_rnd,
                       NULL, // log_prop_pdf no es necesario, ya que symmetric = true
                       params))
     {
      Print("=========================================");
      PrintFormat("Tasa de aceptación: %.2f%%", accept_rate * 100.0);

      vector mean = samples.Mean(0);
      PrintFormat("Valor medio (se espera 0): %.4f", mean[0]);

      Print("Primeras 5 muestras:");
      for(int i = 0; i < 5; i++)
        {
         PrintFormat("Muestra %d: %.4f", i + 1, samples[i][0]);
        }
     }

// Guardar muestras en formato CSV
   MatrixToCSV("MH_RW/MH_samples.csv", samples);

   plotTrace(samples);
  }

//+------------------------------------------------------------------+
//|Gráfico de muestras                                                    |
//+------------------------------------------------------------------+
void plotTrace(matrix &smp)
  {
   ChartSetInteger(0, CHART_SHOW, false);
   CGraphic graphic;
   ulong width = ChartGetInteger(0, CHART_WIDTH_IN_PIXELS);
   ulong height = ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS);
   graphic.Create(0, "MH_RW_MCMC", 0, 0, 0, int(width), int(height));
   graphic.BackgroundMain("Trace Plot MH_RW");
   graphic.BackgroundMainSize(16);

   vector v = smp.Col(0);
   double x[];
   v.Swap(x);
   graphic.CurveAdd(x, CURVE_LINES, "Sample");
   graphic.CurvePlotAll();
   graphic.Update();
   Sleep(10 * 1000);
   ChartSetInteger(0, CHART_SHOW, true);
   graphic.Destroy();
   ChartRedraw(0);
  }
//+------------------------------------------------------------------+
Una vez obtenidas las muestras, se lleva a cabo su análisis utilizando Python. Principales herramientas de diagnóstico:
- Gráfico de traza (Trace Plot): gráfico de los valores de x(t) a lo largo de las iteraciones, que permite evaluar la convergencia de la cadena y su grado de mezcla.
- Histograma: comparación de la distribución empírica de las muestras con la densidad teórica objetivo N(0,1).
- Función de autocorrelación (ACF): muestra el nivel de correlación entre muestras consecutivas. En RWM, la autocorrelación suele ser elevada debido a la naturaleza del paseo aleatorio, por lo que es necesario ajustar el adelgazamiento (thin).
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from statsmodels.graphics.tsaplots import plot_acf

# Ruta del archivo
file_path = "C:/Program Files/MetaTrader 5/MQL5/Files/MH_RW/MH_samples.csv"

# Cargar datos
data = pd.read_csv(file_path, header=None)
samples = data.iloc[:, 0].values

# Estadísticas
print("=========================================")
print("MCMC Samples Analysis (MH_RW, N(0, 1)):")
print(f"Number of samples: {len(samples)}")
print(f"Mean: {np.mean(samples):.4f} (expected 0.0000)")
print(f"Std. deviation: {np.std(samples):.4f} (expected 1.0000)")
print("=========================================")

# Gráficos
fig, axes = plt.subplots(3, 1, figsize=(8, 8))

# Gráfico de traza
axes[0].plot(samples)
axes[0].set_title('Trace Plot')
axes[0].set_xlabel('Iteration')
axes[0].set_ylabel('X')

# Histograma y PDF
x_range = np.linspace(samples.min(), samples.max(), 100)
pdf_theoretical = (1 / np.sqrt(2 * np.pi)) * np.exp(-0.5 * x_range**2)
axes[1].hist(samples, bins=50, density=True, alpha=0.6, label='Samples')
axes[1].plot(x_range, pdf_theoretical, 'r-', label='PDF N(0, 1)')
axes[1].set_title('Histogram and PDF')
axes[1].legend()

# ACF
plot_acf(samples, lags=50, ax=axes[2], title='ACF')
axes[2].set_xlabel('Lags')
axes[2].set_ylabel('Correlation')

plt.tight_layout()
plt.show()

Fig. 3: Gráfico de traza e histograma de las muestras con la densidad teórica
Caso multidimensional con distribución auxiliar simétrica (RWM)
Ejemplo n.º 2
Este ejemplo muestra la aplicación del algoritmo RWM a un espacio multidimensional con variables correlacionadas.
#include <Math\Stat\Normal.mqh>
#include <Graphics\Graphic.mqh>
#include <MCMC\MH.mqh>

//+------------------------------------------------------------------+
//|Clase para la distribución normal bidimensional                    |
//+------------------------------------------------------------------+
class BivariateNormalLogPDF : public LogPDF
  {
public:
   virtual double    LogPdf(const vector &x) override
     {
      vector mu(2);
      mu[0] = 0;
      mu[1] = 0; // Media
      matrix Sigma(2, 2);   // Matriz de covarianza
      Sigma[0][0] = 1;
      Sigma[0][1] = 0.8;
      Sigma[1][0] = 0.8;
      Sigma[1][1] = 1;
      matrix Sigma_inv(2, 2);
      Sigma_inv = Sigma.Inv();
      double det = Sigma.Det();
      vector diff = x - mu;
      double quad_form = diff @ Sigma_inv @ diff;
      return -0.5 * (quad_form + MathLog(det) + 2 * MathLog(2 * M_PI));
     }
  };

//
//+------------------------------------------------------------------+
//|Distribución auxiliar simétrica (paseo aleatorio)          |
//+------------------------------------------------------------------+
class MultiRndWalkPropRND : public PropRND
  {
public:
   virtual vector    PropRnd(const vector &x) override
     {
      double sigma = 1;
      vector delta(x.Size());
      int err;
      for(ulong i = 0; i < x.Size(); i++)
        {
         delta[i] = MathRandomNormal(0, sigma, err);
        }
      return x + delta;
     }
  };

//+------------------------------------------------------------------+
//| Función de inicio del script                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   vector start_point(2);
   start_point[0] = 1.0;
   start_point[1] = 1.0;
   BivariateNormalLogPDF target_pdf;
   MultiRndWalkPropRND proposal_rnd;

   MH_Params params;
   params.nsamples = 5000;
   params.burnin = 500;
   params.thin = 10;
   params.symmetric = true;

   MHSampler sampler;
   matrix samples;
   double accept_rate;

   Print("Iniciando Random Walk MH el bidimensional N([0,0], [[1,0.8],[0.8,1]])...");
   if(sampler.MHSample(start_point, samples, accept_rate, &target_pdf, &proposal_rnd, NULL, params))
     {
      PrintFormat("Tasa de aceptación: %.2f%%", accept_rate * 100.0);
      vector mean = samples.Mean(0);
      PrintFormat("Valor medio (se espera [0,0]): [%.4f, %.4f]", mean[0], mean[1]);
      Print("Primeras 5 muestra:");
      for(int i = 0; i < 5; i++)
        {
         PrintFormat("Muestra %d: [%.4f, %.4f]", i + 1, samples[i][0], samples[i][1]);
        }

      MatrixToCSV("MH_RW/MH_bivariate_samples.csv", samples);

      plotBivariateTrace(samples);
     }
  }

//+------------------------------------------------------------------+
//| Gráfico de muestras bidimensionales                                         |
//+------------------------------------------------------------------+
void plotBivariateTrace(matrix &smp)
  {
   ChartSetInteger(0, CHART_SHOW, false);
   CGraphic graphic;
   ulong width = ChartGetInteger(0, CHART_WIDTH_IN_PIXELS);
   ulong height = ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS);
   graphic.Create(0, "MH_Bivariate_MCMC", 0, 0, 0, int(width), int(height));
   graphic.BackgroundMain("Bivariate Normal Distribution");
   graphic.BackgroundMainSize(16);

   vector x1 = smp.Col(0);
   vector y1 = smp.Col(1);
   double x[],y[];
   x1.Swap(x);
   y1.Swap(y);
   graphic.CurveAdd(x, y, CURVE_POINTS, "Samples");
   graphic.CurvePlotAll();
   graphic.Update();
   Sleep(10 * 1000);
   ChartSetInteger(0, CHART_SHOW, true);
   graphic.Destroy();
   ChartRedraw(0);
  }
Para simplificar, elegiremos como distribución objetivo una distribución normal bidimensional N(μ, Σ) con los siguientes parámetros:
- vector de medias μ = [0, 0],
- matriz de covarianza Σ = { {1, 0.8}, {0.8, 1} }
Esta matriz refleja una fuerte correlación entre las dos variables, lo que complica el proceso de muestreo.
Para calcular el logaritmo de la densidad de la distribución objetivo, escribiremos la clase `BivariateNormalLogPDF`, que utiliza la fórmula estándar de la distribución normal multidimensional:
ln p(x) = −0,5(x − μ)^T Σ^−1(x − μ) − 0,5 ln |Σ| − ln (2π)
Como utilizamos el algoritmo simétrico RWM, la distribución auxiliar también debe ser simétrica. Esta distribución se implementa en la clase MultiRndWalkPropRND. El candidato x′ se genera a partir de una distribución normal isotrópica (circular) de la siguiente manera:x' = x + δ
donde:
- δ ∼ N(0, σ²*I),
- σ² = 1,
- I es la matriz identidad.
Esta elección se corresponde con el comportamiento de un paseo aleatorio centrado en el estado actual x.
El muestreo se lleva a cabo usando los siguientes parámetros:
- nsamples=5000, burnin=500, thin=10.
- Punto inicial: [1.0,1.0].
- Gráficos de traza de las muestras: gráficos de los valores x1(t) y x2(t) a lo largo de las iteraciones para evaluar la convergencia y la mezcla de la cadena,
- Función de autocorrelación (ACF): muestra la correlación entre muestras consecutivas para cada variable (x1, x2),
- Gráfico de dispersión: nube de muestras con elipses de confianza superpuestas (95 % y 99 %) de la distribución teórica N(μ, Σ).

Fig. 4: Gráfico de muestras bidimensionales y elipses de confianza
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from statsmodels.graphics.tsaplots import plot_acf
from matplotlib.patches import Ellipse
from scipy.linalg import eigh

# Ruta del archivo
file_path = "C:/Program Files/MetaTrader 5/MQL5/Files/MH_RW/MH_bivariate_samples.csv"

# Cargar datos
data = pd.read_csv(file_path, header=None)
samples_x1 = data.iloc[:, 0].values
samples_x2 = data.iloc[:, 1].values

# Estadísticas
print("=========================================")
print("MCMC Samples Analysis (MH_RW, Bivariate):")
print(f"Number of samples: {len(samples_x1)}")
print(f"Mean X1: {np.mean(samples_x1):.4f} (expected 0.0000)")
print(f"Mean X2: {np.mean(samples_x2):.4f} (expected 0.0000)")
print(f"Std. deviation X1: {np.std(samples_x1):.4f} (expected 1.0000)")
print(f"Std. deviation X2: {np.std(samples_x2):.4f} (expected 1.0000)")
print(f"Covariance: {np.cov(samples_x1, samples_x2)[0, 1]:.4f} (expected 0.8000)")
print("=========================================")

# Función de trazado de elipses
def plot_ellipse(mean, cov, ax, n_std=1.96, **kwargs):
    vals, vecs = eigh(cov)
    order = vals.argsort()[::-1]
    vals, vecs = vals[order], vecs[:, order]
    theta = np.degrees(np.arctan2(*vecs[:, 0][::-1]))
    width, height = 2 * n_std * np.sqrt(vals)
    ellipse = Ellipse(xy=mean, width=width, height=height, angle=theta, **kwargs)
    ax.add_patch(ellipse)

# Gráficos de traza y ACF
fig1, axes = plt.subplots(2, 2, figsize=(10, 8))
fig1.suptitle('MCMC Samples Analysis (Trace and ACF)', fontsize=16)

# Gráfico de traza para X1
axes[0, 0].plot(samples_x1)
axes[0, 0].set_title('Trace Plot (X1)')
axes[0, 0].set_xlabel('Iteration')
axes[0, 0].set_ylabel('X1')

# Gráfico de traza para X2
axes[0, 1].plot(samples_x2)
axes[0, 1].set_title('Trace Plot (X2)')
axes[0, 1].set_xlabel('Iteration')
axes[0, 1].set_ylabel('X2')

# ACF para X1
plot_acf(samples_x1, lags=50, ax=axes[1, 0], title='ACF (X1)')
axes[1, 0].set_xlabel('Lags')
axes[1, 0].set_ylabel('Correlation')

# ACF para X2
plot_acf(samples_x2, lags=50, ax=axes[1, 1], title='ACF (X2)')
axes[1, 1].set_xlabel('Lags')
axes[1, 1].set_ylabel('Correlation')

plt.tight_layout(rect=[0, 0.03, 1, 0.95])

# Gráfico de dispersión con elipses
fig2, ax = plt.subplots(figsize=(8, 8))
ax.scatter(samples_x1, samples_x2, s=10, alpha=0.5, label='Samples')
plot_ellipse([0, 0], np.array([[1, 0.8], [0.8, 1]]), ax, n_std=1.96, edgecolor='red', facecolor='none', label='95% Ellipse')
plot_ellipse([0, 0], np.array([[1, 0.8], [0.8, 1]]), ax, n_std=3.034, edgecolor='green', facecolor='none', label='99% Ellipse')
ax.set_title('Bivariate Scatter Plot with Ellipses')
ax.set_xlabel('X1')
ax.set_ylabel('X2')
ax.legend()
ax.grid(True)
ax.set_aspect('equal')

plt.show()
Distribución auxiliar asimétrica
Ejemplo n.º 3
Este ejemplo pone de manifiesto la necesidad de utilizar el algoritmo completo de Metropolis-Hastings. Esto se debe a que la distribución objetivo está definida únicamente para valores positivos, lo que requiere el uso de una distribución de propuesta asimétrica q.
Como distribución objetivo, elegiremos la distribución gamma unidimensional Gamma(α=3, β=2). Esta distribución solo está definida para x > 0.
#include <Math\Stat\Math.mqh>
#include <Math\Stat\Gamma.mqh>
#include <Math\Stat\Lognormal.mqh>
#include <Graphics\Graphic.mqh>
#include <MCMC\MH.mqh>

// Clase para la distribución gamma objetivo
class GammaLogPDF : public LogPDF
  {
public:
   virtual double    LogPdf(const vector &x) override
     {
      double alpha = 3.0; // Parámetro de forma
      double beta = 2.0;  // Parámetro de escala
      return alpha * MathLog(beta) - MathGammaLog(alpha) + (alpha - 1) * MathLog(x[0]) - beta * x[0];
     }
  };

//+--------------------------------------------------------------------------+
//| Clase para la distribución auxiliar asimétrica (lognormal) |
//+--------------------------------------------------------------------------+
class LogNormalPropRND : public PropRND
  {
public:
   virtual vector    PropRnd(const vector &x) override
     {
      double sigma = 2;
      double mu = MathLog(x[0]);
      vector x_new(1);
      int err;
      x_new[0] = MathRandomLognormal(mu, sigma, err);
      return x_new;
     }
  };

//+------------------------------------------------------------------+
//|Clase para el logaritmo de la densidad de la distribución de propuesta         |
//+------------------------------------------------------------------+
class LogNormalLogPropPDF : public LogPropPDF
  {
public:
   virtual double    LogPropPdf(const vector &x, const vector &y) override
     {
      double sigma = 2;
      double mu = MathLog(y[0]);
      int err;
      double log_pdf = MathProbabilityDensityLognormal(x[0], mu, sigma, true, err);
      return log_pdf;
     }
  };

//+------------------------------------------------------------------+
//| Gráfico de las muestras                                                   |
//+------------------------------------------------------------------+
void plotTrace(matrix &smp)
  {
   ChartSetInteger(0, CHART_SHOW, false);
   CGraphic graphic;
   ulong width = ChartGetInteger(0, CHART_WIDTH_IN_PIXELS);
   ulong height = ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS);
   graphic.Create(0, "MH_Gamma_MCMC", 0, 0, 0, int(width), int(height));
   graphic.BackgroundMain("Gamma Distribution Samples");
   graphic.BackgroundMainSize(16);

   vector x = smp.Col(0);
   double x_arr[], y_arr[];
   x.Swap(x_arr);
   graphic.CurveAdd(x_arr, CURVE_POINTS, "Samples");
   graphic.CurvePlotAll();
   graphic.Update();
   Sleep(10 * 1000);
   ChartSetInteger(0, CHART_SHOW, true);
   graphic.Destroy();
   ChartRedraw(0);
  }

//+------------------------------------------------------------------+
//| Función de inicio del script                                     |
//+------------------------------------------------------------------+
void OnStart()
  {
   vector start_point(1);
   start_point[0] = 1.5;
   GammaLogPDF target_pdf;
   LogNormalPropRND proposal_rnd;
   LogNormalLogPropPDF proposal_pdf;

   MH_Params params;
   params.nsamples = 5000;
   params.burnin = 500;
   params.thin = 10;
   params.symmetric = false;

   MHSampler sampler;
   matrix samples;
   double accept_rate;

   Print("Iniciando MH con una oferta no simétrica para Gamma(3, 2)...");
   if(sampler.MHSample(start_point, samples, accept_rate, &target_pdf, &proposal_rnd, &proposal_pdf, params))
     {
      PrintFormat("Tasa de aceptación: %.2f%%", accept_rate * 100.0);
      PrintFormat("Valor medio (se espera %.4f): %.4f", 3.0/2.0, samples.Mean(0)[0]);
      Print("Primeras 5 muestras:");
      for(int i = 0; i < 5; i++)
        {
         PrintFormat("Muestra %d: %.4f", i + 1, samples[i][0]);
        }
      MatrixToCSV("MH_RW/MH_gamma_samples.csv", samples);
      plotTrace(samples);
     }
  }
El logaritmo de la densidad, implementado en la clase GammaLogPDF (que hereda de la clase abstracta LogPDF), se calcula de la siguiente manera:
lnp(x) = αlnβ − lnΓ(α) + (α − 1)lnx − βx
Como distribución auxiliar q(x′∣x), tomaremos la distribución lognormal LogNormal(lnx,σ²). Esta distribución resulta naturalmente adecuada para generar candidatos positivos x′ a partir del estado positivo actual x, ya que centra el logaritmo de la nueva propuesta en el logaritmo del estado actual. Sin embargo, no es simétrica, por lo que debemos implementar dos clases:
- LogNormalPropRND para generar candidatos x′,
- LogNormalLogPropPDF para calcular el logaritmo de la densidad de la distribución de propuesta.
El muestreo se realiza con los siguientes parámetros:
- nsamples=5000, burnin=500, thin=10, symmetric=false,
- Punto inicial: x0 = 1,5
Para evaluar el funcionamiento del algoritmo en este ejemplo didáctico, comparamos los resultados empíricos con los valores teóricos conocidos de las características estadísticas de la distribución gamma:
- media esperada: E[X] = α/β = 1,5,
- varianza esperada: Var[X] = α/β² = 0,75
En problemas prácticos reales (cuando se desconocen las características exactas de p(x)), para evaluar la calidad de la cadena se utilizan, como es habitual, los gráficos de traza, la tasa de aceptación y la función de autocorrelación (ACF). Los resultados del script MQL5 muestran una convergencia satisfactoria; la tasa de aceptación se sitúa en el rango óptimo (≈30 %-40 %), y la media empírica se aproxima al valor esperado.

Fig. 5: Gráfico de traza e histogramas de las muestras con la densidad teórica gamma
Metropolis-Hastings independiente
Ejemplo n.º 4
El algoritmo de Metropolis-Hastings independiente (IMH) utiliza una distribución auxiliar independiente q(x'∣x)=q(x'), que no depende del estado actual x. Esta es una característica clave del IMH que lo distingue del MH de paseo aleatorio.
Como, por la independencia, q(x'∣x)=q(x') y q(x∣x')=q(x), el logaritmo del coeficiente de aceptación viene dado por:
r = ln(p(x')q(x) / p(x)q(x')) = [ lnp(x′) + lnq(x) ] − [ lnp(x) + lnq(x′) ]
El único requisito que debe cumplir el algoritmo IMH es que q(x′) cubra el soporte de la distribución objetivo p(x).
Como distribución objetivo se ha elegido la distribución beta Beta(α=2, β=5), definida en el intervalo unitario x∈[0,1]. El logaritmo de la densidad, implementado en la clase BetaLogPDF, se calcula utilizando el logaritmo de la función beta para garantizar la estabilidad numérica:
lnp*(x) = (α−1)lnx + (β−1)ln(1−x) − lnB(α, β)
Como distribución auxiliar q(x′), elegiremos la distribución uniforme Uniform(0,1). Esta elección se ajusta perfectamente al dominio de definición de la distribución beta objetivo (x∈[0,1]). La distribución de propuesta se implementa mediante dos clases:
- UniformPropRND: para generar candidatos x′ ∼ Uniform(0,1).
- UniformLogPropPDF: para calcular lnq(x′).
Una simplificación importante: dado que la densidad de una distribución uniforme es q(x) = 1 y q(x′) = 1 para x ∈ [0, 1], la relación q(x)/q(x′) es igual a 1, y su logaritmo es igual a 0. Así pues, en este caso concreto, el coeficiente de aceptación del IMH se simplifica a la forma de Metropolis:
r = ln p*(x′) − ln p*(x)
El muestreo se llevó a cabo con los siguientes parámetros:
- punto inicial: x0 = 0,3
- nsamples=5000, burnin=500, thin=10, symmetric=false (aunque en este caso no tiene importancia, ya que lnq(x)−lnq(x′)=0).
La ventaja clave del IMH radica en que puede desplazarse rápidamente a cualquier punto del espacio de estados, lo que, siempre que se elija adecuadamente q(x′), da lugar a una autocorrelación baja en comparación con el RWM.
Para evaluar el éxito del muestreo en este ejemplo didáctico, comparamos la media empírica obtenida a partir de la muestra con la media teórica conocida: E[X] = α + βα ≈ 0,2857.
Los resultados empíricos confirman el éxito del muestreo a partir de la distribución objetivo Beta(2,5).

Fig. 6: Gráfico de traza e histograma de las muestras con la densidad teórica beta
Elección del algoritmo MCMC MH: RWM frente a IMH
La elección entre Metropolis con paseo aleatorio (RWM) y Metropolis-Hastings independiente (IMH) depende del nivel de conocimiento previo que se tenga sobre la distribución objetivo p(x).
RWM es la opción más versátil y tiene mayor relevancia práctica.
El candidato x′ se genera como un «paseo aleatorio» en torno al estado actual x. Se aplica cuando se conoce mal la forma de la distribución objetivo o cuando el espacio es de alta dimensión y complejo (por ejemplo, multimodal). Requiere un ajuste minucioso de la escala de paso (δ o σ²) para alcanzar una tasa de aceptación óptima, con el fin de evitar una mezcla lenta (alta autocorrelación).
El IMH es un algoritmo más eficaz para generar muestras independientes, aunque requiere conocimientos previos.
El candidato x′ se genera a partir de una distribución auxiliar fija (independiente de x) q(x′). Se aplica cuando se consigue elegir un q(x′) que aproxime bien la distribución objetivo p(x). Si se elige adecuadamente q(x′), se consigue una mezcla muy rápida de la cadena (baja autocorrelación). Sin embargo, si q(x′) no cubre las colas de p(x), la cadena puede atascarse, lo que daría lugar a resultados erróneos.
Conclusión
El algoritmo de Metropolis-Hastings —un método de Monte Carlo basado en cadenas de Markov (MCMC)— permite generar muestras a partir de distribuciones complejas para las que no es posible el muestreo directo. En este artículo se analizan tanto los fundamentos teóricos del algoritmo como su implementación en el lenguaje MQL5 en forma de la clase MHSampler. Esta clase permite al usuario, al implementar la lógica para la distribución objetivo (LogPDF) y la generación de propuestas (PropRND, LogPropPDF), adaptar fácilmente el algoritmo a diferentes variantes de MCMC, entre ellas Metropolis con paseo aleatorio y Metropolis-Hastings independiente.
Para ilustrar de forma clara el funcionamiento del algoritmo, se utilizaron distribuciones unidimensionales y bidimensionales como distribuciones objetivo. La calidad de las muestras generadas se evaluó utilizando herramientas de diagnóstico estándar: gráficos de traza, histogramas y funciones de autocorrelación generados en Python.
La tasa de aceptación (acceptance rate) servía como indicador clave de la eficacia de la cadena y se utilizaba para optimizar la escala de la distribución de propuesta q(x′∣x), determinada, por ejemplo, por la desviación típica en el caso de la distribución normal o por la amplitud del intervalo en el caso de la distribución uniforme. La elección correcta de la escala es fundamental: una distribución demasiado estrecha ralentiza la exploración del espacio de estados, aumentando la autocorrelación de las muestras, mientras que una distribución demasiado amplia reduce la tasa de aceptación, lo que disminuye la eficiencia computacional.
Aunque el algoritmo se caracteriza por su versatilidad, su eficacia disminuye en problemas multidimensionales y cuando existe una fuerte correlación entre las variables. En estos casos, son preferibles métodos más especializados, como el método híbrido de Monte Carlo (HMC) o el muestreo por rebanadas (slice sampling), que aprovechan mejor la geometría de la distribución objetivo y requieren menos ajustes manuales. No obstante, gracias a su sencillez, el algoritmo de Metropolis-Hastings sigue siendo una herramienta básica muy utilizada en la inferencia bayesiana.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | MH.mqh | Archivo de inclusión | El algoritmo de Metropolis-Hastings |
| 2 | Exmp1_MH_RW.mq5 | Script | Ejemplo de muestreo de una distribución unidimensional mediante RWM |
| 3 | Exmp1_Plot_MH_RW.py | Script | Diagnóstico en Python |
| 4 | Exmp2_MH_RW.mq5 | Script | Ejemplo de muestreo de una distribución bidimensional mediante el algoritmo RWM |
| 5 | Exmp2_Plot_MH_RW.py | Script | Diagnóstico en Python |
| 6 | Exmp3_MH_RW.mq5 | Script | Ejemplo de muestreo de una distribución unidimensional con una distribución de propuesta asimétrica |
| 7 | Exmp3_Plot_MH_RW.py | Script | Diagnóstico en Python |
| 8 | Exmp4_IMH.mq5 | Script | Ejemplo de muestreo de una distribución unidimensional mediante el algoritmo IMH |
| 9 | Exmp4_Plot_IMH.py | Script | Diagnóstico en Python |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/20008
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.