

Mapas autoorganizados de Kohonen en un asesor experto de MQL5
 26
 1

Introducción: en busca del orden invisible
Imagine que está mirando el gráfico de un par de divisas. Miles de velas, millones de puntos de datos, un flujo interminable de cifras. En algún lugar de este caos se esconden patrones, regularidades y estructuras recurrentes. Pero el cerebro humano no es capaz de tener en mente miles de velas a la vez y encontrar conexiones entre ellas. Necesitamos un mapa de este caos. Necesitamos una estructura que nos permita ver dónde se agrupan las situaciones de mercado similares y dónde comienza algo fundamentalmente nuevo.
Precisamente para ello, el científico finlandés Teuvo Kohonen inventó en 1982 los mapas autoorganizados (Self-Organizing Maps o SOM). No es simplemente otra red neuronal más. Es una forma de hacer que el ordenador perciba la estructura invisible de los datos, encuentre orden en el caos y cree un mapa bidimensional de un espacio multidimensional. Y lo más interesante es que esta tecnología, ideada hace cuarenta años para el análisis del habla, resultó ser ideal para el análisis de los mercados financieros.
Qué son los mapas autoorganizados: la geografía del caos del mercado
Empecemos con una analogía sencilla. Imagine que es geógrafo y que tiene que elaborar un mapa de una zona desconocida. Dispone de las coordenadas de miles de puntos, mediciones de altitud, temperatura y humedad: una gran cantidad de parámetros para cada punto. ¿Cómo convertir este montón de números en un mapa bidimensional claro, en el que los lugares similares estén cerca unos de otros y los diferentes, lejos entre sí?
El mapa autoorganizado de Kohonen hace precisamente eso, pero con datos de mercado. Disponemos de un espacio multidimensional de características: precios, volúmenes, volatilidad, variaciones en distintos periodos e indicadores técnicos. Cada vela del gráfico es un punto en este espacio multidimensional. SOM toma todos estos puntos y los proyecta en una rejilla bidimensional de neuronas, conservando al mismo tiempo la topología: las situaciones de mercado similares se sitúan en neuronas adyacentes del mapa.
La magia comienza durante el proceso de aprendizaje. La red está formada por una rejilla bidimensional de neuronas, por ejemplo, de veinte por veinte, es decir, cuatrocientas neuronas. Cada neurona tiene un vector de pesos de la misma dimensión que los datos de entrada. Cuando le mostramos a la red un nuevo patrón del mercado, esta encuentra la neurona con los pesos más similares; esta neurona se denomina «Best Matching Unit» o BMU. Entonces ocurre la magia: no solo la BMU actualiza sus pesos para parecerse aún más al patrón de entrada, sino que sus vecinas en el mapa también se desplazan en la misma dirección. Cuanto más lejos se está de la BMU, menor es su influencia.
Tras aprender de miles de situaciones de mercado, el mapa se autoorganiza. Las neuronas de una esquina del mapa pueden ser responsables de fuertes tendencias alcistas; en otra esquina, de caídas bajistas; y en el centro, de movimientos laterales e incertidumbre. El mapa crea una especie de geografía de los estados del mercado, en la que la distancia entre las neuronas refleja el grado de diferencia entre los patrones.
Por qué los SOM son ideales para el trading: las ventajas de la topología
Las redes neuronales tradicionales para la clasificación, como el perceptrón multicapa o las redes convolucionales, funcionan según el principio de la «caja negra». Usted les ofrece datos y ellas le devuelven una predicción, pero lo que ocurre en su interior es un misterio. Los SOM son diferentes. Le ofrecen visualización, comprensión y estructura. Puede consultar el mapa y ver en qué zona del espacio de patrones se encuentra la situación actual del mercado. Puede seguir cómo el mercado se desplaza por el mapa de un estado a otro.
Y lo que es aún más importante, los SOM conservan la topología. Si dos patrones de mercado son similares, se encontrarán en neuronas adyacentes. Esto significa que la red no se limita a clasificar: forma clústeres, agrupa y encuentra límites naturales entre los distintos tipos de comportamiento del mercado. Esto es unsupervised learning, es decir, aprendizaje no supervisado. No es necesario que etiquete los datos de antemano en las categorías «tendencia alcista», «tendencia bajista» o «movimiento lateral». La red encontrará por sí misma estas clases y determinará por sí misma los límites entre ellas.
Los SOM también son resistentes al ruido. Los datos del mercado contienen ruido por definición: valores atípicos aleatorios, huecos de cotización, manipulaciones y picos provocados por las noticias. Las redes neuronales convencionales pueden presentar sobreajuste debido a este ruido. Los SOM, gracias a la actualización de las vecindades de las neuronas, promedian el ruido e identifican patrones estables.
Arquitectura SOM en MQL5: creación de un mapa neuronal
Veamos cómo se ha implementado el mapa autoorganizado en el código del asesor experto de trading. Empecemos por los parámetros básicos:
#define SOM_WIDTH 20
#define SOM_HEIGHT 20
#define SOM_NEURONS (SOM_WIDTH * SOM_HEIGHT)

struct QuantumProcessor {
    matrix som_weights;           // Pesos del SOM [SOM_NEURONS x input_dim]
    double learning_rate_som;
    double neighborhood_radius;

    void Init() {
        learning_rate_som = 0.1;
        neighborhood_radius = 5.0;
        som_weights = matrix::Zeros(SOM_NEURONS, FEATURES_COUNT);
        InitializeRandomMatrix(som_weights, -0.5, 0.5);
    }
Un mapa de veinte por veinte neuronas nos ofrece cuatrocientos puntos en el espacio de clasificación. Cada neurona tiene un vector de pesos de dimensión FEATURES_COUNT: cuatrocientas características extraídas de los datos de mercado. La inicialización de los pesos con valores aleatorios comprendidos entre −0,5 y +0,5 genera una diversidad inicial en el mapa.
Los parámetros clave del aprendizaje son una tasa de aprendizaje de 0,1 y un radio de vecindad de 5,0. El radio de la vecindad determina hasta qué distancia de la Best Matching Unit se extiende la influencia al actualizar los pesos. Un radio amplio al inicio del aprendizaje permite que el mapa se organice de forma aproximada. A medida que avanza el aprendizaje, se puede reducir el radio para realizar ajustes precisos.
Búsqueda de la «Best Matching Unit»: el núcleo del algoritmo
La operación más importante en SOM es la búsqueda de la neurona más parecida al patrón de entrada:
int FindBestMatchingUnit(const vector &_input) {
    int bmu = 0;
    double min_distance = DBL_MAX;

    for(int i = 0; i < SOM_NEURONS; i++) {
        vector neuron_weights = som_weights.Row(i);
        double distance = 0.0;

        for(ulong j = 0; j < MathMin(_input.Size(), neuron_weights.Size()); j++) {
            double diff = _input[j] - neuron_weights[j];
            distance += diff * diff;
        }

        if(distance < min_distance) {
            min_distance = distance;
            bmu = i;
        }
    }
    return bmu;
}
El algoritmo es sencillo y elegante. Así, recorremos las cuatrocientas neuronas del mapa y, para cada una de ellas, calculamos la distancia euclidiana entre los pesos de la neurona y el vector de entrada. Calcular la distancia al cuadrado es más rápido que extraer además la raíz cuadrada, y basta para comparar las distancias. La neurona con la distancia mínima se convierte en la ganadora: la BMU.
Se trata de una operación cuya complejidad es lineal con respecto al número de neuronas. Para un mapa de 20 por 20 y 400 características, una iteración de la búsqueda de la BMU requiere 160 000 operaciones de multiplicación y suma. En los procesadores actuales, esto se realiza en microsegundos. Es importante destacar que esta operación es determinista: para una misma entrada siempre se encontrará la misma BMU (siempre que los pesos no hayan cambiado).
Actualización de los pesos: la danza de las neuronas
Una vez localizada la BMU, comienza lo más interesante: la actualización de los pesos de la vecindad:
void UpdateSOMWeights(const vector &_input, int bmu) {
    int bmu_x = bmu % SOM_WIDTH;
    int bmu_y = bmu / SOM_WIDTH;

    for(int i = 0; i < SOM_NEURONS; i++) {
        int neuron_x = i % SOM_WIDTH;
        int neuron_y = i / SOM_WIDTH;

        double distance = MathSqrt((neuron_x - bmu_x) * (neuron_x - bmu_x) +
                                 (neuron_y - bmu_y) * (neuron_y - bmu_y));

        if(distance <= neighborhood_radius) {
            double influence = MathExp(-(distance * distance) /
                              (2.0 * neighborhood_radius * neighborhood_radius));

            for(ulong j = 0; j < MathMin(_input.Size(), som_weights.Cols()); j++) {
                som_weights[i][j] += learning_rate_som * influence *
                                   (_input[j] - som_weights[i][j]);
            }
        }
    }
}
El código implementa la función clásica de vecindad con núcleo gaussiano. En primer lugar, calculamos las coordenadas de la BMU en el mapa bidimensional: el resto de dividir el índice por la anchura da la coordenada x, y la división entera del índice por la anchura da la coordenada y. A continuación, para cada neurona calculamos la distancia euclidiana hasta la BMU en las coordenadas del mapa (¡no en el espacio de características!).
Si la distancia es menor que el radio de la vecindad, la neurona queda bajo su influencia. El grado de influencia viene determinado por una función gaussiana: la exponencial del negativo del cuadrado de la distancia. En el centro (la propia BMU), la influencia es máxima y es igual a uno. En el límite del radio, la influencia se reduce casi a cero. Esta función suave crea una topología suave: las neuronas se actualizan de forma proporcional a su proximidad al ganador.
La regla final de aprendizaje es la clásica regla delta. El nuevo peso es igual al peso anterior más la tasa de aprendizaje multiplicada por la influencia y por la diferencia entre la entrada y el peso actual. Esta regla aproxima el vector de pesos de la neurona al vector de entrada. Cuanto más cerca está una neurona de la BMU, mayor es la fuerza de atracción. Cuanto más lejos está, más débil es la atracción.
Integración del SOM en el sistema de negociación: efectos cuánticos
Una particularidad de la implementación en el asesor experto es la integración del SOM como parte de un «procesador cuántico», que añade efectos adicionales al SOM básico:
matrix ApplyQuantumEffects(const matrix &input_data, const matrix &context_data) {
    matrix result = matrix::Zeros(input_data.Rows(), input_data.Cols());

    for(ulong i = 0; i < input_data.Rows(); i++) {
        vector input_row = input_data.Row(i);

        // Encontramos la BMU para la entrada actual
        int bmu = FindBestMatchingUnit(input_row);

        // Actualizamos los pesos del SOM
        UpdateSOMWeights(input_row, bmu);

        // Obtenemos la activación de la BMU
        vector bmu_weights = som_weights.Row(bmu);

        // Aplicamos efectos clásicos + activación SOM
        for(ulong j = 0; j < input_data.Cols(); j++) {
            double input_val = input_data[i][j];
            double context_val = (i < context_data.Rows() && j < context_data.Cols()) ?
                                context_data[i][j] : 0.0;

            // Efecto SOM
            double som_factor = 1.0;
            if(j < bmu_weights.Size()) {
                som_factor += (bmu_weights[j] - input_val) * coherence * 0.1;
            }

            // Efectos clásicos
            double resonance = 1.0 + resonance_strength *
                             MathCos(input_val * context_val * M_PI);
            double interference = interference_amplitude *
                                MathSin(input_val * context_val * 2.0 * M_PI);
            double coherent_factor = coherence + (1.0 - coherence) *
                                   MathExp(-decoherence_rate * i);

            result[i][j] = input_val * resonance * coherent_factor *
                         som_factor + interference;
        }
    }

    return result;
}
El término «efectos cuánticos» es, por supuesto, una metáfora. Aquí no hay ningún tipo de computación cuántica real. Pero la idea es interesante: a la salida del SOM se aplican transformaciones adicionales que simulan la resonancia, la interferencia y la coherencia. El SOM identifica patrones similares y los agrupa, mientras que los efectos adicionales aportan no linealidad y dependencia contextual.
El efecto SOM calcula la diferencia entre los pesos de la BMU y los datos de entrada, la multiplica por el parámetro de coherencia y la suma al coeficiente básico. Esto genera una retroalimentación: si el patrón actual está lejos del centro del clúster (de los pesos de la BMU), la salida se amplifica o se atenúa. La resonancia se simula mediante el coseno del producto de la entrada y el contexto. La interferencia se añade como un componente sinusoidal. El factor de coherencia se atenúa exponencialmente con el índice, simulando la pérdida de memoria.
Aprendizaje a partir de datos históricos: de las barras a los patrones
El proceso de entrenamiento del asesor experto comienza con su inicialización:
void TrainSOMNetwork() {
    matrix training_data = matrix::Zeros(TrainingBars, FEATURES_COUNT);
    vector targets = vector::Zeros(TrainingBars);

    MqlRates rates[];
    ArraySetAsSeries(rates, true);

    if(CopyRates(Symbol(), Period(), 0, TrainingBars + 50, rates) < TrainingBars + 50) {
        Print("Failed to copy rates for training");
        return;
    }

    for(int i = 0; i < TrainingBars; i++) {
        vector features = vector::Zeros(FEATURES_COUNT);

        // Características básicas
        double price_change = (rates[i].close - rates[i].open) / rates[i].open;
        double volatility = 0.0;
        for(int j = i; j < i + 10 && j < ArraySize(rates); j++) {
            double change = (rates[j].close - rates[j].open) / rates[j].open;
            volatility += change * change;
        }
        volatility = MathSqrt(volatility / 10.0);

        double volume_ratio = (rates[i].tick_volume > 0) ?
            MathLog(1.0 + rates[i].tick_volume / 1000.0) : 0.0;

        features[0] = MathMax(-1.0, MathMin(1.0, price_change * 100));
        features[1] = MathMax(0.0, MathMin(1.0, volatility * 100));
        features[2] = MathMax(0.0, MathMin(1.0, volume_ratio / 10.0));
Las tres primeras características son las básicas. Variación del precio de la barra actual, normalizada en un intervalo comprendido entre menos uno y más uno. La volatilidad de las últimas diez barras, calculada como la desviación estándar de las variaciones, normalizada entre cero y uno. El volumen en una escala logarítmica, también normalizado.
A continuación, se añaden características adicionales —las variaciones de precios y los rangos de las veinte barras anteriores—, lo que crea una ventana temporal para analizar el historial a corto plazo. Un total de cuatrocientas características por cada barra. Se trata de una representación multidimensional de la situación del mercado que el SOM aprenderá a agrupar en clústeres.
Creación de valores objetivo: predecir el futuro
El punto clave del aprendizaje es la definición de la variable objetivo. ¿Qué queremos predecir?
// NUEVO VALOR OBJETIVO: variación del precio tras N barras (por defecto, 24)
if(i + TargetBarsLookahead < ArraySize(rates)) {
    double current_price = rates[i].close;
    double future_price = rates[i + TargetBarsLookahead].close;
    double price_change_percent = (current_price - future_price) / future_price * 100.0;

    // Definimos el valor objetivo basándonos en umbrales personalizables
    if(price_change_percent > BullishThreshold) {        // Crecimiento superior al umbral
        targets[i] = 0.8;
    }
    else if(price_change_percent < BearishThreshold) {   // Caída superior al umbral
        targets[i] = 0.2;
    }
    else {                                               // Movimiento lateral
        targets[i] = 0.5;
    }
}
El sistema examina un número configurable de barras futuras (veinticuatro por defecto) y calcula la variación porcentual del precio. Si la variación supera el umbral de crecimiento (por defecto, el 0,5 %), el valor objetivo se fija en 0,8, lo que constituye una fuerte señal alcista. Si la caída supera el umbral (por defecto, −0,5 %), el valor objetivo se fija en 0,2, lo que constituye una fuerte señal bajista. Todo lo demás se clasifica como un movimiento lateral con un valor objetivo de 0,5.
Esta clasificación en tres categorías proporciona a la red unos objetivos de aprendizaje claros. El SOM agrupa las situaciones de mercado que conducen al crecimiento en una zona del mapa, las situaciones previas a una caída en otra zona y la incertidumbre en una tercera. Tras el entrenamiento con miles de ejemplos, el mapa se convierte en una herramienta predictiva.
El proceso de predicción: de las características a la señal
Cuando el asesor experto recibe un nuevo «tick», extrae las características y hace una predicción:
double GetSOMPrediction(double &confidence) {
    vector feature_data = vector::Zeros(FEATURES_COUNT);

    MqlRates rates[];
    ArraySetAsSeries(rates, true);

    if(CopyRates(Symbol(), Period(), 0, 50, rates) < 50) {
        Print("Failed to copy rates");
        return -1;
    }

    // Asignamos los valores de las características
    double price_change = (rates[0].close - rates[1].close) / rates[1].close;
    double volatility = 0.0;
    for(int i = 0; i < 10; i++) {
        double change = (rates[i].close - rates[i].open) / rates[i].open;
        volatility += change * change;
    }
    volatility = MathSqrt(volatility / 10.0);

    double volume_ratio = (rates[0].tick_volume > 0) ?
        MathLog(1.0 + rates[0].tick_volume / 1000.0) : 0.0;

    feature_data[0] = MathMax(-1.0, MathMin(1.0, price_change * 100));
    feature_data[1] = MathMax(0.0, MathMin(1.0, volatility * 100));
    feature_data[2] = MathMax(0.0, MathMin(1.0, volume_ratio / 10.0));

    return g_som_net.Predict(feature_data, confidence);
}
La extracción de características es idéntica a lo que se hizo durante el entrenamiento: variación del precio, volatilidad, volumen, además de los valores históricos. El vector de características se transmite al método «Predict» de la red neuronal, que recorre toda la arquitectura: el SOM localiza la BMU, se aplican los efectos cuánticos, los datos se procesan mediante bloques de Transformer y, en la salida, se obtiene una predicción comprendida entre cero y uno.
Un valor cercano a 0,8 significa que la situación actual del mercado es similar a aquellas situaciones de la muestra de entrenamiento que fueron seguidas de un repunte. Un valor cercano a 0,2 indica una probable caída. Un valor cercano a 0,5 indica incertidumbre: el mercado se encuentra en un movimiento lateral o a punto de dar un giro.
Procesamiento de señales y apertura de posiciones
La lógica para la toma de decisiones de trading se basa en la predicción y el nivel de confianza del modelo:
void ProcessSignals(double prediction, double confidence) {
    if(TimeCurrent() - g_last_signal_time < PeriodSeconds(Period())) return;

    int positions = CountPositions();

    if(confidence >= MinConfidence && prediction >= 0.6 && positions == 0) {
        if(OpenPosition(ORDER_TYPE_BUY)) {
            g_last_signal_time = TimeCurrent();
            Print("SOM BUY: Prediction=", DoubleToString(prediction*100,1),
                  "%, Confidence=", DoubleToString(confidence*100,1), "%");
        }
    }
    else if(confidence >= MinConfidence && prediction <= 0.4 && positions == 0) {
        if(OpenPosition(ORDER_TYPE_SELL)) {
            g_last_signal_time = TimeCurrent();
            Print("SOM SELL: Prediction=", DoubleToString(prediction*100,1),
                  "%, Confidence=", DoubleToString(confidence*100,1), "%");
        }
    }
}
El asesor experto solo abre una posición si se cumplen tres condiciones: la confianza del modelo es superior al umbral mínimo (por defecto, el 65 %), la predicción es lo suficientemente sólida (superior a 0,6 para comprar o inferior a 0,4 para vender) y no hay posiciones abiertas. Esta lógica conservadora minimiza las entradas falsas.
El parámetro de confianza se calcula mediante un metamodelo que evalúa el grado de fiabilidad de la predicción actual, basándose en la precisión histórica del modelo y en las características del patrón actual. Un nivel bajo de confianza puede significar que el patrón no se parece a nada de la muestra de entrenamiento: el modelo se encuentra en territorio desconocido y es mejor abstenerse de operar.
El aprendizaje continuo: la adaptación al mercado
Los mercados cambian. Los patrones que funcionaban hace un año pueden haber quedado obsoletos. Por ello, el asesor experto permite el aprendizaje continuo:
input bool     ContinuousLearning = true; // Retrain periodically
input int      RetrainHours = 12;        // Retrain every N hours

void OnTick() {
    if(!g_net_initialized) return;
    if(!IsNewBar()) return;

    if(ContinuousLearning && ShouldRetrain()) {
        Print("Retraining SOM...");
        TrainSOMNetwork();
        g_last_retrain_time = TimeCurrent();
        Print("SOM retrained!");
    }
Cada doce horas (intervalo configurable), el asesor experto inicia un reentrenamiento con datos históricos recientes. El mapa SOM se actualiza para adaptarse a las nuevas condiciones del mercado. Los patrones antiguos no se olvidan por completo: los pesos de las neuronas cambian gradualmente, conservando la estructura acumulada, pero añadiendo nueva información.
Este mecanismo es fundamental para la estabilidad a largo plazo del sistema de trading. Un modelo estático, entrenado una sola vez, tarde o temprano se degrada. El modelo adaptativo, que aprende constantemente a partir de datos recientes, sigue siendo relevante.
Visualización de un mapa SOM: ver lo invisible
Una de las principales ventajas de los mapas SOM es la posibilidad de visualización. Tras el entrenamiento, se puede construir una matriz U (matriz de distancias unificada), que muestra las distancias entre neuronas vecinas. Las zonas oscuras de la matriz U son los límites entre los clústeres, mientras que las zonas claras son regiones homogéneas con patrones similares.
También se puede colorear el mapa según la media de los valores objetivo asignados a cada neurona. Las neuronas rojas corresponden a la zona de los patrones bajistas, las verdes a los patrones alcistas y las grises a los patrones laterales. Este mapa se convierte en una herramienta para el operador: al observar en qué neurona se enmarca la situación actual, se puede evaluar de inmediato la dirección probable del movimiento.
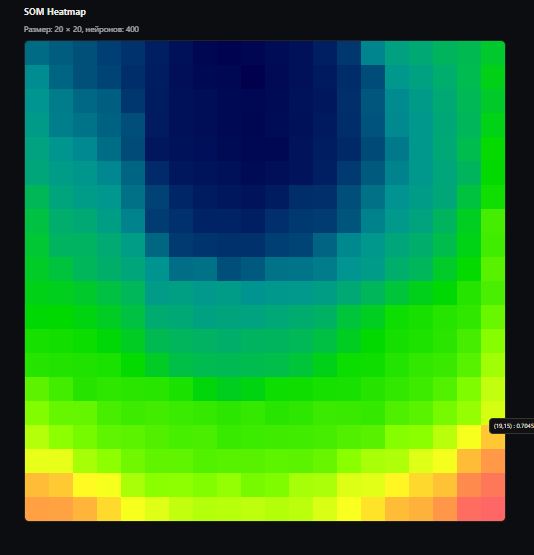
En la implementación del asesor experto, la visualización se lleva a cabo mediante la exportación de un mapa HTML interactivo: un mapa térmico SOM con información al pasar el cursor y función de zoom. Se trata de una página web autónoma generada en MQL5 sin bibliotecas externas. Tras el entrenamiento (o al pulsar la tecla de acceso rápido «H» en el gráfico), el método ExportSOMHTML calcula la norma L2 de los pesos de cada neurona (como medida de la «fuerza» o densidad estructural del clúster), normaliza los valores en [0..1] y guarda un archivo HTML en el directorio común del terminal (Common\Files\SOM_map.html).
El código de exportación es sencillo y eficaz:
bool ExportSOMHTML(const string filename = "SOM_map.html") {
    // Comprobación de la inicialización
    if(input_quantum_proc.som_weights.Rows() != SOM_NEURONS) {
        Print("ExportSOMHTML: som_weights not initialized");
        return false;
    }

    // Cálculo de las normas L2 para un mapa térmico
    vector vals = vector::Zeros(SOM_NEURONS);
    double vmin = DBL_MAX, vmax = -DBL_MAX;
    for(int i = 0; i < SOM_NEURONS; i++) {
        double s = 0.0;
        for(ulong j = 0; j < input_quantum_proc.som_weights.Cols(); j++) {
            double w = input_quantum_proc.som_weights[i][j];
            s += w * w;
        }
        s = MathSqrt(s);
        vals[i] = s;
        if(s < vmin) vmin = s;
        if(s > vmax) vmax = s;
    }

    // Normalización y escritura de HTML
    double range = (vmax > vmin) ? (vmax - vmin) : 1.0;
    int h = FileOpen(filename, FILE_WRITE | FILE_TXT | FILE_COMMON, CP_UTF8);
    if(h == INVALID_HANDLE) {
        Print("ExportSOMHTML: cannot open file: ", filename);
        return false;
    }

    // Generación de HTML con Canvas y JS para la visualización
    // ... (código HTML completo con una paleta HSL que va del azul al rojo, interacción al pasar el cursor y ajuste de tamaño)

    FileClose(h);
    Print("SOM map exported to Common\\Files\\", filename);
    return true;
}
El archivo se abre haciendo doble clic en la plataforma MT5 o en cualquier navegador. El mapa de 20×20 casillas se colorea desde el azul «frío» (norma de los pesos baja: clústeres débiles o vacíos) hasta el rojo «caliente» (norma alta: patrones densos y activos). Pase el cursor por encima de una celda y verá las coordenadas (x, y) y la intensidad normalizada (0,0000–1,0000). El tamaño se adapta automáticamente: en una pantalla grande, las celdas son más grandes; en un móvil, son más pequeñas.
Esta representación gráfica es clave para interpretar el modelo. Por ejemplo, si la BMU actual cae en la zona roja «caliente» con una norma elevada, esto indica la presencia de un clúster fuerte de patrones (alcistas o bajistas). Si está en azul, significa que el mercado se encuentra en una zona poco común e incierta, en la que es mejor no operar.
Comparación con otros métodos: en qué aspectos destaca el SOM
El análisis técnico clásico utiliza indicadores predefinidos: el RSI, el MACD y las bandas de Bollinger. Estos indicadores han sido creados por personas a partir de hipótesis sobre el comportamiento del mercado. El SOM no da nada por sentado de antemano. Aprende a partir de los datos y detecta patrones que realmente funcionan, y no aquellos que creemos que funcionan.
Las redes neuronales simples de propagación directa (redes feedforward) requieren datos etiquetados: hay que indicar la respuesta correcta para cada ejemplo. El SOM es un método de aprendizaje no supervisado (unsupervised learning). Puede funcionar también en modo supervisado (como en nuestro asesor experto), pero su principal ventaja es su capacidad para detectar por sí mismo la estructura de los datos.
Las redes neuronales profundas (LSTM, GRU, Transformers) requieren enormes volúmenes de datos y recursos computacionales. El SOM es compacto, rápido y puede entrenarse incluso con muestras pequeñas. Las cuatrocientas neuronas del mapa se entrenan en cuestión de minutos en un ordenador normal, y la predicción se realiza en milisegundos.
Random Forest y el «gradient boosting» funcionan muy bien con datos tabulares, pero no conservan bien la topología. Crean árboles de decisión que dividen el espacio de características en áreas rectangulares. El SOM genera un mapa suave y continuo en el que los patrones similares se sitúan próximos entre sí. Esta propiedad es de vital importancia para los datos financieros, en los que pequeños cambios en las características no deben provocar variaciones bruscas en las predicciones.
Limitaciones y problemas: la realidad frente a la teoría
Al igual que cualquier tecnología, SOM no es la panacea. El primer problema es el tamaño del mapa. Un mapa demasiado pequeño (por ejemplo, de diez por diez neuronas) no podrá reflejar toda la complejidad de los patrones del mercado. Un mapa demasiado grande (por ejemplo, de cien por cien) presentará sobreajuste y se entrenará lentamente. El tamaño óptimo se determina de forma experimental.
El segundo problema es el número de épocas de entrenamiento. Si hay muy pocas épocas, el mapa no tendrá tiempo de organizarse; si hay demasiadas, se producirá un sobreajuste. En nuestro asesor experto se utilizan solo tres épocas en el aprendizaje continuo, lo que supone un equilibrio entre la adaptación y la estabilidad.
El tercer problema es la normalización de las características. El SOM es sensible a la escala de los datos. Si una característica tiene valores comprendidos entre cero y cien, y otra entre cero y uno, la primera característica dominará al calcular las distancias. Es necesario normalizar minuciosamente todas las características dentro de un mismo rango.
El cuarto problema es la dependencia temporal. El SOM clásico no tiene en cuenta el orden temporal de los datos: cada patrón se procesa de forma independiente. En el caso de las series temporales financieras, esta es una limitación. Nuestro asesor experto resuelve parcialmente el problema añadiendo retardos históricos a las características e integrando el SOM con bloques de Transformer que procesan secuencias.
Perspectivas de futuro: hacia dónde avanzar
Los mapas autoorganizados son solo el principio. Existen variaciones del algoritmo clásico de Kohonen que se pueden integrar en el asesor experto. Por ejemplo, Growing Neural Gas es un algoritmo que añade y elimina neuronas de forma dinámica durante el proceso de aprendizaje, adaptando automáticamente el tamaño del mapa a la complejidad de los datos.
Los mapas temporales de Kohonen añaden conexiones temporales entre las neuronas, lo que permite que el mapa memorice no solo patrones, sino también secuencias de patrones. Esto resulta fundamental para predecir las tendencias del mercado, en las que no solo es importante la situación actual, sino también la trayectoria que ha seguido el mercado hasta llegar a ella.
Los SOM jerárquicos crean varios niveles de mapas, en los que el nivel superior agrupa a las neuronas del nivel inferior en metaclústeres. Esto permite captar la estructura del mercado en diferentes escalas temporales, desde las fluctuaciones a escala de minutos hasta las tendencias semanales.
La integración de los SOM con otras técnicas de aprendizaje profundo abre aún más posibilidades. Se puede utilizar una red SOM como primera capa de extracción de características antes de una red LSTM. Es posible entrenar conjuntos de mapas SOM en diferentes marcos temporales y combinar sus predicciones. Se puede aplicar el aprendizaje por refuerzo sobre un mapa SOM, de modo que el agente aprenda estrategias de negociación utilizando los estados del mercado clasificados por el mapa.
Recomendaciones prácticas: cómo utilizar el asesor experto
Si decide probar o utilizar el asesor experto SOM, empiece por ajustar minuciosamente los parámetros de aprendizaje. El parámetro TrainingBars determina cuántas barras históricas se deben utilizar para el entrenamiento: dos mil es el mínimo, cuatro mil es mejor. TargetBarsLookahead determina el horizonte de predicción: veinticuatro barras en un gráfico horario equivalen a una previsión a un día vista.
Los umbrales «BullishThreshold» y «BearishThreshold» son críticos. Unos umbrales demasiado bajos (por ejemplo, el 0,1 %) darán lugar a una gran cantidad de señales débiles. Si son demasiado altos (por ejemplo, el 2 por ciento), las señales serán poco frecuentes. Los valores óptimos dependen de la volatilidad del instrumento y del marco temporal.
El parámetro MinConfidence filtra las predicciones con un nivel de confianza bajo. El valor 0,65 significa que el asesor experto operará únicamente cuando la confianza del modelo sea superior al 65 por ciento. Esto reduce el número de operaciones, pero mejora su calidad. Al realizar pruebas con datos históricos, observe la relación entre la tasa de operaciones ganadoras y el factor de beneficio para distintos valores de este parámetro.
Asegúrese de utilizar el aprendizaje continuo (ContinuousLearning = true) cuando opere con una cuenta real. Los mercados evolucionan, y un modelo estático quedará obsoleto rápidamente. El parámetro RetrainHours = 12 indica que el reentrenamiento se realiza dos veces al día, lo que supone un equilibrio razonable entre la adaptación y la estabilidad.
Veamos, pues, la prueba de nuestro sistema:
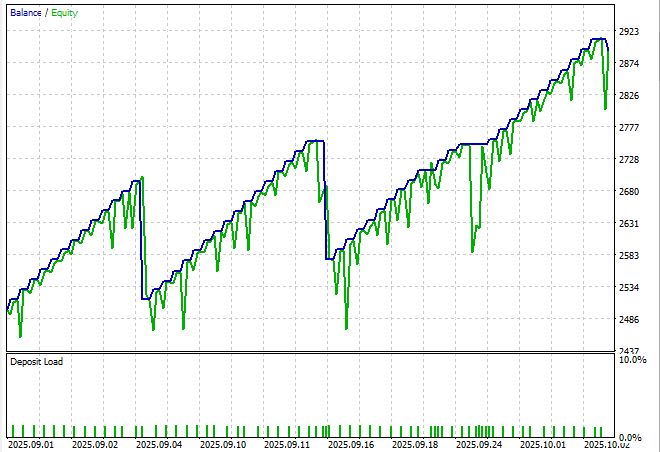
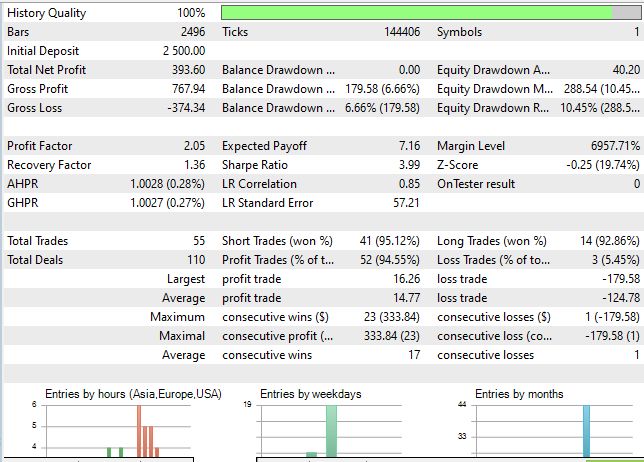
El gráfico no es que sea muy bonito, pero hay que tener en cuenta que se ha obtenido sin ninguna optimización y con los parámetros elegidos sin un criterio concreto. Y, sin embargo, el ratio de Sharpe estuvo a punto de alcanzar el valor de 4:
Conclusión: cartografía neuronal de las finanzas
Los mapas autoorganizados de Kohonen son una herramienta elegante para analizar datos complejos y multidimensionales. Creados hace cuarenta años para el reconocimiento del habla, han encontrado aplicación en cientos de ámbitos, desde la bioinformática hasta la sociología. Y, como se ha visto, resultan muy adecuados para el análisis de los mercados financieros.
El asesor experto cuyo código hemos analizado muestra una de las formas de aplicar SOM en el trading algorítmico. No se trata de un sistema de trading listo para operar, sino de una plataforma de investigación que muestra las posibilidades de esta tecnología. El trading real requerirá un trabajo adicional: realizar pruebas con datos históricos, optimizar los parámetros, integrar el sistema con el de gestión de riesgos y estar psicológicamente preparado para los drawdowns.
Pero lo más importante es el concepto. La idea de que el mercado se puede cartografiar, de que el caos de las velas en el gráfico esconde una estructura ordenada que se puede descubrir y aprovechar. El SOM nos ofrece una herramienta para crear este mapa. Un mapa que muestra dónde nos encontramos en el espacio de estados del mercado y hacia dónde es probable que nos dirijamos a continuación.
El código es abierto. Y la tecnología está disponible. Ahora solo queda aplicarla con sensatez, paciencia y la debida precaución. Los mercados no perdonan la arrogancia, pero premian a quienes utilizan las herramientas adecuadas de la forma correcta. Quizás los mapas autoorganizados se conviertan en su herramienta para navegar por el océano de datos financieros.
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19958
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.


Se ha publicado el artículo «Mapas autoorganizados de Kohonen» en la guía de MQL5:
Autor: Yevgeniy Koshtenko