Superando las limitaciones del aprendizaje automático (Parte 6): Validación cruzada de memoria efectiva
 22
 0

En nuestro análisis anterior sobre la validación cruzada, repasamos el enfoque clásico y cómo se aplica a los datos de series temporales para optimizar los modelos y mitigar el sobreajuste. Para su comodidad, se incluye aquí un enlace a ese análisis. También sugerimos que podemos alcanzar un rendimiento superior al que implica la interpretación tradicional. En este artículo, analizamos los puntos ciegos de las técnicas convencionales de validación cruzada y mostramos cómo pueden mejorarse mediante métodos de validación específicos para cada ámbito.
Para ilustrar la idea más rápidamente, consideremos un experimento mental. Imaginemos que fuera posible viajar en el tiempo 400 años hacia el futuro. Al llegar, se encuentra en una habitación con un periódico por cada día transcurrido durante su ausencia: una montaña de periódicos que recogen siglos de acontecimientos mundiales que se ha perdido. Junto a esta montaña hay un terminal de MetaTrader 5 en funcionamiento. Ahora bien, antes de negociar, debe informarse sobre el mundo a través de esos periódicos.
¿En qué orden los leería? ¿Es necesario que lea todos los periódicos disponibles o puede obtener buenos resultados asimilando la información más reciente? ¿Hasta qué punto hay que remontarse en el tiempo antes de que la información quede «reflejada» en el precio y deje de ser útil?
Este es el tipo de preguntas que se resuelven mejor mediante la validación cruzada. Sin embargo, las formas clásicas de validación cruzada parten, por naturaleza, de la premisa de que toda la información contenida en el pasado es necesaria. Queremos introducir una nueva forma de validación cruzada que permita comprobar si esta hipótesis se cumple.
Antes de profundizar en los resultados que hemos obtenido con nuestro terminal MetaTrader 5, analicemos primero esta cuestión para que el lector comprenda claramente la motivación de este enfoque. En términos generales, empezar por el periódico más antiguo de la sala y seguir leyendo en orden cronológico no serviría de nada.
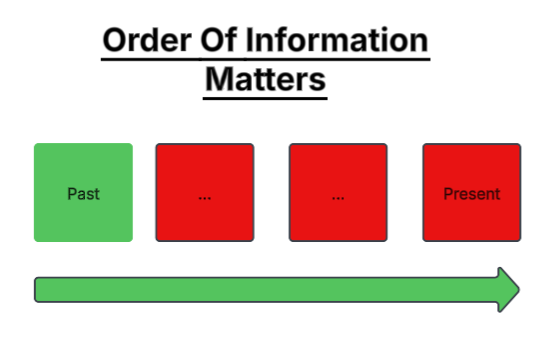
Figura 1: ¿Es siempre mejor que analicemos todos los datos históricos de los que disponemos sobre un mercado?
Un trader inteligente preferiría empezar por la información más reciente e ir retrocediendo en el tiempo, ya que la información más antigua pierde rápidamente su relevancia en los mercados financieros. Esto pone de manifiesto una verdad sutil propia del mundo de las finanzas: la información se degrada.
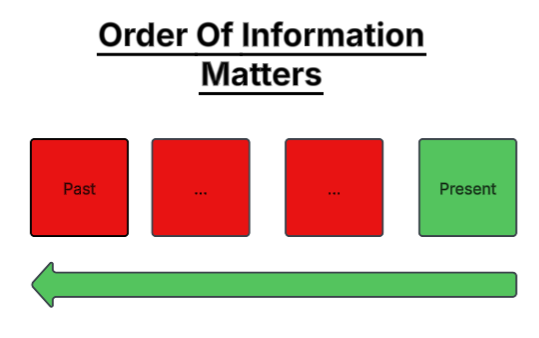
Figura 2: ¿O tal vez sería mejor partir de la hipótesis de que los mercados financieros otorgan mayor importancia a la información más reciente de la que se dispone?
En las ciencias naturales, la información no se degrada. Los apuntes de Newton sobre la gravedad siguen dando los mismos resultados siglos después. Sin embargo, en los mercados financieros, las estrategias que en su día funcionaron en la década de 1950 pueden fracasar hoy en día. Las condiciones del mercado evolucionan, y la información que antes era valiosa a menudo acaba incorporándose a los precios o queda obsoleta.
Esto nos lleva a una pregunta importante: ¿el uso de más datos históricos mejora siempre el rendimiento predictivo de nuestros modelos estadísticos? Nuestros resultados sugieren lo contrario. Si se alimenta a un modelo con demasiados datos de un pasado lejano, su precisión predictiva puede verse reducida. Al igual que en el experimento mental que hemos realizado, no es necesario leer todos los periódicos que se han publicado jamás, sino solo aquellos que siguen siendo relevantes para el presente.
Los traders profesionales no comienzan su análisis a partir de la primera vela registrada en cada mercado en el que operan. Sin embargo, en el aprendizaje automático, esperamos que nuestros modelos lo hagan, dando por sentado sin más que «cuanto más, mejor». Este debate cuestiona esa suposición y analiza si los mercados financieros tienen una memoria efectiva —un límite más allá del cual la información más antigua deja de tener importancia—.
Nuestro objetivo es estudiar la relación entre la cantidad de datos históricos utilizados para el entrenamiento y nuestro rendimiento fuera de la muestra. Nos centramos en determinar si un modelo entrenado con un subconjunto de datos más pequeño y reciente puede igualar o incluso superar el rendimiento de un modelo entrenado con el conjunto de datos completo. Para analizar esto, usamos datos de mercado correspondientes a unos ocho años y los dividimos en dos partes iguales. El conjunto de entrenamiento se fue ampliando progresivamente —10 %, 20 %, 30 %, y así sucesivamente— mediante la incorporación de datos cada vez más antiguos. Se asignó un modelo a cada partición. A continuación, medimos el error de cada modelo en un conjunto de prueba fijo de aproximadamente 4 años.
Los resultados fueron claros: el error fuera de la muestra más bajo se obtuvo con el modelo que se ajustó utilizando solo el 80 % de los datos de entrenamiento disponibles, y no la totalidad de los mismos. Añadir datos más antiguos a partir de ese umbral solo empeoró la precisión de las predicciones. Esto demuestra que los modelos pueden aprender mejor con menos datos, sobre todo si las observaciones más antiguas ya no reflejan la realidad actual del mercado.
La cantidad de datos que se utiliza para entrenar el modelo pretende servir como indicador de los costes asociados a la creación del mismo. En términos generales, cuantos más datos usamos para entrenar el modelo, más costoso resulta obtenerlo. Por lo tanto, estos resultados tienen importantes implicaciones para los profesionales de todos los niveles. Comprenderlos ayuda a reducir los costes computacionales y los costes de la infraestructura en la nube, a acortar los ciclos de desarrollo y a mejorar la eficiencia de los modelos.
Primeros pasos con nuestro análisis en Python
Ahora vamos a empezar a analizar los datos exportados desde MetaTrader 5 utilizando las bibliotecas estándar de Python en las que solemos basarnos.
#Import the standard python libraries
import numpy as np
import pandas as pd
import seaborn as sns
import MetaTrader5 as mt5
import matplotlib.pyplot as plt
Ahora iniciemos sesión en el terminal MetaTrader 5.
#Log in to our MT5 Terminal
if(mt5.initialize()):
   #User feedback
   print("Logged In")

else:
   print("Failed To Log In")
Logged In
Antes de obtener los datos históricos de un símbolo, debemos seleccionar primero dicho símbolo en la ventana «Observación del mercado».
#Fetch Data on the EURUSD Symbol
#First select the EURUSD symbol from the Market Watch
if(mt5.symbol_select("EURUSD")):
    #Found the symbol
    print("Found the EURUSD Symbol")
Ahora podemos obtener las cotizaciones de nuestro bróker.
#Fetch the historical EURUSD data we need
data = pd.DataFrame(mt5.copy_rates_from_pos("EURUSD",mt5.TIMEFRAME_D1,0,3000))
data
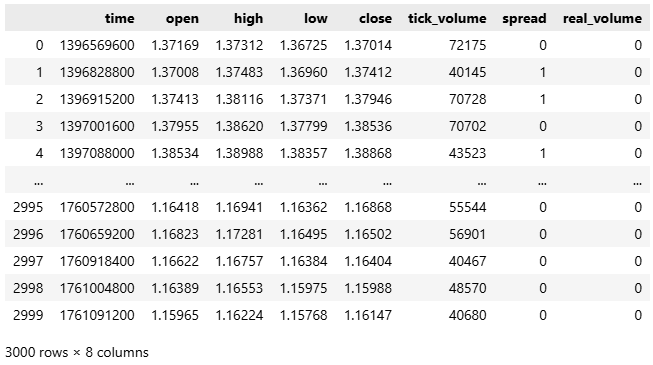
Figura 1: Primeros pasos en nuestro análisis de los datos históricos del mercado del EURUSD.
Por convención, los datos nos llegan en formato de tiempo Unix, ya que la mayoría de los brókeres utilizan servidores Linux. Así que convertiremos el tiempo, expresado en segundos, a un formato legible para las personas: año-mes-día.
#Convert the time from seconds to human readable
data['time'] = pd.to_datetime(data['time'],unit='s')
#Make sure the correct changes were made
data
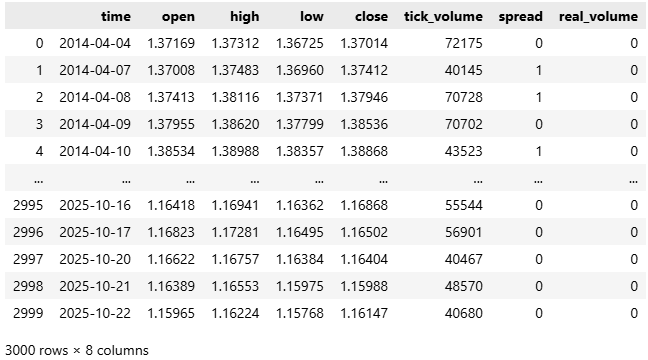
Figura 2: Conversión del tiempo expresado en segundos a un formato legible para las personas.
Ahora centrémonos en las cuatro columnas que componen los datos de precios de apertura, máximo, mínimo y cierre.
#Select the OHLC columns
data = data.iloc[:,:-3]
data
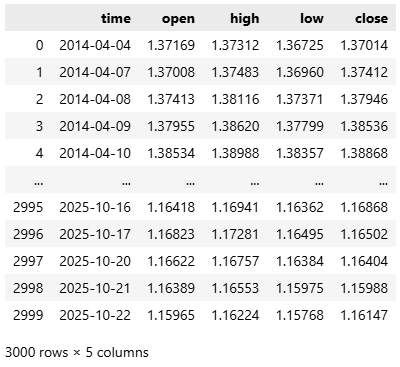
Figura 3: Reducimos el conjunto de datos para poder centrar nuestro análisis en los cuatro niveles de precios principales.
A continuación, empezamos por construir un modelo clásico de predicción de series temporales, en el que se realizan predicciones a un paso.
#Define the classical horizon
HORIZON = 1
Una vez realizada esta configuración, etiquetamos nuestros datos.
#Label the data
data['Target'] = data['True Close'].shift(HORIZON)
Eliminamos las filas con valores ausentes, ya que estos valores pueden provocar errores al ajustar modelos de scikit-learn.
#Drop missing rows
data.dropna(inplace=True)
A continuación, importamos las bibliotecas de aprendizaje automático necesarias.
#Import cross validation tools
from sklearn.linear_model import Ridge,LinearRegression
from sklearn.metrics import root_mean_squared_error
from sklearn.neural_network import MLPRegressor
Luego dividimos nuestro conjunto de datos en dos partes iguales: una para el entrenamiento y otra para la evaluación.
#The big picture of what we want to test
train , test = data.iloc[:data.shape[0]//2,:] , data.iloc[data.shape[0]//2:,:]
Después separamos las características de entrada y las variables objetivo de salida.
#Define inputs and target
X = data.columns[1:-1]
y = data.columns[-1]
Para que nuestro flujo de trabajo sea modular, definimos una función llamada get_model(), que devuelve un regresor de bosque aleatorio. Los bosques aleatorios son potentes estimadores capaces de captar interacciones complejas y no lineales entre variables que los modelos más sencillos podrían pasar por alto.
#Fetch a new copy of the model
def get_model():
    return(RandomForestRegressor(random_state=0,n_jobs=-1))
Una vez definido nuestro modelo, pasamos a la sección principal del programa. Aquí creamos una lista para registrar las puntuaciones de rendimiento del modelo y especificamos el número total de iteraciones que queremos ejecutar. Los usuarios pueden experimentar libremente con este parámetro: un mayor número de iteraciones ofrece información más detallada.
En cada iteración del bucle, entrenamos el modelo con una fracción cada vez mayor de los datos de entrenamiento. Utilizando la función `arange` de NumPy, creamos fracciones que van de 0,1 a 1,0 en incrementos de 0,1. Para cada fracción, entrenamos el modelo utilizando únicamente la parte más reciente de los datos de entrenamiento disponibles y lo evaluamos en un conjunto de prueba fijo. Este proceso se repite hasta que el modelo se haya entrenado con toda la partición de entrenamiento.
Una vez completadas todas las iteraciones, representamos gráficamente el rendimiento del modelo en función de la fracción de entrenamiento. El marcador rojo del gráfico destaca el error de prueba más bajo, observado en el 80 %. Esto significa que el modelo alcanzó su mejor rendimiento fuera de la muestra cuando se entrenó únicamente con el 80 % de los datos disponibles.
Debemos señalar que este procedimiento no es lo mismo que la validación cruzada clásica de k pliegues. En nuestra configuración, los conjuntos de entrenamiento y de prueba no comparten ninguna observación. El conjunto de entrenamiento simplemente se amplía para incluir datos más antiguos, mientras que el conjunto de prueba permanece fijo. El hecho de que el error alcance su mínimo antes de utilizar el 100 % de los datos sugiere que los datos más antiguos no aportaban ningún valor predictivo adicional.
En conclusión, nuestro experimento demuestra que un modelo más pequeño y económico —entrenado con una parte limitada y más reciente de los datos— puede ofrecer mejores resultados que un modelo entrenado con todo el conjunto de datos histórico.
#Store our performance
error = []

#Define the total number of iterations we wish to perform
ITERATIONS = 10

#Let us perform the line search
for i in np.arange(ITERATIONS):
    #Training fraction
    fraction =((i+1)/10)

    #Partition the data to select the most recent information
    partition_index = train.shape[0] - int(train.shape[0]*fraction)

    train_X_partition = train.loc[partition_index:,X]
    train_y_partition = train.loc[partition_index:,y]

    #Fit a model
    model = get_model()

    #Fit the model
    model.fit(train_X_partition,train_y_partition)

    #Cross validate the model out of sample
    score = root_mean_squared_error(test.loc[:,y],model.predict(test.loc[:,X]))

    #Append the error levels
    error.append(score)

#Plot the results
plt.title('Improvements Made By Historical Data')
plt.plot(error,color='black')
plt.grid()
plt.ylabel('Out of Sample RMSE')
plt.xlabel('Progressivley Fitting On All Historical Data')
plt.scatter(np.argmin(error),np.min(error),color='red')
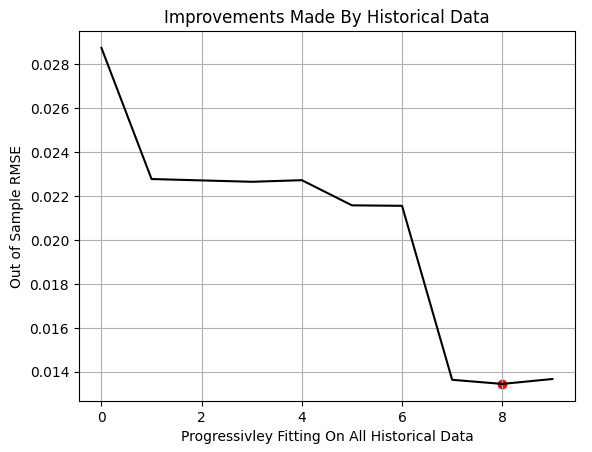
Figura 4: Los resultados que hemos obtenido con nuestro terminal MetaTrader 5 indican que el mero hecho de introducir más datos históricos no siempre mejora el rendimiento.
A continuación, determinamos el índice de partición óptimo estimado a partir de nuestra búsqueda lineal.
#Let us select the partition of interest
partition_index = train.shape[0] - int(train.shape[0]*(0.8))
Nuestra metodología indica que las primeras 300 observaciones —aproximadamente un año de datos— incluidas en el conjunto de entrenamiento no resultaron útiles para la predicción.
train.loc[partition_index:,:]
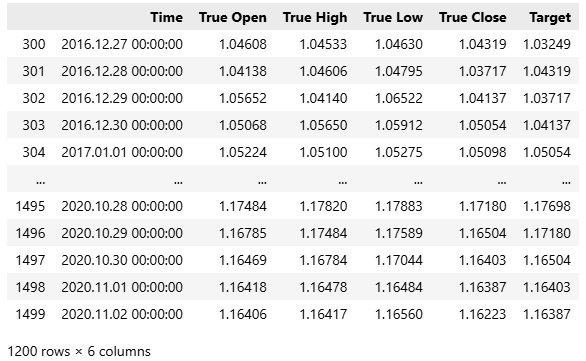
Figura 5: Hemos estimado que el subconjunto anterior de nuestros datos de entrenamiento es el más relevante para el mercado actual.
Por lo tanto, compararemos el rendimiento de dos modelos:
- Modelo clásico: entrenado con todos los datos disponibles y que realiza predicciones con un paso de antelación.
- Variante moderna: entrenada únicamente con la partición óptima de todos los datos históricos disponibles y diseñada para realizar predicciones con un horizonte superior a un paso.
Establezcamos primero un nivel de rendimiento de referencia siguiendo la configuración clásica. Para ello, inicializamos un nuevo modelo.
#Prepare the baseline model
model = LinearRegression()
Ajustamos el modelo con todo el conjunto de datos, siguiendo la configuración clásica.
#Fit the baseline model on all the data
model.fit(train.loc[:,X],train.loc[:,y])
A continuación, nos preparamos para exportar el modelo al formato ONNX (Open Neural Network Exchange). ONNX ofrece una forma independiente del framework para representar y desplegar modelos de aprendizaje automático, lo que permite que se ejecuten en diferentes plataformas, independientemente de su entorno de entrenamiento.
#Prepare to export to ONNX
import onnx
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType
Tras cargar las dependencias necesarias, definimos las dimensiones de entrada y salida de nuestro modelo.
#Define ONNX model input and output dimensions
initial_types = [("FLOAT INPUT",FloatTensorType([1,4]))]
final_types = [("FLOAT OUTPUT",FloatTensorType([1,1]))]
Luego convertimos el modelo de sklearn a su formato prototipo ONNX utilizando la función `convert_sklearn`.
#Convert the model to its ONNX prototype
onnx_proto = convert_sklearn(model,initial_types=initial_types,target_opset=12)
Una vez convertido, guardamos el modelo ONNX en el disco con onnx.save().
#Save the ONNX model
onnx.save(onnx_proto,"EURUSD Baseline LR.onnx")
Primeros pasos en MQL5
En esta fase, estamos listos para establecer nuestro punto de referencia de rendimiento. El primer paso consiste en definir las constantes del sistema que se mantendrán fijas a lo largo de ambas pruebas, garantizando así que cualquier diferencia de rendimiento se deba exclusivamente a nuestras decisiones de modelización.//+------------------------------------------------------------------+ //| Information Decay.mq5 | //| Gamuchirai Ndawana | //| https://www.mql5.com/en/users/gamuchiraindawa | //+------------------------------------------------------------------+ #property copyright "Gamuchirai Ndawana" #property link "https://www.mql5.com/en/users/gamuchiraindawa" #property version "1.00" //+------------------------------------------------------------------+ //| System definitions | //+------------------------------------------------------------------+ #define SYMBOL "EURUSD" #define SYSTEM_TIMEFRAME PERIOD_D1 #define SYSTEM_DATA COPY_RATES_OHLC #define TOTAL_MODEL_INPUTS 4 #define TOTAL_MODEL_OUTPUTS 1 #define ATR_PERIOD 14 #define PADDING 2
Cargamos el modelo ONNX. Recordemos que este modelo de referencia se entrenó con todos los datos históricos y se configuró para predecir un paso por delante.
//+------------------------------------------------------------------+
//| System resources we need                                         |
//+------------------------------------------------------------------+
#resource "\\Files\\EURUSD Baseline LR.onnx" as const uchar onnx_buffer[];
A continuación, cargamos las bibliotecas necesarias: las de ejecución de operaciones y nuestra biblioteca de utilidades personalizada, que obtiene información esencial para operar, como el tamaño mínimo del lote y los precios actuales de demanda (bid) y oferta (ask).
//+------------------------------------------------------------------+
//| Libraries                                                        |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
CTrade Trade;
TradeInfo *TradeHelper;
También definimos un conjunto de variables globales que se utilizarán en toda la aplicación.
//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
long         onnx_model;
vectorf      onnx_inputs,onnx_output;
MqlDateTime current_time,time_stamp;
int         atr_handler;
double      atr[];
Una vez completada la configuración, pasamos a la fase de inicialización de la aplicación. Aquí creamos la instancia del modelo ONNX a partir del búfer definido en el encabezado del programa. Luego realizamos una comprobación de errores verificando que el identificador del modelo sea válido. Si se detecta un identificador no válido, se muestra un mensaje de error y se interrumpe la inicialización. De lo contrario, pasamos a definir las dimensiones de entrada y salida del modelo. Cualquier error que se produzca aquí se notifica al usuario de la misma manera. Si la inicialización se realiza correctamente, a continuación establecemos los valores iniciales de las variables globales clave, como la hora actual, creamos nuevas instancias de clase e inicializamos el indicador técnico del que depende nuestra aplicación.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {

//--- Create the ONNX model from its buffer
   onnx_model = OnnxCreateFromBuffer(onnx_buffer,ONNX_DATA_TYPE_FLOAT);

//--- Check for errors
   if(onnx_model == INVALID_HANDLE)
     {
      //--- User feedback
      Print("An error occured loading the ONNX model:\n",GetLastError());
      //--- Abort
      return(INIT_FAILED);
     }

//--- Setup the ONNX handler input shape
   else
     {
      //--- Define the I/O shapes
      ulong input_shape[] = {1,4};
      ulong output_shape[] = {1,1};

      //--- Attempt to set input shape
      if(!OnnxSetInputShape(onnx_model,0,input_shape))
        {
         //--- User feedback
         Print("Failed to specify the correct ONNX model input shape:\n",GetLastError());
         //--- Abort
         return(INIT_FAILED);
        }

      //--- Attempt to set output shape
      if(!OnnxSetOutputShape(onnx_model,0,output_shape))
        {
         //--- User feedback
         Print("Failed to specify the correct ONNX model output shape:\n",GetLastError());
         //--- Abort
         return(INIT_FAILED);
        }

      //--- Mark the current time
      TimeLocal(current_time);
      TimeLocal(time_stamp);

      //--- Setup the trade helper
      TradeHelper = new TradeInfo(SYMBOL,SYSTEM_TIMEFRAME);

      //--- Setup our technical indicators
      atr_handler = iATR(Symbol(),SYSTEM_TIMEFRAME,ATR_PERIOD);
      //--- Success
      return(INIT_SUCCEEDED);
     }
  }
Cuando la aplicación deja de utilizarse, liberamos correctamente los recursos, incluida la memoria asignada al modelo ONNX, al indicador técnico y a otros objetos dinámicos creados durante la ejecución.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   OnnxRelease(onnx_model);
   IndicatorRelease(atr_handler);
   delete(TradeHelper);
  }
La lógica principal de la aplicación se encuentra en la función OnTick(). Cada vez que llega un nuevo precio de mercado, actualizamos la hora actual mediante la función TimeLocal(), que devuelve la hora local del ordenador en el que se ejecuta el terminal MetaTrader 5. A continuación, comparamos `currenttime.dayofyear` con `timestamp.dayofyear`.
Como Timestamp se actualizó por última vez durante la inicialización, esta condición solo se cumplirá una vez que haya transcurrido un día completo. Cuando la condición no se cumple, actualizamos timestamp a la hora actual, actualizamos los búferes del indicador técnico y preparamos los vectores de entrada y salida para el modelo ONNX.
A continuación, solicitamos una nueva predicción al modelo mediante el comando OnnxRun(). Esta función recibe la instancia del modelo ONNX, los parámetros de tipo bandera para los atributos especiales del modelo y los vectores de entrada y salida preparados.
Una vez obtenida la predicción, mostramos un mensaje de respuesta al usuario. Si no hay posiciones abiertas, llevamos a cabo las acciones según los resultados del modelo. Sin embargo, si el modelo no genera una predicción, informamos al usuario de que se ha producido un error.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- Check for updated candles
   TimeLocal(current_time);

//--- Periodic one day test
   if(current_time.day_of_year != time_stamp.day_of_year)
     {
      //--- Update the time stamp
      TimeLocal(time_stamp);

      //--- Update technical indicators
      CopyBuffer(atr_handler,0,0,1,atr);

      //--- Prepare a prediction from our model
      onnx_inputs = vectorf::Zeros(TOTAL_MODEL_INPUTS);
      onnx_inputs[0] = (float) iOpen(Symbol(),SYSTEM_TIMEFRAME,0);
      onnx_inputs[1] = (float) iHigh(Symbol(),SYSTEM_TIMEFRAME,0);
      onnx_inputs[2] = (float) iLow(Symbol(),SYSTEM_TIMEFRAME,0);
      onnx_inputs[3] = (float) iClose(Symbol(),SYSTEM_TIMEFRAME,0);

      //--- Also prepare the outputs
      onnx_output = vectorf::Zeros(TOTAL_MODEL_OUTPUTS);

      //--- Fetch a prediction from our model
      if(OnnxRun(onnx_model,ONNX_DATA_TYPE_FLOAT,onnx_inputs,onnx_output))
        {
         //--- Give user feedback
         Comment("Trading Day: ",time_stamp.year," ",time_stamp.mon," ",time_stamp.day_of_week,"\nForecast: ",onnx_output[0]);

         //--- Check if we have an open position
         if(PositionsTotal() == 0)
           {
            //--- Long condition
            if(onnx_output[0] > iClose(SYMBOL,SYSTEM_TIMEFRAME,0))
               Trade.Buy(TradeHelper.MinVolume(),SYMBOL,TradeHelper.GetAsk(),TradeHelper.GetBid()-(atr[0]*PADDING),TradeHelper.GetBid()+(atr[0]*PADDING),"");

            //--- Short condition
            if(onnx_output[0] < iClose(SYMBOL,SYSTEM_TIMEFRAME,0))
               Trade.Sell(TradeHelper.MinVolume(),SYMBOL,TradeHelper.GetBid(),TradeHelper.GetAsk()+(atr[0]*PADDING),TradeHelper.GetAsk()-(atr[0]*PADDING),"");
           }

         //--- Manage our open position
         else
           {
               //--- This control branch remains empty for now
           }
        }

      //--- Something went wrong
      else
        {
         Comment("Failed to obtain a prediction from our model. ",GetLastError());
        }
     }
  }
//+------------------------------------------------------------------+
Por último, se anula la definición de todas las constantes del sistema que hemos creado anteriormente.
//+------------------------------------------------------------------+
//| Undefine system constants                                        |
//+------------------------------------------------------------------+
#undef SYMBOL
#undef SYSTEM_DATA
#undef SYSTEM_TIMEFRAME
#undef ATR_PERIOD
#undef PADDING
#undef TOTAL_MODEL_INPUTS
#undef TOTAL_MODEL_OUTPUTS
Ahora que ya hemos definido nuestra aplicación, estamos listos para empezar a realizar pruebas. Así, realizaremos nuestra evaluación en el periodo de prueba retrospectiva de cinco años identificado anteriormente. Vamos a empezar seleccionando la versión de referencia de la aplicación que acabamos de crear y definiendo las fechas de entrenamiento correspondientes.
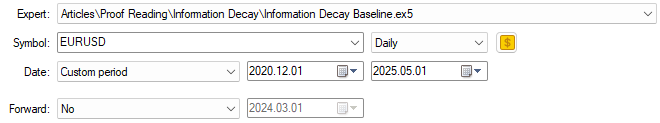
Figura 6: Las fechas que hemos seleccionado para nuestro periodo de prueba retrospectiva se sitúan fuera del periodo de entrenamiento que identificamos en la figura 3.
A continuación, especificamos las condiciones de emulación en las que se ejecutará la prueba retrospectiva. Recordemos que utilizamos el modo «Cada tick basado en ticks reales» para reflejar una evolución realista de las condiciones del mercado. El ajuste de retardo está configurado en «retardo aleatorio», lo que nos permite emular de forma fiable la naturaleza impredecible de los entornos de negociación en tiempo real.
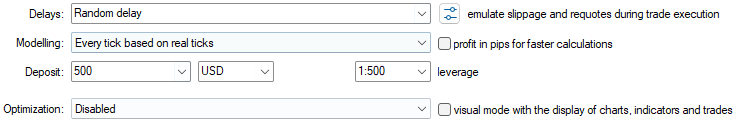
Figura 7: Las condiciones de prueba retrospectiva que hemos seleccionado tienen por objeto emular el caos de las condiciones reales del mercado.
Al analizar el rendimiento de referencia, observamos que la versión inicial de nuestra aplicación generó un beneficio total de 90 dólares durante el periodo de prueba retrospectiva de cinco años. Aunque este resultado no es del todo malo, dista mucho de ser impresionante. Un análisis más detallado revela una característica alarmante en la composición de las operaciones: la aplicación no realizó ninguna operación en largo durante toda la prueba retrospectiva. Todas las operaciones realizadas fueron exclusivamente posiciones cortas. Este comportamiento no se esperaba ni se pretendía durante el desarrollo, y no existe una explicación clara de por qué el modelo se comportó de esta manera. Además, la tasa de acierto de la estrategia fue de aproximadamente el 50 %, apenas por encima de lo esperable por azar. Lo que resulta aún más preocupante es que el beneficio esperado era negativo, lo que indica que la aplicación probablemente generaría pérdidas a largo plazo.
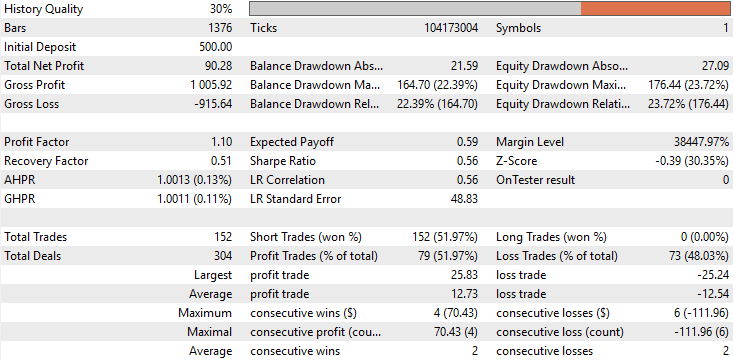
Figura 8: Un análisis estadístico detallado de los resultados que hemos obtenido de la prueba retrospectiva que hemos realizado.
Al analizar la curva de capital, podemos observar una volatilidad e inestabilidad pronunciadas a lo largo de todo el periodo de pruebas. A medida que nos acercamos a noviembre de 2022, el saldo de la cuenta deja de crecer y entra en una fase de consolidación prolongada que se mantiene durante casi tres años dentro del periodo de la prueba retrospectiva. En general, el modelo de referencia no logra hacer crecer la cuenta de forma significativa y inspira poca confianza en su viabilidad a largo plazo.
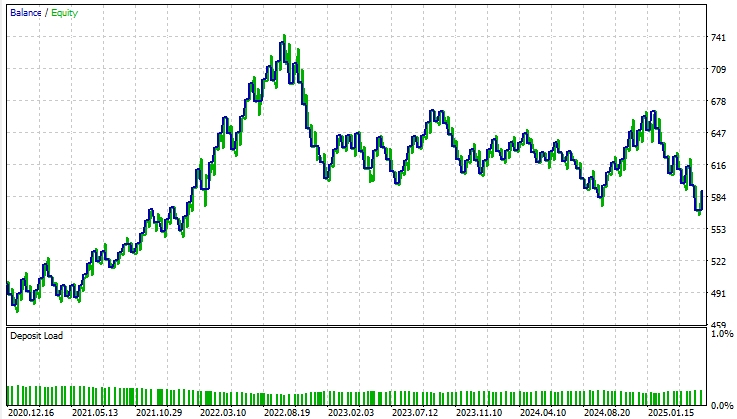
Figura 9: Visualización de la curva de capital que hemos obtenido al seguir las pautas tradicionales sobre cómo construir un modelo estadístico.
Modificación de nuestro modelo ONNX
Ahora que hemos establecido este rendimiento de referencia —obtenido con la configuración clásica—, vamos a salir del marco tradicional y a modificar nuestro modelo ONNX para reflejar mejor cómo operan realmente los traders humanos profesionales. La primera modificación importante se aleja de la filosofía de diseño convencional. En lugar de desarrollar modelos que solo hacen predicciones a un paso vista, ahora diseñamos nuestro modelo para que haga predicciones a diez pasos vista. Los traders humanos no operan vela a vela; actúan basándose en una visión más amplia de la evolución prevista del mercado. Por lo tanto, nuestro modelo debería reflejar esa misma intuición con visión de futuro. HORIZON = 10 A continuación, identificamos la partición óptima de los datos, estimada mediante técnicas de validación cruzada.
#Let us select the partition of interest
partition_index = train.shape[0] - int(train.shape[0]*(0.8))
train.loc[partition_index:,:]
Luego cargamos un modelo nuevo, idéntico en su arquitectura al modelo de referencia.
#Prepare the improved baseline model
model = LinearRegression()
Entrenamos el nuevo modelo exclusivamente con esta partición óptima de los datos.
#Fit the improved baseline model
model.fit(train.loc[partition_index:,X],train.loc[partition_index:,y])
Una vez entrenado, convertimos este modelo mejorado en su prototipo ONNX. Pero hay que tener en cuenta que ambos modelos tienen la misma complejidad.
#Convert the model to its ONNX prototype
onnx_proto = convert_sklearn(model,initial_types=initial_types,target_opset=12)
Por último, guardamos el modelo ONNX en un archivo.
#Save the ONNX model
onnx.save(onnx_proto,"EURUSD Improved Baseline LR.onnx")
Mejora de nuestros resultados iniciales
El usuario debe considerar que el único componente que hay que modificar es la referencia al recurso del archivo ONNX que se encuentra en el encabezado de la aplicación. El resto del sistema no sufre cambios y funcionará exactamente igual que antes. //+------------------------------------------------------------------+ //| System resources we need | //+------------------------------------------------------------------+ #resource "\\Files\\EURUSD Improved Baseline LR.onnx" as const uchar onnx_buffer[];
A continuación, seleccionamos esta versión mejorada de la aplicación para someterla a prueba durante el mismo periodo de cinco años que el modelo de referencia. Es importante destacar que todas las condiciones de la prueba retrospectiva —incluidos el retraso aleatorio y la ejecución basada en ticks— se mantienen idénticas a las utilizadas en la figura 7 para garantizar la comparabilidad.
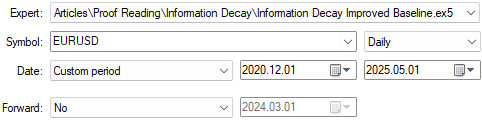
Figura 10: Selección de la nueva versión mejorada de nuestra aplicación para comparar las mejoras logradas.
Al analizar las estadísticas detalladas de rendimiento, la diferencia entre las dos aplicaciones se hace evidente de inmediato. El beneficio neto total del modelo mejorado se ha triplicado con creces, pasando de unos 90 dólares a 330 dólares. Ahora podemos observar que la asimetría inicial en la distribución de las operaciones se ha corregido por completo. En nuestra aplicación de trading de referencia, todas las operaciones eran exclusivamente posiciones cortas, lo que suponía un desequilibrio no deseado en el comportamiento del modelo. Por el contrario, la versión mejorada ahora realiza operaciones tanto en largo como en corto de forma equilibrada, lo que refleja el proceso de toma de decisiones más natural de un trader humano real.
Además, se ha producido una notable mejora en la tasa de acierto, que ha pasado de aproximadamente el 52 % a casi el 60 %. Se trata de un avance alentador, que sugiere que la lógica de decisión interna del modelo se ha vuelto más coherente y perspicaz.
Sin embargo, lo que más me ha sorprendido de este análisis es que el número total de operaciones se mantuvo idéntico en ambos modelos. Cada versión realizó exactamente 152 operaciones durante la prueba retrospectiva. A pesar de ello, el modelo mejorado logró más del triple del beneficio neto total, lo que demuestra un claro aumento de la eficiencia. En otras palabras, con el mismo número de operaciones, el modelo mejorado generó una rentabilidad considerablemente mayor. Además, tanto el coeficiente de Sharpe como el beneficio esperado han aumentado considerablemente, lo que constituye una prueba más de que el modelo está asignando su capital y eligiendo el momento de sus operaciones de forma más inteligente.
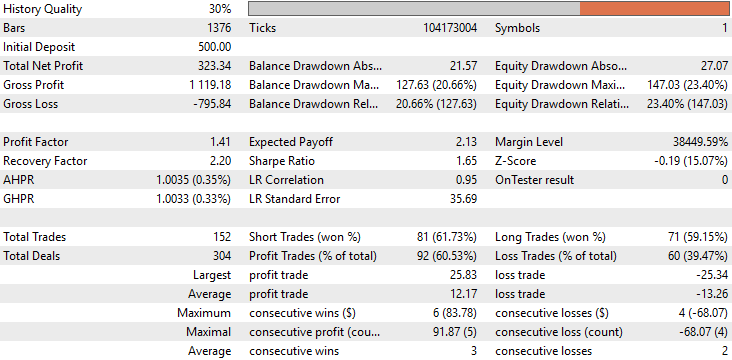
Figura 11: Un análisis detallado de los resultados obtenidos indica que los cambios que hemos introducido han sido adecuados.
Al analizar la curva de capital generada por la versión mejorada, la diferencia es notable. El prolongado periodo de consolidación que lastraba la aplicación inicial —y que se extendió por casi tres años— ha desaparecido por completo. El nuevo modelo muestra un crecimiento constante y sostenido, lo que indica que las limitaciones estructurales o los puntos ciegos que pudiera haber en la versión anterior se han resuelto ahora de forma eficaz. Este resultado es alentador y, a la vez, respalda los ajustes realizados, pues confirma que tuvieron un impacto significativo.
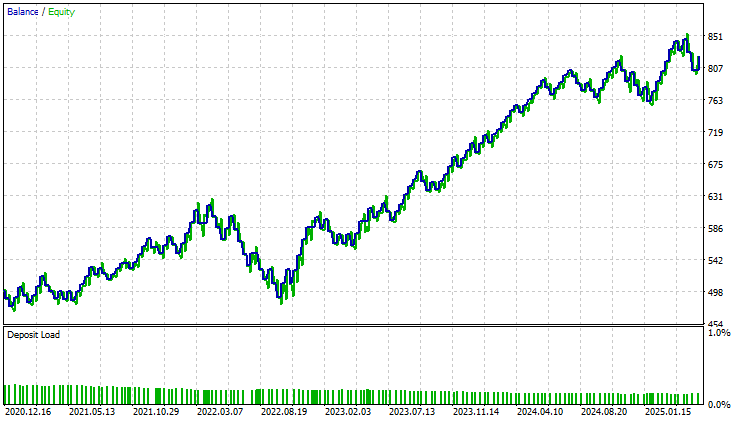
Figura 12: La curva de capital mejorada que hemos obtenido demuestra que los cambios que hemos introducido han aportado estabilidad a nuestro sistema a lo largo de una prueba de 5 años.
Conclusión
Tras leer este artículo, el lector debería contar con conocimientos prácticos sobre la verdadera naturaleza del aprendizaje estadístico en el trading algorítmico que le permitan actuar con mayor criterio. Una conclusión clave es que la adhesión ciega a los principios estadísticos tradicionales no nos resulta necesariamente útil como traders algorítmicos. No podemos limitarnos a tomar prestadas las heurísticas del «big data» y esperar que funcionen sin modificaciones en nuestro ámbito, donde los datos más recientes tienen un peso mucho mayor en términos de relevancia.
Este artículo también ha ofrecido consejos prácticos para ahorrar capital que, de otro modo, podría destinarse erróneamente a la adquisición de modelos excesivamente complejos o ineficientes. Las conclusiones que aquí se presentan pueden traducirse directamente en un ahorro económico real, no solo en gastos de capital, sino también en recursos informáticos, tiempo de desarrollo y costes de infraestructura asociados a la implantación de sistemas avanzados de aprendizaje automático.
Por último, el lector debería tener ahora una visión más clara de los puntos ciegos inherentes a los paradigmas clásicos de validación cruzada. A menudo pasamos por alto si todos los datos que incluimos contribuyen realmente a alcanzar nuestro objetivo. El análisis que aquí se presenta pone de manifiesto una nueva forma de sobreajuste, sobre la que el aprendizaje estadístico clásico ofrece poca orientación. Esto demuestra que el mero hecho de intentar entrenar un modelo con todos los datos disponibles puede constituir en sí mismo una fuente de ineficiencia que pasa desapercibida. En conjunto, estas lecciones nos permiten crear modelos de aprendizaje automático más eficaces, eficientes y rentables para el trading algorítmico.
| Nombre del archivo | Descripción del archivo |
|---|---|
| Information Decay Baseline.mq5 | Aplicación de trading de referencia desarrollada utilizando paradigmas clásicos de aprendizaje automático. |
| Information Decay Improved Baseline.mq5 | Aplicación mejorada, desarrollada mediante la «validación cruzada de memoria efectiva» (EMCV), una técnica específica del ámbito que se presenta en este trabajo. |
| Limitations of Cross Validation 1.ipynb | Cuaderno de Jupyter utilizado para analizar datos de mercado y crear nuestros modelos ONNX. |
| EURUSD Baseline LR.onnx | Modelo ONNX clásico, creado siguiendo las mejores prácticas clásicas. |
| EURUSD Improved Baseline LR.onnx | Modelo ONNX mejorado que superó al modelo de referencia clásico al seguir las nuevas prácticas recomendadas específicas del ámbito que se analizan aquí. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/20010
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.