

Predicción de una distribución condicional mediante un perceptrón multicapa (MLP)
 38
 9

Introducción
En mercados financieros tan volátiles e inciertos como el Forex, predecir con precisión la evolución de los precios sigue siendo un reto fundamental para los operadores y los analistas. Los métodos de regresión tradicionales basados en funciones de pérdida estándar, como el error cuadrático medio (MSE) o la suma de errores al cuadrado (SSE), suelen ofrecer un rendimiento inferior al esperado. Estas funciones suponen la homocedasticidad, es decir, la constancia de la varianza de la variable objetivo, lo que rara vez se corresponde con la dinámica real de las series temporales financieras. Para modelar adecuadamente estos datos, se requiere un enfoque que tenga en cuenta la heterocedasticidad, es decir, la variación de la varianza de los incrementos de precio en función de las características de entrada.
El artículo presenta un enfoque probabilístico del problema de regresión mediante el uso de un perceptrón multicapa (MLP) para predecir la distribución gaussiana condicional de los incrementos de precio. Para ello, implementamos una función de pérdida personalizada basada en la log-verosimilitud negativa gaussiana (GaussianNLLLoss).
Para aplicar este enfoque, se creó la clase MLPRegressor, integrada con la biblioteca ALGLIB, que proporciona el algoritmo de optimización L-BFGS. El artículo describe detalladamente los métodos clave de la clase —la propagación hacia delante y la retropropagación—, la integración con L-BFGS y un indicador que muestra la aplicación del modelo a la predicción de incrementos de precio en pares de divisas, junto con una estimación de la incertidumbre. En definitiva, nuestro modelo ofrece al operador no solo una predicción puntual, sino la distribución condicional completa de la variable objetivo.
La función de pérdida MSE y su relación con la verosimilitud gaussiana de varianza constante
En primer lugar, recordemos qué es una función de pérdida y por qué desempeña un papel fundamental en los problemas de aprendizaje automático. La función de pérdida cuantifica cuánto se desvían las predicciones del modelo de los datos reales. Una de las funciones de pérdida más habituales en los problemas de regresión es el error cuadrático medio (MSE), que se calcula de la siguiente manera:
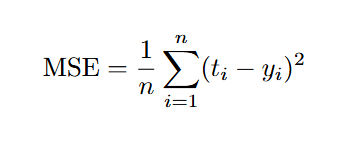
donde:
- t — valor real de la variable objetivo (target),
- y — valor previsto por el modelo,
- n — número de observaciones.
Desde el enfoque de máxima verosimilitud, minimizar el error cuadrático medio (MSE) equivale a suponer que la variable objetivo sigue una distribución normal centrada en la predicción del modelo y con varianza constante σ²:
t ~ N (y, σ²)
Entonces, la función de verosimilitud para una muestra de n observaciones de este modelo se expresa como el producto de las densidades de la distribución normal:
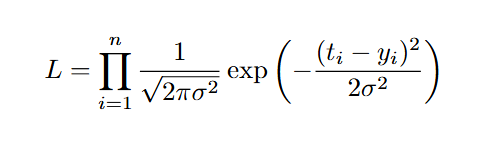
Para facilitar la optimización, normalmente se minimiza el logaritmo negativo de la verosimilitud:
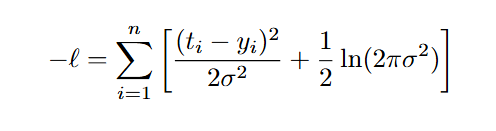
Dado que la varianza σ² es una constante, el segundo término de la fórmula no depende de los parámetros del modelo y no afecta a la optimización. Por lo tanto, minimizar la log-verosimilitud negativa equivale a minimizar el error cuadrático medio (MSE). Esto demuestra que el uso del MSE como función de pérdida supone implícitamente que los incrementos de precio siguen una distribución normal con una varianza constante, independiente de las características de entrada.
Sin embargo, en el contexto de los datos financieros, como los incrementos de precio en los pares de divisas del mercado Forex, esta suposición rara vez se ajusta a la realidad. En tales circunstancias, utilizar el MSE como función de pérdida resulta demasiado simplista y puede dar lugar a modelos que no sean lo suficientemente precisos y que no tengan en cuenta la volatilidad cambiante. Para superar esta limitación, construimos una función de pérdida personalizada basada en la log-verosimilitud negativa gaussiana, que modela la varianza condicional en función de las características de entrada.
Verosimilitud gaussiana con varianza variable mediante GaussianNLLLoss
En este caso, suponemos que la variable objetivo t sigue una distribución normal con una varianza condicional σi², que depende de los datos de entrada xi.
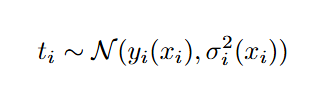
Entonces, el logaritmo negativo de la verosimilitud, promediado sobre n observaciones, se expresa como:
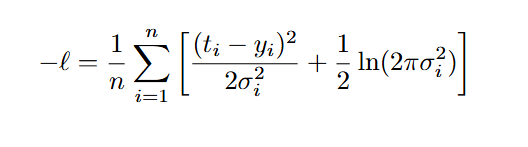
Esta función de pérdida se compone de dos términos. El primer término es, en esencia, el error cuadrático medio ponderado. El peso de cada término es inversamente proporcional a la varianza prevista. Esto significa que, cuanto mayor sea la incertidumbre prevista (σ²), menor será la influencia del error correspondiente en la función de pérdida global.
El segundo término evita que el modelo aumente de forma trivial σi² para minimizar el primer término. Esto favorece que el modelo prediga una varianza que se ajuste a la incertidumbre real de los datos.
Así pues, la función GaussianNLLLoss nos permite predecir simultáneamente dos magnitudes: la esperanza condicional μi y la varianza σi². Esto equivale a modelar una distribución normal completa para cada punto de datos.
//+------------------------------------------------------------------+
//| GaussianNLLLoss (Negative Log-Likelihood)                        |
//+------------------------------------------------------------------+
double GaussianNLLLoss(const matrix &output, const matrix &target, int sample)
  {
   if(output.Rows() != 2 || output.Cols() != sample || target.Rows() != sample || target.Cols() != 1)
     {
      Print("GaussianNLLLoss: Invalid matrix dimensions");
      return DBL_MAX;
     }

   vector mu = output.Row(0);
   vector sigma2 = output.Row(1); // after softplus

// Limit the dispersion from below by eps value
   for(int i = 0; i < sample; i++)
     {
      sigma2[i] = MathMax(sigma2[i], 1e-6); // max(sigma_i^2, eps)
     }

//  target - mu
   vector diff = target.Col(0) - mu;
//  (t - mu)^2 / (2 * sigma^2)
   vector term1 = diff * diff / (2.0 * sigma2);
//  0.5 * log(2 * PI * sigma^2)
   vector term2 = 0.5 * (MathLog(2.0 * M_PI * sigma2));
// Sum both terms and average
   double sum = (term1 + term2).Sum();
   return sum / sample;
  }
El concepto de verosimilitud
La verosimilitud es un concepto fundamental en estadística, que se utiliza tanto en el enfoque frecuentista como en el bayesiano. Caracteriza la probabilidad de los datos observados dados los parámetros del modelo. En el contexto del aprendizaje automático, la verosimilitud es una medida de hasta qué punto un modelo describe los datos.
Consideremos, por ejemplo, un conjunto de datos que se supone que sigue una distribución normal con media μ y varianza σ². La función de verosimilitud indica hasta qué punto es verosímil que los datos observados hayan sido generados por una distribución normal con valores específicos de estos parámetros. En otras palabras, ayuda a responder a la pregunta: «¿En qué medida se ajustan los parámetros seleccionados a los datos observados?».
Para ilustrar el principio de máxima verosimilitud, se puede ejecutar un script que represente gráficamente la log-verosimilitud de una muestra procedente de una distribución normal N(0,1) en función de la media. Para una varianza fija σ² = 1, se prueban los valores de μ en el intervalo [−3, 3] y se calcula la verosimilitud utilizando la función MathProbabilityDensityNormal. El gráfico resultante muestra que la log-verosimilitud alcanza su máximo para un valor de μ cercano a 0, próximo a la media muestral de los datos generados. Todos los demás valores de μ tienen una verosimilitud menor, lo que indica que se ajustan peor a los datos.
#include <Math\Stat\Normal.mqh>
#include <Graphics\Graphic.mqh>

//+----------------------------------------------------+
//| Log-Likelihood                             |
//+----------------------------------------------------+
double LogLikelihood(const double &t[], double mu, double sigma)
{
   int n = ArraySize(t);
   double result[];
   ArrayResize(result, n);
   // Calculate the logarithm of the probability density
   MathProbabilityDensityNormal(t, mu, sigma, true, result);

   // Sum ln(p(x_i)) to get the log-likelihood
   double ll = 0.0;
   for(int i = 0; i < n; i++)
      ll += result[i];

   return ll;
}

//+--------------------------------------------+
//| Plot Log-Likelihood                        |
//+--------------------------------------------+
void PlotLL(const double &mu_values[], const double &ll_values[], int sec)
{
   ChartSetInteger(0, CHART_SHOW, false);
   CGraphic graphic;
   ulong width = ChartGetInteger(0, CHART_WIDTH_IN_PIXELS);
   ulong height = ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS);
   graphic.Create(0, "LL_Graphic", 0, 0, 0, int(width), int(height));
   graphic.CurveAdd(mu_values,ll_values, ColorToARGB(clrBlue, 255), CURVE_LINES, "Log-Likelihood");
   graphic.XAxis().Name("Mu");
   graphic.YAxis().Name("Log-Likelihood");
   graphic.BackgroundMain("Log-Likelihood");
   graphic.XAxis().NameSize(18);
   graphic.YAxis().NameSize(18);
   graphic.BackgroundMainColor(ColorToARGB(clrBlack, 255));
   graphic.BackgroundMainSize(24);
   graphic.CurvePlotAll();
   graphic.Update();
   Sleep(sec * 1000);
   ChartSetInteger(0, CHART_SHOW, true);
   graphic.Destroy();
   ChartRedraw(0);
}

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
{
   // Generate a synthetic sample
   MathSrand(55);
   int n = 100; // Number of observations
   double true_mu = 0.0; // True mean
   double true_sigma = 1.0; // Fixed standard deviation
   double t[]; // Sample
   ArrayResize(t, n);
   MathRandomNormal(true_mu, true_sigma, n, t);

   // Range for mu
   double mu_min = -3.0;
   double mu_max = 3.0;
   double mu_step = 0.1;
   int steps = (int)((mu_max - mu_min) / mu_step) + 1;

   double mu_values[];
   double ll_values[];
   ArrayResize(mu_values, steps);
   ArrayResize(ll_values, steps);

   // Calculate log-likelihood for each mu
   double max_ll = -DBL_MAX;
   double best_mu = 0.0;
   for(int i = 0; i < steps; i++)
   {
      mu_values[i] = mu_min + i * mu_step;
      ll_values[i] = LogLikelihood(t, mu_values[i], true_sigma);
      if(ll_values[i] > max_ll)
      {
         max_ll = ll_values[i];
         best_mu = mu_values[i];
      }
   }

   PlotLL(mu_values, ll_values, 10);

   // Display results
   Print("True mean: mu = ", true_mu);
   Print("Found mean: mu = ", best_mu);
   Print("Maximum log likelihood value: ", max_ll);
}
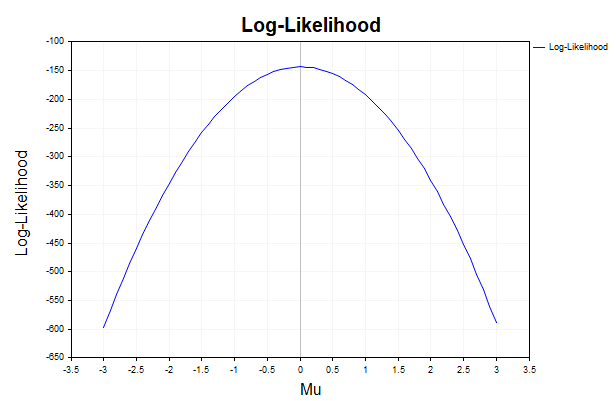
Fig. 1. Gráfico de la función de log-verosimilitud para la media de N(0,1)
Implementación del modelo MLP para un problema de regresión con la función de pérdida GaussianNLLLoss
Para predecir la distribución gaussiana condicional mediante el enfoque propuesto, utilizaremos un perceptrón multicapa (MLP), implementado en la clase MLPRegressor. La arquitectura de la red es muy sencilla: el modelo consta de una sola capa oculta y tiene un número fijo de salidas, concretamente dos; la primera corresponde a la esperanza condicional de los incrementos de precio y la segunda, a la varianza condicional.
Para garantizar una modelización correcta de estos parámetros, utilizamos funciones de activación fijas en la capa de salida: una función de activación lineal para la media y una función Softplus para la varianza, que garantiza que la varianza predicha sea positiva. El usuario puede elegir la función de activación de la capa oculta según su criterio. La lista de funciones de activación disponibles se encuentra en la sección «Aprendizaje automático / Activación» de la ayuda de MQL5.
Hay dos métodos que desempeñan un papel fundamental en el funcionamiento del modelo: la propagación hacia delante (FeedForward) y la retropropagación (Backprop). El primero calcula las predicciones μi y σi2 a partir de los datos de entrada, mientras que el segundo determina los gradientes de la función de pérdida GaussianNLLLoss para que el algoritmo L-BFGS pueda actualizar los parámetros del modelo.
FeedForward
El método FeedForward implementa la propagación hacia delante de una señal a través de una red neuronal y calcula predicciones a partir de los datos de entrada:
//+------------------------------------------------------------------+
//| Feed forward                                                     |
//+------------------------------------------------------------------+
bool MLPRegressor::FeedForward(const matrix &data)
  {
   ones_ = matrix::Ones(1, data.Rows());
   n1 = weights1.MatMul(data.Transpose()) + bias1.MatMul(ones_);
   n1.Activation(act1, ac_func);
   n2 = weights2.MatMul(act1) + bias2.MatMul(ones_);
   act2.Init(n2.Rows(), n2.Cols());
   act2.Row(n2.Row(0), 0); // First output: linear activation (copy directly)
// Second output: softplus
   vector z = n2.Row(1);
   vector sigma2;
   z.Activation(sigma2, AF_SOFTPLUS);
   act2.Row(sigma2, 1);

   return true;
  }
En la última capa, la red genera dos valores:
- μi — media obtenida directamente mediante activación lineal,
- σi2 — varianza que pasa por Softplus para que siempre sea positiva.
Backprop
El método Backprop implementa la retropropagación del error calculando los gradientes de la función de pérdida con respecto a todos los parámetros del modelo: pesos y sesgos. Estos gradientes son necesarios para entrenar el modelo utilizando el algoritmo L-BFGS:
//+--------------------------------------------------------+
//| Backprop                                               |
//+--------------------------------------------------------+
bool MLPRegressor::Backprop(const matrix &data, const matrix &target)
  {
   const double eps = 1e-6;     // Parameter for numerical stability of optimization
   vector mu = act2.Row(0);     // mu_i (network output for the mean)
   vector sigma2 = act2.Row(1); // sigma_i^2 (network output for variance)
// Limit sigma2 from below by the value of eps
   for(int i = 0; i < Sample_; i++)
     {
      sigma2[i] = MathMax(sigma2[i], eps); // max(sigma_i^2, eps)
     }
   vector t = target.Col(0);    // t_i (target variable)
   vector diff = t - mu;        // t_i - mu_i

// 1. Gradients of the loss function at the network outputs (mu_i, sigma_i^2)
   matrix DerivLoss_wrt_Output(layer2, Sample_);
   DerivLoss_wrt_Output.Row(-1*diff / sigma2 /Sample_, 0);  // dL/d(mu_i) = -(t_i - mu_i) / sigma^2_i
   vector term = 0.5 / sigma2 - 0.5 * (diff * diff / (sigma2 * sigma2)); // dL/d(sigma_i^2)
   DerivLoss_wrt_Output.Row(term/Sample_, 1); // dL/d(sigma_i^2) = (1/(2*sigma_i^2) - (t_i - mu_i)^2 / (2*sigma_i^2)^2)

// 2. Derivatives of output layer activations
   matrix deriv_act2(layer2, Sample_);
   deriv_act2.Row(vector::Ones(Sample_), 0);
   vector z = n2.Row(1);
   vector sigmoid_z;
   z.Derivative(sigmoid_z, AF_SOFTPLUS);
   deriv_act2.Row(sigmoid_z, 1);

// 3. Output layer error D2
   matrix D2 = deriv_act2 * DerivLoss_wrt_Output; // [layer2, Sample_]

// 4. Derivatives of hidden layer activations
   matrix deriv_act1;
   n1.Derivative(deriv_act1, ac_func); // [layer1, Sample_]

// 5. Hidden layer error D1
   matrix D1 = weights2.Transpose().MatMul(D2); // [layer1, Sample_]
   D1 = D1 * deriv_act1;

// 6. Calculate gradients
   matrix ones = matrix::Ones(Sample_, 1);
   gW1 = D1.MatMul(data);             // Gradients for weights1
   gb1 = D1.MatMul(ones);             // Gradients for bias1
   gW2 = D2.MatMul(act1.Transpose()); // Gradients for weights2
   gb2 = D2.MatMul(ones);             // Gradients for bias2

   return true;
  }
El método Backprop comienza calculando los gradientes de la función de pérdida con respecto a las salidas de la red: la media μi y la varianza σi². Lamentablemente, no podremos utilizar la función «LossGradient» integrada de la sección de aprendizaje automático, ya que se basa en funciones de pérdida integradas. Por lo tanto, debemos calcular nosotros mismos estos gradientes utilizando las siguientes fórmulas.
El gradiente de la función de pérdida con respecto a la media de la salida se calcula de la siguiente manera:
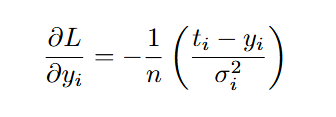
El gradiente de la función de pérdida con respecto a la varianza de la salida viene dado por:
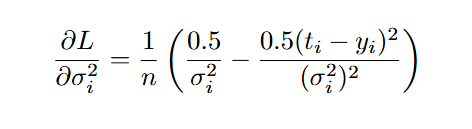
El método Backprop está adaptado a la función de pérdida GaussianNLLLoss, pero su estructura es universal. Si se desea utilizar una función de pérdida diferente, no estándar, un paso clave es calcular los gradientes con respecto a las salidas de la red. Los pasos restantes —el cálculo de las derivadas de las funciones de activación y la propagación del error— siguen las reglas estándar de la retropropagación.
Método Fit: entrenamiento de un modelo con L-BFGS
El método Fit se encarga de entrenar la red neuronal combinando la propagación hacia delante, la retropropagación y la optimización de parámetros mediante el algoritmo L-BFGS.
//+-------------------------------------------------+
//| Fit method using L-BFGS                         |
//+-------------------------------------------------+
bool MLPRegressor::Fit(const matrix &data, const matrix &target)
  {
   Sample_ = (int)data.Rows();
   Features = (int)data.Cols();
   ones_ = matrix::Ones(1, Sample_);

   ArrayResize(target_Plot, Sample_);
   for(int i = 0; i < Sample_; i++)
      target_Plot[i] = target[i, 0];

   if(!CreateNet())
      return false;

// Create an object for optimization
   MLPOptimizationObjective objective(GetPointer(this), data, target);
   MLPReportCallback frep(GetPointer(this)); // Create an object to track the loss function
   CObject obj;

// Prepare parameters
   CRowDouble params;
   objective.PackParameters(params);
   double theta[];
   ArrayResize(theta, params.Size());
   for(int i = 0; i < params.Size(); i++)
      theta[i] = params[i];

// Set up optimization parameters
   double epsg = 0.0001;     // Gradient accuracy
   double epsf = 0.00001;     // Precision by function value
   double epsw = 0.0000;   // Accuracy by parameters
   int maxits = Epochs;       // Maximum number of iterations

// Initialize and start L-BFGS
   CMinLBFGSStateShell state;
   CMinLBFGSReportShell rep;
   CAlglib::MinLBFGSCreate(params.Size(), theta, state);
   CAlglib::MinLBFGSSetCond(state, epsg, epsf, epsw, maxits);
   CAlglib::MinLBFGSSetXRep(state, true); // Enable optimization progress reports
   CAlglib::MinLBFGSOptimize(state, objective, frep, true, obj);
   CAlglib::MinLBFGSResults(state, theta, rep);

//----------TerminationType field contains completion code, which can be:
//  -8    internal integrity control detected  infinite  or  NAN  values  in
//        function/gradient. Abnormal termination signalled.
//   1    relative function improvement is no more than EpsF.
//   2    relative step is no more than EpsX.
//   4    gradient norm is no more than EpsG
//   5    MaxIts steps was taken
//   7    stopping conditions are too stringent,
//        further improvement is impossible,
//        X contains best point found so far.
//   8    terminated    by  user  who  called  minlbfgsrequesttermination().
//        X contains point which was   "current accepted"  when  termination
//        request was submitted.
//--------------------------------------------------------------------------
// Get the final array of parameters
   for(int i = 0; i < (int)params.Size(); i++)
     {
      params.Set(i, theta[i]);
     }
   objective.UnpackParameters(params);

// Final forward pass with optimized parameters
   if(!FeedForward(data))
      return false;

// Save all network outputs in one-dimensional form for later use in the PlotGraphic method
// for visualization. The array contains the parameters of the normal distribution for each observation.
   ArrayResize(NetOutput, Sample_ * layer2);
   for(int i = 0; i < Sample_; i++)
      for(int j = 0; j < layer2; j++)
         NetOutput[i * layer2 + j] = act2.Transpose()[i, j];

   PrintFormat("L-BFGS Optimization completed. Iterations: %d, Termination type: %d, Final loss: %.5f",
               rep.GetIterationsCount(), rep.GetTerminationType(), objective.GetLoss());

   for(int i = 0; i < LossCount; i++)
      PrintFormat("Iteration %d, Loss: %.5f", i, LossPlot[i]);

   return true;
  }
El entrenamiento consta de las siguientes fases. En primer lugar, se invoca el método CreateNet, que inicializa las matrices de pesos (weights1, weights2) y de sesgos (bias1, bias2) con valores aleatorios, preparando así el modelo para el entrenamiento. A continuación, se crea un objeto de la clase MLPOptimizationObjective, que conecta el modelo con el optimizador L-BFGS, proporcionando la función de pérdida y sus gradientes.
Los parámetros del modelo se convierten en un array unidimensional denominado «params» mediante el método PackParameters, para adaptarlos al formato requerido por L-BFGS. Para supervisar la convergencia, se crea un objeto de la clase MLPReportCallback, que registra los valores de la función de pérdida en el array LossPlot tras cada iteración de optimización.
A continuación, se configura el algoritmo L-BFGS utilizando los parámetros de optimización:
- epsg — precisión basada en la norma del gradiente, que determina el criterio de parada cuando los gradientes son suficientemente pequeños,
- epsf — precisión según el valor de la función de pérdida,
- epsw — precisión en función de los cambios en los parámetros,
- maxits — número máximo de iteraciones correspondiente al número de épocas especificado por el usuario.
La optimización se inicia con un vector inicial de parámetros mediante las funciones MinLBFGSCreate y MinLBFGSOptimize. Al activar la función MinLBFGSSetXRep(state, true), se invoca el método virtual Rep de la clase MLPReportCallback para guardar el historial de los valores de la función de pérdida. Una vez finalizada la optimización, los parámetros finales se extraen al array theta mediante MinLBFGSResults y se desempaquetan de nuevo en matrices de pesos y sesgos. A continuación, se realiza una última propagación hacia delante mediante el método FeedForward para obtener las predicciones del modelo. Estos resultados se almacenan en el array NetOutput para su posterior análisis o visualización.
¿Por qué se eligió L-BFGS?
Se eligió L-BFGS para entrenar el modelo MLPRegressor porque admite sin problemas funciones de pérdida definidas por el usuario, a diferencia del algoritmo de Levenberg-Marquardt, que se limita únicamente a funciones cuadráticas como el MSE.
Los métodos de gradiente estocástico, como Adam, son la opción óptima y, a menudo, la única para entrenar redes neuronales con muchas capas ocultas en grandes conjuntos de datos en los que es necesario procesar enormes cantidades de información. Sin embargo, en el análisis de cotizaciones suelen utilizarse conjuntos de datos relativamente pequeños, dado que la información histórica pierde rápidamente su capacidad predictiva. En estas condiciones, los métodos de gradiente estocástico pueden converger más lentamente que los métodos cuasi-Newton, como L-BFGS.
Clases para la integración con el optimizador L-BFGS
Para vincular nuestra clase con el método de optimización, se han implementado dos clases auxiliares: MLPOptimizationObjective y MLPReportCallback. Las utilizamos para proporcionar al optimizador las funciones de pérdida y los gradientes, así como para realizar un seguimiento del progreso de la optimización.
Clase MLPOptimizationObjectiveLa clase MLPOptimizationObjective conecta la red neuronal MLPRegressor con el algoritmo de optimización L-BFGS de la biblioteca ALGLIB. Al heredar de CNDimensional_Grad, sobrescribe la función virtual Grad para proporcionar a L-BFGS el valor de la función de pérdida GaussianNLLLoss y los gradientes necesarios para el entrenamiento.
//+------------------------------------------------------------------+ //| Class for the L-BFGS optimizer objective function | //+------------------------------------------------------------------+ class MLPOptimizationObjective : public CNDimensional_Grad { private: MLPRegressor* m_mlp; // Pointer to the neural network object matrix m_data; // Input data matrix m_target; // Target values double m_loss; // Current losses public: MLPOptimizationObjective(MLPRegressor* mlpLBFGS, const matrix &data, const matrix &target) : m_mlp(mlpLBFGS), m_data(data), m_target(target), m_loss(0.0) {} double GetLoss() { return m_loss; } // Method for converting parameters to a one-dimensional array void PackParameters(CRowDouble ¶ms) { int total_params = (int)(m_mlp.GetNumNeuronsLayer1() * m_data.Cols() + // weights1 m_mlp.GetNumNeuronsLayer1() + // bias1 m_mlp.GetNumNeuronsLayer2() * m_mlp.GetNumNeuronsLayer1() + // weights2 m_mlp.GetNumNeuronsLayer2()) ; // bias2 params.Resize(total_params); int idx = 0; // weights1 for(int i = 0; i < m_mlp.GetNumNeuronsLayer1(); i++) for(int j = 0; j < (int)m_data.Cols(); j++) params.Set(idx++, m_mlp.weights1[i,j]); // bias1 for(int i = 0; i < m_mlp.GetNumNeuronsLayer1(); i++) params.Set(idx++, m_mlp.bias1[i,0]); // weights2 for(int i = 0; i < m_mlp.GetNumNeuronsLayer2(); i++) for(int j = 0; j < m_mlp.GetNumNeuronsLayer1(); j++) params.Set(idx++,m_mlp.weights2[i,j]); // bias2 for(int i = 0; i < m_mlp.GetNumNeuronsLayer2(); i++) params.Set(idx++,m_mlp.bias2[i,0]); } // Method for unpacking parameters from a one-dimensional array void UnpackParameters(const CRowDouble ¶ms) { int idx = 0; // weights1 for(int i = 0; i < m_mlp.GetNumNeuronsLayer1(); i++) for(int j = 0; j <(int) m_data.Cols(); j++) m_mlp.weights1[i,j] = params[idx++]; // bias1 for(int i = 0; i < m_mlp.GetNumNeuronsLayer1(); i++) m_mlp.bias1[i,0] = params[idx++]; // weights2 for(int i = 0; i < m_mlp.GetNumNeuronsLayer2(); i++) for(int j = 0; j < m_mlp.GetNumNeuronsLayer1(); j++) m_mlp.weights2[i,j] = params[idx++]; // bias2 for(int i = 0; i < m_mlp.GetNumNeuronsLayer2(); i++) m_mlp.bias2[i,0] = params[idx++]; } virtual void Grad(CRowDouble ¶ms, double &func, CRowDouble &grad, CObject &obj) override { UnpackParameters(params); // Feed forward if(!m_mlp.FeedForward(m_data)) { func = DBL_MAX; for(int i = 0; i < params.Size(); i++) grad.Set(i, DBL_MAX); return; } // Calculate the loss function func = GaussianNLLLoss(m_mlp.act2, m_target,(int) m_data.Rows()); m_loss = func; // Perform backpropagation to obtain gradients if(!m_mlp.Backprop(m_data, m_target)) { func = DBL_MAX; for(int i = 0; i < params.Size(); i++) grad.Set(i, DBL_MAX); return; } // Form a gradient vector int idx = 0; for(int i = 0; i < m_mlp.GetNumNeuronsLayer1(); i++) for(int j = 0; j <(int) m_data.Cols(); j++) grad.Set(idx++, m_mlp.gW1[i,j]); for(int i = 0; i < m_mlp.GetNumNeuronsLayer1(); i++) grad.Set(idx++, m_mlp.gb1[i,0]); for(int i = 0; i < m_mlp.GetNumNeuronsLayer2(); i++) for(int j = 0; j < m_mlp.GetNumNeuronsLayer1(); j++) grad.Set(idx++, m_mlp.gW2[i,j]); for(int i = 0; i < m_mlp.GetNumNeuronsLayer2(); i++) grad.Set(idx++, m_mlp.gb2[i,0]); } };
L-BFGS trabaja con un array unidimensional de parámetros, pero nuestra red almacena los parámetros como matrices de pesos y vectores de sesgos. Por lo tanto, vectorizamos los parámetros mediante la función PackParameters y los desempaquetamos de nuevo en matrices mediante la función UnpackParameters.
El método Grad es el método principal al que recurre L-BFGS en cada iteración. Se invoca repetidamente, a veces decenas o cientos de veces por iteración, para estimar la función de pérdida y los gradientes para diferentes conjuntos de parámetros. Por lo tanto, no conviene registrar en el historial de entrenamiento todos los valores de la función de pérdida calculados por este método, ya que incluirían evaluaciones intermedias de L-BFGS que no reflejan el progreso real del entrenamiento.
Para supervisar la convergencia, se utiliza una clase MLPReportCallback independiente, que registra los valores de la función de pérdida únicamente una vez finalizada la iteración.
Clase MLPReportCallbackAl heredar de la clase CNDimensional_Rep de la biblioteca ALGLIB, nuestra clase sobrescribe la función virtual Rep para almacenar los valores de la función de pérdida en el array LossPlot y analizar posteriormente la convergencia del modelo.
//+------------------------------------------------------------------+
//| Class for tracking the network training progress                 |
//+------------------------------------------------------------------+
class MLPReportCallback : public CNDimensional_Rep
  {
private:
   MLPRegressor      *mlp;

public:
                     MLPReportCallback(MLPRegressor *mlp_instance) : mlp(mlp_instance) {}
                    ~MLPReportCallback() {}

   virtual void      Rep(CRowDouble &arg, double func, CObject &obj) override
     {
      if(mlp != NULL)
        {
         ArrayResize(mlp.LossPlot, mlp.LossCount + 1, 10000);
         mlp.LossPlot[mlp.LossCount] = func;
         mlp.LossCount++;
        }
      else
        {
         Print("MLPReportCallback: Invalid pointer to MLPRegressor");
        }

     }
  };
El algoritmo L-BFGS invoca el método Rep, pasándole los parámetros actuales del modelo (arg) y el valor de la función de pérdida (func). Es importante que la llamada a Rep se realice únicamente una vez finalizada una iteración completa de L-BFGS, y no durante los cálculos intermedios del método Grad de la clase MLPOptimizationObjective. En esta fase, solo queda almacenar la información necesaria en el array, por ejemplo, el valor de la pérdida.
Indicador para predecir la distribución condicional
Para probar el modelo MLPRegressor, escribiremos un indicador que prediga la esperanza condicional del incremento de precio y la varianza condicional.
Parámetros de entrada del indicador:
- InpPeriodWindow — tamaño de la ventana para calcular los incrementos de precio,
- InpSamples — número de ejemplos de entrenamiento,
- InpShift — número de barras para la prueba,
- InpLayer1 — número de neuronas de la capa oculta de la red,
- InpEpochs — número máximo de épocas para el entrenamiento del modelo.
Los conjuntos de datos de entrenamiento y de prueba se generan mediante las funciones CollectData y CollectTestData. Para el entrenamiento se utilizan los precios de cierre históricos. Las características forman una matriz de tamaño nsamples × (window − 1), en la que cada fila contiene los incrementos de precio de las window − 1 barras anteriores. La variable objetivo es un vector de tamaño nsamples×1 que contiene los incrementos de precio (close_i − close_i+1).
Los datos se normalizan utilizando la media (train_data_mean) y la desviación estándar (train_data_std) calculadas a partir del conjunto de entrenamiento. La normalización estabiliza el entrenamiento al mejorar la convergencia del modelo, ya que lleva las características de entrada y la variable objetivo a la misma escala. La función CollectTestData genera un conjunto de prueba para las últimas InpShift barras, aplicando los mismos parámetros de normalización.
En la función OnInit, se crea una instancia de la clase MLPRegressor con la función de activación de la capa oculta especificada. Una vez finalizado el entrenamiento, se muestran el tiempo dedicado al mismo y el número total de parámetros del modelo.
En la función OnCalculate, la previsión se realiza mediante el método Predict, y los cálculos solo se llevan a cabo cuando aparece una nueva barra.
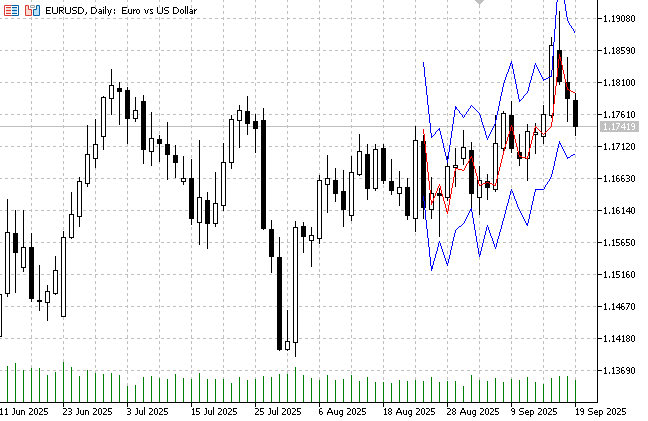
Fig. 2. Predicción del incremento medio de precio del EURUSD e intervalos de predicción del 95 %
Conclusión
En este artículo, hemos utilizado un modelo de perceptrón multicapa que predice los parámetros de una distribución gaussiana condicional. Para ello, aplicamos una función de pérdida personalizada basada en la log-verosimilitud negativa gaussiana. Esta función de pérdida nos permite modelar de forma eficaz la heterocedasticidad de los incrementos de precio, lo que supone una ventaja clave frente a los enfoques tradicionales de entrenamiento de redes neuronales basados en el error cuadrático medio (MSE), que presupone implícitamente que la varianza de la variable objetivo es constante.
Hemos descrito detalladamente la arquitectura de la clase MLPRegressor, incluidos los métodos de propagación hacia delante y de retropropagación, así como la integración con el algoritmo de optimización L-BFGS de la biblioteca ALGLIB a través de las clases MLPOptimizationObjective y MLPReportCallback.
El indicador, basado en la clase MLPRegressor, demuestra la aplicabilidad práctica del modelo, ya que permite a los operadores obtener intervalos de confianza además de la previsión de la media. Esto permite tomar decisiones más fundamentadas, al tener en cuenta no solo las fluctuaciones de precios previstas, sino también su incertidumbre, lo cual resulta especialmente valioso en mercados volátiles.
Es importante destacar que el entrenamiento de las redes neuronales no debe limitarse a funciones de pérdida estándar, como el MSE. Los experimentos con diferentes modelos probabilísticos y funciones de verosimilitud abren nuevas posibilidades para el análisis de datos. Los investigadores y los profesionales pueden adaptar los modelos de aprendizaje automático a las características específicas de los mercados financieros, lo que permite mejorar la precisión de las previsiones y comprender mejor la dinámica del mercado.
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19683
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Creación de un sistema de trading (Parte 4): Cómo influyen las salidas aleatorias en la esperanza matemática del trading
 Particularidades del trabajo con números del tipo double en MQL4
 Reimaginando las estrategias clásicas (parte 16): Rupturas de las bandas de Bollinger dobles

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Todo está bien, salvo por un detalle. Para el «indicador de previsión» debería haberse activado el parámetro PLOT_SHIFT (con las líneas proyectadas hacia el futuro), pero ahora, en lugar de la previsión, solo se muestra el «dato real» en el historial. O quizá tengamos diferentes interpretaciones del término «previsión».
Pero es que solo hacemos previsiones para el siguiente paso. No hacemos previsiones para varias barras.
En otras palabras, ¿mostramos en cada barra de prueba el precio de cierre previsto y su intervalo para una barra que, por así decirlo, aún no existe?
¿Por qué «inexistente»? La barra cero aún se está formando, pero ya hemos obtenido la previsión para ella al abrirse esta barra, ya que se ha formado un nuevo vector de indicadores. Y este pronóstico no cambia ni se recalcula, ya que depende de los precios pasados, y no de los precios pasados y actuales. ¿O se me ha escapado algo y el código mira hacia el futuro?
Probablemente no se trate de una predicción del futuro; me refería a otra cosa. Por lo que parece, el cálculo de la previsión se realiza justo al inicio de la formación de una nueva barra, es decir, en realidad solo cuando se conoce un precio de apertura de esa «barra», por eso lo he calificado, y cito, «como si no existiera».