

取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(GinAR)
 23
 0

はじめに
多変量時系列予測(MTSF)は、運輸や環境科学から、もちろん金融市場に至るまで、さまざまな分野で分析に欠かせない要素となっています。 金融分野においては、相互に関連する複数の金融商品(株式、指数、通貨)の過去の変動に基づいて、それらの将来の動向を予測する能力を意味します。 こうしたモデルを活用することで、より的確な投資判断を下し、リスクを管理するとともに、資産間に潜む関係性を明らかにすることができます。
形式的には、多変量時系列(Multivariate Time Series, MTS)は、時空間グラフとして表現できます。このグラフでは、各変数(為替レート、取引高、収益率など)が時間の経過とともに観測され、潜在的な依存関係を通じて他の変数と結び付いています。 こうした依存関係は、大きく2つに分類されます。1つは事象間の因果関係を表す「時間的依存関係」、もう1つは資産間や市場セクター間の相互依存関係を表す「空間的依存関係」です。
MTSを効果的に予測するには、こうした時空間的依存関係を特定し、活用することが不可欠です。 これは、ボラティリティが高い局面や市場ショックが発生した状況において、特に重要となります。このような状況では、従来のモデルでは十分な速さで適応できないことがあるためです。 そこで役立つのが、グラフニューラルネットワークです。 これらのモデルは、グラフ畳み込みネットワークとリカレントモデルの長所を組み合わせ、変数間の複雑な関係に基づく、より精度の高い予測を可能にします。
しかし、実際の運用はそれほど単純ではありません。 金融データはしばしば不完全です。 一部の指標が利用できなかったり、観測期間の一部でしかデータが得られなかったりすることがあります。 欠損値が生じる原因はさまざまです。データ配信の中断、指標の算出方法の変更、あるいはブローカー側の技術的なエラーなどが考えられます。 特に、主要な資産のデータが欠損すると、予測精度は大幅に低下します。 このような状況では、一般的なグラフモデルは変数間の依存関係を適切に評価できなくなり、誤差が雪だるま式に蓄積して、予測の品質が低下するおそれがあります。
この問題への対処法として、データを利用できない変数を単純に除外する方法があります。 しかし、これは短絡的な解決策です。重要な資産のデータが欠けることで、モデル全体の論理構造が損なわれ、誤った結論につながる可能性があるためです。 より高度なアプローチでは、欠損値を補う手法(補完)を用い、時間的な文脈と、資産間の相関関係やネットワーク構造などの固定的な空間的関係を組み合わせます。 しかし、欠損データの割合が高い場合や、観測できる変数と欠損している変数との間に信頼できる関係が存在しない場合、こうした手法では十分に対応できないことがあります。 その結果、再び誤差が蓄積し、予測の信頼性が損なわれてしまいます。
では、どうすればよいのでしょうか。 解決策は、学習を「補完 → 予測」という別々の段階に分けることなく、予測プロセスの中で、利用可能な変数の情報を用いて欠損データを直接補完できるモデルを構築することです。 まさにこの仕組みを実現するのが、論文「GinAR: An End-To-End Multivariate Time Series Forecasting Model Suitable for Variable Missing」で紹介されている、新しいGraph Interpolation Attention Recursive Network (GinAR)フレームワークです。 これは、多変量時系列における変数の欠損に対応するために設計された、新しいエンドツーエンドアーキテクチャです。
GinARはSRU (Simple Recurrent Unit)をベースとし、次の2つの主要な構成要素を組み込んでいます。
- 補間アテンション(Interpolation Attention, IA):利用可能なデータにAttention機構を適用し、欠損している変数を推定する仕組みです。 これにより、ゼロ値や外れ値から学習しようとすることで生じる誤差を回避できます。
- 適応型グラフ畳み込み(AGCN):欠損値の補完後に変数間の関係構造を再構築する、適応型グラフ畳み込みです。これにより、資産間の直接的な相関関係だけでなく、間接的な相関関係も考慮できます。
このように、GinARは予測すると同時に、変数間の依存関係のモデルも改良していくことで、誤差の増幅を防ぎます。 特に重要なのは、極めて厳しい条件下でも機能する点です。 フレームワークの開発者らが実データを用いて実施した実験では、変数の最大90%が利用できない状況でも、高い予測精度が維持されました。 たとえば、ポートフォリオに含まれる資産のうち、ごく一部についてしかデータを取得できず、残りの資産については情報が得られない状況を想像してみてください。それでもGinARは、システム全体の予測を生成します。
まとめると、GinARの主な成果は以下の通りです。
- 欠損変数を含む多変量時系列予測(MTSF)を対象とし、事前の補完処理を必要としないモデルとして、初めて提案されたものです。
- 新しいアーキテクチャ(IA + AGCN)によって、SRUの全結合層を置き換え、変数間の依存関係に生じる歪みを最小限に抑えます。
- 著者らの論文に示された実験結果によると、GinARは5種類のデータセットにおいて、他の11モデルを上回る性能を示しました。また、欠損率が極めて高い場合でも、安定した性能を維持しました。
金融市場にとって、これは、一部のデータが欠損していても、体系的かつ高精度な予測を実現できることを意味します。 つまり、理想的な入力データに依存することなく、適応型戦略の構築、ストレステスト、リスク管理を確実に実施できるということです。 結局のところ、現実の市場が完璧であることはありません。そしてGinARは、まさにそのような環境での利用を想定して開発されたフレームワークなのです。
GinARアルゴリズム
GinARフレームワークのアーキテクチャは、従来のEncoder → Decoder構成に従っています。 EncoderにはGinAR層を積み重ねた構造を採用し、Decoderは多層パーセプトロン(MLP)によって実装されています。 このシステムの重要な構成要素となるのが、再帰的モデリングの原理に基づくモジュールであるGinARセルです。 不完全なデータ、すなわち変数が欠損した時系列が入力された場合でも、このモデルは、完全な履歴データが存在しない変数を含め、すべての変数の将来値を同時に予測できます。
GinARの内部ロジックを設計するにあたり、フレームワークの著者らは、SRUの従来の再帰的構造に含まれるすべての全結合層を、2つの専用構成要素、すなわちIA(補間アテンション)とAGCN(適応型グラフ畳み込みネットワーク) に置き換えることを提案しました。
最初の構成要素は、利用可能な近傍変数の情報を利用して、欠損した変数を補完します。 これは、金融市場において特に重要です。主要な資産のデータが一部でも欠損すると、モデルの予測精度が大幅に低下する可能性があるためです。 IAメカニズムは、利用可能なデータに基づいて欠損時系列の意味のある表現を再構築し、ノイズの影響を最小限に抑えることで、この問題に対処します。
2つ目の構成要素であるAGCNは、資産、指数、セクター間の関係など、あらかじめ定義された固定的な依存関係グラフに頼るのではなく、学習中に適応型グラフの構造を直接学習します。 これにより、変数間の空間的な関係が時間とともに変化する場合や、その関係がすぐには明らかでない場合でも、柔軟に捉えることができます。
GinARのEncoderは、各時間ステップで、現在の特徴量と前のステップの内部状態を入力として受け取る再帰的な方式で実装されています。 GinARセルはこれらを処理して状態を更新し、現在の時間ステップに対応する隠れ表現を生成します。 このアプローチにより、欠損データの補完、依存関係グラフの再構築、動的パターンの抽出を、すべて単一のモジュール内で同時に行うことができます。 また、残差接続(スキップ接続)により、学習の安定性を損なうことなく、モデルを深く構築できます。 これは、短期的な変動と長期的なトレンドの両方が重要となる、複雑な市場シグナルの予測において特に重要です。
次のステップは予測です。 そのためには、得られた潜在表現を適切に集約する必要があります。 一方、各GinARセルの最終隠れ状態には、モデルの再帰的な性質により、入力データの時間的構造に関する完全な情報が含まれています。 他方で、多層構造とスキップ接続により、各隠れ表現は、微細な値動きから全体的な相関関係に至るまで、異なる抽象化レベルの情報を反映しています。 そのため、すべての層から得られた特徴量を1つのテンソルに統合し、Decoderに入力します。 Decoderは、直接マルチステップ予測(DMSF)戦略を用いて学習された多層パーセプトロンです。 この手法では、誤差が蓄積しやすい逐次的な反復予測に頼ることなく、予測対象期間全体(たとえば、今後5~10本のバーにわたる価格変動)を一度に予測できます。
その結果、GinARは、データの欠損、動的な関係性、時系列間の強い相関が存在する状況でも、予測タスクを効果的に処理できる堅牢なアーキテクチャを実現しています。 欠損データの補完、グラフ学習、予測を単一のエンドツーエンドのソリューションに統合することで、現実の市場に存在する不確実性に適応できるモデルとなっています。
補間アテンション(IA)メカニズムは、履歴データが完全に欠損している変数の表現を再構築するために設計されています。 欠損している変数ごとに、再構築の基礎となる観測変数の集合と、それぞれの変数に対応する影響の重みを決定する必要があります。 この処理は、主に2つの段階から構成されます。まず、欠損変数と利用可能な変数との対応関係を確立し、次にAttentionを適用して情報を集約し、表現を再構築します。
第1段階では、変数間の対応行列を構築します。 単位行列IN ∈ Rᴺ*ᴺと、変数の2つの行列埋め込みEIA1 ∈ Rᴺ*ᵈおよびEIA2 ∈ Rᵈ*ᴺを初期化します。 これらの埋め込みは、モデルとともに学習されます。 変数間の相関行列は、次の式を用いて計算されます。
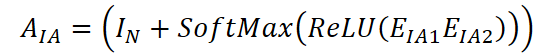
行列AIA ∈ Rᴺ*ᴺの要素(i, j)は、変数iとjの間の関係の強さを表します。 この値が正であれば、観測変数 jを利用して、欠損している変数iを補完できることを示します。 したがって、欠損変数iごとに、関連する観測変数の集合N(i)⊆ {1,…,N}を特定できます。
対応関係を特定した後、Attention機構を用いて欠損変数の表現を再構築します。 そのために、Attention係数aijを計算します。この係数は、観測変数jが変数i の再構築においてどの程度重要であるかを表します。
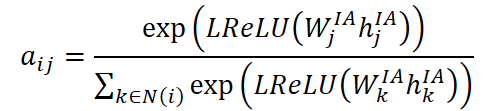
ここで、hᴵᴬjは変数jの現在の隠れ表現、Wᴵᴬjは学習可能な重み行列です。 活性化関数にはLReLUを使用します。これにより、活性化が弱い場合に勾配がゼロになるのを防ぎます。
得られた係数を用いて、観測変数から情報を集約します。 欠損変数iの表現は、次の式によって再構築されます。
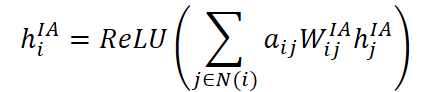
ここで、Wᴵᴬijは、変数iとjの各ペアに対して個別に設定される学習可能な重み行列です。また、外れ値に対する頑健性を高めるため、最終的な集約結果はReLUを用いて正規化されます。
この処理をすべての欠損変数に対して繰り返し、M個すべての欠損成分の表現を再構築します。 その結果、新しいテンソルXᴵᴬM ∈ Rᴺ*ᴴ*ᶜ′が得られます。このテンソルでは、以前は欠損していた変数を含め、すべての変数が完全な隠れ表現を持ちます。 なお、実際の実装では、表現の再構築を効率化するため、ステップ2とステップ3に行列乗算と並列計算を利用します。
このように、補間アテンション(IA)を用いることで、変数間の関係構造を事前に厳密に定義することなく、欠損変数を含む多変量時系列(MTS)のデータを柔軟に補完できます。 これは、資産間の相関構造が変動しやすく、過去のデータが不完全であったり、ノイズを含んでいたりする可能性のある金融予測タスクにおいて、特に重要です。
多変量時系列予測(MTSF)では、変数間の空間的依存関係を表すために、事前定義されたグラフ構造がしばしば使用されます。 そのために隣接行列Aを定義し、モデルが潜在的な関係性を捉えられるようにします。 しかし、欠損データが大量に存在する場合、特に複数の変数について完全な情報が得られない場合には、このような事前定義グラフ構造だけでは不十分なことがあります。 この制約を克服するため、フレームワークの著者らは、事前定義されたグラフ構造とデータから生成されるグラフを組み合わせる適応型グラフ畳み込みを導入しました。
事前定義グラフ構造は、交通ネットワークなどの場合には距離情報に基づいて構築されます。一方、データにトポロジー情報が含まれていない場合には、変数間のピアソン相関係数を用います。 この場合、グラフ畳み込みに使用する隣接行列は、次のように計算されます。
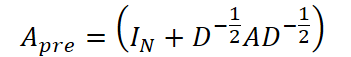
ここで、IN ∈ Rᴺ*ᴺは単位行列、Dはグラフ頂点の次数行列、Aは元の隣接行列です。 この正規化によって、学習中の重みのスケールが安定します。
しかし、一部の変数が欠損している場合や、変数間の関係が不明な場合には、空間的依存関係を動的に特定する必要があります。 そのために、データから適応型グラフを構築し、学習します。 この処理は、単位行列IN ∈ Rᴺ*ᴺ の初期化と、変数の埋め込み EA ∈ Rᴺ*ᵈのランダム初期化から始まります。 これらの埋め込みは、モデルの学習に伴って更新されます。
IAによって変数を補完すると、隠れ表現のテンソルXᴵᴬM ∈ Rᴺ*ᴴ*ᶜ′ が得られます。 次に、埋め込みと時間的表現の両方を組み合わせて、変数の更新された表現En ∈ Rᴺ*ᵈ を計算します。
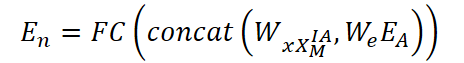
ここで、Wx および Weは、それぞれ時間的特徴量と埋め込みに対応する学習可能な重み行列です。また、concat(⋅)は最後の軸に沿ってデータを連結する演算を表します。 この表現を用いて、適応型隣接行列を構築します。
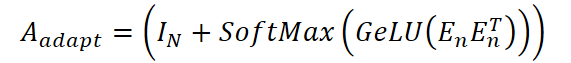
最後に、適応型グラフ畳み込みを用いて、2つのグラフから得られる情報を集約します。この処理では、2つのチャネルを組み合わせます。一方は事前定義されたグラフ構造を使用し、もう一方は適応型グラフ構造を使用します。 変数の最終的な表現は、次の式で計算されます。
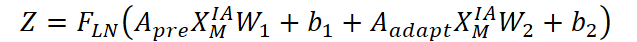
この設計により、静的な空間情報と動的な空間情報を統合できます。これは、一部の変数が欠損した多変量時系列を予測する際に、特に重要です。
2つのグラフを組み合わせることで、モデルは堅牢性と適応性を兼ね備えた構造を獲得し、変数間の依存関係をより正確に特定できるようになります。その結果、短期および中期の予測精度の向上が期待できます。
GinARアーキテクチャの主な考え方は、補間アテンション(IA)と適応型グラフ畳み込み(AGCN)を、単純な再帰モデルに統合することです。 この組み合わせにより、欠損変数を補完するだけでなく、時空間的依存関係も効果的に考慮することができます。
ここでは、GinARセルの構造と、データを予測するまでの処理を段階的に詳しく見ていきます。
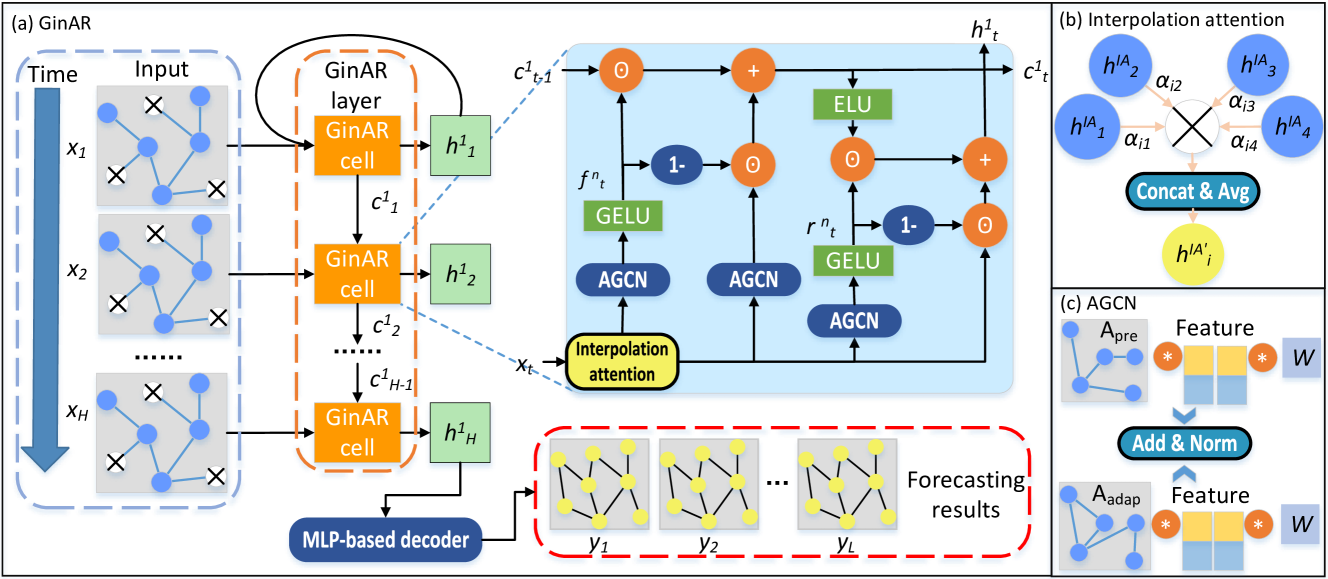
単一の時間ステップにおいて、GinARセルは基本的な計算単位として機能します。 このセルは、IAを用いて欠損した入力値を補完し、AGCNを用いて変数間の空間的な関係を処理します。 入力テンソル xTは、まず補間アテンションによって変換されます。
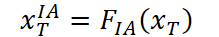
次に、忘却ゲート fTとリセットゲート rTを、事前定義グラフApreと適応型グラフAadapt からの情報を集約することで計算します。
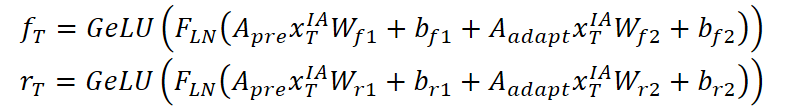
新しい状態 cTは、現在の変換済み入力と前の状態cT-1を、忘却ゲートによって重み付けして組み合わせることで形成されます。
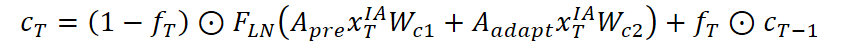
最後に、隠れ状態hTは、更新されたセル状態と入力を非線形に組み合わせることで計算されます。
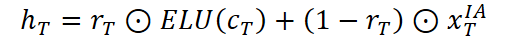
このように、各GinARセルは、データの補完と空間情報の集約を含む一連の処理を通じて、内部状態を更新します。
全体構造を見ると、GinAR Encoderは複数のGinAR層で構成されています。 各層は、直列に接続されたH個のセルから成ります。 まず、元の入力データX∈Rᴺ*ᴴ*ᶜを正規化し、マスキング処理を施して、テンソルXM∈Rᴺ*ᴴ*ᶜを生成します。このとき、M個の変数の値はゼロに設定されます。
次に、XMを最初のGinAR層に入力します。この層では、各セルが1つの時間ステップを処理します。 まず状態c₀を初期化し、x₁とc₀を最初のセルに入力して、h¹₁とc₁を生成します。 続いて、これらの値をx₂とともに次のセルに渡し、同じ処理を繰り返します。 その結果、第1層の隠れ状態の系列h¹ = [h¹₁, h¹₂, …, h¹H]が得られます。
このテンソルは次の層への入力となります。 この処理を、n層すべてで繰り返します。 その後、各層から最後の隠れ状態hHⁱを抽出し、それらを連結して最終ベクトルhallnを生成します。
最終表現hallnは、多層パーセプトロン(MLP)に基づくDecoderに入力され、予測値が生成されます。
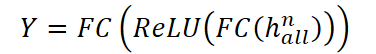
このように、GinARは、データの補完と時空間的依存関係のモデリングを単一の再帰的・畳み込み型フレームワークに統合することで、欠損値を含む時系列データをエンドツーエンドで処理します。
以下に、GinARフレームワークの著者らによる構成図を示します。
MQL5での実装
GinARフレームワークの理論的な側面を確認したので、次は実践編に進みます。ここでは、フレームワークの著者らが説明した手法をMQL5で実装する方法の一例を紹介します。
ただし、主要なアルゴリズムの開発に着手する前に、いくつかの準備作業が必要です。 前述のGinARの説明からわかるように、元のアルゴリズムでは、SoftMax関数を用いたデータの正規化が繰り返しおこなわれます。 そこで、今回はこれをOpenCLプログラム内の独立した関数として実装することにしました。これにより、多変量データを扱う際の柔軟性と高いパフォーマンスを確保できます。
準備作業
アルゴリズムを整理して実装するため、処理を複数の機能ブロックに分割しました。 まず、最初のブロックとして、ワークグループ内のスレッドが計算した値の最大値を求める処理から始めます。 この処理を担うのがLocalMax関数です。
LocalMax関数は、2つのパラメータを受け取ります。1つ目は現在のスレッドで計算された値、2つ目はスレッドをワークグループにグループ化する際の基準となる、タスク空間内の次元インデックス(loc)です。
#define BarrierLoc      barrier(CLK_LOCAL_MEM_FENCE)
float LocalMax(const float value, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
最初に、ローカルワークグループ内でのスレッドIDと、ワークグループ全体のサイズを取得します。 次に、デバイスのローカルメモリ上にTemp配列を作成します。この配列は、同じワークグループ内のスレッド間で中間値をやり取りするために使用されます。
続いて、プログラムはワークグループ内に形成されたすべてのサブグループを順に処理し、それぞれの局所最大値を求めます。 各値はTemp配列の要素に格納されます。
//--- Find Max
   for(int d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls) &&
         (d == 0 || Temp[id - d] < value))
         Temp[id - d] = IsNaNOrInf(value, MIN_VALUE);
      BarrierLoc;
     }
その後、反復的なリダクション(縮約)処理を開始し、Temp配列を1つの値に集約します。この値は、配列内のすべての要素の最大値です。
   int count = ls;
   do
     {
      count = (count + 1) / 2;
      if(id < count && (id + count) < ls && Temp[id] < Temp[id + count])
         Temp[id] = Temp[id + count];
      BarrierLoc;
     }
   while(count > 1);
//---
   return IsNaNOrInf(Temp[0], MIN_VALUE);
  }
これらの処理の結果は、呼び出し元のプログラムに返されます。
先ほどのLocalMax関数と同様に、次はもう1つの基本的な処理ブロックとして、ローカルワークグループ内の要素を合計する関数を作成します。 この処理を担うのがLocalSum関数です。LocalMaxと同じ原理に基づいていますが、最大値を求める代わりに加算をおこないます。
float LocalSum(const float value, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
初期段階では、これまでと同様に、スレッドIDとワークグループのサイズを取得します。 また、中間的な合計値を格納するため、ローカルメモリ上にTemp配列を作成します。
次に、ローカルワークグループ内のすべてのスレッドを順に処理し、中間値を累積していきます。 ここで注目すべきなのは、条件d == 0の使用です。この条件により、最初の反復時にTemp配列が正しく初期化されます。
//--- Sum
   float result = IsNaNOrInf(value, 0);
   for(int d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls))
         Temp[id - d] = (d == 0 ? result : Temp[id - d] + result);
      BarrierLoc;
     }
その後、先ほどと同じリダクション処理を行い、各ステップで要素数を半分に減らしていきます。ここでは、要素同士を比較する代わりに、Temp配列の要素を単純に加算します。
   int count = ls;
   do
     {
      count = (count + 1) / 2;
      if(id < count && (id + count) < ls)
         Temp[id] += Temp[id + count];
      BarrierLoc;
     }
   while(count > 1);
   result = IsNaNOrInf(Temp[0], 0);
//---
   return result;
  }
ワークグループ内のすべての要素の合計である最終値が、呼び出し元のプログラムに返されます。
準備作業の最終段階では、これまでに実装した補助関数LocalMaxとLocalSumを、ワークグループ内の値を数値的に安定した方法で正規化するLocalSoftMax関数の単一のアルゴリズムに統合します。
float LocalSoftMax(const float value, const int loc)
  {
//--- Look Max
   const float max = LocalMax(value, loc);
   BarrierLoc;
LocalSoftMax関数内では、まずLocalMaxが呼び出され、ワークグループ内のすべてのスレッドの中から最大値が求められます。 これは、計算を安定させるために必要な処理です。各値から最大値を引くことで、オーバーフローを防ぎ、指数関数の計算における数値的な安定性を向上させます。
次に、このシフト処理を適用した状態で、各値の指数関数が計算されます。 この演算の結果は一時的に変数resultに格納され、その後、LocalSum 関数を呼び出して、グループ内の指数値の総和を計算します。
//--- SoftMax
   float result = IsNaNOrInf(exp(value - max), 0);
   const float sum = LocalSum(result, loc);
   result = IsNaNOrInf(result / (sum == 0 ? 1 : sum), 0);
//---
   return result;
  }
続いて、正規化をおこないます。resultを指数関数の値の総和で割ることで、正規化された値が得られます。 また、ゼロ除算を防ぐため、合計値がゼロの場合には、分母として1が使用されます。 最後に、正規化された値を返します。
このような構造にすることで、SoftMaxを後続のOpenCLカーネルで柔軟に利用できる基本構成要素として実装できます。 これにより、コードが整理され、デバッグが容易になるとともに、アーキテクチャ全体の可読性も向上します。特に、MQL5における GinARの実装で使用されるグラフモデルやAttention機構において、この点は重要です。
しかし、SoftMaxの順伝播処理だけでは、モデルを学習させるには不十分です。 誤差逆伝播時に重みを正しく更新するには、適切な勾配伝播関数を実装する必要があります。 この関数により、入力値の変化が最終的な誤差にどのような影響を与えるかを、モデルが考慮できるようになります。
この機能を実装するために、LocalSoftMaxGrad関数を使用します。この関数は、入力値に対するSoftMax関数の勾配を計算します。 入力パラメータは、SoftMaxの出力に相当する値value、後続のネットワーク層から渡される勾配grad、そしてワークグループの形成に使用されるタスク空間の次元インデックスlocです。
float LocalSoftMaxGrad(const float value, const float grad, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
関数の冒頭では、現在のスレッドのIDと、ローカルワークグループ内のスレッドの総数を取得します。 さらに、LocalMaxやLocalSumで行った方法と同様に、中間値を格納するためのローカル配列Tempを作成します。 また、val変数には、エラーへの対策を施した入力値が格納されます。
   float result = 0;
   float val = IsNaNOrInf(value, 0);
   for(uint d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls))
         Temp[id - d] = IsNaNOrInf(val * grad, 0);
      BarrierLoc;
      for(uint l = 0; l < min(ls, (uint)(total - d)); l++)
         result += Temp[l] * ((float)((d + l) == id) - val);
      BarrierLoc;
     }
//---
   return result;
  }
次に、ワークグループ全体に含まれるサブグループを順番に処理します。 各ブロックでは、積val * gradの値を一時バッファに格納するとともに、SoftMaxの導関数の標準的な公式を使用して、result変数に計算結果を累積していきます。 この式では、論理条件(d + l) == idが使用されています。これにより、ヤコビ行列の対角成分と非対角成分の両方が、正しく処理されるようになります。
関数の戻り値は、指定された入力要素に対応する最終的な勾配です。 この値は呼び出し元のカーネルに返され、モデルのアーキテクチャにおいて逆伝播処理が正しく実行されるようにします。
以上により、この関数はOpenCLモジュールにおけるSoftMaxの処理サイクルを完成させます。つまり、順伝播の計算から、適切な勾配の誤差逆伝播まで、一連の処理が実装されます。
補間アテンション
SoftMax やその勾配の伝播など、基本演算の実装に関する準備作業が完了したので、次に GinARアーキテクチャにおいて重要な役割を果たす補間アテンション 機構の構築に進みます。 最初の段階では、OpenCLを使用してこのアルゴリズムの順伝播処理を実装し、グラフィックスアクセラレータ上で効率的な並列処理を実現することを目指します。
InterpositionAttentionカーネルは、入力として次の複数の配列を受け取ります。
- 入力特徴行列matrix_in
- 学習可能なパラメータWおよびA
- 潜在表現GL
- 隣接行列Adj
- 中間表現H
- Attention値Atten
- 結果行列matrix_out
また、特徴空間の次元数を表すdimensionも引数として渡されます。
__kernel void InterpositionAttention(__global const float* matrix_in,
                                     __global const float* W,
                                     __global const float* A,
                                     __global const float* GL,
                                     __global float* Adj,
                                     __global float* H,
                                     __global float* Atten,
                                     __global float* matrix_out,
                                     const int dimension
                                    )
  {
   const size_t i = get_global_id(0);
   const size_t j = get_local_id(1);
   const size_t total = get_global_size(0);
   const size_t total_loc = get_local_size(1);
実行の開始時に、グローバルスレッドインデックスiとローカルスレッドインデックスjを定義します。これらのインデックスは、入力配列および出力配列の各要素にアクセスするために使用されます。 次に、グローバルバッファ内の部分配列に正しくアクセスできるように、適切なオフセットを計算します。
const int shift_i = i * dimension;
const int shift_j = j * dimension;
const int shift_adj = i * total_loc + j;
最初のステップでは、GL配列に格納された各ノードの潜在表現を要素ごとに乗算し、ノードiとノードjの間の隣接重みを計算します。
float adj = 0;
for(int d = 0; d < dimension; d++)
   adj += IsNaNOrInf(GL[shift_i + d] * GL[shift_j + d], 0);
adj = max(IsNaNOrInf(adj, 0), 0);
adj = LocalSoftMax(adj, 1);
Adj[shift_adj] = adj;
adj += (float)(i == j);
その結果を変数adjに累積し、LocalSoftMax関数を使用して正規化した後、隣接行列Adjに格納します。 続いて、iとjが一致する場合にはadjに1を加算し、対角要素が保持されるようにします。
次に、中間表現Hの生成に進みます。 これを実現するために、現在のノードの入力特徴量に対して、学習可能な重み行列Wを用いた乗算を順次実行します。 各計算結果は配列Hに格納され、スレッド間の同期にはBarrierLocバリアを使用します。
for(int id_h = 0; id_h < dimension; id_h += total_loc)
  {
   if(j >= (dimension - id_h))
      break;
   float h = 0;
   for(int w = 0; w < dimension; w++)
      h += IsNaNOrInf(matrix_in[shift_i + w] * W[(id_h + j) * dimension + w], 0);
   H[shift_i + id_h + j] = h;
   BarrierLoc;
  }
Hが形成されたら、次にAttention値eを計算します。この値は、ノードiとjの間の相互作用の重要度を表します。 ゼロ除算を防ぐため、値は小さな正の数で初期化されます。 各要素間に正の相関がある場合はHの対応する行と学習可能なベクトルAとの重み付き内積を累積します。 その結果をLocalSoftMax関数で再度正規化し、配列Attenに格納します。
float e = 1e-12f;
if(adj > 0)
  {
   e = 0;
   for(int a = 0; a < dimension; a++)
      e += IsNaNOrInf(H[shift_i + a] * A[a], 0) + IsNaNOrInf(H[shift_j + a] * A[dimension + a], 0);
  }
e = LocalSoftMax(e, 1);
Atten[shift_adj] = e;
最後のステップでは、他の観測変数から得られた情報に基づいて、分析対象の変数の値を補完します。 欠損している、または補完対象となる変数iの値は、各変数 jの表現に対応するAttention係数を乗じ、それらを重み付き和として集約することで算出されます。 このような集約処理により、近傍の変数から対象変数へ有用な情報を伝達できます。
 for(int d = 0; d < dimension; d += total_loc)
   {
    if(j >= (dimension - d))
       break;
    float out = 0;
    int shift_h = d + j;
    int shift_att = i * total_loc;
    int shift_out = i * dimension + shift_h;
    for(int n = 0; n < total_loc; n++)
       out += IsNaNOrInf(H[shift_h + n * dimension] * Atten[shift_att + n], 0);
    matrix_out[shift_out] = Activation(out, ActFunc_LReLU);
   }
}
外れ値に対する頑健性を高め、異常値の影響を軽減するため、得られた値は活性化関数LReLUを使用して正規化されます。 これにより、特に不安定なデータセットやノイズを含むデータセットを扱う場合に、モデルの学習をより安定させることができます。
このステップにより、補間アテンションの順伝播処理が完了し、変数間の内部的な関係と学習された相関パラメータの両方を考慮した、変数iの最終的な表現が生成されます。
以上のように、ここで説明したOpenCLカーネルは、並列処理を効果的に活用してグラフ構造の各要素を処理し、補間アテンションの順伝播処理を実装しています。 これにより、潜在特徴量に基づいて時系列内の要素間の相互作用を適応的にモデル化できるようになります。その結果、コンテキストを考慮しながら、データ構造に柔軟に適応するモデルを構築できます。
次のステップでは、補間アテンションの逆伝播アルゴリズムを実装し、これもOpenCLカーネルとして構成します。 この関数では、順伝播処理に関与するすべてのパラメータと入力データについて、勾配を計算します。
このコードの基本的な考え方は、各要素について、中間変数である隠れ特徴量H、Attention係数Atten、入力行列、重み、および特徴量行列GLに対する誤差の偏微分を計算することです。
__kernel void InterpositionAttentionGrad(__global const float* matrix_in,
                                         __global float* matrix_in_gr,
                                         __global const float* W,
                                         __global float* W_gr,
                                         __global const float* A,
                                         __global float* A_gr,
                                         __global const float* GL,
                                         __global float* GL_gr,
                                         __global float* Adj,
                                         __global float* H,
                                         __global float* H_gr,
                                         __global float* Atten,
                                         __global float* matrix_out_gr,
                                         const int dimension
                                        )
  {
   const size_t i = get_global_id(0);
   const size_t j = get_local_id(1);
   const size_t total = get_global_size(0);
   const size_t total_loc = get_local_size(1);
カーネル内では、インデックスiおよびjによって識別される各スレッドにおいて、次の一連の計算が順番に実行されます。
- 出力勾配とAttention重みを基に、隠れ特徴量に対する勾配Hgradを計算します。この際、LeakyReLU活性化関数の影響も考慮します。
   const int shift_i = i * dimension;
   const int shift_j = j * dimension;
   const int shift_adj = i * total_loc + j;
//--- H Gradient
   for(int d = 0; d < dimension; d += total_loc)
     {
      if(j >= (dimension - d))
         break;
      float h_grad = 0;
      int shift_h = shift_i + d + j;
      int shift_att = i;
      int shift_out = d + j;
      for(int n = 0; n < total_loc; n++)
        {
         float gr = matrix_out_gr[shift_out + n * dimension];
         h_grad += IsNaNOrInf(
                      Deactivation(gr, gr, ActFunc_LReLU) * Atten[shift_att + n * total_loc], 0);
        }
      H_gr[shift_h] = h_grad;
      BarrierLoc;
     }
- 次に、Attention係数に関する勾配Attgradを計算し、SoftMaxの逆伝播処理に渡します。これにより、Attention分布における誤差が適切に伝播されるようにします。
//--- Attention Gradient
   float att_grad = 0;
   for(int d = 0; d < dimension; d++)
     {
      float gr = matrix_out_gr[shift_i + d];
      gr = Deactivation(gr, gr, ActFunc_LReLU);
      att_grad += IsNaNOrInf(gr * H[shift_j + d], 0)
     }
   att_grad = LocalSoftMaxGrad(Atten[shift_adj], att_grad, 1);
- 次に、この勾配を使用して、行列Aの重みを考慮しながら、隠れ特徴量Hに対する勾配を更新するとともに、行列A自体に対する勾配も累積します。
for(int d = 0; d < dimension; d++)
  {
   float h_grad = att_grad * A[d];
   h_grad = LocalSum(h_grad, 1);
   if(j == 0)
      H_gr[shift_i + d] += h_grad;
   h_grad = att_grad * A[dimension + d];
   h_grad = LocalSum(h_grad, 1);
   if(j == 0)
      H_gr[shift_j + d] += h_grad;
   float a_grad = att_grad * H[shift_i + d];
   a_grad = LocalSum(a_grad, 1);
   A_gr[d] += a_grad;
   a_grad = att_grad * H[shift_j + d];
   a_grad = LocalSum(a_grad, 1);
   A_gr[dimension + d] += a_grad;
  }
- 隠れ特徴量Hに対する勾配と重み行列Wを使用して、入力特徴量に対する勾配を計算します。これにより、学習時に入力データに関する勾配を正しく求められるようになります。
//--- Input Gradient
   for(int d = 0; d < dimension; d += total_loc)
     {
      if(j >= (dimension - id_h))
         break;
      float grad = 0;
      for(int w = 0; w < dimension; w++)
         grad += IsNaNOrInf(H_gr[shift_i + w] * W[(id_h + j) + dimension * w], 0);
      matrix_in_gr[shift_i + d + j] = grad;
      BarrierLoc;
     }
- 最後に、隣接行列に対してSoftMaxの逆伝播処理を適用し、適応行列GLに対する勾配を計算します。その勾配を、変数iと変数jの両方について累積します。
//--- Adj Gradient
   float grad = LocalSoftMaxGrad(Adj[shift_adj], att_grad, 1);
   for(int d = 0; d < dimension; d++)
     {
      GL_gr[shift_i + d] += IsNaNOrInf(grad * GL[shift_j + d], 0);
      GL_gr[shift_j + d] += IsNaNOrInf(grad * GL[shift_i + d], 0);
     }
  }
関数全体の構造は、ローカルスレッド間の同期処理(BarrierLoc)を用いて構築されています。これにより、スレッド間のデータ交換が正しく行われることを保証し、競合状態の発生を防ぎます。
このアプローチにより、学習中にモデルのすべてのパラメータを正確かつ安定的に更新できます。その結果、重みを効果的に調整し、多変量時系列における欠損値補完の精度を向上させることができます。
この段階で、OpenCLプログラムの主要な構成要素の実装が完了しました。 次のステップとして、MQL5の機能を活用し、メインプログラム内で一連の処理を統合していきます。具体的には、各機能の統合、計算処理の管理、そしてモデルの学習を行います。 しかし、すでに説明する内容がかなり多くなっているため、解説の明瞭さと質を維持するために、ここでいったん区切りを設けたいと思います。
この重要な作業は次回の記事で引き続き取り上げ、MQL5におけるアルゴリズムの実践的な実装方法、OpenCLとの連携に関する詳細、そしてパフォーマンスの最適化について詳しく解説します。 これにより、各段階を急ぐことなく、十分な深さと丁寧さを保ちながら検討できます。
結論
最後に、本記事で紹介したGinARフレームワークは、欠損値を含む多変量時系列の予測に対して、強力なアプローチを示すものであることを強調しておきます。 補間アテンションと適応型グラフ畳み込みを再帰型アーキテクチャに統合することで、欠損データを効果的に補完するとともに、複雑な時空間的依存関係を考慮できるようになります。
本記事で紹介した主要な構成要素のOpenCLによる実装は、今後、実際の取引システムへの統合や、さらなる最適化を進めるうえで、幅広い可能性を切り開くものです。
今後は、今回の成果をMQL5のメインプログラムに統合することに重点を置き、提案した手法の可能性を最大限に引き出していく予定です。 ぜひ、次回の記事でも引き続き本テーマを掘り下げていきましょう。
参考文献
- GinAR: An End-to-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラムのコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18854
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(主要構成要素)
 取引におけるニューラルネットワーク:確率的時系列予測(最終回)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:確率的時系列予測(Encoder)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索