

Neuronale Netze im Handel: Das adaptive Graphdiffusionsmodell (Attention-Modul)
 18
 0

Einleitung
Im vorherigen Artikel haben wir das SAGDFN-Framework kennengelernt. Wir haben die wichtigsten Funktionsprinzipien erörtert und die Stärken des Systems hervorgehoben. Aber der Markt ist kein Museum für Architekturmodelle. Hier ist kein Platz für übermäßiges Zögern oder leblose Schemata. Damit ein Gebäude stehen bleibt, muss es Stein für Stein errichtet werden, wobei jede Etage auf ihre Stabilität überprüft werden muss.
Das SAGDFN-Framework wurde ursprünglich als Antwort auf eines der ältesten und zugleich drängendsten Probleme an den Finanzmärkten konzipiert: Datenredundanz und Rauschen, das die tatsächlichen Signale überdeckt. Herkömmliche Analysemethoden gingen entweder in dieser Informationsflut unter oder versuchten, sie durch grobe Filterung zu reduzieren. SAGDFN bietet jedoch einen anderen Ansatz – nicht nur zu filtern, sondern intelligent auszuwählen. Die Autoren des Frameworks schlugen vor, nur jene Nachbarn beizubehalten, die das Verhalten des Systems tatsächlich beeinflussen. Das lässt sich mit einem alten Handelssprichwort vergleichen: Höre auf den Markt, aber lerne, die Rufe der Menge vom Flüstern derer zu unterscheiden, die den Weg kennen.
Das zentrale Konzept, auf dem die gesamte Architektur aufbaut, ist das Significant Neighbors Sampling – ein dynamisches System zur Auswahl signifikanter Nachbarn. Stellen Sie sich einen alten Hafen vor, in dem jede Minute Hunderte Schiffe einlaufen und Neuigkeiten aus allen Meeren mitbringen. Nicht alle sind für Ihr Unternehmen von Bedeutung: Manche transportieren lediglich Gerüchte aus ausländischen Märkten, während andere Fracht befördern, die schon morgen ihren Wert verlieren wird. Das Ziel von SAGDFN ist es, nur diejenigen zuzulassen, deren Segel den Handel wirklich in die richtige Richtung lenken. Um dies zu erreichen, nutzt das Modell eine Kombination aus deterministischer Wichtigkeitsbewertung und kontrollierter Zufälligkeit – eine Art „Wind der Veränderung“, der verhindert, dass das System in bestehenden Verbindungen verharrt, und dadurch das Risiko einer Überanpassung verringert.
Ein weiteres, ebenso wichtiges Element ist der α-Entmax-Mechanismus – ein mathematischer „Dirigent“ der Attention-Verteilung. Im Gegensatz zum sanften, aber allumfassenden SoftMax verteilt er seine Stärke nicht auf alle Eingänge, sondern macht die Verteilung dünn besetzt und setzt starke Akzente dort, wo sie wirklich gebraucht werden. Das entspricht der alten Kaufmannsweisheit: Man soll sein Kapital nicht für Nebensächlichkeiten verschwenden, sondern in das investieren, was den größten Ertrag bringt.
SAGDFN zeichnet sich zudem durch seine Ausgewogenheit zwischen lokalem und globalem Kontext aus. Wie ein erfahrener Analyst kann es den Markt aus nächster Nähe betrachten – indem es benachbarte Daten, einzelne Kursbalken und lokale Cluster von Transaktionen analysiert. Gleichzeitig behält es dabei den Gesamtzusammenhang im Blick: Trends, etablierte Muster und die Struktur langfristiger Strömungen. In dieser Hinsicht fungiert es als Navigator, der das Schiff anhand der Sterne steuert, dabei aber die Tiefe unter dem Kiel nicht aus den Augen verliert.
Die Architektur des SAGDFN-Frameworks ist modular und erweiterbar, was unter sich ständig ändernden Handelsbedingungen besonders wertvoll ist. Hier gibt es keine Steinmauern, die den Forscher einschränken könnten. Jeder Block – ob für die Nachbarauswahl, die Attention-Normalisierung oder die Integration externer Datenquellen – kann verfeinert, optimiert oder ersetzt werden.
Nachfolgend ist die von den Autoren erstellte Darstellung des SAGDFN-Frameworks abgebildet.
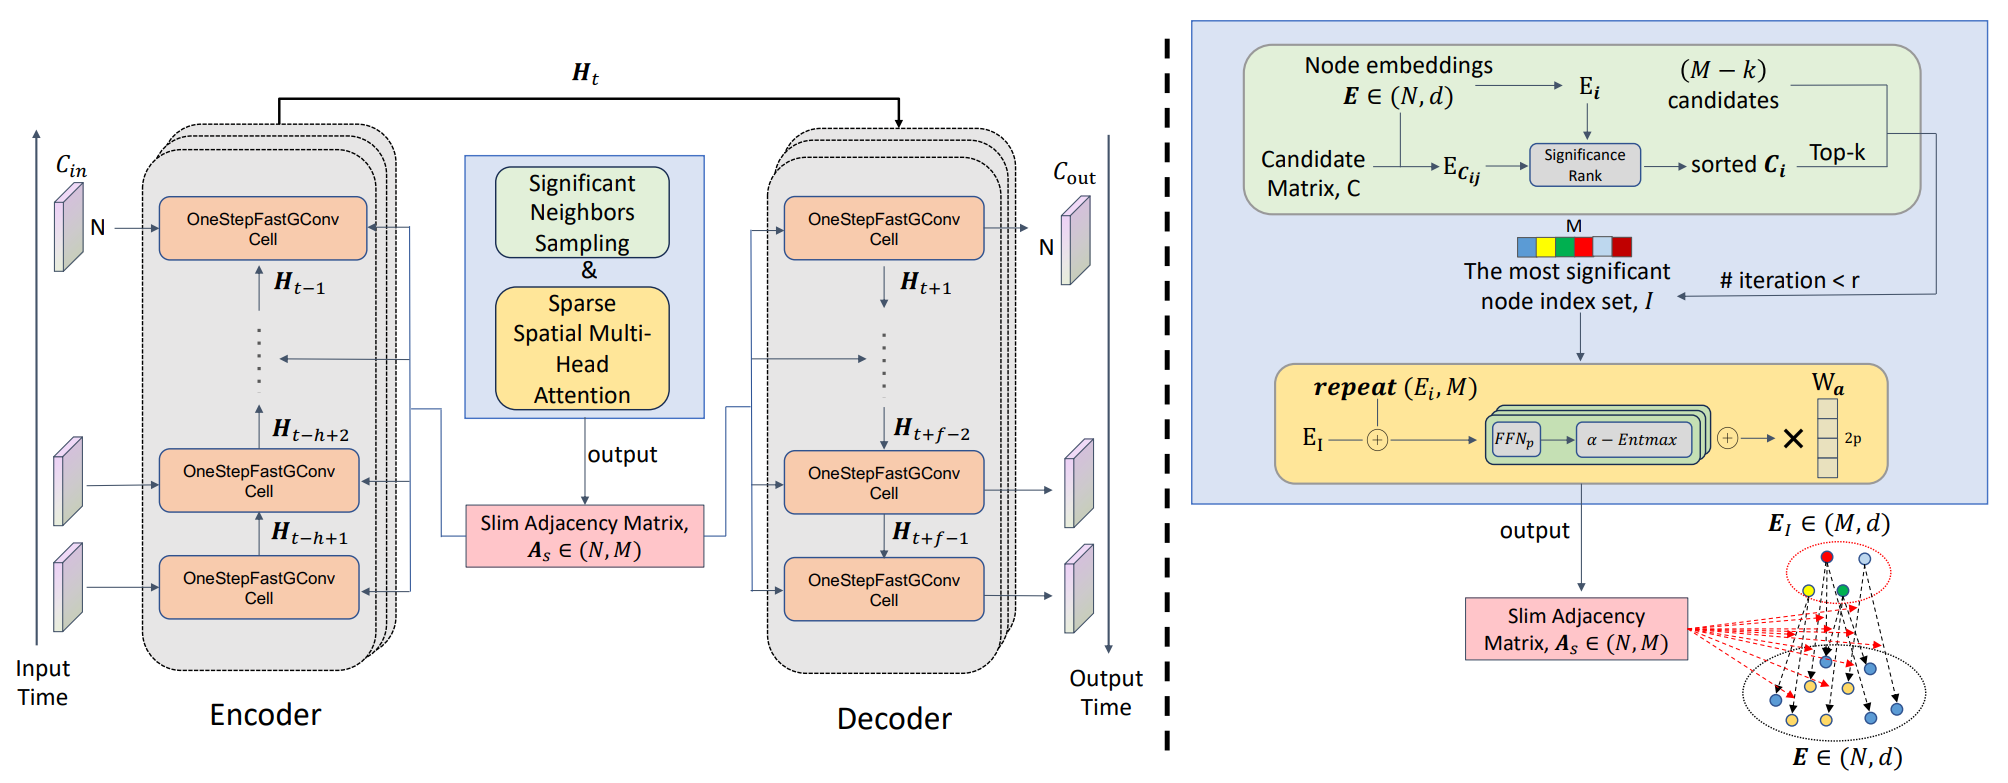
Im praktischen Teil des vorherigen Artikels haben wir bereits den ersten wichtigen Schritt getan: Wir haben den Algorithmus zur Auswahl signifikanter Nachbarn im OpenCL-Kontext implementiert und damit den Grundstein für die gesamte Struktur gelegt. Wir haben gelernt, aus einem riesigen Datensatz genau jene Verbindungen herauszufiltern, die wirklich von Bedeutung sind, und diese ohne übermäßiges Rauschen an die nachfolgende Berechnungspipeline weiterzuleiten. Dies war nicht nur ein technisches Experiment, sondern ein entscheidender Schritt bei der Entwicklung eines künftigen Handelsmechanismus: Ohne einen gut abgestimmten Auswahlmechanismus ist es unmöglich, ein zuverlässiges Analysesystem aufzubauen.
Heute setzen wir unsere Arbeit fort und gehen bei der Integration unserer eigenen Auslegung der von den Autoren des SAGDFN-Frameworks vorgeschlagenen Ansätze mithilfe von MQL5-Werkzeugen einen Schritt weiter.
Diskussion zur Umsetzung
Nachdem die Algorithmen des Moduls zur Auswahl signifikanter Nachbarn – eines Mechanismus zur Auswahl der signifikantesten Verbindungen – erfolgreich implementiert wurden, besteht der nächste logische Schritt darin, von der Datenaufbereitung zur tiefergehenden Analyse und Transformation überzugehen. Heute beginnen wir mit der Entwicklung der Algorithmen für das Modul für dünn besetzte räumliche Multi-Head-Attention, das als zentrales Werkzeug zur Extraktion struktureller Muster aus den bereits ausgewählten Nachbarn dienen wird.
Dieses Modul fungiert als eine Art intelligentes Sieb, das nicht nur Informationen verarbeiten, sondern auch die Aufmerksamkeit des Modells so lenken kann, dass es sich auf wirklich bedeutsame räumliche Zusammenhänge konzentriert, ohne dabei den Gesamtzusammenhang aus den Augen zu verlieren. Es nutzt einen Multi-Head-Attention-Mechanismus, doch im Gegensatz zum klassischen Ansatz implementieren die Autoren des Frameworks diesen in dünn besetzter Form. Dadurch lässt sich der Rechenaufwand erheblich reduzieren, ohne dass die Qualität der Analyse darunter leidet. Somit durchläuft jeder Datenstrom nicht eine monolithische Gewichtsmatrix, sondern ein effizienteres und dennoch selektiv ausdrucksstarkes Attention-Netzwerk, in dem jeder Attention-Kopf seine eigene Filter- und Hervorhebungsfunktion erfüllt.
Bevor wir mit der eigentlichen Implementierung beginnen, ist es wichtig, darzulegen, wie wir die Implementierung der von den Autoren des Frameworks vorgeschlagenen Algorithmen strukturieren möchten und welche Kernpunkte besondere Beachtung verdienen. Die Entwickler des Frameworks bieten einen recht intuitiven und übersichtlichen Ansatz. Um den Graphen zu erstellen, konkatenieren sie die Einbettung jedes Elements paarweise mit den Einbettungen seiner nächsten Nachbarn, die im Modul Auswahl signifikanter Nachbarn vorab ausgewählt wurden. Jedes dieser Paare durchläuft anschließend ein kompaktes, vollständig verbundenes Modell, das die nachfolgende Darstellung der Kanten bildet.
Auf den ersten Blick erscheint die Methodik transparent und logisch, und der Verarbeitungsablauf wirkt einfach und unkompliziert. Betrachtet man diesen Ansatz jedoch im Kontext der praktischen Umsetzung – insbesondere bei realen Handelsdaten mit hoher Kantendichte –, wird deutlich, dass hinter dieser scheinbaren Einfachheit ein sehr erheblicher Mehraufwand steckt. Die paarweise Konkatenation der Einbettungen jedes Elements und seiner Nachbarn führt zu einer erheblichen Zunahme des Datenvolumens, was wiederum den Speicherbedarf erhöht. Jedes Paar erzeugt praktisch einen neuen Vektor, und je mehr solcher Paare es gibt, desto mehr Ressourcen werden für deren Speicherung und weitere Verarbeitung benötigt.
Zudem erhöht die Verwendung eines vollständig verbundenen Modells für jedes Paar den Rechenaufwand, da jedes Paar einzeln verarbeitet werden muss. Dies führt zu längeren Ausführungszeiten und schränkt die Flexibilität des Systems bei der Arbeit mit großen Graphen oder unter Bedingungen begrenzter Rechenressourcen ein. Trotz der visuellen Übersichtlichkeit dieser Lösung könnte sie daher zu einem Engpass beim Aufbau eines effizienten und skalierbaren Systems werden.
Betrachtet man das ursprüngliche Konstrukt genauer, wird deutlich: Die Autoren verwenden dasselbe kleine, vollständig verbundene Netzwerk, um alle Paare [ei ‖ ej] zu verarbeiten, wobei ei die Einbettung eines Knotens und ej die Einbettung eines seiner ausgewählten Nachbarn ist. Die Parameter dieses Netzwerks sind für alle Paare gleich: Es handelt sich nicht um eine Reihe unterschiedlicher Modelle, sondern um denselben Satz von Gewichten, der immer wieder verwendet wird. Genau diese Gemeinsamkeit dient uns als Hebel für die Beschleunigung.
Eine vollständig verbundene Schicht ist ihrem Wesen nach eine lineare Transformation in Verbindung mit Nichtlinearität. In der linearen Phase multipliziert sie die Komponenten des Eingabevektors mit den entsprechenden Gewichten und summiert die Ergebnisse. Ist die Eingabe die Konkatenation [ei ‖ ej] ∈ R2d und die Gewichtsmatrix der ersten Schicht W ∈ Rh × 2d, so lässt sich das Produkt in die Summe zweier Terme zerlegen.
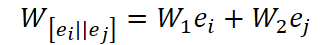
wobei W1 und W2 ∈ Rh × d die linke bzw. rechte Hälfte von W sind.
Diese einfache algebraische Beobachtung weist den Weg nach vorn: Anstatt M Durchläufe durch dieselbe Schicht für jedes ei und alle seine Nachbarn durchzuführen, ist es sinnvoller, die Projektion jedes Knotens pi = W1 ei einmal zu berechnen und die Nachbarprojektion ki = W2 ei separat zu berechnen. In diesem Fall lässt sich jedes Paar (i, j) in der linearen Stufe sofort als pi + kj berechnen. Dann folgen dieselbe Nichtlinearität und der nächste lineare Attention-Kopf, jedoch ohne die rechenintensive Matrix wiederholt auf den konkatenierten Vektor anzuwenden.
In der Praxis bedeutet dies, dass wir den ursprünglichen Einbettungstensor E vorab mit zwei Gewichtsmatrizen multiplizieren, wodurch zwei Projektionstensoren entstehen. Diese Operationen werden einmal pro Batch ausgeführt und lassen sich auf der GPU äußerst gut vektorisieren. Danach müssen wir für jedes Knoten-Nachbar-Paar lediglich die entsprechenden Projektionen addieren. Der Vorteil ist zweifach: Jedes ei wird genau einmal mit den Query-Gewichten W1 multipliziert, unabhängig davon, wie viele Nachbarn es hat, und jedes ej wird ebenfalls nur einmal mit den Key-Gewichten W2 multipliziert, selbst wenn es in Dutzenden anderer Listen vorkommt. Der dicht besetzte Teil der Berechnung skaliert nicht mehr mit M.
Betrachtet man die asymptotische Komplexität, wird die Verschiebung im Lastprofil deutlich. Eine naive Konkatenation erfordert N * M Matrix-Vektor-Multiplikationen der Dimension h * 2d, was zu einem Zeitaufwand von O(NMhd) für die erste lineare Stufe führt. Der überarbeitete Berechnungsweg führt zwei Multiplikationen, EW1 und EW2, mit jeweils O(Nhd) Zeitaufwand aus; anschließend folgen nur noch N * M Additionen von h-dimensionalen Vektoren und die Anwendung eines recheneffizienten Attention-Kopfes – also O(NMh) ohne den rechenintensiven Faktor d. Wenn d groß und M nicht klein ist, lässt sich der Unterschied direkt in der Profiler-Ausgabe erkennen. Was den Speicherbedarf angeht, sieht es ähnlich aus: Anstatt N * M konkatenierte Vektoren der Länge 2d zu speichern, halten wir zwei Matrixpools, P und K, jeweils der Größe N * h, im Speicher und bilden die Summen für die benötigten Paare bei Bedarf. Der Speicherdruck sinkt, und der ALU-Durchsatz wird effizienter genutzt.
Diese Logik passt perfekt zu unserer Implementierung in MQL5 + OpenCL. Zur Bildung der Projektionen können wir eine Standard-Faltungsschicht mit einer Filteranzahl von 2h verwenden, die unabhängig von der aktuellen Menge der Nachbarn einmal pro Durchlauf ausgeführt wird. Das ist wichtig, weil sich die Liste I von einer Iteration zur nächsten ändern kann, während die Neuberechnung der Projektionen dennoch stabil und kostengünstig bleibt. Anschließend lesen wir für jedes Paar (i,j) die Zeilen Pi und Kj ein, summieren sie elementweise und wenden den Attention-Kopf an. Wo früher Matrixmultiplikationen über konkatenierte Tensoren stattfanden, bleiben nun einfache Vektoradditionen und eine einzige kleine lineare Schicht übrig – Operationen, die sich ideal für eine breite Vektorisierung eignen. Wird darauf aufbauend eine dünn besetzte Attention-Normalisierung angewendet, arbeitet sie direkt mit den resultierenden Logits und verändert das Schema der vorab berechneten Projektionen in keiner Weise.
Auch in puncto Interpretierbarkeit gibt es einen schönen Bonus. Die Matrix W1 fungiert nun als Query-Projektion, während W2 als Keys dient. Ihre Zeilen und Aktivierungen zeigen, welche Einbettungskomponenten die Attention in einem bestimmten Attention-Kopf stärker prägen. Im Risikomanagement ist dies ein kleines Detail, das erklärt, warum sich das Modell derzeit auf Öl statt auf Anleihen konzentriert oder warum ein Währungspaar plötzlich zum dominierenden Nachbarn für Technologiewerte geworden ist.
Ein weiterer wichtiger Aspekt, der besondere Beachtung verdient, betrifft die Verwendung der α-Entmax-Funktion. Ihr Hauptmerkmal ist die Fähigkeit, die Eingabedaten auf glatte Weise zu normalisieren und dabei zu steuern, wie stark unbedeutende Elemente herausgefiltert werden. Für α==1 entspricht diese Funktion der Standardfunktion SoftMax; für α==2 nähert sie sich Sparse-SoftMax an und bewirkt ein stärkeres Nullsetzen unbedeutender Werte. Trotz der Attraktivität dieses Ansatzes ist jedoch zu beachten, dass der α-Entmax-Algorithmus eine iterative Suche nach dem Parameter τ erfordert, was zwangsläufig die Rechenkomplexität und die Ausführungszeit der Operation erhöht. In unserer Implementierung haben wir uns dafür entschieden, der Effizienz Vorrang einzuräumen, und diese Funktion durch Sparse-SoftMax ersetzt. Dieser Ansatz bewahrt die Designphilosophie des Frameworks, unwesentliche Elemente aus der Analyse auszuschließen, und sorgt gleichzeitig für eine höhere Leistung sowie einen geringeren Ressourcenverbrauch während der Berechnungsphase.
Im nächsten Schritt werden wir dieses Konzept sorgfältig in unsere bestehende Pipeline integrieren. Die lineare Algebra hat uns die harte Arbeit bereits abgenommen – nun müssen wir die Berechnungen nur noch zeitlich und im Speicher richtig verteilen, damit sich unsere Multi-Head-Attention-Optik schnell, präzise und ohne unnötiges Rauschen fokussieren kann.
Erweiterung eines OpenCL-Programms
Nachdem wir nun die architektonischen Prinzipien des Moduls für dünn besetzte räumliche Multi-Head-Attention erörtert haben, ist es an der Zeit, dieses Konzept in die Praxis umzusetzen. Im vorangegangenen Schritt haben wir betont, dass die einmalige Multiplikation des Eingabetensors mit der Parametermatrix nicht nur Ressourcen spart, sondern es uns auch ermöglicht, alle wesentlichen Eigenschaften des Algorithmus beizubehalten, einschließlich der Auswahl der signifikantesten Nachbarn. Im Zusammenhang mit OpenCL kommt dem eine besondere Bedeutung zu: Hier werden jede Operation und die Nutzung des lokalen Speichers auf hohe Leistung optimiert.
Wir beginnen mit dem Kernel SparseMHScores für den Vorwärtsdurchlauf, der die Gewichtungskoeffizienten zwischen zentralen Elementen und ihren signifikantesten Nachbarn berechnet. Der Kernel ist so konzipiert, dass die Verarbeitung jedes einzelnen Elements so parallel wie möglich erfolgt. Gleichzeitig bleibt die Kontrolle über die Dünnbesetztheit der Gewichte erhalten.
__kernel void SparseMHScores(__global const float* data,
                             __global const float* indexes,
                             __global float* scores,
                             const float sparse              ///< [0.0 .. 1.0) sparsity coefficient
                            )
  {
   const int main = (int)get_global_id(0);
   const int slave = (int)get_local_id(1);
   const int head = (int)get_global_id(2);
   const int total_mains = (int)get_global_size(0);
   const int total_slaves = (int)get_local_size(1);
   const int total_heads = (int)get_global_size(2);
Zunächst ermittelt jeder globale Thread den Index seines Hauptelements main sowie den lokalen Bezeichner des Nachbarn slave. Gleichzeitig wird der aktuelle Attention-Kopf head bestimmt, wodurch alle Köpfe gleichzeitig verarbeitet werden können und eine mehrdimensionale Attention-Karte erstellt werden kann. Anschließend wird ein lokales Array namens Temp angelegt, das bei der Ermittlung der Maximal- und Minimalwerte im Block zur temporären Speicherung von Zwischenergebnissen dient.
__local float Temp[LOCAL_ARRAY_SIZE];
Als Nächstes lesen wir die Logit-Werte für das Hauptelement und dessen Nachbarn aus den data-Arrays aus. Die Funktion IsNaNOrInf stellt sicher, dass nachfolgende Operationen korrekt ausgeführt werden. Ist der Wert ungültig (NaN oder Inf), wird er durch 0 ersetzt.
   float value = IsNaNOrInf(data[RCtoFlat(main, head, total_mains, 2 * total_heads, 0)], 0);
   int slave_id = (int)indexes[RCtoFlat(main, slave, total_mains, total_slaves, 0)];
   if(slave_id < total_mains && slave_id >= 0)
      value += IsNaNOrInf(
                  data[RCtoFlat(slave_id, head + total_heads, total_mains, 2 * total_heads, 0)],
                  0);
Bitte beachten Sie, dass wir zunächst den genauen Nachbarindex aus dem Puffer indexes abrufen. In diesem Fall wird besonderes Augenmerk auf die Überprüfung der Gültigkeit des ermittelten Indexes gelegt. Befindet sich ein Nachbar außerhalb des zulässigen Bereichs oder weist er einen negativen Index auf, wird er aus den Berechnungen ausgeschlossen. Dadurch wird die Richtigkeit der Berechnungen gewährleistet und eine fehlerhafte Summierung verhindert.
Als Nächstes wird die zentrale Sparse-SoftMax-Operation implementiert. Zunächst werden lokale Maxima und Minima mithilfe der Funktionen LocalMax und LocalMin berechnet, wodurch sich der Schwellenwert ermitteln lässt. Dieser Schwellenwert steuert die Filterung insignifikanter Elemente: Werte unterhalb des Schwellenwerts werden auf null gesetzt, während auf signifikante Elemente eine Exponentialfunktion angewendet wird; anschließend erfolgt eine Normalisierung durch die Summe aller Elemente im Block.
   const float max_value = LocalMax(value, 1, Temp);
   const float min_value = LocalMin(value, 1, Temp);
   const float threshold = (max_value - min_value) * sparse + min_value;
   value = (threshold <= value ? IsNaNOrInf(exp(value - max_value), 0) : 0);
   const float sum = LocalSum(value, 1, Temp);
   value = IsNaNOrInf(value / sum, 0);
//---
   scores[RCtoFlat(slave, head, total_slaves, total_heads, main)] = value;
  }
Das Ergebnis ist ein dünn besetzter, aber aussagekräftiger Gewichtsvektor, der die Bedeutung jedes Nachbarn für das aktuelle Element widerspiegelt. Die berechneten Gewichte werden in das Ausgabe-Array scores geschrieben. Die Funktion RCtoFlat wandelt mehrdimensionale Indizes in eindimensionale Positionen um. Dieser Ansatz gewährleistet eine einheitliche Speicherung der Ergebnisse und ermöglicht es der nächsten Graphfaltungsstufe, diese direkt für die Informationsaggregation zu nutzen.
Insgesamt implementiert dieser Kernel eine kompakte, leistungsstarke und parallele Attention-Verarbeitung, die eine präzise Gewichtsverteilung zwischen den Elementen und ihren signifikanten Nachbarn gewährleistet. Er behält die gesamte Logik des von den Autoren vorgeschlagenen SAGDFN-Ansatzes bei, sorgt jedoch dafür, dass die Berechnungen effizient, skalierbar und für den praktischen Einsatz bei großen Zeitreihen geeignet sind.
Nachdem wir nun den Vorwärtsdurchlauf im Detail untersucht und verstanden haben, wie die dünn besetzten Attention-Gewichte für jeden Attention-Kopf und jedes Element gebildet werden, ist der nächste logische Schritt die Implementierung des Rückwärtsdurchlaufs.
Der Rückwärtsdurchlauf ist für die korrekte Berechnung der Gradienten während des Modelltrainings erforderlich. Er sorgt dafür, dass die am Ausgang ermittelten Fehler präzise an die Einbettungen und Parameter zurückpropagiert werden, die an der Berechnung der Attention-Gewichte beteiligt sind. Im Zusammenhang mit OpenCL bedeutet dies, einen separaten Kernel zu erstellen, der die Struktur des Vorwärtsdurchlaufs nachbildet, sich jedoch darauf konzentriert, Gradienten korrekt zu akkumulieren und die dünn besetzte Struktur der Gewichte zu berücksichtigen.
Es gibt jedoch einige wichtige Punkte, die an dieser Stelle besonders hervorgehoben werden sollten. Zunächst einmal geht der Query-Logit gleichzeitig in die Berechnung aller Attention-Koeffizienten ein. Das bedeutet, dass er während des Rückwärtsdurchlaufs die Fehlergradienten aus allen zugehörigen Informationsflüssen akkumulieren muss, um sicherzustellen, dass die Fehlersignale korrekt durch das gesamte Netzwerk weitergeleitet werden.
Zweitens arbeiten wir bei benachbarten Elementen mit einer Art dünn besetzter Matrix, was bei der Gestaltung des Algorithmus für den Rückwärtsdurchlauf bestimmte Einschränkungen mit sich bringt und besondere Überlegungen erfordert. Diese Struktur erfordert eine sorgfältige Prüfung, welche Elemente tatsächlich an den Berechnungen beteiligt sind, damit sich die Gradienten nur entlang aktiver Verbindungen ausbreiten, ohne Ressourcen für leere oder unbedeutende Positionen zu verschwenden.
Und natürlich dürfen wir die Besonderheiten der SoftMax-Funktion nicht vergessen: Die Änderung eines einzelnen Elements wirkt sich automatisch auf den gesamten Vektor aus, wodurch eine gegenseitige Abhängigkeit zwischen den Koeffizienten entsteht. In unserem Fall weisen wir Elementen, die nicht zu den ausgewählten Nachbarn gehören, das Gewicht Null zu. Gleichzeitig wird der Fehlergradient sorgfältig über den gesamten Attention-Vektor weitergegeben. Dies stellt sicher, dass die Parameter auch für jene Elemente korrekt aktualisiert werden, die nicht tatsächlich an aktiven Verbindungen beteiligt waren, und wahrt so die Integrität und Stabilität der Fehlerrückpropagation.
Um ein schlüssigeres und tieferes Verständnis der Funktionsweise des Kernels für den Rückwärtsdurchlauf zu erlangen, sollten wir uns zunächst noch einmal die Logik des Moduls für dünn besetzte räumliche Multi-Head-Attention vor Augen führen. Während des Vorwärtsdurchlaufs haben wir anhand vorberechneter Indizes und Knotenprojektionen dünn besetzte Attention-Scores für ausgewählte Nachbarn erzeugt. Diese Werte spielen eine entscheidende Rolle bei der Verteilung von Informationen zwischen den Knoten des Graphen, weshalb die korrekte Weitergabe des Fehlers in Rückwärtsrichtung für ein stabiles Modelltraining von entscheidender Bedeutung ist.
Der Kernel SparseMHScoresGrad ist dafür zuständig, die Fehlergradienten sorgfältig auf jedes Element des Eingangstensors zu verteilen, wobei die Dünnbesetztheit und die Besonderheiten von SoftMax berücksichtigt werden. Insbesondere wirkt sich eine Änderung eines einzelnen Logits auf alle Elemente des Attention-Vektors aus; daher sollten auch jene Nachbarn, die nicht in der endgültigen Menge enthalten waren, den entsprechenden Gradienten erhalten. Dadurch lässt sich die korrekte Berechnungsstruktur beibehalten und eine Störung des Gleichgewichts bei der Fehlerverteilung vermeiden.
__kernel void SparseMHScoresGrad(__global float* data_gr,
                                 __global const float* indexes,
                                 __global const float* scores,
                                 __global const float* scores_gr
                                )
  {
   const int main = (int)get_global_id(0);
   const int slave = (int)get_local_id(1);
   const int head = (int)get_global_id(2);
   const int total_mains = (int)get_global_size(0);
   const int total_slaves = (int)get_local_size(1);
   const int total_heads = (int)get_global_size(2);
Jedem Kernel-Thread werden drei zentrale Indizes zugewiesen:
- main — der Knoten, für den der Gradient berechnet wird,
- slave — der lokale Index des Nachbarn,
- head – der Attention-Kopf.
Der Temp-Puffer im lokalen Speicher dient dazu, Zwischenwerte von Gradienten innerhalb eines lokalen Thread-Blocks vorübergehend zu speichern, und die Synchronisation über BarrierLoc gewährleistet die Datenkonsistenz während der parallelen Verarbeitung.
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total_slaves, (uint)LOCAL_ARRAY_SIZE);
Im ersten Berechnungsblock werden die Gradienten bezüglich des untersuchten Knotens berechnet. Zunächst werden der Attention-Koeffizient für den aktuellen Nachbarn und dessen Index slave_id abgerufen.
//--- Calculate gradient by main
     {
      float value = IsNaNOrInf(scores[RCtoFlat(slave, head, total_slaves, total_heads, main)], 0);
      int slave_id = (int)indexes[RCtoFlat(main, slave, total_mains, total_slaves, 0)];
      const float sc_gr = IsNaNOrInf(
                            scores_gr[RCtoFlat(slave, head, total_slaves, total_heads, main)], 0);
Der Gradient grad wird als Differenz zwischen dem tatsächlichen Gewicht und dem erwarteten Wert berechnet, multipliziert mit dem Fehlergradienten sc_gr des Attention-Koeffizienten für die aktuelle Position.
      float grad = 0;
      for(uint d = 0; d < total_slaves; d += ls)
        {
         if(slave >= d && slave < (d + ls))
            Temp[slave - d] = IsNaNOrInf(sc_gr, 0);
         BarrierLoc;
         for(uint l = 0; l < min(ls, (uint)(total - d)); l++)
            grad += IsNaNOrInf(Temp[l] * ((float)((d + l) == slave && slave_id == main) - value), 0);
         BarrierLoc;
        }
Die lokale Aggregation über Temp mit anschließender Summierung über LocalSum ermöglicht eine effiziente parallele Summierung und minimiert so die Latenz bei der Arbeit mit großen Datensätzen.
      grad = LocalSum(grad, 1, Temp);
      if(slave == 0)
         data_gr[RCtoFlat(main, head, total_mains, 2 * total_heads, 0)] = grad;
     }
Das Ergebnis wird von nur einem Thread in den globalen Puffer geschrieben, wodurch eine Wettlaufsituation verhindert wird.
Der zweite Block ist für die Berechnung der Gradienten in Bezug auf die Nachbarn zuständig. An dieser Stelle ist zu beachten, dass hypothetisch jeder Nachbar für jeden Knoten an der Bildung des entsprechenden Attention-Koeffizienten beteiligt ist, selbst wenn dieser null ist. Daher betrachten wir den Wert von main als Index des zu analysierenden Nachbarn und durchlaufen alle Knoten.
//--- Calculate gradient by slave
     {
      float grad = 0;
      for(uint d = 0; d < total_mains; d++)
        {
         float value = IsNaNOrInf(scores[RCtoFlat(slave, head, total_slaves, total_heads, d)], 0);
         const float sc_gr = IsNaNOrInf(
                               scores_gr[RCtoFlat(slave, head, total_slaves, total_heads, d)], 0);
         int slave_id = (int)indexes[RCtoFlat(d, slave, total_mains, total_slaves, 0)];
Jeder Thread prüft, ob der aktuelle Index einem benachbarten Knoten entspricht, und fügt dessen Beitrag sorgfältig zum Gesamtgradienten hinzu. Lokale Barrieren und die Aggregation über Temp stellen sicher, dass alle Threads koordiniert an dem Prozess teilnehmen.
         float gr = IsNaNOrInf(sc_gr * ((float)(slave_id == d) - value), 0);
         gr = LocalSum(gr, 1, Temp);
         if(slave == 0)
            grad += gr;
        }
      if(slave == 0)
         data_gr[RCtoFlat(main, head + total_heads, total_mains, 2 * total_heads, 0)] =
                                                                             IsNaNOrInf(grad, 0);
     }
  }
Die Ergebnisse werden im globalen Puffer data_gr gespeichert, um spätere Aktualisierungen der Modellparameter zu ermöglichen. Dieser Ansatz ermöglicht es, den Fehler auch bei einer dünn besetzten Attention-Struktur, bei der viele Elemente ein Gewicht von null haben, korrekt weiterzugeben, ohne die Integrität der Berechnungen zu beeinträchtigen.
Es sei außerdem darauf hingewiesen, dass diese Implementierung die Möglichkeiten der GPU zur Parallelverarbeitung voll ausschöpft. Jeder Thread verarbeitet eine eigenständige Teilmenge der Daten, wobei lokaler Speicher und Barrieren Konflikte minimieren und die Konsistenz gewährleisten. Dies ist besonders wichtig beim Trainieren von Modellen auf großen Graphen mit Tausende Knoten, bei denen die herkömmliche sequenzielle Gradientenberechnung zu langsam und zu ressourcenintensiv wäre.
Insgesamt zeigt der Kernel SparseMHScoresGrad, wie sich die Fehlerrückpropagation für dünn besetzte Multi-Head-Attention effizient implementieren lässt und dabei Genauigkeit, Erhaltung der Dünnbesetztheit und hohe Recheneffizienz vereint werden.
Damit können wir die Implementierungsphase aufseiten des OpenCL-Programms abschließen. Der gesamte Prozess zur Umsetzung eines Mechanismus für dünn besetzte Multi-Head-Attention – vom Vorwärtsdurchlauf mit der Gewichtsberechnung bis hin zur präzisen Verteilung der Gradienten im Rückwärtsdurchlauf – wurde vollständig auf parallele Verarbeitung umgestellt. Wir haben für eine korrekte und effiziente Interaktion zwischen den Knoten und ihren Nachbarn gesorgt, eine dünn besetzte Struktur beibehalten, um Speicherplatz und Rechenressourcen zu schonen, und die Genauigkeit der Gradienten für das weitere Modelltraining gewährleistet. Der Algorithmus kann nun in den Rest des MQL5-Programms integriert werden.
Multi-Head-Attention-Objekt
In diesem Schritt gehen wir dazu über, alle bisher entwickelten Komponenten in eine einzige Struktur innerhalb des Hauptprogramms zu integrieren. Zu diesem Zweck erstellen wir die Klasse CNeuronSNSMHAttention, die die Grundfunktionalität einer Faltungsschicht von CNeuronConvOCL erbt und zwei zentrale Module kombiniert: Auswahl signifikanter Nachbarn und dünn besetzte räumliche Multi-Head-Attention. Diese Klasse dient als eine Art Rechenkern, der die Auswahl signifikanter Nachbarn, die Bildung von Projektionen und die Berechnung von Attention-Gewichten zusammenführt und dadurch ein hohes Maß an Kohärenz und Konsistenz im Betrieb der gesamten Architektur gewährleistet.
class CNeuronSNSMHAttention   :  public CNeuronConvOCL
  {
   float             fSparse;
   //---
   CNeuronBaseOCL    cNeighbors;
   CNeuronBaseOCL    cRamdomCandidates;
   CNeuronConvOCL    cProjection[2];
   CNeuronBaseOCL    cScores;

   //---
   virtual bool      SignificantNeighborsSampling(CNeuronBaseOCL *NeuronOCL);
   virtual bool      SparseMHScores(void);
   virtual bool      SparseMHScoresGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSNSMHAttention(void) {};
                    ~CNeuronSNSMHAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint heads,
                          uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSNSMHAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
  };
Die Klasse enthält mehrere interne Objekte, von denen jedes eine spezielle Aufgabe erfüllt.
- cNeighbors und cRamdomCandidates sind für die Verarbeitung von Nachbarkandidaten zuständig. Das erste Objekt verarbeitet die signifikantesten Nachbarn, das zweite zufällig ausgewählte Nachbarn; dies erhält die Vielfalt der Stichprobe und verhindert, dass sich das Modell lokal auf eng begrenzte Datenmuster festlegt.
- cProjection-Objekte projizieren die ursprünglichen Einbettungen in den Query- und den Key-Raum und schaffen damit die Grundlage für die nachfolgenden Multi-Head-Attention-Berechnungen.
- cScores sammelt die berechneten Attention-Koeffizienten und wandelt sie in eine dünn besetzte Einflussmatrix um, die in der Phase der Graphfaltung verwendet wird.
- Der Parameter fSparse legt den Dünnbesetztheitskoeffizienten für die Attention fest und ermöglicht so, das Verhältnis zwischen Vorhersagegenauigkeit und Rechenaufwand zu steuern, insbesondere bei der Arbeit mit großen Zeitreihen.
An dieser Stelle ist es wichtig, zu beachten, dass alle internen Objekte der Klasse CNeuronSNSMHAttention als statisch deklariert sind, wodurch der Konstruktor und der Destruktor der Klasse leer bleiben können. Dieser Ansatz vereinfacht die Speicherverwaltung und macht die Initialisierung der Schicht vorhersehbarer. Die grundlegende Konfiguration und der Aufbau der Architektur der neuronalen Schicht erfolgen über die Methode Init, die alle Elemente übersichtlich zusammenführt und deren Parameter festlegt.
bool CNeuronSNSMHAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint window, uint heads,
                                 uint m_units, float sparse,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!sparse >= 1 || sparse < 0)
      return false;
   fSparse = sparse;
//---
   if(!CNeuronConvOCL::Init(numOutputs, myIndex, open_cl, heads, heads, 1, units * m_units,
                                                              1, optimization_type, batch))
      return false;
Der Algorithmus der Methode beginnt mit der Überprüfung der Gültigkeit des Dünnbesetztheitskoeffizienten sparse. Liegt der Wert nicht im gültigen Bereich [0, 1), gibt die Funktion sofort false zurück, wodurch weitere Konfigurationsfehler verhindert werden. Anschließend wird der Parameter fSparse zur Verwendung bei der Berechnung der Attention-Gewichte gespeichert.
Anschließend wird die übergeordnete Klasse initialisiert, wobei die grundlegenden Parameter des Objekts festgelegt werden.
An dieser Stelle sei darauf hingewiesen, dass wir in diesem Fall die Funktionalität der übergeordneten Klasse nicht darauf beschränken, lediglich grundlegende Schnittstellen zu erstellen. Dies ist ein vollwertiges Objekt unseres Modells, das eine Multi-Head-Attention-Faltung durchführt.
Nach der grundlegenden Initialisierung beginnt die schrittweise Konfiguration der internen Objekte. Zunächst wird das Modul cNeighbors initialisiert; es ist für die Verarbeitung der signifikantesten Nachbarn zuständig.
   int index = 0;
   if(!cNeighbors.Init(0, index, OpenCL, units * m_units, optimization, iBatch))
      return false;
   CBufferFloat* temp = cNeighbors.getOutput();
   if(!temp ||
      !temp.Random(0, (float)(units - 1)))
      return false;
In der Anfangsphase füllen wir den Ergebnispuffer des Objekts mit zufälligen Nachbarindexwerten, um eine vielfältige Stichprobe zu gewährleisten.
Eine ähnliche Abfolge wird für das Modul cRamdomCandidates ausgeführt, das zufällige Kandidaten zur Erweiterung der Stichprobe speichert.
   index++;
   if(!cRamdomCandidates.Init(0, index, OpenCL, units * m_units, optimization, iBatch))
      return false;
   temp = cRamdomCandidates.getOutput();
   if(!temp ||
      !temp.Random(0, (float)(units - 1)))
      return false;
Dieser Ansatz bietet einen hybriden Mechanismus zur Nachbarauswahl – eine Kombination aus signifikanten und zufälligen Elementen.
Anschließend werden zwei Objekte im Array cProjection initialisiert; sie bilden Projektionen der ursprünglichen Einbettungen in den Query- und den Key-Raum. Dem ersten Objekt wird die Aktivierungsfunktion SoftPlus zugewiesen, dem zweiten TANH. Dadurch entsteht eine nichtlineare Transformation, die es dem Modell ermöglicht, komplexe Wechselwirkungen zwischen Elementen zu berücksichtigen.
   index++;
   if(!cProjection[0].Init(index, 0, OpenCL, window, window, 2 * heads, units, 1,
                                                             optimization, iBatch))
      return false;
   cProjection[0].SetActivationFunction(SoftPlus);
   index++;
   if(!cProjection[1].Init(index, 0, OpenCL, 2 * heads, 2 * heads, 2 * heads, units,
                                                           1, optimization, iBatch))
      return false;
   cProjection[0].SetActivationFunction(TANH);
   index++;
   if(!cScores.Init(0, index, OpenCL, units * m_units * heads, optimization, iBatch))
      return false;
//---
   return true;
  }
Abschließend wird das Objekt cScores initialisiert; es akkumuliert die dünn besetzten Attention-Gewichte und bildet die endgültige Einflussmatrix, die bei der Graphfaltung verwendet wird.
Insgesamt handelt es sich bei der Methode Init um einen sorgfältig konzipierten, schrittweisen Initialisierungsprozess, der sicherstellt, dass alle Komponenten der Schicht korrekt konfiguriert sind. Dadurch wird sichergestellt, dass jedem Objekt die erforderlichen Dimensionen, Aktivierungsfunktionen und Parameter zugewiesen werden, damit es innerhalb einer einheitlichen Architektur funktionieren kann. Dieser Ansatz macht die Schicht flexibel und skalierbar, sodass sie an verschiedene Datenkonfigurationen, unterschiedliche Anzahlen von Attention-Köpfen und unterschiedliche Größen der Nachbarstichprobe angepasst werden kann, wobei die Recheneffizienz und die hohe Genauigkeit erhalten bleiben.
Die Methode feedForward implementiert den Vorwärtsdurchlauf der Daten durch die einheitliche Architektur des Moduls mit großer Sorgfalt und gewährleistet dabei das sequenzielle Zusammenspiel aller internen Komponenten. Zunächst wird die Methode SignificantNeighborsSampling aufgerufen, die Index-Arrays für signifikante Nachbarn erstellt. Sollte dieser Schritt aus irgendeinem Grund fehlschlagen, gibt die Funktion sofort false zurück, wodurch weitere Berechnungen verhindert werden und der korrekte Zustand der Schicht erhalten bleibt.
bool CNeuronSNSMHAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!SignificantNeighborsSampling(NeuronOCL))
      return false;
Nachdem die Nachbarn erfolgreich ausgewählt wurden, wird ein Zeiger auf das Quelldatenobjekt NeuronOCL in der lokalen Variablen inputs gespeichert und anschließend nacheinander an die Projektionsblöcke übergeben. Die Schleife durchläuft jedes Element des Arrays cProjection. Für jedes Element wird dessen eigene Methode FeedForward aufgerufen; diese führt lineare und nichtlineare Transformationen am Eingabetensor durch und erzeugt dabei Query- und Key-Projektionen für die nachfolgende Attention-Operation.
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(uint i = 0; i < cProjection.Size(); i++)
     {
      if(!cProjection[i].FeedForward(inputs))
         return false;
      inputs = cProjection[i].AsObject();
     }
Dabei wird nach der Verarbeitung jedes Blocks dessen Ausgabe als Eingabe für den nächsten Schritt zugewiesen, wodurch ein kontinuierlicher Datenfluss und eine saubere kaskadierte Transformation gewährleistet werden.
Im nächsten Schritt wird die Methode SparseMHScores aufgerufen, die dünn besetzte Vektoren der Attention-Koeffizienten für alle Knoten-Nachbar-Paare berechnet und dabei den Dünnbesetztheitskoeffizienten fSparse berücksichtigt.
   if(!SparseMHScores())
      return false;
   if(!CNeuronConvOCL::feedForward(cScores.AsObject()))
      return false;
//---
   return true;
  }
Die resultierenden Werte werden akkumuliert und an die Faltungsschicht zur Aggregation mittels Multi-Head-Attention weitergeleitet, deren Funktionalität durch die übergeordnete Klasse implementiert wird. Hier wird die abschließende Transformation durchgeführt, die die endgültigen Ausgabewerte der Schicht erzeugt.
Der gesamte Prozess ist so konzipiert, dass die Daten die wichtigsten Phasen logisch und sequenziell durchlaufen: zunächst die Auswahl signifikanter Nachbarn, dann die Erzeugung von Projektionen, anschließend die Berechnung dünn besetzter Attention-Koeffizienten und schließlich die Aggregation der Informationen. Dieser Ansatz gewährleistet eine hohe Lesbarkeit des Codes und erleichtert die Integration zusätzlicher Transformationen oder Optimierungen, ohne die Gesamtarchitektur zu beeinträchtigen. Am Ende der Methode wird true zurückgegeben, was anzeigt, dass der Vorwärtsdurchlauf erfolgreich abgeschlossen wurde und die Schicht für die weitere Verarbeitung bereit ist.
Die Methode calcInputGradients ist dafür zuständig, den Fehlergradienten präzise auf alle internen Komponenten der Schicht und die Eingabedaten zu verteilen, um einen korrekten Rückwärtsdurchlauf für das Training des Modells zu gewährleisten. Zunächst wird geprüft, ob der Zeiger auf die vorherige Schicht, prevLayer, gültig ist. Fehlt dieser Zeiger, gibt die Funktion sofort false zurück, wodurch fehlerhafte Berechnungen verhindert werden.
bool CNeuronSNSMHAttention::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!prevLayer)
     return false;
Anschließend wird die gleichnamige Methode in der übergeordneten Klasse aufgerufen, um die Gradienten auf der Ebene der Aggregationsschicht cScores zu verteilen.
   if(!CNeuronConvOCL::calcInputGradients(cScores.AsObject()))
      return false;
   if(!SparseMHScoresGrad())
      return false;
Anschließend wird SparseMHScoresGrad aufgerufen, um die Gradienten durch die dünn besetzten Attention-Koeffizienten zu verteilen, die vom Modul für dünn besetzte räumliche Multi-Head-Attention erzeugt werden. Hier werden die Eigenschaften der dünn besetzten Nachbarmatrix berücksichtigt, wobei das Funktionsprinzip der Architektur beibehalten wird.
Anschließend beginnt eine Schleife, die das cProjection-Array in umgekehrter Reihenfolge durchläuft, beginnend mit dem letzten Block. Für jede Projektion wird ein Eingabeobjekt inputs definiert: Handelt es sich nicht um den ersten Block, wird die Ausgabe des vorherigen Blocks verwendet; andernfalls wird prevLayer verwendet.
   int total=(int)cProjection.Size();
   CNeuronBaseOCL* inputs = NULL;
   for(int i = total-1; i >=0; i--)
     {
      inputs = (i>0 ? cProjection[i-1].AsObject() : prevLayer);
      if(!inputs.CalcHiddenGradients(cProjection[i].AsObject()))
         return false;
     }
//---
   return true;
  }
Für jedes Objekt wird die Methode CalcHiddenGradients aufgerufen, die die lokalen Gradienten der verborgenen Zustände berechnet und dabei alle akkumulierten Gradienten der nächsten Ebene berücksichtigt. Dadurch wird eine konsistente und korrekte Fehlerrückpropagation durch alle Zwischenschichten gewährleistet, während gleichzeitig die Konsistenz zwischen den Gewichten und den verborgenen Zuständen erhalten bleibt.
Somit führt calcInputGradients einen vollständigen und strukturierten Rückwärtsdurchlauf durch das kombinierte Modul durch, wobei die Gradienten präzise sowohl auf die dünn besetzten Attention-Koeffizienten als auch auf alle Projektionsschichten verteilt werden, um so den nachfolgenden Optimierungsschritt vorzubereiten.
Die Methode updateInputWeights ist dafür zuständig, die Gewichtsparameter aller internen Komponenten der Schicht nacheinander zu aktualisieren, nachdem die Fehlergradienten verteilt wurden. Sie gewährleistet eine korrekte Modelloptimierung auf der Grundlage der berechneten Gradienten und verteilt die Änderungen präzise auf jedes Element der Architektur.
bool CNeuronSNSMHAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(uint i = 0; i < cProjection.Size(); i++)
     {
      if(!cProjection[i].UpdateInputWeights(inputs))
         return false;
      inputs = cProjection[i].AsObject();
     }
Zunächst deklariert die Methode einen lokalen Zeiger auf das Eingabedatenobjekt inputs, der anfangs auf eine externe NeuronOCL-Schicht verweist. Anschließend wird eine Schleife über alle cProjection-Blöcke gestartet. Für jeden Block wird die Methode UpdateInputWeights aufgerufen, die die berechneten Gradienten auf die Gewichtsparameter des aktuellen Blocks anwendet. Sollte die Aktualisierung der Gewichte zu irgendeinem Zeitpunkt fehlschlagen, gibt die Methode sofort false zurück, wodurch verhindert wird, dass das Modell in einen inkonsistenten Zustand gerät. Nachdem der Block erfolgreich aktualisiert wurde, wird der Zeiger in inputs auf die Ausgabe der aktuellen Projektion umgeleitet, damit der nächste Block die aktuellen Eingabedaten korrekt erhält.
Nachdem die Schleife abgeschlossen ist, wird die gleichnamige Methode der übergeordneten Klasse aufgerufen; diese aktualisiert die Gewichte der Multi-Head-Attention-Aggregationsschicht und gewährleistet so die Konsistenz über alle Ebenen des Modells hinweg. Dieser Schritt ist entscheidend, um sicherzustellen, dass die dünn besetzten Attention-Koeffizienten korrekt funktionieren, und um den Einfluss jedes ausgewählten Nachbarn in der endgültigen Vorhersagefunktion zu bewahren.
   if(!CNeuronConvOCL::updateInputWeights(cScores.AsObject()))
      return false;
//---
   return true;
  }
Schließlich gibt die Methode true zurück, was bedeutet, dass die Gewichtsoptimierung für alle internen Komponenten des Moduls erfolgreich abgeschlossen wurde.
Insgesamt ermöglicht das CNeuronSNSMHAttention-Objekt, komplexe Algorithmen zur Nachbarauswahl und Multi-Head-Attention übersichtlich in einer einzigen Struktur zu vereinen, und gewährleistet so Transparenz, Skalierbarkeit und Flexibilität.
Die Arbeit heute war intensiv und produktiv. Wir haben uns eingehend mit der Implementierung der Module Auswahl signifikanter Nachbarn und dünn besetzte räumliche Multi-Head-Attention befasst. Wir haben ihre architektonischen Merkmale analysiert und die Mechanismen der Vorwärts- und Rückwärtsdurchläufe sowie die Gewichtsoptimierung eingehend untersucht. Es ist an der Zeit, eine kurze Pause einzulegen, um das Aufgenommene sacken lassen zu können und die Grundlage für den nächsten Schritt zu schaffen.
Im nächsten Artikel werden wir auf die begonnene Arbeit zurückkommen und sie sorgfältig zu ihrem logischen Abschluss bringen. Wir werden das von uns entwickelte Modell anhand historischer Daten testen, seine Robustheit und Prognosegenauigkeit bewerten und die praktische Anwendbarkeit des vorgeschlagenen Ansatzes anhand realer Finanzzeitreihen demonstrieren.
Fazit
In diesem Artikel haben wir uns eingehend mit der praktischen Umsetzung der wichtigsten Module des SAGDFN-Frameworks unter Verwendung von MQL5 und OpenCL befasst. Wir haben Ansätze zur Auswahl signifikanter Nachbarn mithilfe des Verfahrens Auswahl signifikanter Nachbarn, zum Aufbau dünn besetzter Multi-Head-Attention und zur effizienten Organisation von Vorwärts- und Rückwärtsdurchläufen innerhalb einer einzelnen neuronalen Schicht analysiert. Besonderes Augenmerk wurde auf die Optimierung der Berechnungen gelegt: Wir haben gezeigt, wie die Wiederverwendung von Gewichtsparametern und die Umstellung auf eine Normalisierung, die eine dünn besetzte Verteilung erzeugt, den Speicherbedarf erheblich senken und die Datenverarbeitung beschleunigen können.
Dadurch bietet die Architektur sowohl eine hohe Prognosegenauigkeit als auch eine hohe Recheneffizienz, wodurch sich das Modell für die Verarbeitung einer großen Anzahl von Zeitreihen eignet.
Literaturverzeichnis
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Software
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für das Online-Training des Modells |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor zum Testen des Modells |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19370
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



