

Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (módulo de atención)
 23
 0

Introducción
En el artículo anterior nos familiarizamos con el framework SAGDFN. Analizamos los principios clave de su funcionamiento e hicimos hincapié en sus puntos fuertes. Pero el mercado no es un museo de maquetas arquitectónicas. Aquí no resultan excusables la excesiva indecisión ni los esquemas sin vida. Para que un edificio se mantenga en pie, hay que construirlo ladrillo a ladrillo, comprobando la solidez de cada nivel.
El framework SAGDFN se concibió inicialmente como respuesta a uno de los problemas más antiguos y, al mismo tiempo, más vivos de los mercados financieros: la redundancia de datos y el ruido que enmascara las señales verdaderas. Los métodos clásicos de análisis o bien se ahogaban en este flujo de información, o bien intentaban drenarlo mediante un filtrado burdo. SAGDFN, en cambio, propone un enfoque diferente: no se trata simplemente de filtrar, sino de seleccionar con criterio. Los autores del framework propusieron conservar únicamente aquellos vecinos que realmente influyen en el comportamiento del sistema. Es algo parecido a una vieja sabiduría del trading: escucha al mercado, pero aprende a distinguir los gritos de la multitud de los susurros de quienes conocen el camino.
La idea clave en torno a la cual se articula toda la arquitectura es Significant Neighbors Sampling, un sistema dinámico de muestreo de vecinos significativos. Imagine un puerto antiguo al que llegan cada minuto cientos de barcos con noticias de todo el mundo. No todos ellos son importantes para su negocio: algunos solo traen rumores de mercados ajenos; otros, mercancía que mañana se devaluará. El objetivo de SAGDFN es admitir únicamente a aquellos cuyas velas realmente impulsan la negociación en la dirección adecuada. Para ello, el modelo utiliza una combinación de evaluación determinista de la importancia y aleatoriedad controlada: una especie de viento de cambio que evita que el sistema se estanque en las relaciones habituales y, de este modo, reduce el riesgo de sobreajuste.
Otro elemento no menos importante fue el mecanismo α-Entmax, un «director de orquesta» matemático que regula la distribución de la atención. A diferencia del SoftMax, que es suave pero lo abarca todo, este no dispersa sus fuerzas entre todos, sino que hace más dispersa la distribución, dejando acentos fuertes allí donde realmente se necesitan. Es como una antigua habilidad de los comerciantes: no malgastar el capital en nimiedades, sino invertirlo en aquello que reportará el mayor rendimiento.
El SAGDFN también destaca por su equilibrio entre el contexto local y el global. Como un analista experimentado, sabe observar el mercado de cerca, analizando los datos vecinos, las barras individuales y los clústeres locales de transacciones. Y, al mismo tiempo, tener presente el panorama general: las tendencias, las regularidades observadas y la estructura de los flujos a largo plazo. En este sentido, desempeña la función de un navegante que guía el barco orientándose por las estrellas, pero sin olvidar la profundidad que hay bajo la quilla.
La arquitectura del framework SAGDFN es modular y ampliable, lo que resulta especialmente valioso en un contexto de condiciones de trading en constante cambio. Aquí no hay muros de piedra que limiten al investigador. Cada bloque —ya sea el muestreo de vecinos, la normalización de la atención o la integración con fuentes de datos externas— puede modificarse, optimizarse o sustituirse.
A continuación se muestra una representación del framework SAGDFN elaborada por el autor.
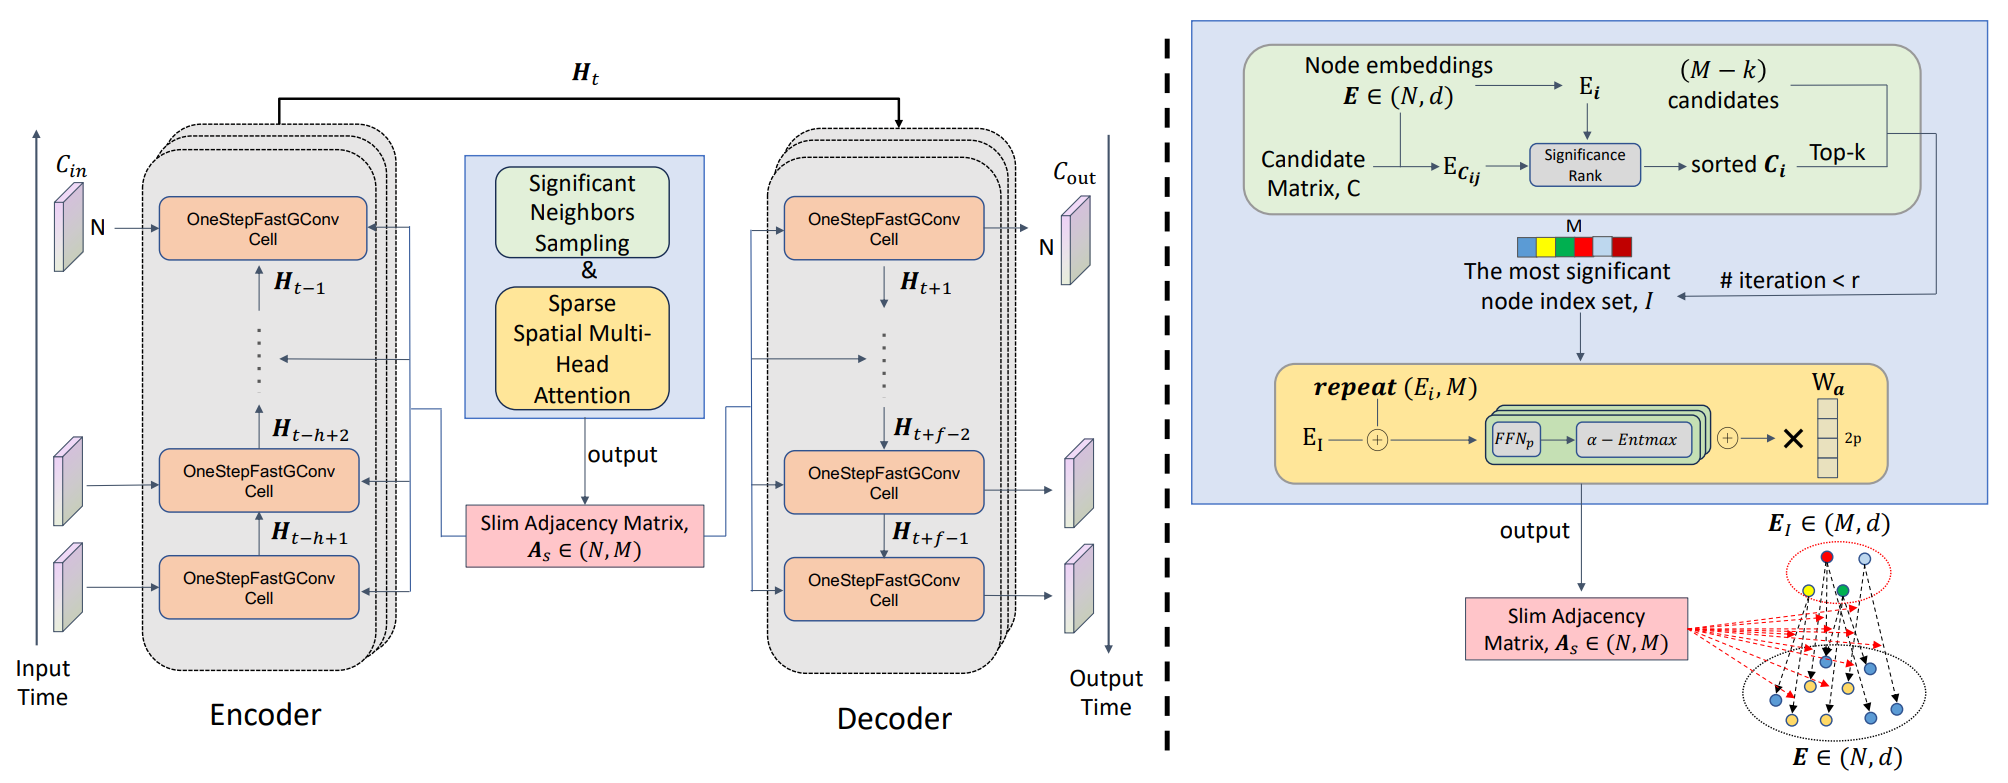
En la parte práctica del artículo anterior ya dimos el primer paso importante: implementamos el algoritmo del módulo Significant Neighbors Sampling en el contexto de OpenCL, sentando así las bases de toda la estructura. Hemos aprendido a extraer de un enorme conjunto de datos precisamente aquellas relaciones que tienen un significado real y a transmitirlas al flujo computacional posterior sin ruido superfluo. No fue simplemente un experimento técnico, sino una etapa clave en la creación del futuro mecanismo de trading: sin un mecanismo de muestreo bien ajustado, es imposible construir un sistema de análisis fiable.
Hoy continuamos con nuestro trabajo y pasamos al siguiente nivel: integrar con MQL5 nuestra propia visión de los enfoques propuestos por los autores del framework SAGDFN.
Discusión de la implementación
Tras la implementación exitosa de los algoritmos del módulo Significant Neighbors Sampling —un mecanismo de selección de los vecinos más significativos—, llega la siguiente etapa lógica: pasar de la preparación de los datos a un análisis más profundo y a su transformación. Hoy comenzamos a trabajar en el diseño de los algoritmos del módulo Sparse Spatial Multi-Head Attention, que se convertirá en una herramienta clave para extraer regularidades estructurales a partir de los vecinos ya seleccionados.
Este módulo es una especie de tamiz inteligente, capaz no solo de procesar la información, sino también de distribuir la atención del modelo de tal forma que se centre en las relaciones espaciales realmente significativas, sin perder de vista el contexto global. Utiliza un mecanismo de atención multicabeza, pero, a diferencia del enfoque clásico, los autores del framework lo implementan en un formato disperso. Esto permite reducir considerablemente la carga computacional sin que se vea afectada la calidad del análisis. De este modo, cada flujo de datos no pasa a través de una matriz monolítica de pesos, sino a través de una red de atención más eficiente y, al mismo tiempo, selectivamente enriquecida, en la que cada cabeza de atención desempeña su función de filtrado y énfasis.
Antes de pasar a la implementación propiamente dicha, es importante definir nuestra visión de cómo se estructurará la implementación de los algoritmos propuestos por los autores del framework y qué aspectos clave merecen una atención especial. Los autores del framework proponen un enfoque bastante intuitivo y claro. Para construir el grafo, concatenan por pares los embeddings de cada elemento con los embeddings de sus vecinos más cercanos, previamente seleccionados en el módulo Significant Neighbors Sampling. A continuación, cada par de este tipo pasa por un modelo compacto completamente conectado, que forma la representación posterior de las conexiones.
A primera vista, la metodología parece clara y lógica, y el proceso de procesamiento, simple y directo. Sin embargo, si se analiza este enfoque en el contexto de una implementación práctica, especialmente con datos reales de mercado que presentan una alta densidad de relaciones, resulta evidente que tras esa aparente simplicidad se esconden costes muy elevados. La concatenación por pares de los embeddings de cada elemento y sus vecinos provoca un aumento considerable del volumen de datos y, por lo tanto, también incrementa los requisitos de memoria RAM. Cada par crea, de hecho, un nuevo vector, y cuantos más pares haya, más recursos se necesitan para almacenarlos y procesarlos posteriormente.
Además, el uso de un modelo completamente conectado para cada par aumenta la carga computacional, ya que cada par debe someterse a un procesamiento individual. Esto provoca un aumento del tiempo de ejecución y hace que el sistema sea menos flexible al trabajar con grafos grandes o en condiciones de recursos computacionales limitados. Por lo tanto, pese a la claridad visual de esta solución, puede convertirse en un cuello de botella en el camino hacia la creación de un sistema eficiente y escalable.
Si se analiza con más detenimiento la construcción original, resulta evidente que los autores pasan todos los pares [ei ‖ ej]$ por una misma pequeña red completamente conectada, donde ei es el embedding del nodo y ej es el embedding de uno de sus vecinos seleccionados. Los parámetros de esta red son comunes a todos los pares: no se trata de un conjunto de modelos diferentes, sino del mismo conjunto de pesos que se reutiliza una y otra vez. Precisamente este carácter compartido es nuestro punto de apoyo para acelerar el proceso.
Una capa completamente conectada es, en esencia, una transformación lineal más una no linealidad. En la etapa de la parte lineal, multiplica los componentes del vector de entrada por los pesos correspondientes y los suma. Si la entrada es la concatenación [ei ‖ ej] ∈ R2d, y la matriz de pesos de la primera capa W ∈ Rh * 2d, entonces el producto se descompone en la suma de dos términos.
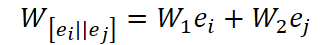
donde W1 y W2 ∈ Rh * d son las mitades izquierda y derecha de W.
Esta sencilla observación algebraica nos abre el camino: en lugar de realizar M pasadas de cada ei por la misma capa para todos sus vecinos, es más sensato calcular una sola vez la proyección de cada nodo pi = W1 ei y, por separado, la proyección del vecino ki = W2 ei. Entonces, cualquier par (i,j) en la etapa lineal se obtiene instantáneamente como pi + kj. A continuación, se mantiene la misma no linealidad y aparece la siguiente cabeza de atención lineal, pero ya sin la matriz pesada repetitiva en la concatenación.
En la práctica, esto significa que multiplicamos previamente el tensor de embeddings inicial E por dos matrices de pesos, obteniendo así dos tensores de proyección. Estas operaciones se ejecutan una vez por lote y se vectorizan perfectamente en la GPU. Después de esto, para cada par nodo—vecino, solo nos queda sumar las proyecciones correspondientes. La ventaja es doble: cada ei se multiplica por los pesos de consulta W1 exactamente una vez, independientemente del número de vecinos que tenga, y cada ej se multiplica por los pesos de las claves W2 también una sola vez, incluso si aparece en decenas de listas ajenas. La parte densa del trabajo deja de escalar con M.
Si nos centramos en los órdenes de complejidad, se aprecia claramente cómo cambia el perfil de la carga. Una concatenación ingenua obliga a realizar N * M multiplicaciones matriz-vector de dimensión h * 2d, lo que da O(NMhd) para la primera etapa lineal. La ruta refactorizada realiza dos multiplicaciones, EW1 y EW2, con un coste de O(Nhd) cada una; a continuación, solo N * M sumas de vectores h-dimensionales y una cabeza ligera, es decir, O(NMh) sin el costoso factor d. Cuando d es grande y M no es pequeño, la diferencia se nota claramente en el perfilador. En términos de memoria, la situación es similar: en lugar de almacenar N * M vectores concatenados de longitud 2d, mantenemos dos matrices auxiliares, P y K, cada una de N * h, y formamos sobre la marcha las sumas para los pares necesarios. La presión sobre la memoria disminuye y el throughput de la ALU se aprovecha de forma más eficaz.
Esta misma lógica encaja a la perfección con nuestra implementación en MQL5 + OpenCL. Para generar las proyecciones, podemos utilizar una capa convolucional estándar con un número de filtros igual a 2h, que se ejecuta una vez por pasada, independientemente del conjunto de vecinos actual. Esto es importante porque la lista I puede variar de una iteración a otra, mientras que el recálculo de las proyecciones sigue siendo estable y de bajo coste. A continuación, para cada par (i,j), leemos las filas Pi y Kj, las sumamos elemento a elemento y aplicamos la cabeza de atención. En los lugares donde antes había multiplicaciones matriciales sobre tensores concatenados, ahora solo quedan sumas vectoriales limpias y una pequeña capa lineal: operaciones que se adaptan perfectamente a una vectorización amplia. Si, además, se utiliza una normalización dispersa de la atención, esta opera ya con los logits obtenidos y no altera en absoluto el esquema de las proyecciones preliminares.
Además, hay una ventaja adicional agradable en términos de interpretabilidad. La matriz W1 empieza a desempeñar el papel de proyección de consulta, y W2 el de proyección de claves. A partir de sus filas y activaciones se puede ver qué componentes del embedding participan más activamente en la formación de la atención en una cabeza concreta. En lo que respecta a la gestión de riesgos, se trata de un detalle menor que permite explicar por qué el modelo mira al petróleo y no a los bonos en este momento, o por qué un par de divisas se ha convertido de repente en el vecino dominante de las acciones tecnológicas.
Otro aspecto importante que merece una atención especial está relacionado con el uso de la función α-Entmax. Su característica principal radica en la capacidad de normalizar suavemente los datos de entrada, con la posibilidad de ajustar el nivel de descarte de los elementos poco relevantes. Cuando α==1, esta función es equivalente al clásico SoftMax, y cuando α==2, se aproxima a Sparse-SoftMax, lo que proporciona una anulación más agresiva de los valores irrelevantes. Sin embargo, a pesar del atractivo de esta idea, hay que tener en cuenta que el algoritmo α-Entmax requiere una búsqueda iterativa del parámetro τ, lo que inevitablemente aumenta la complejidad computacional y el tiempo de ejecución de la operación. En nuestra implementación, decidimos dar prioridad a la eficiencia y sustituimos esta función por Sparse-SoftMax. Esta elección permite mantener el enfoque del framework, orientado a excluir del análisis los elementos poco relevantes, al tiempo que garantiza un mayor rendimiento y reduce el consumo de recursos en la fase de cálculo.
En el siguiente paso, integraremos cuidadosamente este esquema en nuestro pipeline existente. El álgebra lineal ya ha hecho el trabajo pesado por nosotros; ahora solo queda distribuir correctamente los cálculos en el tiempo y la memoria para que nuestra óptica de atención multicabeza enfoque de forma rápida, precisa y sin ruido innecesario.
Ampliación del programa OpenCL
Ahora que hemos analizado los principios arquitectónicos del módulo Sparse Spatial Multi-Head Attention, es el momento de plasmar este concepto en una implementación práctica. En la etapa anterior destacamos que multiplicar una sola vez el tensor inicial por la matriz de parámetros no solo ahorra recursos, sino que también permite conservar todas las características clave del algoritmo, incluida la selección de los vecinos más significativos. En el contexto de OpenCL, esto cobra especial importancia: aquí, cada operación y cada uso de la memoria local se optimizan para lograr un alto rendimiento.
Empezamos con el kernel de pasada directa SparseMHScores, que se encarga de calcular los coeficientes de ponderación entre los elementos centrales y sus vecinos más significativos. El kernel está diseñado para que el procesamiento de cada elemento sea lo más paralelo posible. Al mismo tiempo, se mantiene el control sobre la dispersión de los pesos.
__kernel void SparseMHScores(__global const float* data,
                             __global const float* indexes,
                             __global float* scores,
                             const float sparse              ///< [0,0 .. 1.0) coeficiente de dispersidad
                            )
  {
   const int main = (int)get_global_id(0);
   const int slave = (int)get_local_id(1);
   const int head = (int)get_global_id(2);
   const int total_mains = (int)get_global_size(0);
   const int total_slaves = (int)get_local_size(1);
   const int total_heads = (int)get_global_size(2);
En primer lugar, cada flujo global obtiene el índice de su elemento principal main y el identificador local del vecino slave. Al mismo tiempo, se determina la cabeza de atención actual head, lo que permite procesar todas las cabezas simultáneamente y crear un mapa multidimensional de correlaciones. A continuación, se crea una matriz local Temp, que se utiliza para almacenar temporalmente los cálculos intermedios al hallar los valores máximos y mínimos del bloque.
__local float Temp[LOCAL_ARRAY_SIZE];
Luego extraemos los valores de los logits del elemento principal y de su vecino de los arrays data. La función IsNaNOrInf garantiza la corrección de las operaciones posteriores. Si el valor es incorrecto (NaN o Inf), se sustituye por 0.
   float value = IsNaNOrInf(data[RCtoFlat(main, head, total_mains, 2 * total_heads, 0)], 0);
   int slave_id = (int)indexes[RCtoFlat(main, slave, total_mains, total_slaves, 0)];
   if(slave_id < total_mains && slave_id >= 0)
      value += IsNaNOrInf(
                  data[RCtoFlat(slave_id, head + total_heads, total_mains, 2 * total_heads, 0)],
                  0);
Tenga en cuenta que, previamente, obtenemos el índice exacto del vecino del búfer indexes. En este sentido, se ha prestado especial atención a la comprobación de la validez del índice obtenido. Si el vecino está fuera de los límites o es negativo, se excluye de los cálculos. Esto garantiza la corrección de los cálculos y evita que se produzcan sumas erróneas.
A continuación, se implementa la operación clave Sparse-Softmax. En primer lugar, se calculan los máximos y mínimos locales mediante las funciones LocalMax y LocalMin, lo que permite determinar el valor umbral threshold. Este umbral controla la eliminación de los elementos de menor importancia: los valores inferiores al umbral se ponen a cero, mientras que los elementos significativos se someten a una función exponencial normalizada con respecto a la suma de todos los elementos del bloque.
   const float max_value = LocalMax(value, 1, Temp);
   const float min_value = LocalMin(value, 1, Temp);
   const float threshold = (max_value - min_value) * sparse + min_value;
   value = (threshold <= value ? IsNaNOrInf(exp(value - max_value), 0) : 0);
   const float sum = LocalSum(value, 1, Temp);
   value = IsNaNOrInf(value / sum, 0);
//---
   scores[RCtoFlat(slave, head, total_slaves, total_heads, main)] = value;
  }
El resultado es un vector de pesos disperso pero informativo, que refleja la importancia de cada vecino para el elemento actual. Los pesos calculados se almacenan en la matriz de salida scores. La función RCtoFlat convierte los índices multidimensionales en posiciones unidimensionales. Este enfoque garantiza un almacenamiento coherente de los resultados y permite que la siguiente etapa de la convolución de grafos los utilice directamente para agregar información.
En conjunto, este kernel implementa un procesamiento de la atención compacto, de alto rendimiento y paralelo, lo que garantiza una distribución precisa de los pesos entre los elementos y sus vecinos significativos. Mantiene toda la lógica del enfoque SAGDFN propuesto por los autores, pero hace que los cálculos sean eficientes, escalables y aptos para su uso práctico en series temporales de gran extensión.
Una vez que hemos analizado en detalle la pasada directa y hemos comprendido cómo se forman los pesos de atención dispersos para cada cabeza de atención y cada elemento, el siguiente paso lógico es implementar la pasada inversa.
La pasada inversa es necesaria para calcular correctamente los gradientes durante el entrenamiento del modelo. Se encarga de que los errores obtenidos en la salida se propaguen correctamente hacia los embeddings y los parámetros que intervienen en el cálculo de los pesos de atención. En el contexto de OpenCL, esto implica crear un kernel independiente que reproduzca la estructura de la pasada directa, pero centrándose en la acumulación correcta de los gradientes y teniendo en cuenta la estructura dispersa de los pesos.
Sin embargo, conviene destacar aquí algunos aspectos importantes. En primer lugar, el logit de consulta interviene simultáneamente en el cálculo de todos los coeficientes de atención. Esto significa que, durante la pasada inversa, debe acumular los gradientes de error de todos los flujos de información relacionados, garantizando la propagación correcta de las señales de error por toda la red.
En segundo lugar, para los elementos vecinos trabajamos con una especie de matriz dispersa, lo que impone ciertas restricciones y particularidades a la construcción del algoritmo de la pasada inversa. Esta estructura requiere tener muy en cuenta qué elementos participan realmente en los cálculos, para que los gradientes se propaguen únicamente a través de los enlaces activos, sin malgastar recursos en posiciones vacías o irrelevantes.
Y, por supuesto, no hay que olvidar la particularidad de la función SoftMax: la modificación de un elemento afecta automáticamente a todo el vector, creando una interdependencia entre los coeficientes. En nuestro caso, a los elementos que no figuran entre los vecinos seleccionados les asignamos un peso nulo. Al mismo tiempo, el gradiente de error se propaga con precisión a lo largo de toda la secuencia, lo que garantiza una actualización correcta de los parámetros incluso para aquellos elementos que, en realidad, no participaron en las conexiones activas, preservando así la integridad y la estabilidad del proceso de retropropagación.
Para comprender de forma más fluida y profunda el funcionamiento del kernel de la pasada inversa, conviene volver primero a la lógica en la que se basa el módulo Sparse Spatial Multi-Head Attention. En la etapa de la pasada directa, generamos estimaciones de atención dispersas para los vecinos seleccionados, utilizando índices y proyecciones de nodos calculados previamente. Estos valores desempeñan un papel fundamental en la distribución de la información entre los nodos del grafo y, por lo tanto, la propagación correcta del error en sentido inverso es fundamental para un entrenamiento estable del modelo.
El kernel SparseMHScoresGrad se encarga de distribuir con precisión los gradientes de error entre cada elemento del tensor de entrada, teniendo en cuenta la dispersidad y las particularidades de SoftMax. En concreto, una variación de un logit afecta a todos los elementos del vector de atención, por lo que incluso los elementos con peso nulo deben tratarse correctamente en el cálculo del gradiente, sin interpretarlos como conexiones activas plenas. Esto permite mantener la estructura correcta de los cálculos y no alterar el equilibrio en la distribución del error.
__kernel void SparseMHScoresGrad(__global float* data_gr,
                                 __global const float* indexes,
                                 __global const float* scores,
                                 __global const float* scores_gr
                                )
  {
   const int main = (int)get_global_id(0);
   const int slave = (int)get_local_id(1);
   const int head = (int)get_global_id(2);
   const int total_mains = (int)get_global_size(0);
   const int total_slaves = (int)get_local_size(1);
   const int total_heads = (int)get_global_size(2);
A cada flujo del kernel se le asignan tres índices clave:
- main: el nodo para el que se calcula el gradiente,
- slave: índice local del vecino,
- head: cabeza de atención.
El búfer de la memoria local Temp se utiliza para almacenar temporalmente los valores intermedios de los gradientes dentro del bloque local de flujos, mientras que la sincronización mediante BarrierLoc garantiza la coherencia de los datos durante el procesamiento paralelo.
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total_slaves, (uint)LOCAL_ARRAY_SIZE);
En el primer bloque de cálculos, los gradientes se calculan con respecto al nodo analizado. En primer lugar, se extrae el coeficiente de atención del vecino actual y su índice slave_id.
//--- Calcular gradiente por main
     {
      float value = IsNaNOrInf(scores[RCtoFlat(slave, head, total_slaves, total_heads, main)], 0);
      int slave_id = (int)indexes[RCtoFlat(main, slave, total_mains, total_slaves, 0)];
      const float sc_gr = IsNaNOrInf(
                            scores_gr[RCtoFlat(slave, head, total_slaves, total_heads, main)], 0);
El gradiente grad se calcula como la diferencia entre el peso real y el valor esperado, multiplicada por el gradiente de error del coeficiente de atención sc_gr para la posición actual.
      float grad = 0;
      for(uint d = 0; d < total_slaves; d += ls)
        {
         if(slave >= d && slave < (d + ls))
            Temp[slave - d] = IsNaNOrInf(sc_gr, 0);
         BarrierLoc;
         for(uint l = 0; l < min(ls, (uint)(total - d)); l++)
            grad += IsNaNOrInf(Temp[l] * ((float)((d + l) == slave && slave_id == main) - value), 0);
         BarrierLoc;
        }
El uso de la agregación local a través de Temp y la suma posterior LocalSum garantiza una suma paralela y eficaz, minimizando los retrasos al trabajar con grandes conjuntos de datos.
      grad = LocalSum(grad, 1, Temp);
      if(slave == 0)
         data_gr[RCtoFlat(main, head, total_mains, 2 * total_heads, 0)] = grad;
     }
El resultado obtenido se guarda en el búfer global mediante un único flujo, evitando la condición de carrera.
El segundo bloque se encarga de calcular los gradientes con respecto a los vecinos. En este sentido, hay que tener en cuenta que, hipotéticamente, cada vecino participa en la formación del coeficiente de atención correspondiente (aunque sea nulo) para cada nodo. Por eso tomamos el valor main como índice del vecino que se va a analizar y organizamos un bucle para recorrer todos los nodos.
//--- Calcular gradiente por slave
     {
      float grad = 0;
      for(uint d = 0; d < total_mains; d++)
        {
         float value = IsNaNOrInf(scores[RCtoFlat(slave, head, total_slaves, total_heads, d)], 0);
         const float sc_gr = IsNaNOrInf(
                               scores_gr[RCtoFlat(slave, head, total_slaves, total_heads, d)], 0);
         int slave_id = (int)indexes[RCtoFlat(d, slave, total_mains, total_slaves, 0)];
Cada flujo comprueba si el índice actual corresponde a un nodo vecino y suma con precisión su contribución al gradiente global. Las barreras locales y la suma a través de Temp garantizan que todos los flujos participen de forma coordinada en el proceso.
         float gr = IsNaNOrInf(sc_gr * ((float)(slave_id == d) - value), 0);
         gr = LocalSum(gr, 1, Temp);
         if(slave == 0)
            grad += gr;
        }
      if(slave == 0)
         data_gr[RCtoFlat(main, head + total_heads, total_mains, 2 * total_heads, 0)] =
                                                                             IsNaNOrInf(grad, 0);
     }
  }
Los resultados se guardan en el búfer global data_gr para actualizar posteriormente los parámetros del modelo. Este enfoque permite propagar correctamente el error incluso en el caso de una estructura de atención dispersa, en la que muchos elementos tienen un peso nulo, sin que ello afecte a la integridad de los cálculos.
Además, cabe señalar que esta implementación aprovecha al máximo las capacidades paralelas de la GPU. Cada flujo trabaja con un subconjunto independiente de datos, mientras que la memoria local y las barreras minimizan los conflictos y garantizan la coherencia. Esto resulta especialmente importante a la hora de entrenar modelos en grafos grandes con miles de nodos, en los que el cálculo secuencial tradicional de los gradientes resultaría demasiado lento y consumiría demasiados recursos.
En general, el kernel SparseMHScoresGrad muestra cómo se puede implementar de forma eficaz la retropropagación del error para la atención multicabeza dispersa, combinando precisión, conservación de la dispersidad y una alta eficiencia computacional.
Con esto podemos dar por concluida la fase de implementación en el programa OpenCL. Todo el proceso de construcción de la atención multicabeza dispersa, desde la pasada directa con el cálculo de los pesos hasta la distribución precisa de los gradientes en la pasada inversa, se ha trasladado íntegramente a un contexto paralelo. Hemos garantizado una interacción correcta y eficaz entre los nodos y sus vecinos, hemos conservado una estructura dispersa para ahorrar memoria y recursos computacionales, y hemos asegurado la precisión de los gradientes para el entrenamiento posterior del modelo. Ahora el algoritmo está listo para integrarse con el resto del programa MQL5.
Objeto de atención multicabeza
En esta fase, pasamos a integrar todos los componentes desarrollados anteriormente en una estructura única dentro del programa principal. Para ello, creamos la clase CNeuronSNSMHAttention, que hereda la funcionalidad básica de la capa convolucional de CNeuronConvOCL y combina dos módulos clave: Significant Neighbors Sampling (muestreo de vecinos significativos) y Sparse Spatial Multi-Head Attention (atención espacial dispersa multicabeza). Esta clase se convierte en una especie de núcleo de cálculo, al concentrar los procesos de selección de vecinos significativos, formación de proyecciones y cálculo de los pesos de atención, lo que asegura una alta coherencia y coordinación en el funcionamiento de toda la arquitectura.
class CNeuronSNSMHAttention   :  public CNeuronConvOCL
  {
   float             fSparse;
   //---
   CNeuronBaseOCL    cNeighbors;
   CNeuronBaseOCL    cRamdomCandidates;
   CNeuronConvOCL    cProjection[2];
   CNeuronBaseOCL    cScores;

   //---
   virtual bool      SignificantNeighborsSampling(CNeuronBaseOCL *NeuronOCL);
   virtual bool      SparseMHScores(void);
   virtual bool      SparseMHScoresGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSNSMHAttention(void) {};
                    ~CNeuronSNSMHAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint heads,
                          uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSNSMHAttention;   }
   //--- métodos para trabajar con archivos
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
  };
La clase contiene varios objetos internos, cada uno de los cuales desempeña una función específica.
- cNeighbors y cRamdomCandidates se encargan de procesar los candidatos a vecinos. El primero se encarga de los más significativos y el segundo, de los aleatorios, lo que permite mantener la diversidad de la muestra y evita que el modelo se quede estancado en patrones de datos estrechos.
- Los objetos cProjection permiten generar proyecciones de los embeddings originales en el espacio de consultas y claves, lo que constituye la base para los cálculos posteriores de la atención multicabeza.
- cScores acumula los coeficientes de atención calculados y los transforma en una matriz de influencia dispersa, que se utilizará en la etapa de convolución de grafos.
- El parámetro fSparse establece el coeficiente de dispersidad de la atención, lo que permite controlar el equilibrio entre la precisión de la predicción y la carga computacional, especialmente al trabajar con series temporales de gran tamaño.
En esta fase, es importante destacar que todos los objetos internos de la clase CNeuronSNSMHAttention se declaran estáticamente, lo que permite dejar vacíos el constructor y el destructor de la clase. Este diseño simplifica la gestión de la memoria y hace que la inicialización de la capa sea más predecible. La configuración principal y el despliegue de la arquitectura de la capa neuronal se llevan a cabo mediante el método Init, que agrupa cuidadosamente todos los elementos y establece sus parámetros.
bool CNeuronSNSMHAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint window, uint heads,
                                 uint m_units, float sparse,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!sparse >= 1 || sparse < 0)
      return false;
   fSparse = sparse;
//---
   if(!CNeuronConvOCL::Init(numOutputs, myIndex, open_cl, heads, heads, 1, units * m_units,
                                                              1, optimization_type, batch))
      return false;
El algoritmo del método comienza comprobando la validez del coeficiente de dispersidad sparse. Si el valor no se encuentra dentro del intervalo válido [0, 1), la función devuelve inmediatamente false, lo que evita nuevos errores de configuración. A continuación, el parámetro fSparse se guarda para utilizarlo en el cálculo de los pesos de atención.
A continuación, se llama a la inicialización de la clase base, donde se definen los parámetros básicos del objeto.
Cabe precisar que, en este caso, no limitamos la funcionalidad de la clase base únicamente a la creación de interfaces básicas. Se trata de un objeto completo de nuestro modelo que lleva a cabo la convolución de atención multicabeza.
Tras la inicialización básica, comienza la configuración por etapas de los objetos internos. En primer lugar, se inicializa el módulo cNeighbors, que se encarga de procesar los vecinos más significativos.
   int index = 0;
   if(!cNeighbors.Init(0, index, OpenCL, units * m_units, optimization, iBatch))
      return false;
   CBufferFloat* temp = cNeighbors.getOutput();
   if(!temp ||
      !temp.Random(0, (float)(units - 1)))
      return false;
En la fase inicial, rellenamos el búfer de resultados del objeto con valores aleatorios de los índices de los vecinos, lo que garantiza la diversidad del muestreo.
Se lleva a cabo una secuencia similar para el módulo cRamdomCandidates, que almacena candidatos aleatorios para ampliar el muestreo.
   index++;
   if(!cRamdomCandidates.Init(0, index, OpenCL, units * m_units, optimization, iBatch))
      return false;
   temp = cRamdomCandidates.getOutput();
   if(!temp ||
      !temp.Random(0, (float)(units - 1)))
      return false;
Este enfoque proporciona un mecanismo híbrido de selección de vecinos: una combinación de elementos significativos y aleatorios.
A continuación, se inicializan dos objetos del array cProjection, que forman las proyecciones de los embeddings originales en los espacios de consultas y claves. Al primer objeto se le asigna la función de activación SoftPlus, y al segundo, TANH. Esto genera una transformación no lineal y permite que el modelo tenga en cuenta las interacciones complejas entre los elementos.
   index++;
   if(!cProjection[0].Init(index, 0, OpenCL, window, window, 2 * heads, units, 1,
                                                             optimization, iBatch))
      return false;
   cProjection[0].SetActivationFunction(SoftPlus);
   index++;
   if(!cProjection[1].Init(index, 0, OpenCL, 2 * heads, 2 * heads, 2 * heads, units,
                                                           1, optimization, iBatch))
      return false;
   cProjection[0].SetActivationFunction(TANH);
   index++;
   if(!cScores.Init(0, index, OpenCL, units * m_units * heads, optimization, iBatch))
      return false;
//---
   return true;
  }
Para terminar, se inicializa el objeto cScores, que acumula los pesos de atención dispersos y genera la matriz de influencia final que se utiliza en la convolución de grafos.
En general, el método Init consiste en un proceso de inicialización por etapas cuidadosamente diseñado, que garantiza la configuración correcta de todos los componentes de la capa. Garantiza que cada objeto cuente con las dimensiones, las funciones de activación y los parámetros necesarios para funcionar dentro de una arquitectura unificada. Este enfoque hace que la capa sea flexible y escalable, lo que permite adaptarla a diferentes configuraciones de datos, al número de cabezas de atención y al tamaño del muestreo de vecinos, al tiempo que se mantiene la eficiencia computacional y una alta precisión.
El método feedForward implementa con precisión la pasada directa de datos a través de la arquitectura unificada del módulo, garantizando la interacción secuencial de todos los componentes internos. En primer lugar, se invoca el método SignificantNeighborsSampling, que genera arrays de índices de vecinos significativos. Si, por cualquier motivo, este paso falla, la función devuelve inmediatamente false, lo que impide que se realicen más cálculos y mantiene la corrección del estado de la capa.
bool CNeuronSNSMHAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!SignificantNeighborsSampling(NeuronOCL))
      return false;
Tras seleccionar correctamente los vecinos, se almacena en la variable local inputs un puntero al objeto de datos de origen NeuronOCL, que se envía para su paso secuencial a través de los bloques de proyección. El bucle recorre cada elemento del array cProjection. Para cada elemento se invoca su propio método FeedForward, que realiza transformaciones lineales y no lineales del tensor de entrada, generando las proyecciones de consultas y claves para la posterior operación de atención.
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(uint i = 0; i < cProjection.Size(); i++)
     {
      if(!cProjection[i].FeedForward(inputs))
         return false;
      inputs = cProjection[i].AsObject();
     }
Además, tras el procesamiento de cada bloque, la entrada del siguiente paso se reasigna a la salida del anterior, lo que garantiza un flujo continuo de datos y una transformación en cascada precisa.
El siguiente paso consiste en llamar al método SparseMHScores, que calcula los coeficientes de atención dispersos para todos los pares nodo–vecino, teniendo en cuenta el coeficiente de dispersidad fSparse.
   if(!SparseMHScores())
      return false;
   if(!CNeuronConvOCL::feedForward(cScores.AsObject()))
      return false;
//---
   return true;
  }
Los valores obtenidos se acumulan y se envían a la capa convolucional de agregación de atención multicabeza, cuya funcionalidad la proporciona la clase base. Aquí se realiza la transformación final, que genera los valores de salida definitivos de la capa.
Todo el proceso está diseñado para garantizar un recorrido lógico y coherente de los datos a través de las etapas clave: primero, la selección de vecinos significativos; a continuación, la generación de proyecciones, el cálculo de los coeficientes de atención dispersos y, por último, la agregación de la información. Este enfoque garantiza una gran legibilidad del código y permite integrar fácilmente transformaciones u optimizaciones adicionales sin alterar la arquitectura general. Al final del método se devuelve true, lo que indica que la pasada directa ha finalizado correctamente y que la capa está lista para continuar con el proceso.
El método calcInputGradients se encarga de distribuir con precisión el gradiente de error entre todos los componentes internos de la capa y los datos de entrada, lo que garantiza una pasada inversa correcta para el entrenamiento del modelo. En primer lugar, se comprueba que el puntero a la capa anterior prevLayer sea válido. En caso de que no exista, la función devuelve inmediatamente false, lo que evita cálculos incorrectos.
bool CNeuronSNSMHAttention::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!prevLayer)
     return false;
A continuación, se invoca el método homónimo de la clase base para distribuir los gradientes en el nivel de la capa de agregación cScores.
   if(!CNeuronConvOCL::calcInputGradients(cScores.AsObject()))
      return false;
   if(!SparseMHScoresGrad())
      return false;
Después se invoca SparseMHScoresGrad, que se encarga de distribuir los gradientes a través de los coeficientes de atención dispersos formados por el módulo Sparse Spatial Multi-Head Attention. Es precisamente aquí donde se tienen en cuenta las particularidades de la matriz dispersa de vecinos, conservando el principio de funcionamiento de la arquitectura.
Luego se inicia un bucle por el array de proyecciones cProjection en orden inverso, comenzando por el último bloque. Para cada proyección se define el objeto de entrada inputs: si no se trata del primer bloque, se utiliza la salida del bloque anterior; en caso contrario, se utiliza prevLayer.
   int total=(int)cProjection.Size();
   CNeuronBaseOCL* inputs = NULL;
   for(int i = total-1; i >=0; i--)
     {
      inputs = (i>0 ? cProjection[i-1].AsObject() : prevLayer);
      if(!inputs.CalcHiddenGradients(cProjection[i].AsObject()))
         return false;
     }
//---
   return true;
  }
Para cada objeto se invoca el método CalcHiddenGradients, que calcula los gradientes locales de los estados ocultos teniendo en cuenta todos los gradientes acumulados del siguiente nivel. Esto garantiza una propagación coherente y correcta del error a través de todas las capas intermedias, manteniendo la coherencia de los pesos y los estados ocultos.
De este modo, calcInputGradients realiza una pasada inversa completa y estructurada a través del módulo unificado, distribuyendo con precisión los gradientes tanto por los coeficientes de atención dispersos como por todas las capas de proyección, lo que garantiza la preparación para el siguiente paso de optimización.
El método updateInputWeights se encarga de actualizar secuencialmente los parámetros de peso de todos los componentes internos de la capa tras la distribución de los gradientes de error. Garantiza una optimización correcta del modelo a partir de los gradientes calculados, distribuyendo con precisión los cambios entre cada elemento de la arquitectura.
bool CNeuronSNSMHAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(uint i = 0; i < cProjection.Size(); i++)
     {
      if(!cProjection[i].UpdateInputWeights(inputs))
         return false;
      inputs = cProjection[i].AsObject();
     }
En primer lugar, el método declara un puntero local al objeto de datos de entrada inputs, que inicialmente apunta a la capa externa NeuronOCL. A continuación, se ejecuta un bucle por todos los bloques de proyección cProjection. Para cada bloque se invoca el método UpdateInputWeights, que aplica los gradientes calculados a los parámetros de peso del bloque actual. Si la actualización de los pesos falla en cualquier etapa, el método devuelve inmediatamente false, evitando que el modelo entre en un estado incoherente. Una vez actualizado correctamente el bloque, el puntero de inputs se redirige a la salida de la proyección actual, para que el siguiente bloque reciba correctamente los datos de entrada actualizados.
Al finalizar el ciclo, se invoca el método homónimo de la clase base, que actualiza los pesos de la capa de agregación de la atención multicabeza, garantizando la coherencia entre todos los niveles del modelo. Este paso es fundamental para garantizar el correcto funcionamiento de los coeficientes de atención dispersos y para mantener la influencia de cada vecino seleccionado en la función predictiva final.
   if(!CNeuronConvOCL::updateInputWeights(cScores.AsObject()))
      return false;
//---
   return true;
  }
Al finalizar, el método devuelve true, lo que indica que la optimización de los pesos se ha realizado correctamente para todos los componentes internos del módulo.
En conjunto, el objeto CNeuronSNSMHAttention permite combinar de forma precisa algoritmos complejos de selección de vecinos y de atención multicabeza en una única estructura, lo que garantiza transparencia, escalabilidad y flexibilidad.
La jornada de hoy ha sido intensa y productiva. Nos hemos sumergido de lleno en la implementación de los módulos Significant Neighbors Sampling y Sparse Spatial Multi-Head Attention. Hemos analizado sus características arquitectónicas y hemos examinado en detalle los mecanismos de la pasada directa y la pasada inversa, así como la optimización de los pesos. Ha llegado el momento de hacer una pequeña pausa para dejar que la información asimilada se asiente y preparar el terreno para el siguiente paso.
En el próximo artículo retomaremos el trabajo iniciado y lo llevaremos con cuidado hasta su conclusión lógica. Además, realizaremos pruebas del modelo construido con datos históricos, evaluaremos su robustez y la precisión de sus pronósticos, y demostraremos la aplicabilidad práctica del enfoque propuesto en series temporales financieras reales.
Conclusión
En este artículo hemos analizado en detalle la implementación práctica de los módulos clave del framework SAGDFN mediante MQL5 y OpenCL. Hemos analizado los enfoques para seleccionar vecinos significativos mediante Significant Neighbors Sampling, construir atención multicabeza dispersa y organizar eficazmente la pasada directa y la pasada inversa dentro de una única capa neuronal. Se ha prestado especial atención a la optimización de los cálculos: hemos demostrado cómo la reutilización de los parámetros de ponderación y el paso a la normalización dispersa permiten reducir considerablemente la carga sobre la memoria y acelerar el procesamiento de datos.
En definitiva, la arquitectura creada garantiza a la vez una alta precisión en las predicciones y una gran eficiencia computacional, lo que hace que el modelo sea adecuado para trabajar con un gran número de series temporales.
Referencias
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19370
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Robot de trading basado en un modelo GPT
 Herramientas de trading de MQL5 (Parte 7): Panel informativo para el seguimiento de posiciones en múltiples símbolos y de la cuenta
 Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (Final)
 Asesor experto de Forex basado en la red neuronal N-BEATS

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso