

取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(主要構成要素)
 19
 1

はじめに
前回の記事では、GinARフレームワークについて詳しく解説しました。GinARは、グラフニューラルネットワークの利点と、非同期・不完全・異種のデータを用いて学習できる能力を組み合わせた、時系列データ処理のための先進的なアーキテクチャです。 このアプローチの基本的な考え方は、時系列を単なる平坦な観測値の列としてではなく、グラフ構造として捉えることにあります。このグラフでは、個々の変数や時点を、任意の学習可能な相互依存関係によって結び付けることができます。 この手法は、データが不規則で、欠損値を含み、複雑な潜在的関係を示すことの多い金融モデリングの問題において、特に有効です。
GinARは、こうした問題を解決するための汎用的なツールとして提案されました。 そのモジュール構造は、主に次の要素から構成されています。
- 補間アテンション:観測済みの変数から情報を集約することで、欠損値の再構成を可能にする仕組み
- グラフ層:それぞれが独自の学習可能な重みを持つ層
- 適応型正規化関数:外れ値やスケールの不安定性に対するモデルの頑健性を高める関数
補間アテンション(Interpolation Attention)は、このアーキテクチャの中核を担う仕組みです。これは従来のSelf-Attentionカーネルとは異なり、変数間の大域的な依存関係と、個々の観測値を取り巻く局所的なコンテキストの両方を考慮できる、独立した適応型モジュールです。 実際には、たとえば、直近の観測値が欠けている場合でも、周辺の指標間の関係や市場全体の状況を利用して、金融指標の値を予測できます。 このような仕組みは、データの到着が遅れたり、不規則な間隔で届いたり、大きな欠損が生じたりする実環境において、特に重要です。
GinARの大きな特徴の一つは、学習中にグラフ構造を動的に再構成できることです。 多くのグラフベースのモデルでは、グラフ構造が事前に固定されていますが、GinARでは学習の過程でその構造が形成されます。 これにより、市場環境の変化、相関関係、潜在的な要因を考慮できるようになります。 モデルは、どの変数同士を結び付けるべきか、どの接続の影響を弱めるべきか、また、現在のコンテキストにおいてどの変数を重要なものとして扱うべきかを、自ら学習します。 その結果、市場レジームや市場の動態に適応できる柔軟なアーキテクチャが実現します。
著者によるGinARフレームワークの構成図を以下に示します。
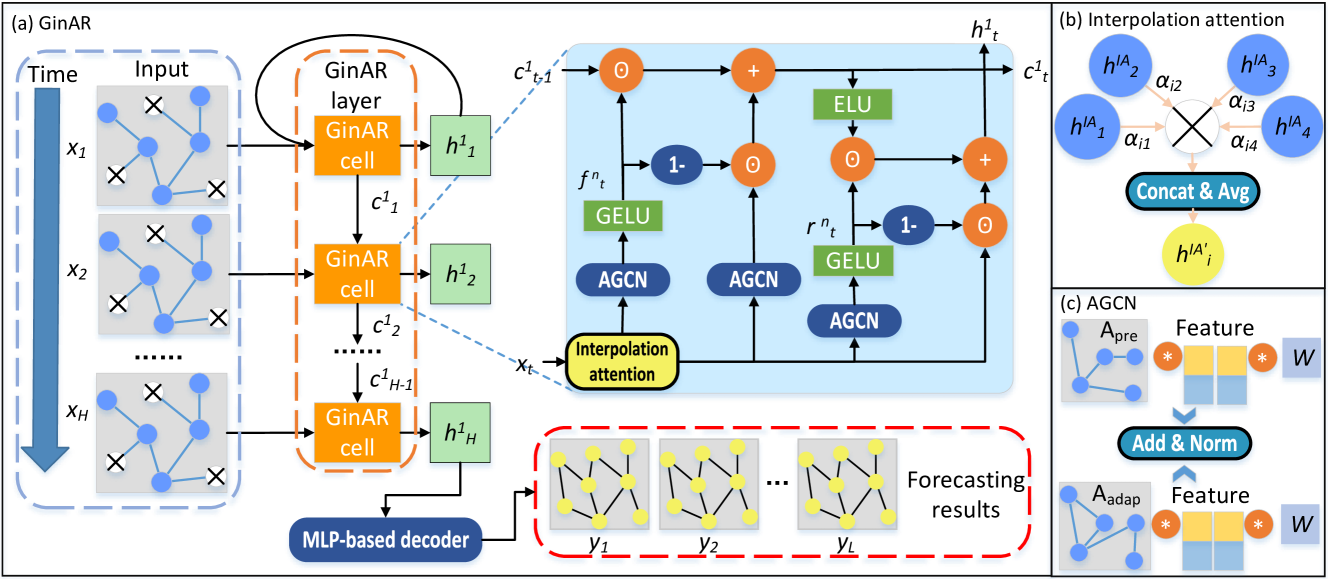
前回の記事の実践セクションでは、OpenCLプログラム内で計算を実行するための基盤を整えるべく、多くの作業をおこないました。 局所的なリダクション演算やSoftMaxの計算から、補間アテンションモジュールにおける順伝播・逆伝播まで、主要な関数をすべて実装しました。 特に重視したのは、ローカルメモリの適切な管理、スレッド同期、そして数値安定性です。これらは、並列計算環境で不完全な時系列データを扱ううえで、非常に重要な要素です。
こうした準備によって、次の段階であるモデルのコア部分とメインプログラムとの統合に向けた道筋が整いました。 ここで、アルゴリズムが実際に動き始めます。取引環境からデータを入力し、OpenCLデバイス上で処理した後、モデルに通して、予測結果や取引判断を出力します。 高水準のロジックと、低水準の高速計算処理をつなぐこの仕組みは、GinARアーキテクチャ全体を実装するうえで、極めて重要な要素となります。
補間アテンション
今回は、GinARフレームワークの主要構成要素を実装するため、実践的な作業を数多く進めていきます。 そのため、理論的な説明に時間をかけすぎず、さっそく本題に入りましょう。
まず、重要なモジュールであるInterpolation Attentionを作成します。このモジュールは、独立した CNeuronInterpolationAttentionクラスとして実装します。 このクラスは、ライブラリにおけるニューラルネットワーク層の基底クラスCNeuronBaseOCLを継承し、前回の記事の実践編で準備したOpenCLカーネルを、順伝播から逆伝播までの一連の処理で効率的に利用するために必要なロジックを実装します。
class CNeuronInterpolationAttention :  public CNeuronBaseOCL
  {
protected:
   //---
   uint                 iCount;
   uint                 iDimension;
   //---
   CParams              cW;
   CParams              cA;
   CParams              cGL;
   //---
   CNeuronBaseOCL       cH;
   CNeuronBaseOCL       cAdj;
   CNeuronBaseOCL       cAttention;
   //---
   virtual bool      InterpolationAttention(CNeuronBaseOCL *NeuronOCL);
   virtual bool      InterpolationAttentionGrad(CNeuronBaseOCL *NeuronOCL);
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronInterpolationAttention(void) { activation = None; }
                    ~CNeuronInterpolationAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const {  return defNeuronInterpolationAttention; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
このクラスには、複数の内部変数が用意されています。iCountとiDimensionは、入力データテンソルの要素数と次元数を定義します。また、cW、cA、cGLは、学習可能な行列のパラメータを保持するオブジェクトです。 さらに、中間結果を保存するためのオブジェクトとして、隠れ表現、隣接グラフ、アテンション重みをそれぞれ格納する専用のオブジェクトが用意されています。
計算処理の中核は、InterpolationAttentionメソッドとInterpolationAttentionGradにカプセル化されています。これらは、それぞれ順伝播と逆伝播を担当します。 両メソッドでは、前回の記事の実践編で作成した対応するOpenCLカーネルを実行するための準備と、実行キューへの登録をおこないます。 これらのメソッドでは、すでに説明したアルゴリズムを使用しているため、本記事では詳しく取り上げません。 各メソッドの完全なコードは、学習用の添付ファイルに収録されています。
CNeuronInterpolationAttentionクラスの内部オブジェクトは、すべてメンバーオブジェクトとして直接宣言されています。これにより、インスタンスのライフサイクル管理が簡素化されます。 そのため、クラスのコンストラクタとデストラクタには、特別な処理を記述する必要がありません。明示的な初期化やリソースの解放も不要です。 クラス自身のメンバーと親クラスから継承した構成要素を含め、必要な設定はすべてInitメソッドに集約されています。 これにより、初期化処理が明確で予測しやすい構造になり、コードの重複を避けるとともに、さまざまなモデル構成でこのモジュールを再利用する際の信頼性を高められます。
bool CNeuronInterpolationAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                         uint units_count, uint dimension,
                                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * dimension,
                                                        optimization_type, batch))
      return false;
ソッドの本体では、まず親クラスCNeuronBaseOCLの同名メソッドを呼び出します。 このとき、入力信号の空間的な次元数を考慮して、層のサイズを再計算します。
続いて、変数の数と表現の次元数という、モデルの主要なパラメータを保存します。これらの値は、その後の計算や内部バッファの管理に使用されます。 また、順伝播と逆伝播で使用する、他のすべてのベクトルと行列のサイズを決定します。
iCount = units_count;
iDimension = dimension;
次のコードブロックでは、補間アテンションで使用するパラメータと中間テンソルを初期化します。 まず、学習可能な重み cWを作成します。 これは、変数間の相互作用を表す個別の行列であり、サイズはdimension × dimensionです。
int index = 0;
if(!cW.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
   return false;
次に、ノード間のアテンション情報の集約を担うcAパラメータを初期化します。
index++;
if(!cA.Init(0, index, OpenCL, 2 * iDimension, optimization, iBatch))
   return false;
index++;
if(!cGL.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
   return false;
その後、cGLオブジェクトを作成します。 これは変数の潜在ベクトルを表し、こちらもdimension × dimensionのサイズを持ちます。
すべての学習可能パラメータの初期化が完了したら、中間結果を保存する補助オブジェクトの設定に移ります。 cHバッファは、入力信号に重みを乗じて得られる線形変換結果の行列を保持します。 そのサイズはunits_count × dimensionです。
index++;
if(!cH.Init(0, index, OpenCL, iCount * iDimension, optimization, iBatch))
   return false;
続いて、cAdjオブジェクトを設定します。このオブジェクトには、変数間の相関値を調整した結果が格納されます。
   index++;
   if(!cAdj.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
      return false;
   index++;
   if(!cAttention.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
      return false;
//---
   return true;
  }
最後に、cAttentionは、SoftMaxによる正規化を経て得られた最終的なAttention値を保持するテンソルです。
各オブジェクトの初期化後には、処理が正常に完了したかどうかを確認します。 いずれかの段階で失敗した場合、メソッドは直ちにfalseを返します。これにより、設定時のエラーに対する確実な保護が実現されます。
すべてのオブジェクトの設定が正常に完了し、OpenCLデバイスのメモリ上に配置されると、メソッドはtrueを返して終了します。 これは、この層が完全に初期化され、モデルの一部として実行できる状態になったことを意味します。
オブジェクトの初期化が完了したら、次に順伝播処理を設定します。この処理はfeedForwardメソッドで実装します。 このメソッドの役割は、入力データを適切に準備し、先ほど開発したOpenCLカーネルを使って主要な計算を実行することです。 アルゴリズム自体は比較的簡潔ですが、層全体の動作において重要な役割を果たす、いくつかの段階から構成されています。
bool CNeuronInterpolationAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(bTrain)
     {
      if(!cW.FeedForward())
         return false;
      if(!cA.FeedForward())
         return false;
      if(!cGL.FeedForward())
         return false;
     }
   if(!InterpolationAttention(NeuronOCL))
      return false;
//---
   return true;
  }
まず、メソッドは bTrainフラグを確認します。このフラグは、層が学習モードにあるかどうかを示します。 学習モードの場合、最初にモデルの学習可能パラメータそれぞれについて、対応するFeedForwardメソッドを実行する必要があります。 この呼び出しは、パラメータの値を更新し、現在の計算サイクルに正しく参加できるようにするために必要です。 3つの呼び出しすべてで処理の成功を確認し、少しでも失敗があれば、メソッドは直ちに実行を中止してfalseを返します。 これにより、初期化されていないパラメータや無効なパラメータが後続の計算に渡されることを防ぎます。
準備処理がすべて完了したら、メインのInterpolationAttentionメソッドを呼び出します。 この関数は、Attentionの計算、値の集約、そして層の出力表現の生成を担当するOpenCLカーネルの実行を開始します。
最後に、このメソッドは各処理の成否を示す真偽値を呼び出し元に返します。
calcInputGradientsメソッドは、誤差逆伝播のロジックがすでに対応するOpenCLカーネルに移されているため、非常に簡潔に実装されています。 ここでは、カーネルの実行開始と必要なバッファの受け渡しを担当するラッパー関数 InterpolationAttentionGradを呼び出すだけです。 その後、処理の成否を示す真偽値を呼び出し元に返します。
bool CNeuronInterpolationAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!InterpolationAttentionGrad(NeuronOCL))
      return false;
//---
   return true;
  }
この実装は、ニューラルネットワーク層全体の基本的な動作構造を維持しています。そのため、学習処理のロジックを変更することなく、ほかの種類の層と組み合わせてこのモジュールを使用できます。 これは、システムのアーキテクチャが柔軟であることを示しており、新たな機能を可能な限り簡単かつ安全に統合できるようにします。
このモジュールの学習可能パラメータの更新処理も、簡潔で論理的な構造になっています。 計算に使用する重みは、すべてクラス内部のオブジェクト(cW、cA、cGL)として管理されており、それぞれが独自の更新アルゴリズムを持っています。 updateInputWeightsメソッドは、これらのオブジェクトに対応する関数を呼び出すだけです。これにより、モジュール性が保たれ、明快なアーキテクチャが実現されています。
bool CNeuronInterpolationAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cW.UpdateInputWeights())
      return false;
   if(!cA.UpdateInputWeights())
      return false;
   if(!cGL.UpdateInputWeights() ||
      !Normilize(cGL.getWeightsParams(), 2 * iDimension))
      return false;
//---
   return true;
  }
特に注意が必要なのは、cGLテンソルです。このテンソルは、更新された後にNormilize関数による追加の正規化処理を受けます。 これは、cGLが変数間の相関に基づく接続の重みを保持しており、その係数の安定性がAttentionモジュール全体の安定性に直接影響するためです。 正規化によって極端な値の影響を抑え、重みの解釈可能性を維持しやすくなります。 このように、このメソッドは追加の介入や設定を必要とせず、学習サイクルを完了させます。
CNeuronInterpolationAttentionクラスの完全なソースコードと、すべてのメソッドの実装は、添付ファイルに含まれています。 本記事では、技術的な詳細を詰め込みすぎず、読み進めやすい内容にすることを意図して、説明を簡潔にしています。ただし、このモジュールのロジックとGinARフレームワーク全体への統合方法を十分に理解するために、ソースコードにも目を通すことをお勧めします。
AGCN
GinARフレームワークの開発における次の論理的なステップは、適応型グラフ畳み込み(AGCN)の仕組みを実装することです。 これは、グラフのノードとして表現された時系列データ間の複雑な関係を考慮するための重要な構成要素です。 従来の手法では、グラフ構造をあらかじめ定義し、学習中も固定したまま使用します。一方、適応型畳み込みでは、データの現在の状態に基づいて、モデルが接続のトポロジーを独自に構築し、変更できます。 この柔軟性は、構造が絶えず変動し、隠れた相互関係や外部からの影響を受ける金融時系列データを扱ううえで、特に重要です。
この仕組みを実装するため、CNeuronAGCNクラスとして独立したモジュールを開発しました。 このクラスは、全結合層の基底クラスであるCNeuronBaseOCLを継承し、OpenCLによる高速化を利用して適応型畳み込みを実行するために必要なロジックをすべてカプセル化しています。 内部構造は、特徴量の抽出、接続行列の生成、正規化、集約、グラフの重みの学習など、処理の各段階で計算効率と精度を最大限に高められるよう設計されています。
このモジュールの特徴は、情報の処理にあたって固定された隣接行列に依存せず、リアルタイムで行列を計算する点です。 そのために、入力データを一連の変換処理に通し、各ノードの潜在表現を生成します。 これらの表現を使ってノード間の類似度を計算し、その結果に基づいて適応型の接続行列を構築します。 つまり、モデルは各時系列を個別に評価し、どの時系列と接続するべきか、また、その接続をどの程度強くするかを自ら判断します。 その結果、各ノードがコンテキストに応じて振る舞いを調整できる、柔軟なAttentionの仕組みが実現します。
新しいクラスの構造は以下の通りです。
class CNeuronAGCN    :  public CNeuronBaseOCL
  {
protected:
   CParams              cEa;
   CNeuronSwiGLUOCL     cWx;
   CNeuronSwiGLUOCL     cWe;
   CNeuronBaseOCL       cWconcat_ex;
   CNeuronConvOCL       cEn;
   CNeuronTransposeOCL  cEnT;
   CNeuronBaseOCL       cEnEnT;
   CNeuronSoftMaxOCL    cAadapt;
   CNeuronBaseOCL       cAadaptX;
   CNeuronBaseOCL       cApreX;
   CNeuronSwiGLUOCL     cWadapt;
   CNeuronSwiGLUOCL     cWpre;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None) override;

public:
                     CNeuronAGCN(void) {activation = None;}
                    ~CNeuronAGCN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronAGCN; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   //---
   virtual uint      GetWindow(void) const      { return cWx.GetWindow(); }
   virtual uint      GetUnits(void) const       { return cWx.GetUnits(); }
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
計算処理全体は単一のオブジェクトにまとめられていますが、その内部には多数の補助層や演算処理が含まれています。 処理ロジックは複数の段階に分かれており、クラスの各メソッドを実装しながら順番に確認していきます。 出力される特徴量は、時系列の内容に関する情報とトポロジー上の関係の両方を考慮し、適応されたグラフ上で協調的なフィルタリングを行った結果として解釈できます。
前の層と同様に、CNeuronAGCNクラスの内部構成要素はすべてメンバーオブジェクトとして直接宣言しています。 この方法により、クラスのコンストラクタとデストラクタを空のままにし、初期化処理をすべてInitメソッドInitに集約できます。 これによって実装が簡潔になり、層内のオブジェクトのライフサイクルも管理しやすくなります。
bool CNeuronAGCN::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint units_count, uint dimension,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            units_count * dimension, optimization_type, batch))
      return false;
初期化は、親クラスの同名メソッドを呼び出すところから始まります。ここでインターフェースの初期設定と、層全体に関する基本パラメータの設定をおこないます。 その後、適応型グラフ畳み込みを構成する主要な構成要素を、順番に設定していきます。
最初のステップでは、データ構造に関する追加情報をエンコードするためのcEaオブジェクトを作成します。
//---
   int index = 0;
   if(!cEa.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cEa.SetActivationFunction(None);
次に、2つの重要な層であるcWxとcWeを初期化します。これらは、入力データと、時系列の構造について事前に学習した情報から、それぞれ特徴量を抽出する役割を担います。 どちらの層もSwiGLU機構を用いて実装され、並行して学習が実施されます。
index++;
if(!cWx.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                   1, optimization, iBatch))
   return false;
index++;
if(!cWe.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                   1, optimization, iBatch))
   return false;
続いて、潜在空間の表現を結合するためのcWconcat_exバッファを用意します。
index++;
if(!cWconcat_ex.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
   return false;
cWconcat_ex.SetActivationFunction(None);
初期化処理の次の段階では、結合された特徴量に線形変換を適用するcEn層を設定します。 さらに、転置処理をおこなうcEnTモジュールを組み合わせ、予備的なAttention行列を生成するためのデータを準備します。
index++;
if(!cEn.Init(0, index, OpenCL, 2 * dimension, 2 * dimension, dimension, units_count,
                                                           1, optimization, iBatch))
   return false;
cEn.SetActivationFunction(None);
index++;
if(!cEnT.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cEnEnT.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
   return false;
cEnEnT.SetActivationFunction(GELU);
転置処理の後、準備されたデータは行列積の演算に渡され、元の表現とその転置表現の間で内積が計算されます。 その結果、対称的な関係行列が生成され、cEnEnTオブジェクトに格納されます。 このブロックでは、生成された値にGELU関数も適用されます。この関数は、負の相関を完全に排除することなく緩やかに抑制し、最終的な表現への影響を小さくします。
この方法により、グラフのノード間に存在する重要なパターンや潜在的な関係を特定しやすくなります。これは、適応型アテンション行列を構築するうえで極めて重要です。 この演算を通じて、モデルはグラフ内部のより深い構造的パターンを捉え、ノード間の相互作用に適切な重みを付けられるようになります。
次に、得られた値を正規化する重要なステップに進みます。 ここでは、cAadaptオブジェクト内でSoftMax関数を使用します。 この演算によって、生の重み係数が確率分布に変換され、グラフのノード間にある各エッジに重要度が割り当てられます。 その結果、弱くノイズの多い依存関係は抑制され、強く情報量の多い依存関係は強調されます。 こうして、入力信号の各要素がどのように相互作用するかを反映した、適応型アテンション行列が完成します。
index++;
if(!cAadapt.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
   return false;
cAadapt.SetHeads(units_count);
次の処理では、適応型の重みを入力データに適用します。 この段階では、対応するAttention係数を使って入力特徴量に重み付けをおこないます。 結果はcAadaptXバッファに格納されます。このバッファには、コンテキスト情報が加わった新しい入力信号の表現が保存されます。 言い換えれば、グラフ内の各ノード間で特定された関係を考慮し、元の入力を再重み付けした表現です。
index++;
if(!cAadaptX.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cAadaptX.SetActivationFunction(None);
index++;
if(!cApreX.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cApreX.SetActivationFunction(None);
さらに、事前定義されたグラフ構造を考慮して入力データを調整します。 この処理の目的は、学習対象のモデルの外部で導き出された、ノード間の既知の関係を強調することです。たとえば、ファンダメンタルズに基づく関係、トポロジー、専門家が定めたルールなどが該当します。 仕組み自体は先ほどの処理と似ています。元のテンソルに重みを適用しますが、ここでは適応型アテンション行列ではなく、外部から与えられた係数行列を使用します。 結果はcApreXバッファに保存されます。 これにより、モデルは2つの独立した情報経路を同時に利用できます。1つは自動学習によって特定されたパターンに基づく経路、もう1つは構造的な事前情報に基づく経路です。 両者を組み合わせることで、モデルの柔軟性と頑健性のバランスを改善できます。
最後に、初期化処理の仕上げとして、2つの畳み込み層cWadaptとcWpreを作成します。 どちらもSwiGLUアーキテクチャを使用し、生成された接続行列の構造に合わせて特徴量を調整するフィルタとして機能します。
   index++;
   if(!cWadapt.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                          1, optimization, iBatch))
      return false;
   cWadapt.SetActivationFunction(None);
   index++;
   if(!cWpre.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                              optimization, iBatch))
      return false;
   cWpre.SetActivationFunction(None);
   SetActivationFunction(None);
//---
   return true;
  }
すべての初期化処理が完了したら、層の活性化関数を明示的に無効化します。非線形変換は内部ブロックですでに適用されているため、出力部分で重複して適用する必要はありません。
このように、Initメソッドは、適応型畳み込みを構成するすべての要素を生成し、設定するための、整理された一連の処理で構成されています。 各構成要素が特定の計算を担当し、層全体のアーキテクチャに組み込まれることで、モデルがその後の処理を実行するための基盤が形成されます。
次の段階では、feedForwardメソッドを実装します。このメソッドは、学習可能な接続と、外部から指定された構造的な接続の両方を考慮しながら、適応型グラフ畳み込みの順伝播処理全体を実行します。 アルゴリズムはかなり複雑なので、各ブロックが担う意味上の役割に注目しながら、順番に確認していきましょう。
bool CNeuronAGCN::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput || SecondInput.Total() < cAadapt.Neurons())
      return false;
アルゴリズムの実行を開始する前に、入力データの妥当性を必ず確認します。事前に定義された相関係数の行列であるSecondInputが存在しない場合、または行列演算に必要なサイズが確保されていない場合は、処理を直ちに終了します。
次に、モデルが学習モードにある場合、ノードの適応型コンテキストを担当する経路について、パラメータを準備するループを開始します。 まず、エッジの埋め込み表現を計算するための学習可能パラメータを保持するcEaオブジェクトで順伝播を実行します。 その結果をcWeに渡し、外部の相互作用に関する重み行列を生成します。この重み行列は、現在の学習ステップにおけるノード間の接続のコンテキストを反映します。
if(bTrain)
  {
   if(!cEa.FeedForward())
      return false;
   if(!cWe.FeedForward(cEa.AsObject()))
      return false;
  }
同時に、主要な特徴量系列を処理するメイン経路も動作します。 この経路ではcWxの順伝播メソッドを呼び出し、各ノードの現在の状態を表す特徴量を生成します。
if(!cWx.FeedForward(NeuronOCL))
   return false;
if(!Concat(cWx.getOutput(), cWe.getOutput(), cWconcat_ex.getOutput(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
その後、2つの出力ベクトル(cWxとcWe)を、系列の各要素に沿って結合します。これにより、後続の処理で構造情報とコンテキスト情報の両方を考慮できるようになります。 結合後の出力はcEnに渡されます。ここでは線形畳み込みを実行し、次元を削減するとともに、意味のある特徴量を強調します。
if(!cEn.FeedForward(cWconcat_ex.AsObject()))
   return false;
if(!cEnT.FeedForward(cEn.AsObject()))
   return false;
if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(),
             cEnT.GetCount(), cEnT.GetWindow(), cEnT.GetCount()))
   return false;
if(cEnEnT.Activation() != None)
   if(!Activation(cEnEnT.getOutput(), cEnEnT.getOutput(), cEnEnT.Activation()))
      return false;
続いて、重要な演算をおこないます。行列を転置し、元の行列との積を計算することで、cEnEnTオブジェクト内に対称的な相関行列を構築します。 このオブジェクトに活性化関数(今回はGELU)が設定されている場合は、それを適用し、ノイズや負の相関の影響を緩和します。
得られた行列をcAadaptオブジェクトに渡し、Multi-Head Attention構造の内部でSoftMaxを適用します。 これにより、各行の重みが正規化され、現在のデータ構造に適応したAttention行列が得られます。 さらに、対角成分の接続を強化するため、IdentSum関数を呼び出します。この関数は結果に単位行列を加算し、入力データが疎な場合でもグラフの頑健性を確保します。
if(!cAadapt.FeedForward(cEnEnT.AsObject()))
   return false;
if(!IdentSum(cAadapt.getOutput(), cAadapt.getOutput(), cAadapt.Heads()))
   return false;
次に、2つの並列した行列積処理を実行します。 1つ目の経路では、外部データであるSecondInputとニューラル層の現在の出力を乗算し、その結果をcApreXバッファに保存します。 2つ目の経路では、同様の処理をcAadapt Attention行列と現在の出力に対して実行し、結果をcAadaptXに保存します。
if(!MatMul(SecondInput, NeuronOCL.getOutput(), cApreX.getOutput(),
           cWpre.GetUnits(), cWpre.GetUnits(), cWpre.GetWindow()))
   return false;
if(!MatMul(cAadapt.getOutput(), NeuronOCL.getOutput(), cAadaptX.getOutput(),
           cWadapt.GetUnits(), cWadapt.GetUnits(), cWadapt.GetWindow()))
   return false;
最後に、両方の経路を学習可能な畳み込みブロックcWpreとcWadaptに通します。 これにより、局所的な特徴量を考慮しながら、得られたデータをさらに調整できます。
   if(!cWpre.FeedForward(cApreX.AsObject()))
      return false;
   if(!cWadapt.FeedForward(cAadaptX.AsObject()))
      return false;
   if(!SumAndNormilize(cWadapt.getOutput(), cWpre.getOutput(), Output, cWadapt.GetWindowOut(), true))
      return false;
//---
   return true;
  }
その後、SumAndNormilize関数を呼び出し、2つの経路の出力を結合して、層の出力として必要な形式に整えます。
このように、このメソッドでは、適応型アテンション、特徴量抽出、構造情報の統合、畳み込み変換という複数の強力な仕組みを同時に実現しています。 これにより、このモジュールは、ノード間の内部的な依存関係と外部から与えられた構造上の制約の両方を考慮できる、本格的なグラフ処理ブロックとなります。
適応型グラフ畳み込み(AGCN)の順伝播が完了したら、次に始まるのが、層の出力から学習可能な各構成要素へ誤差勾配を伝播させる、極めて重要な段階です。 この処理では、誤差逆伝播をおこないます。これにより、最終結果に対する各オブジェクトの寄与を正確に評価し、誤差を最小化するようにパラメータを調整できます。 アルゴリズム全体は、calcInputGradients メソッドに実装されています。
bool CNeuronAGCN::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                     CBufferFloat *SecondInput,
                                     CBufferFloat *SecondGradient,
                                     ENUM_ACTIVATION SecondActivation = -1)
  {
   if(!NeuronOCL || !SecondInput || !SecondGradient ||
      SecondInput.Total() < cAadapt.Neurons() ||
      SecondGradient.Total() < cAadapt.Neurons())
      return false;
最初に、入力データの妥当性を通常どおり確認します。受け取ったポインタが初期化されていない場合や、入力バッファのサイズが行列演算に不十分な場合は、メソッドの実行を終了します。 その後、実際の誤差の伝播処理に進みます。
AGCNブロックの誤差逆伝播は、最後、つまり層の出力から開始します。ここでは、すでに最終結果が形成されています。 この場合、最終結果は、主要な2つの構成要素であるcWadaptとcWpreの出力を合計したものです。 これらの構成要素は、Attention情報とグラフの静的な構造情報の両方を一般化した表現を構築する役割を担っています。
ブロックの出力は2つのテンソルの単純な合計であるため、後続の層から受け取った誤差勾配は、追加の重み係数を適用せずに、両方のモジュールへ同じように伝える必要があります。 ただし、各モジュールの内部接続を通じて勾配を計算する前に、順伝播で使用した活性化関数の影響を考慮して勾配を調整する必要があります。 そのためにDeActivationメソッドを呼び出します。これは基本的に、得られた勾配に、cWadaptとcWpreの出力に適用された活性化関数の導関数を乗算する処理です。 非線形変換を経由する誤差逆伝播を正しくおこなうには、このステップが欠かせません。
if(!DeActivation(cWadapt.getOutput(), cWadapt.getGradient(), Gradient, cWadapt.Activation()))
   return false;
if(!DeActivation(cWpre.getOutput(), cWpre.getGradient(), Gradient, cWpre.Activation()))
   return false;
次に、cAadaptXとcApreXオブジェクトに対してCalcHiddenGradientsメソッドを呼び出し、誤差をそれぞれの入力へ伝播させます。これらのオブジェクトを通じて、ノード間の適応型接続行列と事前定義された接続行列を使って形成された2つの経路が処理されます。
if(!cApreX.CalcHiddenGradients(cWpre.AsObject()))
   return false;
if(!cAadaptX.CalcHiddenGradients(cWadapt.AsObject()))
   return false;
続いて、MatMulGradを使って、行列乗算の演算を通じた誤差逆伝播を実行します。ここでは、各構成要素が全体の誤差にどの程度寄与したかを計算します。 活性化関数が使用されている場合は、DeActivationによって逆方向の変換を適用し、正規化前の状態に対応する誤差を復元します。
   if(!MatMulGrad(SecondInput, SecondGradient,
                  NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                  cApreX.getGradient(), cWpre.GetUnits(),
                  cWpre.GetUnits(), cWpre.GetWindow()))
      return false;
   if(SecondActivation != None)
      if(!DeActivation(SecondInput, SecondGradient,
                       SecondGradient, SecondActivation))
         return false;
//---
   if(!MatMulGrad(cAadapt.getOutput(), cAadapt.getGradient(),
                  NeuronOCL.getOutput(), PrevOutput,
                  cAadaptX.getGradient(),  cWadapt.GetUnits(),
                  cWadapt.GetUnits(), cWadapt.GetWindow()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), PrevOutput,
                       PrevOutput, cWx.GetWindow(), false))
      return false;
   if(NeuronOCL.Activation() != None)
      if(!DeActivation(NeuronOCL.getOutput(), PrevOutput,
                       PrevOutput, NeuronOCL.Activation()))
         return false;
順伝播で実行した2つの行列乗算では、どちらもメインの情報経路からの入力データを使用していました。 そのため、両方の経路に沿って誤差勾配を累積する必要があります。 この処理には、一時バッファPrevOutputを使用します。 NeuronOCLで活性化関数が使用されている場合は、その導関数を適用し、非線形性を考慮して勾配を正しく再計算します。
次の重要なステップは、順伝播で生成したcEnEnTの相関行列を通じた誤差逆伝播です。 まず隠れ層の勾配を計算し、GELU関数を使用していた場合は、出力に対してDeActivationを適用します。
if(!cEnEnT.CalcHiddenGradients(cAadapt.AsObject()))
   return false;
if(cEnEnT.Activation() != None)
   if(!DeActivation(cEnEnT.getOutput(), cEnEnT.getGradient(),
                    cEnEnT.getGradient(), cEnEnT.Activation()))
      return false;
続いて、MatMulGradを呼び出し、特徴量とその転置表現との乗算演算を通じて、勾配を逆方向に伝播させます。
if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
               cEnT.getOutput(), cEnT.getGradient(),
               cEnEnT.getGradient(), cEnT.GetCount(),
               cEnT.GetWindow(), cEnT.GetCount()))
   return false;
さらに、転置によって得られた側の誤差をcEn層に渡し、すでに得られている値と合算します。活性化関数が使用されていた場合は、ここでもDeActivationを適用します。
if(!cEn.CalcHiddenGradients(cEnT.AsObject()))
   return false;
if(!SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(),
                    cEn.getGradient(), cEnT.GetWindow(), false))
   return false;
if(cEn.Activation() != None)
   if(!DeActivation(cEn.getOutput(), cEn.getGradient(),
                    cEn.getGradient(), cEn.Activation()))
      return false;
その直後に、勾配をcWconcat_exへ渡し、特徴量を逆方向に分離する処理を開始します。順伝播では特徴量を結合していたことを思い出してください。
if(!cWconcat_ex.CalcHiddenGradients(cEn.AsObject()))
   return false;
if(!DeConcat(cWx.getGradient(), cWe.getGradient(), cWconcat_ex.getGradient(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
if(cWx.Activation() != None)
   if(!DeActivation(cWx.getOutput(), cWx.getGradient(),
                    cWx.getGradient(), cWx.Activation()))
      return false;
if(cWe.Activation() != None)
   if(!DeActivation(cWe.getOutput(), cWe.getGradient(),
                    cWe.getGradient(), cWe.Activation()))
      return false;
DeConcat関数は、勾配をcWx 用とcWe用の2つの部分に正しく分割します。 それぞれのモジュールでは、DeActivationを個別に呼び出し、適切な勾配を復元します。 その後、ネットワーク内の誤差逆伝播を続けます。まずcWxを通じて入力データのレベルまで伝播させ、次にcWeを通じてcEaまで伝播させます。
   if(!NeuronOCL.CalcHiddenGradients(cWx.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), PrevOutput,
                       NeuronOCL.getGradient(), cWx.GetWindow(), false))
      return false;
   if(!cEa.CalcHiddenGradients(cWe.AsObject()))
      return false;
//---
   return true;
  }
メイン経路の入力データのレベルには、すでに誤差勾配を伝播させています。そのため、ここで得られた値を、それまでに累積していた値に加算します。
特に重要なのは、このメソッドがすべての処理を厳密な順序で実行する点です。 誤差は、順伝播とは逆方向に伝播させる必要があるためです。 各ステップでは、畳み込み、正規化、活性化、転置による影響を適切に補正します。 勾配の計算がすべて完了して初めて、モデルは重みを更新できる状態になります。こうして、学習の各段階で精度を維持します。
パラメータの更新メソッドは、非常にシンプルでありながら、洗練された信頼性の高い方法で実装されています。 ここでは複雑な条件分岐や追加の計算は必要ありません。 累積された勾配と選択された最適化方式に基づいて、それぞれの学習可能な重みを直接保持する内部オブジェクトに処理を委ねます。
bool CNeuronAGCN::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second)
  {
   if(!cEa.UpdateInputWeights())
      return false;
   if(!cWe.UpdateInputWeights(cEa.AsObject()))
      return false;
   if(!cWx.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cEn.UpdateInputWeights(cWconcat_ex.AsObject()))
      return false;
   if(!cWpre.UpdateInputWeights(cApreX.AsObject()))
      return false;
   if(!cWadapt.UpdateInputWeights(cAadaptX.AsObject()))
      return false;
//---
   return true;
  }
各メソッドは、順伝播で使用した適切な入力オブジェクトを引数として呼び出されます。これにより、グラフのトポロジーに沿った計算の整合性が保たれます。
この方法を採用することで、コードの構造が読みやすくなるだけでなく、拡張もしやすくなります。
読者が技術的な詳細を確認できるよう、このクラスのすべてのソースコードと各メソッドの定義を、添付ファイルとして提供しています。
GinARセル
ここからは、最後の段階となる、GinARの本格的な計算セルの構築に進みます。これまでに説明してきたすべてのコンポーネントを、統一された構造に統合します。 CNeuronGinARCellクラスでは、補間アテンション、適応型グラフ畳み込み、メモリ制御機構が一体となり、柔軟性を備えながらも、厳密に構造化されたアーキテクチャを形成します。
class CNeuronGinARCell  :  public CNeuronBaseOCL
  {
protected:
   CNeuronInterpolationAttention cX_IA;
   CNeuronAGCN                   cX_AGCN;
   CNeuronAGCN                   cForgetGate;
   CNeuronAGCN                   cResetGate;
   CNeuronBaseOCL                cContext;
   CBufferFloat                  bTemp;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None) override;

public:
                     CNeuronGinARCell(void) { activation = None;}
                    ~CNeuronGinARCell(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinARCell; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
上記の新しいオブジェクトの構造から分かるように、CNeuronGinARCellはCNeuronBaseOCLの基本インターフェースを継承しています。これにより、フレームワーク内の他の層やモジュールとの互換性が確保されます。 ただし、単純なブロックとは異なり、このクラスは複数の機能構成要素を組み合わせています。
- cX_IA:入力時系列を平滑化し、調整する補間アテンションブロック
- cX_AGCN:入力特徴量間の関係を考慮しながら、特徴量の汎用的な表現を生成する、メインの適応型グラフ畳み込みモジュール
- cForgetGateとcResetGate:GRUセルに類似した忘却機構とリセット機構を実装する、2つの追加のグラフベースのサブシステム
- cContext:蓄積された隠れメモリの状態を保持する内部バッファ
- bTemp:中間計算に使用する一時バッファ
このクラスは、ニューラル層の標準的なサイクルを実装しています。 Initメソッドでは、CNeuronGinARCellの各構成要素を順番に初期化します。 ここで、出力数、特徴空間の次元数、最適化方式、バッチサイズなど、モデルの主要なパラメータを指定します。
bool CNeuronGinARCell::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint units_count, uint dimension,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            units_count * dimension, optimization_type, batch))
      return false;
次に、セル内部の各ブロックを順番に初期化します。 まず、補間アテンションを担当するcX_IAを初期化します。
int index = 0;
if(!cX_IA.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
続いて、メインのグラフ畳み込みモジュールcX_AGCNを初期化し、その後に制御ゲートであるcForgetGateとcResetGateを初期化します。 それぞれに固有のインデックスを割り当てます。
index++;
if(!cX_AGCN.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cForgetGate.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cResetGate.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
独立したステップとして、内部状態を蓄積する役割を担うcContextモジュールを初期化します。 起動時にランダムなノイズが生じないよう、出力を明示的にゼロで初期化します。また、純粋な記憶用バッファとして使用できるよう、活性化関数を無効にします。
   index++;
   if(!cContext.Init(0, index, OpenCL, units_count * dimension, optimization, iBatch))
      return false;
   if(!cContext.getPrevOutput().Fill(0))
      return false;
   cContext.SetActivationFunction(None);
   bTemp.BufferFree();
   if(!bTemp.BufferInit(units_count * units_count, 0) ||
      !bTemp.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
最後に、中間処理を実行するための一時バッファbTempを作成します。 バッファのサイズは、units_count * units_countという二次の大きさに設定します。 すでにバッファが作成されている場合は、最初に解放することで、正常な動作を確保するとともにリソースを節約します。
すべての処理が完了すると、メソッドは呼び出し元に真偽値を返します。
feedForwardメソッドに実装された順伝播アルゴリズムは、CNeuronGinARCellの主要な動作ロジックを担います。Attention機構、グラフ畳み込み、忘却ゲートとリセットゲートによるメモリ管理を組み合わせています。
bool CNeuronGinARCell::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!cX_IA.FeedForward(NeuronOCL))
      return false;
最初の段階では、cX_IAモジュールを実行し、NeuronOCLから渡された元のデータに補間変換を適用します。 得られた表現は、3つの並列ブロックに渡されます。メインのグラフ畳み込みモジュールcX_AGCNと、制御マスクの生成を担当するcForgetGateおよびcResetGateです。
if(!cX_AGCN.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!cForgetGate.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!cResetGate.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!Activation(cForgetGate.getOutput(), cForgetGate.getOutput(), GELU))
   return false;
if(!Activation(cResetGate.getOutput(), cResetGate.getOutput(), GELU))
   return false;
これら3つのブロックには、それぞれ2つ目の入力であるSecondInputが渡されます。この入力には、隣接行列や隣接ノードに関するデータなど、グラフや構造に関する情報が含まれています。 各層を通過した後、cForgetGateとcResetGateの出力には、活性化関数GELUを適用します。これにより、急激な変化や負の値の影響を抑えながら、より滑らかで柔軟なマスクを生成できます。
次に、内部コンテキストを更新します。 ここで注意したいのは、順伝播中に、逆伝播で必要となるコンテキスト値が上書きされてしまう点です。 これを防ぐため、バッファカルーセルを使用します。具体的には、SwapOutputsメソッドを呼び出し、OutputとPrevOutputのバッファポインタを入れ替えます。
//--- Context
   if(!cContext.SwapOutputs())
      return false;
   if(!GateElementMult(cContext.getPrevOutput(), cX_AGCN.getOutput(),
                       cForgetGate.getOutput(), cContext.getOutput()))
      return false;
続いて、cContextの前の状態とcX_AGCNの出力を、忘却マスクcForgetGateで重み付けし、要素ごとの乗算によって新しいコンテキストベクトルを生成します。 これにより、どのメモリ要素を保持し、どの要素をゼロにするかを柔軟に制御できます。
新しいコンテキストベクトルには、負の値を扱えるELU活性化関数を適用します。これにより、勾配の安定性が向上します。
//--- Output
   if(!Activation(cContext.getOutput(), cContext.getPrevOutput(), ELU))
      return false;
   if(!GateElementMult(cContext.getPrevOutput(), cX_IA.getOutput(), cResetGate.getOutput(), Output))
      return false;
//---
   return true;
  }
最後に、更新されたコンテキスト、cX_IAの結果テンソル、そしてcResetGateのマスクを要素ごとに乗算し、ブロックの最終出力をOutputバッファに生成します。 この処理では、長期メモリ、現在の入力状態、そして出力に関連性の高い特徴量を通す役割を持つリセットマスクを組み合わせます。
処理の途中でエラーや失敗が発生した場合、メソッドはfalse を返します。 すべての処理が正常に完了した場合はtrueを返し、セル全体を通じてデータが正しく処理されたことを示します。
誤差逆伝播アルゴリズムは、一見したほど単純ではありません。 特に難しいのは、複数の経路から得られる勾配を慎重に合算し、正規化する必要がある点です。入力データは、メイン経路であるcX_AGCNだけでなく、制御ゲートcForgetGateとcResetGateを通る補助経路でも複数回使用されます。 そのため、各経路の出力先は最終的な勾配にそれぞれ独自の寄与をもたらし、それらをすべて正しく統合する必要があります。
bool CNeuronGinARCell::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                          CBufferFloat *SecondInput,
                                          CBufferFloat *SecondGradient,
                                          ENUM_ACTIVATION SecondActivation = -1)
  {
   if(!NeuronOCL || !SecondInput || !SecondGradient)
      return false;
//--- Output
   if(!GateElementMultGrad(cContext.getPrevOutput(), cContext.getGradient(),
                           cX_IA.getOutput(), cX_IA.getPrevOutput(),
                           cResetGate.getOutput(), cResetGate.getGradient(),
                           Gradient, ELU, cX_IA.Activation(), GELU))
      return false;
まず、セルの最終出力に対する勾配を、コンテキストcContext、補間アテンションの結果cX_IA、リセットゲートcResetGateに分配します。 この処理では、それぞれに対応する活性化関数の導関数も考慮します。
次に、内部メモリ状態cContextの勾配を再構成します。 この状態は、メインの畳み込みモジュールcX_AGCNの出力と、cForgetGateのマスクとの乗算によって形成されます。そのため、同様の誤差逆伝播処理を適用します。 ここでは別の活性化関数と勾配が関係し、計算結果はcContextオブジェクトに蓄積されます。
//--- Context
   if(!GateElementMultGrad(cContext.getOutput(), cContext.getPrevOutput(),
                           cX_AGCN.getOutput(), cX_AGCN.getGradient(),
                           cForgetGate.getOutput(), cForgetGate.getGradient(),
                           cContext.getGradient(), None,
                           cX_AGCN.Activation(), GELU))
      return false;
次に、特に重要なステップとして、勾配を補間アテンションモジュールcX_IAに戻します。 このモジュールは3つの分岐すべてに共通する前段の処理を担っているため、各経路について個別にCalcHiddenGradientsを呼び出す必要があります。対象となるのは、メイン経路のcX_AGCN、忘却ゲートのcForgetGate、リセットゲートのcResetGateです。
//--- Gradient to Interpolation Attention
   if(!cX_IA.CalcHiddenGradients(cX_AGCN.AsObject(), SecondInput,
                                 SecondGradient, SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!cX_IA.CalcHiddenGradients(cForgetGate.AsObject(), SecondInput,
                                 GetPointer(bTemp), SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(SecondGradient, GetPointer(bTemp),
                       SecondGradient, cForgetGate.GetUnits(), false, 0, 0, 0, 1))
      return false;
   if(!cX_IA.CalcHiddenGradients(cResetGate.AsObject(), SecondInput,
                                 GetPointer(bTemp), SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(SecondGradient, GetPointer(bTemp), SecondGradient,
                       cForgetGate.GetUnits(), false, 0, 0, 0, 1))
      return false;
最初の呼び出しでは結果をSecondGradientに直接出力します。2回目と3回目の呼び出しでは結果をbTempに出力し、その後SecondGradientに加算します。これにより、すべての寄与が1つの出力経路に確実に集約されます。
最後に、cX_IAに関連付けられた元の入力データオブジェクトNeuronOCLに対して、隠れ勾配の計算を実行します。 これで誤差の伝播経路が完了し、入力データの変化が出力にどのような影響を与えるかという情報が、モデルの先頭まで正確に伝わります。
//---
   if(!NeuronOCL.CalcHiddenGradients(cX_IA.AsObject()))
      return false;
//---
   return true;
  }
このように、このメソッドは、すべての方向に対して勾配を順次集約し、重み付けしながら伝播させる仕組みを実装しています。 これにより、1つの出力が複数の計算経路に同時に影響するGinARのような複雑な多要素構造でも、適切な学習が可能になります。
このクラスの完全なコードとすべてのメソッドは、自己学習用の添付ファイルとして提供しています。 必要に応じて、順伝播から誤差逆伝播、重みの更新に至るまで、計算の流れ、コンポーネント間の依存関係、各段階でのデータの受け渡しを簡単に追跡できます。
ここまで、重要なコンポーネントのアーキテクチャ、メソッド、内部ロジックを一つずつ詳しく検討し、次のステップに向けた確かな基盤を築いてきました。 ここで少し休憩し、ひと息ついて、考えを整理しましょう。 次回の記事では、この議論を自然な形で締めくくります。理論から実践へと進み、市場データを使って、実装した手法が実際にどの程度の効果を発揮するのかを評価します。
結論
本記事では、GinARフレームワークを構成する主要コンポーネントのアーキテクチャを詳しく分析しました。 各構成要素の初期化処理を順を追って確認し、順伝播の実装について説明するとともに、誤差逆伝播アルゴリズムを詳しく見てきました。 特に、Attentionモジュール、グラフ畳み込み、制御ゲートがどのように相互作用するかに注目しました。これにより、柔軟性と表現力を備えた構造を実現できます。
このモジュール性は、規模の拡張を容易にするだけでなく、より複雑な制御ブロックを統合する道も開きます。たとえば、強化学習への応用や、変数間の依存関係を考慮する予測タスクへの対応が考えられます。
参考文献
- GinAR: An End-To-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム向けコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18892
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(GinAR)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:確率的時系列予測(最終回)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
非常に興味深い記事であり、GinAR実装シリーズの貴重な続編となっています。現在、私たちはアルゴリズム取引向けの、より広範な多段階機械学習研究フレームワークを開発中であり、特に「資産横断的なモデリングによって、従来の銘柄別モデルでは捉えきれない情報が得られるかどうか」という点を積極的に調査していることから、このアーキテクチャに強く関心を引かれました。
私たちのフレームワークは、市場データの収集、特徴量エンジニアリング、履歴データセットの構築、モデル研究、検証、候補生成、実行という各層を意図的に独立させて構成されています。 機械学習は、直接的な取引権限の源泉ではなく、証拠層 として扱われます。したがって、モデルがインサンプルで良好なパフォーマンスを示しているという理由だけで、下流の取引決定に影響を与えることは許されず、まずアウトオブサンプルの安定した増分価値を実証しなければなりません。
現在、当社はFX、金、米国株価指数、株式、エネルギー商品を網羅するマルチアセット・ユニバースを扱っています。履歴データは、「ブロンズ」→「シルバー」→「ゴールド」というパイプラインを通じて処理され、厳格な時点管理が行われています。意思決定時点で利用可能な情報は、ラベル付けや結果分析に使用される将来の情報とは分離して管理されます。
現在のゴールドのトレーニングデータセットには、観測値ごとに142のソース特徴量が 含まれており、そのうち129が数値特徴量、13がカテゴリカル特徴量です。特徴量セットには、ボラティリティ、トレンド、モメンタム、市場構造、ブレイク挙動、価格変動のコンテキスト、流動性条件、セッション状態、その他の決定論的な市場記述子が含まれます。
GinARのテストに先立ち、我々はすでにロジスティック回帰、XGBoost、LightGBM、CatBoostを用いた第2世代のモデルファミリーを構築していました。これらのモデルは、時系列ウォークフォワード検証、閾値スクリーニング、ブートストラップ安定性分析、キャリブレーションチェック、レジーム分析、および未処理のホールドアウト段階を用いて評価されました。
10の銘柄が、当社の「ディープ・バリデーションPASS」候補段階に到達しました:
GBPUSD、USDCHF、US500、US30、USDCAD、EURUSD、USDJPY、EURGBP、USTEC、XAUUSD。
これらが、GinAR実験の初期の研究対象群となりました。
GinARが私たちにとって特に興味深い点は、既存のモデルとは根本的に異なる要素を導入していることです。現在のGEN2モデルは主に銘柄ごとの分類器であるのに対し、GinARは複数の銘柄にわたる動的なクロスアセット関係や 潜在表現を 同時に学習する可能性を提供します。
金融市場においてこれは特に重要な意味を持ちます。なぜなら、金融商品は互いに独立していないからです。通貨、金、株価指数、その他の資産間の関係性は、市場環境、ボラティリティ、取引セッションの構造によって変化します。さらに、マルチアセットの取引対象範囲には、すべての金融商品が同時に有効な気配値やアクティブな取引セッションを持っているわけではない期間が必然的に存在します。
このため、我々は取引権限を持たず、既存の実行システムにも影響を与えない、完全に独立した「GinARリサーチ部門」を設立しました。
その目的は、本記事の実装を逐行再現することでも、既存のモデルを直ちに置き換えることでもありませんでした。むしろ、より限定的な研究課題に答えを出したいと考えたのです。
GinARスタイルのクロスアセット・グラフモデルは、既存の銘柄別GEN2モデルを超える、追加のアウト・オブ・サンプル情報を提供できるか?
したがって、当社の実装は、以下の主要なアーキテクチャのアイデアに基づいた、クリーンルーム方式で構築されたGinAR着想の研究モデルとなりました:
最初の実験では、Gold特徴量契約の共通の数値部分を使用し、モデルにノードあたり129個の数値特徴量 を与えました。
この実験で使用したターゲットは、240分間のWHIPSAW分類問題 でした。
ラベルの整合性は、重要な方法論上の課題であることが判明した。我々の過去のラベルには以下が含まれている:
WHIPSAW
NO_WHIPSAW
AMBIGUOUS_FIRST_MOVE
、また場合によっては INCOMPLETE も含まれています。
「AMBIGUOUS_FIRST_MOVE」は、同じM1小節内で両方のファーストムーブ・バリアが検出された場合に発生し、これは利用可能なソースデータからは実際の小節内順序を特定できないことを意味する。
そこで、我々は明示的な以下の処理を採用した:
AMBIGUOUS_DO_NOT_GUESS
というポリシーを採用しました。
バイナリ・ターゲット・コントラクトは次のようになりました:
WHIPSAW = 1
NO_WHIPSAW = 0
一方、AMBIGUOUS_FIRST_MOVE および INCOMPLETE は、いずれかのクラスに強制的に分類されるのではなく、二値損失および評価指標から除外されました。
この点は私たちにとって重要でした。なぜなら、曖昧な結果を2つのクラスのいずれかに変換すると、人為的なラベルノイズが生じるからです。
また、厳格な先読み防止対策も講じました。
検証プロトコルは以下の通りでした:
180日間のトレーニング
30日間の検証
60日間のウォークフォワードステップ
240分のパージ/ギャップ
60日間の最終未処理ホールドアウト
初期のGinAR実験中、最終ホールドアウトデータは封印されたままでした。
意図的に、ランダムなトレーニング/テストの分割は避けた。
もう 1 つの重要な点は、欠落変数に関するものです。GinAR の「補間アテンション」は、取引セッションの違いにより、一時的に金融商品が入手できない場合のあるマルチアセット取引環境において、非常に有用である可能性があります。
しかし、我々はモデルを用いて過去の観測値を生成することはしなかった。
元のデータセットにおいて欠落していたソース観測値はそのまま欠落したままであり、マスクによって明示的に表現された。内部補間は、ニューラル表現の一部としてのみ使用された。再構築された値は、Goldデータセットには書き戻されなかった。
その後、6つの時系列ウォークフォワード・フォールド にわたってGinAR研究モデルを学習させた。
有効なターゲット観測値の数は多く、各フォールド間で比較的安定していた。その結果得られたOOF評価では、約114,558件のフォールド外予測が 生成された。
6つのフォールドにおけるPR-AUC値は以下の通りでした:
フォールド1:0.6894
フォールド2:0.6910
フォールド 3: 0.6833
フォールド4:0.6866
フォールド5:0.6584
第6期:0.6999
ほとんどのフォールドは比較的安定していましたが、フォールド5は著しく性能が低下していました。この期間は、後のレジームやグラフ構造の分析において特に興味深いものだと考えています。
次のステップは、私たちが最も重要だと考えた部分、すなわち既存のGEN2チャンピオンモデルとの直接比較でした。
GinARのOOF予測を、同じ銘柄/タイムスタンプの交点における対応するGEN2の予測と照合しました。
この比較には、90,122件のマッチしたアウト・オブ・フォールド観測値 が含まれていました。
結果は以下の通りでした:
Delta PR-AUC:-0.0161
デルタ LogLoss:+0.0059
PR-AUCが高いほど、LogLossが低いほど望ましいため、今回の結果は明らかに既存のGEN2モデルの方が優れていることを示しています。
言い換えれば、最初の実験において、GinARは単独のWHIPSAW分類器として、既存のロジスティック回帰/XGBoost/LightGBM/CatBoostモデル群の性能を上回ることはできませんでした。
したがって、我々はGinARをGEN2の代替として推奨しなかった。
しかし、この結果によって、GinAR が金融アプリケーションにとって興味をそそらないものになったとは思いません。
実際、この実験結果は、このアーキテクチャの最も価値のある部分は、必ずしも最終的なスタンドアロンの分類器ではないことを示唆しているかもしれません。
GinARは、シンボルごとの独立したモデルには本来備わっていない、資産横断的な潜在表現 を生成します。
このため、我々は GinAR を研究用エンコーダーとして維持し、次の研究課題を「
「GinARはGEN2に取って代わることができるか?」
から、
「GinARはGEN2を補完するクロスアセット情報を提供できるか?」
したがって、次に計画している実験は以下の通りです:
GEN2ベースライン
対
GEN2 + GinARによるクロスアセット埋め込み
を比較し、フォールドセーフなスタッキング、確率的不一致分析、レジーム分析、グラフ安定性分析、およびアブレーションテストを実施します。
特に、GEN2のチャンピオンモデルが誤りである一方でGinARが正しいケース、およびその逆のケースを検証することに重点を置いています。これらの誤りセットが十分に異なっていれば、GinARの単独でのPR-AUCが低くても、追加の特徴量層として有用である可能性があります。
また、学習された隣接行列が時間経過とともに安定しているか、あるいは異なるボラティリティや市場レジームにおいて金融商品間の関係性が実質的に変化するかどうかについても検証する予定である。
この点において、グラフベースのモデルはトレーディングシステムにおいて特に有用になると我々は考えています。
例えば、次のような関係の重要性が挙げられます:
金 ↔ 米ドル、
FX ↔ 米国株価指数、
USDCAD ↔ エネルギー、
あるいはUSTEC ↔ 大型ハイテク株
といった相関関係が、必ずしも時間の経過とともに一定であり続けるとは限らない。
これらの関係を動的に学習できるモデルは、たとえその直接的な分類ヘッドが単独では最強の予測因子でなかったとしても、貴重な文脈情報を提供し得る。
また、我々の実験から得られた方法論的な教訓として、トレーニング損失や単一のバックテストのみに基づいて新しいニューラルネットワークのアーキテクチャを評価してしまうことは非常に容易であるという点も言及する価値がある。同じアウトオブフォールドの観測値を用いて既存のベンチマークと比較した結果、モデルの解釈が変化した。
私たちにとって、この種の比較は不可欠です。
新しいモデルは、単に妥当な指標を生成するという理由だけで有用であると見なされるべきではありません。そのモデルは、以下のいずれかを実証しなければなりません:
したがって、現段階での我々の結論は以下の通りである:
GinARは現時点では、我々のGEN2モデルよりも優れたスタンドアロン分類器とは言えないが、クロスアセット表現および特徴生成層としては依然として有望な候補である。
モデル開発の意思決定においてホールドアウトセットを繰り返し使用することを避けるため、次の研究段階が定義されるまで、意図的に最終的な未処理のホールドアウトセットを非公開にしてきました。
著者が今後行う実市場データを用いた実験、特に以下の点について非常に興味があります:
このシリーズを公開していただき、ありがとうございます。これは、多変量グラフベース学習を金融時系列に適用する上で、私たちがこれまでに出会った中でも特に興味深い方向性のひとつです。
私たちの最初の独立した比較では、GEN2に対して単独での優位性は示されませんでしたが、この実験は、GinARを単なる別の分類器としてではなく、クロスアセット・インテリジェンス層として 活用するという、私たちにとって新しく、かつより有用な可能性を秘めた研究の方向性を切り開いてくれました。
次回の記事を楽しみにしております。また、私たちの知見と著者の市場データに基づく結果を比較できることを大変楽しみにしています。