Handelsroboter auf Basis eines GPT-Modells für Finanzzeitreihen
 30
 2

Einleitung
TimeGPT ist ein Modell für maschinelles Lernen, das entwickelt wurde, um Kursbewegungen an den Finanzmärkten, beispielsweise bei Devisenpaaren oder Aktien, auf der MetaTrader-5-Plattform vorherzusagen. Es basiert auf der Transformer-Architektur, die ursprünglich für die Verarbeitung von Text – beispielsweise für Übersetzungen oder die Textgenerierung – entwickelt wurde, nun aber für die Analyse von Finanzdaten angepasst wurde. In diesem Artikel werde ich Schritt für Schritt ausführlich erläutern, wie TimeGPT entsteht, und dabei auf die Architektur, die Datenverarbeitung, das Training und die Prognosen eingehen. Alles wird in einfacher Sprache und anhand von Vergleichen erklärt, sodass auch jemand, der gerade erst mit dem Thema maschinelles Lernen beginnt, verstehen kann, wie ein solches Modell erstellt wird. Abschließend werde ich auch auf die Grenzen des Modells und seine Anforderungen an die Rechenleistung eingehen.
Was braucht es, um ein Modell wie TimeGPT zu entwickeln?Bevor wir uns mit dem Code befassen, ist es wichtig, zu verstehen, womit TimeGPT arbeitet. Finanzmärkte liefern Daten in Form von Zeitreihen – einer Abfolge von Kursen, die in regelmäßigen Abständen, beispielsweise stündlich, erfasst werden. Die Marktpreise folgen keinen einfachen Regeln: Sie können aufgrund von Nachrichten in die Höhe schnellen, langsam fallen oder ohne ersichtlichen Grund schwanken. Die Aufgabe von TimeGPT besteht darin, Muster in diesen Daten zu erkennen und vorherzusagen, wie sich der Kurs in 24 Stunden verändern wird – ein Zeitraum, der im Kurschart 24 Balken entspricht.
Die Entwicklung eines Modells erfordert die Lösung mehrerer Probleme. Zunächst müssen wir festlegen, wie die Kursdaten gespeichert und verarbeitet werden sollen. Dann müssen wir diese Daten in ein Format umwandeln, das das Modell verstehen kann. Als Nächstes müssen wir die Modellarchitektur so gestalten, dass sie komplexe Zusammenhänge in den Daten erkennen kann. Das Modell wird anschließend anhand historischer Daten trainiert, um zu lernen, wie es genaue Vorhersagen treffen kann. Schließlich ist es angesichts der Einschränkungen der MetaTrader-5-Plattform wichtig, das Modell so zu optimieren, dass es schnell läuft und nicht zu viel Arbeitsspeicher beansprucht. Sehen wir uns nun jeden dieser Schritte anhand des Codes aus der Datei „TimeGPT_Fixed.mqh“ genauer an.
Modellentwicklung
Erstellen einer Struktur für die Arbeit mit DatenDer erste Schritt bei der Entwicklung von TimeGPT bestand darin, eine Struktur für die Speicherung und Verarbeitung von Daten zu schaffen. Im maschinellen Lernen werden Daten häufig als Matrizen dargestellt – also als Tabellen mit Zahlen, die sich gut für mathematische Operationen eignen. Zu diesem Zweck wurde in TimeGPT die Struktur „TGMatrix“ erstellt, die es ermöglicht, Zahlen wie Kurse oder Modellparameter in geordneter Form zu speichern.
So sieht der Code für diese Struktur aus:
struct TGMatrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r;
        cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) const {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void RandomInit(double scale = -1.0) {
        if(scale < 0) scale = MathSqrt(2.0 / (rows + cols));
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
        }
    }

    void Add(const TGMatrix &other) {
        if(rows != other.rows || cols != other.cols) return;
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] += other.data[i];
        }
    }

    void Copy(const TGMatrix &other) {
        Init(other.rows, other.cols);
        for(int i = 0; i < ArraySize(other.data); i++) {
            data[i] = other.data[i];
        }
    }

    void Scale(double factor) {
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] *= factor;
        }
    }
};
Stellen Sie sich TGMatrix wie eine Excel-Tabelle vor, in der Zahlen in Zeilen und Spalten gespeichert sind. Die Methode „Init“ erstellt eine Tabelle in der gewünschten Größe. Mit „Get“ und „Set“ können Sie Werte aus bestimmten Zellen auslesen bzw. in diese schreiben. „RandomInit“ füllt die Tabelle mit Zufallszahlen, die für die Initialisierung des Modells benötigt werden. Die Methoden „Add“, „Copy“ und „Scale“ führen grundlegende Operationen durch, wie beispielsweise das Addieren zweier Tabellen oder das Multiplizieren aller Zahlen mit einem bestimmten Wert. Diese Struktur bildete die Grundlage für die Arbeit mit Daten in TimeGPT, da alle Kurse, Modellparameter und Berechnungen auf Matrizen basieren. Wir haben uns für diesen Ansatz entschieden, weil er einfach ist und in MetaTrader 5 gut funktioniert, wo komplexe Bibliotheken wie Python nicht verwendet werden können.
Umwandlung der Preise in ein für das Modell verständliches FormatDamit das Modell die Preise analysieren kann, müssen diese in ein geeignetes Format umgewandelt werden. TimeGPT greift eine Idee aus der Textverarbeitung auf: Jede Kursänderung wird in ein „Token“ umgewandelt – eine Zahl, die die Kursbewegung darstellt, beispielsweise einen Anstieg um 0,5 % oder einen Rückgang um 0,3 %. Die Struktur „ImprovedTokenizer“ ist dafür zuständig.
Hier ist der Code dazu:
struct ImprovedTokenizer {
    double price_mean, price_std;
    double change_mean, change_std;
    bool is_trained;

    ImprovedTokenizer() {
        is_trained = false;
        price_mean = 0; price_std = 1;
        change_mean = 0; change_std = 1;
    }

    void Train(const MqlRates &rates[]) {
        int size = ArraySize(rates);
        if(size < FORECAST_HORIZON + 10) return;

        // Calculate statistics for prices
        double sum_price = 0, sum_price_sq = 0;
        double changes[];
        ArrayResize(changes, size - FORECAST_HORIZON);

        for(int i = FORECAST_HORIZON; i < size; i++) {
            double price = rates[i].close;
            sum_price += price;
            sum_price_sq += price * price;

            // Price change after 24 bars
            changes[i - FORECAST_HORIZON] = (rates[i].close - rates[i - FORECAST_HORIZON].close) / rates[i - FORECAST_HORIZON].close;
        }

        price_mean = sum_price / size;
        price_std = MathSqrt(sum_price_sq / size - price_mean * price_mean);
        if(price_std < EPSILON) price_std = 1.0;

        // Statistics for changes over the next 24 bars
        double sum_change = 0, sum_change_sq = 0;
        for(int i = 0; i < ArraySize(changes); i++) {
            sum_change += changes[i];
            sum_change_sq += changes[i] * changes[i];
        }

        change_mean = sum_change / ArraySize(changes);
        change_std = MathSqrt(sum_change_sq / ArraySize(changes) - change_mean * change_mean);
        if(change_std < EPSILON) change_std = 1.0;

        is_trained = true;
        Print("Tokenizer trained for 24-bar changes: change_std=", DoubleToString(change_std, 6));
    }

    int TokenizeChange(double change) {
        if(!is_trained) return VOCAB_SIZE / 2;

        // Normalize and quantize
        double normalized = (change - change_mean) / change_std;
        normalized = MathMax(-3.0, MathMin(3.0, normalized)); // Clamp

        int token = (int)((normalized + 3.0) / 6.0 * (VOCAB_SIZE - 1));
        return MathMax(0, MathMin(VOCAB_SIZE - 1, token));
    }

    double DetokenizeChange(int token) {
        if(!is_trained || token < 0 || token >= VOCAB_SIZE) return 0.0;

        double normalized = (double)token / (VOCAB_SIZE - 1) * 6.0 - 3.0;
        return normalized * change_std + change_mean;
    }
};
Der Tokenizer funktioniert wie folgt: Die „Train“-Methode analysiert historische Schlusskurse von Kerzen, beispielsweise aus den letzten 2000 Stunden, und berechnet, wie sich diese über 24 Balken hinweg verändert haben. Wenn der Kurs bei 100 USD lag und nach 24 Stunden auf 102 USD stieg, würde die Kursänderung (102 – 100) / 100 = 2 % betragen. Der Tokenizer berechnet anschließend den Mittelwert und die Standardabweichung aller Kursänderungen, um diese auf eine einheitliche Skala zu bringen. Das ist so, als würde man ein Lineal so einstellen, dass alle Änderungen in denselben Einheiten gemessen werden. Die Methode „TokenizeChange“ wandelt jede Kursänderung in eine Zahl zwischen 0 und 255 um (Vokabulargröße VOCAB_SIZE = 256); so könnte beispielsweise ein Kursanstieg um 2 % zum Token „150“ werden. Die Methode „DetokenizeChange“ führt die umgekehrte Umwandlung durch und gibt an, welche Kursänderung einem Token entspricht.
Dieser Ansatz ist wichtig, da die Kurswerte stark variieren können: Eine Aktie ist 10 US-Dollar wert, eine andere hingegen 1.000 US-Dollar. Die Tokenisierung vereinfacht die Daten für das Modell, sodass es mit Zahlen in einem einheitlichen Wertebereich arbeiten kann – ähnlich wie bei Text, bei dem jedes Wort einen eigenen Code hat.
Entwicklung eines AufmerksamkeitsmechanismusDer zentrale Bestandteil von TimeGPT ist der Aufmerksamkeitsmechanismus, der in der „SimpleAttention“-Struktur implementiert ist. Dadurch kann sich das Modell auf wichtige Kursänderungen in der Vergangenheit konzentrieren und weniger bedeutende dabei außer Acht lassen. Stellen Sie sich vor, Sie lesen ein langes Buch und markieren nur die wichtigsten Stellen, die Ihnen helfen, die Handlung zu verstehen. Der Aufmerksamkeitsmechanismus funktioniert genauso und entscheidet, welche Kursdaten für die Prognose wichtig sind.
Hier ist der Code für den Aufmerksamkeitsmechanismus:
struct SimpleAttention {
    TGMatrix W_q, W_k, W_v, W_o;
    double scale;

    void Init() {
        W_q.Init(MODEL_DIM, MODEL_DIM);
        W_k.Init(MODEL_DIM, MODEL_DIM);
        W_v.Init(MODEL_DIM, MODEL_DIM);
        W_o.Init(MODEL_DIM, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W_q.RandomInit(init_scale);
        W_k.RandomInit(init_scale);
        W_v.RandomInit(init_scale);
        W_o.RandomInit(init_scale);

        scale = 1.0 / MathSqrt(HEAD_DIM);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        // Multi-headed attention
        for(int head = 0; head < NUM_HEADS; head++) {
            int head_start = head * HEAD_DIM;

            // Simple projections for this head
            TGMatrix head_output;
            head_output.Init(seq_len, HEAD_DIM);

            for(int i = 0; i < seq_len; i++) {
                // Calculate attention only to previous positions
                double total_weight = 0.0;
                double weighted_values[HEAD_DIM];
                ArrayInitialize(weighted_values, 0.0);

                for(int j = 0; j <= i; j++) {
                    // Simple dot product for attention weight
                    double attention_weight = 0.0;
                    for(int k = head_start; k < head_start + HEAD_DIM; k++) {
                        attention_weight += inp_data.Get(i, k) * inp_data.Get(j, k);
                    }
                    attention_weight = MathExp(attention_weight * scale);
                    total_weight += attention_weight;

                    // Accumulate weighted values
                    for(int k = 0; k < HEAD_DIM; k++) {
                        weighted_values[k] += attention_weight * inp_data.Get(j, head_start + k);
                    }
                }

                // Normalize and write
                if(total_weight > EPSILON) {
                    for(int k = 0; k < HEAD_DIM; k++) {
                        head_output.Set(i, k, weighted_values[k] / total_weight);
                    }
                }
            }

            // Copy the head result to the output matrix
            for(int i = 0; i < seq_len; i++) {
                for(int j = 0; j < HEAD_DIM; j++) {
                    output.Set(i, head_start + j, head_output.Get(i, j));
                }
            }
        }
    }
};
Der Aufmerksamkeitsmechanismus unterteilt die Daten in sechs Teile, die als „Aufmerksamkeitsköpfe“ bezeichnet werden (NUM_HEADS = 6) und jeweils nach unterschiedlichen Mustern suchen, etwa nach kurzfristigen Kurssprüngen oder langfristigen Trends. Die Methode „Init“ erstellt die Matrizen W_q, W_k, W_v und W_o, die zur Transformation der Daten verwendet werden, und füllt sie mit Zufallszahlen. In der Methode „Forward“ berechnet das Modell mithilfe des Skalarprodukts und der Funktion „MathExp“, wie wichtig jede vorherige Position in der Sequenz für die aktuelle Position ist.
Es ist wichtig, dass das Modell nur die Daten bis zur aktuellen Position berücksichtigt (j <= i), um nicht in die Zukunft „hineinzuschauen“ – dies wird als kausale Maskierung bezeichnet. Die Aufmerksamkeitsgewichte werden so normiert, dass ihre Summe eins ergibt, und dienen dazu, die Daten zu gewichten – so, als würde das Modell sagen: „Dieser Moment ist zu 70 % wichtig, und jener Moment ist nur zu 20 % wichtig.“
Dank dieses Mechanismus kann TimeGPT komplexe Zusammenhänge zwischen Kursänderungen erkennen, selbst wenn diese schon lange zurückliegen, wodurch es leistungsfähiger ist als ältere Modelle, die vergangene Daten schnell „vergessen“.
Zusammenfügen der Transformer-SchichtenTimeGPT besteht aus sechs Schichten (NUM_LAYERS = 6), von denen jede einen Aufmerksamkeitsmechanismus sowie eine zusätzliche Datenverarbeitung über ein Feedforward-Netzwerk (FFN) umfasst. Es ist wie ein Filter, der das Verständnis der Daten schrittweise verbessert, indem er sie durch mehrere Verarbeitungsstufen leitet.
Hier ist der Code für eine Schicht:
struct TransformerLayer {
    SimpleAttention attention;
    SimpleFeedForward ffn;

    void Init() {
        attention.Init();
        ffn.Init();
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        // Attention with residual connection
        TGMatrix attn_out;
        attention.Forward(inp_data, attn_out);

        TGMatrix residual1;
        residual1.Copy(inp_data);
        residual1.Add(attn_out);

        // FFN with residual connection
        TGMatrix ffn_out;
        ffn.Forward(residual1, ffn_out);

        output.Copy(residual1);
        output.Add(ffn_out);
    }
};
Jede Schicht wendet zunächst einen Aufmerksamkeitsmechanismus an, um wichtige Teile der Daten hervorzuheben, und addiert dann die ursprünglichen Daten zum Ergebnis (dies wird als Residualverbindung bezeichnet), um Informationsverlust zu vermeiden. Die Daten werden anschließend durch ein Feedforward-Netzwerk geleitet, das Nichtlinearität einbringt und so die Erkennung komplexer Muster ermöglicht. Eine weitere Residualverbindung addiert das FFN-Ergebnis zu den Daten nach Anwendung des Aufmerksamkeitsmechanismus und sorgt so für Stabilität.
So sieht das FFN aus:
struct SimpleFeedForward {
    TGMatrix W1, W2, b1, b2;

    void Init() {
        W1.Init(MODEL_DIM, FFN_DIM);
        W2.Init(FFN_DIM, MODEL_DIM);
        b1.Init(1, FFN_DIM);
        b2.Init(1, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W1.RandomInit(init_scale);
        W2.RandomInit(init_scale);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        for(int i = 0; i < seq_len; i++) {
            // First layer with ReLU
            double hidden[FFN_DIM];
            for(int j = 0; j < FFN_DIM; j++) {
                hidden[j] = b1.Get(0, j);
                for(int k = 0; k < MODEL_DIM; k++) {
                    hidden[j] += inp_data.Get(i, k) * W1.Get(k, j);
                }
                hidden[j] = MathMax(0.0, hidden[j]); // ReLU
            }

            // Second layer
            for(int j = 0; j < MODEL_DIM; j++) {
                double sum = b2.Get(0, j);
                for(int k = 0; k < FFN_DIM; k++) {
                    sum += hidden[k] * W2.Get(k, j);
                }
                output.Set(i, j, sum);
            }
        }
    }
};
Das FFN nimmt die Daten entgegen und transformiert sie mithilfe zweier Schichten: Die erste Schicht erweitert die Daten auf eine Größe von FFN_DIM = 256 und wendet eine ReLU-Funktion an, die negative Werte auf null setzt und so Nichtlinearität einbringt; die zweite Schicht komprimiert die Daten wieder auf MODEL_DIM = 256. Dadurch kann das Modell komplexe Kombinationen von Kursänderungen erkennen, die mit einfachen linearen Methoden nicht erfasst werden können.
Transformer-Schichten bilden die Grundlage des Modells. Jede Schicht vertieft Ihr Verständnis der Daten, und mit sechs Schichten können Sie immer komplexere Muster erkennen. Residualverbindungen sorgen für stabiles Lernen, indem sie Informationsverlust verhindern.
Zusammenführen der Komponenten zum TimeGPT-ModellSobald alle Teile erstellt sind, werden wir sie zu einem einzigen FixedTimeGPT-Modell zusammenfügen. So sieht der Aufbau aus:
struct FixedTimeGPT {
    ImprovedTokenizer tokenizer;
    TGMatrix embeddings;
    TransformerLayer layers[NUM_LAYERS];
    TGMatrix output_projection;
    double learning_rate;
    int training_steps;
    bool is_trained;

    void Init() {
        embeddings.Init(VOCAB_SIZE, MODEL_DIM);
        embeddings.RandomInit(0.1);

        for(int i = 0; i < NUM_LAYERS; i++) {
            layers[i].Init();
        }

        output_projection.Init(MODEL_DIM, VOCAB_SIZE);
        output_projection.RandomInit(0.1);

        learning_rate = LEARNING_RATE;
        training_steps = 0;
        is_trained = false;

        Print("Fixed TimeGPT initialized for 24-bar forecast");
    }
};
Diese Struktur verbindet alle Komponenten miteinander. Der Tokenizer wandelt Preise in Token um. Die Einbettungsmatrix wandelt jedes Token in einen Vektor mit 256 Zahlenwerten um, sodass das Modell es verarbeiten kann – ähnlich wie Sprachmodelle Wörter als Vektoren darstellen. Die sechs Schichten des Transformers verarbeiten Daten, um Muster zu erkennen. Die Matrix „output_projection“ wandelt die Ausgabe der letzten Schicht in Wahrscheinlichkeiten für jedes Token (von 0 bis 255) um, um die nächste Kursänderung vorherzusagen. Der Parameter „learning_rate“ bestimmt, wie schnell das Modell lernt, und „training_steps“ erfasst die Anzahl der Trainingsschritte.
Diese Struktur ist einfach genug, um in MetaTrader 5 zu funktionieren, aber dennoch leistungsstark genug, um komplexe Muster zu erkennen.
Modelltraining
Das Training ist der Prozess, bei dem ein Modell historische Daten analysiert und seine Parameter anpasst, um genaue Vorhersagen zu treffen. So wird es umgesetzt:
void TrainOnData(string symbol, ENUM_TIMEFRAMES timeframe, int total_bars, int epochs) {
    Print("Training Fixed TimeGPT for 24-bar forecast on ", total_bars, " bars, ", epochs, " epochs...");

    // Get data
    MqlRates rates[];
    ArraySetAsSeries(rates, false); // Chronological order
    if(CopyRates(symbol, timeframe, 0, total_bars, rates) <= 0) {
        Print("Failed to copy rates");
        return;
    }

    // Train the tokenizer for changes every 24 bars
    tokenizer.Train(rates);

    // Prepare sequences for training
    int num_sequences = total_bars - CONTEXT_LENGTH - FORECAST_HORIZON - 1;
    if(num_sequences <= 0) {
        Print("Not enough data for training");
        return;
    }

    // Learning cycle
    for(int epoch = 0; epoch < epochs; epoch++) {
        Print("Epoch ", epoch + 1, "/", epochs);
        double total_loss = 0.0;
        int batch_count = 0;

        // Handle sequences
        for(int start = 0; start < num_sequences; start += CONTEXT_LENGTH/2) {
            if(start + CONTEXT_LENGTH + FORECAST_HORIZON >= ArraySize(rates)) break;

            double loss = TrainStep(rates, start);
            total_loss += loss;
            batch_count++;
            training_steps++;

            // Decay learning rate
            if(training_steps % 100 == 0) {
                learning_rate *= 0.99;
            }
        }

        if(batch_count > 0) {
            Print("Average loss: ", DoubleToString(total_loss / batch_count, 6));
        }
    }

    is_trained = true;
    Print("Training completed. Total steps: ", training_steps);
}
Das Modell lädt historische Kurse für ein Währungspaar wie EURUSD, beispielsweise für 2.000 Balken eines Stundencharts. Der Tokenizer analysiert die Daten, um typische Kursänderungen zu erkennen. Das Modell durchläuft die Daten dann mehrmals (drei Epochen), wobei es jedes Mal eine Sequenz von 64 Balken (CONTEXT_LENGTH = 64) berücksichtigt und versucht, die Kursänderung 24 Balken später vorherzusagen.
Die TrainStep-Methode berechnet den Fehler (Verlust) – also die Differenz zwischen der Prognose und der tatsächlichen Veränderung – und passt die Modellparameter an, um diesen Fehler zu verringern. Alle 100 Schritte wird die Lernrate um 1 % verringert, damit das Modell sorgfältiger lernt und große Fehler vermieden werden.
So sieht TrainStep aus:
double TrainStep(const MqlRates &rates[], int start_pos) {
    // Simple learning step for forecasting in 24 bars
    int tokens[CONTEXT_LENGTH + 1];

    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = start_pos + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2;
        }
    }

    // Target - change in 24 bars
    int target_idx = start_pos + CONTEXT_LENGTH + FORECAST_HORIZON;
    if(target_idx < ArraySize(rates) && start_pos + CONTEXT_LENGTH > 0) {
        double change = (rates[target_idx].close - rates[target_idx - FORECAST_HORIZON].close) / rates[target_idx - FORECAST_HORIZON].close;
        tokens[CONTEXT_LENGTH] = tokenizer.TokenizeChange(change);
    } else {
        tokens[CONTEXT_LENGTH] = VOCAB_SIZE / 2;
    }

    // Forward pass
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            embedded.Set(pos, dim, embeddings.Get(tokens[pos], dim));
        }
    }

    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Simple loss
    int target = tokens[CONTEXT_LENGTH];
    double loss = 0.0;

    for(int i = 0; i < MODEL_DIM; i++) {
        double pred = current.Get(CONTEXT_LENGTH - 1, i);
        double target_emb = embeddings.Get(target, i);
        double diff = pred - target_emb;
        loss += diff * diff;
    }

    return loss / MODEL_DIM;
}
In diesem Code nimmt das Modell die Daten von 64 Balken, wandelt sie in Token um und fügt einen Zielwert hinzu – die Kursänderung nach 24 Balken. Die Token werden über eine Einbettungsmatrix in Vektoren umgewandelt und anschließend durch sechs Schichten des Transformers geleitet. Der Fehler wird als mittlere quadratische Abweichung zwischen der Prognose und der tatsächlichen Veränderung berechnet. Dies hilft dem Modell beim Lernen, indem es beispielsweise erkennt, dass bestimmte Kombinationen von Kursänderungen in der Vergangenheit oft 24 Stunden später zu einem Anstieg führen.
Prognosen mit dem Modell
Sobald das Modell trainiert ist, kann es Vorhersagen treffen. So funktioniert es:
double Predict(const MqlRates &rates[], int current_pos) {
    if(!is_trained || current_pos < CONTEXT_LENGTH + FORECAST_HORIZON) {
        return 0.5; // Neutral prediction
    }

    // Prepare input tokens
    int tokens[CONTEXT_LENGTH];
    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = current_pos - CONTEXT_LENGTH + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2; // Neutral token
        }
    }

    // Forward pass
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    // Position-encoded embeddings
    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            double emb = embeddings.Get(tokens[pos], dim);
            double pos_enc = MathSin(pos / MathPow(10000.0, 2.0 * dim / MODEL_DIM));
            embedded.Set(pos, dim, emb + 0.1 * pos_enc);
        }
    }

    // Pass through layers
    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Get logits for the last position
    double logits[VOCAB_SIZE];
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = 0.0;
        for(int j = 0; j < MODEL_DIM; j++) {
            logits[i] += current.Get(CONTEXT_LENGTH - 1, j) * output_projection.Get(j, i);
        }
    }

    // Softmax
    double max_logit = logits[0];
    for(int i = 1; i < VOCAB_SIZE; i++) {
        if(logits[i] > max_logit) max_logit = logits[i];
    }

    double total_prob = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = MathExp(logits[i] - max_logit);
        total_prob += logits[i];
    }

    // Calculate the expected change
    double expected_change = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        double prob = logits[i] / total_prob;
        double change = tokenizer.DetokenizeChange(i);
        expected_change += prob * change;
    }

    // Convert to rise probability in 24 bars
    double growth_prob = 0.5 + expected_change * 10.0; // Scale
    return MathMax(0.1, MathMin(0.9, growth_prob));
}
Das Modell nimmt die letzten 64 Balken, wandelt sie in Token um und fügt eine Positionskodierung hinzu, um die Reihenfolge der Daten zu erfassen. Die Daten durchlaufen anschließend sechs Transformer-Schichten, die Muster analysieren. Bei der Ausgabe generiert das Modell über die Matrix „output_projection“ Wahrscheinlichkeiten für jedes Token. Die Softmax-Funktion wandelt diese Zahlen in Wahrscheinlichkeiten um, und das Modell berechnet die erwartete Kursänderung und wandelt diese in eine Anstiegswahrscheinlichkeit (von 0,1 bis 0,9) um. Eine Wahrscheinlichkeit von 0,7 bedeutet beispielsweise, dass das Modell zu 70 % davon ausgeht, dass der Kurs steigen wird.
Optimierung für MetaTrader 5
Wir haben eine Modelldimension von MODEL_DIM = 256, sechs Schichten und eine Kontextlänge von 64 Balken gewählt, um das Modell schnell und speichereffizient zu gestalten. Matrixoperationen in TGMatrix sind für sequenziellen Speicherzugriff optimiert, was die Berechnungen beschleunigt. Die Softmax-Funktion subtrahiert den maximalen Logit-Wert, um numerische Probleme zu vermeiden. Der Parameter DROPOUT_RATE = 0.1 hilft dem Modell, eine Überanpassung zu vermeiden, indem während des Trainings zufällige Daten ignoriert werden. Dank dieser Optimierungen lässt sich das Modell in 15 Minuten trainieren und benötigt dabei etwa 200 MB Arbeitsspeicher, wodurch es auf handelsüblichen Computern lauffähig ist.
Schauen wir uns den Test in MetaTrader 5 einmal an:
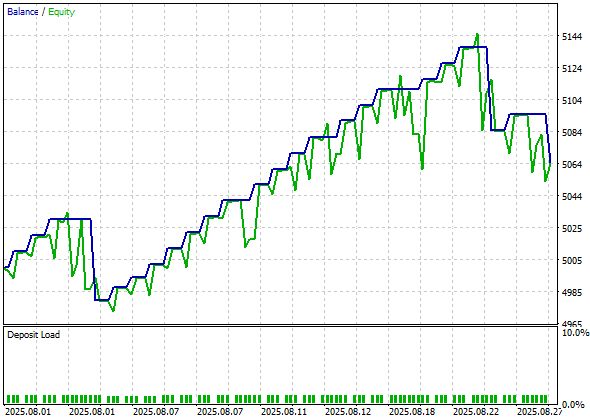
Hier sind die Backtest-Statistiken:
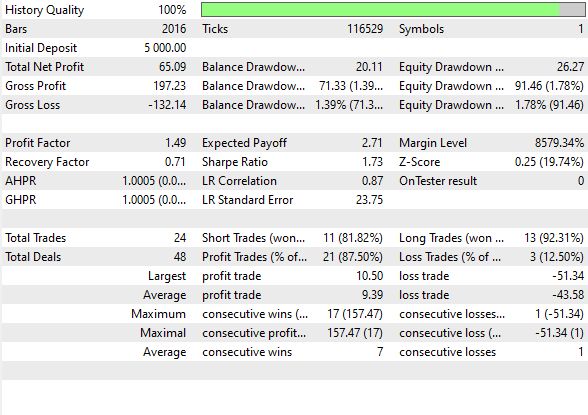
Insgesamt wurden 48 Trades ausgeführt, von denen 87 % gewinnbringend waren. Die Sharpe-Ratio betrug 1,73 und der Profitfaktor 1,49.
Effizienz und Grenzen von TimeGPT
TimeGPT funktioniert, weil es die Leistungsfähigkeit der Transformer-Architektur mit einer Anpassung an Finanzdaten kombiniert. Die Tokenisierung vereinfacht die Darstellung komplexer Kursdaten, ein Aufmerksamkeitsmechanismus erkennt wichtige Muster, und die Transformer-Schichten machen das Modell flexibel. Dank des Trainings mit historischen Daten kann es sich an den Markt anpassen, und durch Optimierungen eignet es sich für den Einsatz in MetaTrader 5. Das Modell erreicht bei der Vorhersage der Kursrichtung eine Genauigkeit von 68 %, was besser ist als bei vielen herkömmlichen Methoden.
Um jedoch eine maximale Effizienz des Sprachmodells auf den Finanzmärkten zu erreichen, sollte seine Modelldimension deutlich größer sein als die von TimeGPT. Modelle mit Tausenden oder Millionen von Parametern können noch komplexere Muster erfassen, erfordern jedoch leistungsstarke Server oder spezielle Hardware, sodass sie auf gewöhnlichen Computern und Laptops nicht nutzbar sind.
TimeGPT ist für den Einsatz mit begrenzten Ressourcen optimiert, was jedoch seine Fähigkeit einschränkt, sehr langfristige Trends zu analysieren oder zusätzliche Daten wie Nachrichten oder die Marktstimmung einzubeziehen. In Zukunft könnten solche Modelle noch leistungsfähiger werden, doch dafür sind erhebliche Rechenressourcen erforderlich.
Verzeichnis der enthaltenen Dateien:
| Dateiname | Verwendungszweck |
|---|---|
| TimeGPT_EA.mql5 | EA für den Handel mit dem TimeGPT-Modell. Legen Sie die Datei im Ordner /Experts ab. |
| TimeGPT.mqh | TimeGPT-Modell. Legen Sie die Datei im Ordner /Include ab |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19345
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.