

機械学習を活用したマルチスレッド自動売買ロボット:構想から実装まで
 20
 1

このプロジェクトは、私が以前作成したコードの一つを復活させたものです。 そのコードは長年にわたり、ほこりをかぶったハードドライブに眠ったままでしたが、今ではもはや動作しません。開発環境があまりにも大きく変わってしまったからです。 開発を再開するだけでなく、数回にわたる記事を通じて、その過程を段階的に解説していくことにしました。
当初の構想は、強力な並列計算を活用し、場合によってはクラウドコンピューティングのクラスタも用いて、マルチスレッド対応のロボットを開発することでした。 こんな状況を想像してみてください。複数のモニターの前に座り、通貨ペアの値動きを見ていると、人間の脳にはそもそも、数十もの銘柄を同時に監視し、数百もの指標を分析し、現代の市場が求めるスピードで意思決定をおこなう能力がないことに気づくのです。 まさにこのとき、複数の銘柄からなるポートフォリオを扱い、数十年にわたるデータを並列に分析できる、インテリジェントな自動売買ロボットを開発するというアイデアが生まれました。
でも、なぜ組み込み言語のMQL5ではなく、Pythonを使うのでしょうか。 私たちのソリューションのハイブリッドアーキテクチャを目にした人なら、おそらく誰もがこの疑問を抱くことでしょう。 その答えは、私たちが解決しようとしている問題の本質にあるのです。 機械学習には、scikit-learn、XGBoost、pandasといった強力なライブラリが必要です。Pythonには、こうしたタスクのためにあつらえたかのようなエコシステムが整っています。
この選択にはもう1つ理由があります。それは、私たちのロボットのアーキテクチャが、「責任の分担」と「分業」という理念に基づいて構築されているからです。 Pythonは、データ収集、前処理、特徴量生成、モデルの学習、および売買シグナルの生成といった「頭脳」的な役割を担っています。 MetaTrader 5は、Python APIを通じて「手」の役割を担い、注文執行、ポジション管理、リアルタイムの市場データの提供をおこないます。
マルチスレッドは、単なる技術的な解決策にとどまらず、もはや不可欠なものになりつつあります。 ロボットがEURUSD、GBPUSD、AUDUSDなどの通貨ペアを同時に分析する必要がある場合、逐次処理がボトルネックとなります。 各スレッドには、それぞれ専用の通貨ペア、モデル、意思決定コンテキストが割り当てられます。 これは、経験豊富なトレーダーが複数の取引アイデアを同時に頭に思い描くのに似ていますが、それを機械の計算能力で実現するものです。
私たちのアプローチの特徴は、ポートフォリオレベルのリスク管理を組み込んでいることです。 各銘柄を個別に取引するのではなく、ポートフォリオ全体のリスクを制限するグローバル変数TOTAL_PORTFOLIO_RISKを導入します。 つまり、各銘柄のポジションサイズは、そのボラティリティだけでなく、他の銘柄で既に保有しているポジションも考慮して算出されるということです。
TOTAL_PORTFOLIO_RISK: float = 500.0
POSITION_SIZES: Dict[str, float] = {}
SYMBOL_TRADES: Dict[str, bool] = {}
ログ記録システムと市場データの取得
機械学習アルゴリズムの詳細に入る前に、強固な基盤となるログ記録・データ取得システムを構築する必要があります。 ログなしでマルチスレッドアプリケーションのデバッグを試みたことはありますか? それは、目隠しをして干し草の山から針を探すようなものです。
私たちのログ記録システムは、容量に上限のあるキューを中心に構築されています。一見すると複雑すぎる仕組みに思えるかもしれませんが、これには大きな意味があります。 次のような状況を想像してみてください。5つのスレッドが同時にコンソールへ情報を書き込もうとしているのです。 スレッド間の調整がなければ、メッセージが入り乱れてしまいます。 キューによって一貫性が保たれ、別の出力用スレッドによってログの読みやすさが確保されます。
log_queue = queue.Queue(maxsize=1000)

def log_printer():
    while True:
        try:
            log_message = log_queue.get(timeout=10)
            if log_message is None:
                break
            print(log_message)
        except queue.Empty:
            continue
キューの容量をちょうど1000件にしているのはなぜでしょうか。 これは実務経験から得られた知見です。 キューの容量が小さすぎると、処理が集中する時間帯に重要なメッセージが失われる原因となりますが、逆に大きすぎると、メモリを過剰に消費することになります。 自動売買ロボットでは、キューの容量を1000件にすると最適なバランスが得られます。
それでは、システムの核心であるretrieve_data関数について見ていきましょう。 一見単純に見えますが、そこには信頼性に関する哲学が込められています。 「retries_limit = 300」を見てください。 これは適当に選んだ数値ではありません。 実際の取引では、証券会社のサーバーが数秒間、場合によっては数分間利用できなくなることがあります。 1秒間隔で300回試行することで、復旧を待つ時間を5分間確保できます。
特に、テクニカル指標の作成には細心の注意を払っています。 単にRSIやMACDを算出するだけでなく、相互につながる特徴量からなるエコシステム全体を構築しています。 RSIは、資産が買われすぎか売られすぎかを示します。 MACDはモメンタムの変化を示します。 ATRはボラティリティを測定します。 しかし、これらの指標が機械学習モデル内で相互作用したときに、魔法のようなことが起こるのです。
# RSI (Relative Strength Index)
delta = raw_data['close'].diff()
gain = delta.where(delta > 0, 0).rolling(14).mean()
loss = (-delta.where(delta < 0, 0)).rolling(14).mean()
rs = gain / loss
raw_data['RSI_14'] = (100 - (100 / (1 + rs))).astype(np.float64)
なお、ここではfloat32の代わりにnp.float64を使用している点に注意してください。 これはメモリの無駄遣いのように思えますが、後の関数では高精度な計算が必要となります。 精度を犠牲にすると、特徴量のクラスタリングが不安定になる可能性があります。
どのテクニカル指標にも、それぞれ独自の「個性」があります。 ウィリアムズ%Rは、価格変動に対して鋭敏に反応します。 アルーン・オシレーターは、トレンドの強さを示します。 効率比は、価格変動の「純度」を測る指標です。 これらすべての指標を機械学習モデルに組み込むことで、人間の知覚を超えた多次元的な市場像が得られます。
データ拡張と合成サンプルの生成
機械学習は大量のデータを必要としますが、金融市場で得られる過去の事例は限られています。 このジレンマをどう解決すればよいでしょうか。 データ拡張は、限られた履歴データから充実した学習データセットを作成するための鍵となります。
augment_data関数は、それぞれに深い理論的根拠を持つ4つのデータ拡張手法を実装しています。 最初の戦略は、ノイズを加えることです。 「なぜ、きれいなデータを台無しにするのか」と疑問に思うかもしれません。 その答えは、実際の市場の性質にあります。 価格が完全に滑らかに動くことはありません。常に微細な変動やスリッページ、突発的な急変が生じます。 制御されたノイズを加えることで、モデルを実環境の条件に備えさせます。
noisy_data = raw_data.astype(np.float32) + np.random.normal(0, noise_level, raw_data.shape).astype(np.float32) パラメータ「noise_level = 0.01」は、決して偶然に選ばれたわけではありません。 これは特徴量の値の約1%に相当し、変動を生み出すには十分ですが、パターンを歪めるほどではありません。 まるで水面に広がる穏やかな波紋のようなものだと考えてください。流れの方向を変えることはありませんが、よりリアルな印象を与えてくれます。
2つ目の戦略は、時間シフトです。 データを1時間進めたコピーを作成します。 不自然に思えるかもしれませんが、金融のパターンは、わずかな時間的なずれを伴いながら繰り返されることがよくあります。 午前中のボラティリティが夕方に再び現れることもあれば、週単位のサイクルが1~2日ずれることもあります。
3つ目の戦略はスケーリングです。 すべての値に、0.9から1.1までの範囲のランダムな係数を乗じます。 これは、ボラティリティが高い時期や低い時期、強気相場や弱気相場など、さまざまな市場状況をシミュレートするものです。 一つの期間のデータだけで学習したモデルは、市場の状況が変化すると対応できなくなる可能性があります。
4つ目の戦略は、価格列の反転です。 価格データに-1を掛けて、事実上、チャートを上下逆さまにします。 これにより、モデルが鏡像パターンを認識できるようになります。 三尊が反転すると、逆三尊になりますが、各特徴量間の数学的な関係性は維持されます。
for col in price_columns:
    if col in inverted_data.columns:
        inverted_data[col] *= -1
データ拡張の結果を正しく処理することは極めて重要です。 浮動小数点演算では、無限大やNaNが生成されることがあります。 ここでのデータクリーニングでは、問題のある値を中央値で補完します。これは、外れ値の影響を受けやすい平均値を用いるよりも頑健な方法です。
データ拡張後、データ量は5倍に増加します。 1000時間の履歴データから、5000件の学習用サンプルが得られます。 しかし、これは単なる量的な増加にとどまらず、質的な充実でもあります。 モデルは、実際に起きたことだけでなく、条件がわずかに異なっていれば起こり得た状況も学習します。
出来高の処理には特に注意を払っています。 価格とは異なり、出来高は負の値にはならないため、反転時には変更せず、ノイズを加える際にはゼロを下限として、それを下回る値をゼロに置き換えます。 これにより、データの経済的な整合性が保たれます。
データのラベル付けと目的変数の作成
適切にラベル付けされたデータのない機械学習は、文字の意味を説明せずに文字を見せるだけで、子供に読み方を教えようとするようなものです。 markup_data関数とlabel_data関数は、生の価格データを、明確な目的ラベルを持つ学習用サンプルに変換するという根本的な課題を解決します。
markup_data関数は、最も単純なラベル付け手法を実装しています。1期間後の価格が現在の価格よりmarkup_ratioの値だけ高くなるかどうかを予測します。 このアプローチは初歩的に見えますが、その単純さは見かけだけのものです。 markup_ratioパラメータの値0.00002(ほとんどの通貨ペアで2ピップ)は、実際の取引コストを考慮しています。
def markup_data(
    data: pd.DataFrame,
    target_column: str,
    label_column: str,
    markup_ratio: float = 0.00002
) -> pd.DataFrame:
    log("Starting markup_data function")
    data[label_column] = np.where(
        data[target_column].shift(-1) > data[target_column] + markup_ratio,
        1,
        0
    ).astype(np.int8)
    data.loc[data[label_column].isna(), label_column] = 0
    log(f"Number of labels set for price change greater than markup ratio: {data[label_column].sum()}")
    return data
label_data関数は、より洗練された手法を採用しています。 単に1期間の価格変化を比較するのではなく、ストップロスとテイクプロフィットを設定した実際の取引戦略をシミュレーションします。 金融市場は非線形であるため、これは極めて重要です。 価格は目標価格に達するかもしれませんが、その途中でストップロスに到達してしまう可能性があります。
def label_data(
    data: pd.DataFrame,
    symbol: str,
    min_days: int = 2,
    max_days: int = 72
) -> pd.DataFrame:
    if not mt5.initialize(path=TERMINAL_PATH):
        log("Terminal connection error")
        return data

    symbol_info = mt5.symbol_info(symbol)
    stop_level: float = 300 * symbol_info.point
    take_level: float = 800 * symbol_info.point
    labels: List[Optional[int]] = []

    for i in range(data.shape[0] - max_days):
        rand: int = random.randint(min_days, max_days)
        curr_pr: float = data['close'].iloc[i]
        future_pr: float = data['close'].iloc[i + rand]
        min_pr: float = data['low'].iloc[i:i + rand].min()
        max_pr: float = data['high'].iloc[i:i + rand].max()
        price_change: float = abs(future_pr - curr_pr)

        if (price_change > take_level and
            future_pr > curr_pr and
            min_pr > curr_pr - stop_level):
            labels.append(1)
        elif (price_change > take_level and
              future_pr < curr_pr and
              max_pr < curr_pr + stop_level):
            labels.append(0)
        else:
            labels.append(None)
ラベル付けのアルゴリズムは次のように動作します。各時点について、min_daysからmax_daysの範囲(2時間から72時間)で、分析対象の期間の長さをランダムに選択します。 次に、この区間における価格の動きを分析します。 チェックのロジックは3段階から成ります。すなわち、価格変動が十分に大きいか(price_change > take_level)、方向が正しいか(買いの場合:future_pr > curr_pr)、そしてストップロスが途中で発動していないか(min_pr > curr_pr - stop_level)です。
期間の長さをランダムにすることによって、 モデルが固定された時間間隔に対して過学習するのを防ぐことができます。 市場は、私たちの分析期間を把握していません。パターンが形成されるのに、5時間かかることもあれば、50時間かかることもあります。 ランダム性を取り入れることで、モデルは市場変動のさまざまな時間スケールに、より適応しやすくなります。
data = data.iloc[:len(labels)].copy()
    data['labels'] = labels
    data.dropna(inplace=True)

    X = data.drop('labels', axis=1)
    y = data['labels']

    rus = RandomUnderSampler(random_state=2)
    X_balanced, y_balanced = rus.fit_resample(X, y)

    data_balanced = pd.concat([X_balanced, y_balanced], axis=1)
    log(f"Number of growth labels (1.0): {data_balanced['labels'].value_counts().get(1.0, 0)}")
    log(f"Number of decline labels (0.0): {data_balanced['labels'].value_counts().get(0.0, 0)}")
    return data_balanced
パラメータをstop_level = 300ポイント、take_level = 800ポイントとすると、リスクリワード比はおよそ1:2.67となります。 これらの値にsymbol_info.pointを掛けることで、対象の銘柄に合わせて自動的に調整されます。 EURUSDでpoint = 0.00001の場合、これは300ポイントのストップロスと800ポイントのテイクプロフィットに相当します(ブローカーの価格表示形式にもよりますが、およそ30ピップと80ピップに相当します)。
RandomUnderSamplerは、クラス不均衡の問題を根本的に解決します。つまり、バランスが取れるまで、多数派クラスからランダムにサンプルを削除していくのです。 金融データにおいては、明確な売買の機会よりも、「明確なシグナルがない」期間が常に多いものです。 バランス調整をおこなわないと、モデルは90%のケースで「シグナルなし」と予測するよう学習してしまい、形式的には正確であっても、実際には役に立たないものになってしまいます。
ガウス混合モデルを用いた特徴量生成とクラスタリング
基本的なテクニカル指標のセットを作成したら、次のような疑問が浮かびます。入手可能なデータから、さらに多くの情報を引き出すにはどうすればよいのでしょうか。 generate_new_features関数は、既存の特徴量をランダムに組み合わせることで、派生特徴量を自動的に生成し、この問題を解決します。
このアプローチの根底にある考え方はシンプルですが、強力です。つまり、2つの特徴量がそれぞれ有用な情報を含んでいるならば、それらを数学的に組み合わせることで、隠れたパターンを明らかにできるのです。 ある指標がトレンドの強さを示し、別の指標がその持続性を示すと想像してみてください。 これら2つの指標の積は、強いトレンドが持続不可能になる瞬間を明らかにすることができます。
def generate_new_features(
    data: pd.DataFrame,
    num_features: int = 10,
    random_seed: int = 1
) -> pd.DataFrame:
    random.seed(random_seed)
    new_features: Dict[str, pd.Series] = {}

    columns = data.columns
    for i in range(num_features):
        feature_name = f'feature_{i}'
        col1_idx, col2_idx = random.sample(range(len(columns)), 2)
        col1, col2 = columns[col1_idx], columns[col2_idx]
        operation = random.choice([
            'add', 'subtract', 'multiply', 'divide',
            'shift', 'rolling_mean', 'rolling_std',
            'rolling_max', 'rolling_min', 'rolling_sum'
        ])
列や演算の選択におけるランダムさは、一見無秩序に見えるかもしれませんが、そこに多様性が生まれます。 決定論的なアプローチでは、一見して明らかではないものの有用な組み合わせを見逃してしまう可能性があります。 除算には特に注意が必要です。ゼロ除算を避けるため、分母に1e-8という小さな値を加えます。
elif operation == 'divide':
            new_features[feature_name] = (data[col1] / (data[col2] + 1e-8)).astype(np.float32)
        elif operation == 'shift':
            shift = random.randint(1, 10)
            new_features[feature_name] = data[col1].shift(shift).fillna(method='ffill').fillna(method='bfill').astype(np.float32)
シフト演算により、1~10期間の範囲でランダムに選んだラグを持つラグ特徴量が生成されます。 これにより、モデルはさまざまな時間スケールで過去を「記憶」できるようになります。 移動統計量を用いると、元の特徴量を平滑化したものが追加され、短期的なノイズに隠れた長期的な傾向を明らかにできます。
次のステップは、ガウス混合モデルを用いた特徴量のクラスタリングです。 これは、当システムの最も洗練された部分の一つです。 GMMは、データがいくつかの正規分布の混合によって生成されると仮定します。 金融市場の文脈では、これは強気相場、弱気相場、横ばい、高ボラティリティ、低ボラティリティといった市場レジームに分類することを意味します。
def cluster_features_by_gmm(
    data: pd.DataFrame,
    n_components: int = 6
) -> pd.DataFrame:
    X = data.drop(['label', 'labels'], axis=1, errors='ignore').astype(np.float32)
    X = X.replace([np.inf, -np.inf], np.nan).fillna(X.median(numeric_only=True))

    gmm = GaussianMixture(
        n_components=n_components,
        covariance_type='full',
        reg_covar=0.1,
        random_state=1
    )
    gmm.fit(X)
    data['cluster'] = gmm.predict(X).astype(np.int16)
    return data
「n_components = 6」という設定は、詳細度と解釈可能性のバランスを考慮して選ばれています。 クラスタの数が少なすぎるとニュアンスが失われ、多すぎると過学習や不安定さが生じます。 6つのクラスタにより、主要な市場レジーム、すなわち「強い上昇トレンド」、「弱い上昇トレンド」、「低ボラティリティの横ばい」、「高ボラティリティの横ばい」、「弱い下降トレンド」、「強い下降トレンド」を捉えることができます。
「covariance_type='full'」パラメータを使用すると、GMMは特徴量間の相関をモデル化できるようになります。 変数が独立していることはめったにない金融分野において、これは極めて重要です。 RSIとMACDは、市場の状況によって異なる動きを示すことがあり、完全共分散行列はこの点を考慮に入れています。
共分散の正則化(reg_covar=0.1)は、データがほぼ線形従属である場合に、モデルの縮退を防ぎます。 金融データでは、例えば複数の指標が同時に極端な値を示す場合など、こうした状況が頻繁に発生します。
どのクラスタに属するかという情報が、新たな強力な特徴量となります。 機械学習モデルは、指標の具体的な値に関する情報だけでなく、現在の状況がどの市場レジームに属するかという情報も受け取ります。 これにより、他の特徴量の解釈を劇的に変える可能性のある文脈情報が追加されます。
再帰的特徴量削減とアンサンブルを用いたXGBoost学習
数十ものテクニカル指標、生成された特徴量、クラスタラベルを利用できる状況では、「次元の呪い」という典型的な問題に直面します。特徴量が多いからといって、必ずしもモデルの性能が良くなるとは限りません。 逆に、冗長で相関のある特徴量は、過学習を招き、汎化能力を低下させる可能性があります。
feature_engineering関数は、交差検証を伴う再帰的特徴量削減(RFECV)によって、このジレンマを解決します。 この手法は、経験豊富なトレーダーが、自分のツールの中から不要な指標を徐々に排除し、最も有益な指標だけを残していくのと同じような仕組みです。
def feature_engineering(
    data: pd.DataFrame,
    n_features_to_select: int = 15
) -> pd.DataFrame:
    X = data.drop(['label', 'labels'], axis=1, errors='ignore').astype(np.float32)
    y = data['labels'].astype(np.int8)
    X = X.replace([np.inf, -np.inf], np.nan).fillna(X.median(numeric_only=True))

    unique_classes = y.unique()
    if len(unique_classes) < 2:
        log(f"Error in feature_engineering: Only one class found in labels: {unique_classes}")
        raise ValueError(f"The target 'y' needs to have more than 1 class. Got {len(unique_classes)} class instead")

    clf = RandomForestClassifier(n_estimators=100, random_state=1)
    rfecv = RFECV(
        estimator=clf,
        step=1,
        cv=5,
        scoring='accuracy',
        n_jobs=1,
        verbose=1,
        min_features_to_select=n_features_to_select
    )
    rfecv.fit(X, y)
RFECVは反復的に動作します。まずすべての特徴量を用いてモデルを学習させ、各特徴量の重要度を判定し、重要度が最も低い特徴量を1つ除去し、このプロセスを繰り返します。step=1と設定すると、各反復で1つの特徴量のみが除去されることになります。この方法は、時間はかかりますが、正確です。 処理を高速化するには、step=5に設定するという方法もありますが、金融分野では誤りによる損失が大きすぎます。
RandomForestClassifierをベース推定器として選択したのは、決して偶然ではありません。 ランダムフォレストは、異種の特徴量に対して良好な性能を発揮し、外れ値に対しても頑健です。 そのfeature_importances_はジニ不純度の減少量に基づいており、直感的に理解しやすい特徴量の重要度指標を提供します。
selected_features = X.columns[rfecv.get_support()]
    selected_data = data[selected_features.tolist() + ['label', 'labels']]
    log("\nBest features:")
    log(str(pd.DataFrame({'Feature': selected_features})))
    return selected_data
それでは、本システムの核心である、アンサンブルを用いたXGBoostの学習について見ていきましょう。 XGBoostは、特徴量間の非線形な相互作用をモデル化できる点や、過学習に対する耐性があることから、金融分野の問題においてその性能の高さで知られています。
def train_xgboost_classifier(
    data: pd.DataFrame,
    num_boost_rounds: int = 500
) -> BaggingClassifier:
    if data.empty:
        raise ValueError("Data should not be empty")

    X = data.drop(['label', 'labels'], axis=1).astype(np.float32)
    y = data['labels'].astype(np.int8)

    clf = xgb.XGBClassifier(
        objective='binary:logistic',
        random_state=1,
        max_depth=5,
        learning_rate=0.2,
        n_estimators=300,
        subsample=0.01,
        colsample_bytree=0.1,
        reg_alpha=1,
        reg_lambda=1
    )
XGBoostのパラメータは、金融データの処理に適した設定が選択されています。max_depth=5はツリーの深さを制限し、ノイズの多いデータでの過学習を防ぎます。また、learning_rate=0.2は、安定性を維持しつつ、十分に高速な学習を保証します。 正則化パラメータは極めて重要です。subsample=0.01は、各ツリーがデータのわずか1%だけで学習されることを意味し、これにより過学習が大幅に軽減されます。また、colsample_bytree=0.1は、各ツリーが特徴量のわずか10%しか使用しないことを示しています。 これは極端に見えるかもしれませんが、多数の木(n_estimators=300)と組み合わせることで、多様な弱学習器からなる強力なアンサンブルが形成されます。
bagging_clf = BaggingClassifier(estimator=clf, random_state=1)
    param_grid = {
        'n_estimators': [10, 20, 30],
        'max_samples': [0.5, 0.7, 1.0],
        'max_features': [0.5, 0.7, 1.0]
    }

    grid_search = GridSearchCV(bagging_clf, param_grid, cv=5, scoring='accuracy')
    grid_search.fit(X, y)
    accuracy = grid_search.best_score_
    log(f"Average cross-validation accuracy: {accuracy:.2f}")
    return grid_search.best_estimator_
さらに、BaggingClassifierはXGBoostの上に、もう1つのアンサンブル層を追加します。 メタアンサンブルを作成します。各要素はすでに勾配ブースティングアンサンブルであり、バギングによって、そのようなXGBoostモデルがいくつか組み合わされます。 この2層構成のアンサンブルは、過学習に対して極めて高い頑健性を発揮します。
GridSearchCVは、交差検証を通じて最適なバギングパラメータを自動的に選択します。max_samplesは、アンサンブル内の各モデルの学習にどの程度の割合のデータを使用するかを制御し、max_featuresは、各モデルが利用できる特徴量の割合を決定します。 これらのパラメータの組み合わせがアンサンブルに多様性をもたらし、その有効性の鍵となります。
ポートフォリオリスク管理と動的なポジションサイズの決定
個々の銘柄ではロボットが素晴らしい成果を上げているのに、ポートフォリオとして運用を始めると、大惨事になってしまう状況を想像してみてください。 その理由は単純です。各ポジション間の連携不足です。 相関性の高い複数の通貨ペアで、それぞれ1ロットの取引を5つ同時に行うと、5ロットのポジション1つに相当するリスクが生じる可能性があります。
calculate_portfolio_position_sizes関数は、リスク管理の手法に革新をもたらします。 ポジションサイズを固定するのではなく、各銘柄の現在のボラティリティとポートフォリオリスクの上限に基づいて動的に算出します。
def calculate_portfolio_position_sizes(symbols: List[str]) -> None:
    global POSITION_SIZES

    if not mt5.initialize(path=TERMINAL_PATH):
        log("Error connecting to the terminal for calculating positions")
        return

    try:
        symbol_risks = {}
        for symbol in symbols:
            symbol_info = mt5.symbol_info(symbol)
            if symbol_info is None:
                continue

            # Get ATR for the last 14 days
            rates = mt5.copy_rates_from_pos(symbol, mt5.TIMEFRAME_D1, 0, 20)
            if rates is None or len(rates) < 14:
                continue

            df = pd.DataFrame(rates)
            df['tr'] = np.maximum(df['high'] - df['low'],
                                 np.maximum(abs(df['high'] - df['close'].shift(1)),
                                           abs(df['low'] - df['close'].shift(1))))
            atr = df['tr'].rolling(14).mean().iloc[-1]

            # Risk per standard lot
            risk_per_lot = (atr / symbol_info.point) * symbol_info.trade_tick_value
            symbol_risks[symbol] = risk_per_lot
ATRが、このリスク管理システムの基盤となります。 この指標は、日々の値動きだけでなく、前日の終値と当日の始値のギャップも考慮して、銘柄の14日間の平均ボラティリティを測定します。 各日の「トゥルーレンジ」は、その日の高値と安値の差、高値と前日の終値の差、および前日の終値と当日の安値の差という3つの値のうち、最大の値として算出されます。
式「risk_per_lot = (atr / symbol_info.point) * symbol_info.trade_tick_value」は、ボラティリティを金銭的価値に変換します。 EURUSDのATRが0.00080(80ピップ)の場合、1ピップの価値を1米ドルとすると、標準ロットでのリスク額は80米ドルとなります。
# Risk per instrument
        risk_per_instrument = TOTAL_PORTFOLIO_RISK / len(symbols)

        # Calculate position sizes
        for symbol, risk_per_lot in symbol_risks.items():
            symbol_info = mt5.symbol_info(symbol)
            base_size = risk_per_instrument / risk_per_lot

            # Normalize to the broker's requirements
            min_lot = symbol_info.volume_min
            lot_step = symbol_info.volume_step
            normalized_size = max(min_lot, round(base_size / lot_step) * lot_step)

            POSITION_SIZES[symbol] = normalized_size
            SYMBOL_TRADES[symbol] = False

            log(f"{symbol}: lot={normalized_size:.3f}, risk={normalized_size * risk_per_lot:.2f}")
リスクを各銘柄に均等に配分すること(risk_per_instrument = TOTAL_PORTFOLIO_RISK / len(symbols))は、単純すぎるように思えるかもしれませんが、ポートフォリオのバランスを保つことができます。 TOTAL_PORTFOLIO_RISKが500米ドルで、通貨ペアが5つある場合、各銘柄のリスク上限は100米ドルとなります。
ポジションサイズをブローカーの要件に合わせて調整することは極めて重要です。 実際のブローカーには、最小ロット数(通常0.01)やロット数の変更単位(通常0.01)といった制約があります。 関数「round(base_size / lot_step) * lot_step」は、計算されたサイズを最も近い有効な値に丸めます。
SYMBOL_TRADESフラグシステムにより、1つの銘柄に対して複数のポジションを開くことが防止されます。 これは、各スレッドが独立して取引シグナルを受信できるマルチスレッド環境において、特に重要です。
def check_and_update_position_flags() -> None:
    global SYMBOL_TRADES

    if not mt5.initialize(path=TERMINAL_PATH):
        return

    try:
        positions = mt5.positions_get()
        if positions is None:
            positions = []

        open_symbols = set()
        for pos in positions:
            if pos.magic == 123456:  # Our magic number
                open_symbols.add(pos.symbol)

        # Reset flags for symbols without open positions
        for symbol in list(SYMBOL_TRADES.keys()):
            if symbol not in open_symbols and SYMBOL_TRADES[symbol]:
                SYMBOL_TRADES[symbol] = False
                log(f"Flag reset for {symbol} - position is closed")
check_and_update_position_flags関数は、ロボットの内部状態と取引ターミナル上の実際のポジションとの同期を確保します。 ポジションは、トレーダーが手動で決済することも、ストップロスやテイクプロフィットによって決済されることもあります。 定期的に確認しないと、ロボットはそのポジションがまだオープンであると「判断」してしまい、新たな取引の機会を逃してしまう可能性があります。
マジックナンバー「123456」は、このロボットのポジションを、他の自動売買ロボットや手動取引によるポジションと区別するためのIDです。 これにより、自ら建てたポジションだけを管理できるようになります。
取引ロジックとリアルタイムの注文執行
どの自動売買ロボットにとっても、注文が執行されるときこそが正念場です。 これまでのすべての手順(データ収集、特徴量の生成、モデルの学習)は、「買い」、「売り」、あるいは「様子見」という判断を下すという、ひとつの目標のためにおこなわれています。 online_trading関数は、これらの決定を実際の市場ポジションに変換します。
def online_trading(
    symbol: str,
    features: np.ndarray,
    model: Any
) -> Optional[Any]:
    global SYMBOL_TRADES, POSITION_SIZES

    # Check and update position flags
    check_and_update_position_flags()

    if not mt5.initialize(path=TERMINAL_PATH):
        log("Error: Failed to connect to MetaTrader 5 terminal")
        return None

    # Check if a position is already open for this symbol
    if SYMBOL_TRADES.get(symbol, False):
        log(f"Position for {symbol} already open")
        mt5.shutdown()
        return None

    # Get the position size from the portfolio calculation
    volume = POSITION_SIZES.get(symbol, 0.1)
この関数の最初の数行は、防御的プログラミングの好例となっています。 ポジションフラグを確認することで、重複した取引を防ぐことができます。 ネットワークの問題や取引ターミナルの再起動により、取引ターミナルの初期化が予期せず失敗する場合があります。 事前に計算したPOSITION_SIZESから注文数量を求めることで、全体のリスク管理戦略との整合性を確保します。
銘柄情報を取得するループには、特に注目する必要があります。 実取引では、ブローカーのサーバーへの接続に問題が生じた場合、symbol_infoが一時的にNoneを返すことがあります。 ロボットはすぐに諦めるのではなく、5秒間隔で最大3万回再試行します。
attempts: int = 30000
    symbol_info = None
    for _ in range(attempts):
        symbol_info = mt5.symbol_info(symbol)
        if symbol_info is not None:
            break
        log(f"Error: Instrument not found. Attempt {_ + 1} of {attempts}")
        time.sleep(5)

    if symbol_info is None:
        mt5.shutdown()
        return None

    tick = mt5.symbol_info_tick(symbol)
    price_bid: float = tick.bid
    price_ask: float = tick.ask
    signal = model.predict(features)
    positions_total: int = mt5.positions_total()
3万回の試行は多すぎるように思えるかもしれませんが、アルゴリズム取引の文脈では、これは約41時間にわたる連続した試行に相当します。 市場は24時間稼働しており、短期的な技術的な問題によって取引の機会を逃すようなことがあってはなりません。
取引判断のロジックは、そのシンプルさゆえに洗練されています。 このモデルは確率値を返すため、0.5を閾値として「買い」と「売り」に分類します。 さらに、「positions_total < MAX_OPEN_TRADES」というチェックをおこなうことで、過度なレバレッジを防ぐことができます。
request = None
    if positions_total < MAX_OPEN_TRADES and signal[-1] > 0.5:
        request = {
            "action": mt5.TRADE_ACTION_DEAL,
            "symbol": symbol,
            "volume": volume,
            "type": mt5.ORDER_TYPE_BUY,
            "price": price_ask,
            "sl": price_ask - 50 * symbol_info.point,
            "tp": price_ask + 100 * symbol_info.point,
            "deviation": 20,
            "magic": 123456,
            "comment": "Portfolio Buy",
            "type_time": mt5.ORDER_TIME_GTC,
            "type_filling": mt5.ORDER_FILLING_FOK,
        }
取引リクエストの構造には、多くの重要なパラメータが含まれています。 TRADE_ACTION_DEALは、市場価格での即時約定を意味します。 ORDER_TYPE_BUY/SELLによって売買の方向が決まります。 50ピップのストップロスと100ピップのテイクプロフィットを設定すると、リスクリワード比は1:2になります。
「deviation=20」というパラメータを設定すると、ブローカーは、指定価格から最大20ポイントの乖離の範囲内で注文を執行できるようになります。 相場が激しく変動する状況下では、これにより、気配値の受信から注文の送信までの間に生じるごくわずかな価格変動を理由に、注文が拒否されるのを防ぐことができます。
ORDER_TIME_GTC (Good Till Cancelled)とは、注文がキャンセルされるまで有効であることを意味します。 ORDER_FILLING_FOK (Fill Or Kill)では、注文は全数量が約定するか、拒否されるかのいずれかとなり、部分約定は認められません。
for _ in range(attempts):
        result = mt5.order_send(request)
        if result.retcode == mt5.TRADE_RETCODE_DONE:
            # Mark that the position is open for this symbol
            SYMBOL_TRADES[symbol] = True
            log(f"Position opened {symbol}: {'Buy' if signal[-1] > 0.5 else 'Sell'}, lot={volume}")
            mt5.shutdown()
            return result.order
        log(f"Error: Trade request not executed, retcode={result.retcode}. Attempt {_ + 1}/{attempts}")
        time.sleep(3)
注文執行サイクルにおいても、複数回の試行が行われます。 TRADE_RETCODE_DONEは、注文執行が成功したことを意味します。 その他のコードは、資金不足、流動性の問題、または技術的な問題を示している可能性があります。 試行の間隔を3秒空けることで、市場が落ち着く時間を確保できます。
マルチスレッド環境において、ポジションの重複を防ぐためには、注文が正常に執行された後にSYMBOL_TRADES[symbol]フラグをTrueに設定することが極めて重要です。 ポジションの売買方向と注文数量をログ記録することで、取引活動を漏れなく追跡できるようになります。
マルチスレッドアーキテクチャとスレッドの連携
各演奏者がそれぞれのパートを演奏しながら、全員が同じ指揮者の指示に従うオーケストラを想像してみてください。 このマルチスレッドアーキテクチャも同じ原理で動作します。各スレッドはそれぞれが担当する通貨銘柄を独立して処理しますが、すべてのスレッドは共有のグローバル変数や関数を通じて協調動作します。
process_symbol関数は、各スレッドの主要な「実行者」となります。 この関数は、過去データの取得からリアルタイム取引の終わりのないサイクルまで、単一銘柄のライフサイクル全体をカプセル化しています。
def process_symbol(symbol: str) -> None:
    global all_symbols_done
    try:
        raw_data = retrieve_data(symbol)
        if raw_data is None:
            log(f"Data not found for symbol {symbol}")
            return

        labeled_data_engineered = process_data(raw_data)
        train_data = labeled_data_engineered[labeled_data_engineered.index <= FORWARD]
        test_data = labeled_data_engineered[labeled_data_engineered.index > FORWARD]

        if train_data.empty or len(train_data['labels'].unique()) < 2:
            log(f"Skipping symbol {symbol}: Insufficient data or single class in labels")
            return

        xgb_clf = train_xgboost_classifier(train_data, num_boost_rounds=1000)
        test_features = test_data.drop(['label', 'labels'], axis=1)
        test_labels = test_data['labels']
        accuracy = evaluate_xgboost_classifier(xgb_clf, test_features, test_labels)
        log(f"Accuracy for symbol {symbol}: {accuracy * 100:.2f}%")
金融分野では、時間軸に基づいてデータを学習用データセットとテスト用データセットに分割することが極めて重要です。 区切りとなるFORWARD = datetime(2025, 1, 1)は、モデルを2025年より前のデータで学習し、その基準日時より後のデータでテストすることを意味します。 これは、モデルが過去に基づいて未来を予測しなければならないという、現実世界の状況を再現したものです。
「len(train_data['labels'].unique()) < 2」というチェックにより、単一クラスのデータで学習を試みることを防ぎます。 ボラティリティが低い期間には、すべてのサンプルに「シグナルなし」というラベルが付けられ、学習が不可能になる場合があります。
モデルの学習が正常に完了すると、無限の取引サイクルが始まります。
features = test_features.values
        position_id = None
        while not all_symbols_done:
            position_id = online_trading(symbol, features, xgb_clf)
            time.sleep(6)

        all_symbols_done = True
    except Exception as e:
        log(f"Error processing symbol {symbol}: {e}")
グローバル変数all_symbols_doneは、すべてのスレッドを正常終了させるための仕組みとして機能します。 どのスレッドでもこのフラグをTrueに設定でき、それによって他のスレッドに終了するよう通知することができます。 このフラグが設定される理由には、重大なエラー、1日の損失上限への到達、ユーザーからのコマンドなど、さまざまなものがあります。
取引サイクル間のtime.sleep(6)の間隔は、応答性とシステム負荷のバランスを考慮して設定されています。 間隔が短すぎると、ブローカーのAPIに過度な負荷がかかり、アクセスがブロックされる可能性があります。一方、間隔が長すぎると、取引機会を逃す可能性があります。
このメイン関数は、スレッドの作成と終了を調整します。
if __name__ == "__main__":
    symbols = ["EURUSD", "GBPUSD", "AUDUSD", "NZDUSD", "USDCAD"]

    # First, we calculate the position sizes for the entire portfolio
    calculate_portfolio_position_sizes(symbols)

    threads = []
    for symbol in symbols:
        thread = threading.Thread(target=process_symbol, args=(symbol,))
        thread.start()
        threads.append(thread)

    for thread in threads:
        thread.join()

    log_queue.put(None)
スレッドを開始する前に calculate_portfolio_position_sizes(symbols)を呼び出すことで、取引開始前にすべてのポジションサイズが計算され、POSITION_SIZESに格納されるようになります。 これにより、スレッドが未定義のポジションサイズで取引を試みるといった事態を防ぐことができます。
各スレッドのthread.join()メソッドにより、プログラムの正常終了が保証されます。 メインスレッドは、すべての子スレッドが終了するのを待ってから、自身を終了します。 最後のlog_queue.put(None)は、ログ記録スレッドに終了するよう通知します。
特定の通貨ペア["EURUSD", "GBPUSD", "AUDUSD", "NZDUSD", "USDCAD"]の選択は、決して偶然によるものではありません。 すべての通貨ペアは、基準通貨または決済通貨として米ドル(USD)を含んでおり、ある程度の相関関係はあるものの、リスクを分散させるのに十分な多様性を備えています。
このアーキテクチャは、並行プログラミングにおける古典的な課題、すなわち「協調を必要としつつ、スレッド間の独立性をどのように確保するか」という問題に対する洗練された解決策を示しています。 グローバル変数POSITION_SIZES、SYMBOL_TRADES、およびall_symbols_doneは、スレッド間の通信チャネルとして機能し、キューを使ったログ記録システムにより、メッセージが同時に書き込まれる際の競合が防止されます。
各スレッドにおける例外処理は極めて重要です。 あるスレッドで未処理の例外が発生しても、システム全体がクラッシュしてはなりません。 各スレッドは、エラーをログに記録したうえで、安全に終了します。
システムテストと野心的な開発計画
現在のtest_model関数は、マークアップとエグジットまでの期間を考慮し、過去データ上で損益をシミュレーションすることで取引戦略を検証する基本的な手法を示しています。
def test_model(
    model: Any,
    X_test: pd.DataFrame,
    y_test: pd.Series,
    markup: float,
    initial_balance: float = 10000.0,
    point_cost: float = 0.00001
) -> None:
    balance = initial_balance
    trades = 0
    profits = []

    predicted_labels = model.predict(X_test.values)
    close = X_test['close'].values

    for i in range(len(predicted_labels) - 10):
        entry_price = close[i]
        exit_price = close[i + 10]
        # Detailed trading logic taking into account direction and markup
        ...
    total_profit = balance - initial_balance
    log(f"Total accumulated profit or loss: {total_profit:.2f}")
しかし、これはまだ始まりに過ぎません。 このシステムの真の未来は、抜本的な規模拡大と、質的に新たな段階への移行にあります。
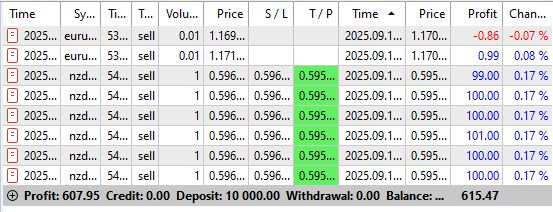
現時点では、テスト区間におけるシステムの正解率は約64~65%で、平均利益は平均損失を大幅に上回っています。
数日間の取引で、次のような成果を上げることができました。
また、所定の勝率とリスクを前提に、複数のポジションからなるポートフォリオと単一のポジションについてそれぞれおこなった収益性のシミュレーションでも、非常に有望な結果が得られています。
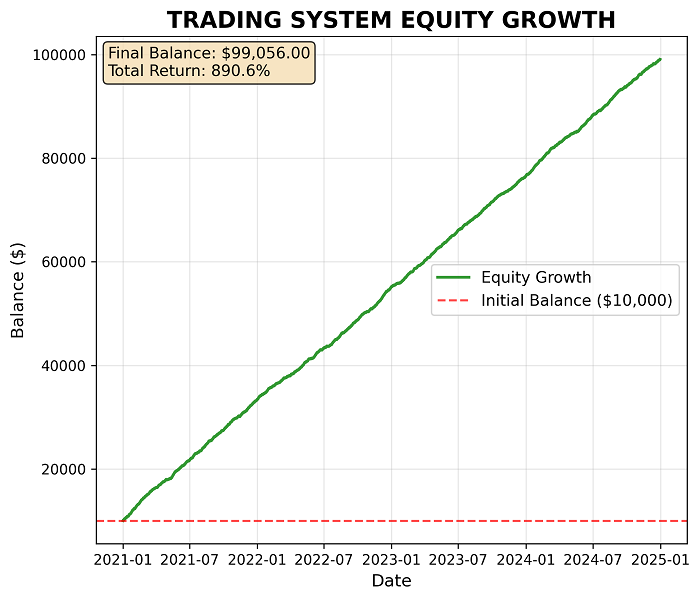
とはいえ、自作のPython製テスターはあまり信用していないため、実際の取引でシステムを徹底的にテストするか、ロジックをMQL5で書き直し、実ティックのデータベースとリクオートのエミュレーション機能を備えた高性能なストラテジーテスターを利用できるようにする必要があるでしょう。
MQL5への完全移植:アーキテクチャの革命
PythonとMetaTrader 5を組み合わせたハイブリッドアーキテクチャには、根本的な速度上の制限があります。 MQL5に完全移植するには、独自の機械学習ライブラリを作成する必要があります。 主要なモジュールには、XGBoost向けの高性能な行列演算、x64アーキテクチャ向けにネイティブ最適化を施した勾配ブースティングの実装、および特徴量のクラスタリング用に調整したガウス混合モデルが含まれます。 これは技術的に困難な課題ですが、これによりAPIの遅延をすべて解消し、パフォーマンスを10~50倍向上させることができます。
次世代のグラフィカルインターフェースモジュール型アーキテクチャを採用した、本格的なリアルタイムGUIシステムを構築する計画です。 ダッシュボードには、すべての銘柄の現在のポジション、リアルタイムの損益、リスク上限の使用状況、および各取引スレッドの状態が表示されます。 重要な構成要素となるのが、動的なパラメータ管理モジュールです。このモジュールにより、システムを再起動せずにTOTAL_PORTFOLIO_RISK、モデルの閾値、および対象期間を変更できます。 このアラートシステムには、1日の損失限度額の超過、モデルの異常なシグナル、ブローカーとの接続の切断に関する通知が含まれます。
ハイレベルなリスクマネージャー:ポートフォリオ管理における飛躍的な進化現在のリスク管理システムは、計画中のものと比べると、原始的に見えます。 新しいリスクマネージャは、長さの異なるローリングウィンドウを用いて、銘柄間の相関関係をリアルタイムで分析します。 モンテカルロシミュレーションに基づくバリュー・アット・リスク(VaR)の算出により、さまざまな確率水準におけるポートフォリオの潜在的な損失額を予測することができます。 動的ヘッジシステムは、相関リスクが許容範囲を超えた場合に、リスクを相殺するポジションを自動的に建てます。
マルチスレッドによる学習:モデルの大軍大規模並列モデル学習への移行は、画期的なものとなるでしょう。 各CPUスレッドは、XGBoostのハイパーパラメータ、学習期間、特徴量セットのさまざまな組み合わせを検証します。 このシステムは、アウトオブサンプルでの結果に基づいて、各期間に最適なモデルを自動的に選択します。 ランダムフォレスト、SVM、ニューラルネットワーク、LightGBMのアンサンブルにより、いずれの単独実装よりも優れた性能を発揮するメタモデルが構築されます。
25年分のデータセットを生成するためのGAN:合成された市場の履歴最も野心的な計画は、敵対的生成ネットワーク(GAN)を用いて、主要通貨ペアの25年分の合成価格時系列データを作成することです。 GANは実際の過去のデータを用いて学習され、その後、実際の市場の統計的特性(ボラティリティクラスタリング、裾の厚い分布、自己相関)を保持した膨大なデータセットを生成します。 これにより、ディープラーニングにおけるデータ不足の問題が解決されるでしょう。
100個の専門モデルのアンサンブル:時間・価格空間のセグメンテーションその集大成として、100個のモデルからなるアンサンブルが構築され、各モデルが市場状況の中でそれぞれ固有の「領域」を担当することになります。 各モデルの学習は、特定の市場レジーム(高ボラティリティ、横ばい、強いトレンド、ニュース発表時期、休日前の取引時間帯)のデータを用いて実施されます。 このような市場レジームは、例えば、特徴量のクラスタリング、マルコフ連鎖、あるいはSSMに基づく手法を用いて特定できます。 各モデルにBaggingClassifierを適用することで、安定性がさらに向上します。 メタ分類器は、極めて高い精度で現在の市場レジームを判定し、それに対応する特化型モデルを起動します。 このアーキテクチャにより、あらゆる市場状況にリアルタイムで適応し、これまでにない予測精度を実現します。
Google Cloud Platformとの連携:1,000コアのスーパーコンピュータの計算能力こうした野心的な計画を実現する上で、ローカルのコンピューティングリソースがボトルネックとなります。 Google Cloud Platformは、Python APIとの直接連携によって、この問題を解決します。 google-cloud-computeライブラリを使用すると、並列モデル学習用に、数百のCPUコアとテラバイト級のメモリを備えた仮想マシンをプログラムで作成することができます。
from google.cloud import compute_v1
from google.cloud import storage

# Creating a high-performance cluster
instance_client = compute_v1.InstancesClient()
operation = instance_client.insert(
    project="trading-ai-project",
    zone="us-central1-a",
    instance_resource={
        "name": "trading-cluster-node",
        "machine_type": "zones/us-central1-a/machineTypes/c2-standard-60",
        "scheduling": {"preemptible": True}  # Cost reduction by 5 times
    }
)
AI Platform Trainingを使用すると、数十台のマシンで同時にXGBoostやニューラルネットワークの分散学習をおこなえます。 Cloud Storageを利用すれば、ペタバイト規模の過去のデータに即座にアクセスできます。 BigQuery MLは、取引アルゴリズムと直接連携し、パターンをリアルタイムで分析します。
重要な利点の一つは、コンピューティングリソースのオートスケーリングです。 モデルの再学習中は、システムが自動的に数百のインスタンスを起動し、負荷が低い期間にはインスタンス数を最小限に抑えることで、コストを最適化します。 プリエンプティブルインスタンスにより、計算コストを5分の1に削減できるため、今後開発する極めて複雑なモデルの学習も経済的に実現可能となります。
結論
この記事では、機械学習の手法を用いたマルチスレッドの自動売買ロボットを作成するための第一歩を踏み出しました。 検討したアーキテクチャは、データ収集やデータ拡張から、特徴量の生成、クラスタリング、XGBoostモデルの学習、さらにはポートフォリオリスク管理の統合に至るまでの全プロセスを網羅しています。 PythonとMetaTrader 5の役割分担により、両者の長所を最大限に活用できることがわかりました。つまり、機械学習向けのPythonライブラリが持つ柔軟性と豊富なエコシステム、そしてリアルタイムの取引執行におけるMetaTrader 5の堅牢性を、同時に活用できるのです。
とはいえ、これは連載第1回にすぎません。 今後の記事では、システムのMQL5への移植、グラフィカルインターフェースの開発、クラウドサービスとの連携、GANを用いた合成データセットの生成、および特化型モデルのアンサンブル構築といったテーマを取り上げる予定です。 これらの取り組みにより、自動売買ロボットの規模が大幅に拡大し、効率も向上して、本格的な導入への道が開かれます。
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19577
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


素晴らしい記事ですね!掲載していただき、本当にありがとうございます。次の記事も楽しみにしています!