基于 GPT 语言模型的交易机器人
 58
 2

引言
TimeGPT 是一个机器学习模型,用于在 MetaTrader 5 平台上预测金融市场(如外汇货币对或股票)的价格走势。它基于 Transformer 架构。该架构最初是为处理文本(如翻译或文本生成)而设计的,现在则被适配用于金融数据分析。在本文中,我将详细说明 TimeGPT 是如何逐步创建的,涵盖其架构、数据处理、训练和预测。所有内容都将用通俗的语言配合类比来解释,即使只是刚开始学习机器学习的人也能理解这样一个模型是如何创建的。最后,我还会谈及该模型的局限性及其计算资源需求。
创建一个像 TimeGPT 这样的模型需要哪些条件?在深入代码之前,重要的是先理解 TimeGPT 处理的是什么。金融市场以时间序列的形式产生数据,即以固定间隔(例如每小时)记录的一系列价格。市场价格并不遵循简单的规则:它们可能因新闻而暴涨、缓慢下跌,或无缘无故地波动。TimeGPT 的任务是在这些数据中寻找规律,并预测价格在 24 小时后将如何变化。在市场图表的术语中,这称为 24 根 K 线。
开发一个模型需要解决几个问题。首先,我们需要确定如何存储和处理价格数据。然后,我们需要将这些数据转换为模型能够理解的格式。接着,我们需要设计模型架构,使其能够发现数据中的复杂依赖关系。随后,让模型基于历史数据进行训练,学习如何做出准确预测。最后,考虑到 MetaTrader 5 平台的限制,优化模型使其运行迅速且不会占用过多内存也很重要。现在,让我们通过 TimeGPT_Fixed.mqh 文件中的代码逐一查看这些步骤。
模型开发
创建用于处理数据的结构 开发 TimeGPT 的第一步是创建一个用于存储和处理数据的结构。在机器学习中,数据通常表示为矩阵,即便于进行数学运算的数字表格。为此,TimeGPT 中创建了 TGMatrix 结构,它允许以有序形式存储价格或模型参数等数字。
该结构的代码如下:
struct TGMatrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r;
        cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) const {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void RandomInit(double scale = -1.0) {
        if(scale < 0) scale = MathSqrt(2.0 / (rows + cols));
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
        }
    }

    void Add(const TGMatrix &other) {
        if(rows != other.rows || cols != other.cols) return;
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] += other.data[i];
        }
    }

    void Copy(const TGMatrix &other) {
        Init(other.rows, other.cols);
        for(int i = 0; i < ArraySize(other.data); i++) {
            data[i] = other.data[i];
        }
    }

    void Scale(double factor) {
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] *= factor;
        }
    }
};
可以将 TGMatrix 想象成一张 Excel 表格,其中的数字按行和列存储。Init 方法创建所需大小的表格;Get 和 Set 允许读取和写入特定单元格的值;RandomInit 用随机数填充表格,这些随机数是模型初始设置所需的;Add、Copy 和 Scale 方法则执行基本操作,例如将两张表相加或将所有数字乘以某个值。这一结构成为 TimeGPT 中处理数据的基础,因为所有价格、模型参数和计算都使用矩阵。我们选择这种方法是因为它简单,并且在 MetaTrader 5 中运行良好;在该平台中无法使用像 Python 那样的复杂库。
将价格转换为模型可理解的格式为了让模型能够分析价格,需要将其转换为一种方便的格式。TimeGPT 借鉴了文本处理中的一个思路:每个价格变化都被转换为一个 "token"(标记),即一个代表价格变动的数字,例如上涨 0.5% 或下跌 0.3%。ImprovedTokenizer 结构负责此事。
这是它的代码:
struct ImprovedTokenizer {
    double price_mean, price_std;
    double change_mean, change_std;
    bool is_trained;

    ImprovedTokenizer() {
        is_trained = false;
        price_mean = 0; price_std = 1;
        change_mean = 0; change_std = 1;
    }

    void Train(const MqlRates &rates[]) {
        int size = ArraySize(rates);
        if(size < FORECAST_HORIZON + 10) return;

        // Calculate statistics for prices
        double sum_price = 0, sum_price_sq = 0;
        double changes[];
        ArrayResize(changes, size - FORECAST_HORIZON);

        for(int i = FORECAST_HORIZON; i < size; i++) {
            double price = rates[i].close;
            sum_price += price;
            sum_price_sq += price * price;

            // Price change after 24 bars
            changes[i - FORECAST_HORIZON] = (rates[i].close - rates[i - FORECAST_HORIZON].close) / rates[i - FORECAST_HORIZON].close;
        }

        price_mean = sum_price / size;
        price_std = MathSqrt(sum_price_sq / size - price_mean * price_mean);
        if(price_std < EPSILON) price_std = 1.0;

        // Statistics for changes over the next 24 bars
        double sum_change = 0, sum_change_sq = 0;
        for(int i = 0; i < ArraySize(changes); i++) {
            sum_change += changes[i];
            sum_change_sq += changes[i] * changes[i];
        }

        change_mean = sum_change / ArraySize(changes);
        change_std = MathSqrt(sum_change_sq / ArraySize(changes) - change_mean * change_mean);
        if(change_std < EPSILON) change_std = 1.0;

        is_trained = true;
        Print("Tokenizer trained for 24-bar changes: change_std=", DoubleToString(change_std, 6));
    }

    int TokenizeChange(double change) {
        if(!is_trained) return VOCAB_SIZE / 2;

        // Normalize and quantize
        double normalized = (change - change_mean) / change_std;
        normalized = MathMax(-3.0, MathMin(3.0, normalized)); // Clamp

        int token = (int)((normalized + 3.0) / 6.0 * (VOCAB_SIZE - 1));
        return MathMax(0, MathMin(VOCAB_SIZE - 1, token));
    }

    double DetokenizeChange(int token) {
        if(!is_trained || token < 0 || token >= VOCAB_SIZE) return 0.0;

        double normalized = (double)token / (VOCAB_SIZE - 1) * 6.0 - 3.0;
        return normalized * change_std + change_mean;
    }
};
令牌化器的工作方式如下。Train 方法分析历史 K 线的收盘价(例如最近 2000 小时的数据),并计算它们在 24 根 K 线内的变化。如果价格是 100 美元,24 小时后变为 102 美元,则变化为 (102 - 100) / 100 = 2%。然后,令牌化器计算所有变化的均值和标准差,将它们统一到同一尺度。这就像调整一把尺子,使所有变化都以相同的单位来衡量。TokenizeChange 方法将每个变化转换为 0 到 255 之间的数字(词表大小 VOCAB_SIZE = 256),例如,2% 的上涨可能变为 token "150"。DetokenizeChange 方法执行反向转换,指出某个 token 对应哪个价格变化。
这种方法很重要,因为原始价格的差异可能非常大:一只股票价值 10 美元,而另一只可能价值 1000 美元。令牌化使数据对模型来说更简单,使其能在单一数值范围内处理数字,就像文本一样:文本中每个词都有自己的编码。
构建注意力机制TimeGPT 的关键部分是实现在 SimpleAttention 结构中的注意力机制。它允许模型关注过去重要的价格变化,同时忽略不那么重要的变化。想象一下读一本很长的书,只标出那些帮助你理解情节的关键点。注意力机制做的事情是一样的:它决定哪些价格数据对预测是重要的。
以下是注意力机制的代码:
struct SimpleAttention {
    TGMatrix W_q, W_k, W_v, W_o;
    double scale;

    void Init() {
        W_q.Init(MODEL_DIM, MODEL_DIM);
        W_k.Init(MODEL_DIM, MODEL_DIM);
        W_v.Init(MODEL_DIM, MODEL_DIM);
        W_o.Init(MODEL_DIM, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W_q.RandomInit(init_scale);
        W_k.RandomInit(init_scale);
        W_v.RandomInit(init_scale);
        W_o.RandomInit(init_scale);

        scale = 1.0 / MathSqrt(HEAD_DIM);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        // Multi-headed attention
        for(int head = 0; head < NUM_HEADS; head++) {
            int head_start = head * HEAD_DIM;

            // Simple projections for this head
            TGMatrix head_output;
            head_output.Init(seq_len, HEAD_DIM);

            for(int i = 0; i < seq_len; i++) {
                // Calculate attention only to previous positions
                double total_weight = 0.0;
                double weighted_values[HEAD_DIM];
                ArrayInitialize(weighted_values, 0.0);

                for(int j = 0; j <= i; j++) {
                    // Simple dot product for attention weight
                    double attention_weight = 0.0;
                    for(int k = head_start; k < head_start + HEAD_DIM; k++) {
                        attention_weight += inp_data.Get(i, k) * inp_data.Get(j, k);
                    }
                    attention_weight = MathExp(attention_weight * scale);
                    total_weight += attention_weight;

                    // Accumulate weighted values
                    for(int k = 0; k < HEAD_DIM; k++) {
                        weighted_values[k] += attention_weight * inp_data.Get(j, head_start + k);
                    }
                }

                // Normalize and write
                if(total_weight > EPSILON) {
                    for(int k = 0; k < HEAD_DIM; k++) {
                        head_output.Set(i, k, weighted_values[k] / total_weight);
                    }
                }
            }

            // Copy the head result to the output matrix
            for(int i = 0; i < seq_len; i++) {
                for(int j = 0; j < HEAD_DIM; j++) {
                    output.Set(i, head_start + j, head_output.Get(i, j));
                }
            }
        }
    }
};
注意力机制将数据分成六个部分,称为 "头"(heads,NUM_HEADS = 6),每个头寻找不同的模式,例如短期价格尖峰或长期趋势。Init 方法创建用于转换数据的 W_q、W_k、W_v 和 W_o 矩阵,并用随机数初始化它们。在 Forward 方法中,模型使用点积和 MathExp 函数计算序列中每个先前位置对当前位置的重要程度。
重要的是,模型只查看截至当前位置的数据(j <= i),以免 "窥视" 未来,这称为因果掩码。注意力权重经过归一化,使其总和为 1,并用于对数据加权,就好像模型在说:"这一刻的重要性是 70%,那一刻只有 20%。"
这一机制使 TimeGPT 能够发现价格变化之间的复杂关系,即使这些变化发生在很久以前,这使它比那些很快 "忘记" 历史数据的旧模型更强大。
组装 Transformer 层TimeGPT 由六层组成(NUM_LAYERS = 6),每层都包含一个注意力机制,以及通过前馈网络(FFN)进行的额外数据处理。它就像一个过滤器,经过若干处理阶段逐步提升对数据的理解。
以下是其中一层的代码:
struct TransformerLayer {
    SimpleAttention attention;
    SimpleFeedForward ffn;

    void Init() {
        attention.Init();
        ffn.Init();
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        // Attention with residual connection
        TGMatrix attn_out;
        attention.Forward(inp_data, attn_out);

        TGMatrix residual1;
        residual1.Copy(inp_data);
        residual1.Add(attn_out);

        // FFN with residual connection
        TGMatrix ffn_out;
        ffn.Forward(residual1, ffn_out);

        output.Copy(residual1);
        output.Add(ffn_out);
    }
};
每一层首先应用注意力机制来突出数据中的重要部分,然后将原始数据加到结果中(这称为残差连接),以避免信息丢失。随后数据通过前馈网络,该网络增加了非线性,从而能够发现复杂的模式。另一个残差连接将 FFN 的结果加到经过注意力处理后的数据上,从而保持稳定性。
FFN 的样子如下:
struct SimpleFeedForward {
    TGMatrix W1, W2, b1, b2;

    void Init() {
        W1.Init(MODEL_DIM, FFN_DIM);
        W2.Init(FFN_DIM, MODEL_DIM);
        b1.Init(1, FFN_DIM);
        b2.Init(1, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W1.RandomInit(init_scale);
        W2.RandomInit(init_scale);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        for(int i = 0; i < seq_len; i++) {
            // First layer with ReLU
            double hidden[FFN_DIM];
            for(int j = 0; j < FFN_DIM; j++) {
                hidden[j] = b1.Get(0, j);
                for(int k = 0; k < MODEL_DIM; k++) {
                    hidden[j] += inp_data.Get(i, k) * W1.Get(k, j);
                }
                hidden[j] = MathMax(0.0, hidden[j]); // ReLU
            }

            // Second layer
            for(int j = 0; j < MODEL_DIM; j++) {
                double sum = b2.Get(0, j);
                for(int k = 0; k < FFN_DIM; k++) {
                    sum += hidden[k] * W2.Get(k, j);
                }
                output.Set(i, j, sum);
            }
        }
    }
};
FFN 接收数据并通过两层进行变换:第一层将数据扩展到 FFN_DIM = 256 的维度,并应用 ReLU 函数将负值置零,从而增加非线性;第二层将数据压缩回 MODEL_DIM = 256。这有助于模型检测简单线性方法无法看到的复杂价格变化组合。
Transformer 层是模型的基础。每一层都增强对数据的理解,而六层允许捕捉日益复杂的模式。残差连接通过防止信息丢失使学习保持稳定。
将各组件组合成 TimeGPT 模型所有部件创建完成后,我们将它们组装成一个单一的 FixedTimeGPT 模型。其结构如下:
struct FixedTimeGPT {
    ImprovedTokenizer tokenizer;
    TGMatrix embeddings;
    TransformerLayer layers[NUM_LAYERS];
    TGMatrix output_projection;
    double learning_rate;
    int training_steps;
    bool is_trained;

    void Init() {
        embeddings.Init(VOCAB_SIZE, MODEL_DIM);
        embeddings.RandomInit(0.1);

        for(int i = 0; i < NUM_LAYERS; i++) {
            layers[i].Init();
        }

        output_projection.Init(MODEL_DIM, VOCAB_SIZE);
        output_projection.RandomInit(0.1);

        learning_rate = LEARNING_RATE;
        training_steps = 0;
        is_trained = false;

        Print("Fixed TimeGPT initialized for 24-bar forecast");
    }
};
这一结构将所有组件整合在一起。令牌化器将价格转换为 token。嵌入(embeddings)矩阵将每个 token 转换为一个 256 维的数值向量,使模型能够像语言模型表示单词那样处理它。Transformer 的六层处理数据以寻找模式。output_projection 矩阵将最后一层的输出转换为每个 token(0 到 255)的概率,以预测下一个价格变化。learning_rate 参数决定模型学习的速度,training_steps 跟踪训练步数。
这一结构足够简单,可以在 MetaTrader 5 上运行,但仍足够强大,能够发现复杂的模式。
模型训练
训练是模型分析历史数据并调整其参数以做出准确预测的过程。其实现方式如下:
void TrainOnData(string symbol, ENUM_TIMEFRAMES timeframe, int total_bars, int epochs) {
    Print("Training Fixed TimeGPT for 24-bar forecast on ", total_bars, " bars, ", epochs, " epochs...");

    // Get data
    MqlRates rates[];
    ArraySetAsSeries(rates, false); // Chronological order
    if(CopyRates(symbol, timeframe, 0, total_bars, rates) <= 0) {
        Print("Failed to copy rates");
        return;
    }

    // Train the tokenizer for changes every 24 bars
    tokenizer.Train(rates);

    // Prepare sequences for training
    int num_sequences = total_bars - CONTEXT_LENGTH - FORECAST_HORIZON - 1;
    if(num_sequences <= 0) {
        Print("Not enough data for training");
        return;
    }

    // Learning cycle
    for(int epoch = 0; epoch < epochs; epoch++) {
        Print("Epoch ", epoch + 1, "/", epochs);
        double total_loss = 0.0;
        int batch_count = 0;

        // Handle sequences
        for(int start = 0; start < num_sequences; start += CONTEXT_LENGTH/2) {
            if(start + CONTEXT_LENGTH + FORECAST_HORIZON >= ArraySize(rates)) break;

            double loss = TrainStep(rates, start);
            total_loss += loss;
            batch_count++;
            training_steps++;

            // Decay learning rate
            if(training_steps % 100 == 0) {
                learning_rate *= 0.99;
            }
        }

        if(batch_count > 0) {
            Print("Average loss: ", DoubleToString(total_loss / batch_count, 6));
        }
    }

    is_trained = true;
    Print("Training completed. Total steps: ", training_steps);
}
模型加载历史价格,例如在小时图上加载 2000 根 K 线的数据,交易品种如 EURUSD。令牌化器分析数据以理解典型的价格变化。然后模型多次遍历数据(三个 epoch),每次取一段 64 根 K 线的序列(CONTEXT_LENGTH = 64),并尝试预测 24 根 K 线之后的价格变化。
TrainStep 方法计算误差(loss),即预测值与实际变化之间的差异,并调整模型参数以减小这一误差。每 100 步,学习率降低 1%,使模型学习得更加谨慎,避免出现大的误差。
TrainStep 的样子如下:
double TrainStep(const MqlRates &rates[], int start_pos) {
    // Simple learning step for forecasting in 24 bars
    int tokens[CONTEXT_LENGTH + 1];

    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = start_pos + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2;
        }
    }

    // Target - change in 24 bars
    int target_idx = start_pos + CONTEXT_LENGTH + FORECAST_HORIZON;
    if(target_idx < ArraySize(rates) && start_pos + CONTEXT_LENGTH > 0) {
        double change = (rates[target_idx].close - rates[target_idx - FORECAST_HORIZON].close) / rates[target_idx - FORECAST_HORIZON].close;
        tokens[CONTEXT_LENGTH] = tokenizer.TokenizeChange(change);
    } else {
        tokens[CONTEXT_LENGTH] = VOCAB_SIZE / 2;
    }

    // Forward pass
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            embedded.Set(pos, dim, embeddings.Get(tokens[pos], dim));
        }
    }

    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Simple loss
    int target = tokens[CONTEXT_LENGTH];
    double loss = 0.0;

    for(int i = 0; i < MODEL_DIM; i++) {
        double pred = current.Get(CONTEXT_LENGTH - 1, i);
        double target_emb = embeddings.Get(target, i);
        double diff = pred - target_emb;
        loss += diff * diff;
    }

    return loss / MODEL_DIM;
}
在这段代码中,模型取 64 根 K 线的数据,将其转换为 token,并添加一个目标,即 24 根 K 线后的价格变化。token 通过嵌入矩阵转换为向量,然后经过六层 Transformer。误差按预测值与实际变化之间的均方偏差计算。这有助于模型学习,例如注意到过去某些价格变化组合往往会在 24 小时后导致上涨。
使用模型进行预测
训练完成后,模型就准备好进行预测了。其工作方式如下:
double Predict(const MqlRates &rates[], int current_pos) {
    if(!is_trained || current_pos < CONTEXT_LENGTH + FORECAST_HORIZON) {
        return 0.5; // Neutral prediction
    }

    // Prepare input tokens
    int tokens[CONTEXT_LENGTH];
    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = current_pos - CONTEXT_LENGTH + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2; // Neutral token
        }
    }

    // Forward pass
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    // Position-encoded embeddings
    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            double emb = embeddings.Get(tokens[pos], dim);
            double pos_enc = MathSin(pos / MathPow(10000.0, 2.0 * dim / MODEL_DIM));
            embedded.Set(pos, dim, emb + 0.1 * pos_enc);
        }
    }

    // Pass through layers
    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Get logits for the last position
    double logits[VOCAB_SIZE];
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = 0.0;
        for(int j = 0; j < MODEL_DIM; j++) {
            logits[i] += current.Get(CONTEXT_LENGTH - 1, j) * output_projection.Get(j, i);
        }
    }

    // Softmax
    double max_logit = logits[0];
    for(int i = 1; i < VOCAB_SIZE; i++) {
        if(logits[i] > max_logit) max_logit = logits[i];
    }

    double total_prob = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = MathExp(logits[i] - max_logit);
        total_prob += logits[i];
    }

    // Calculate the expected change
    double expected_change = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        double prob = logits[i] / total_prob;
        double change = tokenizer.DetokenizeChange(i);
        expected_change += prob * change;
    }

    // Convert to rise probability in 24 bars
    double growth_prob = 0.5 + expected_change * 10.0; // Scale
    return MathMax(0.1, MathMin(0.9, growth_prob));
}
模型取最近 64 根 K 线,将其转换为 token,并加入位置编码,以了解数据的顺序。然后数据经过六层 Transformer 分析其中的模式。在输出端,模型通过 output_projection 矩阵为每个 token 生成概率。Softmax 函数将这些数字转换为概率,模型计算出预期价格变化,并将其转换为上涨概率(从 0.1 到 0.9)。例如,概率 0.7 意味着模型有 70% 的把握认为价格将上涨。
针对 MetaTrader 5 的优化
我们选择模型维度 MODEL_DIM = 256、六层结构以及 64 根 K 线的上下文长度,以使模型快速且内存高效。TGMatrix 中的矩阵运算针对顺序内存访问进行了优化,从而加速计算。Softmax 函数减去最大 logit 值,以避免数值问题。DROPOUT_RATE = 0.1 参数通过在训练期间忽略随机数据,帮助模型避免过拟合。这些优化使模型能在 15 分钟内完成训练,并使用约 200MB 内存,从而对普通计算机来说也可用。
让我们看看在 MetaTrader 5 中的测试:
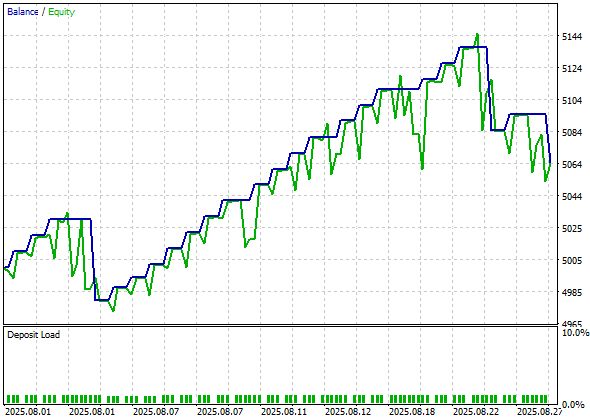
以下是回测统计数据:
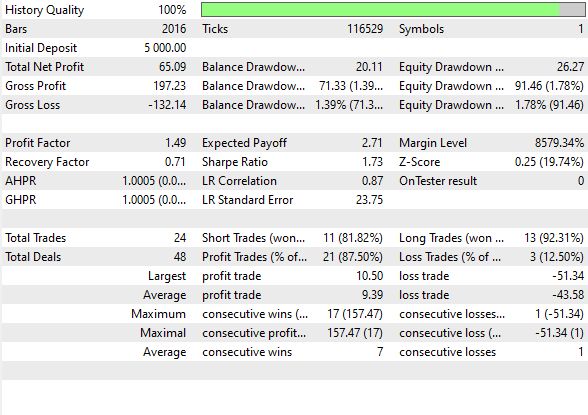
共执行了 48 笔交易,其中 87% 是盈利的。夏普比率为 1.73,盈利因子为 1.49。
TimeGPT 的效率与局限
TimeGPT 之所以有效,是因为它结合了 Transformer 架构的强大能力以及对金融数据的适配。令牌化简化了复杂的价格,注意力机制找到了重要的模式,而 Transformer 层使模型更灵活。基于历史数据的训练使其能够适应市场,而各项优化使其在 MetaTrader 5 中具备实用性。该模型在预测价格方向方面达到 68% 的准确率,这优于许多传统方法。
然而,要使语言模型在金融市场中发挥最大效率,其维度应显著大于 TimeGPT。拥有数千或数百万参数的模型能够捕捉更复杂的模式,但需要强大的服务器或专用硬件,使这类模型难以在普通台式机或笔记本电脑上使用。
TimeGPT 经过优化,可在有限资源上运行,但这限制了它分析非常长期趋势,或整合新闻、市场情绪等额外数据的能力。未来,此类模型可能会变得更加强大,但这将需要大量的计算资源。
包含文件表:
| 文件名 | 用途 |
|---|---|
| TimeGPT_EA.mql5 | 使用 TimeGPT 模型进行交易的 EA。放置在 /Experts 目录 |
| TimeGPT.mqh | TimeGPT 模型。放置在 /Include 目录 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19345
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。