

選択的状態空間モデルを採用したMambaベースのニューラルネットワーク自動売買ロボットの開発
 4
 3

現代のアルゴリズム取引には、根本的な問題があります。従来のニューラルネットワークアーキテクチャでは、Attention(アテンション)機構に基づくモデルが広く利用されていますが、その計算量はO(N²)となります。つまり、時系列の長さを2倍にすると、処理量は4倍になります。数千本ものローソク足からなる過去データを分析するトレーディングシステムにとって、この非効率性は重大な制約となります。
たとえば、ある取引システムが、エントリーを判断するために直近2048本の価格バーを分析する必要があるとします。Transformerでは、この長さの系列に対して約400万個のAttention計算が必要になります。そのため、処理に数秒を要する場合があります。高頻度取引(HFT)では、ミリ秒単位の遅延が取引結果を左右するため、このような遅延は、戦略の失敗に等しいと言えます。
さらに、現代の金融市場は、複雑化すると同時に市場間の相互連関も強まっています。精度の高い予測をおこなうためには、より長い過去データを分析し、異なる資産間や時間軸間の相関関係を考慮する必要があります。従来のアーキテクチャではこの課題に十分対応できず、分析可能なコンテキスト長が512~1024データポイント程度に制限されるケースもあります。
2024~2025年の時系列予測のトレンド:Mamba
2023年12月、カーネギーメロン大学の研究者らは、系列データ処理のための新しいアーキテクチャであるMambaを発表しました。Mambaは選択的状態空間モデル(SSM, Selective State Space Model)に基づいており、高い精度と線形計算量O(N)を両立することを特徴としています。この点が、Transformerモデルとの大きな違いです。
2024~2025年には、時系列予測の分野で、AttentionベースのアーキテクチャからSSMへと研究の関心が広がっています。その背景には、特に金融分野において、より長く、より複雑な系列を効率的に分析する必要性があります。
Mambaは、これまでのリカレント型アーキテクチャの発展の延長線上に位置付けることができます。単純なRNNから始まり、LSTMやGRUへと発展し、その後TransformerとAttention機構が大きな革新をもたらしました。そして現在、研究コミュニティは、原理的に新しいアプローチが必要だという認識に至りました。SSMを基盤とするMambaは、従来のアーキテクチャが持っていた複数の長所を組み合わせています。RNNの効率性、LSTMの長期記憶、Transformerの並列化可能性という、既存アーキテクチャの長所を統合しています。
こうした進化を後押ししているのが、マクロ経済サイクルや長期的な市場パターンを分析する必要性の高まりです。数百程度のデータポイントしか扱えない従来型モデルでは、季節性、数年単位のサイクル、異なる市場間の相関関係などを十分に捉えられない場合があります。理論上は無制限のコンテキスト長を備えるMambaは、計算効率を維持しながら、10年分のような長期間の履歴データを分析する可能性を開きます。
Mambaの中心的な考え方は、「選択的記憶(Selective Memory)」です。モデルは、重要なイベントを強調し、ノイズを無視することができます。これは金融データの分析において特に有用です。金融市場では、穏やかな値動きが続く期間と、突然の急激な変動が発生する期間が交互に現れるからです。Attention機構の代わりに、Mambaは、重要な情報が現れたときにのみ更新される、コンパクトな隠れ状態を使用します。このアプローチにより、モデルは長期間の時系列データに対してより高速かつ高精度な処理が可能になります。
// State Space Model fundamental equations
h(t+1) = A·h(t) + B·x(t)    // Update state
y(t) = C·h(t) + D·x(t)      // Output signal
ここで、h(t)は時刻tにおけるシステムの隠れ状態を表し、x(t)は入力信号(たとえば、ある資産の価格)を表します。また、行列A、B、C、Dはシステムのダイナミクス(状態の変化の仕方)を定義します。
Mambaとその前身モデルとの重要な違いは、これらの行列が静的なものではないという点です。つまり、入力データに応じて行列が適応的に変化し、情報を選択的に処理できるようになっています。
選択性:効率性の鍵
Mambaの最大の革新は、選択性にあります。従来の状態空間モデルでは、すべての入力データを基本的に同じように扱っていました。それに対してMambaは、重要な情報と重要でない情報を区別することができます。これにより、重要な出来事を「忘れて」しまうことを防ぐと同時に、ノイズが隠れ状態に蓄積していくことも抑えられます。
選択性のメカニズムでは、システムパラメータBとCが、入力データの関数になります。
void ApplySelectiveSSM(Matrix &input_data, Matrix &output) {
    // Dynamic adaptation of parameters
    for(int i = 0; i < input_data.cols; i++) {
        double input_val = input_data.Get(0, i);
        double selection_weight = Sigmoid(input_val);

        // Selective updating of parameters
        adaptive_B.Set(i, j, B.Get(i, j) * selection_weight);
        adaptive_C.Set(j, i, C.Get(j, i) * selection_weight);
    }
}
このアプローチにより、モデルは重要でない情報を「忘れる」ことができます。たとえば、ボラティリティが低い期間における小さな価格変動などです。一方で、重要な出来事を「記憶する」こともできます。たとえば、急激な価格変動や出来高の急増などです。
実装編:理論からコードへ
MQL5でMambaアーキテクチャを実装するには、その基盤となるデータ構造を慎重に設計する必要があります。中心となる要素がMatrix構造体です。これは、多次元配列を安全に扱うための機能を提供します。
struct Matrix {
    double data[];
    int rows, cols;

    Matrix() {
        rows = 0; cols = 0;
        ArrayResize(data, 0);
    }

    double Get(int r, int c) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }
};
Mambaブロックのアーキテクチャは、短期的な依存関係を捉える局所畳み込み、長期的な記憶を担う選択的SSM、そして情報の流れを制御するゲーティング機構という、複数のコンポーネントから構成されています。
struct MambaBlock {
    Matrix A, B, C, D;           // SSM parameters
    Matrix conv_weights;         // 1D convolution
    Matrix gate_weights;         // Gating
    Matrix state;               // Hidden state

    void Forward(Matrix &input_data, Matrix &output) {
        output.Init(input_data.rows, input_data.cols);

        for(int t = 0; t < input_data.rows; t++) {
            // Local processing via convolution
            Matrix conv_out;
            conv_out.Init(1, input_data.cols);
            ApplyConvolution(input_data, t, conv_out);

            // Selective processing via SSM
            Matrix gated;
            gated.Init(1, input_data.cols);
            ApplySelectiveSSM(conv_out, gated);

            // Residual connection for learning stability
            for(int j = 0; j < input_data.cols; j++) {
                double residual = input_data.Get(t, j);
                double processed = gated.Get(0, j);
                output.Set(t, j, residual + processed * 0.5);
            }
        }
    }
};
A行列の初期化には、特別な注意が必要です。研究によると、HiPPO(High-order Polynomial Projection Operators:高次多項式射影演算子)による初期化を使用することで、システムの記憶特性を最適化できます。
void InitializeHiPPOMatrix() {
    for(int i = 0; i < SSM_STATE_SIZE; i++) {
        for(int j = 0; j < SSM_STATE_SIZE; j++) {
            if(i == j) {
                A.Set(i, j, -1.0);  // Diagonal stabilization
            } else if(j < i) {
                A.Set(i, j, 0.1 / (i - j + 1));  // HiPPO weights
            }
        }
    }
}
時系列処理における重要な革新の一つが、パッチングという概念でした。これは、長い系列を短いセグメント(パッチ)に分割し、それぞれを1つのトークンとして処理する方法です。コンピュータビジョンから借用され、PatchTSTの研究で時系列に適用されたこの手法によって、計算負荷が大幅に軽減されます。
struct PatchEmbedding {
    Matrix patch_weights;
    Matrix position_embedding;

    void Forward(double &time_series[], Matrix &patches) {
        int num_patches = (ArraySize(time_series) / 2) / PATCH_SIZE;
        patches.Init(num_patches, HIDDEN_SIZE);

        for(int p = 0; p < num_patches; p++) {
            for(int h = 0; h < HIDDEN_SIZE; h++) {
                double sum = 0.0;

                // Handle a patch of PATCH_SIZE
                for(int i = 0; i < PATCH_SIZE; i++) {
                    int price_idx = (p * PATCH_SIZE + i) * 2;
                    int vol_idx = price_idx + 1;

                    if(price_idx < ArraySize(time_series)) {
                        sum += time_series[price_idx] * patch_weights.Get(i * 2, h);
                        sum += time_series[vol_idx] * patch_weights.Get(i * 2 + 1, h);
                    }
                }

                // Positional encoding to preserve temporal information
                sum += position_embedding.Get(p, h);
                patches.Set(p, h, sum);
            }
        }
    }
};
金融時系列におけるパッチングの適用は、特に効果的です。16個の時点からなる1つのパッチは、15分足チャートでは4時間の期間を、1時間足チャートでは1日の期間を表すことができます。これにより、モデルは個々の価格ポイントではなく、意味のある時間単位で処理できるようになります。
Mambaアーキテクチャの学習には、最新の最適化アルゴリズムを使用する必要があります。AdamW (Adam with Weight Decay)は、従来のAdamを改良したもので、不適切な正則化の問題を修正しています。
void UpdateWeightsAdamW(double grad_scale) {
    step_count++;
    double effective_lr = learning_rate * adaptive_lr_factor;
    double weight_decay = 0.01;

    for(int i = 0; i < output_projection.rows; i++) {
        for(int j = 0; j < output_projection.cols; j++) {
            double grad = grad_scale * 0.01;
            double weight = output_projection.Get(i, j);

            // Update moments
            double m = beta1 * output_m.Get(i, j) + (1 - beta1) * grad;
            double v = beta2 * output_v.Get(i, j) + (1 - beta2) * grad * grad;

            output_m.Set(i, j, m);
            output_v.Set(i, j, v);

            // Bias correction
            double m_hat = m / (1 - MathPow(beta1, step_count));
            double v_hat = v / (1 - MathPow(beta2, step_count));

            // Update with weight decay
            double update = effective_lr * (m_hat / (MathSqrt(v_hat) + epsilon) + weight_decay * weight);
            output_projection.Set(i, j, weight - update);
        }
    }
}
アーキテクチャ上の革新を詳しく見る
Mambaを深く理解するには、そのアーキテクチャを構成する要素を、数学的な演算のレベルで考える必要があります。選択性メカニズムは、従来のアプローチとの根本的な違いを示すものです。従来の状態空間モデルでは、パラメータBとCは時間の経過にかかわらず一定のままであり、その結果、入力の流れの変化する特性にモデルが適応できません。
Mambaの選択性メカニズムは、入力信号をシステムパラメータへと変換する射影関数を通じて実装されています。
Matrix ComputeSelectiveParameters(Matrix &input_sequence) {
    Matrix selective_B, selective_C;
    selective_B.Init(input_sequence.rows, SSM_STATE_SIZE);
    selective_C.Init(SSM_STATE_SIZE, input_sequence.rows);

    for(int t = 0; t < input_sequence.rows; t++) {
        // Projection of the input signal into the parameter space
        double input_norm = 0.0;
        for(int f = 0; f < input_sequence.cols; f++) {
            input_norm += input_sequence.Get(t, f) * input_sequence.Get(t, f);
        }
        input_norm = MathSqrt(input_norm);

        // Adaptive scaling of parameters
        double adaptation_factor = Tanh(input_norm * 0.1);

        for(int s = 0; s < SSM_STATE_SIZE; s++) {
            selective_B.Set(t, s, base_B.Get(t, s) * adaptation_factor);
            selective_C.Set(s, t, base_C.Get(s, t) * adaptation_factor);
        }
    }

    return selective_parameters;
}
このアプローチにより、モデルはさまざまな種類の入力情報に対する「感度」を動的に調整できるようになります。金融市場の文脈では、これはボラティリティが高い期間には注目度を高め、値動きが収束している期間にはそれを低下させる能力を意味します。
ハードウェアを考慮した最適化
Mambaが成功した重要な要因の一つは、最新のコンピューティングアーキテクチャに合わせて最適化されていることです。従来のSSMでは、時系列の各時点を順番に処理する必要があるため、並列コンピューティングにはあまり適していません。Mambaは、GPUアーキテクチャを効率的に利用できる並列スキャンアルゴリズムによって、この問題を解決しています。
void ParallelScanSSM(Matrix &input_sequence, Matrix &output_sequence) {
    int sequence_length = input_sequence.rows;
    Matrix cumulative_states;
    cumulative_states.Init(sequence_length, SSM_STATE_SIZE);

    // Phase 1: Upward scan
    for(int level = 0; level < (int)MathLog2(sequence_length); level++) {
        int step_size = 1 << level;

        for(int i = step_size; i < sequence_length; i += step_size * 2) {
            // Combine states using an associative operation
            CombineStates(cumulative_states, i - step_size, i);
        }
    }

    // Phase 2: Downward propagation
    for(int level = (int)MathLog2(sequence_length) - 1; level >= 0; level--) {
        int step_size = 1 << level;

        for(int i = step_size * 3; i < sequence_length; i += step_size * 2) {
            // Propagation of accumulated states
            PropagateStates(cumulative_states, i - step_size, i);
        }
    }

    // Generate output sequence
    GenerateOutput(cumulative_states, output_sequence);
}
この実装により、N個のプロセッサを使用して長さNの系列を処理する場合、O(log N)の時間計算量を実現でき、逐次的なO(N)アルゴリズムと比較して、スケーラビリティが大幅に向上します。
高度な初期化手法
SSMパラメータの初期化は、学習の安定性と長期記憶の質を確保する上で重要な役割を果たします。研究によると、HiPPO(High-order Polynomial Projection Operators:高次多項式射影演算子)による初期化を使用することで、連続関数に対する最適な近似特性が得られます。
void InitializeHiPPOAdvanced() {
    // Calculate the optimal HiPPO coefficients
    Matrix legendre_matrix;
    legendre_matrix.Init(SSM_STATE_SIZE, SSM_STATE_SIZE);

    for(int n = 0; n < SSM_STATE_SIZE; n++) {
        for(int k = 0; k < SSM_STATE_SIZE; k++) {
            if(n > k) {
                // Coefficients of Legendre polynomials
                double coeff = MathSqrt((2*n + 1) * (2*k + 1));
                if((n - k) % 2 == 1) coeff *= -1;
                legendre_matrix.Set(n, k, coeff);
            } else if(n == k) {
                legendre_matrix.Set(n, k, -(2*n + 1));
            }
        }
    }

    // Discretization for digital processing
    double time_scale = 1.0;
    Matrix discrete_A;
    discrete_A.Init(SSM_STATE_SIZE, SSM_STATE_SIZE);

    for(int i = 0; i < SSM_STATE_SIZE; i++) {
        for(int j = 0; j < SSM_STATE_SIZE; j++) {
            double continuous_val = legendre_matrix.Get(i, j);
            // Tustin transform for discretization
            double discrete_val = (2.0/time_scale - continuous_val) / (2.0/time_scale + continuous_val);
            discrete_A.Set(i, j, discrete_val);
        }
    }

    A = discrete_A;
}
この初期化により、モデルは長期的な依存関係を持つ関数を効果的に近似できるようになります。これは、複雑な周期成分やトレンド成分を持つ金融時系列を分析する上で重要です。
マルチスケール分析との統合
金融市場は、異なる時間スケール上に存在する構造によって特徴づけられます。日次のトレンドは週次のサイクルと相反することがあり、さらに週次のサイクルは月次や四半期ごとのパターンの中に組み込まれています。Mambaアーキテクチャは、マルチスケール処理によってこの問題に対処する洗練された方法を提供します。
struct MultiScaleMambaProcessor {
    MambaBlock scales[4];  // M5, M15, H1, H4
    Matrix fusion_weights;

    void Init() {
        // Different parameters for different scales
        for(int i = 0; i < 4; i++) {
            scales[i].Init();
            // Adapt the state size to the time scale
            int scale_state_size = SSM_STATE_SIZE * (i + 1);
            scales[i].ResizeState(scale_state_size);
        }

        fusion_weights.Init(4, HIDDEN_SIZE);
        fusion_weights.Random(0.1);
    }

    Matrix ProcessMultiScale(double &price_data[], int timeframes[]) {
        Matrix scale_outputs[4];

        for(int scale = 0; scale < 4; scale++) {
            // Resample data for the appropriate timeframe
            double resampled_data[];
            ResampleData(price_data, timeframes[scale], resampled_data);

            // Process using the corresponding Mamba block
            Matrix scale_input;
            PrepareScaleInput(resampled_data, scale_input);
            scales[scale].Forward(scale_input, scale_outputs[scale]);
        }

        // Merge information from different scales
        Matrix fused_output;
        FuseMultiScaleOutputs(scale_outputs, fused_output);

        return fused_output;
    }

private:
    void FuseMultiScaleOutputs(Matrix scale_outputs[], Matrix &fused) {
        fused.Init(scale_outputs[0].rows, HIDDEN_SIZE);

        for(int t = 0; t < fused.rows; t++) {
            for(int h = 0; h < HIDDEN_SIZE; h++) {
                double weighted_sum = 0.0;
                double total_weight = 0.0;

                for(int scale = 0; scale < 4; scale++) {
                    if(t < scale_outputs[scale].rows && h < scale_outputs[scale].cols) {
                        double weight = fusion_weights.Get(scale, h);
                        weighted_sum += scale_outputs[scale].Get(t, h) * weight;
                        total_weight += weight;
                    }
                }

                fused.Set(t, h, total_weight > 0 ? weighted_sum / total_weight : 0.0);
            }
        }
    }
};
Mambaモデルの学習には、SSMアーキテクチャ特有の性質に適応した、専用のアプローチが必要です。重要な問題の一つは、再帰的な計算における勾配を安定させることです。
void StabilizedTraining(double &training_data[], double targets[]) {
    double gradient_norm_threshold = 1.0;
    double stability_factor = 0.99;

    for(int epoch = 0; epoch < training_epochs; epoch++) {
        double epoch_loss = 0.0;
        int batch_count = 0;

        for(int batch = 0; batch < num_batches; batch++) {
            // Forward pass with gradient tracking
            Matrix intermediate_states[NUM_LAYERS];
            double prediction = ForwardWithGradientTracing(training_data, intermediate_states);

            double loss = ComputeLoss(prediction, targets[batch]);
            epoch_loss += loss;

            // Calculate gradients with regularization
            Matrix gradients[NUM_LAYERS];
            ComputeRegularizedGradients(loss, intermediate_states, gradients);

            // Check the stability of gradients
            double grad_norm = ComputeGradientNorm(gradients);
            if(grad_norm > gradient_norm_threshold) {
                // Scale gradients to prevent explosion
                ScaleGradients(gradients, gradient_norm_threshold / grad_norm);
            }

            // Update parameters with exponential smoothing
            UpdateParametersSmoothed(gradients, stability_factor);
            batch_count++;
        }

        double avg_loss = epoch_loss / batch_count;

        // Adaptive learning rate correction
        if(epoch > 0 && avg_loss > previous_loss * 1.1) {
            learning_rate *= 0.8;  // Decrease in case of instability
        } else if(avg_loss < previous_loss * 0.95) {
            learning_rate *= 1.05; // Increase with stable improvement
        }

        previous_loss = avg_loss;

        Print("Epoch ", epoch, " | Loss: ", DoubleToString(avg_loss, 6),
              " | LR: ", DoubleToString(learning_rate, 6));
    }
}
Mambaアーキテクチャを実運用の取引システムに実装するには、多くの実務上の要因を考慮する必要があります。パフォーマンス監視システムでは、予測の精度だけでなく、モデルの内部状態の安定性も監視する必要があります。
struct MambaMonitoringSystem {
    double state_stability_threshold;
    double prediction_variance_limit;
    int monitoring_window;

    bool MonitorSystemHealth() {
        // Check the stability of internal states
        double state_variance = ComputeStateVariance();
        if(state_variance > state_stability_threshold) {
            Print("WARNING: High state variance detected: ", state_variance);
            return false;
        }

        // Analysis of the consistency of predictions
        double prediction_variance = ComputePredictionVariance();
        if(prediction_variance > prediction_variance_limit) {
            Print("WARNING: Prediction instability: ", prediction_variance);
            return false;
        }

        // Check gradients for anomalies
        if(DetectGradientAnomalies()) {
            Print("WARNING: Gradient anomalies detected");
            TriggerModelReinitialization();
            return false;
        }

        return true;
    }

private:
    double ComputeStateVariance() {
        double variance_sum = 0.0;
        for(int layer = 0; layer < NUM_LAYERS; layer++) {
            Matrix layer_state = mamba_layers[layer].GetCurrentState();
            double layer_variance = 0.0;
            double layer_mean = 0.0;

            // Calculate the average
            for(int i = 0; i < layer_state.rows * layer_state.cols; i++) {
                layer_mean += layer_state.data[i];
            }
            layer_mean /= (layer_state.rows * layer_state.cols);

            // Calculating the variance
            for(int i = 0; i < layer_state.rows * layer_state.cols; i++) {
                double diff = layer_state.data[i] - layer_mean;
                layer_variance += diff * diff;
            }
            layer_variance /= (layer_state.rows * layer_state.cols);

            variance_sum += layer_variance;
        }

        return variance_sum / NUM_LAYERS;
    }
};
今後の研究方向
Mambaアーキテクチャの発展は、さらなる研究のための複数の方向性を切り開いています。強化学習アルゴリズムとの統合により、変化する市場環境の中で自己学習できる適応型取引エージェントの開発が可能になると考えられます。
Mambaを用いたFew-shot学習の研究によって、最小限の学習データで新しい金融商品に迅速に適応できるモデルにつながる可能性があります。これは、特に新興市場や新しい暗号通貨において重要です。
Mambaとメタ学習技術を組み合わせることで、手動によるパラメータ調整を必要とせず、さまざまな市場環境に自動的に適応できる汎用的な取引システムを構築できる可能性が開かれます。
実装に関する実践的な推奨事項
実際の取引環境におけるMambaの性能をテストするため、ModernAI_Expert.mq5というEAが開発されました。これは、MetaTrader 5エコシステムにおけるSSMの本格的な実装です。その目的は、アルゴリズム取引における最新の機械学習手法の実用的な適用例を示すことです。
このEAは、純粋なAIアプローチの原則に基づいて構築されており、すべての取引判断はニューラルネットワークの予測のみに基づいておこなわれます。ハイブリッド型システムとは異なり、ModernAI_Expertは、従来のテクニカル指標を使用せず、Mambaアーキテクチャが市場データに潜むパターンを識別する能力に全面的に依存しています。SSMの基本実装では、最大200本の入力バーに対応し、分析の深さを設定できるほか、24時間ごとのモデル自動再学習や、信頼度の閾値を設定可能なインテリジェントなシグナルフィルタリングを備えています。
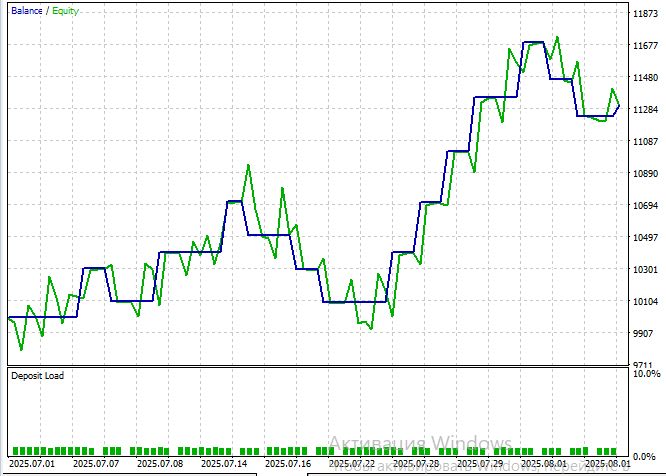
ModernAI_Expertは、高度な入力データの正規化システムを実装しています。これは、ニューラルネットワークを安定して動作させる上で重要です。このシステムでは、正規化された価格変化と対数スケール化された出来高を処理することで、学習の安定性を確保し、一方の種類のデータが他方を支配することを防ぎます。このアプローチは、変動が大きく、活動が突発的に急増しうる金融時系列において、特に重要です。
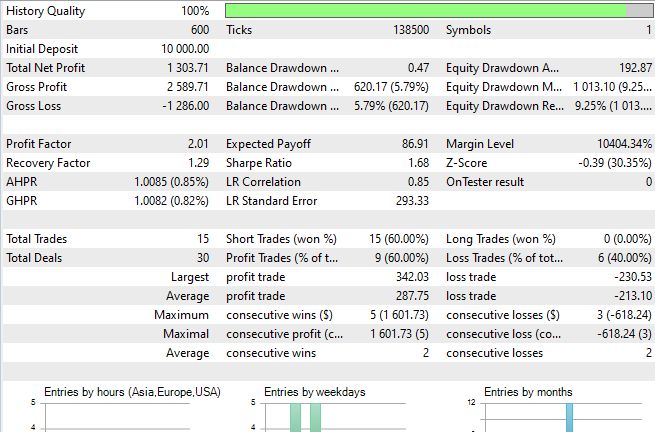
ModernAI_Expertの主な特徴は、動的なポジション管理です。取引量は標準的なリスク管理ルールだけでなく、AIモデルの信頼度にも依存します。各取引にはこの信頼度を示すコメントが付加されるため、トレーダーはリアルタイムで判断の質を評価できます。
もう一つの重要な機能は、インテリジェントな決済シグナルです。ポジションは、ストップロスやテイクプロフィットだけで決済されるのではなく、モデルのセンチメントが変化した場合にも決済されます。ロングポジションは信頼度が40%を下回った場合に決済され、ショートポジションは信頼度が60%を上回った場合に決済されます。これにより、従来のストップが発動する前に、システムが市場環境の変化に対応できるようになります。
結論
Mambaアーキテクチャは、Transformerモデルが抱える二次計算量という根本的な問題を解決することで、アルゴリズム取引における画期的なブレークスルーをもたらします。O(N)の線形計算量への移行と選択的記憶機構によって、計算効率を維持しながら、極めて長い時系列を分析できる可能性が開かれます。
ModernAI_Expert.mq5という形での実用的な実装は、従来のテクニカル指標を使用しない純粋なAIアプローチを示すことで、この技術が実運用に使用できる段階にあることを証明しています。
主な知見
Mambaアーキテクチャの主な成果は、計算面でのブレークスルーです。二次計算量から線形計算量への移行により、性能を損なうことなく数千本のバーを分析できるようになります。選択的記憶機構は情報を適応的にフィルタリングし、重要なイベントに焦点を当てながら市場ノイズを無視します。このシステムのスケーラビリティによって、長期的な過去データを分析し、マクロ経済サイクルを特定できる可能性が開かれます。
この技術の本番運用への適用可能性は、モデルの信頼度に基づく動的なポジション管理とともにMetaTrader 5へ統合されたことによって確認されています。これは、ハイブリッド型システムから、取引意思決定における純粋なAIアプローチへのパラダイムシフトを意味します。
Mambaは、長い系列を効率的に処理する能力と、変化する市場環境への適応性を組み合わせた、アルゴリズム取引の新しい時代を切り開きます。
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19047
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 量子リザバコンピューティング(QRC)回路の実装
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 自動売買ロボット向けリスクマネージャー(第1回):EA向けリスク管理用インクルードファイル

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
ModernTimeSeriesNet.mqh ファイルをコンパイルすると、次のようなエラーが発生します:- undeclare
こんにちは!記事の最新版に最新のバージョンを添付しました。以前のバージョンでは、EAはそのままコンパイルできていましたが、問題は必要な変数がmqhではなくEA内で定義されていたことにありました。
こんにちは!記事の最新版に最新のバージョンを添付しました。以前のバージョンでは、アドバイザーはそのままコンパイルできていましたが、問題は変数がmではなくEA内で定義されていた点にありました。
ありがとうございます、すべて正常に動作するようになりました。