

Robot de trading basado en un modelo GPT
 38
 2

Introducción
TimeGPT es un modelo de aprendizaje automático diseñado para predecir los movimientos de precios en los mercados financieros, como los pares de divisas o las acciones, en la plataforma MetaTrader 5. Se basa en la arquitectura Transformer, que se creó inicialmente para trabajar con textos —por ejemplo, para la traducción o la generación de texto—, pero que en este caso se ha adaptado para el análisis de datos financieros. En este artículo explicaré detalladamente cómo se crea TimeGPT, desglosando paso a paso su estructura, el procesamiento de datos, el entrenamiento y la predicción. Todo se explicará en un lenguaje sencillo, con analogías, para que incluso alguien que esté empezando a estudiar el aprendizaje automático pueda entender cómo se crea un modelo de este tipo. Al final, también abordaré las limitaciones del modelo y sus requisitos en cuanto a recursos informáticos.
¿Qué se necesita para crear un modelo como TimeGPT?Antes de adentrarnos en el código, es importante comprender con qué trabaja TimeGPT. Los mercados financieros generan datos en forma de series temporales: se trata de una secuencia de precios registrados a intervalos regulares, por ejemplo, cada hora. Los precios en el mercado no se rigen por reglas sencillas: pueden dispararse bruscamente a raíz de una noticia, caer lentamente o fluctuar sin motivo aparente. El objetivo de TimeGPT es detectar patrones en estos datos y predecir cómo cambiará el precio en 24 horas, lo que en los gráficos de mercado se conoce como «24 barras».
El desarrollo de un modelo requiere resolver varias tareas. En primer lugar, hay que determinar cómo almacenar y procesar los datos sobre los precios. A continuación, hay que convertir esos datos a un formato que el modelo pueda entender. Luego hay que diseñar la arquitectura del modelo para que pueda detectar relaciones complejas en los datos. Después se entrena el modelo con datos históricos para que aprenda a realizar predicciones precisas, y por último, es importante optimizar el modelo para que funcione con rapidez y no requiera demasiada memoria, considerando las limitaciones de la plataforma MetaTrader 5. Ahora analizaremos cada una de estas etapas, basándonos en el código del archivo TimeGPT_Fixed.mqh.
Desarrollo del modelo
Creación de una estructura para trabajar con datos El primer paso en el desarrollo de TimeGPT fue crear una estructura para almacenar y procesar datos. En el aprendizaje automático, los datos suelen representarse en forma de matrices, es decir, tablas con números que resultan muy prácticas para realizar operaciones matemáticas. Para ello, en TimeGPT se ha creado la estructura TGMatrix, que permite almacenar números, como precios o parámetros del modelo, de forma ordenada.
Este es el código de esta estructura:
struct TGMatrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r;
        cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) const {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void RandomInit(double scale = -1.0) {
        if(scale < 0) scale = MathSqrt(2.0 / (rows + cols));
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
        }
    }

    void Add(const TGMatrix &other) {
        if(rows != other.rows || cols != other.cols) return;
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] += other.data[i];
        }
    }

    void Copy(const TGMatrix &other) {
        Init(other.rows, other.cols);
        for(int i = 0; i < ArraySize(other.data); i++) {
            data[i] = other.data[i];
        }
    }

    void Scale(double factor) {
        for(int i = 0; i < ArraySize(data); i++) {
            data[i] *= factor;
        }
    }
};
Imagina TGMatrix como una tabla de Excel, en la que los números se almacenan en filas y columnas. El método Init crea una tabla del tamaño deseado; Get y Set permiten leer y escribir valores en celdas concretas; RandomInit rellena la tabla con números aleatorios, necesarios para la configuración inicial del modelo; y los métodos Add, Copy y Scale realizan operaciones básicas, como la suma de dos tablas o la multiplicación de todos los números por un valor determinado. Esta estructura se ha convertido en la base para trabajar con datos en TimeGPT, ya que todos los precios, los parámetros del modelo y los cálculos utilizan matrices. Hemos optado por este enfoque porque es sencillo y funciona bien en MetaTrader 5, donde no se pueden utilizar bibliotecas complejas como en Python.
Conversión de los precios a un formato comprensible para el modeloPara que el modelo pueda analizar los precios, es necesario convertirlos a un formato adecuado. TimeGPT toma prestada una idea del procesamiento de textos: cada variación del precio se convierte en un «token», es decir, un número que representa el movimiento del precio, por ejemplo, un aumento del 0,5 % o una caída del 0,3 %. Para ello, se ha creado la estructura ImprovedTokenizer.
Este es su código:
struct ImprovedTokenizer {
    double price_mean, price_std;
    double change_mean, change_std;
    bool is_trained;

    ImprovedTokenizer() {
        is_trained = false;
        price_mean = 0; price_std = 1;
        change_mean = 0; change_std = 1;
    }

    void Train(const MqlRates &rates[]) {
        int size = ArraySize(rates);
        if(size < FORECAST_HORIZON + 10) return;

        // Calculamos las estadísticas de los precios
        double sum_price = 0, sum_price_sq = 0;
        double changes[];
        ArrayResize(changes, size - FORECAST_HORIZON);

        for(int i = FORECAST_HORIZON; i < size; i++) {
            double price = rates[i].close;
            sum_price += price;
            sum_price_sq += price * price;

            // Variación del precio tras 24 barras
            changes[i - FORECAST_HORIZON] = (rates[i].close - rates[i - FORECAST_HORIZON].close) / rates[i - FORECAST_HORIZON].close;
        }

        price_mean = sum_price / size;
        price_std = MathSqrt(sum_price_sq / size - price_mean * price_mean);
        if(price_std < EPSILON) price_std = 1.0;

        // Estadísticas de las variaciones a 24 barras
        double sum_change = 0, sum_change_sq = 0;
        for(int i = 0; i < ArraySize(changes); i++) {
            sum_change += changes[i];
            sum_change_sq += changes[i] * changes[i];
        }

        change_mean = sum_change / ArraySize(changes);
        change_std = MathSqrt(sum_change_sq / ArraySize(changes) - change_mean * change_mean);
        if(change_std < EPSILON) change_std = 1.0;

        is_trained = true;
        Print("Tokenizer trained for 24-bar changes: change_std=", DoubleToString(change_std, 6));
    }

    int TokenizeChange(double change) {
        if(!is_trained) return VOCAB_SIZE / 2;

        // Normalizamos y cuantizamos
        double normalized = (change - change_mean) / change_std;
        normalized = MathMax(-3.0, MathMin(3.0, normalized)); // Aplicamos clamp

        int token = (int)((normalized + 3.0) / 6.0 * (VOCAB_SIZE - 1));
        return MathMax(0, MathMin(VOCAB_SIZE - 1, token));
    }

    double DetokenizeChange(int token) {
        if(!is_trained || token < 0 || token >= VOCAB_SIZE) return 0.0;

        double normalized = (double)token / (VOCAB_SIZE - 1) * 6.0 - 3.0;
        return normalized * change_std + change_mean;
    }
};
El tokenizador funciona de la siguiente manera. El método Train analiza los precios de cierre históricos de las velas, por ejemplo, de las últimas 2.000 horas, y calcula cómo han variado al cabo de 24 barras. Si el precio era de 100 $ y, 24 horas después, pasó a ser de 102 $, la variación será de (102 - 100) / 100 = 2 %. A continuación, el tokenizador calcula la media y la desviación estándar de todas las variaciones para llevarlas a una escala común. Es como ajustar una regla para medir todos los cambios en las mismas unidades. El método TokenizeChange convierte cada cambio en un número comprendido entre 0 y 255 (el tamaño del diccionario es VOCAB_SIZE = 256); por ejemplo, un aumento del 2 % puede convertirse en el token «150». El método DetokenizeChange realiza la conversión inversa, para saber qué cambio de precio corresponde a cada token.
Este enfoque es importante porque los precios brutos pueden variar mucho: una acción cuesta 10 $ y otra, 1.000 $. La conversión en tokens simplifica los datos para el modelo, lo que le permite trabajar con números dentro de un mismo rango, al igual que con texto, en el que cada palabra tiene su propio código.
Construcción del mecanismo de atenciónLa parte fundamental de TimeGPT es el mecanismo de atención, implementado en la estructura SimpleAttention. Permite que el modelo se centre en las variaciones importantes de los precios en el pasado, ignorando las menos significativas. Imagina que estás leyendo un libro largo y solo destacas los puntos clave que te ayudan a entender la trama. El mecanismo de atención hace lo mismo a la hora de determinar qué datos sobre los precios son importantes para la previsión.
Este es el código del mecanismo de atención:
struct SimpleAttention {
    TGMatrix W_q, W_k, W_v, W_o;
    double scale;

    void Init() {
        W_q.Init(MODEL_DIM, MODEL_DIM);
        W_k.Init(MODEL_DIM, MODEL_DIM);
        W_v.Init(MODEL_DIM, MODEL_DIM);
        W_o.Init(MODEL_DIM, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W_q.RandomInit(init_scale);
        W_k.RandomInit(init_scale);
        W_v.RandomInit(init_scale);
        W_o.RandomInit(init_scale);

        scale = 1.0 / MathSqrt(HEAD_DIM);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        // Atención multicabeza
        for(int head = 0; head < NUM_HEADS; head++) {
            int head_start = head * HEAD_DIM;

            // Proyecciones simples para esta cabeza
            TGMatrix head_output;
            head_output.Init(seq_len, HEAD_DIM);

            for(int i = 0; i < seq_len; i++) {
                // Calculamos la atención únicamente sobre las posiciones anteriores
                double total_weight = 0.0;
                double weighted_values[HEAD_DIM];
                ArrayInitialize(weighted_values, 0.0);

                for(int j = 0; j <= i; j++) {
                    // Producto escalar simple para el peso de la atención
                    double attention_weight = 0.0;
                    for(int k = head_start; k < head_start + HEAD_DIM; k++) {
                        attention_weight += inp_data.Get(i, k) * inp_data.Get(j, k);
                    }
                    attention_weight = MathExp(attention_weight * scale);
                    total_weight += attention_weight;

                    // Acumulamos los valores ponderados
                    for(int k = 0; k < HEAD_DIM; k++) {
                        weighted_values[k] += attention_weight * inp_data.Get(j, head_start + k);
                    }
                }

                // Normalizamos y guardamos
                if(total_weight > EPSILON) {
                    for(int k = 0; k < HEAD_DIM; k++) {
                        head_output.Set(i, k, weighted_values[k] / total_weight);
                    }
                }
            }

            // Copiamos el resultado de la cabeza en la matriz de salida
            for(int i = 0; i < seq_len; i++) {
                for(int j = 0; j < HEAD_DIM; j++) {
                    output.Set(i, head_start + j, head_output.Get(i, j));
                }
            }
        }
    }
};
El mecanismo de atención divide los datos en seis partes, denominadas «cabezas» (NUM_HEADS = 6), cada una de las cuales busca sus propios patrones, como saltos de precio a corto plazo o tendencias a largo plazo. El método Init crea las matrices W_q, W_k, W_v y W_o, que se utilizan para transformar los datos, y las rellena con números aleatorios. En el método Forward, el modelo calcula la importancia que tiene cada posición anterior de la secuencia para la posición actual, utilizando el producto escalar y la función MathExp.
Es importante que el modelo solo tenga en cuenta los datos hasta la posición actual (j <= i), para no «mirar» el futuro; esto se denomina «enmascaramiento causal». Los pesos de atención se normalizan para que su suma sea igual a uno, y se utilizan para ponderar los datos, como si el modelo dijera: «Este momento tiene una importancia del 70 %, mientras que aquel solo tiene un 20 %».
Este mecanismo permite a TimeGPT detectar relaciones complejas entre las variaciones de precios, incluso si se produjeron hace mucho tiempo, lo que hace a TimeGPT más potente que los modelos anteriores, que «olvidan» rápidamente los datos del pasado.
Montaje de las capas de TransformerTimeGPT consta de seis capas (NUM_LAYERS = 6), cada una de las cuales incluye un mecanismo de atención y un procesamiento adicional de los datos mediante una red feed-forward (FFN). Es como un filtro que mejora progresivamente la comprensión de los datos al pasar por varias etapas de procesamiento.
Este es el código de una capa:
struct TransformerLayer {
    SimpleAttention attention;
    SimpleFeedForward ffn;

    void Init() {
        attention.Init();
        ffn.Init();
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        // Atención con conexión residual
        TGMatrix attn_out;
        attention.Forward(inp_data, attn_out);

        TGMatrix residual1;
        residual1.Copy(inp_data);
        residual1.Add(attn_out);

        // FFN con conexión residual
        TGMatrix ffn_out;
        ffn.Forward(residual1, ffn_out);

        output.Copy(residual1);
        output.Add(ffn_out);
    }
};
Cada capa aplica primero un mecanismo de atención para destacar las partes importantes de los datos y, a continuación, añade los datos originales al resultado (lo que se denomina «conexión residual») para no perder información. A continuación, los datos pasan por una red feed-forward, que introduce una no linealidad que permite detectar patrones complejos. Otra conexión residual suma el resultado de la FFN a los datos tras la atención, manteniendo la estabilidad.
Así se ve la FFN:
struct SimpleFeedForward {
    TGMatrix W1, W2, b1, b2;

    void Init() {
        W1.Init(MODEL_DIM, FFN_DIM);
        W2.Init(FFN_DIM, MODEL_DIM);
        b1.Init(1, FFN_DIM);
        b2.Init(1, MODEL_DIM);

        double init_scale = MathSqrt(2.0 / MODEL_DIM);
        W1.RandomInit(init_scale);
        W2.RandomInit(init_scale);
    }

    void Forward(const TGMatrix &inp_data, TGMatrix &output) {
        int seq_len = inp_data.rows;
        output.Init(seq_len, MODEL_DIM);

        for(int i = 0; i < seq_len; i++) {
            // Primera capa con ReLU
            double hidden[FFN_DIM];
            for(int j = 0; j < FFN_DIM; j++) {
                hidden[j] = b1.Get(0, j);
                for(int k = 0; k < MODEL_DIM; k++) {
                    hidden[j] += inp_data.Get(i, k) * W1.Get(k, j);
                }
                hidden[j] = MathMax(0.0, hidden[j]); // ReLU
            }

            // Segunda capa
            for(int j = 0; j < MODEL_DIM; j++) {
                double sum = b2.Get(0, j);
                for(int k = 0; k < FFN_DIM; k++) {
                    sum += hidden[k] * W2.Get(k, j);
                }
                output.Set(i, j, sum);
            }
        }
    }
};
La FFN toma los datos y los transforma a través de dos capas: la primera amplía los datos hasta un tamaño de FFN_DIM = 256 y aplica la función ReLU, que pone a cero los valores negativos, añadiendo así no linealidad; y la segunda comprime los datos de nuevo hasta MODEL_DIM = 256. Esto ayuda al modelo a detectar combinaciones complejas de variaciones de precios que no son perceptibles mediante métodos lineales sencillos.
Las capas del Transformer constituyen la base del modelo. Cada capa mejora la comprensión de los datos, y las seis capas permiten detectar patrones cada vez más complejos. Las conexiones residuales hacen que el entrenamiento sea estable, evitando la pérdida de información.
Integración de los componentes en el modelo TimeGPTUna vez creadas todas las partes, las reuniremos en un único modelo FixedTimeGPT. Esta es su estructura:
struct FixedTimeGPT {
    ImprovedTokenizer tokenizer;
    TGMatrix embeddings;
    TransformerLayer layers[NUM_LAYERS];
    TGMatrix output_projection;
    double learning_rate;
    int training_steps;
    bool is_trained;

    void Init() {
        embeddings.Init(VOCAB_SIZE, MODEL_DIM);
        embeddings.RandomInit(0.1);

        for(int i = 0; i < NUM_LAYERS; i++) {
            layers[i].Init();
        }

        output_projection.Init(MODEL_DIM, VOCAB_SIZE);
        output_projection.RandomInit(0.1);

        learning_rate = LEARNING_RATE;
        training_steps = 0;
        is_trained = false;

        Print("Fixed TimeGPT initialized for 24-bar forecast");
    }
};
Esta estructura agrupa todos los componentes. El tokenizador convierte los precios en tokens. La matriz de embeddings convierte cada token en un vector numérico de 256 dimensiones, para que el modelo pueda tratarlo como si fuera la descripción de una palabra. Seis capas de Transformer procesan los datos para detectar patrones. La matriz output_projection transforma el resultado de la última capa en probabilidades para cada token (de 0 a 255) con el fin de predecir la próxima variación del precio. El parámetro learning_rate determina la tasa de aprendizaje del modelo, mientras que training_steps lleva el seguimiento del número de pasos de entrenamiento.
Esta estructura es lo suficientemente sencilla como para funcionar en MetaTrader 5, pero al mismo tiempo tiene la potencia necesaria para detectar patrones complejos.
Entrenamiento del modelo
El entrenamiento es un proceso en el que el modelo analiza los datos históricos y ajusta sus parámetros para realizar predicciones precisas. Así es como se ha implementado:
void TrainOnData(string symbol, ENUM_TIMEFRAMES timeframe, int total_bars, int epochs) {
    Print("Training Fixed TimeGPT for 24-bar forecast on ", total_bars, " bars, ", epochs, " epochs...");

    // Obtenemos los datos
    MqlRates rates[];
    ArraySetAsSeries(rates, false); // Orden cronológico
    if(CopyRates(symbol, timeframe, 0, total_bars, rates) <= 0) {
        Print("Failed to copy rates");
        return;
    }

    // Entrenamos el tokenizador para las variaciones tras 24 barras
    tokenizer.Train(rates);

    // Preparamos las secuencias para el entrenamiento
    int num_sequences = total_bars - CONTEXT_LENGTH - FORECAST_HORIZON - 1;
    if(num_sequences <= 0) {
        Print("Not enough data for training");
        return;
    }

    // Ciclo de entrenamiento
    for(int epoch = 0; epoch < epochs; epoch++) {
        Print("Epoch ", epoch + 1, "/", epochs);
        double total_loss = 0.0;
        int batch_count = 0;

        // Procesamos las secuencias
        for(int start = 0; start < num_sequences; start += CONTEXT_LENGTH/2) {
            if(start + CONTEXT_LENGTH + FORECAST_HORIZON >= ArraySize(rates)) break;

            double loss = TrainStep(rates, start);
            total_loss += loss;
            batch_count++;
            training_steps++;

            // Reducción de la tasa de aprendizaje
            if(training_steps % 100 == 0) {
                learning_rate *= 0.99;
            }
        }

        if(batch_count > 0) {
            Print("Average loss: ", DoubleToString(total_loss / batch_count, 6));
        }
    }

    is_trained = true;
    Print("Training completed. Total steps: ", training_steps);
}
El modelo carga los precios históricos, por ejemplo, de 2.000 barras, para un par de divisas como el EUR/USD, en un gráfico horario. El tokenizador analiza los datos para identificar las variaciones típicas del precio. A continuación, el modelo recorre los datos varias veces (tres épocas), tomando cada vez una secuencia de 64 barras (CONTEXT_LENGTH = 64) e intentando predecir la variación del precio al cabo de 24 barras.
El método TrainStep calcula el error (loss) —la diferencia entre la predicción y la variación real— y ajusta los parámetros del modelo para reducir dicho error. Cada 100 pasos, la tasa de aprendizaje se reduce un 1 %, para que el modelo aprenda con más cautela y evite los errores graves.
Este es el aspecto de TrainStep:
double TrainStep(const MqlRates &rates[], int start_pos) {
    // Un sencillo paso de entrenamiento para la predicción a 24 barras
    int tokens[CONTEXT_LENGTH + 1];

    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = start_pos + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2;
        }
    }

    // Objetivo: cambio tras 24 barras
    int target_idx = start_pos + CONTEXT_LENGTH + FORECAST_HORIZON;
    if(target_idx < ArraySize(rates) && start_pos + CONTEXT_LENGTH > 0) {
        double change = (rates[target_idx].close - rates[target_idx - FORECAST_HORIZON].close) / rates[target_idx - FORECAST_HORIZON].close;
        tokens[CONTEXT_LENGTH] = tokenizer.TokenizeChange(change);
    } else {
        tokens[CONTEXT_LENGTH] = VOCAB_SIZE / 2;
    }

    // Propagación directa
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            embedded.Set(pos, dim, embeddings.Get(tokens[pos], dim));
        }
    }

    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Pérdida simple
    int target = tokens[CONTEXT_LENGTH];
    double loss = 0.0;

    for(int i = 0; i < MODEL_DIM; i++) {
        double pred = current.Get(CONTEXT_LENGTH - 1, i);
        double target_emb = embeddings.Get(target, i);
        double diff = pred - target_emb;
        loss += diff * diff;
    }

    return loss / MODEL_DIM;
}
En este código, el modelo toma 64 barras de datos, las convierte en tokens y añade un objetivo: la variación del precio al cabo de 24 barras. Los tokens se transforman en vectores mediante una matriz de embeddings y, a continuación, pasan por seis capas del Transformer. El error se calcula como el error cuadrático medio entre la predicción y la variación real. Esto ayuda al modelo a aprender, por ejemplo, a detectar que determinadas combinaciones de variaciones del precio en el pasado suelen provocar una subida 24 horas después.
Predicción con el modelo
Una vez entrenado, el modelo está listo para realizar predicciones. Así es como funciona:
double Predict(const MqlRates &rates[], int current_pos) {
    if(!is_trained || current_pos < CONTEXT_LENGTH + FORECAST_HORIZON) {
        return 0.5; // Predicción neutra
    }

    // Preparamos los tokens de entrada
    int tokens[CONTEXT_LENGTH];
    for(int i = 0; i < CONTEXT_LENGTH; i++) {
        int idx = current_pos - CONTEXT_LENGTH + i;
        if(idx > 0 && idx < ArraySize(rates)) {
            double change = (rates[idx].close - rates[idx-1].close) / rates[idx-1].close;
            tokens[i] = tokenizer.TokenizeChange(change);
        } else {
            tokens[i] = VOCAB_SIZE / 2; // Token neutro
        }
    }

    // Propagación directa
    TGMatrix embedded;
    embedded.Init(CONTEXT_LENGTH, MODEL_DIM);

    // Embeddings con codificación posicional
    for(int pos = 0; pos < CONTEXT_LENGTH; pos++) {
        for(int dim = 0; dim < MODEL_DIM; dim++) {
            double emb = embeddings.Get(tokens[pos], dim);
            double pos_enc = MathSin(pos / MathPow(10000.0, 2.0 * dim / MODEL_DIM));
            embedded.Set(pos, dim, emb + 0.1 * pos_enc);
        }
    }

    // Paso por las capas
    TGMatrix current;
    current.Copy(embedded);

    for(int i = 0; i < NUM_LAYERS; i++) {
        TGMatrix layer_out;
        layers[i].Forward(current, layer_out);
        current.Copy(layer_out);
    }

    // Obtenemos los logits de la última posición
    double logits[VOCAB_SIZE];
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = 0.0;
        for(int j = 0; j < MODEL_DIM; j++) {
            logits[i] += current.Get(CONTEXT_LENGTH - 1, j) * output_projection.Get(j, i);
        }
    }

    // Softmax
    double max_logit = logits[0];
    for(int i = 1; i < VOCAB_SIZE; i++) {
        if(logits[i] > max_logit) max_logit = logits[i];
    }

    double total_prob = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        logits[i] = MathExp(logits[i] - max_logit);
        total_prob += logits[i];
    }

    // Calculamos la variación esperada
    double expected_change = 0.0;
    for(int i = 0; i < VOCAB_SIZE; i++) {
        double prob = logits[i] / total_prob;
        double change = tokenizer.DetokenizeChange(i);
        expected_change += prob * change;
    }

    // Convertimos en probabilidad de subida tras 24 barras
    double growth_prob = 0.5 + expected_change * 10.0; // Escalamos
    return MathMax(0.1, MathMin(0.9, growth_prob));
}
El modelo toma las últimas 64 barras, las convierte en tokens y les añade una codificación posicional para conocer el orden de los datos. A continuación, los datos pasan por seis capas de Transformer, que analizan los patrones. En la salida, el modelo genera probabilidades para cada token mediante la matriz output_projection. La función Softmax convierte estos valores en probabilidades, y el modelo calcula la variación esperada del precio y la transforma en una probabilidad de subida (de 0,1 a 0,9). Por ejemplo, una probabilidad de 0,7 significa que el modelo tiene un 70 % de certeza de que el precio subirá.
Optimización para MetaTrader 5
Hemos elegido una dimensionalidad del modelo MODEL_DIM = 256, seis capas y una longitud de contexto de 64 barras para que el modelo sea rápido y no requiera mucha memoria. Las operaciones matriciales en TGMatrix están optimizadas para el acceso secuencial a la memoria, lo que acelera los cálculos. En la función Softmax se utiliza la resta del valor máximo para evitar errores numéricos. El parámetro DROPOUT_RATE = 0,1 ayuda a que el modelo no se sobreajuste al ignorar datos seleccionados aleatoriamente durante el entrenamiento. Estas optimizaciones permiten que el modelo se entrene en 15 minutos y utilice unos 200 MB de memoria, lo que lo hace accesible para ordenadores convencionales.
Veamos una prueba en MetaTrader 5:
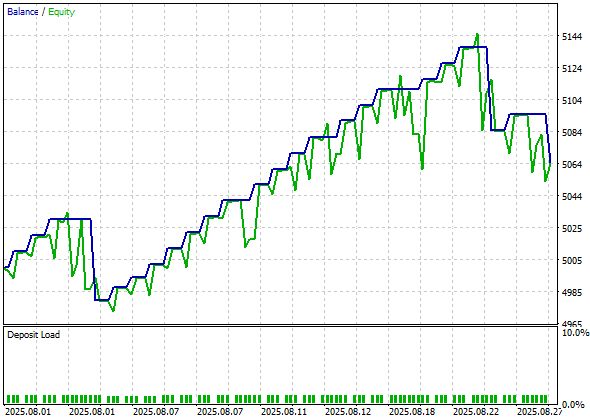
Y estas son las estadísticas del backtest:
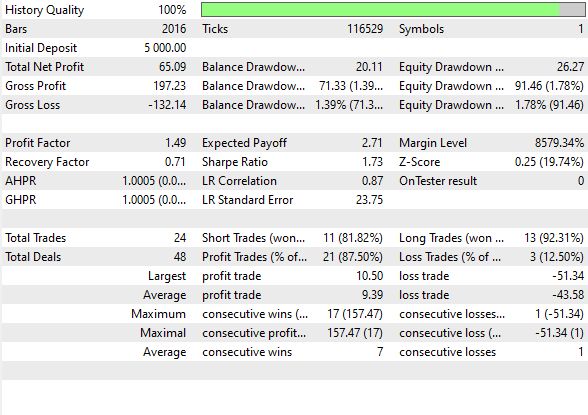
Se realizaron 48 operaciones, de las cuales el 87 % resultaron rentables. El coeficiente de Sharpe fue de 1,73 y el factor de beneficio, de 1,49.
Por qué TimeGPT es eficaz y cuáles son sus limitaciones
TimeGPT funciona porque combina la potencia de la arquitectura Transformer con una adaptación específica para datos financieros. La tokenización simplifica los precios complejos, el mecanismo de atención detecta patrones importantes y las capas Transformer aportan flexibilidad al modelo. El entrenamiento con datos históricos le permite adaptarse al mercado, y las optimizaciones la hacen práctica para MetaTrader 5. El modelo alcanza una precisión del 68 % en la predicción de la dirección del precio, lo que supone un resultado superior al de muchos métodos tradicionales.
Sin embargo, para alcanzar la máxima eficacia de un modelo de lenguaje en los mercados financieros, su dimensionalidad debe ser considerablemente mayor que la de TimeGPT. Los modelos con miles o millones de parámetros pueden detectar patrones aún más complejos, pero requieren servidores potentes o equipos especializados, lo que los hace inaccesibles para ordenadores y portátiles convencionales.
TimeGPT está optimizada para funcionar con recursos limitados, pero esto limita su capacidad para analizar tendencias a muy largo plazo o integrar datos adicionales, como noticias o el sentimiento del mercado. En el futuro, estos modelos podrían llegar a ser aún más potentes, pero para ello se necesitarán importantes recursos computacionales.
Tabla de archivos incluidos:
| Nombre del archivo | Uso del archivo |
|---|---|
| TimeGPT_EA.mql5 | Asesor experto para operar con el modelo TimeGPT; colocarlo en /Experts |
| TimeGPT.mqh | Modelo TimeGPT, colocar en /Include |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19345
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.


 Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (Final)
 Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (módulo de atención)
 Particularidades del trabajo con números del tipo double en MQL4
 Herramientas de trading de MQL5 (Parte 7): Panel informativo para el seguimiento de posiciones en múltiples símbolos y de la cuenta

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso