

Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (SAGDFN)
 24
 0

Introducción
Las series temporales multivariantes se caracterizan no solo por la habitual dependencia temporal (tendencias, estacionalidad, picos repentinos de actividad), sino también por una correlación espacial, que resulta mucho más engañosa. Describe cómo los cambios en una secuencia afectan a las demás. Y estas relaciones cobran vida propia: aparecen y desaparecen, y varían en intensidad y dirección en función de las noticias globales, los cambios en la política monetaria de los Estados, las crisis políticas o los avances tecnológicos. Por ejemplo, el tipo de cambio EURUSD puede variar debido a los cambios en los precios del gas en Europa provocados por shocks energéticos, mientras que las acciones de los fabricantes de microchips pueden verse afectadas por la situación en las fábricas asiáticas.
Los modelos tradicionales, como ARIMA o VAR, funcionaban bastante bien con series temporales individuales, pero en cuanto se trata de cientos de instrumentos, empiezan a fallar. Los métodos de aprendizaje automático de última generación (máquinas de vectores de soporte (SVM), procesos gaussianos) han ampliado los horizontes del análisis, pero su arquitectura rara vez ha tenido en cuenta la rica red de interrelaciones. Incluso las redes neuronales recurrentes (RNN) y los Transformers modernos, que han demostrado resultados impresionantes en el procesamiento de secuencias, resultaron limitados en el contexto de las series temporales multivariantes: les faltaba la sutileza necesaria para trabajar con redes dinámicas de correlaciones.
En este contexto surgieron las redes neuronales de grafos (GNN), que inicialmente se crearon para tareas con una estructura de grafo muy marcada: redes de transporte, interacciones sociales y cadenas de suministro. Pero en el mundo financiero, construir un grafo así es una tarea que es casi un arte. Dos empresas del mismo sector pueden comportarse de manera diametralmente opuesta, mientras que dos mercados muy distantes entre sí (por ejemplo, EE. UU. y Japón) pueden reaccionar de forma sincronizada ante los mismos estímulos macroeconómicos.
La respuesta fueron las redes neuronales de grafos adaptativas (adaptive-weight-GNN), que construyen el grafo directamente a partir de los datos, y no a partir de suposiciones. Aprenden una matriz de relaciones entre los activos, identificando no las correlaciones formales, sino las reales. Un ejemplo clásico: el oro y el yen japonés, que suelen comportarse como activos refugio. En circunstancias normales, su relación puede no resultar evidente, pero en períodos de agitación global, el modelo detectará la sincronía de su evolución y ajustará la previsión.
No obstante, estos enfoques tampoco están exentos de limitaciones. La primera es la escalabilidad: una matriz de correlaciones N×N para un gran número de activos se convierte en un monstruo voraz que puede colapsar incluso potentes aceleradores gráficos, saturando su memoria con cálculos intermedios. La segunda son las conexiones falsas: muchos algoritmos adaptativos dan por sentado que todos los nodos están conectados entre sí en cierta medida, pero no es así. En las previsiones financieras, una acción poco significativa de un mercado local no debería tener un impacto considerable en las previsiones globales.
Para resolver estos problemas, se desarrolló un nuevo enfoque basado en la difusión sobre grafos y en el principio de dispersidad espacial. La clave reside en no intentar analizar todas las conexiones posibles, sino en identificar los nodos clave —una especie de puntos de anclaje de influencia— que marcan la pauta de todo el sistema. En el ámbito financiero, pueden ser el dólar estadounidense, el euro, el petróleo, el oro y los índices bursátiles S&P 500 y Nikkei 225.
Entre estos algoritmos destaca el framework SAGDFN, presentado en el artículo «SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting». Los autores del framework proponen seleccionar los nodos más significativos mediante el algoritmo muestreo de nodos significativos (Significant Nodes Sampling). Y el módulo atención espacial dispersa multicabeza (Sparse Spatial Multi-Head Attention) se encarga de refinar aún más las interdependencias. Como resultado, se forma una matriz compacta de tamaño N×M, en la que M es muchas veces menor que N.
La aplicación del enfoque propuesto reduce la complejidad computacional de N² a MN y, al mismo tiempo, disminuye el consumo de memoria. Permite realizar predicciones a partir de enormes volúmenes de datos sin sobrecargar los recursos de cálculo y hace que el sistema sea más resistente al ruido. Esto cobra especial importancia en los periodos de turbulencias en los mercados, provocados por decisiones inesperadas de los bancos centrales y por fuertes fluctuaciones en los precios de las materias primas.
Las consecuencias prácticas son evidentes. Los grandes fondos de inversión obtienen una herramienta para reequilibrar sus carteras con mayor precisión. Los fondos de cobertura obtienen una base para estrategias que tienen en cuenta no solo la dinámica de activos concretos, sino también la compleja interacción de las interrelaciones globales. Los operadores algorítmicos obtienen la posibilidad de operar con un gran número de instrumentos sin retrasos críticos en la toma de decisiones.
Algoritmo SAGDFN
Scalable Adaptive Graph Diffusion Forecasting Network (SAGDFN) es un algoritmo moderno diseñado para hacer que la predicción de series temporales sea más flexible, escalable y eficiente, incluso al trabajar con grafos extremadamente grandes. La idea principal consiste en reducir considerablemente la carga computacional y los requisitos de memoria sin que ello afecte a la precisión de las previsiones. En lugar de procesar mecánicamente toda la estructura del grafo, el modelo se centra en los elementos y las relaciones más significativos, que influyen realmente en el resultado final. Este enfoque no solo elimina el ruido superfluo, sino que también permite elaborar previsiones de forma más rápida, eficiente y precisa.
En el funcionamiento de SAGDFN, la función α-Entmax desempeña un papel fundamental. Actúa como una especie de filtro que ayuda al modelo a destacar las correlaciones espaciales realmente importantes entre los nodos del grafo y a ignorar las relaciones secundarias. Esto resulta especialmente valioso en contextos en los que los datos presentan una estructura compleja y en constante evolución, como, por ejemplo, en los mercados financieros o en los sistemas de transporte urbano. A partir de las relaciones seleccionadas se forma una matriz de adyacencia compacta, que no se define manualmente, sino que se crea durante el proceso de entrenamiento. Este carácter dinámico de la construcción hace que el algoritmo sea más flexible y capaz de adaptarse a nuevas condiciones sin necesidad de una reconfiguración completa.
La arquitectura SAGDFN se basa en el esquema «codificador-decodificador», de probada eficacia, pero no requiere conocimientos previos sobre las relaciones espaciales. Esto garantiza la versatilidad del modelo y su aplicabilidad en los ámbitos más diversos: desde el análisis de las fluctuaciones financieras, donde es importante detectar las interrelaciones entre numerosos activos, hasta la predicción de flujos de energía, rutas logísticas e incluso cadenas de producción. El modelo identifica de forma secuencial los vecinos más significativos de cada nodo, los combina con la información original y genera una matriz de adyacencia densa, que posteriormente se utiliza para el análisis espaciotemporal.
La particularidad de SAGDFN radica en que el entrenamiento de todos los componentes clave se lleva a cabo de forma sincronizada y coordinada. En un ciclo único se optimizan los índices de los nodos significativos, sus embeddings, los parámetros de atención y la matriz de adyacencia resultante. Para la calibración se utiliza la función de pérdida L1, que permite alcanzar un equilibrio entre la precisión de la predicción y la robustez frente al ruido en los datos. Este enfoque garantiza que, con el tiempo, el modelo no solo mejore la calidad de las previsiones, sino que también se adapte a los cambios en la estructura del sistema analizado.
Por lo tanto, SAGDFN resuelve uno de los problemas que desde hace tiempo afectan a las redes neuronales de grafos: cómo mantener una alta precisión en las predicciones evitando una complejidad excesiva y unos costes computacionales redundantes.
Los autores del framework SAGDFN encomendaron la funcionalidad de seleccionar los nodos más significativos al módulo de muestreo de vecinos significativos (Significant Neighbors Sampling, SNS), un enfoque metodológico orientado a optimizar los procesos computacionales en las redes neuronales de grafos (GNN) cuando se trata de predecir series temporales con un gran número de elementos interrelacionados.
Las implementaciones tradicionales de los modelos de grafos construyen una matriz de adyacencia completa de tamaño N×N y la utilizan para la convolución sobre grafos posterior, con el fin de detectar correlaciones espaciales entre todos los nodos del grafo analizado. Sin embargo, este enfoque se caracteriza por una complejidad computacional cuadrática, lo que lo hace extremadamente costoso en términos de recursos. Sobre todo si el número de nodos supera los 2.000, una situación que se observa con frecuencia en problemas aplicados reales, ya sean mercados financieros, redes de transporte o sistemas industriales de monitorización.
La idea principal de SNS consiste en replantear la importancia de las conexiones: ni mucho menos todos los nodos ejercen una influencia significativa sobre el estado de un elemento concreto del grafo. Para obtener una predicción de calidad, basta con tener en cuenta solo un pequeño subconjunto de vecinos, los más relevantes, que contribuyen de manera decisiva a la dinámica del proceso. El método propone seleccionar dinámicamente dichos vecinos significativos entre todos los N nodos, creando una matriz de adyacencia compacta de tamaño N×M, donde M es considerablemente menor que N. Esto reduce la carga sobre los recursos informáticos y acelera el procesamiento de datos, al tiempo que mantiene la capacidad del modelo para reflejar adecuadamente las dependencias internas del sistema.
El funcionamiento de SNS comienza con la inicialización de la matriz de embeddings de nodos E ∈ RN×d, donde cada fila Ei es una representación vectorial del nodo i-ésimo y contiene información sobre sus características e interrelaciones. En paralelo, se forma una matriz de candidatos C ∈ {1,…,N}N×M, en la que cada fila define un conjunto de vecinos potencialmente significativos para el nodo correspondiente. En esta fase aún no se ha determinado cuáles serán los más importantes; la tarea de selección se resolverá más adelante, teniendo en cuenta las características espaciales y contextuales de los datos.
A continuación, el algoritmo SNS clasifica los M candidatos de cada nodo según su relevancia, utilizando una medida de proximidad entre embeddings; por lo general, se trata de la distancia euclidiana, aunque también es posible utilizar otras métricas. Cuanto menor sea la distancia entre las representaciones vectoriales de dos nodos, mayor será la probabilidad de que su relación refleje realmente la influencia que uno ejerce sobre el otro. A continuación, se forma un conjunto final compuesto por los K vecinos más significativos, que constituyen el núcleo de la matriz de adyacencia. Las M−K posiciones restantes pueden completarse con elementos seleccionados al azar para aumentar la diversidad de las relaciones y mejorar la robustez del modelo frente a las fluctuaciones locales de los datos. Este enfoque combinado permite evitar una rigidez excesiva de la estructura y previene el sobreajuste, que suele producirse cuando se fijan las conexiones de forma estática.
Como salida, el método genera una muestra de índices I de nodos significativos, a partir de la cual se construye una matriz de adyacencia compacta As de tamaño N×M. Esta solución reduce considerablemente la complejidad computacional, acercándola a una complejidad lineal en comparación con la implementación cuadrática tradicional O(N²). Y, aun así, no sacrifica la calidad de la predicción. Como resultado, SNS abre la posibilidad de aplicar redes neuronales de grafos en ámbitos en los que, anteriormente, estos enfoques se consideraban demasiado exigentes en términos de recursos: se pueden predecir en tiempo real las fluctuaciones de los precios de mercado, la distribución de los flujos de tráfico, los cambios en el consumo energético y otros procesos en los que la interrelación entre los elementos desempeña un papel decisivo.
De este modo, el muestreo de vecinos significativos (Significant Neighbors Sampling, SNS) no solo ahorra recursos, sino que permite replantearse el propio concepto de trabajar con grafos de gran tamaño. Abandonar el procesamiento global de todas las relaciones en favor de un análisis dinámico y selectivo crea las condiciones necesarias para construir modelos predictivos más flexibles y adaptativos, que aprenden a centrarse en lo que realmente importa, en lugar de ahogarse en datos redundantes.
El módulo de atención espacial dispersa multicabeza (Sparse Spatial Multi-Head Attention) en SAGDFN es el núcleo que transforma los nodos vecinos significativos seleccionados en una matriz compacta de conexiones As de tamaño N×M, que determina cuánta información debe fluir desde cada uno de los M nodos hacia un nodo concreto i durante la convolución sobre grafos. A diferencia de los enfoques basados en información previa sobre la topología, el módulo SS-MHA se construye íntegramente a partir de los datos. No utiliza estructuras externas y no se ve afectado por supuestos erróneos u obsoletos sobre las relaciones espaciales. Esto hace que el modelo sea versátil y aplicable a la resolución de diversas tareas en los mercados financieros, las redes energéticas o los flujos de transporte, donde las relaciones entre los componentes varían con el tiempo y no pueden representarse mediante un modelo manual sencillo.
Desde el punto de vista técnico, el módulo combina dos ideas clave. En primer lugar, el producto interno de vectores permite evaluar de forma eficaz y en paralelo una medida básica de similitud entre nodos: el vector del nodo i se transforma en una matriz de tamaño M×d, repitiendo la fila y concatenándola con los embeddings de sus M vecinos significativos. Esto da lugar a una matriz que contiene, al mismo tiempo, información sobre el contexto local del nodo y sus candidatos a vecinos, lo que abre la vía a operaciones matriciales rápidas en las plataformas modernas de diferenciación automática.
En segundo lugar, los autores del framework SAGDFN rechazan el enfoque puramente lineal y entrenan una medida de correlación no lineal mediante pequeños bloques neuronales feed-forward (FFN). Para cada nodo y cada cabeza de atención, estos FFN transforman las representaciones concatenadas en una matriz de puntuaciones Y, en la que las dos columnas se interpretan como correlaciones probables y menos probables, respectivamente. La arquitectura multicabeza se asemeja aquí al trabajo de un grupo de expertos que analizan un mismo conjunto de datos desde diferentes perspectivas: una cabeza identifica las relaciones estacionales, otra, la reacción ante las noticias, y una tercera, los indicadores latentes de riesgo.
Una etapa clave es la normalización de las puntuaciones. En lugar del SoftMax estándar, que distribuye los pesos de forma difusa por todo el conjunto y a menudo genera multitud de conexiones pequeñas e irrelevantes, los autores del framework proponen utilizar la función α-Entmax. Proporciona distribuciones de atención dispersas, pero informativas: los valores altos se potencian, mientras que los débiles se reducen a cero. En las aplicaciones financieras, esto es fundamental: en el mercado, solo unos pocos instrumentos marcan realmente la tendencia en un momento dado: la moneda de reserva, un índice importante o una materia prima clave. α-Entmax actúa como una lente que se centra en los objetos más destacados y filtra el ruido de fondo. El parámetro α ofrece flexibilidad: varía desde SoftMax (α=1) hasta SparseMax (α=2). Se selecciona el grado óptimo de dispersidad para un dominio de datos concreto.
En la práctica, para cada cabeza de atención se calculan las puntuaciones normalizadas Zp, que se agrupan en un tensor multidimensional Zi para el nodo i. A continuación, se construye el tensor Z de tamaño N×M×(2P) a partir de todos los nodos y, mediante una transformación lineal con los pesos Wa, se reduce a la matriz final As de tamaño N×M. Esta matriz ya no representa un grafo denso N×N, sino que selecciona cuidadosamente, para cada nodo, únicamente aquellas M señales que influyen realmente en la posterior convolución sobre grafos.
Este enfoque resulta especialmente eficaz en los mercados financieros, donde los instrumentos que influyen en la evolución de los precios hoy pueden no hacerlo mañana. Por ejemplo, en un periodo de pánico, los activos líderes pueden ser el oro y el yen; en una fase de crecimiento económico, el índice S&P 500 y las acciones tecnológicas; y, ante una crisis energética, los precios del petróleo y las divisas de los países exportadores de energía. El módulo permite identificar a esos líderes evidentes y ocultos, descartando las correlaciones aleatorias que podrían distorsionar la previsión.
Además de mejorar la precisión de las predicciones, α-Entmax ofrece otras ventajas: las puntuaciones dispersas reducen el número de operaciones innecesarias en la convolución sobre grafos, lo que hace que el modelo sea más interpretable; el analista puede ver qué M nodos han influido realmente en la predicción de un instrumento concreto. La combinación de la sustitución aleatoria al seleccionar vecinos y la normalización dispersa garantiza la actualización de los embeddings de nodos en toda la red, sin pasar por alto variables importantes.
La implementación técnica tiene en cuenta el uso eficiente de la GPU y de frameworks automatizados: concatenación y procesamiento por lotes, bloques FFN compactos para cada cabeza, y una transformación lineal del último tensor Z en As para una parametrización fina de la influencia de cada cabeza y de cada canal.
En conjunto, la atención espacial dispersa multicabeza (Sparse Spatial Multi-Head Attention) ofrece un equilibrio práctico entre precisión y eficiencia en el uso de recursos: sensibilidad a las señales más importantes, adaptación a condiciones cambiantes y escalabilidad para miles de series temporales.
La predicción basada en la arquitectura Encoder–Decoder en el framework SAGDFN es la culminación de todas las etapas anteriores. Aquí se combinan los vecinos significativos seleccionados previamente, la atención espacial dispersa multicabeza y una convolución sobre grafos eficaz con un potente modelo secuencial que permite tener en cuenta la dinámica temporal. A diferencia de los enfoques sencillos, que se centran en las dependencias espaciales o en el aspecto temporal, el enfoque propuesto por los autores del framework permite describir y utilizar ambas dimensiones de forma conjunta. Esto permite obtener previsiones más precisas y estables para series temporales multivariantes.
Intuitivamente, el funcionamiento de la arquitectura Encoder–Decoder puede representarse de la siguiente manera. El codificador condensa la información de la secuencia histórica, acumulando patrones espaciotemporales en una representación compacta de estados ocultos. A continuación, el decodificador genera, paso a paso, predicciones utilizando la representación obtenida y los valores previstos que recibe en cada paso.
En este caso, el elemento crítico es un mecanismo rápido de difusión sobre grafos, basado en una matriz de adyacencia compacta As, que garantiza la transmisión de información relevante entre los nodos del grafo en cada iteración temporal.
La convolución sobre grafos en múltiples pasos, que implementa la difusión de información a través de los vecinos, viene definida por la siguiente expresión:
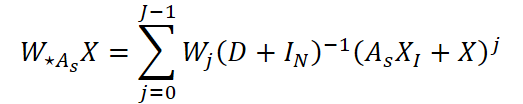
donde D es la matriz diagonal de grados para As, IN es la matriz identidad de tamaño N, y XI es la matriz de datos originales, agregados sobre los M vecinos seleccionados (indexación por I).
Este operador conserva la información sobre el estado propio del nodo (término X) y acumula la señal procedente de los vecinos significativos (AsXI); luego normaliza estas señales según la suma de grados y las hace pasar por los filtros lineales Wj. La ventaja práctica es la posibilidad de controlar el radio de propagación de la información mediante el parámetro J: un J pequeño fija relaciones locales, mientras que uno grande permite tener en cuenta influencias más lejanas.
A continuación, los autores del framework SAGDFN integran esta operación sobre grafos en un paso de tipo GRU, sustituyendo la multiplicación estándar de matrices por una convolución sobre grafos. Así surge OneStepFastGConv, una iteración de un solo paso que combina la agregación espacial y la recurrencia temporal:
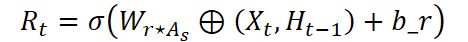
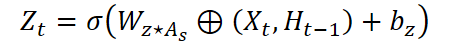
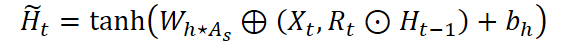
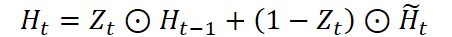
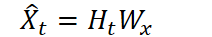
Aquí, la concatenación ⊕ combina la observación actual y el estado oculto anterior, mientras que las operaciones ⊙ y σ tienen su significado habitual. Este paso garantiza que, antes de actualizar el estado oculto, cada nodo tenga en cuenta sus propias características y la señal procedente de sus asociados más significativos en el grafo. Esto es especialmente importante en el ámbito financiero: al elaborar una predicción del precio de una acción, no solo se tiene en cuenta su propio historial, sino también los movimientos de los principales instrumentos relacionados: divisas, materias primas e índices.
La predicción de datos se lleva a cabo en dos etapas: Encoder y Decoder. En Encoder, ejecutamos OneStepFastGConv sobre una ventana histórica de longitud h, obteniendo al final una representación Ht0-1 que acumula la información espaciotemporal de toda la ventana de datos analizada.
A continuación, el Decoder parte del estado inicial Ht0-1 y de la observación en el paso t0, generando sucesivamente el número especificado de pasos hacia adelante.
El entrenamiento se lleva a cabo mediante retropropagación de extremo a extremo: se calculan los gradientes con respecto a Θ (incluidos los embeddings, los parámetros de FFN en el módulo de atención, los pesos de la convolución sobre grafos y los parámetros de GRU) y se utilizan para actualizar el modelo. Cabe destacar que, dado que los embeddings participan en la selección de vecinos y en el cálculo de As, la estructura del grafo también cambia a lo largo del entrenamiento: esto dota al sistema de adaptabilidad, permitiéndole descubrir nuevas relaciones significativas a medida que cambia el mercado.
Encoder–Decoder, combinado con OneStepFastGConv y la estructura adaptativa As, crea una plataforma potente y flexible para la predicción espaciotemporal. Combina la interpretabilidad (a través de una matriz dispersa de conexiones y la visualización de vecinos relevantes), la adaptabilidad (actualización dinámica de los embeddings y de la estructura del grafo) y la escalabilidad práctica, lo que la convierte en una herramienta especialmente valiosa para el análisis y la toma de decisiones en los mercados financieros.
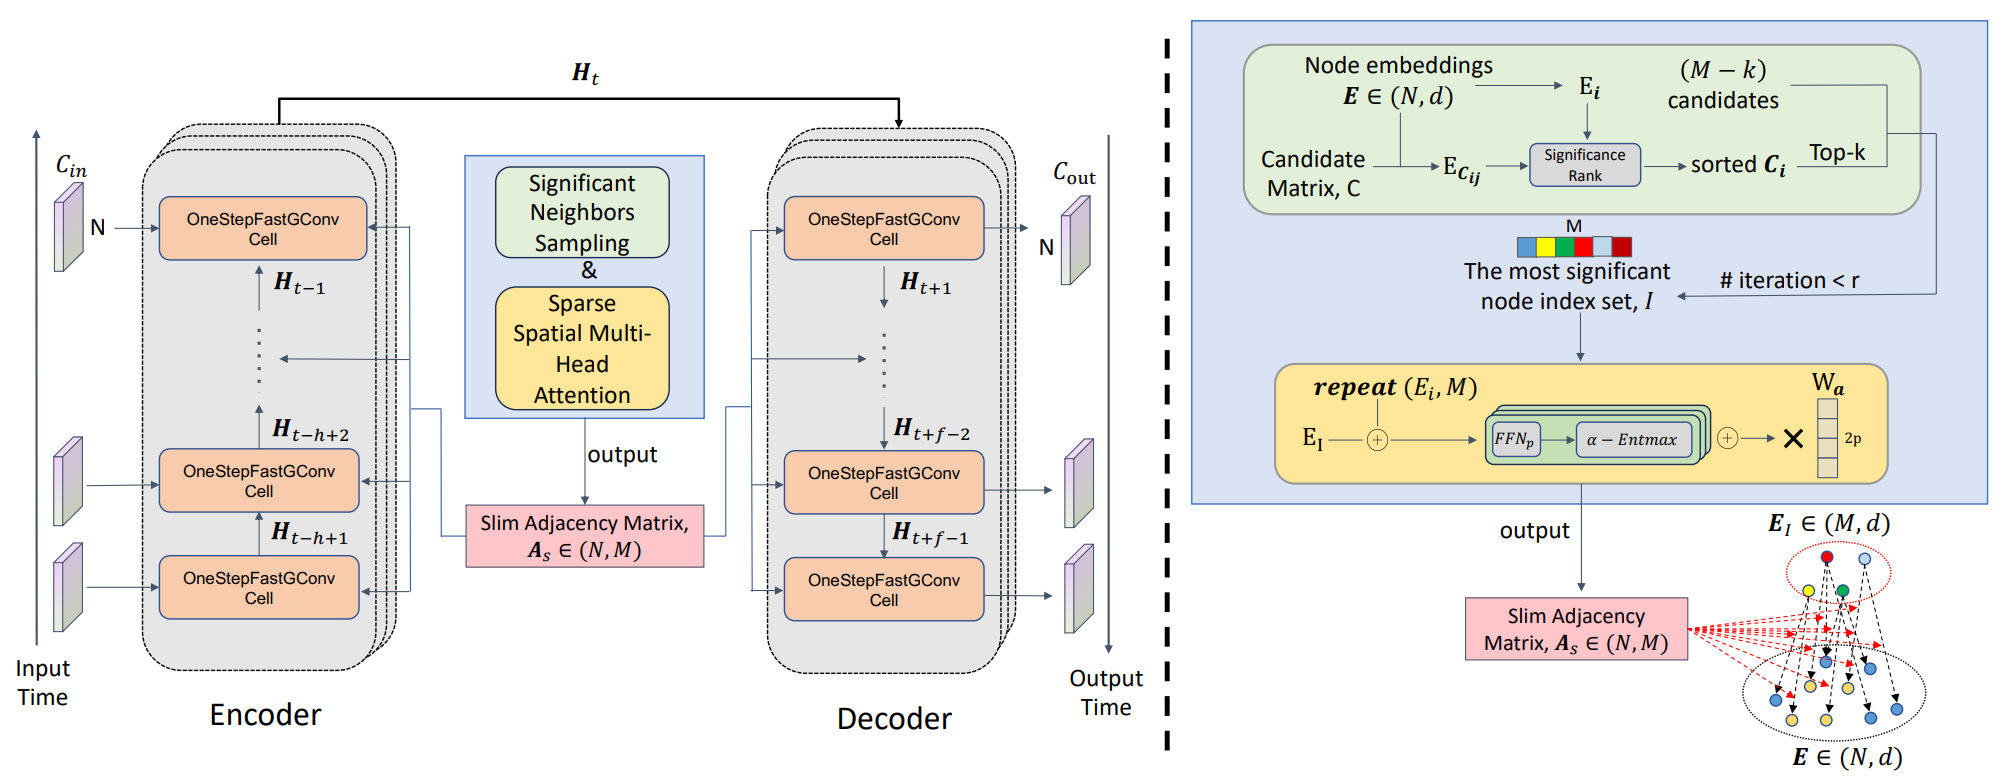
La visualización del framework SAGDFN realizada por el autor se presenta a continuación.
Implementación en MQL5
Tras un análisis detallado de la parte teórica del framework SAGDFN, pasamos a la implementación práctica de los enfoques propuestos. Aquí mostraremos una de las vías reales para trasladar las ideas de los autores del framework al entorno MQL5. A lo largo de este trabajo, analizaremos los siguientes aspectos:
- preparación de los datos;
- almacenamiento y actualización de embeddings;
- muestreo de vecinos significativos;
- mecanismo de atención dispersa;
- integración de la convolución rápida sobre grafos en la lógica recurrente.
Nuestro objetivo es una implementación funcional, reproducible y, sobre todo, práctica, apta para un uso real.
El módulo muestreo de vecinos significativos (Significant Neighbors Sampling, SNS) se encarga de una tarea sencilla, pero de vital importancia: seleccionar precisamente a aquellos líderes que realmente conforman el panorama informativo de la red. De una selección adecuada de los vecinos depende precisamente qué señales se amplificarán y cuáles quedarán reducidas a ruido de fondo.
Cabe señalar aquí que los autores del framework SAGDFN propusieron clasificar los M vecinos más significativos obtenidos en el paso anterior, formando un conjunto de los K elementos más cercanos que sirven de núcleo de la matriz de adyacencia. Las M−K posiciones restantes se completan con elementos seleccionados aleatoriamente para aumentar la diversidad de las conexiones. En nuestra implementación, decidimos ir más allá e incorporar la clasificación paralela de una muestra aleatoria.
La idea es sencilla y, al mismo tiempo, eficaz: en lugar de tomar primero los K candidatos más cercanos y luego completarlos con elementos aleatorios, formamos dos conjuntos: el de candidatos preseleccionados y el de candidatos aleatorios. Y luego los evaluamos simultáneamente. En la muestra final se incluyen los nodos del conjunto combinado que están realmente más cercanos según el embedding, independientemente de si se seleccionaron mediante una heurística o al azar. Esta combinación de explotación y exploración aporta al modelo estabilidad y flexibilidad a la vez: retiene a los líderes consolidados, pero no deja pasar la oportunidad de detectar nuevos centros de influencia en el mercado.
Vamos a trasladar la implementación técnica de este algoritmo al contexto de OpenCL. Para ello, crearemos el kernel SignificantNeighborsSampling.
__kernel void SignificantNeighborsSampling(__global const float *data,
                                           __global const float *candidates,
                                           __global const float *random_cands,
                                           __global float *neighbors,
                                           const int dimension
                                          )
  {
   const size_t main = get_global_id(0);
   const size_t slave = get_local_id(1);
   const int total_main = (int)get_global_size(0);
   const int total_slave = (int)get_local_size(1);
El kernel comienza con la declaración de la firma. Recibe como entrada los arrays globales data, candidates y random_cands, destinados a almacenar los embeddings de las series y los dos conjuntos de candidatos. El array neighbors sirve para registrar los resultados. Y el entero dimension determina el tamaño del embedding. La firma establece la lógica de ejecución: un work-item global se encarga de un nodo principal (main), mientras que un conjunto de work-item locales dentro del grupo se encarga de procesar los candidatos.
Luego se extraen los identificadores del contexto de ejecución, se declaran los arrays locales y se calcula el tamaño local de trabajo.
   __local int Idx[LOCAL_ARRAY_SIZE];
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int ls = min(total_slave, (int)LOCAL_ARRAY_SIZE);
La memoria local es una herramienta muy eficaz para acelerar el proceso: aquí se utiliza como búfer para almacenar temporalmente los índices y las distancias dentro de un subgrupo.
En el siguiente bloque, determinamos los desplazamientos en los arrays planos de datos de entrada hasta los elementos necesarios de la secuencia.
   const int shift_main = RCtoFlat(main, 0, total_main, dimension, 0);
   int cand = (int)candidates[slave];
   int rand_cand = (int)random_cands[slave];
A continuación, conviene señalar que, para buscar los vecinos más cercanos, utilizamos dos conjuntos, uno de los cuales se ha generado mediante muestreo aleatorio. En ese caso, es muy probable que uno o más elementos de la secuencia estén presentes en ambas muestras. Por eso, el siguiente bloque consiste en una sencilla comprobación de duplicados. Esto evita volver a examinar el mismo índice, lo cual es lógico y ahorra cálculos. En la primera fase, comprobamos si hay duplicados dentro del flujo actual.
//--- comprobación de duplicados
   if(rand_cand == cand)
      rand_cand = -1;
Después comprobamos si hay duplicados en el pool de vecinos seleccionados previamente.
//--- Buscar entre los candidatos
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Idx[slave - l] = cand;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i >= (slave - l))
            continue;
         if(cand == Idx[i])
            cand = -1;
         if(rand_cand == Idx[i])
            rand_cand = -1;
        }
      BarrierLoc;
     }
Aquí vamos registrando por partes los índices de los candidatos en un array de datos local y, a continuación, cada flujo compara sus índices con los elementos del array.
Tenga en cuenta que, para garantizar que se conserve una única copia de cada elemento, solo comprobamos duplicados en los índices de los hilos anteriores. Por lo tanto, solo se excluyen los elementos de los hilos posteriores, conservándose el elemento de la primera aparición.
A continuación, realizamos la comprobación de forma análoga en el pool de muestreo aleatorio de candidatos.
//--- Buscar entre candidatos aleatorios
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Idx[slave - l] = rand_cand;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i >= (slave - l))
            continue;
         if(cand == Idx[i])
            cand = -1;
         if(rand_cand == Idx[i])
            rand_cand = -1;
        }
      BarrierLoc;
     }
Una vez que los candidatos han superado la comprobación de unicidad dentro del grupo local, calculamos los offsets planos shift_cand y shift_rand_cand para obtener el inicio del embedding de cada candidato en el array data.
   const int shift_cand = RCtoFlat(cand, 0, total_main, dimension, 0);
   const int shift_rand_cand = RCtoFlat(rand_cand, 0, total_main, dimension, 0);
Luego se procede al cálculo de la distancia euclidiana. En primer lugar, se inicializan a cero las variables locales de las distancias de los candidatos de ambos pools.
//--- calcular la distancia
   float dist_cand = 0;
   float dist_rand_cand = 0;
   for(int d = 0; d < dimension; d++)
     {
      float value = IsNaNOrInf(data[shift_main + d], 0);
      if(main != cand && cand >= 0)
         dist_cand += pow(value - IsNaNOrInf(data[shift_cand + d], 0), 2.0f);
      if(main != rand_cand && rand_cand >= 0)
         dist_rand_cand += pow(value - IsNaNOrInf(data[shift_rand_cand + d], 0), 2.0f);
     }
A continuación, en un ciclo por las dimensiones de los embeddings, se extrae el valor del embedding objetivo y de los candidatos. Para determinar la distancia, en las variables locales se suman los cuadrados de la diferencia entre el elemento objetivo y el candidato correspondiente.
Cabe señalar que los cálculos se realizan únicamente para los elementos no eliminados.
Una vez calculadas las distancias, se prepara la determinación de la posición en el ranking. En primer lugar, inicializamos las variables locales cand_position y rand_position a cero, lo que corresponde al primer elemento del array. No obstante, comprobamos si son iguales las distancias de los elementos de los pools preseleccionado y aleatorio. En caso de que las distancias sean idénticas, damos preferencia al pool de candidatos seleccionados anteriormente y aumentamos el valor de rand_position.
//--- calcular la posición
   int cand_position = 0;
   int rand_position = (int)(dist_cand >= dist_rand_cand);
A continuación, comienza una serie de bloques en los que, a partir de fragmentos de la memoria local Temp, se recopilan colectivamente las distancias actuales y se calcula cuántos elementos de la muestra local tienen una distancia menor que la considerada. La primera serie copia las distancias del pool de candidatos preseleccionados (o -1 para los que no existen).
//--- por candidatos
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Temp[slave - l] = (cand >= 0 ? IsNaNOrInf(dist_cand, -1) : -1);
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (slave - l))
            continue;
         if(Temp[i] < 0)
            continue;
         if(cand >= 0)
           {
            if(Temp[i] < dist_cand)
               cand_position++;
            else
               if(Temp[i] < dist_cand && i < (slave - l))
                  cand_position++;
           }
         if(rand_cand >= 0)
           {
            if(Temp[i] < dist_rand_cand)
               rand_position++;
            else
               if(Temp[i] < dist_rand_cand && i < (slave - l))
                  rand_position++;
           }
        }
      BarrierLoc;
     }
Cada flujo del grupo recorre los elementos de Temp, incrementando cand_position y rand_position en función de qué distancias sean menores. Aquí se aplica una sutil lógica de desempate: si dos distancias son iguales, el orden se determina por el índice, lo que garantiza que la clasificación sea determinista en caso de distancias iguales. Las barreras garantizan que Temp se llene correctamente antes de la lectura y se vacíe a continuación.
Una segunda serie similar hace lo mismo, pero lleva a Temp las distancias de los elementos de la muestra aleatoria y vuelve a ajustar las posiciones teniendo en cuenta el resto del subgrupo local.
//--- por candidatos aleatorios
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Temp[slave - l] = (rand_cand >= 0 ? IsNaNOrInf(dist_rand_cand, -1) : -1);
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (slave - l))
            continue;
         if(Temp[i] < 0)
            continue;
         if(cand >= 0)
           {
            if(Temp[i] < dist_cand)
               cand_position++;
            else
               if(Temp[i] < dist_cand && i < (slave - l))
                  cand_position++;
           }
         if(rand_cand >= 0)
           {
            if(Temp[i] < dist_rand_cand)
               rand_position++;
            else
               if(Temp[i] < dist_rand_cand && i < (slave - l))
                  rand_position++;
           }
        }
      BarrierLoc;
     }
Es importante comprender esta parte: el algoritmo implementa un cálculo distribuido de la posición; cada slave calcula por sí mismo en qué lugar de la lista de su grupo local, ordenada por distancia, quedará. Esto nos permite realizar una clasificación sin necesidad de una ordenación global, de forma totalmente local, lo que ahorra tanto memoria como tiempo.
La etapa final es la escritura del resultado. Si el candidato existe y su posición es menor que el número total de vecinos buscados, se calcula el índice de offset y se escribe el índice del candidato en la celda correspondiente del array neighbors.
//--- resultado
   if(cand >= 0 && cand_position < total_slave)
     {
      const int shift_dist_cand = RCtoFlat(main, cand_position, total_main, total_slave, 0);
      neighbors[shift_dist_cand] = cand;
     }
   if(rand_cand >= 0 && rand_position < total_slave)
     {
      const int shift_dist_cand = RCtoFlat(main, rand_position, total_main, total_slave, 0);
      neighbors[shift_dist_cand] = rand_cand;
     }
  }
El algoritmo presentado evalúa en paralelo los candidatos deterministas y aleatorios, elimina duplicados localmente, calcula las distancias y clasifica a los candidatos según su posición en la submuestra local, sin necesidad de una ordenación global.
Hoy hemos trabajado mucho y a fondo, y el artículo ya ha quedado bastante completo. Ahora es el momento ideal para hacer una pausa, dejar que los pensamientos se asienten y echar un vistazo a lo que hemos hecho desde una perspectiva nueva. En el próximo artículo retomaremos el tema con nuevas energías y continuaremos el camino que hemos emprendido, avanzando paso a paso.
Conclusión
En este artículo nos hemos familiarizado con el framework SAGDFN, que destaca entre soluciones similares por su escalabilidad, su capacidad para trabajar eficazmente con grafos de gran tamaño y para minimizar los costes computacionales sin perder precisión. Su enfoque adaptativo a la hora de seleccionar las conexiones significativas entre los nodos permite conservar la información clave y, al mismo tiempo, evitar sobrecargar el modelo con datos superfluos.
En el apartado teórico, hemos analizado con detalle las características clave y los mecanismos internos del framework. Hemos explicado los principios de funcionamiento del algoritmo y, a continuación, hemos dado el primer paso hacia su implementación práctica. Se ha prestado especial atención al módulo muestreo de vecinos significativos (Significant Neighbors Sampling, SNS), que desempeña un papel importante en la optimización de los cálculos y la reducción de costes al trabajar con grafos de gran tamaño. Además, hemos introducido una serie de mejoras que hicieron que el proceso de selección de vecinos sea más flexible y adaptativo.
Este artículo supone un paso importante hacia la creación de una herramienta predictiva completa, capaz de procesar eficazmente grandes volúmenes de datos y extraer de ellos relaciones espaciotemporales útiles. En el próximo artículo continuaremos esta línea, ampliando la arquitectura con nuevos componentes y acercándonos poco a poco a la realización de pruebas exhaustivas de todo el sistema con datos históricos reales.
Enlaces
- SAGDFN: A Scalable Adaptive Graph Diffusion Forescasting Network for Multivariate Time Series Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto de entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto de entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clase | Estructura de la descripción del estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clase | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19323
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 34): Conversión de datos brutos del mercado en modelos predictivos mediante un pipeline avanzado de ingesta
 Asesor experto de trading neuronal basado en PatchTST
 Tablas en el paradigma MVC en MQL5: integramos el componente Model en el componente View
 Redes neuronales en el trading: Entrenamiento de metaparámetros basado en la heterogeneidad (Final)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso