

取引におけるニューラルネットワーク:適応的周期セグメンテーション(LightGTS)
 17
 0

はじめに
時系列予測は、エネルギーや交通から医療、教育に至るまで、さまざまな分野で長年にわたり重要な役割を果たしてきました。 しかし、1秒の価値さえ金銭に直結する金融分野では、予測精度がとりわけ重要になります。 わずかなモデルの判断ミスでも、戦略はすぐに赤字に転落しかねません。
統計的手法であれ、深層学習であれ、従来のアプローチの多くは、「1つのタスクに1つのモデル」という原則に基づいています。 こうしたモデルは、限定された条件下では良好に機能します。しかし、実際の金融市場は予測困難な動きを見せます。ボラティリティ、データのスケール、周期、相場レジームが変化するため、特定のタスクに特化した固定的なモデルでは対応しきれない場合があります。
こうした背景から、「時系列基盤モデル(Time Series Foundation Models, TSFM)」と呼ばれるモデル群が登場しています。 これらは、汎用性とスケーラビリティの実現を目指し、大規模かつ多様なデータセットを用いて学習されます。 しかし、実際には膨大な計算リソースを必要とし、精度の向上が必ずしもコストに見合うとは限りません。 数千万ものパラメータを備えていても、実際のタスクでは、期待される汎用性を十分に発揮できないことがあります。
時系列データを特徴づけるのは、そのリズムです。 トークンが単語に対応するテキストとは異なり、時系列ではデータのスケールと周期性が重要な意味を持ちます。 たとえば、1時間ごとに観測されるデータもあれば、15分ごとに観測されるデータもあります。 また、日次・週次の季節性を示すものもあれば、四半期・年次の季節性を示すものもあります。 こうした特性は、データ内部で繰り返し現れるパターン、すなわち*内部周期*に影響を与えます。内部周期を適切に捉えることは、高精度な予測を実現するうえで極めて重要です。 さらに、データのスケールが変われば周期長も変化します。モデルがこうした変化に対応できなければ、汎化能力は大きく低下します。
問題は、既存モデルの多くが固定的なトークン化方式を採用していることです。 これらのモデルは、データのスケールや周期構造を考慮せず、一定の長さを持つセグメントに機械的に分割します。 その結果、一部のトークンには情報が過密に入り込み、別のトークンはほとんど情報を持たなくなります。 これによって情報の特徴が曖昧になり、繰り返し現れるパターンも損なわれてしまいます。 この問題は、あるスケールのデータで学習したモデルを、異なるスケールのデータに適用する場合に特に顕著になります。予測精度が低下し、それを補うためにパラメータ数を増やさなければならず、結果として学習時間とコストも増大します。
論文「LightGTS: A Lightweight General Time Series Forecasting Model」の著者らは、単純にモデルの規模を拡大する力ずくのアプローチではなく、時系列が本来備えている性質、すなわちスケール不変性と周期性を活用するという合理的な方針を採用しました。 その成果として開発されたのが、実際の時系列予測タスクに適した、軽量かつ効率的な LightGTSフレームワークです。 その中核となる考え方は、スケールの違いに無理に対処するのではなく、スケールに応じてモデルを適応させることにあります。
固定長のセグメントに機械的に分割する代わりに、周期的トークン化を採用します。 この手法では、完全な1周期に相当する長さのセグメントが得られるよう、データを適応的に分割します。 これにより、日足チャートでも1分足チャートでも、データのスケールにかかわらず、周期的なパターンを全体として捉えられるようになります。 トークン内の意味的な情報が保持されるため、特徴表現の安定性が高まり、異なるタスク間でも転移しやすくなります。
このフレームワークでは、予測に並列デコーディングを採用しています。Encoderの最終トークンを起点とし、その情報に基づいて将来の値を一括して生成します。 逐次的な自己回帰型の手法とは異なり、これにより処理時間を短縮し、予測を繰り返す過程で誤差が蓄積するのを抑えることができます。また、時系列そのものが持つ構造を、より効果的に活用することもできます。 最終トークンには過去のコンテキストの要点が集約されており、将来の予測にも直接利用されるため、時系列の構造を踏まえた一貫性のある予測が可能になります。
さらに、LightGTSフレームワークでは、固定的な特徴射影も採用していません。 その代わりに、周期長の変化や複数のデータソースに柔軟に対応できる層を導入しています。 これは、1時間ごとの株価データと日次のマクロ経済データが同じポートフォリオ内で共存するような金融分野のアプリケーションにおいて、特に重要です。
その成果は注目に値します。 LightGTSは、パラメータ数を500万未満に抑えながら、業界最高水準のモデルに匹敵する予測精度を実現しています。 これは、他のTSFMモデルと比較して、パラメータ数が10分の1から100分の1程度であることを意味します。 その結果、学習時間の短縮やインフラコストの削減が期待でき、実際の取引システムや分析プラットフォームへの導入も、より現実的な選択肢となります。
LightGTSアルゴリズム
金融市場における典型的な予測問題を考えてみましょう。 ここでは、価格気配値、出来高、各種指標、その他の市場シグナルなどからなる多変量時系列を扱います。 これをXt = {xi,t-L:t}i=1,Cのように表します。ここで、各xiは、過去L個のタイムステップにおける個別チャネルの観測値を表します。 チャネル数Cは固定されておらず、1つから数十個まで、さまざまな値を取り得ます。 これは、時系列上を移動しながら一定期間の履歴を取り出すスライディングウィンドウです。
私たちの目標は、そこから未来のFステップ先までを見て、値Ŷt = {ŷi,t:t+F}i=1,Cを予測することです。 また、学習時に予測精度を評価するため、実際の観測値である正解データYt = {yi,t:t+F}i=1,Cも使います。 これらすべては、標準的な予測フレームワークに当てはまります。
ここからが最も興味深い部分です。 モデルは2段階に分けて学習されます。 まず、さまざまなソースから得られた多様な時系列データを用いて、大規模な事前学習をおこないます。 これには、株式、通貨、経済指標、気象などの過去のデータ、つまり、時間的な構造を持つあらゆるデータが含まれます。 次に、特定のタスクに合わせてモデルをファインチューニングします。
興味深いことに、モデルにはファインチューニングがまったく必要ない場合もあります。最初から十分に汎用的なモデルとして学習されていれば、テストセットで評価するだけで十分な可能性があります。 これはアルゴリズム取引において特に重要です。個々の金融商品ごとにモデルをファインチューニングすることが、常に可能とは限らないためです。特にリアルタイムでは、そのような調整が難しい場合があります。
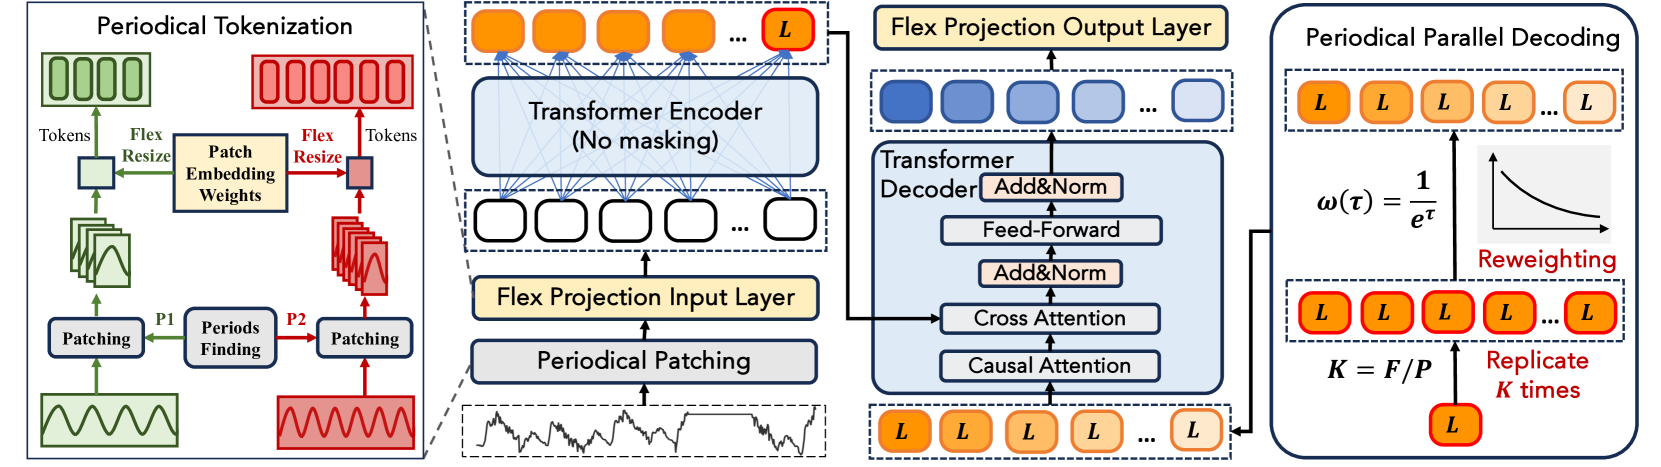
では、LightGTSモデルの独自性はどこにあるのでしょうか。 その鍵となるのが、周期的トークン化です。これは、時系列そのもののリズムに適応する、まさに魔法の定規です。 このフレームワークの著者らは、系列を周期パッチ、すなわち、日次や週次などの完全な1周期に相当するデータ区間に分割することを提案しています。 この処理は「適応的周期パッチ化」と呼ばれます。 この手法では、時系列のスケールと構造を考慮し、市場の振る舞いに繰り返し現れるパターンにぴったり合う区間を形成します。
この手法を説明するため、ここでは単純なケースとして、1次元の時系列を考えます。 実際には、この手法は多変量データにも容易に拡張できます。各チャネルを個別に処理するだけでよく、データの構造が失われることもありません。
さまざまなソースから得られた時系列データの集合を扱うと考えてみましょう。データには、さまざまな金融資産、市場、時間軸のものが含まれます。 それぞれの時系列には、固有のリズム、いわゆる「自然周期」があります。 たとえば、日次の取引サイクル、週次のボラティリティ、季節的なトレンドなどです。 このような時系列を効果的に扱うには、まず、その周期の長さを特定する必要があります。つまり、分析対象のデータに含まれる何個の時点が、完全な1周期を構成するのかを求めます。
データのサンプリング頻度に関する事前情報(たとえば、1時間ごと、あるいは1分ごとにデータが得られること)があれば、周期の長さは簡単に求められます。たとえば、1時間ごとのデータで日次周期を考える場合、1周期は24個のデータ点で構成されます。 一方、サンプリング頻度に関する情報が得られない場合は、高速フーリエ変換(FFT)などを用いたスペクトル解析が役立ちます。これにより、時系列に含まれる支配的な周波数を「嗅ぎ分ける」ことができます。 こうした周波数は、繰り返し現れるパターン、すなわち、市場の動向を予測するうえで重要な周期を反映しています。
周期の長さをPとすると、時系列全体を、ちょうど1周期分の長さを持つ連続した非重複の区間に分割します。 それぞれの区間は「パッチ」と呼ばれ、P個のデータ点を含み、完全な1周期をカバーします。 生成されるパッチの数は、元の時系列の長さをLとしたとき、LをPで割った商の小数部分を切り捨てた値です。
一見すると単純な処理ですが、実際には、モデルが新たなレベルの意味的な構造を捉えるための基盤となります。 異なる時間軸、サンプリング頻度、データソースから得られた時系列が、周期に同期した単一の空間で扱われるようになります。 これにより、データのスケールの違いに起因するノイズが取り除かれ、モデルは局所的なボラティリティに適応するだけでなく、周期ごとに実際に繰り返されるパターンを識別するよう学習できます。
このような時系列の分割方法によって、異種のデータソースを用いた学習が可能になります。 サンプリング頻度が異なっていても、すべての時系列が、周期を情報の基本単位とする比較可能な形式に変換されるためです。 これにより、モデルは繰り返し現れる市場シグナルを識別し、汎化できるようになります。これは、実際の取引環境で信頼性の高い予測を行ううえで極めて重要です。
時系列を、それぞれが時系列の完全な1周期をカバーする周期パッチに分割したら、次に、これらのパッチをベクトル表現へ適切に写像する必要があります。 ここで射影層の役割が重要になります。ただし、現実の世界と同じように、重要なのは細部です。
単純な方法としては、固定の射影行列を用いて各パッチをトークンに変換することが考えられます。 しかし、ここに問題があります。 金融データの種類によって、周期の長さが異なるのです。たとえば、1分足データにおける日次周期は1,440個のデータ点で構成される一方、1時間足データにおける週次周期はわずか120個のデータ点で構成されます。 その結果、入力パッチのサイズはそれぞれ異なり、固定の射影行列では対応できません。データの一部を切り捨てるか、すべてのパッチを共通のサイズにリサイズする必要があります。 単純な補間でも、データを引き伸ばしたり縮めたりすることで、ある程度は対応できます。 しかし、問題は、こうした操作によってデータの意味が歪められてしまうことです。 その結果、形の上ではきれいに整っていても、モデルにとって意味の乏しいトークンが生成されてしまいます。
こうした歪みを避けるために導入されるのが、Flex Projection Layer(柔軟な射影層)です。 その役割は、単にパッチを固定次元に圧縮することではなく、データの意味を保ちながら圧縮することです。 言い換えれば、長さ96のパッチから得られるトークンは、長さ144のパッチから得られるトークンと同等であるべきです。ただし、どちらのパッチも同じ市場周期を反映していることが前提となります。
では、技術的にはどのように実現するのでしょうか。 長さPのパッチに対して学習済みの射影重みθがあるとします。 これらを長さP′の新しいパッチに適応させる際には、データと重みの積、ひいては生成されるトークンが、可能な限り元のものに近くなるようにします。 ここでは、単純な補間では不十分です。あまりにも粗い方法だからです。 そこで、擬似逆行列を用いて重みを適応させる線形変換を利用します。これは、数値計算や回帰分析でよく知られた手法です。
この仕組みはflex-resize(フレックスリサイズ)と呼ばれ、最適化問題を解くためのものです。具体的には、新しいパッチに適用したとき、元の結果にできるだけ近い結果を生成する新しい重みθ′を求めます。数学的には、フロベニウスノルムを基準として両者の差を最小化します。 ここで導入される係数δは、元のパッチと補間後のパッチとの分散の違いを考慮し、射影の統計的な安定性を維持するのに役立ちます。 flex-resizeの最終的な式は一見複雑ですが、その本質は、重み行列に柔軟性と適応性を持たせることにあります。
Flex Projection Layerの実装では、入力用と出力用の2つのパラメータ行列を使用します。それぞれ、基準となるパッチサイズ(たとえば96)に合わせて設計されています。 モデルのフォワードパスでは、同じδ⁻¹(A)+変換を用いて、これらの行列を現在のパッチの長さに合わせて調整します。 その後、パッチはモデルの隠れ空間へと射影されます。こうしてトークンが生成され、元の市場周期の構造が保持されます。
したがって、日足ローソク足を用いて週次トレンドを分析する場合でも、分足チャートを用いてスキャルピングをおこなう場合でも、モデルは常に、統一された一貫性のある形式で表現されたデータを処理します。 これにより、異なるスケール間の不整合が解消され、一から再学習することなく、事前学習済みの重みを効果的に活用できるようになります。 さまざまなソースから異なる頻度でデータが得られる金融市場において、このような柔軟性は単なる付加価値ではなく、必要不可欠なものです。
LightGTSフレームワークのアーキテクチャは、標準的なTransformerと同様に、EncoderとDecoderで構成されます。それぞれに、マルチヘッドAttentionモジュールと全結合層(フィードフォワードネットワーク)が含まれています。 ただし、重要な違いが1つあります。Attentionモジュールでは回転位置エンコーディング(RoPE)が使用されます。これにより、トークンの絶対位置だけでなく、相対位置も考慮できます。 これは、データ点の順序だけでなく、データ点間の距離も重要となる時系列において、特に有効です。
周期パッチがFlex Projectionによってトークンに変換されると、トークン列𝐗ₑ = {𝐱ₑ₁, 𝐱ₑ₂, …, 𝐱ₑₙ} が形成されます。ここで、各 𝐱ₑᵢ は、インデックスi で示されるパッチのベクトル表現です。 このトークン列を処理する際、EncoderはRoPEを用いて位置情報を組み込みます。つまり、各トークンは自身の位置を考慮するだけでなく、他のトークンとの相対的な位置のずれも考慮します。
具体的には、各トークンについて、Query(クエリ)ベクトルとKey(キー)ベクトルは、学習可能な行列 𝐖Q および 𝐖K を用いて計算されます。 次に、位置iとjに対応するベクトルの組(𝐱ₑᵢ, 𝐱ₑⱼ)に対して、回転行列𝐑i−jを適用します。この行列によって、両トークンの位置の差が明示的に反映されます。 トークンiとトークンjの間の類似度は、次の式で計算されます。
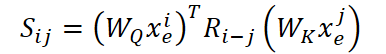
この値が大きいほど、トークンiがトークン jに向けるAttentionが強いことを意味します。 こうして得られたすべての値は、SoftMax関数を用いて正規化されます。その後、別の学習可能な行列𝐖Vを用いて得られたValueベクトルの重み付き和を計算するために使用されます。
このAttentionによって、各トークンがどの近傍トークンに注目するか、また、どの程度強く注目するかが決まります。 Attention処理の後、各トークンは全結合ブロックであるフィードフォワードネットワークによってさらに処理され、潜在的な特徴が抽出されるとともに、その表現が豊かになります。
その結果、Encoderの出力として得られる潜在空間では、各ベクトル𝐞ⱼが、対応するパッチの局所的な情報だけでなく、時系列内の相対位置を考慮した、ほかのすべてのトークンからの文脈情報も含むようになります。 この仕組みにより、モデルはデータの構造、リズム、反復パターンを捉えられるようになります。これは、個々のデータ点そのものよりも、その前後の文脈が重要となる金融時系列において、特に重要です。
前述のとおり、周期パッチ化は、時系列から繰り返し現れる周期を抽出するのに役立ちます。 しかし、予測の生成時にこの情報を最大限に活用するため、モデルは「周期的並列デコーディング」(periodic parallel decoding)という新しいアプローチを採用しています。 予測を段階的に生成する従来の自己回帰型アプローチとは異なり、この手法では非自己回帰的戦略を採用し、予測対象となる将来の期間全体を一度に処理します。
その基本的な考え方は、シンプルでありながら巧妙です。Encoderの出力である潜在空間の最後のトークン𝐞ₙには、それ以前の系列全体に関する情報が圧縮されており、その内部に含まれる周期性も反映されています。 そこで、このトークンを取り出してK複製します。ここで、K = F/Pは、予測対象となる周期の数を表します。こうして得られた行列𝐇を、Decoderへの入力として使用します。
ただし、最後のトークンが予測に与える影響は、時間的に先の将来になるほど弱まる点に注意が必要です。 そのため、各複製ベクトル𝐡ⱼ に重み関数 ω(j) = 1/eʲを適用し、現在時点から離れるにつれて、その寄与を指数関数的に減少させます。 こうして得られた重み付きトークン ω(j)·𝐡ⱼをDecoderに同時に入力します。これが、Decoderの並列アーキテクチャの基本的な仕組みです。
Decoderは、将来の各周期に対応する予測トークンを格納した行列𝐙を出力します。 これらのトークンを通常の時系列データの値に戻すため、モデルは、既出のflex-resize機構を用いた逆射影を行います。今回は、この処理をDecoderのパラメータθdに適用します。
このようにして、モデルは予測対象期間全体の予測値𝐘̂を一度に生成します。これにより、逐次的な予測で生じがちな誤差の蓄積や遅延を回避できます。 計算が高速化されるだけでなく、周期性もより適切に維持されます。これは、トークン化の段階ですでに捉えられた周期性が、Encoderから最終出力に至るまで、アーキテクチャ全体を通じて引き継がれるためです。
内部では、LightGTSは時計仕掛けのように、リズミカルかつ正確に、余分なオーバーヘッドを伴わずに動作します。 周期的トークン化と並列デコーディングにより、このモデルは、従来のアーキテクチャにありがちな、構造の複雑さや転移性の低さといった問題を回避します。
時系列予測で広く用いられている手法に従い、LightGTSフレームワークの著者らは、損失関数として標準的な平均二乗誤差(MSE)を採用しています。 MSEは、予測値と実際の観測値との誤差を測定し、予測精度を評価するための客観的な指標となります。
LightGTSフレームワークについて著者らが作成した構成図を以下に示します。
MQL5による実装
LightGTSフレームワークの理論的な側面を詳しく検討してきたので、ここからは本記事の実装編に移ります。 このセクションでは、金融時系列の特性とプラットフォームの制約を考慮しながら、MQL5を用いてモデルの主要な構成要素を実装するための、独自のアプローチを紹介します。
まずは、最も基本的でありながら、同時に非常に興味深い要素の一つである適応的周期パッチ化から始めましょう。 このメカニズムは、時系列をTransformerで処理できる構造へと変換するプロセスの出発点です。 ここでは、いくつかの簡単には解決できない課題に直面します。
その一つであるパッチサイズの動的な変更については、元のフレームワークの著者らもすでに言及しています。 論文では、重みを可変なパッチ長に適応させる洗練された手法が提案されていますが、実装上はこの問題の一部しか解決しません。 しかし、実際の実装では、この手法で解決できるのは問題の一部にすぎません。
パッチサイズが変われば、パッチ数も変化します。しかも、その変化は動的で、事前に予測できません。 これにより、モデルのアーキテクチャはさらに複雑になります。特に、MQL5のような静的な型付けを採用する言語で実装する場合は、その影響が顕著です。 従来のループや配列を扱うには、あらゆる段階でサイズを厳密に管理する必要があります。つまり、入力データの次元を調整するだけでなく、時系列の周期性と過去の観測値との整合性を保ちながら、時系列を可変数のパッチに適応的に分割する仕組みも構築しなければなりません。
残念ながら、私たちが採用しているアーキテクチャ上の仕組みでは、実行時に入力テンソルや出力テンソルの次元を動的に変更することはできません。 そのため、バッファサイズを固定したまま、可変数のトークンを扱える、より実用的なアプローチが必要になります。
考えられる方法の一つは、想定される最大数のトークンを格納できるよう、余裕を持たせたバッファを確保することです。 実際のトークン数が最大数に満たない場合、余剰のセルをゼロで埋めます。 この方法なら、パッチ数が異なる場合にもある程度柔軟に対応できます。しかし、その代償としてメモリを余分に消費し、確保した領域のかなりの部分が未使用のまま残ることになります。
さらに、Transformerアーキテクチャの重要な弱点である、シーケンス長に対してAttentionの計算量が二次的に増加するという問題も見過ごせません。 入力するトークンが増えるほど、Attentionブロックの処理に必要な時間と計算リソースも増大します。 つまり、トークン数が過剰になると、メモリ効率が低下するだけでなく、モデルの計算性能にも直接悪影響を及ぼします。これは、リアルタイム処理や高頻度の市場データを扱う場合に、特に深刻な問題となります。
そこで、より柔軟な代替手法が必要になります。 この点で注目したいのが、LightGTSフレームワークの著者らが提案した、「重複のない周期パッチ」という概念です。この手法では、時系列の各セグメントが完全な1周期に対応します。 これは理にかなった考え方です。時系列には、しばしば明確な周期成分が含まれており、各周期を個別に分析することで、意味的に明瞭な特徴量を抽出できるからです。
しかし、私たちはこの問題を別の視点から捉えることを提案します。 パッチ同士を重複させないという厳格な制約を取り払ったらどうでしょうか。 代わりに、出力パッチ数をあらかじめ指定し、入力シーケンスの周期性に応じて、隣接するウィンドウ間のオーバーラップ長を調整するのです。
このアプローチには、いくつかの利点があります。 第一に、分析対象の時系列の周期性にかかわらず、パッチ数を一定に保つことができます。 これは、アーキテクチャを固定するうえで非常に便利です。 第二に、オーバーラップを柔軟に調整することで、データを切り捨てたり、ウィンドウの境界で情報を失ったりすることなく、周期的なデータ構造全体をカバーすることができます。 最後に、出力テンソルのコンパクトさを維持しながら、意味表現の解像度をより滑らかに制御できるようになります。
つまり、私たちが提案するのは、「1パッチにつき1周期」という厳格なルールを制御された表現密度に置き換えることです。これにより、出力情報の総量を維持しながら、入力系列の長さの変化に対するモデルのロバスト性を高めます。
ここまでで、基本的な考え方は明確になったと思います。 それでは、実装に移りましょう。 最初におこなうのは、分析対象の時系列の周期性を特定することです。 そのために、高速フーリエ変換(FFT)に基づく、古典的で実績のある手法を用います。
この手法の考え方は単純です。時系列の周波数成分の振幅スペクトルを調べ、エネルギーが最も大きい周波数を特定します。 この周波数は通常、データに含まれる支配的な周期に対応します。 そして、周期は検出された周波数の逆数として求めます。
なぜFFTを選ぶのでしょうか。 第一に、大量のデータを扱う場合でも、高速かつ効率的に計算できるアルゴリズムだからです。 第二に、目視では捉えられない可能性のある、隠れた周期的依存関係を検出できます。 さらに、FFTには、時系列の周波数特性について事前情報がない場合でも利用できるという利点があります。これは、実際の取引データではよくある状況です。
もちろん、もう一つの利点は、私たちのライブラリにすぐに利用できるFFTの実装が用意されていることです。 以前、FITSフレームワークに取り組んだ際にも、この実装を使用しました。
私たちのライブラリに実装されているFFTは、スペクトルの実部と虚部を返します。これは、高速フーリエ変換の結果を表す標準的な形式です。 しかし、この情報だけでは、信号を支配し、振動の構造を決定している周波数がどれなのかは分かりません。
CPUへの過剰な負荷を避け、並列処理の効率を維持するため、各シーケンスの支配的周波数をOpenCLの実行環境内で直接特定するカーネルを実装します。 各ワークアイテムは、それぞれのスペクトルを受け取り、すべての周波数成分のエネルギーを計算したうえで、振幅が最大となる成分を選択します。 これは、複雑なメロディーを聴きながら、その全体の構造を形作る根本的なリズムを瞬時に聞き分けるようなものです。 この方法は、各変数がそれぞれ固有の特徴的な周波数を持つ可能性がある、多変量時系列を扱う場合に特に重要です。
このアルゴリズムは、実部と虚部のスペクトル成分を格納した配列を処理するOpenCLカーネルMainFreqとして実装します。 このカーネルは、各シーケンスについて、最も顕著な周波数のインデックスを格納した配列を返します。
__kernel void MainFreq(__global const float* freq_r,
                       __global const float* freq_im,
                       __global float *main_freq,
                       int dimension
                      )
  {
   if(dimension <= 0)
      return;
//---
   size_t n = get_global_id(0);
   const int shift = n * dimension;
カーネル本体では、まず一次元のタスク空間における各ワークアイテムのインデックスを取得します。 このインデックスは、分析対象となる各シーケンスを一意に識別する番号を示します。 このインデックスを使ってスペクトル配列内のオフセットを求め、各ワークアイテムが自身に対応するシーケンスだけを処理するようにします。
次に、最大振幅(エネルギー)と、それに対応するインデックスを格納する変数を初期化します。
float max_f = 0;
float max_id = 0;
float energy;
これで準備は完了です。続いて、最初の高調波からスペクトルを走査するループを設定します。
for(int i = 1; i < dimension; i++)
  {
   float2 freq = (float2)(freq_r[shift + i], freq_im[shift + i]);
   energy = ComplexAbs(freq);
   if(max_f < energy)
     {
      max_f = energy;
      max_id = i + 1;
     }
  }
ここでは、周波数ゼロの成分(DC成分)を意図的に除外します。この成分は周期性に関する情報を持たず、信号の定常成分を表すためです。
各反復処理では、実部と虚部から複素数を構成します。 この複素数の絶対値は、対応する周波数成分の強さを表します。 求めた値が現在の最大値を上回っていれば、最大値とそのインデックスを更新します。
最後に、スペクトル全体の走査が完了したら、結果をグローバルデータバッファに書き込みます。
 main_freq[n] = max_id;
}
このアルゴリズムは、経験豊かな指揮者のように、オーケストラの各楽器の音を注意深く聴き分け、どの楽器が主旋律を担っているかを見極めます。 単に周波数を特定するだけでなく、信号の中で最も顕著な周期を算出し、その結果を用いてモデル内のパッチを適応的に構築します。 また、複数系列を扱う設定でも、各系列は独立して処理されます。その結果、局所的な周期性を特定するための、自動的に動作するスケーラブルで柔軟な仕組みが実現します。
さらに、提案するアルゴリズムは完全に決定論的であり、学習可能なパラメータを一切含まず、学習コストも発生しない点を強調しておきます。 この手法はスペクトルの物理的性質のみに基づいており、統計量や回帰分析、適応的な重みを用いることなく、周波数成分の振幅を直接評価します。 そのため、処理の仕組みが明確で信頼性が高く、特にデータの前処理段階で扱いやすい手法となっています。この段階では、アンダーフィッティングやオーバーフィッティングに起因する歪みの混入を防ぐことが重要です。 つまり、このアプローチは確率論的な仮定ではなく、純粋で偏りのない数学に基づいています。これは、変動の激しい市場の時系列を分析するうえで、特に重要な点です。
次のステップでは、セグメントサイズが動的に変化する適応的パッチ化アルゴリズムを実際に実装します。 しかし、ご想像のとおり、これは簡単に説明できる内容ではありません。 実装にあたっては、数多くの技術的な詳細に注意を払う必要がありますし、この記事もすでにかなりの長さになっています。 そこで、サスペンスドラマの伝統にならい、ここでいったん小休止を挟み、提案した手法の実装方法については次回の記事で引き続き解説することにしましょう。
次回の記事では、周期長の変動に対応しながら出力トークン数を一定に保つ、パッチの動的生成メカニズムについて、実装手順を一つずつ解説します。 また、アーキテクチャの柔軟性と計算効率の間に生じるトレードオフについても検討します。
結論
本記事では、LightGTSフレームワークの理論的基礎について、周期的パッチ化、柔軟なトークン射影、並列デコーディング機構という主要な構成要素に焦点を当て、詳しく解説しました。 また、モデルの再学習をおこなうことなく、このアーキテクチャが多変量時系列を処理し、さまざまな周期に適応する仕組みを分析しました。 特に、高速フーリエ変換(FFT)を用いて支配的周波数を算出する際の技術的な側面について、重点的に取り上げました。
さらに、動的なメモリ割り当てやトークン数の変動に伴う実装上の制約についても検討し、オーバーラップするパッチと固定長の出力ベクトルに基づく代替手法を提案しました。 このアプローチは、Transformerアーキテクチャとの互換性を高めるだけでなく、メモリの過剰な消費や性能の低下を回避し、計算リソースをより効率的に活用することを可能にします。
本記事で紹介した内容は、適応的パッチ化の完全な実装と、それを予測アーキテクチャに統合するための確かな基盤となります。 次回の記事では、引き続きこのテーマを掘り下げ、時系列を適応的に分割する具体的な実装方法と、生成されたトークンを学習可能なモデルに統合する方法について解説します。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18596
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


 取引におけるニューラルネットワーク:インテリジェントな予測パイプライン(スパース混合エキスパート)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 初級から中級まで:サンドボックスの操作

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索