

Neuronale Netze im Handel: Das adaptive Graphdiffusionsmodell (SAGDFN)
 12
 0

Einleitung
Multivariate Zeitreihen zeichnen sich nicht nur durch die bekannte zeitliche Abhängigkeit (Trends, Saisonalität, plötzliche Aktivitätsspitzen) aus, sondern auch durch räumliche Korrelation, die weitaus heimtückischer ist. Sie beschreibt, wie sich Veränderungen in einer Sequenz auf andere auswirken. Und diese Zusammenhänge entwickeln ein Eigenleben: Sie entstehen und verschwinden wieder, und ihre Stärke und Richtung ändern sich je nach weltweiten Nachrichten, Veränderungen in der nationalen Geldpolitik, politischen Krisen oder technologischen Durchbrüchen. So kann beispielsweise der EURUSD-Wechselkurs als Reaktion auf Veränderungen der Erdgaspreise in Europa schwanken, die durch Energieschocks verursacht werden, während die Aktienkurse von Halbleiterherstellern von den Bedingungen in asiatischen Fabriken beeinflusst werden können.
Traditionelle Modelle wie ARIMA oder VAR funktionierten bei einzelnen Zeitreihen recht gut, doch sobald man es mit Hunderten Finanzinstrumenten zu tun hat, stoßen sie an ihre Grenzen. Methoden des maschinellen Lernens der nächsten Generation (Support-Vektor-Maschinen (SVMs), Gauß-Prozesse) haben die Möglichkeiten der Analyse erweitert, doch ihre Architektur hat das komplexe Netzwerk von Verknüpfungen bislang kaum berücksichtigt. Selbst moderne rekurrente neuronale Netze (RNNs) und Transformer, die bei der Sequenzverarbeitung beeindruckende Ergebnisse erzielt haben, erwiesen sich in einem multivariaten Kontext als begrenzt: Ihnen fehlte die nötige Flexibilität, um dynamische Korrelationsnetzwerke zu verarbeiten.
Vor diesem Hintergrund entstanden graphneuronale Netze (GNNs); sie wurden ursprünglich für Aufgaben mit einer ausgeprägten Graphstruktur entwickelt: Verkehrsnetze, soziale Interaktionen und Lieferketten. In der Finanzwelt grenzt die Konstruktion eines solchen Graphen jedoch schon fast an Kunst. Zwei Unternehmen derselben Branche können sich völlig gegensätzlich verhalten, während zwei weit voneinander entfernte Märkte (wie die USA und Japan) auf dieselben makroökonomischen Impulse im Gleichklang reagieren können.
Die Lösung waren graphneuronale Netze mit adaptiven Gewichten (GNNs mit adaptiven Gewichten), die einen Graphen direkt aus den Daten und nicht auf der Grundlage von Annahmen erstellen. Sie lernen eine Matrix der Beziehungen zwischen Vermögenswerten und ermitteln dabei tatsächliche statt formale Korrelationen. Ein klassisches Beispiel: Gold und der japanische Yen, die oft als sichere Häfen fungieren. Unter normalen Umständen ist der Zusammenhang zwischen ihnen vielleicht nicht offensichtlich, doch in Zeiten globaler Umbrüche erkennt das Modell die Synchronität ihrer Entwicklungen und passt die Prognose entsprechend an.
Dennoch sind auch diese Ansätze nicht ohne Einschränkungen. Erstens die Skalierbarkeit: Eine N×N-Korrelationsmatrix für eine große Anzahl von Vermögenswerten wird zu einem ressourcenhungrigen Monster, das selbst leistungsstarke GPUs zum Erliegen bringen kann, indem es deren Speicher mit Zwischenergebnissen überflutet. Zweitens: Scheinzusammenhänge. Viele adaptive Algorithmen gehen davon aus, dass alle Knoten in gewissem Maße miteinander verbunden sind, doch dies ist nicht der Fall. In Finanzprognosen sollte eine unbedeutende Aktie an einem lokalen Markt keinen wesentlichen Einfluss auf globale Prognosen haben.
Um diese Probleme anzugehen, wurde ein neuer Ansatz entwickelt, der auf Graphdiffusion und dem Prinzip der räumlichen Dünnbesetztheit basiert. Entscheidend ist, nicht zu versuchen, jede mögliche Verbindung zu analysieren, sondern Schlüsselknoten – sozusagen Einflussanker – zu identifizieren, die den Ton für das gesamte System angeben. Im Finanzkontext könnten dazu der US-Dollar, der Euro, Öl, Gold sowie die Aktienindizes S&P 500 und Nikkei 225 gehören.
Unter diesen Algorithmen sticht das SAGDFN-Framework hervor; es wurde in der Arbeit „SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting“ vorgestellt. Die Autoren des Frameworks schlagen vor, die signifikantesten Knoten mithilfe des Significant Nodes Sampling-Algorithmus auszuwählen. Das Sparse Spatial Multi-Head Attention-Modul wird anschließend verwendet, um diese Wechselbeziehungen weiter zu verfeinern. Das Ergebnis ist eine kompakte N×M-Matrix, wobei M um ein Vielfaches kleiner ist als N.
Durch den vorgeschlagenen Ansatz lässt sich die Rechenkomplexität von N² auf MN reduzieren, während gleichzeitig der Speicherbedarf sinkt. Dadurch lassen sich Prognosen für riesige Datensätze erstellen, ohne die Rechenressourcen zu überlasten, und das System wird robuster gegenüber Rauschen. Dies gewinnt insbesondere in Zeiten von Marktturbulenzen an Bedeutung, die durch unerwartete Entscheidungen der Zentralbanken und starke Schwankungen der Rohstoffpreise verursacht werden.
Die praktischen Auswirkungen liegen auf der Hand. Große Investmentfonds erhalten ein Instrument für ein präziseres Portfolio-Rebalancing. Für Hedgefonds bietet dies eine Grundlage für Strategien, die nicht nur die Dynamik einzelner Vermögenswerte berücksichtigen, sondern auch das komplexe Zusammenspiel globaler Wechselbeziehungen. Algorithmische Händler erhalten die Möglichkeit, mit einer großen Anzahl von Finanzinstrumenten zu arbeiten, ohne dass es dabei zu kritischen Verzögerungen bei der Entscheidungsfindung kommt.
Der SAGDFN-Algorithmus
Das skalierbare adaptive Graphdiffusions-Prognosenetzwerk (SAGDFN) ist ein hochmoderner Algorithmus, der darauf ausgelegt ist, Zeitreihenprognosen flexibler, skalierbarer und effizienter zu gestalten – selbst bei der Arbeit mit extrem großen Graphen. Die Grundidee besteht darin, den Rechenaufwand und den Speicherbedarf deutlich zu reduzieren, ohne dabei die Genauigkeit der Vorhersagen zu beeinträchtigen. Anstatt die gesamte Graphstruktur mechanisch zu verarbeiten, konzentriert sich das Modell auf die wichtigsten Elemente und Verbindungen, die einen tatsächlichen Einfluss auf das Endergebnis haben. Dieser Ansatz beseitigt nicht nur überflüssiges Rauschen, sondern ermöglicht es auch, Prognosen schneller, kostengünstiger und genauer zu erstellen.
Beim Betrieb von SAGDFN spielt die α-Entmax-Funktion eine entscheidende Rolle. Sie fungiert als eine Art Filter, der dem Modell dabei hilft, wirklich wichtige räumliche Korrelationen zwischen den Knoten eines Graphen zu erkennen und nebensächliche Verbindungen zu ignorieren. Dies ist besonders wertvoll in Situationen, in denen die Daten eine komplexe und sich dynamisch verändernde Struktur aufweisen, wie beispielsweise auf den Finanzmärkten oder in städtischen Verkehrssystemen. Auf der Grundlage der ausgewählten Verbindungen wird eine kompakte Adjazenzmatrix gebildet; diese Matrix wird nicht manuell festgelegt, sondern während des Trainingsprozesses generiert. Durch diesen dynamischen Aufbau ist der Algorithmus flexibler und kann sich besser an neue Bedingungen anpassen, ohne dass eine vollständige Neukonfiguration erforderlich ist.
Die SAGDFN-Architektur basiert auf dem bewährten Encoder-Decoder-Framework, erfordert jedoch keinerlei Vorkenntnisse über räumliche Beziehungen. Dies gewährleistet die Vielseitigkeit des Modells und seine Anwendbarkeit in einer Vielzahl von Bereichen: von der Analyse finanzieller Schwankungen – bei der es darauf ankommt, die Zusammenhänge zwischen einer Vielzahl von Vermögenswerten zu erkennen – bis hin zur Prognose von Energieflüssen, Logistikrouten und sogar Produktionsketten. Das Modell ermittelt nacheinander die signifikantesten Nachbarn jedes Knotens, kombiniert diese mit den Ausgangsinformationen und erstellt eine dicht besetzte Adjazenzmatrix, die anschließend für die räumlich-zeitliche Analyse verwendet wird.
Eine Besonderheit von SAGDFN besteht darin, dass alle seine Schlüsselkomponenten synchron und koordiniert trainiert werden. In einer einheitlichen Optimierungsschleife werden die Indizes der signifikanten Knoten, deren Einbettungen, die Aufmerksamkeitsparameter und die abschließende Adjazenzmatrix optimiert. Die L1-Verlustfunktion wird während des Trainings verwendet; sie trägt dazu bei, ein Gleichgewicht zwischen Vorhersagegenauigkeit und Robustheit gegenüber Rauschen in den Daten herzustellen. Dieser Ansatz stellt sicher, dass das Modell im Laufe der Zeit nicht nur die Qualität seiner Prognosen verbessert, sondern sich auch an Veränderungen in der Struktur des analysierten Systems anpasst.
Folglich löst SAGDFN eines der seit Langem bestehenden Probleme bei graphneuronalen Netzen: Wie lässt sich eine hohe Vorhersagegenauigkeit aufrechterhalten und gleichzeitig übermäßige Komplexität und Rechenaufwand vermeiden?
Die Autoren des SAGDFN-Frameworks übertrugen die Aufgabe der Auswahl der wichtigsten Knoten dem Modul Significant Neighbors Sampling (SNS) – einem methodischen Ansatz, der darauf abzielt, die Rechenprozesse in graphneuronalen Netzen (GNNs) bei der Vorhersage von Zeitreihen mit einer großen Anzahl miteinander verbundener Elemente zu optimieren.
Bei herkömmlichen Implementierungen von Graphmodellen wird eine vollständige N×N-Adjazenzmatrix erstellt und für die anschließende Graphfaltung verwendet, um räumliche Korrelationen zwischen allen Knoten des analysierten Graphen zu ermitteln. Dieser Ansatz weist jedoch eine quadratische Rechenkomplexität auf, wodurch er äußerst ressourcenintensiv ist. Dies gilt insbesondere dann, wenn die Anzahl der Knoten 2000 übersteigt – eine Situation, die in realen Anwendungen häufig vorkommt, sei es auf den Finanzmärkten, in Verkehrsnetzen oder in industriellen Überwachungssystemen.
Der Kerngedanke hinter SNS besteht darin, die Bedeutung von Verbindungen zu überdenken: Nicht jeder Knoten hat einen wesentlichen Einfluss auf den Zustand eines bestimmten Elements im Graphen. Um eine genaue Vorhersage zu treffen, reicht es aus, nur eine kleine, äußerst relevante Teilmenge von Nachbarn zu berücksichtigen, die einen entscheidenden Beitrag zur Dynamik des Prozesses leisten. Das Verfahren sieht vor, solche signifikanten Nachbarn dynamisch aus allen N Knoten auszuwählen und so eine kompakte Adjazenzmatrix der Größe N×M zu erstellen, wobei M deutlich kleiner ist als N. Dadurch wird die Belastung der Rechenressourcen verringert und die Datenverarbeitung beschleunigt, während die Fähigkeit des Modells, die internen Zusammenhänge des Systems genau abzubilden, erhalten bleibt.
Die Verarbeitung in SNS beginnt mit der Initialisierung der Knoten-Einbettungsmatrix E ∈ RN×d, wobei jede Zeile Ei eine Vektordarstellung des i-ten Knotens ist und Informationen über dessen Eigenschaften und Beziehungen enthält. Gleichzeitig wird eine Kandidatenmatrix C ∈ {1,…,N}N×M erstellt, wobei jede Zeile eine Menge potenziell signifikanter Nachbarn für den entsprechenden Knoten angibt. Zum jetzigen Zeitpunkt steht noch nicht fest, welche Nachbarn sich als die wichtigsten erweisen werden – das Auswahlproblem wird später unter Berücksichtigung der räumlichen und kontextbezogenen Merkmale der Daten gelöst.
Anschließend ordnet der SNS-Algorithmus die M Kandidaten für jeden Knoten nach ihrer Relevanz, wobei ein Maß für die Nähe zwischen den Einbettungen herangezogen wird – meist der euklidische Abstand, obwohl auch andere Metriken verwendet werden können. Je geringer der Abstand zwischen den Vektordarstellungen zweier Knoten ist, desto höher ist die Wahrscheinlichkeit, dass ihre Beziehung den tatsächlichen Einfluss des einen auf den anderen widerspiegelt. Anschließend wird eine abschließende Menge der K signifikantesten Nachbarn gebildet, die als Kern der Adjazenzmatrix dient. Die verbleibenden M−K Positionen können mit zufällig ausgewählten Elementen besetzt werden, um die Vielfalt der Verbindungen zu erhöhen und die Robustheit des Modells gegenüber lokalen Schwankungen in den Daten zu verbessern. Dieser kombinierte Ansatz vermeidet eine übermäßige strukturelle Starrheit und verhindert eine Überanpassung, die häufig auftritt, wenn Verbindungen statisch fixiert sind.
Das Verfahren gibt eine Indexmenge I signifikanter Knoten aus, aus der eine kompakte Adjazenzmatrix As der Größe N×M konstruiert wird. Dieser Ansatz reduziert die Rechenkomplexität erheblich auf ein nahezu lineares Niveau, statt der quadratischen Komplexität O(N²) der herkömmlichen Implementierung. Und das, ohne Abstriche bei der Prognosequalität zu machen. Dadurch eröffnet SNS die Möglichkeit, graphneuronale Netze in Bereichen einzusetzen, in denen solche Ansätze bisher als zu ressourcenintensiv galten: So lassen sich in Echtzeit Schwankungen der Marktpreise, die Verteilung von Verkehrsströmen, Veränderungen im Energieverbrauch und andere Prozesse vorhersagen, bei denen die Wechselbeziehungen zwischen den Elementen eine entscheidende Rolle spielen.
Somit spart Significant Neighbors Sampling nicht nur Ressourcen – es ermöglicht uns auch, das Konzept der Arbeit mit großen Graphen grundlegend zu überdenken. Der Wechsel von einer globalen Analyse aller Zusammenhänge hin zu einer dynamischen und selektiven Analyse schafft die Voraussetzungen für die Entwicklung flexiblerer und anpassungsfähigerer Vorhersagemodelle, die lernen, sich auf das Wesentliche zu konzentrieren, anstatt sich in einer Flut von Daten zu verlieren.
Das Modul für dünn besetzte räumliche Mehrkopfaufmerksamkeit (Sparse Spatial Multi-Head Attention) in SAGDFN ist die Kernkomponente, die die ausgewählten signifikanten Nachbarknoten in eine kompakte Verbindungsmatrix As der Größe N×M umwandelt. Diese bestimmt, wie viele Informationen fließen sollen: von jedem der M Knoten zu einem bestimmten Knoten i während der Graphfaltung. Im Gegensatz zu Ansätzen, die auf Vorwissen über die Topologie beruhen, wird das SS-MHA-Modul vollständig aus Daten aufgebaut. Es stützt sich nicht auf externe Strukturen und ist nicht anfällig für fehlerhafte oder veraltete Annahmen über räumliche Zusammenhänge. Dadurch ist das Modell vielseitig einsetzbar und lässt sich auf eine Vielzahl von Problemstellungen in Finanzmärkten, Energienetzen oder Verkehrsströmen anwenden, bei denen sich die Beziehungen zwischen den Komponenten im Laufe der Zeit ändern und nicht durch ein einfaches, manuell erstelltes Modell erfasst werden können.
Technisch gesehen vereint das Modul zwei Schlüsselkonzepte. Erstens ermöglicht das Skalarprodukt von Vektoren eine effiziente und parallele Schätzung eines grundlegenden Ähnlichkeitsmaßes zwischen Knoten: Der Vektor des Knotens i wird in eine M×d-Matrix umgewandelt, indem die Zeile wiederholt und mit den Einbettungen seiner M signifikanten Nachbarn konkateniert wird. Dadurch entsteht eine Matrix, die gleichzeitig Informationen über den lokalen Kontext eines Knotens und dessen potenzielle Nachbarn enthält, was den Weg für schnelle Matrixoperationen in modernen Frameworks zur automatischen Differenzierung ebnet.
Zweitens weichen die Autoren des SAGDFN-Frameworks von einem rein linearen Ansatz ab und trainieren mithilfe kleiner Feedforward-Netzwerkblöcke (FFNs) ein nichtlineares Korrelationsmaß. Für jeden Knoten und jeden Aufmerksamkeitskopf wandeln diese FFNs die konkatenierten Darstellungen in eine Matrix von Bewertungswerten Y um, wobei die beiden Spalten als wahrscheinliche bzw. weniger wahrscheinliche Korrelationen interpretiert werden. In diesem Zusammenhang lässt sich eine Multi-Head-Architektur mit der Arbeit einer Expertengruppe vergleichen, die denselben Datensatz aus verschiedenen Blickwinkeln untersucht: Ein Aufmerksamkeitskopf identifiziert saisonale Zusammenhänge, ein anderer erkennt Reaktionen auf Nachrichten und ein dritter deckt latente Risikoindikatoren auf.
Ein wichtiger Schritt ist die Normalisierung der Bewertungswerte. Anstelle der üblichen SoftMax-Funktion, die die Gewichte über die gesamte Menge verteilt und häufig viele kleine, unbedeutende Verbindungen erzeugt, empfehlen die Autoren des Frameworks die Verwendung der α-Entmax-Funktion. Sie erzeugt dünn besetzte, aber aussagekräftige Aufmerksamkeitsverteilungen: Große Werte werden verstärkt, während kleine auf null reduziert werden. In Finanzanwendungen ist dies von entscheidender Bedeutung: Es gibt nur wenige Finanzinstrumente auf dem Markt, die zu einem bestimmten Zeitpunkt wirklich die Richtung vorgeben – eine Reservewährung, ein wichtiger Index oder ein zentraler Rohstoff. α-Entmax wirkt wie eine Linse, die markante Objekte fokussiert und Hintergrundrauschen herausfiltert. Der Parameter α kann Werte von 1 bis 2 annehmen: Bei α=1 entspricht die Funktion SoftMax, bei α=2 SparseMax. Für den jeweiligen Datenbereich wird der optimale Grad der Dünnbesetztheit ausgewählt.
In der Praxis werden für jeden Aufmerksamkeitskopf normalisierte Bewertungswerte Zp berechnet, die zu einem mehrdimensionalen Tensor Zi für den Knoten i zusammengefasst werden. Anschließend wird über alle Knoten hinweg ein Tensor Z der Größe N×M×(2P) gebildet und mittels einer linearen Transformation mit den Gewichten Wa auf die endgültige Matrix As der Größe N×M reduziert. Diese Matrix ist kein dicht besetzter N×N-Graph mehr; stattdessen wählt sie für jeden Knoten sorgfältig nur jene M Signale aus, die die nachfolgende Graphfaltung tatsächlich beeinflussen.
Dieser Ansatz ist besonders auf den Finanzmärkten wirksam, wo Finanzinstrumente, die heute die Kursentwicklung beeinflussen, morgen möglicherweise nicht mehr denselben Effekt haben. So können beispielsweise in Zeiten der Panik Gold und der Yen die Richtung vorgeben; in einer Phase des Wirtschaftswachstums können der S&P 500-Index und Technologieaktien diese Rolle übernehmen, während bei einem Energieschock die Ölpreise und die Währungen energieexportierender Länder maßgeblich sein können. Das Modul ermöglicht es, solche offensichtlichen und verborgenen Impulsgeber zu identifizieren und gleichzeitig zufällige Korrelationen auszuschließen, die die Prognose verfälschen könnten.
Neben der Verbesserung der Prognosegenauigkeit bietet α-Entmax weitere Vorteile: Dünn besetzte Verteilungen der Bewertungswerte reduzieren die Anzahl unnötiger Operationen bei der Graphfaltung und machen das Modell besser interpretierbar; Analysten können erkennen, welche M Knoten die Prognose für ein bestimmtes Finanzinstrument tatsächlich beeinflusst haben. Die Kombination aus zufälliger Ersetzung bei der Auswahl von Nachbarn und einer Normalisierung, die Dünnbesetztheit erzeugt, stellt sicher, dass die Einbettungen im gesamten Netzwerk aktualisiert werden, ohne dass wichtige Variablen übersehen werden.
Die technische Umsetzung berücksichtigt die effiziente Nutzung von GPUs und Frameworks zur automatischen Differenzierung: Konkatenation und Stapelverarbeitung, kompakte FFNs für jeden Aufmerksamkeitskopf sowie eine lineare Transformation des abschließenden Tensors Z in As zur fein abgestuften Parametrisierung des Einflusses jedes Aufmerksamkeitskopfes und jedes Kanals.
Insgesamt bietet Sparse Spatial Multi-Head Attention einen praktischen Kompromiss zwischen Genauigkeit und Ressourceneffizienz: Sensibilität für die wichtigsten Signale, Anpassungsfähigkeit an sich ändernde Bedingungen und Skalierbarkeit auf Tausende Zeitreihen.
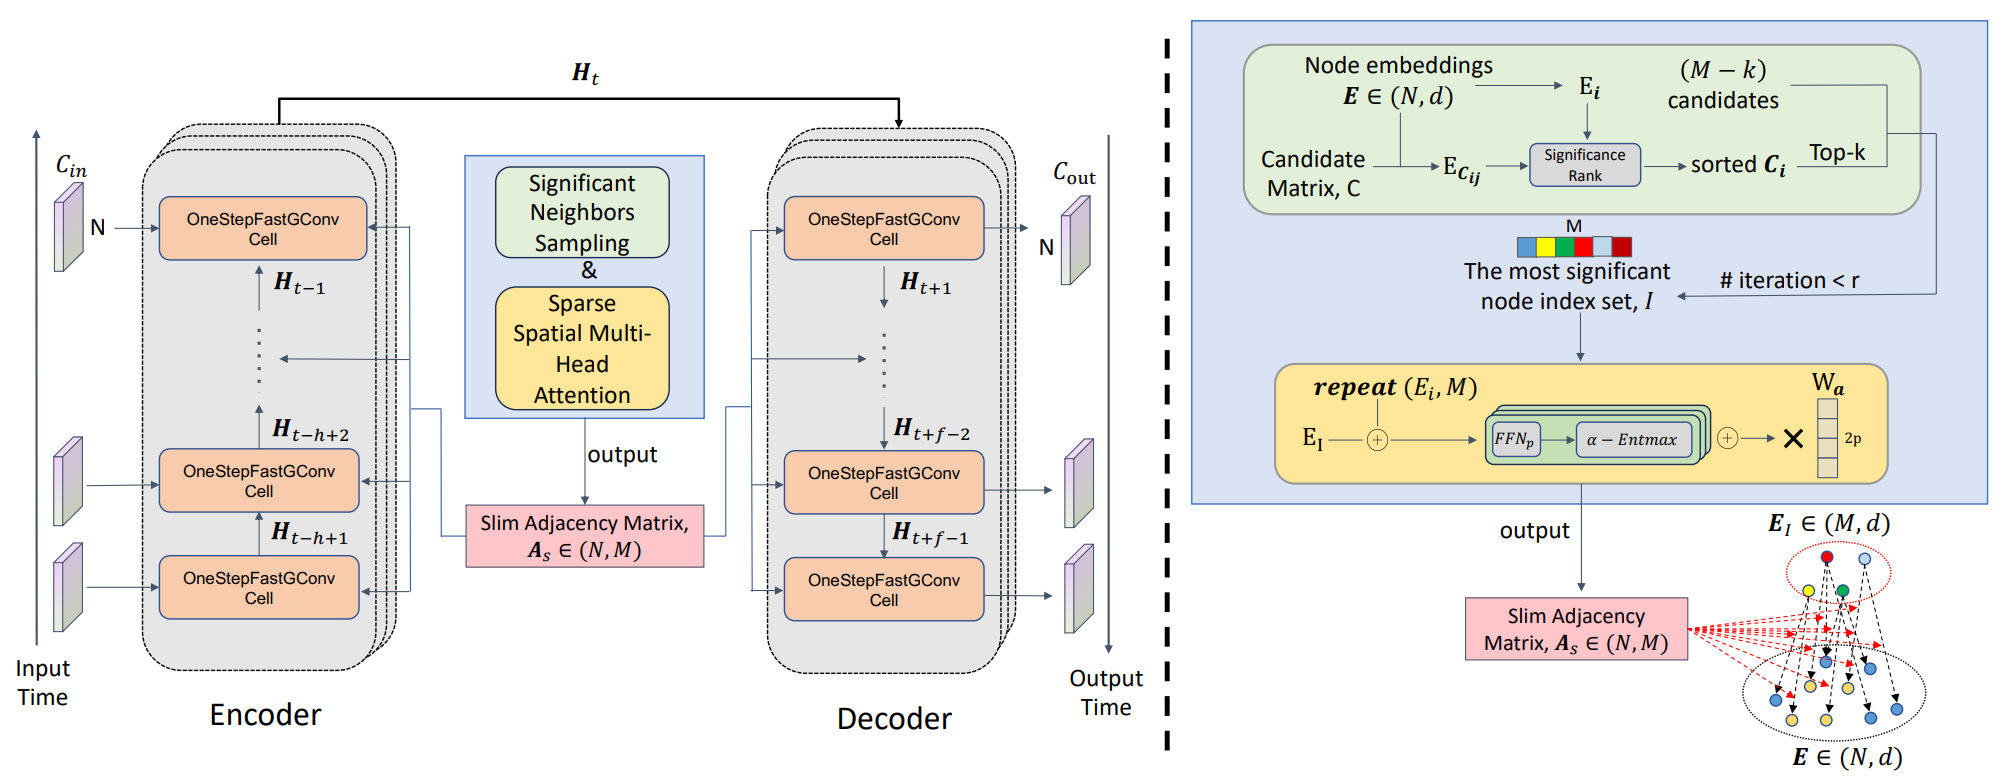
Die Prognose auf Basis der Encoder-Decoder-Architektur im SAGDFN-Framework bildet den Abschluss aller vorangegangenen Phasen. Dieser Ansatz kombiniert zuvor ausgewählte signifikante Nachbarn, Sparse Spatial Multi-Head Attention und effiziente Graphfaltung mit einem leistungsstarken sequenziellen Modell, das es ermöglicht, die zeitliche Dynamik zu berücksichtigen. Im Gegensatz zu einfacheren Ansätzen, die sich auf räumliche Abhängigkeiten oder den zeitlichen Aspekt konzentrieren, ermöglicht es der von den Autoren des Frameworks vorgeschlagene Ansatz, beide Dimensionen gemeinsam zu beschreiben und zu nutzen. Dadurch lassen sich genauere und robustere Prognosen für multivariate Zeitreihen erstellen.
Anschaulich lässt sich die Funktionsweise der Encoder-Decoder-Architektur wie folgt darstellen: Der Encoder verdichtet Informationen aus der historischen Sequenz und fasst dabei räumlich-zeitliche Muster in einer kompakten Darstellung verborgener Zustände zusammen. Der Decoder erstellt dann Schritt für Schritt Prognosen, wobei er diese Darstellung und die in jedem Schritt erhaltenen Prognosewerte verwendet.
In diesem Fall ist der entscheidende Bestandteil ein schneller Mechanismus zur Graphdiffusion, der auf der kompakten Adjazenzmatrix As basiert und die Übertragung relevanter Informationen zwischen den Knoten des Graphen bei jedem Zeitschritt gewährleistet.
Eine mehrstufige Graphfaltung, die die Informationsausbreitung zwischen Nachbarn umsetzt, wird durch folgenden Ausdruck definiert:
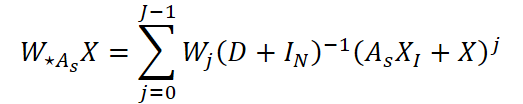
wobei D die diagonale Gradmatrix zu As ist, IN die Einheitsmatrix der Größe N ist und XI die Matrix der Eingabedaten ist, die über die ausgewählten M Nachbarn (indiziert durch I) aggregiert wurden.
Ein solcher Operator bewahrt Informationen über den eigenen Zustand des Knotens (den Term X) und sammelt das Signal der relevanten Nachbarn (AsXI), normalisiert beides anschließend anhand der Gradsumme und leitet es durch lineare Filter Wj weiter. Der praktische Vorteil besteht darin, dass sich der Radius der Informationsausbreitung mithilfe des Parameters J steuern lässt: Ein kleiner Wert von J erfasst lokale Verbindungen, während ein großer Wert auch weiter entfernte Einflüsse berücksichtigt.
Anschließend integrieren die Autoren des SAGDFN-Frameworks diese Graphoperation in einen GRU-ähnlichen Schritt, wobei sie die übliche Matrixmultiplikation durch eine Graphfaltung ersetzen. Daraus ergibt sich OneStepFastGConv, eine einschrittige Iteration, die räumliche Aggregation und zeitliche Rekurrenz kombiniert:
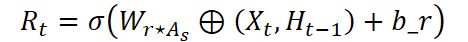
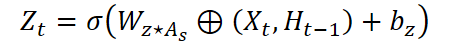
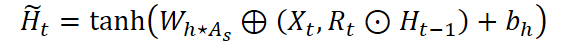
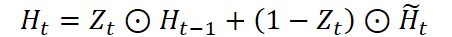
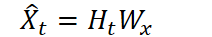
Hier kombiniert der Konkatenationsoperator ⊕ die aktuelle Beobachtung mit dem vorherigen verborgenen Zustand, während die Operatoren ⊙ und σ ihre üblichen Bedeutungen haben. Dieser Schritt stellt sicher, dass jeder Knoten vor der Aktualisierung seines verborgenen Zustands seine eigenen Merkmale sowie das Signal seiner wichtigsten Partner im Graphen berücksichtigt. Dies ist insbesondere im Finanzbereich von Bedeutung: Bei der Prognose des Kurses einer Aktie wird nicht nur deren eigene Kurshistorie berücksichtigt, sondern auch die Kursbewegungen wichtiger, mit ihr zusammenhängender Finanzinstrumente – Währungen, Rohstoffe und Indizes.
Die Datenprognose erfolgt in zwei Stufen: im Encoder und im Decoder. Im Encoder führen wir OneStepFastGConv auf einem historischen Datenfenster der Länge h aus und erhalten schließlich eine Darstellung Ht0-1, in der die räumlich-zeitlichen Informationen des gesamten analysierten Datenfensters zusammengefasst sind.
Anschließend startet der Decoder mit dem Anfangszustand Ht0-1 und der Beobachtung im Schritt t0 und generiert nacheinander die angegebene Anzahl zukünftiger Schritte.
Das Training erfolgt mittels durchgängiger Fehlerrückpropagation – Gradienten bezüglich Θ (einschließlich der Einbettungen, der FFN-Parameter im Aufmerksamkeitsmodul, der Gewichte der Graphfaltung und der GRU-Parameter) werden berechnet und zur Aktualisierung des Modells verwendet. Es ist anzumerken, dass sich die Graphstruktur im Laufe des Trainings ebenfalls verändert, da Einbettungen sowohl bei der Auswahl von Nachbarn als auch bei der Berechnung von As eine Rolle spielen: Dies verleiht dem System Anpassungsfähigkeit und ermöglicht es ihm, neue bedeutsame Verbindungen zu entdecken, wenn sich der Markt verändert.
Der Encoder-Decoder bildet in Kombination mit OneStepFastGConv und der adaptiven As-Struktur eine leistungsstarke und flexible Plattform für die räumlich-zeitliche Vorhersage. Er vereint Interpretierbarkeit (durch eine dünn besetzte Verbindungsmatrix und die Visualisierung relevanter Nachbarn), Anpassungsfähigkeit (dynamische Aktualisierung von Einbettungen und Graphstruktur) sowie praktische Skalierbarkeit, was ihn zu einem besonders wertvollen Werkzeug für die Analyse und Entscheidungsfindung auf den Finanzmärkten macht.
Nachfolgend ist die von den Autoren erstellte Darstellung des SAGDFN-Frameworks abgebildet.
Implementierung in MQL5
Nach einer ausführlichen Erörterung des theoretischen Teils des SAGDFN-Frameworks wenden wir uns nun der praktischen Umsetzung der vorgeschlagenen Ansätze zu. An dieser Stelle zeigen wir eine praktische Möglichkeit auf, wie sich die Ideen der Autoren des Frameworks auf die MQL5-Umgebung übertragen lassen. Im Rahmen dieser Arbeit werden wir folgende Punkte betrachten:
- Datenaufbereitung;
- Speichern und Aktualisieren von Einbettungen;
- Stichprobenziehung signifikanter Nachbarn;
- der dünn besetzte Aufmerksamkeitsmechanismus;
- Integration einer schnellen Graphfaltung in die rekurrente Logik.
Unser Ziel ist eine funktionsfähige, reproduzierbare und – was am wichtigsten ist – praktische Umsetzung, die für den Einsatz in der Praxis geeignet ist.
Das Modul „Significant Neighbors Sampling“ erfüllt eine einfache, aber äußerst wichtige Aufgabe: Es ist dafür zuständig, die führenden Knoten auszuwählen, die die Informationslandschaft des Netzwerks tatsächlich prägen. Die richtige Auswahl der Nachbarn entscheidet darüber, welche Signale verstärkt werden und welche als Hintergrundrauschen verbleiben.
An dieser Stelle sei darauf hingewiesen, dass die Autoren des SAGDFN-Frameworks vorgeschlagen haben, für die im vorherigen Schritt ermittelten M signifikantesten Nachbarn eine Rangbildung vorzunehmen, um eine Menge der K nächstgelegenen Elemente zu bilden, die als Kern der Adjazenzmatrix dienen. Die verbleibenden M−K Positionen werden mit zufällig ausgewählten Elementen besetzt, um die Vielfalt der Verbindungen zu erhöhen. In unserer Implementierung haben wir uns entschlossen, noch einen Schritt weiter zu gehen und eine parallele Rangbildung für eine Zufallsstichprobe hinzuzufügen.
Die Idee ist einfach, aber effektiv: Anstatt zunächst die K nächstgelegenen Kandidaten auszuwählen und diese dann durch zufällige Elemente zu ergänzen, erstellen wir zwei Pools – einen mit vorausgewählten Kandidaten und einen mit zufälligen Kandidaten. Anschließend werten wir sie gleichzeitig aus. Die endgültige Stichprobe umfasst die Knoten aus dem kombinierten Pool, die hinsichtlich ihrer Einbettungen dem jeweiligen Ausgangsknoten tatsächlich am nächsten liegen, unabhängig davon, ob sie anhand einer Heuristik oder zufällig ausgewählt wurden. Diese Kombination aus Exploitation und Exploration verleiht dem Modell sowohl Stabilität als auch Flexibilität: Es behält bewährte Spitzenkandidaten bei und bleibt gleichzeitig offen für die Identifizierung neuer Zentren des Markteinflusses.
Wir werden die technische Umsetzung dieses Algorithmus in den OpenCL-Kontext verlagern. Dazu erstellen wir einen SignificantNeighborsSampling-Kernel.
__kernel void SignificantNeighborsSampling(__global const float *data,
                                           __global const float *candidates,
                                           __global const float *random_cands,
                                           __global float *neighbors,
                                           const int dimension
                                          )
  {
   const size_t main = get_global_id(0);
   const size_t slave = get_local_id(1);
   const int total_main = (int)get_global_size(0);
   const int total_slave = (int)get_local_size(1);
Der Kernel beginnt mit einer Signaturdeklaration. Als Eingabe erhält er die globalen Arrays data, candidates und random_cands, die zur Speicherung der Einbettungen der Zeitreihen und der beiden Kandidatenpools dienen. Das Array neighbors dient zur Speicherung der Ergebnisse. Der ganzzahlige Parameter dimension bestimmt die Größe der Einbettung. Die Signatur legt die Arbeitsverteilung fest: Ein globales Work-Item ist für einen primären Knoten (main) zuständig, während eine Menge lokaler Work-Items innerhalb einer Gruppe die Kandidaten verarbeitet.
Anschließend werden die Ausführungskontext-Identifikatoren extrahiert, lokale Arrays deklariert und die lokale Arbeitsgröße berechnet.
   __local int Idx[LOCAL_ARRAY_SIZE];
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int ls = min(total_slave, (int)LOCAL_ARRAY_SIZE);
Der lokale Speicher ist ein leistungsstarkes Werkzeug zur Beschleunigung von Berechnungen: Hier wird er als Puffer zur vorübergehenden Speicherung von Indizes und Abständen innerhalb einer Untergruppe verwendet.
Im nächsten Block ermitteln wir die Offsets der benötigten Sequenzelemente in den flachen Quelldaten-Arrays.
   const int shift_main = RCtoFlat(main, 0, total_main, dimension, 0);
   int cand = (int)candidates[slave];
   int rand_cand = (int)random_cands[slave];
Als Nächstes ist anzumerken, dass wir zwei Pools zur Suche nach den nächsten Nachbarn verwenden, von denen einer durch zufällige Stichprobenziehung erzeugt wird. In diesem Fall ist es durchaus möglich, dass ein oder mehrere Elemente der Sequenz in beiden Stichproben vorkommen. Daher führt der nächste Block eine einfache Duplikatsprüfung durch. Dadurch wird verhindert, dass derselbe Index erneut berücksichtigt wird, was logisch ist und Rechenaufwand spart. Im ersten Schritt prüfen wir, ob innerhalb des aktuellen Work-Items Duplikate vorhanden sind.
//--- duplicate check
   if(rand_cand == cand)
      rand_cand = -1;
Als Nächstes prüfen wir, ob es unter den zuvor ausgewählten Nachbarn Duplikate gibt.
//--- Look in candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Idx[slave - l] = cand;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i >= (slave - l))
            continue;
         if(cand == Idx[i])
            cand = -1;
         if(rand_cand == Idx[i])
            rand_cand = -1;
        }
      BarrierLoc;
     }
Hier schreiben wir die Indizes der Kandidaten stapelweise in ein lokales Datenarray, und anschließend vergleicht jedes Work-Item seine Indizes mit den Elementen des Arrays.
Bitte beachten Sie, dass wir nur die Indizes der vorhergehenden Work-Items auf Duplikate prüfen, damit von jedem Element genau eine Kopie erhalten bleibt. Folglich werden nur Elemente aus nachfolgenden Work-Items ausgeschlossen, während das zuerst auftretende Element erhalten bleibt.
Anschließend gehen wir auf dieselbe Weise vor, um den Pool der zufällig ausgewählten Kandidaten zu überprüfen.
//--- Look in random candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Idx[slave - l] = rand_cand;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i >= (slave - l))
            continue;
         if(cand == Idx[i])
            cand = -1;
         if(rand_cand == Idx[i])
            rand_cand = -1;
        }
      BarrierLoc;
     }
Sobald die Kandidaten die Eindeutigkeitsprüfung innerhalb der lokalen Gruppe bestanden haben, berechnen wir die linearen Offsets shift_cand und shift_rand_cand, um den Beginn der Einbettung jedes Kandidaten im Array data zu ermitteln.
   const int shift_cand = RCtoFlat(cand, 0, total_main, dimension, 0);
   const int shift_rand_cand = RCtoFlat(rand_cand, 0, total_main, dimension, 0);
Als Nächstes beginnt die Berechnung des euklidischen Abstands. Zunächst werden die lokalen Variablen, die die Abstände der Kandidaten in beiden Pools darstellen, auf null gesetzt.
//--- calc distance
   float dist_cand = 0;
   float dist_rand_cand = 0;
   for(int d = 0; d < dimension; d++)
     {
      float value = IsNaNOrInf(data[shift_main + d], 0);
      if(main != cand && cand >= 0)
         dist_cand += pow(value - IsNaNOrInf(data[shift_cand + d], 0), 2.0f);
      if(main != rand_cand && rand_cand >= 0)
         dist_rand_cand += pow(value - IsNaNOrInf(data[shift_rand_cand + d], 0), 2.0f);
     }
Anschließend werden in einer Schleife über die Einbettungsdimension die Werte der Zieleinbettung und der Kandidateneinbettungen abgerufen. Um den Abstand zu bestimmen, werden die Quadrate der Differenzen zwischen dem Zielelement und dem entsprechenden Kandidaten in lokalen Variablen summiert.
Es ist zu beachten, dass Berechnungen nur für nicht entfernte Elemente durchgeführt werden.
Nach der Berechnung der Abstände beginnen die Vorbereitungen für die Rangbildung. Zunächst setzen wir die lokalen Variablen cand_position und rand_position auf null, was dem ersten Element des Arrays entspricht. Wir prüfen jedoch, ob die Abstände der Elemente aus dem Pool der vorausgewählten Kandidaten und dem Pool der zufällig ausgewählten Kandidaten gleich sind. Sind die Abstände identisch, geben wir dem Pool der zuvor ausgewählten Kandidaten den Vorzug und erhöhen den Wert von rand_position.
//--- calc position
   int cand_position = 0;
   int rand_position = (int)(dist_cand >= dist_rand_cand);
Darauf folgt eine Reihe von Blöcken, in denen die aktuellen Abstände gemeinsam aus Abschnitten des lokalen Speichers Temp abgerufen werden und die Anzahl der Elemente in der lokalen Stichprobe gezählt wird, deren Abstand kleiner ist als der gerade betrachtete. Die erste Reihe kopiert die Abstände aus dem Pool der vorausgewählten Kandidaten (bzw. -1 für fehlende Kandidaten).
//--- by candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Temp[slave - l] = (cand >= 0 ? IsNaNOrInf(dist_cand, -1) : -1);
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (slave - l))
            continue;
         if(Temp[i] < 0)
            continue;
         if(cand >= 0)
           {
            if(Temp[i] < dist_cand)
               cand_position++;
            else
               if(Temp[i] < dist_cand && i < (slave - l))
                  cand_position++;
           }
         if(rand_cand >= 0)
           {
            if(Temp[i] < dist_rand_cand)
               rand_position++;
            else
               if(Temp[i] < dist_rand_cand && i < (slave - l))
                  rand_position++;
           }
        }
      BarrierLoc;
     }
Jedes Work-Item in der Gruppe durchläuft die Elemente von Temp und erhöht dabei cand_position und rand_position, je nachdem, welche Abstände kleiner sind. Hier kommt eine ausgefeilte Logik zur Gleichstandsauflösung zum Einsatz: Sind zwei Abstände gleich, wird die Reihenfolge durch den Index bestimmt, wodurch bei gleichen Abständen eine deterministische Rangbildung gewährleistet ist. Barrieren stellen sicher, dass Temp ordnungsgemäß gefüllt ist, bevor es ausgelesen und anschließend geleert wird.
Eine ähnliche zweite Reihe führt denselben Vorgang durch, verschiebt jedoch die Abstände der Elemente der Zufallsstichprobe in Temp und passt die Positionen unter Berücksichtigung der verbleibenden Elemente der lokalen Untergruppe erneut an.
//--- by random candidates
   for(int l = 0; l < total_slave; l += ls)
     {
      if(slave >= l && slave < (l + ls))
         Temp[slave - l] = (rand_cand >= 0 ? IsNaNOrInf(dist_rand_cand, -1) : -1);
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (slave - l))
            continue;
         if(Temp[i] < 0)
            continue;
         if(cand >= 0)
           {
            if(Temp[i] < dist_cand)
               cand_position++;
            else
               if(Temp[i] < dist_cand && i < (slave - l))
                  cand_position++;
           }
         if(rand_cand >= 0)
           {
            if(Temp[i] < dist_rand_cand)
               rand_position++;
            else
               if(Temp[i] < dist_rand_cand && i < (slave - l))
                  rand_position++;
           }
        }
      BarrierLoc;
     }
Es ist wichtig, diesen Teil zu verstehen: Der Algorithmus implementiert eine verteilte Positionszählung – jeder slave bestimmt selbstständig, an welcher Stelle er in der nach Abstand sortierten Liste der lokalen Gruppe erscheinen wird. Dadurch erhalten wir eine vollständig lokale Rangbildung ohne globale Sortierung, was sowohl Speicherplatz als auch Zeit spart.
Der letzte Schritt besteht darin, das Ergebnis zu schreiben. Wenn ein Kandidat vorhanden ist und seine Position kleiner ist als die Gesamtzahl der gesuchten Nachbarn, wird der Offset-Index berechnet und der Index des Kandidaten in die entsprechende Zelle des Arrays neighbors geschrieben.
//--- result
   if(cand >= 0 && cand_position < total_slave)
     {
      const int shift_dist_cand = RCtoFlat(main, cand_position, total_main, total_slave, 0);
      neighbors[shift_dist_cand] = cand;
     }
   if(rand_cand >= 0 && rand_position < total_slave)
     {
      const int shift_dist_cand = RCtoFlat(main, rand_position, total_main, total_slave, 0);
      neighbors[shift_dist_cand] = rand_cand;
     }
  }
Der vorgestellte Algorithmus führt eine parallele Auswertung deterministischer und zufälliger Kandidaten durch, beseitigt Duplikate lokal, berechnet Abstände und ordnet die Kandidaten nach ihrer Position in der lokalen Teilstichprobe, ohne eine globale Sortierung durchzuführen.
Wir haben heute viel Substanzielles geleistet, und der Artikel ist bereits recht ausführlich geworden. Jetzt ist der perfekte Zeitpunkt, um eine Pause einzulegen, unsere Gedanken zur Ruhe kommen zu lassen und das, was wir bisher erreicht haben, aus einer neuen Perspektive zu betrachten. Im nächsten Artikel werden wir mit neuem Elan auf dieses Thema zurückkommen und den eingeschlagenen Weg Schritt für Schritt fortsetzen.
Fazit
In diesem Artikel haben wir das Framework SAGDFN untersucht, das sich durch seine Skalierbarkeit, die effiziente Verarbeitung großer Graphen und die Minimierung des Rechenaufwands ohne Genauigkeitseinbußen von ähnlichen Lösungen abhebt. Durch seinen adaptiven Ansatz bei der Auswahl aussagekräftiger Verbindungen zwischen Knoten ist es möglich, wichtige Informationen zu erhalten und gleichzeitig eine Überlastung des Modells durch unnötige Daten zu vermeiden.
Im theoretischen Teil haben wir die wesentlichen Merkmale und internen Mechanismen des Frameworks eingehend untersucht. Wir haben erklärt, wie der Algorithmus funktioniert, und dann den ersten Schritt zur Umsetzung unternommen. Besonderes Augenmerk wurde auf das Modul Significant Neighbors Sampling gelegt, das bei der Arbeit mit großen Graphen eine wichtige Rolle bei der Optimierung von Berechnungen und der Senkung des Rechenaufwands spielt. Gleichzeitig haben wir eine Reihe von Verbesserungen vorgenommen, wodurch der Prozess der Nachbarauswahl flexibler und anpassungsfähiger geworden ist.
Diese Arbeit stellte einen wichtigen Schritt auf dem Weg zur Entwicklung eines vollwertigen Prognoseinstruments dar, das in der Lage ist, große Datenmengen effektiv zu verarbeiten und daraus nützliche räumlich-zeitliche Zusammenhänge abzuleiten. Im nächsten Artikel werden wir diesen Ansatz fortsetzen, indem wir der Architektur neue Komponenten hinzufügen und schrittweise auf umfassende Tests des gesamten Systems anhand realer historischer Daten hinarbeiten.
Links
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19323
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



