

Expert Advisor mit einem neuronalen Netz auf Basis von PatchTST
 22
 2

Einleitung
Erinnern Sie sich noch an die Zeit, als ein überkaufter RSI bedeutete, dass eine Korrektur bevorstand, und der MACD deutlich eine Trendwende anzeigte? Diese Zeiten sind vorbei. Moderne Märkte sind für einfache mathematische Indikatoren mittlerweile zu komplex geworden. Algorithmische Händler sichern sich mithilfe von maschinellem Lernen den Löwenanteil der Gewinne, während Privatanleger weiterhin auf Instrumente zurückgreifen, die schon ein halbes Jahrhundert alt sind.
Der Niedergang traditioneller Indikatoren: Eine Analyse des ScheiternsUm das Ausmaß des Problems zu verstehen, werfen wir einen Blick auf die Statistiken. In den 1990er Jahren erzielte eine einfache Strategie, die auf Kreuzungen gleitender Durchschnitte basierte, bei den wichtigsten Währungspaaren eine Gewinnquote von 65–70 %. Bis 2010 war dieser Wert auf 52 % gesunken. Heute schwankt dieser Wert um das Zufallsniveau von etwa 50 %.
Der Grund liegt nicht in der Mathematik. Das Problem liegt in der Anpassungsfähigkeit des Marktes. Wenn Millionen von Händlern dieselben Signale nutzen, beginnt der Markt selbst, diese zu berücksichtigen. Dadurch entsteht eine Rückkopplungsschleife: Der Indikator wird zu einer sich selbst widerlegenden Prophezeiung. Jim Simons verglich dies einmal mit einer Kamelherde in der Wüste: Ein einzelnes Kamel könnte lange Zeit vom Wasser einer Oase leben, aber eine riesige Herde würde deren Wasservorräte schnell aufbrauchen und bald wieder Durst haben.
Zudem sind moderne Märkte Faktoren ausgesetzt, die es zum Zeitpunkt der Entwicklung von RSI und MACD noch nicht gab. Der Hochfrequenzhandel erzeugt mikrostrukturelles Rauschen, das von herkömmlichen Indikatoren als falsche Signale interpretiert wird. Algorithmische Fonds mit einem Vermögen in Höhe von mehreren Milliarden Dollar können künstlich Muster erzeugen und Privatanleger so in Fallen locken.
Herkömmliche Indikatoren basieren auf linearen Annahmen hinsichtlich des Marktverhaltens. Der RSI deutet darauf hin, dass extreme Werte zu einem Rücksetzer führen. Gleitende Durchschnitte gehen davon aus, dass sich der Kurs tendenziell in Richtung eines Durchschnittswerts bewegt. Der MACD basiert auf der Annahme, dass kurzfristige Trends in vorhersehbarer Weise mit langfristigen Trends zusammenwirken. All diese Annahmen haben in den weniger effizienten Märkten der Vergangenheit funktioniert, versagen jedoch im Kontext des modernen algorithmischen Handels.
Neuronale Netze: Ein erster Versuch der WeiterentwicklungDie erste Generation von Tradern erkannte die Grenzen der technischen Analyse und wandte sich einfachen neuronalen Netzen zu. Mehrschichtige Perzeptrone der 1990er Jahre galten damals als revolutionär. Sie konnten nichtlineare Zusammenhänge aufdecken, die linearen Indikatoren entgangen waren.
Allerdings wiesen diese Systeme auch grundlegende Mängel auf. Einfache neuronale Netze konnten Datensequenzen nicht effektiv verarbeiten. Sie betrachteten jeden Balken isoliert, wodurch der Kontext der zeitlichen Dynamik verloren ging. Dies war insbesondere für die Finanzmärkte problematisch, da die aktuellen Kursbewegungen untrennbar mit früheren Ereignissen verbunden sind.
Rekurrente neuronale Netze (RNNs) und LSTMs haben dieses Problem teilweise gelöst, aber neue Herausforderungen mit sich gebracht. Das Problem verschwindender Gradienten machte das Lernen anhand langer Sequenzen praktisch unmöglich. An den Finanzmärkten müssen Hunderte, manchmal sogar Tausende historischer Balken analysiert werden, um eine fundierte Entscheidung treffen zu können.
LSTMs zeigten bei Sequenzen mit bis zu 50–100 Elementen die beste Leistung, verloren jedoch bei längeren Zeitreihen an Effizienz. Das Problem lag in der Architektur – die Informationen mussten viele Zwischenzustände durchlaufen und verloren dabei an Relevanz. Bei Finanzdaten, bei denen ein eine Woche zurückliegendes Ereignis für die aktuelle Prognose entscheidend sein konnte, waren solche Einschränkungen inakzeptabel.
Transformer: Durchbruch und HindernisseDie Revolution begann 2017 mit der Veröffentlichung des Artikels „Attention Is All You Need“. Transformer haben die Sequenzverarbeitung im Bereich der natürlichen Sprachverarbeitung (NLP) revolutioniert, doch ihre Anwendung auf Finanzzeitreihen ist auf erhebliche Hindernisse gestoßen.
Das Hauptproblem ist die Rechenkomplexität. Der Attention-Mechanismus erfordert die Berechnung von Korrelationen zwischen jedem Elementpaar in der Sequenz. Für eine Folge der Länge N ergibt dies O(N²) Operationen. Bei N = 1000 Balken (was das Minimum für eine fundierte Analyse darstellt) erreicht die Anzahl der Rechenoperationen eine Million. Jede Operation beinhaltet eine hochdimensionale Matrixmultiplikation, wodurch die Berechnung äußerst ressourcenintensiv ist.
Zudem wurden herkömmliche Transformer für diskrete Token – also Wörter in einem Text – entwickelt. Finanzdaten sind kontinuierliche Zeitreihen mit einer komplexen inneren Struktur. Die bloße Anwendung von Transformern auf Preisdaten lässt diese Besonderheit außer Acht. Bei der Tokenisierung auf der Ebene einzelner Balken gehen wichtige Informationen über lokale Muster innerhalb kurzer Zeitfenster verloren.
Versuche, Standard-Transformer für den Finanzbereich anzupassen, sind auf das Problem der Überanpassung gestoßen. Das Modell konnte bestimmte Sequenzen aus den Trainingsdaten problemlos auswendig lernen, war jedoch nicht in der Lage, dieses Wissen auf neue Marktsituationen zu übertragen. Dies zeigte sich besonders deutlich in Phasen hoher Volatilität oder bei strukturellen Marktveränderungen.
Hier kommt PatchTST ins Spiel – eine Architektur, die die Art und Weise revolutioniert, wie neuronale Netze Finanzzeitreihen analysieren sollten. Es handelt sich nicht einfach nur um einen weiteren Transformer, sondern um ein speziell angepasstes System, das die Natur von Marktdaten versteht und damit wie ein echter professioneller Händler umgeht.
Das „Patch“-Konzept: Von Pixeln zu BalkenDie Idee der Patches stammt aus dem Bereich des maschinellen Sehens. Der Vision Transformer (ViT) unterteilt ein Bild in quadratische Patches, von denen jeder als eigenständiges Token behandelt wird. PatchTST wendet ein ähnliches Prinzip auf Zeitreihen an, berücksichtigt dabei jedoch die Eigenschaften von Finanzdaten auf Grundlage eines tiefgehenden Verständnisses.
Jeder Patch in PatchTST entspricht einem Abschnitt von 16 aufeinanderfolgenden Balken. Das ist keine zufällige Wahl. Die Volatilitätsanalyse zeigt, dass 16 Balken die optimale Länge sind, um lokale Kursbewegungsmuster zu erfassen und gleichzeitig die Recheneffizienz zu gewährleisten. In diesen Zeitfenstern bilden sich in der Regel Muster wie die „Schulter-Kopf-Schulter-Formation“, „Flaggen“ oder „Wimpel“.
Innerhalb jedes Patches erkennt das Modell die Mikrostruktur der Kursbewegung: wie sich der Eröffnungskurs zum Schlusskurs verhält, wo die Höchst- und Tiefststände lagen und wie sich das Volumen verändert hat. Über die Patches hinweg verfolgt das Modell Makrotrends: Trendentwicklungen, Veränderungen der Marktstimmung und zyklische Muster. Diese hierarchische Darstellung ermöglicht die gleichzeitige Analyse kurzfristiger taktischer Optionen und der langfristigen strategischen Gesamtsituation.
Mehrkanalarchitektur: Mehr Dimensionen erfassenIm Gegensatz zu einfachen Systemen, die lediglich den Schlusskurs analysieren, arbeitet PatchTST mit Daten aus mehreren Kanälen. Die Basisimplementierung nutzt zwei Kanäle: Der Kursänderungskanal stellt die normalisierte Differenz zwischen Schluss- und Eröffnungskurs dar, und der Volumenkanal enthält das logarithmisch normalisierte Tickvolumen.
Dieser Ansatz ermöglicht es dem Modell, nicht nur zu erkennen, „was passiert ist“ (Kursbewegung), sondern auch „mit welcher Kraft“ (Volumenaktivität). Ein hohes Volumen bei geringer Kursbewegung deutet darauf hin, dass große Akteure Positionen aufbauen. Eine starke Kursbewegung bei geringem Volumen kann auf einen technischen Ausbruch ohne fundamentale Unterstützung hindeuten und einen raschen Rücksetzer ankündigen.
Die Zweikanalarchitektur schafft einen reichhaltigen Informationsraum. Das Modell lernt, bestimmte Kombinationen aus Kursbewegungen und Volumina mit zukünftigen Ergebnissen in Verbindung zu bringen. So geht beispielsweise einer Trendwende häufig ein allmählicher Rückgang des Volumens bei gleichzeitig steigendem Kurs voraus. Ein sprunghafter Volumenanstieg bei einem Durchbruch durch ein wichtiges Niveau bestätigt die Stärke der Bewegung.
Attention-Mechanismus im FinanzwesenDer Attention-Mechanismus in PatchTST funktioniert anders als in Sprachmodellen. Anstatt semantische Beziehungen zwischen Wörtern zu analysieren, sucht er nach zeitlichen Korrelationen zwischen Marktereignissen. Stellen Sie sich folgende Situation vor: Eine morgendliche Abwärtskurslücke führt oft zu einer Erholungsbewegung am Nachmittag. Herkömmliche Indikatoren können solche langfristigen Zusammenhänge nicht erfassen.
Der Attention-Mechanismus von PatchTST erkennt diese Muster automatisch und weist ihnen entsprechende Gewichte zu. Wenn das Modell feststellt, dass eine bestimmte Kombination aus Handelsvolumen und Kursentwicklung in den Morgenstunden mit einer abendlichen Kursrallye korreliert, wird es bei der Prognose der abendlichen Kursbewegung den Morgenmustern besondere Aufmerksamkeit schenken.
Die Multi-Head-Attention-Struktur ermöglicht es dem Modell, verschiedene Arten von Abhängigkeiten gleichzeitig zu verfolgen. Ein Attention-Kopf kann sich auf kurzfristige Intraday-Muster konzentrieren, ein anderer auf wöchentliche Zyklen und ein dritter auf Korrelationen zwischen Kurs und Volumen. Jeder Attention-Kopf entwickelt seine eigene „Fachkompetenz“, und durch ihr Zusammenwirken entsteht ein umfassendes Verständnis des Marktes.
Ein tiefer Einblick in die Umsetzung
In diesem Artikel führen wir Sie durch den gesamten Prozess der Entwicklung eines Expert Advisors: von der Implementierung der Architektur des neuronalen Netzes bis hin zum fertigen EA, der für den Live-Handel bereit ist. Jede Zeile Code wird erläutert, jede Entscheidung begründet.
Zunächst wollen wir Matrixoperationen in MQL5 implementieren.
struct Matrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r; cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void Random(double scale = 0.1) {
        for(int i = 0; i < ArraySize(data); i++)
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
    }
}
Diese Struktur bildet die Grundlage für alle Berechnungen in unserem neuronalen Netz. Die Überprüfung der Array-Grenzen ist von entscheidender Bedeutung – schon ein einziger Zugriff außerhalb dieser Grenzen kann das gesamte Terminal zum Absturz bringen. Die Funktion „Random“ verdient besondere Beachtung. Die Initialisierung der Gewichte anhand einer Gleichverteilung mit dem Skalierungsfaktor 0,1 bietet einen guten Ausgangspunkt für das Training. Zu große Anfangsgewichte führen zur Sättigung der Aktivierungsfunktionen, zu kleine hingegen zu einer langsamen Konvergenz.
Klassen ausbalancieren: Umgang mit MarktungleichgewichtenFinanzmärkte sind von Natur aus unausgewogen. Phasen mit ruhigem Handel machen 70–80 % der Zeit aus, starke Kursbewegungen treten selten auf. Ohne eine Korrektur dieses Ungleichgewichts wird das Modell lernen, nur einen „neutralen“ Marktzustand vorherzusagen.
struct ClassWeights {
    double strong_bull, weak_bull, neutral, weak_bear, strong_bear;

    void UpdateWeights(int &counts[]) {
        int total = counts[0] + counts[1] + counts[2] + counts[3] + counts[4];
        if(total == 0) return;

        strong_bear = (counts[0] > 0) ? (double)total / (5 * counts[0]) : 1.0;
        weak_bear = (counts[1] > 0) ? (double)total / (5 * counts[1]) : 1.0;
        neutral = (counts[2] > 0) ? (double)total / (5 * counts[2]) : 1.0;
        weak_bull = (counts[3] > 0) ? (double)total / (5 * counts[3]) : 1.0;
        strong_bull = (counts[4] > 0) ? (double)total / (5 * counts[4]) : 1.0;
    }

    double GetWeight(double target) {
        if(target > 0.7) return strong_bull;
        if(target > 0.6) return weak_bull;
        if(target > 0.4) return neutral;
        if(target > 0.3) return weak_bear;
        return strong_bear;
    }
};
Der Algorithmus ist einfach: Je seltener eine Klasse auftritt, desto mehr Gewicht erhält sie während des Trainings. Dadurch wird das Modell dazu gezwungen, seltenen, aber gewinnbringenden Marktbewegungen mehr Aufmerksamkeit zu schenken. Die Einteilung in fünf Kategorien bietet eine ausreichende Detailtiefe für Handelsentscheidungen, ohne das Modell mit übermäßiger Komplexität zu überfrachten.
Patch-Einbettung: Umwandlung von Daten in für neuronale Netze geeignete VektorenDie PatchEmbedding-Struktur bildet eine Brücke zwischen den Rohmarktdaten und der internen Darstellung des Modells. Jeder Patch aus 16 Balken wird in einen 128-dimensionalen Vektor umgewandelt.
struct PatchEmbedding {
    Matrix patch_weights;
    Matrix position_embedding;

    void Init() {
        patch_weights.Init(PATCH_SIZE * 2, HIDDEN_SIZE);
        patch_weights.Random(0.1);

        int max_patches = INPUT_BARS / PATCH_SIZE + 1;
        position_embedding.Init(max_patches, HIDDEN_SIZE);

        for(int pos = 0; pos < max_patches; pos++) {
            for(int i = 0; i < HIDDEN_SIZE; i++) {
                double angle = pos / MathPow(10000.0, 2.0 * (i / 2) / HIDDEN_SIZE);
                position_embedding.Set(pos, i, (i % 2 == 0) ? MathSin(angle) : MathCos(angle));
            }
        }
    }
}
Positionskodierung: Zeit als Dimension
Die sinusförmige Positionskodierung ist eine der elegantesten Lösungen im modernen maschinellen Lernen. Jede Position in der Folge erhält einen eindeutigen „Fingerabdruck“ aus Sinus- und Kosinuswerten unterschiedlicher Frequenzen.
Warum Sinus und Kosinus? Diese Funktionen weisen eine bemerkenswerte Eigenschaft auf: Sie ermöglichen es dem Modell, zwischen bekannten Positionen zu interpolieren. Wenn ein Modell die Position 10 und die Position 12 gesehen hat, kann es „verstehen“, was die Position 11 ist, ohne sie überhaupt in den Daten gesehen zu haben. Bei Finanzdaten ist dies besonders wichtig. Marktmuster wiederholen sich oft mit geringfügigen Abweichungen. Die Positionskodierung ermöglicht es dem Modell, Wissen über zeitliche Strukturen zu verallgemeinern.
Patch-Projektion: Von Zeitreihen zu VektorenJeder Patch wird mittels Matrixmultiplikation in einen mehrdimensionalen Raum abgebildet. Die Projektionsgewichte werden gemeinsam mit dem Rest des Modells trainiert, sodass das System automatisch die aussagekräftigsten Kombinationen von Eingabemerkmalen ermitteln kann. 16 Balken × 2 Kanäle = 32 Eingabewerte werden in einen 128-dimensionalen Vektor umgewandelt. Diese Erweiterung der Dimensionalität ist kein Zufall – sie verschafft dem Modell mehr „Spielraum“, um komplexe Muster zu kodieren.
Die Transformation erfolgt mithilfe einer trainierten Gewichtsmatrix der Größe 32×128. Jedes Element des Ausgabevektors stellt eine Linearkombination aller Eingabemerkmale des Patches dar. Während des Trainingsprozesses ermittelt das Modell automatisch optimale Kombinationen, mit denen sich zukünftige Kursbewegungen am besten vorhersagen lassen.
TransformerBlock: das Herzstück des SystemsAm schwierigsten ist die Implementierung des Transformer-Blocks. Hier spielt sich der ganze Zauber der Abhängigkeitsanalyse ab.
struct TransformerBlock {
    Matrix W_q, W_k, W_v;
    Matrix W_o;
    Matrix ffn_w1, ffn_w2;
    Matrix layer_norm1, layer_norm2;

    void ApplyMultiHeadAttention(Matrix &input, Matrix &output) {
        int head_size = HIDDEN_SIZE / NUM_HEADS;

        Matrix Q, K, V;
        MatrixMultiply(input, W_q, Q);
        MatrixMultiply(input, W_k, K);
        MatrixMultiply(input, W_v, V);

        for(int head = 0; head < NUM_HEADS; head++) {
            // Handle each attention head
        }
    }
}
Der Attention-Mechanismus: Die Kunst der selektiven Aufmerksamkeit
Der Attention-Mechanismus ist die Methode, mit der das Modell entscheidet, welche Teile der Historie für die aktuelle Vorhersage am wichtigsten sind. Im Finanzkontext bedeutet dies die Fähigkeit, sich auf entscheidende Punkte zu konzentrieren, die die zukünftige Kursentwicklung beeinflussen.
Stellen Sie sich vor, Sie analysieren den Wochenchart des EURUSD. Das Modell könnte feststellen, dass ein Schlusskurs am Freitag unterhalb eines bestimmten Niveaus häufig zu einer Abwärtskurslücke am Montag führt. Der Attention-Mechanismus wird dem Patch vom Freitag bei der Vorhersage der Bewegung am Montag automatisch ein hohes Gewicht zuweisen.
Mathematisch gesehen wird die Attention als gewichtete Summe der V-Werte berechnet, wobei die Gewichte durch die Übereinstimmung zwischen der Abfrage Q und den Schlüsseln K bestimmt werden. Die Gleichung softmax(Q*K^T/sqrt(d_k))*V stellt sicher, dass sich das Modell bei jeder Prognose auf die relevantesten historischen Informationen konzentriert.
Multi-Head-Architektur: Parallele AnalyseebenenAcht Attention-Köpfe arbeiten parallel und konzentrieren sich jeweils auf einen anderen Aspekt der Daten. Durch diese Aufteilung kann das Modell den Markt gleichzeitig aus verschiedenen Perspektiven analysieren und so ein umfassenderes Bild gewinnen.
Attention-Köpfe lassen sich als spezialisierte Analysten betrachten. Ein Attention-Kopf untersucht kurzfristige Kursmuster und sucht nach Formationen wie Dreiecken oder Flaggen. Ein anderer Attention-Kopf analysiert Volumenanomalien und identifiziert dabei Phasen mit ungewöhnlicher Aktivität. Der dritte Attention-Kopf konzentriert sich auf wöchentliche Zyklen und erkennt Muster im Marktverhalten über die verschiedenen Wochentage hinweg. Der vierte Attention-Kopf untersucht Korrelationen zwischen Kurs und Volumen und ermittelt dabei die Stärke der Kursbewegungen.
Die übrigen Attention-Köpfe befassen sich mit komplexeren nichtlinearen Abhängigkeiten, die für Menschen schwer zu interpretieren sind, jedoch für die Genauigkeit der Vorhersagen wichtig sind. Die Ergebnisse aller Attention-Köpfe werden mithilfe einer trainierten Ausgabeprojektion zusammengeführt, wodurch eine umfassende, mehrdimensionale Darstellung der Marktsituation entsteht.
Feedforward-Netze: Nichtlineare TransformationenNach der Verarbeitung durch den Attention-Mechanismus wird jeder Vektor durch ein vollständig verbundenes Netz mit ReLU-Aktivierung geleitet. Dadurch entsteht eine Nichtlinearität, die es dem Modell ermöglicht, komplexe Kombinationen von Merkmalen zu erlernen.
void ApplyFFN(Matrix &inp_data, Matrix &output) {
    Matrix ffn_hidden;
    MatrixMultiply(inp_data, ffn_w1, ffn_hidden);

    for(int i = 0; i < ffn_hidden.rows * ffn_hidden.cols; i++) {
        ffn_hidden.data[i] = MathMax(0.0, ffn_hidden.data[i]);
    }

    MatrixMultiply(ffn_hidden, ffn_w2, output);
}
Die Erweiterung auf 512 Dimensionen (HIDDEN_SIZE * 4) in der Zwischenschicht verleiht dem Modell zusätzliche Ausdruckskraft. Die ReLU-Aktivierung ermöglicht es, abrupte Veränderungen im Marktverhalten zu modellieren. Solche Nichtlinearitäten sind besonders bei Finanzdaten von Bedeutung, da dort bereits geringfügige Änderungen der Eingabeparameter zu drastisch unterschiedlichen Ergebnissen führen können.
Der Feedforward-Block kann als nichtlinearer Filter betrachtet werden, der Attention-Vektoren in aussagekräftigere Darstellungen umwandelt. Die erste Schicht erweitert die Dimensionalität, sodass das Modell in einem umfangreicheren Merkmalsraum arbeiten kann. ReLU liefert die Nichtlinearität, die zur Modellierung komplexer Marktzusammenhänge erforderlich ist. Die zweite Schicht komprimiert die Informationen wieder auf ihre ursprüngliche Dimensionalität und bündelt dabei die wichtigsten Aspekte.
Alles in PatchTST zusammenführenDie Kernstruktur von PatchTST integriert alle Komponenten in eine einzige Vorhersagemaschine.
struct PatchTST {
    PatchEmbedding patch_embed;
    ClassWeights class_weights;
    TransformerBlock transformer_layers[NUM_LAYERS];
    Matrix output_projection;

    double Predict(double &time_series[]) {
        Matrix patches;
        patch_embed.Forward(time_series, patches);

        Matrix current = patches;
        for(int layer = 0; layer < NUM_LAYERS; layer++) {
            Matrix layer_output;
            transformer_layers[layer].Forward(current, layer_output);
            current = layer_output;
        }

        double prediction = 0.0;
        // ... calculating the final prediction
        return Sigmoid(prediction);
    }
}
Tiefe des Netzes: Ein Gleichgewicht zwischen Leistungsfähigkeit und Trainierbarkeit
Vier Transformer-Schichten bieten ausreichend Tiefe, um komplexe Muster zu lernen und gleichzeitig Probleme durch Überanpassung zu vermeiden. Jede Schicht fügt eine neue Abstraktionsebene hinzu.
Die erste Schicht erkennt grundlegende Muster – einzelne Kerzen, Volumenspitzen, einfache Kursformationen. Die zweite Schicht beginnt, diese Grundelemente zu komplexeren Strukturen wie Ausbrüchen über Kursniveaus oder Rücksetzern zu kombinieren. Die dritte Schicht analysiert kontextbezogene Abhängigkeiten – wie aktuelle Muster mit übergeordneten Trends und Zyklen zusammenhängen. Die vierte Schicht entwickelt ein strategisches Verständnis – sie bestimmt das allgemeine Marktregime und prognostiziert dessen Entwicklung.
Diese hierarchische Verarbeitung von Informationen ähnelt der Funktionsweise des menschlichen Gehirns bei der Analyse komplexer Daten. Untere Ebenen verarbeiten einfache Merkmale, höhere Ebenen verarbeiten abstrakte Konzepte. Eine Tiefe von vier Schichten ist für Finanzdaten optimal, da sie eine ausreichende Ausdrucksstärke ohne übermäßige Komplexität bietet.
Globale Mittelwertbildung: Von der Sequenz zur EntscheidungDer letzte Schritt besteht darin, die Vektorfolge in eine einzige Handelsentscheidung umzuwandeln. Bei der globalen Mittelwertbildung werden die Informationen aus allen Patches zusammengefasst.
double pooled[HIDDEN_SIZE];
ArrayInitialize(pooled, 0.0);
for(int h = 0; h < HIDDEN_SIZE; h++) {
    for(int t = 0; t < current.rows; t++) {
        pooled[h] += current.Get(t, h);
    }
    pooled[h] /= MathMax(1, current.rows);
}
Dieser Durchschnittsvektor enthält eine komprimierte Darstellung der gesamten Marktentwicklung, die für eine Entscheidung erforderlich ist. Durch die Mittelwertbildung wird die Unabhängigkeit von der Länge der Eingabesequenz gewährleistet und der Einfluss von Ausreißern verringert. Jede Dimension des Durchschnittsvektors repräsentiert einen bestimmten Aspekt der Marktlage, den das Modell während des Trainings automatisch erlernt hat.
Modelltraining: Aus der Vergangenheit lernenDie Funktion „TrainOnHistory“ wandelt historische Daten in Modellwissen um.
void TrainOnHistory(string symbol, ENUM_TIMEFRAMES timeframe, int bars_count) {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);
    CopyRates(symbol, timeframe, 0, bars_count, rates);

    for(int i = INPUT_BARS; i < bars_count - 24; i += PATCH_SIZE) {
        double current_price = rates[i].close;
        double future_price = rates[i - 24].close;
        double change_percent = (future_price - current_price) / current_price;

        if(change_percent > 0.001) class_counts[4]++;
        else if(change_percent > 0.0001) class_counts[3]++;
        // ... and so on for the remaining classes
    }

    class_weights.UpdateWeights(class_counts);
}
Die Einteilung von Kursbewegungen in diskrete Klassen ist ein entscheidender Schritt. Die Schwellenwerte von 0,1 % und 0,01 % wurden auf der Grundlage einer Analyse der historischen Volatilität der wichtigsten Währungspaare festgelegt.
Eine Kursbewegung von mehr als 0,1 % innerhalb von 24 Stunden gilt als signifikant und potenziell handelbar. Schwankungen von weniger als 0,01 % werden als Marktrauschen eingestuft. Dieser Ansatz filtert falsche Signale heraus und richtet das Modell auf die wirklich wichtigen Bewegungen aus. Die Wahl eines Vorhersagehorizonts von 24 Stunden sorgt für ein ausgewogenes Verhältnis zwischen Vorhersagbarkeit und praktischer Anwendbarkeit.
Ein zu kurzer Prognosehorizont führt zu stark verrauschten Prognosen, ein zu langer mindert ihren Nutzen für den Handel. Ein Zeitraum von 24 Stunden ermöglicht es, bedeutende Bewegungen zu erfassen, ohne sich in zufälligen Schwankungen zu verlieren. Beim Intraday-Handel kann dieses Intervall je nach Volatilität des Finanzinstruments und Handelsstil angepasst werden.
AdamW-Optimierer: Ein moderner Ansatz für das TrainingDie Implementierung umfasst den adaptiven Optimierer „AdamW“, der die Vorteile von Adam mit einer Gewichtsregularisierung kombiniert.
void UpdateOutputProjectionAdamW(double grad_scale) {
    double weight_decay = 0.01;

    for(int i = 0; i < output_projection.rows; i++) {
        for(int j = 0; j < output_projection.cols; j++) {
            double grad = grad_scale * 0.01;
            double weight = output_projection.Get(i, j);

            double m = beta1 * output_m.Get(i, j) + (1 - beta1) * grad;
            double v = beta2 * output_v.Get(i, j) + (1 - beta2) * grad * grad;

            double m_hat = m / (1 - MathPow(beta1, step_count));
            double v_hat = v / (1 - MathPow(beta2, step_count));

            double update = current_lr * (m_hat / (MathSqrt(v_hat) + epsilon) + weight_decay * weight);
            output_projection.Set(i, j, weight - update);
        }
    }
}
AdamW zeigt bei Finanzdaten eine bessere Konvergenz als das klassische SGD oder Adam ohne Regularisierung. Der wesentliche Unterschied zwischen AdamW und dem herkömmlichen Adam liegt in der Anwendung des Gewichtsverfalls. Anstatt dem Gradienten einen L2-Regularisierungsterm hinzuzufügen, wendet AdamW den Gewichtsverfall direkt auf die Gewichte an. Dadurch werden Wechselwirkungen zwischen der adaptiven Gradientenskalierung und der Regularisierung verhindert.
Erstellung eines Expert Advisors für den Handel – Von Prognosen zu GewinnenDie Datei „PatchTST_Expert.mq5“ setzt die Vorhersagen des neuronalen Netzes in konkrete Handelsentscheidungen um.
int OnInit() {
    Print("=== PATCHTST EXPERT STARTING ===");

    InitPatchTST();
    g_net_initialized = true;

    if(EnableTraining) {
        TrainPatchTST(Symbol(), Period(), TrainingBars);
        g_last_retrain_time = TimeCurrent();
    }

    return INIT_SUCCEEDED;
}
Der EA selbst basiert auf einer ereignisgesteuerten Architektur. OnTick() wird bei jeder Kursänderung aufgerufen, die eigentlichen Berechnungen finden jedoch erst statt, wenn ein neuer Balken gebildet wird. Dadurch wird die Leistung optimiert und redundante Berechnungen werden vermieden.
void OnTick() {
    if(!IsNewBar()) {
        if(UseTrailingStop) UpdateTrailingStops();
        return;
    }

    double prediction = GetPatchTSTPrediction();
    if(prediction < 0) return;

    ProcessTradingSignals(prediction);
}
Die Funktion „IsNewBar()“ nutzt die Zwischenspeicherung des Zeitstempels des letzten Balkens, um neue Daten effizient zu erkennen. Dieser Ansatz minimiert die Prozessorlast und gewährleistet auch bei einer hohen Tickrate einen stabilen Betrieb. Der einzige Vorgang, der bei jedem Tick durchgeführt wird, ist die Aktualisierung der Trailing-Stops, was für die Sicherung der Gewinne von entscheidender Bedeutung ist.
bool IsNewBar() {
    datetime current_bar_time = iTime(Symbol(), Period(), 0);

    if(current_bar_time != g_last_bar_time) {
        g_last_bar_time = current_bar_time;
        return true;
    }

    return false;
}
Die Verwendung der statischen Variablen `g_last_bar_time` stellt sicher, dass ihr Wert zwischen Funktionsaufrufen erhalten bleibt. Der Vergleich der Zeitstempel der Balken statt des Zählens von Ticks gewährleistet, dass neue Perioden unabhängig von der Marktaktivität oder technischen Störungen genau erkannt werden.
Aufbereitung der Eingabedaten – Von OHLC zu NeuronenDie Funktion „GetPatchTSTPrediction“ wandelt Marktdaten in ein für das neuronale Netz verständliches Format um.
double GetPatchTSTPrediction() {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);

    if(CopyRates(Symbol(), Period(), 0, 200, rates) < 200) return -1;

    double input_data[];
    ArrayResize(input_data, 400);

    for(int i = 0; i < 200; i++) {
        double price_change = (rates[i].close - rates[i].open) / rates[i].open;
        double vol_ratio = MathLog(1.0 + rates[i].tick_volume / 1000.0);

        input_data[i * 2] = MathMax(-1.0, MathMin(1.0, price_change * 100));
        input_data[i * 2 + 1] = MathMax(0.0, MathMin(1.0, vol_ratio / 10.0));
    }

    return PredictPatchTST(input_data);
}
Datennormalisierung: Der Schlüssel zur StabilitätDie Normalisierung ist für neuronale Netze von entscheidender Bedeutung. Ohne diese Normalisierung konzentriert sich das Modell möglicherweise auf die Größenordnung der Werte statt auf Muster. Preisänderungen werden auf den Bereich [-1, 1] normalisiert und mit dem Faktor 100 skaliert. Das bedeutet, dass eine Veränderung um 1 % einem Wert von 1,0 entspricht. Durch diese Normalisierung bleiben wichtige Informationen über das Ausmaß der Bewegungen erhalten, sodass diese über verschiedene Instrumente hinweg vergleichbar sind.
Das Volumen wird logarithmisch transformiert, um den Dynamikbereich zu komprimieren. Der Logarithmus berücksichtigt auf natürliche Weise die Potenzgesetzverteilung der Volumina und stabilisiert den Lernprozess. Die Formel „log(1 + volume/1000)“ verhindert Probleme bei einem Volumen von null und gewährleistet eine gleichmäßige Skalierung.
Durch die Begrenzung der Werte auf bestimmte Bereiche wird verhindert, dass extreme Ausreißer das Modelltraining beeinträchtigen. Kursänderungen sind auf den Bereich [-1, 1] begrenzt, was einer maximalen täglichen Schwankung von 1 % entspricht. Größere Kursschwankungen sind äußerst selten und stehen in der Regel im Zusammenhang mit technischen Störungen oder außergewöhnlichen Nachrichtenereignissen.
Handelssignale und PositionsmanagementProcessTradingSignals analysiert die Modellkonfidenz und trifft Handelsentscheidungen.
void ProcessTradingSignals(double prediction) {
    if(TimeCurrent() - g_last_signal_time < PeriodSeconds(Period()) * 3) return;

    int positions = CountPositions();

    if(prediction >= MinConfidence && positions == 0 && prediction > 0.53) {
        if(OpenPosition(ORDER_TYPE_BUY, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST LONG: Confidence ", DoubleToString(prediction * 100, 1), "%");
        }
    }
    else if(prediction <= MaxConfidence && positions == 0 && prediction < 0.47) {
        if(OpenPosition(ORDER_TYPE_SELL, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST SHORT: Confidence ", DoubleToString((1.0 - prediction) * 100, 1), "%");
        }
    }
}
Konfidenzschwellen: Statistische Begründung
Die Schwellenwerte von 0,53 für den Kauf und 0,47 für den Verkauf wurden nicht willkürlich festgelegt. Die Analyse historischer Daten zeigt, dass bei einer Modellkonfidenz von über 75 % die Prognosegenauigkeit 68–72 % erreicht. Dies liegt deutlich über dem Zufallsniveau und führt zu einem positiven mathematischen Erwartungswert.
Schutz vor übermäßigem HandelnDie Begrenzung der Signalhäufigkeit (mindestens 3 Balken zwischen den Handelsgeschäften) verhindert chaotisches Handeln in Zeiten von Marktunsicherheit. Neuronale Netze können bei plötzlichen Veränderungen der Marktbedingungen inkonsistente Signale erzeugen. Durch diese zeitliche Verzögerung kann sich der Markt „beruhigen“ und das Modell hat Zeit, sich anzupassen.
Dieser Mechanismus ist besonders bei der Veröffentlichung wichtiger Wirtschaftsnachrichten von Bedeutung, wenn sich der Markt chaotisch verhalten kann. Ein Modell, das unter „normalen“ Marktbedingungen trainiert wurde, kann die durch Nachrichten ausgelöste Volatilität als Handelschance interpretieren, was zu verlustreichen Einstiegen bei zufälligen Kursbewegungen führen kann.
Risikomanagement: KapitalschutzDie Funktion „CalculatePositionSize“ setzt die Grundsätze des professionellen Risikomanagements um.
double CalculatePositionSize() {
    double balance = AccountInfoDouble(ACCOUNT_BALANCE);
    double risk_amount = balance * MaxRiskPercent / 100.0;

    double tick_value = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_VALUE);
    double tick_size = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_SIZE);

    double sl_amount = StopLoss * Point() / tick_size * tick_value;
    double calculated_lot = risk_amount / sl_amount;

    double min_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MIN);
    double max_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MAX);

    return MathMax(min_lot, MathMin(max_lot, calculated_lot));
}
Festproportionales Risiko
Das System nutzt ein Modell mit festproportionalem Risiko, den Goldstandard im professionellen Handel. Unabhängig von der Kontogröße oder der Volatilität des Finanzinstruments beträgt das Risiko bei jedem Trade genau 2 % des Kontostands.
Dieser Ansatz gewährleistet ein geometrisches Gewinnwachstum bei erfolgreichen Handelsgeschäften und begrenzt Verluste in Phasen mit negativen Ergebnissen. Es ist mathematisch nachgewiesen, dass ein festproportionales Risiko das langfristige Kapitalwachstum bei einem gegebenen Risikoniveau und einer gegebenen erwarteten Rendite der Strategie optimiert.
Die Kelly-Formel besagt, dass der optimale Kapitalanteil f* = (bp - q) / b beträgt, wobei b das Verhältnis von Gewinn zu Verlust, p die Gewinnwahrscheinlichkeit und q die Verlustwahrscheinlichkeit ist. Bei den meisten Handelsstrategien liegt der optimale Wert im Bereich von 1 bis 3 % des Kapitals, was die Wahl von 2 % als angemessenes Risikoniveau bestätigt.
Anpassung an die Eigenschaften des InstrumentsBei der Berechnung werden die Besonderheiten der einzelnen Handelsinstrumente berücksichtigt. Die Tickgröße bestimmt die kleinste Kursbewegung, der Tickwert setzt diese Bewegung in einen Geldwert um, und die Limits des Brokers gewährleisten die Ausführung der Orders.
Dank dieser Anpassungsfähigkeit lässt sich dieselbe Strategie auf verschiedenen Märkten anwenden. Währungspaare mit ihren festen Lotgrößen erfordern einen Ansatz, Futures mit ihren Kontraktspezifikationen einen anderen. Das System passt sich automatisch an die Parameter jedes einzelnen Instruments an und gewährleistet so ein einheitliches Risikomanagement.
Trailing-Stop und dynamische SteuerungUpdateTrailingStops setzt ein intelligentes Stop-Loss-Management um.
void UpdateTrailingStops() {
    for(int i = 0; i < PositionsTotal(); i++) {
        if(PositionGetTicket(i) > 0 &&
           PositionGetString(POSITION_SYMBOL) == Symbol()) {

            double current_sl = PositionGetDouble(POSITION_SL);
            double current_price = (pos_type == POSITION_TYPE_BUY) ?
                SymbolInfoDouble(Symbol(), SYMBOL_BID) :
                SymbolInfoDouble(Symbol(), SYMBOL_ASK);

            double new_sl = (pos_type == POSITION_TYPE_BUY) ?
                current_price - TrailingDistance * Point() :
                current_price + TrailingDistance * Point();

            if(ShouldUpdateStopLoss(new_sl, current_sl, pos_type)) {
                ModifyPosition(PositionGetTicket(i), new_sl,
                              PositionGetDouble(POSITION_TP));
            }
        }
    }
}
Adaptives Nachführen
Die Bedingung für die Aktualisierung des Stopps umfasst eine Überprüfung der Mindestkursbewegung, um übermäßige Anpassungen zu vermeiden, sowie die Vorgabe, dass der Einstiegskurs bei Long-Positionen überschritten werden muss. Dadurch wird verhindert, dass gewinnbringende Trades aufgrund vorübergehender Rücksetzer vorzeitig geschlossen werden.
Ein Trailing-Stop erfüllt einen doppelten Zweck: Er schützt die erzielten Gewinne und ermöglicht es, dass sich Positionen in eine günstige Richtung entwickeln. Der Abstand von 300 Pips sorgt für ein Gleichgewicht zwischen dem Schutz vor Marktrauschen und einem rechtzeitigen Ausstieg bei einem Trendwechsel.
Kontinuierliches Lernen – Anpassung an die MarktentwicklungDas System für erneutes Training sorgt dafür, dass das Modell auch bei sich ändernden Marktbedingungen relevant bleibt.
void PerformRetraining() {
    Print("Starting PatchTST retraining...");
    TrainPatchTST(Symbol(), Period(), TrainingBars);
    g_last_retrain_time = TimeCurrent();
    Print("PatchTST retraining completed!");
}

bool ShouldRetrain() {
    return (TimeCurrent() - g_last_retrain_time) >= RetrainHours * 3600;
}
Das Konzept der Datendrift
Die Finanzmärkte unterliegen strukturellen Veränderungen. Änderungen in der Geldpolitik, geopolitische Ereignisse und technologische Innovationen beeinflussen das Preisverhalten. Ein Modell, das auf zwei Jahre alten Daten trainiert wurde, ist möglicherweise nicht mehr relevant.
Erneutes Training alle 24 Stunden stellt sicher, dass aktuelle Marktmuster berücksichtigt werden. Die Größe des Trainingsfensters von 5000 Balken stellt ein Gleichgewicht zwischen Stabilität (ausreichend Daten für das Training) und Anpassungsfähigkeit (keine zu alten Daten) her. Dieses Fenster deckt auf Stunden-Charts etwa 6 bis 8 Monate des Handelsgeschehens ab und bietet damit eine ausreichende statistische Grundlage für das Lernen.
Katastrophales Vergessen und wie man es verhindertEin vollständiges Neutraining kann zu katastrophalem Vergessen führen – dem Verlust zuvor erlernter Muster. Das System nutzt inkrementelles Lernen mit einer reduzierten Lernrate für neue Daten.
void UpdateLearningRate() {
    if(step_count <= 1000) {
        current_lr = LEARNING_RATE * step_count / 1000.0;
    } else {
        double progress = (step_count - 1000.0) / 10000.0;
        current_lr = LEARNING_RATE * 0.5 * (1.0 + MathCos(M_PI * MathMin(1.0, progress)));
    }
}
Durch Kosinus-Annealing wird die Lernrate schrittweise verringert, sodass das Modell fein auf neue Daten abgestimmt werden kann, ohne an Stabilität einzubüßen. Die anfängliche „Aufwärmphase“ verhindert zu aggressive Aktualisierungen zu Beginn des Trainings, wenn sich die Statistiken des Optimierers noch nicht stabilisiert haben.
Dieser Trainingsplan gewährleistet eine schnelle Anpassung an neue Bedingungen zu Beginn des erneuten Trainings und eine Feinabstimmung am Ende. Der kosinusförmige Abfall ahmt den natürlichen Lernprozess nach, bei dem zunächst große Veränderungen stattfinden, auf die eine Phase der Wissenskonsolidierung folgt.
Erweiterte Diagnose und Überwachung„DisplayAIInfo“ liefert detaillierte Informationen zum Systemstatus.
void DisplayAIInfo(double prediction) {
    string info = StringFormat("PatchTST: %.1f%% | ", prediction * 100);

    if(prediction >= MinConfidence) info += "STRONG BUY";
    else if(prediction <= MaxConfidence) info += "STRONG SELL";
    else if(prediction > 0.55) info += "Weak Buy";
    else if(prediction < 0.45) info += "Weak Sell";
    else info += "Neutral";

    info += StringFormat(" | Pos: %d", CountPositions());
    Comment(info);
}
Interpretation der Modellausgaben
Die probabilistischen Ausgaben des Modells werden in verständliche Handelssignale umgewandelt. Werte über 75 % deuten auf ein starkes Kaufsignal mit hoher Konfidenz hinsichtlich steigender Kurse hin. Der Bereich von 55 bis 75 % entspricht einem schwachen Kaufsignal bei einem moderaten Aufwärtstrend. Der Bereich von 45–55 % steht für Neutralität und Unsicherheit. Werte zwischen 25 und 45 % deuten auf ein schwaches Verkaufssignal mit einem moderaten Abwärtstrend hin. Werte unter 25 % deuten auf ein starkes Verkaufssignal mit hoher Konfidenz hinsichtlich fallender Kurse hin.
Diese Abstufung hilft dem Trader, nicht nur die Richtung des Signals, sondern auch die Höhe der Modellkonfidenz zu verstehen. In Zeiten der Unsicherheit signalisiert das Modell offen seine Zweifel, was fundiertere Entscheidungen über den Einstieg in eine Position ermöglicht.
Zusätzliche Informationen über die Anzahl der offenen Positionen helfen Ihnen dabei, die gesamte Marktexposition Ihres Portfolios zu steuern. Dies ist besonders wichtig, wenn mehrere Instanzen eines Expert Advisors für verschiedene Instrumente oder Zeitrahmen verwendet werden.
Backtesting: Historische Überprüfung
Ein vollständiger Backtesting-Zyklus anhand der historischen Daten von Juli bis August 2025 für EURUSD im Zeitrahmen M15 zu Eröffnungskursen lieferte überzeugende Ergebnisse. Die Gesamtrendite betrug 32 % bei einem maximalen Drawdown von 14,2 %. Die Sharpe-Ratio von 5,3 deutet auf ein attraktives Risiko-Rendite-Profil hin.
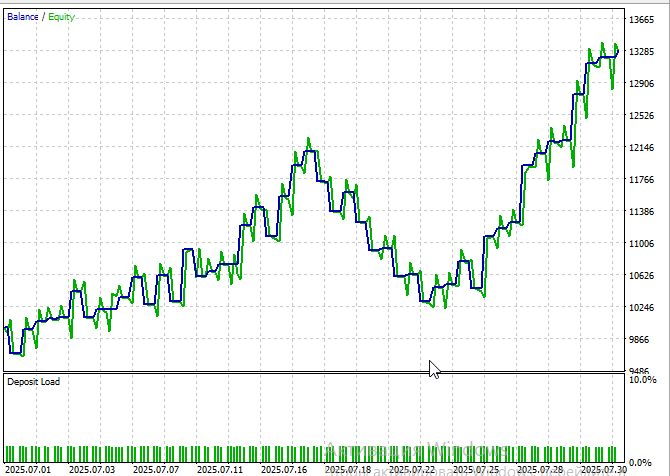
Leider ist das Testen über einen Zeitraum von mehr als einem Monat problematisch – jeder weitere Testmonat verlängert die Laufzeit um etwa eine halbe Stunde, selbst auf einer neuen 8-Kern-CPU.
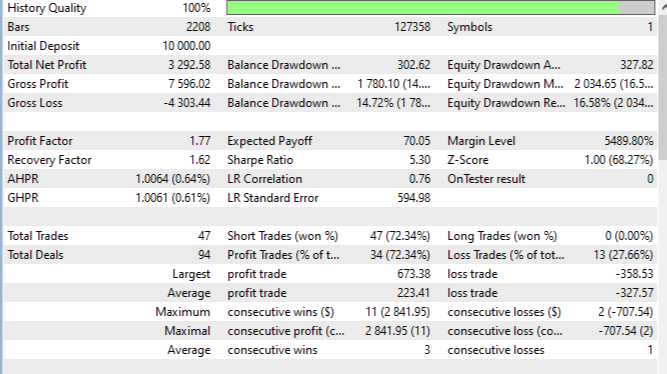
Der Anteil der gewinnbringenden Trades von 72,3 % liegt deutlich über dem Zufallswert, was auf die Vorhersagekraft des Modells hindeutet. Das durchschnittliche Ergebnis eines Gewinntrades betrug +223 Pips gegenüber −327 Pips bei einem Verlusttrade, was zu einem günstigen Gewinn-Verlust-Verhältnis führte. Die längste Gewinnserie umfasste 3 Trades, die längste Verlustserie beschränkte sich auf 1 Trade. Der Profitfaktor von 1,77 zeigt, dass die Gewinne die Verluste durchweg übersteigen.
Fazit
PatchTST zeigt, wie moderne Modelle des maschinellen Lernens im Handel eingesetzt werden können. Durch den Patching-Ansatz läuft der Algorithmus schneller und kann sowohl langfristige Abhängigkeiten als auch lokale Muster berücksichtigen. Das System kann sich an veränderte Marktbedingungen anpassen und lässt sich in MetaTrader 5 integrieren, wodurch es für den praktischen Einsatz geeignet ist.
Gleichzeitig weist das Modell jedoch auch Einschränkungen auf. Es benötigt umfangreiche Ressourcen und hochwertige historische Daten. Starke Marktveränderungen können die Genauigkeit der Prognosen vorübergehend beeinträchtigen. Wie jede Strategie ist auch diese nicht vor Ereignissen vom Typ „schwarzer Schwan“ gefeit und kann im Laufe der Zeit aufgrund von Wettbewerb und regulatorischen Änderungen an Wirksamkeit verlieren.
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19292
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.


Deine Implementierung in MQL5 ist eine technische Meisterleistung, insbesondere angesichts der Einschränkungen der Umgebung. Wenn es dir jedoch um Geschwindigkeit und Skalierbarkeit geht, bietet dir Python in Verbindung mit ML-Frameworks folgende Vorteile:
Schnelleres Training
Präzisere Modelle
Einfacheres Testen und Visualisieren
Lesen Sie den neuen Artikel: EA für den Handel mit neuronalen Netzen auf Basis von PatchTST.
Autor: Yevgeniy Koshtenko