

基于PatchTST的神经网络交易EA
 28
 2

引言
还记得曾经,RSI超买就预示回调将至、MACD能清晰指明趋势转折的时代吗?那样的时代已成为历史。现代市场的复杂度早已超出简单数学指标的承载范围。算法交易者借助机器学习获取了绝大部分利润,而普通散户仍在沿用半个世纪前的工具。
传统指标的消亡:失效剖析我们先看一组统计数据,从而理解问题的严重程度。在上世纪90年代,基于均线交叉的简单策略在主流货币对上胜率可达65%至70%。到2010年,该胜率下滑至52%。如今,它基本徘徊在随机概率附近,大约50%。
问题并不在于数学公式本身。根源在于市场具备自适应能力。当数百万交易者使用同一套信号时,市场本身就会把这些信号纳入定价。由此形成反馈循环:指标变成了自我证伪的预言。Jim Simons(吉姆・西蒙斯)曾将此现象比作沙漠里的骆驼群:单只骆驼可以依靠一处绿洲长久生存,但若庞大的骆驼群一同涌入,绿洲很快就会枯竭,众骆驼再度陷入干渴。
除此之外,现代市场还面临RSI和MACD诞生之初并不存在的各类影响因素。高频交易产生微观结构噪声,传统指标会因此发出错误信号。管理数十亿美元资金的算法基金可以人为制造形态,引诱散户落入陷阱。
传统指标对市场行为都建立在线性假设之上:RSI认为极值之后会出现回撤;均线假设价格有向均值回归的倾向;MACD则基于短期趋势与长期趋势会产生可预测交互的思路。这些假设在过去弱有效市场中尚能成立,但在如今算法交易盛行的环境下已经失效。
神经网络:第一次进化尝试第一批意识到技术分析局限性的交易者,开始尝试简单神经网络。90年代的多层感知机在当时堪称革新,能够捕捉线性指标无法发现的非线性关系。
然而,这类系统同样存在底层缺陷。简易神经网络无法有效处理序列数据,它孤立看待每一根K线,丢失了时序动态上下文。这对金融市场而言是致命短板,因为当下的价格走势和历史行情紧密关联。
循环神经网络(RNN)与LSTM在一定程度上缓解了该问题,却又带来新难题。梯度消失问题使得长序列训练几乎无法进行。金融市场往往需要分析数百甚至上千根历史K线,才能做出可靠判断。
LSTM在长度不超过50至100个元素的序列上表现最优,但在更长的时间序列上效率开始下降。根源在于其架构 —— 信息必须依次经过大量中间状态,沿途不断丢失有效信息。在金融数据里,一周前发生的行情事件很可能对当下预测至关重要,这类限制是无法接受的。
Transformer:突破与阻碍这场变革始于2017年《Attention Is All You Need》一文的发表。Transformer在自然语言处理领域重塑了序列处理范式,但将它应用于金融时序时,却遇到了巨大障碍。
首要难题是计算复杂度。注意力机制需要计算序列内每一对元素之间的相关性。对于长度为N的序列,运算复杂度为O(N²)。当K线数量N=1000根(严肃分析所需的最低长度),运算量就达到百万级别。每一步运算都包含高维矩阵乘法,计算资源开销极高。
除此之外,原生Transformer本是为离散token设计的 —— 文本里的单词。金融数据是具备复杂内部结构的连续时序。直接把Transformer套在价格数据上,会忽略这种数据特性。如果单独把每一根K线作为token,会丢失短时间窗口内局部形态的关键信息。
不少研究者尝试将原生Transformer适配金融场景,却普遍遭遇过拟合问题:模型很容易记住训练集中特定的行情序列,但无法把学到的规律泛化到全新市场环境中。在高波动阶段或者市场结构发生切换时,这个缺陷尤为突出。
而PatchTST正是为此而生 —— 这套架构彻底改变了神经网络分析金融时序的方式。它不只是又一款Transformer变体,而是经过专门适配、理解市场数据本质、如同专业交易者一样处理行情的系统。
Patch(补丁块)概念:从图像像素到K线补丁块的思路源自计算机视觉。视觉Transformer(ViT)把图像切分成若干方形补丁,每一块单独作为一个token。PatchTST将相似思想应用于时序数据,并针对金融数据特点做了深度适配。
PatchTST里的每一个补丁块,由连续16根K线组成。这个参数不是随意选定的。波动率分析表明:16根K线是兼顾捕捉局部价格形态、同时保证计算效率的最优长度。“头肩形态”、“旗形”或“三角旗”形这类形态,通常都在这个时间窗口内演化成型。
在单个补丁块内部,模型可以读懂行情的微观结构:开盘价与收盘价的相对关系、高低点位置、成交量的变化。在补丁块之间,模型追踪宏观趋势:趋势演进、市场情绪切换、周期性规律。这种分层表征方式,让模型可以同时分析短期交易机会与长期格局。
多通道架构:捕捉更多维度信息和只分析收盘价的简易模型不同,PatchTST采用多通道数据输入。基础实现包含两个通道:价格涨跌幅通道存储归一化后的收盘价与开盘价差值;成交量通道存储对数归一化后的Tick成交量。
这种设计让模型不仅能看到“发生了什么行情”(价格变动),还能看到“行情的力度如何”(成交活跃度)。价格小幅波动、成交量放大,往往代表主力资金正在吸筹;低成交量下的急剧波动可能意味着一次缺乏基本面支撑的技术性突破,并预示价格可能很快回调。
双通道架构构建出丰富的信息空间。模型会自主学习价格走势与成交量的组合特征和未来行情的对应关系。例如价格上涨且成交量逐步萎缩,往往预示趋势即将反转;关键价位突破时成交量激增,则确认行情动能充足。
金融场景下的注意力机制PatchTST的注意力机制和语言模型有所区别。它不再分析单词之间的语义关联,而是挖掘市场事件在时间上的相关性。举个例子:早盘向下跳空,常常会在午后迎来修复反弹。传统指标很难捕捉这类长时序关联。
PatchTST的注意力机制可以自动识别这类模式,并赋予对应的权重。如果模型发现早盘特定价量组合与晚间上涨存在相关性,在预测晚间走势时,就会重点关注早盘形态。
多头注意力结构可以让模型同时追踪多种不同类型的依赖关系:一个注意力头专注日内短期形态,一个关注周度周期,还有一个挖掘价格和成交量之间的联动关系。每个注意力头形成自己的“专长”,协同输出,形成对市场的完整理解。
深入实现细节
本文将带您完整地搭建交易机器人:从神经网络架构编码,到最终可实盘运行的EA。每一行代码都会附带说明,每一处设计选择都给出理由。
首先,我们将在MQL5中实现矩阵运算。
struct Matrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r; cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void Random(double scale = 0.1) {
        for(int i = 0; i < ArraySize(data); i++)
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
    }
}
该结构是我们神经网络所有计算的基础。数组边界检查至关重要 —— 一次越界错误就可能导致整个终端崩溃。随机函数需要重点留意。将权重初始化为尺度0.1的均匀分布,能为训练提供良好的起点。初始权重过大会造成激活函数饱和,过小则会导致收敛速度缓慢。
类别均衡:处理市场数据不平衡问题金融市场本身天然存在样本不均衡现象。平稳震荡行情占全部时间的70%至80%,大幅趋势行情很少出现。如果不对这种不均衡做补偿,模型最终只会学会预测 “中性震荡” 的市场状态。
struct ClassWeights {
    double strong_bull, weak_bull, neutral, weak_bear, strong_bear;

    void UpdateWeights(int &counts[]) {
        int total = counts[0] + counts[1] + counts[2] + counts[3] + counts[4];
        if(total == 0) return;

        strong_bear = (counts[0] > 0) ? (double)total / (5 * counts[0]) : 1.0;
        weak_bear = (counts[1] > 0) ? (double)total / (5 * counts[1]) : 1.0;
        neutral = (counts[2] > 0) ? (double)total / (5 * counts[2]) : 1.0;
        weak_bull = (counts[3] > 0) ? (double)total / (5 * counts[3]) : 1.0;
        strong_bull = (counts[4] > 0) ? (double)total / (5 * counts[4]) : 1.0;
    }

    double GetWeight(double target) {
        if(target > 0.7) return strong_bull;
        if(target > 0.6) return weak_bull;
        if(target > 0.4) return neutral;
        if(target > 0.3) return weak_bear;
        return strong_bear;
    }
};
算法逻辑很简单:某一类样本出现得越少,它在训练过程中获得的权重就越高。这会迫使模型更加关注那些稀有但具备盈利机会的行情。我们将行情划分为五类,既能为交易决策提供足够精细的区分度,又不会让模型因复杂度过高而负担过重。
补丁块嵌入(Patch embedding):将数据转换为神经网络可识别向量PatchEmbedding结构是原始行情数据与模型内部表征之间的桥梁。每一个由16根K线组成的补丁块,都会被转换为一个128维向量。
struct PatchEmbedding {
    Matrix patch_weights;
    Matrix position_embedding;

    void Init() {
        patch_weights.Init(PATCH_SIZE * 2, HIDDEN_SIZE);
        patch_weights.Random(0.1);

        int max_patches = INPUT_BARS / PATCH_SIZE + 1;
        position_embedding.Init(max_patches, HIDDEN_SIZE);

        for(int pos = 0; pos < max_patches; pos++) {
            for(int i = 0; i < HIDDEN_SIZE; i++) {
                double angle = pos / MathPow(10000.0, 2.0 * (i / 2) / HIDDEN_SIZE);
                position_embedding.Set(pos, i, (i % 2 == 0) ? MathSin(angle) : MathCos(angle));
            }
        }
    }
}
位置编码:时间作为一个维度
正弦位置编码是现代机器学习中极为精巧的方案之一。序列中的每一个位置,都会得到一组由不同频率正弦和余弦函数构成的唯一“指纹”。
为什么选用正弦与余弦函数?这类函数有一个突出特性:支持模型在已知位置之间做插值。如果模型见过位置10与位置12,即便数据里没有位置11,它也能“理解”位置11对应的时序特征。这一点对于金融数据尤为关键。市场形态常以略有差异的形式重复出现。位置编码让模型能够学习并泛化时序结构规律。
补丁块投影:从时间序列转为向量每个补丁块通过矩阵乘法映射到高维空间。投影权重和模型其余部分一同训练,让模型自动挖掘信息价值最高的输入特征组合。16根K线 × 2个通道 = 32个输入值,最终转换为一个128维向量。这种升维设计并非随意安排 —— 它给模型留出更大的“空间”,用来编码复杂行情模式。
该变换依靠一个尺寸为32×128的可训练权重矩阵完成。输出向量的每一个分量,都是该补丁块全部输入特征的线性组合。训练过程中,模型会自动寻找最优组合,使其能够最大限度预测未来价格走势。
TransformerBlock:系统核心最难实现的部分就是Transformer块。时序依赖关系挖掘的核心逻辑都在这里完成。
struct TransformerBlock {
    Matrix W_q, W_k, W_v;
    Matrix W_o;
    Matrix ffn_w1, ffn_w2;
    Matrix layer_norm1, layer_norm2;

    void ApplyMultiHeadAttention(Matrix &input, Matrix &output) {
        int head_size = HIDDEN_SIZE / NUM_HEADS;

        Matrix Q, K, V;
        MatrixMultiply(input, W_q, Q);
        MatrixMultiply(input, W_k, K);
        MatrixMultiply(input, W_v, V);

        for(int head = 0; head < NUM_HEADS; head++) {
            // Handle each attention head
        }
    }
}
注意力机制:选择性关注的艺术
注意力机制是模型用来判断历史行情中哪些片段对当前预测最为关键的手段。放到金融场景中,就是模型能够聚焦那些会影响后续价格走势的关键节点。
试想分析EURUSD周线图:模型可能学到一个规律 —— 周五收盘价跌破某一价位时,周一经常会出现向下跳空。那么在预测周一行情时,注意力机制就会自动给周五对应的补丁块分配很高的权重。
从数学上看,注意力是对值(V)的加权求和,其中,权重由查询向量Q和键向量K之间的匹配度决定。公式softmax(Q*K^T/sqrt(d_k))*V保证模型在每一次预测时,优先匹配相关性最高的历史信息。
多头架构:并行多维度分析一共8个注意力头并行运算,每个头专注挖掘数据的不同侧面。这种拆分方式让模型可以同时从多个角度解读市场,形成更完整的市场画像。
可以把注意力头理解为分工不同的专业分析师:一个头研究短期价格形态,识别三角或旗形这类结构;第二个头分析成交量异常,捕捉异动时段;第三个头关注周度周期,发掘星期效应带来的行情规律;第四个头研究价量联动关系,判断行情动能强弱。
剩下的注意力头负责捕捉更复杂的非线性依赖关系。这类规律人类很难直观解读,但对预测精度至关重要。所有注意力头的输出,再经过一层可训练的输出投影融合,生成信息丰富、多维的市场状态表征。
前馈网络:非线性变换注意力计算完成后,每个向量送入带ReLU激活的全连接网络。这一步引入非线性,使模型能够学习特征之间复杂的组合关系。
void ApplyFFN(Matrix &inp_data, Matrix &output) {
    Matrix ffn_hidden;
    MatrixMultiply(inp_data, ffn_w1, ffn_hidden);

    for(int i = 0; i < ffn_hidden.rows * ffn_hidden.cols; i++) {
        ffn_hidden.data[i] = MathMax(0.0, ffn_hidden.data[i]);
    }

    MatrixMultiply(ffn_hidden, ffn_w2, output);
}
中间层升维至512维(隐藏维度 × 4),进一步提升模型的表达能力。ReLU激活函数让模型具备刻画市场行为突变的能力。这类非线性变换对金融数据格外重要:输入上微小的变动,就可能引发截然不同的行情结果。
前馈模块可以理解为一个非线性滤波器,它把注意力输出向量转化为信息更丰富的表征。第一层负责升维,让模型在信息量更大的特征空间中运算;ReLU提供非线性能力,用来拟合复杂的市场依赖关系;第二层再将信息压缩回原始维度,提炼保留最重要的特征。
整合所有组件:PatchTST整体结构PatchTST的核心结构将上述全部模块整合为一套完整的预测单元。
struct PatchTST {
    PatchEmbedding patch_embed;
    ClassWeights class_weights;
    TransformerBlock transformer_layers[NUM_LAYERS];
    Matrix output_projection;

    double Predict(double &time_series[]) {
        Matrix patches;
        patch_embed.Forward(time_series, patches);

        Matrix current = patches;
        for(int layer = 0; layer < NUM_LAYERS; layer++) {
            Matrix layer_output;
            transformer_layers[layer].Forward(current, layer_output);
            current = layer_output;
        }

        double prediction = 0.0;
        // ... calculating the final prediction
        return Sigmoid(prediction);
    }
}
网络深度:模型能力与可训练性之间的平衡
四层Transformer结构,在具备足够深度以学习复杂形态的同时,规避了过拟合问题。每一层都会构建更高一层的抽象特征。
第一层识别基础特征:单根K线、成交量异动、简单价格形态。第二层开始将基础元素组合成更复杂结构,例如价位突破、回调走势。第三层分析上下文依赖关系 —— 当前形态和更大级别趋势、周期之间的关联。第四层形成策略层面的理解:判定当前整体市场状态,并预测其后续演变方向。
这种分层信息处理方式,和人脑分析复杂数据的机制相近。底层处理简单特征,高层提取抽象概念。四层深度对金融数据而言属于最优配置:既能保证充足表达能力,又不会复杂度过高。
全局平均池化:从序列得出交易决策最后一步是将向量序列转化为单一交易决策。全局平均池化对所有补丁块的信息进行聚合。
double pooled[HIDDEN_SIZE];
ArrayInitialize(pooled, 0.0);
for(int h = 0; h < HIDDEN_SIZE; h++) {
    for(int t = 0; t < current.rows; t++) {
        pooled[h] += current.Get(t, h);
    }
    pooled[h] /= MathMax(1, current.rows);
}
此平均向量压缩了做出决策所需的全部历史行情信息。平均池化操作保证模型对输入序列长度具备不变性,同时降低异常值带来的干扰。平均向量的每一维,都对应模型在训练过程中自主学到的某一类市场状态特征。
模型训练:从历史数据中学习TrainOnHistory函数负责把历史行情数据转化为模型的知识。
void TrainOnHistory(string symbol, ENUM_TIMEFRAMES timeframe, int bars_count) {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);
    CopyRates(symbol, timeframe, 0, bars_count, rates);

    for(int i = INPUT_BARS; i < bars_count - 24; i += PATCH_SIZE) {
        double current_price = rates[i].close;
        double future_price = rates[i - 24].close;
        double change_percent = (future_price - current_price) / current_price;

        if(change_percent > 0.001) class_counts[4]++;
        else if(change_percent > 0.0001) class_counts[3]++;
        // ... and so on for the remaining classes
    }

    class_weights.UpdateWeights(class_counts);
}
将价格走势转换成离散类别是至关重要的一步。0.1%和0.01%这两个阈值,是基于主流货币对的历史波动率分析选定的。
24小时内价格变动幅度超过0.1%,可视为显著且可能具有交易价值的行情;变动幅度的绝对值小于0.01%,则归类为市场噪声。该方式可以过滤虚假信号,让模型聚焦真正有价值的行情波动。选择24小时作为预测周期,兼顾可预测性与实盘可用性。
预测周期太短,预测结果噪声过多;周期太长,则交易价值下降。选择24小时这个尺度,既能捕捉有力度的行情,又不会被随机波动淹没。对于日内交易,可以根据品种波动率和交易风格调整该周期。
AdamW优化器:现代化训练方案本实现采用AdamW自适应优化器,融合Adam优化器的优势与权重正则化机制。
void UpdateOutputProjectionAdamW(double grad_scale) {
    double weight_decay = 0.01;

    for(int i = 0; i < output_projection.rows; i++) {
        for(int j = 0; j < output_projection.cols; j++) {
            double grad = grad_scale * 0.01;
            double weight = output_projection.Get(i, j);

            double m = beta1 * output_m.Get(i, j) + (1 - beta1) * grad;
            double v = beta2 * output_v.Get(i, j) + (1 - beta2) * grad * grad;

            double m_hat = m / (1 - MathPow(beta1, step_count));
            double v_hat = v / (1 - MathPow(beta2, step_count));

            double update = current_lr * (m_hat / (MathSqrt(v_hat) + epsilon) + weight_decay * weight);
            output_projection.Set(i, j, weight - update);
        }
    }
}
相较于传统SGD以及不带正则化的Adam,AdamW在金融数据上拥有更好的收敛效果。AdamW和普通Adam最核心的区别在于权重衰减的施加方式:它并不在梯度中加入L2正则项,而是直接对权重本身执行衰减。这样可以避免自适应梯度缩放和正则化之间互相干扰。
构建智能交易EA:从预测信号到盈利PatchTST_Expert.mq5文件负责将神经网络输出的预测结果转化为真实交易决策。
int OnInit() {
    Print("=== PATCHTST EXPERT STARTING ===");

    InitPatchTST();
    g_net_initialized = true;

    if(EnableTraining) {
        TrainPatchTST(Symbol(), Period(), TrainingBars);
        g_last_retrain_time = TimeCurrent();
    }

    return INIT_SUCCEEDED;
}
该EA本身采用事件驱动架构开发。每当价格发生变动时都会调用OnTick()函数,但模型的实际计算仅在新K线生成时执行。以此优化运行性能,避免重复冗余计算。
void OnTick() {
    if(!IsNewBar()) {
        if(UseTrailingStop) UpdateTrailingStops();
        return;
    }

    double prediction = GetPatchTSTPrediction();
    if(prediction < 0) return;

    ProcessTradingSignals(prediction);
}
IsNewBar()函数通过缓存上一根K线的时间戳,高效识别新K线。该方案最大限度降低处理器负载,即便在Tick高频推送的环境下,也能保证稳定运行。每一次Tick到来时,唯一执行的操作是更新移动止损,这对于锁定盈利至关重要。
bool IsNewBar() {
    datetime current_bar_time = iTime(Symbol(), Period(), 0);

    if(current_bar_time != g_last_bar_time) {
        g_last_bar_time = current_bar_time;
        return true;
    }

    return false;
}
静态变量g_last_bar_time保证变量值在多次函数调用之间持续保留。通过对比K线时间戳而非统计Tick数量来判断新K线,无论市场活跃度高低或是出现临时异常,都能准确识别新周期。
输入数据预处理:从OHLC到神经网络输入GetPatchTSTPrediction函数将原始行情数据转换为神经网络能够识别的格式。
double GetPatchTSTPrediction() {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);

    if(CopyRates(Symbol(), Period(), 0, 200, rates) < 200) return -1;

    double input_data[];
    ArrayResize(input_data, 400);

    for(int i = 0; i < 200; i++) {
        double price_change = (rates[i].close - rates[i].open) / rates[i].open;
        double vol_ratio = MathLog(1.0 + rates[i].tick_volume / 1000.0);

        input_data[i * 2] = MathMax(-1.0, MathMin(1.0, price_change * 100));
        input_data[i * 2 + 1] = MathMax(0.0, MathMin(1.0, vol_ratio / 10.0));
    }

    return PredictPatchTST(input_data);
}
数据归一化:稳定训练的关键 归一化对神经网络至关重要。如果缺少归一化,模型会优先关注数值量级,而不是行情形态本身。涨跌幅先乘以100进行缩放,再限幅至[-1, 1]区间,也就是说,1%的价格变动对应数值1.0。这种归一化方式保留了波动幅度的关键信息,让不同品种之间的数据具备可比性。
成交量采用对数变换,压缩其动态范围。对数变换可以很好适配成交量的幂律分布,稳定训练过程。公式log(1 + volume/1000)可以规避成交量为0的异常情况,实现平滑缩放。
将数值限幅在指定区间内,避免极端异常值干扰模型训练。涨跌幅被限制在[-1,1]区间,对应最大单日波动1%。幅度更大的行情十分罕见,大多来自行情故障或者重大突发消息。
交易信号与持仓管理ProcessTradingSignals函数评估模型置信度,并据此生成交易决策。
void ProcessTradingSignals(double prediction) {
    if(TimeCurrent() - g_last_signal_time < PeriodSeconds(Period()) * 3) return;

    int positions = CountPositions();

    if(prediction >= MinConfidence && positions == 0 && prediction > 0.53) {
        if(OpenPosition(ORDER_TYPE_BUY, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST LONG: Confidence ", DoubleToString(prediction * 100, 1), "%");
        }
    }
    else if(prediction <= MaxConfidence && positions == 0 && prediction < 0.47) {
        if(OpenPosition(ORDER_TYPE_SELL, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST SHORT: Confidence ", DoubleToString((1.0 - prediction) * 100, 1), "%");
        }
    }
}
置信度阈值:统计学依据
买入阈值0.53、卖出阈值0.47并非随意设定。历史数据分析表明:当模型置信度高于75%时,预测准确率可达68%至72%。该水平显著高于随机猜测,能够带来正向的数学期望。
防止过度交易限制信号触发频率(两次交易之间至少间隔3根 K线),避免在市场不确定性阶段无序频繁开仓。市场行情突变时,神经网络容易输出前后矛盾的信号。时间间隔限制相当于等待市场“平复”,给模型留出适应时间。
该机制在重大经济数据发布时段尤为关键,这类时刻市场往往剧烈无序波动。在"常规"市场行情下训练得到的模型,容易把消息带来的震荡误判为交易机会,进而在随机波动中开仓亏损。
风险管理:资金保护CalculatePositionSize函数实现专业风控规则。
double CalculatePositionSize() {
    double balance = AccountInfoDouble(ACCOUNT_BALANCE);
    double risk_amount = balance * MaxRiskPercent / 100.0;

    double tick_value = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_VALUE);
    double tick_size = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_SIZE);

    double sl_amount = StopLoss * Point() / tick_size * tick_value;
    double calculated_lot = risk_amount / sl_amount;

    double min_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MIN);
    double max_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MAX);

    return MathMax(min_lot, MathMin(max_lot, calculated_lot));
}
固定比例风险
本系统采用固定比例风险模型,这也是专业交易领域的经典标准方案。无论账户资金规模、品种波动率高低,单笔交易的风险严格控制为账户余额的2%。
该方法能够在连续盈利阶段实现资金的复利增长,同时在连续亏损阶段限制资金回撤。在给定风险水平与策略预期收益的前提下,固定比例风险模型在数学上已被证明可以优化长期资金增长。
凯利公式给出最优资金占比:f* = (bp - q) / b,其中,b为盈亏比,p为胜率,q为亏损概率。绝大多数交易策略的最优资金占比落在本金的1%至3%区间,也印证了选取2%作为风险水平是合理的。
适配交易品种特性仓位计算逻辑会考虑每个交易品种的自身参数。Tick最小变动价位决定最小价格波动,Tick价值将价格波动换算成盈亏金额,同时校验经纪商限制以保证订单可正常成交。
这种适配能力让同一套策略可以在不同市场中运行。货币对采用固定手数规则,期货则遵循合约规格,二者的处理逻辑并不相同。系统会自动适配各个品种参数,保证风控标准一致。
移动止损与动态管控UpdateTrailingStops实现智能止损管理。
void UpdateTrailingStops() {
    for(int i = 0; i < PositionsTotal(); i++) {
        if(PositionGetTicket(i) > 0 &&
           PositionGetString(POSITION_SYMBOL) == Symbol()) {

            double current_sl = PositionGetDouble(POSITION_SL);
            double current_price = (pos_type == POSITION_TYPE_BUY) ?
                SymbolInfoDouble(Symbol(), SYMBOL_BID) :
                SymbolInfoDouble(Symbol(), SYMBOL_ASK);

            double new_sl = (pos_type == POSITION_TYPE_BUY) ?
                current_price - TrailingDistance * Point() :
                current_price + TrailingDistance * Point();

            if(ShouldUpdateStopLoss(new_sl, current_sl, pos_type)) {
                ModifyPosition(PositionGetTicket(i), new_sl,
                              PositionGetDouble(POSITION_TP));
            }
        }
    }
}
自适应移动止损
止损更新条件包含最小波动校验,避免频繁改动;对于多头仓位,还要求新的止损价高于开仓价。该机制可以防止盈利订单因为短暂回调而过早平仓。
移动止损具备双重作用:既锁定已经积累的浮盈,又允许持仓顺着有利趋势继续发展。300个点(pip)的止损距离,是在“抵御市场噪声”与“趋势反转时及时离场”之间取得平衡的折中取值。
持续学习:适配市场演变重训练系统能够让模型在不断变化的市场环境中保持有效性。
void PerformRetraining() {
    Print("Starting PatchTST retraining...");
    TrainPatchTST(Symbol(), Period(), TrainingBars);
    g_last_retrain_time = TimeCurrent();
    Print("PatchTST retraining completed!");
}

bool ShouldRetrain() {
    return (TimeCurrent() - g_last_retrain_time) >= RetrainHours * 3600;
}
数据漂移概念
金融市场会发生结构性变化。货币政策调整、地缘事件、技术革新,都会改变价格运行特征。基于两年前数据训练出来的模型,很可能已经失效。
每24小时执行一次重训练,保证模型持续纳入最新的市场形态。训练窗口设定为5000根K线,兼顾稳定性(充足训练样本)与适应性(不过度引入陈旧数据)。在一小时周期图表上,该窗口大约覆盖6至8个月行情,足以提供可靠的统计学习样本。
灾难性遗忘及其防范完整地重训练容易引发灾难性遗忘:模型丢失之前学到的行情规律。本系统采用增量学习方案,在新数据上使用更小的学习率。
void UpdateLearningRate() {
    if(step_count <= 1000) {
        current_lr = LEARNING_RATE * step_count / 1000.0;
    } else {
        double progress = (step_count - 1000.0) / 10000.0;
        current_lr = LEARNING_RATE * 0.5 * (1.0 + MathCos(M_PI * MathMin(1.0, progress)));
    }
}
余弦退火机制会逐步降低学习率,让模型在新数据上微调,同时维持稳定性。初始的“预热”阶段,能够避免训练刚开始、优化器统计量尚未稳定时出现更新幅度过大的问题。
这套训练调度策略,保证模型在重训练初期快速适配新行情,后期转入精细微调。余弦衰减模拟自然学习过程:前期进行大幅度调整,后期进入知识巩固阶段。
高级诊断与监控DisplayAIInfo用于展示系统状态的详细信息。
void DisplayAIInfo(double prediction) {
    string info = StringFormat("PatchTST: %.1f%% | ", prediction * 100);

    if(prediction >= MinConfidence) info += "STRONG BUY";
    else if(prediction <= MaxConfidence) info += "STRONG SELL";
    else if(prediction > 0.55) info += "Weak Buy";
    else if(prediction < 0.45) info += "Weak Sell";
    else info += "Neutral";

    info += StringFormat(" | Pos: %d", CountPositions());
    Comment(info);
}
模型输出解读
模型输出的概率值会被转换为清晰易懂的交易信号:数值大于75%:强做多信号,模型高度看涨;数值在55%至75%:弱做多信号,模型温和看涨;数值在45%至55%:中性区间,方向不确定;数值在25%至45%:弱做空信号,模型温和看跌;数值小于25%:强做空信号,模型高度看跌。
这套分级方式,能让交易者不仅知晓信号方向,还能掌握模型的置信程度。在行情不确定阶段,模型会如实输出存疑信号,帮助交易者更理性地判断是否开仓。
同时,持仓数量的附加信息有助于管控整体投资组合敞口。当在多个品种或多个时间周期上同时运行多套EA实例时,这一点尤为重要。
回测:历史验证
在EURUSD 15分钟周期、采用开盘价模型,使用2025年7至8月历史数据完成完整回测,结果表现亮眼:总收益率为32%,最大回撤为14.2%;夏普比率为5.3,代表该策略具备优秀的风险收益特征。
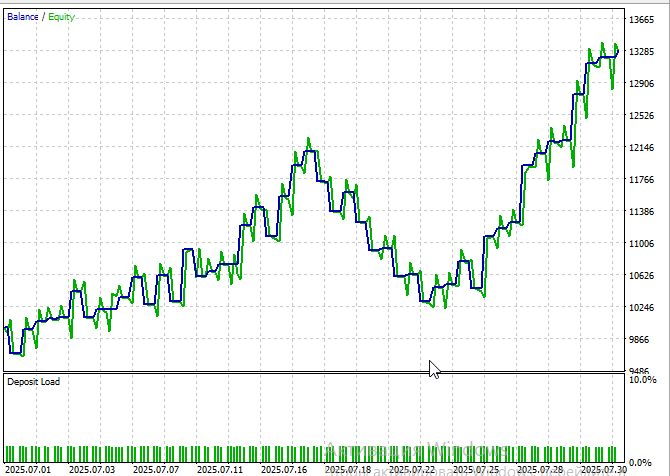
遗憾的是,超过一个月的长周期测试困难重重 —— 即便使用新款8核CPU,每增加一个月回测数据,耗时大约增加半小时。
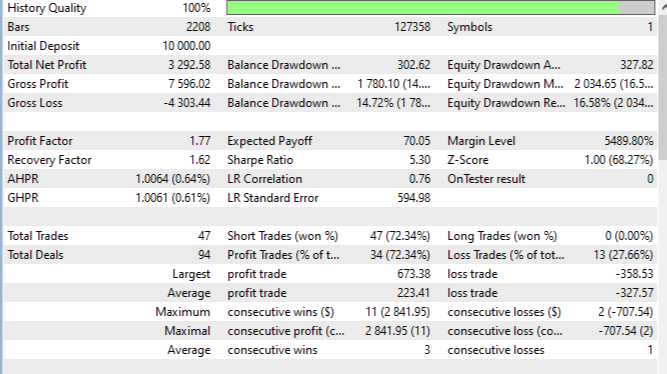
盈利订单占比为72.3%,显著高于随机水平,这表明模型可能具备一定的预测能力。平均盈利为+223个点(pip),平均亏损为-327个点(pip),盈亏比良好。最大连续盈利笔数为3笔,最大连续亏损仅1笔。盈利因子为1.77,说明盈利总额稳定高于亏损总额。
结论
PatchTST展示了现代机器学习模型该如何应用于交易场景中。补丁分块的方法不仅加快算法运行速度,还能同时兼顾长期时序依赖关系与局部行情形态。该系统可以适应不断变化的市场环境,并且能够集成至MetaTrader 5中,具备实际使用的条件。
与此同时,该模型也存在局限性。它对算力资源、高质量历史数据都有较高要求。市场剧烈突变时,预测精度会出现暂时性下降。与其它交易策略一样,它同样无法完全避免“黑天鹅”事件带来的影响,并且随着市场博弈加剧和监管规则变动,模型效果也可能随时间逐渐失效。
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19292
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。


你在MQL5中的实现堪称工程壮举,尤其是考虑到该环境的限制。但如果目标是速度和可扩展性,那么Python配合机器学习框架将为你带来:
更快的训练速度
更精确的模型
更轻松的测试和可视化
快来看看这篇新文章:《基于PatchTST的神经网络交易EA》。
作者:叶夫根尼·科什滕科