

Asesor experto de trading neuronal basado en PatchTST
 36
 2

Introducción
¿Recuerda la época en que un RSI en zona de sobrecompra indicaba una corrección inminente y el MACD señalaba claramente un cambio de tendencia? Esos días ya han quedado atrás. Los mercados actuales se han vuelto demasiado complejos para los indicadores matemáticos sencillos. Los tráders algorítmicos se llevan la mayor parte de los beneficios gracias al aprendizaje automático, mientras que los tráders minoristas siguen confiando en herramientas que tienen ya medio siglo de antigüedad.
La muerte de los indicadores tradicionales: anatomía de un fracasoPara comprender la magnitud del problema, analicemos las estadísticas. En la década de 1990, una estrategia sencilla basada en el cruce de medias móviles lograba un 65-70 % de operaciones rentables en los principales pares de divisas. Para 2010, esta cifra había caído al 52 %. Hoy se mantiene en el nivel del azar: alrededor del 50 %.
La razón no es que las matemáticas hayan cambiado. El problema radica en la adaptación del mercado. Cuando millones de tráders utilizan las mismas señales, el propio mercado empieza a incorporarlas. Esto crea un bucle de retroalimentación: el indicador se convierte en una profecía que se refuta a sí misma. Jim Simons ya hablaba de esto: es como una manada de camellos en el desierto; a un solo camello un oasis le basta durante mucho tiempo, pero una manada enorme lo agota rápidamente y vuelve a verse atormentada por la sed.
Es más, los mercados actuales se ven afectados por factores que no existían en la época en que se crearon el RSI y el MACD. El trading de alta frecuencia genera ruido microestructural que los indicadores tradicionales interpretan como señales falsas. Los fondos algorítmicos con activos por valor de miles de millones pueden crear patrones artificialmente, tendiendo trampas a los tráders minoristas.
Los indicadores tradicionales se basan en supuestos lineales sobre el comportamiento del mercado. El RSI parte de la premisa de que los valores extremos provocan un retroceso. Las medias móviles se basan en la idea de que el precio tiende a situarse en torno a un valor medio. El MACD se basa en la idea de que las tendencias a corto plazo interactúan de forma predecible con las de largo plazo. Todas estas hipótesis funcionaban en los mercados menos eficientes del pasado, pero se desmoronan en el contexto del trading algorítmico moderno.
Redes neuronales: el primer intento de evoluciónLa primera generación de tráders que tomó conciencia de las limitaciones del análisis técnico recurrió a redes neuronales simples. Los perceptrones multicapa de la década de los 90 parecían revolucionarios. Podían detectar relaciones no lineales que se les escapaban a los indicadores lineales.
Sin embargo, estos sistemas también presentaban defectos fundamentales. Las redes neuronales simples no podían procesar eficazmente las secuencias de datos. Analizaban cada barra de forma aislada, perdiendo así el contexto de la dinámica temporal. Esto resultaba especialmente crítico para los mercados financieros, donde el movimiento actual del precio está indisolublemente ligado a los acontecimientos anteriores.
Las redes neuronales recurrentes (RNN) y las LSTM resolvieron en parte este problema, pero trajeron consigo nuevas dificultades. El problema del gradiente desvaneciente hacía que el entrenamiento con secuencias largas fuera prácticamente imposible. Por su parte, los mercados financieros demandan el análisis de cientos (a veces miles) de barras históricas para tomar una decisión fundamentada.
Las redes LSTM mostraban los mejores resultados en secuencias de hasta 50-100 elementos, pero empezaban a perder eficacia en series temporales más largas. El problema radicaba en la arquitectura: la información tenía que pasar por numerosos estados intermedios, perdiendo relevancia por el camino. En el caso de los datos financieros, en los que un acontecimiento ocurrido hace una semana puede resultar de vital importancia para la previsión actual, tales restricciones resultaban inaceptables.
Transformers: un gran avance y obstáculosLa revolución comenzó en 2017 con la publicación del artículo «Attention Is All You Need». Los Transformers cambiaron radicalmente el procesamiento de secuencias en el NLP, pero su aplicación a las series temporales financieras se topó con serios obstáculos.
El principal problema es la complejidad computacional. El mecanismo de atención requiere calcular las correlaciones entre cada par de elementos de la secuencia. Para una secuencia de longitud N, esto supone O(N²) operaciones. Cuando N = 1000 barras (lo mínimo para un análisis riguroso), el número de operaciones alcanza el millón. Cada operación incluye una multiplicación matricial de alta dimensionalidad, lo que hace que los cálculos consuman una enorme cantidad de recursos.
Además, los Transformers tradicionales se diseñaron para tokens discretos: las palabras de un texto. Los datos financieros constituyen series temporales continuas con una estructura interna compleja. La simple aplicación de Transformers a los datos de precios pasa por alto esta particularidad. La tokenización por barras individuales pierde información importante sobre los patrones locales dentro de ventanas temporales breves.
Los intentos de adaptar los Transformers «vanilla» al ámbito financiero se toparon con el problema del sobreajuste. El modelo memorizaba fácilmente secuencias específicas de los datos de entrenamiento, pero no era capaz de generalizar ese conocimiento a nuevas situaciones del mercado. Esto se manifestaba especialmente en periodos de alta volatilidad o de cambios estructurales en el mercado.
Aquí es donde aparece PatchTST, una arquitectura que cambia por completo la forma de entender cómo deben analizar las redes neuronales las series temporales financieras. No se trata simplemente de otro Transformer más, sino de un sistema especialmente adaptado que comprende la naturaleza de los datos del mercado y trabaja con ellos como un auténtico tráder profesional.
El concepto de los parches: de los píxeles a las barrasLa idea de los parches proviene del campo de la visión por computadora. Vision Transformer (ViT) divide la imagen en parches cuadrados, cada uno de los cuales se procesa como un token independiente. PatchTST aplica un principio similar a las series temporales, pero con una comprensión profunda de los datos financieros.
Cada parche de PatchTST consiste en un segmento de 16 barras consecutivas. No es una elección al azar. El análisis de la volatilidad muestra que una longitud de 16 barras es óptima para captar patrones locales de movimiento del precio, sin perder por ello eficiencia computacional. Los patrones como el de «cabeza y hombros», las «banderas» o los «banderines» suelen desarrollarse precisamente en esas ventanas temporales.
Dentro de cada parche, el modelo analiza la microestructura del movimiento: cómo se relaciona el precio de apertura con el de cierre, cuáles fueron los máximos y mínimos, y cómo varió el volumen. Entre un parche y otro, el modelo realiza un seguimiento de las macrotendencias: la evolución de las tendencias, los cambios en el sentimiento del mercado y los patrones cíclicos. Esta representación jerárquica permite analizar al mismo tiempo las oportunidades tácticas a corto plazo y el panorama estratégico a largo plazo.
Arquitectura multicanal: ver más dimensionesA diferencia de los sistemas sencillos, que solo analizan el precio de cierre, PatchTST trabaja con datos multicanal. La implementación básica utiliza dos canales: el canal de variaciones de precios representa la diferencia normalizada entre el precio de cierre y el de apertura, mientras que el canal de volúmenes contiene el volumen de ticks normalizado logarítmicamente.
Este enfoque permite al modelo ver no solo «lo que ha ocurrido» (el movimiento del precio), sino también «con qué intensidad» (la actividad de volumen). Un volumen elevado con un movimiento de precio poco significativo indica que los grandes operadores están acumulando posiciones. Un movimiento brusco con bajo volumen puede indicar una ruptura técnica sin respaldo fundamental, lo que presagia un rápido retroceso.
La arquitectura de dos canales crea un espacio informativo muy rico. El modelo aprende a asociar determinadas combinaciones de movimientos de precios y volúmenes con resultados futuros. Por ejemplo, una disminución gradual de los volúmenes acompañada de un aumento del precio suele preceder a un cambio de tendencia. Un pico de volumen en la ruptura de un nivel importante confirma la fuerza del movimiento.
El mecanismo de atención en el contexto financieroEl mecanismo de atención de PatchTST funciona de forma diferente a como lo hace en los modelos lingüísticos. En lugar de analizar las relaciones semánticas entre palabras, busca correlaciones temporales entre los eventos del mercado. Imagine esta situación: un hueco bajista por la mañana suele dar lugar a un movimiento de recuperación por la tarde. Los indicadores tradicionales no pueden detectar este tipo de dependencias a largo plazo.
El mecanismo de atención de PatchTST detecta automáticamente estos patrones y les asigna las ponderaciones correspondientes. Si el modelo detecta que una determinada combinación de volumen y movimiento del precio durante las horas de la mañana se correlaciona con un rally vespertino, prestará especial atención a los patrones matutinos al pronosticar el movimiento vespertino.
La estructura de atención multicabeza permite al modelo rastrear simultáneamente distintos tipos de dependencias. Una cabeza puede centrarse en los patrones intradía a corto plazo, otra en la ciclicidad semanal y una tercera en las correlaciones entre el precio y el volumen. Cada cabeza desarrolla su propia «especialización», y su trabajo conjunto crea una comprensión integral del mercado.
Inmersión profunda en la implementación
En este artículo recorreremos todo el proceso de creación de un robot de trading: desde el diseño de la arquitectura de la red neuronal hasta el Expert Advisor final, listo para operar en condiciones reales. Se explicará cada línea de código y se justificará cada decisión.
Lo primero: la implementación de operaciones matriciales en MQL5.
struct Matrix {
    double data[];
    int rows, cols;

    void Init(int r, int c) {
        rows = r; cols = c;
        ArrayResize(data, r * c);
        ArrayInitialize(data, 0.0);
    }

    double Get(int r, int c) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void Set(int r, int c, double val) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        data[r * cols + c] = val;
    }

    void Random(double scale = 0.1) {
        for(int i = 0; i < ArraySize(data); i++)
            data[i] = (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
    }
}
Esta estructura constituye la base de todos los cálculos de nuestra red neuronal. La comprobación de los límites del array es fundamental: una sola salida fuera de los límites puede hacer fallar todo el terminal. La función Random merece una atención especial. La inicialización de los pesos según una distribución uniforme con una escala de 0,1 proporciona buenas condiciones iniciales para el entrenamiento. Unos pesos iniciales demasiado grandes provocan la saturación de las funciones de activación, mientras que unos demasiado pequeños dan lugar a una convergencia lenta.
Balanceo de clases: lucha contra la desigualdad del mercadoLos mercados financieros están desequilibrados por naturaleza. Los periodos de mercado tranquilo representan entre el 70 % y el 80 % del tiempo; los movimientos fuertes son poco frecuentes. Si no se compensa este desequilibrio, el modelo aprenderá a predecir únicamente el estado «neutro» del mercado.
struct ClassWeights {
    double strong_bull, weak_bull, neutral, weak_bear, strong_bear;

    void UpdateWeights(int &counts[]) {
        int total = counts[0] + counts[1] + counts[2] + counts[3] + counts[4];
        if(total == 0) return;

        strong_bear = (counts[0] > 0) ? (double)total / (5 * counts[0]) : 1.0;
        weak_bear = (counts[1] > 0) ? (double)total / (5 * counts[1]) : 1.0;
        neutral = (counts[2] > 0) ? (double)total / (5 * counts[2]) : 1.0;
        weak_bull = (counts[3] > 0) ? (double)total / (5 * counts[3]) : 1.0;
        strong_bull = (counts[4] > 0) ? (double)total / (5 * counts[4]) : 1.0;
    }

    double GetWeight(double target) {
        if(target > 0.7) return strong_bull;
        if(target > 0.6) return weak_bull;
        if(target > 0.4) return neutral;
        if(target > 0.3) return weak_bear;
        return strong_bear;
    }
};
El algoritmo es sencillo: cuanto menos frecuente es una clase, mayor peso se le asigna durante el entrenamiento. Esto hace que el modelo preste más atención a los movimientos de mercado poco frecuentes, pero rentables. La clasificación en cinco categorías ofrece una granularidad suficiente para las decisiones de trading, sin sobrecargar el modelo con una complejidad excesiva.
Embedding de parches: convertimos los datos en vectores comprensibles para la red neuronalLa estructura PatchEmbedding es un puente entre los datos brutos del mercado y la representación interna del modelo. Cada parche de 16 barras se convierte en un vector de 128 dimensiones.
struct PatchEmbedding {
    Matrix patch_weights;
    Matrix position_embedding;

    void Init() {
        patch_weights.Init(PATCH_SIZE * 2, HIDDEN_SIZE);
        patch_weights.Random(0.1);

        int max_patches = INPUT_BARS / PATCH_SIZE + 1;
        position_embedding.Init(max_patches, HIDDEN_SIZE);

        for(int pos = 0; pos < max_patches; pos++) {
            for(int i = 0; i < HIDDEN_SIZE; i++) {
                double angle = pos / MathPow(10000.0, 2.0 * (i / 2) / HIDDEN_SIZE);
                position_embedding.Set(pos, i, (i % 2 == 0) ? MathSin(angle) : MathCos(angle));
            }
        }
    }
}
Codificación posicional: el tiempo como dimensión
La codificación posicional sinusoidal es una de las soluciones más elegantes del aprendizaje automático actual. Cada posición de la secuencia recibe una «huella» única formada por senos y cosenos de diferentes frecuencias.
¿Por qué precisamente los senos y los cosenos? Estas funciones tienen una propiedad extraordinaria: permiten al modelo interpolar entre posiciones conocidas. Si el modelo ha visto la posición 10 y la posición 12, puede «entender» qué es la posición 11, incluso sin haberla encontrado en los datos. Esto es especialmente importante en el caso de los datos financieros. Los patrones de mercado suelen repetirse con pequeñas variaciones. La codificación posicional permite al modelo generalizar el conocimiento sobre la estructura temporal.
Proyección de parches: de las series temporales a los vectoresCada parche se proyecta en un espacio multidimensional mediante una multiplicación matricial. Los pesos de proyección se entrenan junto con el resto del modelo, lo que permite al sistema encontrar automáticamente las combinaciones más informativas de las características de entrada. 16 barras × 2 canales = 32 valores de entrada se convierten en un vector de 128 dimensiones. Este aumento de la dimensionalidad no es casual: proporciona al modelo más «espacio» para codificar patrones complejos.
La transformación se realiza mediante una matriz de pesos entrenada de tamaño 32×128. Cada elemento del vector de salida representa una combinación lineal de todas las características de entrada del parche. Durante el proceso de entrenamiento, el modelo encuentra automáticamente las combinaciones óptimas que mejor predicen los movimientos futuros del precio.
TransformerBlock: el corazón del sistemaLa parte más complicada es la implementación del bloque Transformer. Aquí es donde reside toda la magia del análisis de dependencias.
struct TransformerBlock {
    Matrix W_q, W_k, W_v;
    Matrix W_o;
    Matrix ffn_w1, ffn_w2;
    Matrix layer_norm1, layer_norm2;

    void ApplyMultiHeadAttention(Matrix &input, Matrix &output) {
        int head_size = HIDDEN_SIZE / NUM_HEADS;

        Matrix Q, K, V;
        MatrixMultiply(input, W_q, Q);
        MatrixMultiply(input, W_k, K);
        MatrixMultiply(input, W_v, V);

        for(int head = 0; head < NUM_HEADS; head++) {
            // Procesamiento de cada cabeza de atención
        }
    }
}
El mecanismo de atención: el arte de la atención selectiva
El mecanismo de atención es la forma en que el modelo decide qué partes de la historia son las más importantes para la predicción actual. En el contexto financiero, esto significa la capacidad de centrarse en los momentos clave que influyen en el movimiento futuro del precio.
Imagine el análisis de un gráfico semanal de EURUSD. El modelo puede observar que un cierre del viernes por debajo de un nivel determinado a menudo provoca un hueco bajista el lunes. El mecanismo de atención asignará automáticamente un peso alto al parche del viernes al pronosticar el movimiento del lunes.
Matemáticamente, la atención se calcula como la suma ponderada de los valores de V, donde los pesos vienen determinados por la compatibilidad entre la consulta Q y las claves K. La fórmula softmax(Q*K^T/sqrt(d_k))*V garantiza que el modelo se centre en la información histórica más relevante para cada predicción.
Arquitectura de atención multicabeza: dimensiones paralelas del análisisOcho cabezas de atención funcionan en paralelo, y cada una se centra en su propio aspecto de los datos. Esta división permite al modelo analizar el mercado desde diferentes perspectivas al mismo tiempo, creando una visión más completa.
Las cabezas de atención pueden imaginarse como analistas especializados. Una cabeza de atención estudia patrones de precios a corto plazo, siguiendo formaciones como triángulos o banderas. Otra cabeza analiza anomalías de volumen, detectando períodos de actividad inusual. Una tercera cabeza se centra en la ciclicidad semanal, identificando patrones en el comportamiento del mercado según los días de la semana. Una cuarta cabeza examina las correlaciones entre el precio y el volumen, determinando la fuerza de los movimientos.
Las demás cabezas de atención se ocupan de relaciones no lineales más complejas, difíciles de interpretar para una persona, pero importantes para la precisión de las predicciones. Los resultados de todas las cabezas se combinan mediante una proyección de salida entrenada, creando una representación rica y multidimensional de la situación del mercado.
Redes Feed-Forward: transformaciones no linealesTras la atención, cada vector pasa por una red completamente conectada con activación ReLU. Esto añade no linealidad y permite al modelo estudiar combinaciones complejas de características.
void ApplyFFN(Matrix &inp_data, Matrix &output) {
    Matrix ffn_hidden;
    MatrixMultiply(inp_data, ffn_w1, ffn_hidden);

    for(int i = 0; i < ffn_hidden.rows * ffn_hidden.cols; i++) {
        ffn_hidden.data[i] = MathMax(0.0, ffn_hidden.data[i]);
    }

    MatrixMultiply(ffn_hidden, ffn_w2, output);
}
La ampliación a 512 dimensiones (HIDDEN_SIZE * 4) en la capa intermedia aporta al modelo una mayor expresividad. La activación ReLU añade la capacidad de modelar cambios bruscos en el comportamiento del mercado. Estas no linealidades son especialmente importantes en el caso de los datos financieros, donde pequeños cambios en los parámetros de entrada pueden dar lugar a resultados radicalmente diferentes.
El bloque feed-forward puede considerarse un filtro no lineal que transforma los vectores de atención en representaciones más informativas. La primera capa amplía la dimensionalidad, lo que permite que el modelo funcione en un espacio de características más rico. ReLU proporciona la no linealidad necesaria para modelar las complejas relaciones del mercado. La segunda capa comprime la información de nuevo a su dimensionalidad original, concentrando los aspectos más importantes.
Ensamblamos todo en PatchTSTLa estructura principal de PatchTST integra todos los componentes en un único sistema predictivo.
struct PatchTST {
    PatchEmbedding patch_embed;
    ClassWeights class_weights;
    TransformerBlock transformer_layers[NUM_LAYERS];
    Matrix output_projection;

    double Predict(double &time_series[]) {
        Matrix patches;
        patch_embed.Forward(time_series, patches);

        Matrix current = patches;
        for(int layer = 0; layer < NUM_LAYERS; layer++) {
            Matrix layer_output;
            transformer_layers[layer].Forward(current, layer_output);
            current = layer_output;
        }

        double prediction = 0.0;
        // ... cálculos de la predicción final
        return Sigmoid(prediction);
    }
}
Profundidad de la red: equilibrio entre potencia y entrenabilidad
Las cuatro capas de Transformers proporcionan la profundidad suficiente para aprender patrones complejos, evitando al mismo tiempo problemas de sobreajuste. Cada capa añade un nuevo nivel de abstracción.
La primera capa reconoce patrones básicos: velas individuales, picos de volumen y formaciones de precios sencillas. La segunda capa comienza a combinar estos elementos básicos en estructuras más complejas, como rupturas de niveles o movimientos de retroceso. La tercera capa analiza las dependencias contextuales: cómo se relacionan los patrones actuales con tendencias y ciclos más amplios. La cuarta capa forma una comprensión estratégica: determina el régimen general del mercado y prevé su evolución.
Este procesamiento jerárquico de la información es similar al funcionamiento del cerebro humano a la hora de analizar datos complejos. Los niveles bajos procesan rasgos simples, mientras que los altos procesan conceptos abstractos. Una profundidad de cuatro capas es óptima para los datos financieros, ya que garantiza una expresividad suficiente sin una complejidad excesiva.
Promediado global: de la secuencia a la decisiónLa etapa final consiste en convertir la secuencia de vectores en una única decisión de trading. El promediado global agrega la información de todos los parches.
double pooled[HIDDEN_SIZE];
ArrayInitialize(pooled, 0.0);
for(int h = 0; h < HIDDEN_SIZE; h++) {
    for(int t = 0; t < current.rows; t++) {
        pooled[h] += current.Get(t, h);
    }
    pooled[h] /= MathMax(1, current.rows);
}
Este vector promediado contiene una representación comprimida de todo el historial de mercado necesario para tomar una decisión. El promediado garantiza la invariancia respecto a la longitud de la secuencia de entrada y reduce el impacto de los valores atípicos. Cada dimensión del vector promediado representa un aspecto concreto del estado del mercado, aprendido automáticamente por el modelo durante el proceso de entrenamiento.
Entrenamiento del modelo: extraemos conocimiento del historialLa función TrainOnHistory convierte los datos históricos en conocimiento del modelo.
void TrainOnHistory(string symbol, ENUM_TIMEFRAMES timeframe, int bars_count) {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);
    CopyRates(symbol, timeframe, 0, bars_count, rates);

    for(int i = INPUT_BARS; i < bars_count - 24; i += PATCH_SIZE) {
        double current_price = rates[i].close;
        double future_price = rates[i - 24].close;
        double change_percent = (future_price - current_price) / current_price;

        if(change_percent > 0.001) class_counts[4]++;
        else if(change_percent > 0.0001) class_counts[3]++;
        // ... y así sucesivamente para el resto de las clases
    }

    class_weights.UpdateWeights(class_counts);
}
La conversión de los movimientos de precios en clases discretas es una etapa de vital importancia. Los umbrales del 0,1 % y el 0,01 % se han seleccionado basándose en un análisis de la volatilidad histórica de los principales pares de divisas.
Una variación superior al 0,1 % en 24 horas se considera significativa y potencialmente negociable. Las fluctuaciones inferiores al 0,01 % se clasifican como ruido del mercado. Este enfoque filtra las señales falsas y centra el modelo en los movimientos que realmente importan. La elección de un horizonte de predicción de 24 horas garantiza un equilibrio entre la previsibilidad y la aplicabilidad práctica.
Un horizonte demasiado corto hace que las previsiones contengan demasiado ruido, mientras que uno demasiado largo reduce su valor de trading. Un período de 24 horas permite captar movimientos significativos sin perderse en fluctuaciones aleatorias. Para el trading intradía, este intervalo puede ajustarse en función de la volatilidad del instrumento y del estilo de trading.
Optimizador AdamW: un enfoque moderno del entrenamientoLa implementación incluye el optimizador adaptativo AdamW, que combina las ventajas de Adam con la regularización de pesos.
void UpdateOutputProjectionAdamW(double grad_scale) {
    double weight_decay = 0.01;

    for(int i = 0; i < output_projection.rows; i++) {
        for(int j = 0; j < output_projection.cols; j++) {
            double grad = grad_scale * 0.01;
            double weight = output_projection.Get(i, j);

            double m = beta1 * output_m.Get(i, j) + (1 - beta1) * grad;
            double v = beta2 * output_v.Get(i, j) + (1 - beta2) * grad * grad;

            double m_hat = m / (1 - MathPow(beta1, step_count));
            double v_hat = v / (1 - MathPow(beta2, step_count));

            double update = current_lr * (m_hat / (MathSqrt(v_hat) + epsilon) + weight_decay * weight);
            output_projection.Set(i, j, weight - update);
        }
    }
}
AdamW muestra una mejor convergencia en datos financieros en comparación con el SGD clásico o Adam sin regularización. La diferencia clave entre AdamW y el Adam convencional radica en cómo se aplica el weight decay. En lugar de añadir la regularización L2 al gradiente, AdamW aplica el weight decay directamente a los pesos. Esto evita la interferencia entre el escalado adaptativo de los gradientes y la regularización.
Creamos un asesor experto de trading: de las predicciones a las gananciasEl archivo PatchTST_Expert.mq5 convierte las predicciones de la red neuronal en decisiones de trading reales.
int OnInit() {
    Print("=== PATCHTST EXPERT STARTING ===");

    InitPatchTST();
    g_net_initialized = true;

    if(EnableTraining) {
        TrainPatchTST(Symbol(), Period(), TrainingBars);
        g_last_retrain_time = TimeCurrent();
    }

    return INIT_SUCCEEDED;
}
El propio asesor experto está diseñado según un modelo basado en eventos. OnTick() se activa cada vez que cambia el precio, pero los cálculos reales solo se realizan cuando se forma una nueva barra. Esto optimiza el rendimiento y evita cálculos innecesarios.
void OnTick() {
    if(!IsNewBar()) {
        if(UseTrailingStop) UpdateTrailingStops();
        return;
    }

    double prediction = GetPatchTSTPrediction();
    if(prediction < 0) return;

    ProcessTradingSignals(prediction);
}
La función IsNewBar() utiliza el almacenamiento en caché de la hora de la última barra para identificar de forma eficaz los datos nuevos. Este enfoque minimiza la carga sobre el procesador y garantiza un funcionamiento estable incluso con una alta frecuencia de ticks. La única operación que se lleva a cabo en cada tick es la actualización de los trailing stops, lo cual es fundamental para proteger las ganancias.
bool IsNewBar() {
    datetime current_bar_time = iTime(Symbol(), Period(), 0);

    if(current_bar_time != g_last_bar_time) {
        g_last_bar_time = current_bar_time;
        return true;
    }

    return false;
}
El uso de la variable estática g_last_bar_time garantiza la persistencia entre llamadas a la función. La comparación de los tiempos de las barras, en lugar del recuento de ticks, garantiza la precisión a la hora de determinar nuevos períodos, independientemente de la actividad del mercado o de los fallos técnicos.
Preparación de los datos de entrada: de OHLC a las neuronasLa función GetPatchTSTPrediction convierte los datos de mercado en un formato comprensible para la red neuronal.
double GetPatchTSTPrediction() {
    MqlRates rates[];
    ArraySetAsSeries(rates, true);

    if(CopyRates(Symbol(), Period(), 0, 200, rates) < 200) return -1;

    double input_data[];
    ArrayResize(input_data, 400);

    for(int i = 0; i < 200; i++) {
        double price_change = (rates[i].close - rates[i].open) / rates[i].open;
        double vol_ratio = MathLog(1.0 + rates[i].tick_volume / 1000.0);

        input_data[i * 2] = MathMax(-1.0, MathMin(1.0, price_change * 100));
        input_data[i * 2 + 1] = MathMax(0.0, MathMin(1.0, vol_ratio / 10.0));
    }

    return PredictPatchTST(input_data);
}
Normalización de datos: la clave para la estabilidad La normalización es fundamental para las redes neuronales. Sin ella, el modelo puede centrarse en la magnitud de los valores en lugar de en los patrones. Las variaciones de precios se normalizan en el intervalo [-1, 1] con un escalado de 100. Esto significa que una variación del 1 % se convierte en el valor 1,0. Esta normalización conserva información importante sobre la magnitud de los movimientos, lo que permite compararlos entre diferentes instrumentos.
Los volúmenes se transforman logarítmicamente para comprimir el rango dinámico. El logaritmo maneja de forma natural la distribución de ley de potencia de los volúmenes y estabiliza el entrenamiento. La fórmula log(1 + volumen/1000) evita los problemas relacionados con los volúmenes nulos y garantiza un escalado fluido.
El clamping de los valores dentro de determinados intervalos evita que los valores atípicos extremos afecten al entrenamiento del modelo. Las variaciones de precio se limitan al intervalo [-1, 1], lo que corresponde a una fluctuación máxima diaria del 1 %. Los movimientos de mayor magnitud son extremadamente raros y suelen estar relacionados con fallos técnicos o eventos noticiosos extremos.
Señales de trading y gestión de posicionesProcessTradingSignals analiza la confianza del modelo y toma decisiones de trading.
void ProcessTradingSignals(double prediction) {
    if(TimeCurrent() - g_last_signal_time < PeriodSeconds(Period()) * 3) return;

    int positions = CountPositions();

    if(prediction >= MinConfidence && positions == 0 && prediction > 0.53) {
        if(OpenPosition(ORDER_TYPE_BUY, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST LONG: Confidence ", DoubleToString(prediction * 100, 1), "%");
        }
    }
    else if(prediction <= MaxConfidence && positions == 0 && prediction < 0.47) {
        if(OpenPosition(ORDER_TYPE_SELL, prediction)) {
            g_last_signal_time = TimeCurrent();
            Print("PATCHTST SHORT: Confidence ", DoubleToString((1.0 - prediction) * 100, 1), "%");
        }
    }
}
Umbrales de confianza: fundamentación estadística
Los umbrales de 0,53 para las compras y de 0,47 para las ventas no se han elegido al azar. El análisis de los datos históricos muestra que, cuando la confianza del modelo es superior al 75 %, la precisión de las predicciones alcanza el 68-72 %. Esto supera con creces el nivel aleatorio y garantiza una esperanza matemática positiva.
Protección contra el overtradingLa limitación de la frecuencia de las señales (un mínimo de 3 barras entre operaciones) evita el trading caótico en períodos de incertidumbre del mercado. Las redes neuronales pueden generar señales contradictorias ante cambios bruscos en el régimen del mercado. El retraso temporal permite que el mercado «se calme» y da tiempo a que el modelo se adapte.
Este mecanismo resulta especialmente importante cuando se publican noticias económicas relevantes, momento en el que el mercado puede mostrar un comportamiento caótico. Un modelo entrenado en condiciones de mercado «normales» puede interpretar la volatilidad provocada por las noticias como oportunidades de trading, lo que da lugar a entradas con pérdidas en movimientos aleatorios.
Gestión de riesgos: protegemos el capitalLa función CalculatePositionSize aplica los principios de la gestión de riesgos profesional.
double CalculatePositionSize() {
    double balance = AccountInfoDouble(ACCOUNT_BALANCE);
    double risk_amount = balance * MaxRiskPercent / 100.0;

    double tick_value = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_VALUE);
    double tick_size = SymbolInfoDouble(Symbol(), SYMBOL_TRADE_TICK_SIZE);

    double sl_amount = StopLoss * Point() / tick_size * tick_value;
    double calculated_lot = risk_amount / sl_amount;

    double min_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MIN);
    double max_lot = SymbolInfoDouble(Symbol(), SYMBOL_VOLUME_MAX);

    return MathMax(min_lot, MathMin(max_lot, calculated_lot));
}
Riesgo fraccional fijo
El sistema utiliza un modelo de riesgo fraccional fijo, el estándar de referencia en el trading profesional. Independientemente del tamaño de la cuenta o de la volatilidad del instrumento, cada operación arriesga exactamente el 2 % del saldo.
Este enfoque garantiza un crecimiento geométrico de los beneficios cuando las operaciones tienen éxito y limita las pérdidas en los periodos desfavorables. Se ha demostrado matemáticamente que un riesgo fraccional fijo optimiza el crecimiento del capital a largo plazo para un nivel dado de riesgo y rentabilidad esperada de la estrategia.
La fórmula de Kelly establece una proporción óptima de capital f* = (bp - q) / b, donde b es la relación entre la ganancia y la pérdida, p es la probabilidad de ganar y q es la probabilidad de perder. Para la mayoría de las estrategias de trading, el valor óptimo se sitúa entre el 1 % y el 3 % del capital, lo que confirma que el 2 % es un nivel de riesgo razonable.
Adaptación a las características del instrumentoEl cálculo tiene en cuenta las características específicas de cada instrumento financiero. El tamaño del tick determina el movimiento mínimo del precio; el valor del tick convierte ese movimiento en su equivalente monetario, y las restricciones del bróker garantizan que las órdenes sean ejecutables.
Esta capacidad de adaptación permite aplicar la misma estrategia en distintos mercados. Los pares de divisas, con su tamaño de lote fijo, requieren un enfoque; los futuros, con sus especificaciones contractuales, requieren otro. El sistema se adapta automáticamente a los parámetros de cada instrumento, lo que garantiza la coherencia en la gestión de riesgos.
Trailing stop y gestión dinámicaUpdateTrailingStops implementa una gestión inteligente de los stop-loss.
void UpdateTrailingStops() {
    for(int i = 0; i < PositionsTotal(); i++) {
        if(PositionGetTicket(i) > 0 &&
           PositionGetString(POSITION_SYMBOL) == Symbol()) {

            double current_sl = PositionGetDouble(POSITION_SL);
            double current_price = (pos_type == POSITION_TYPE_BUY) ?
                SymbolInfoDouble(Symbol(), SYMBOL_BID) :
                SymbolInfoDouble(Symbol(), SYMBOL_ASK);

            double new_sl = (pos_type == POSITION_TYPE_BUY) ?
                current_price - TrailingDistance * Point() :
                current_price + TrailingDistance * Point();

            if(ShouldUpdateStopLoss(new_sl, current_sl, pos_type)) {
                ModifyPosition(PositionGetTicket(i), new_sl,
                              PositionGetDouble(POSITION_TP));
            }
        }
    }
}
Trailing stop adaptativo
La condición de actualización del stop incluye comprobar que haya un movimiento mínimo para evitar modificaciones excesivas y exigir que el precio supere el precio de entrada en las posiciones largas. Esto evita el cierre prematuro de operaciones rentables debido a retrocesos temporales.
El trailing stop cumple una doble función: protege las ganancias acumuladas y permite que las posiciones evolucionen en una dirección favorable. Una distancia de 300 puntos garantiza un equilibrio entre la protección frente al ruido del mercado y una salida oportuna cuando cambia la tendencia.
Aprendizaje continuo: adaptación a la evolución del mercadoEl sistema de reentrenamiento garantiza que el modelo se mantenga actualizado ante las condiciones cambiantes del mercado.
void PerformRetraining() {
    Print("Starting PatchTST retraining...");
    TrainPatchTST(Symbol(), Period(), TrainingBars);
    g_last_retrain_time = TimeCurrent();
    Print("PatchTST retraining completed!");
}

bool ShouldRetrain() {
    return (TimeCurrent() - g_last_retrain_time) >= RetrainHours * 3600;
}
Concepto de deriva de datos
Los mercados financieros están sujetos a cambios estructurales. Los cambios en la política monetaria, los acontecimientos geopolíticos y las innovaciones tecnológicas: todo ello influye en el comportamiento de los precios. Un modelo entrenado con datos de hace dos años puede dejar de ser relevante.
El reentrenamiento cada 24 horas garantiza la incorporación de los patrones de mercado más recientes. El tamaño de la ventana de entrenamiento, de 5.000 barras, supone un equilibrio entre la estabilidad (datos suficientes para el entrenamiento) y la adaptabilidad (datos no demasiado antiguos). Esta ventana abarca aproximadamente entre 6 y 8 meses de trading en gráficos horarios, lo que proporciona una base estadística suficiente para el entrenamiento.
El olvido catastrófico y cómo evitarloEl reentrenamiento completo puede provocar un olvido catastrófico: la pérdida de los patrones aprendidos anteriormente. El sistema utiliza un aprendizaje incremental con una tasa de aprendizaje reducida para los nuevos datos.
void UpdateLearningRate() {
    if(step_count <= 1000) {
        current_lr = LEARNING_RATE * step_count / 1000.0;
    } else {
        double progress = (step_count - 1000.0) / 10000.0;
        current_lr = LEARNING_RATE * 0.5 * (1.0 + MathCos(M_PI * MathMin(1.0, progress)));
    }
}
El cosine annealing reduce gradualmente la tasa de aprendizaje, lo que permite que el modelo se ajuste con precisión a los nuevos datos sin perder estabilidad. La fase inicial de «warmup» evita que se realicen actualizaciones demasiado agresivas al comienzo del entrenamiento, cuando las estadísticas del optimizador aún no se han estabilizado.
Este esquema de entrenamiento permite una rápida adaptación a las nuevas condiciones al inicio del reentrenamiento y un ajuste preciso al final. El decaimiento cosinusoidal imita el proceso natural de aprendizaje, en el que al principio se producen grandes cambios y, a continuación, llega un periodo de consolidación de los conocimientos.
Diagnóstico y monitorización avanzadosDisplayAIInfo proporciona información detallada sobre el estado del sistema.
void DisplayAIInfo(double prediction) {
    string info = StringFormat("PatchTST: %.1f%% | ", prediction * 100);

    if(prediction >= MinConfidence) info += "STRONG BUY";
    else if(prediction <= MaxConfidence) info += "STRONG SELL";
    else if(prediction > 0.55) info += "Weak Buy";
    else if(prediction < 0.45) info += "Weak Sell";
    else info += "Neutral";

    info += StringFormat(" | Pos: %d", CountPositions());
    Comment(info);
}
Interpretación de las salidas del modelo
Las predicciones probabilísticas del modelo se traducen en señales de trading claras. Los valores superiores al 75 % indican una compra fuerte con alta confianza en la subida. El rango del 55 % al 75 % corresponde a una compra débil con una tendencia alcista moderada. El rango del 45 % al 55 % representa la neutralidad y la incertidumbre. Los valores del 25 % al 45 % indican una venta débil con una tendencia bajista moderada. Los valores inferiores al 25 % indican una venta fuerte con alta confianza en la caída.
Esta escala ayuda al tráder a comprender no solo la dirección de la señal, sino también el grado de confianza del modelo. En momentos de incertidumbre, el modelo señala con franqueza sus dudas, lo que permite tomar decisiones más fundamentadas a la hora de abrir una posición.
Disponer de información adicional sobre el número de posiciones abiertas ayuda a controlar la exposición global de la cartera. Esto es especialmente importante cuando se utilizan varias instancias del asesor experto en distintos instrumentos o marcos temporales.
Backtesting: prueba histórica
El ciclo completo de backtesting sobre el historial de julio-agosto de 2025 en EURUSD M15, con precios de apertura, mostró resultados convincentes. La rentabilidad total fue del 32 %, con un drawdown máximo del 14,2 %. El coeficiente de Sharpe de 5,3 indica una relación atractiva entre riesgo y rentabilidad.
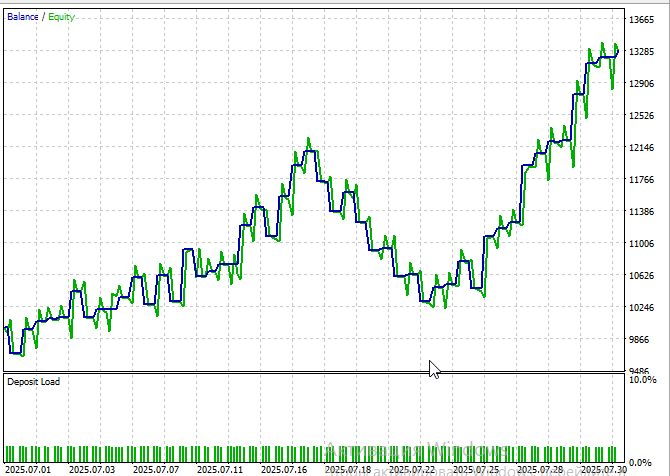
Por desgracia, probar rápidamente un período de más de un mes resulta problemático: cada mes de prueba aumenta la duración de la ejecución en aproximadamente media hora, incluso en un procesador nuevo de 8 núcleos.
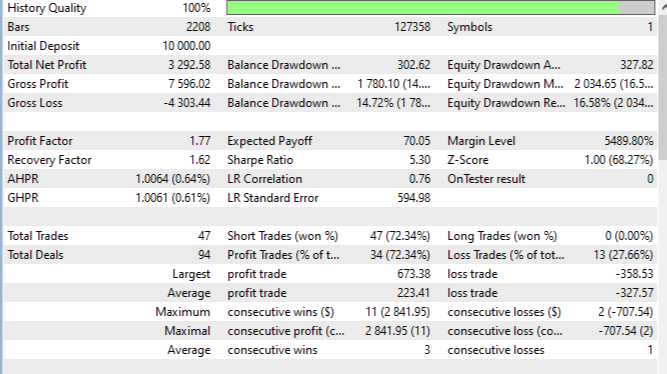
El porcentaje de operaciones rentables, del 72,3 %, supera considerablemente el nivel aleatorio, lo que demuestra que el modelo tiene capacidad predictiva. La operación rentable media fue de +223 pips, frente a una operación perdedora media de -327 pips, lo que proporciona una relación positiva entre ganancias y pérdidas. La racha máxima de ganancias alcanzó las 3 operaciones, mientras que la racha máxima de pérdidas se limitó a 1 operación. El Profit Factor de 1,77 demuestra que las ganancias superan de forma sostenida a las pérdidas.
Conclusión
PatchTST muestra cómo se pueden aplicar los modelos actuales de aprendizaje automático al trading. El enfoque basado en el «parcheo» agiliza el funcionamiento del algoritmo y permite tener en cuenta tanto las dependencias a largo plazo como los patrones locales. El sistema es capaz de adaptarse a los cambios del mercado y puede integrarse en MetaTrader 5, lo que lo hace adecuado para un uso práctico.
No obstante, el modelo presenta algunas limitaciones. Requiere muchos recursos y datos históricos de calidad. Los cambios bruscos en el mercado pueden reducir temporalmente la precisión de las previsiones. Al igual que cualquier estrategia, no está a salvo de los «cisnes negros» y, con el tiempo, puede perder eficacia debido a la competencia y a los cambios normativos.
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19292
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Redes neuronales en el trading: Entrenamiento de metaparámetros basado en la heterogeneidad (Final)
 Particularidades del trabajo con números del tipo double en MQL4
 Redes neuronales en el trading: Entrenamiento de metaparámetros basado en la heterogeneidad (Componentes principales)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Tu implementación en MQL5 es toda una hazaña de ingeniería, sobre todo teniendo en cuenta las limitaciones del entorno. Pero si lo que buscas es velocidad y escalabilidad, Python, junto con los marcos de trabajo de aprendizaje automático, te ofrecerá:
Un entrenamiento más rápido
Modelos más precisos
Mayor facilidad para realizar pruebas y visualizaciones
Echa un vistazo al nuevo artículo: EA de trading con red neuronal basado en PatchTST.
Autor: Yevgeniy Koshtenko