

交易中的神经网络:分解,而非扩大模型规模(结论)
 58
 0

引言
当今金融市场不只是买卖双方撮合交易的场所,而是一个复杂的动态生态系统:每次报价变动,都是上百个因素瞬时相互作用的结果。这里不存在普通意义上的纯粹随机:看似无序的表象之下蕴藏着规律,只不过这些规律以复杂的多层形式呈现。能否识别这类隐藏模式、预判其后续演化,直接决定交易者或者算法交易系统能否取得成功。在之前的文章中,我们已经介绍过SSCNN(空间 - 时序卷积神经网络)框架。此名称初看略显拗口,但其背后是一套自洽且精巧的思想:将空间依赖与时序依赖融合到统一的计算框架中。
SSCNN的核心在于将时间序列作为多维过程沿时间维度展开后的表达形式。每一个时间节点,不仅和过去、未来存在关联,同时还和并行结构相互耦合 —— 也就是各类内部特征空间,它们或同步变化、或存在时滞。
为捕捉这些关联关系,模型采用级联模块组提取局部形态特征,并搭配时序处理单元留存、累积上下文信息。其中的核心组件是基于注意力的归一化(Attention-based Normalization)模块:它融合注意力机制与归一化操作,让模型聚焦真正具备价值的数据片段,同时稳定训练过程。依托这套架构,SSCNN不仅可以在不同精细尺度上解析信号,还能够适应不断变化的数据结构。对于金融品种而言这点尤为关键,因为标的波动率不稳定、市场状态会持续切换。
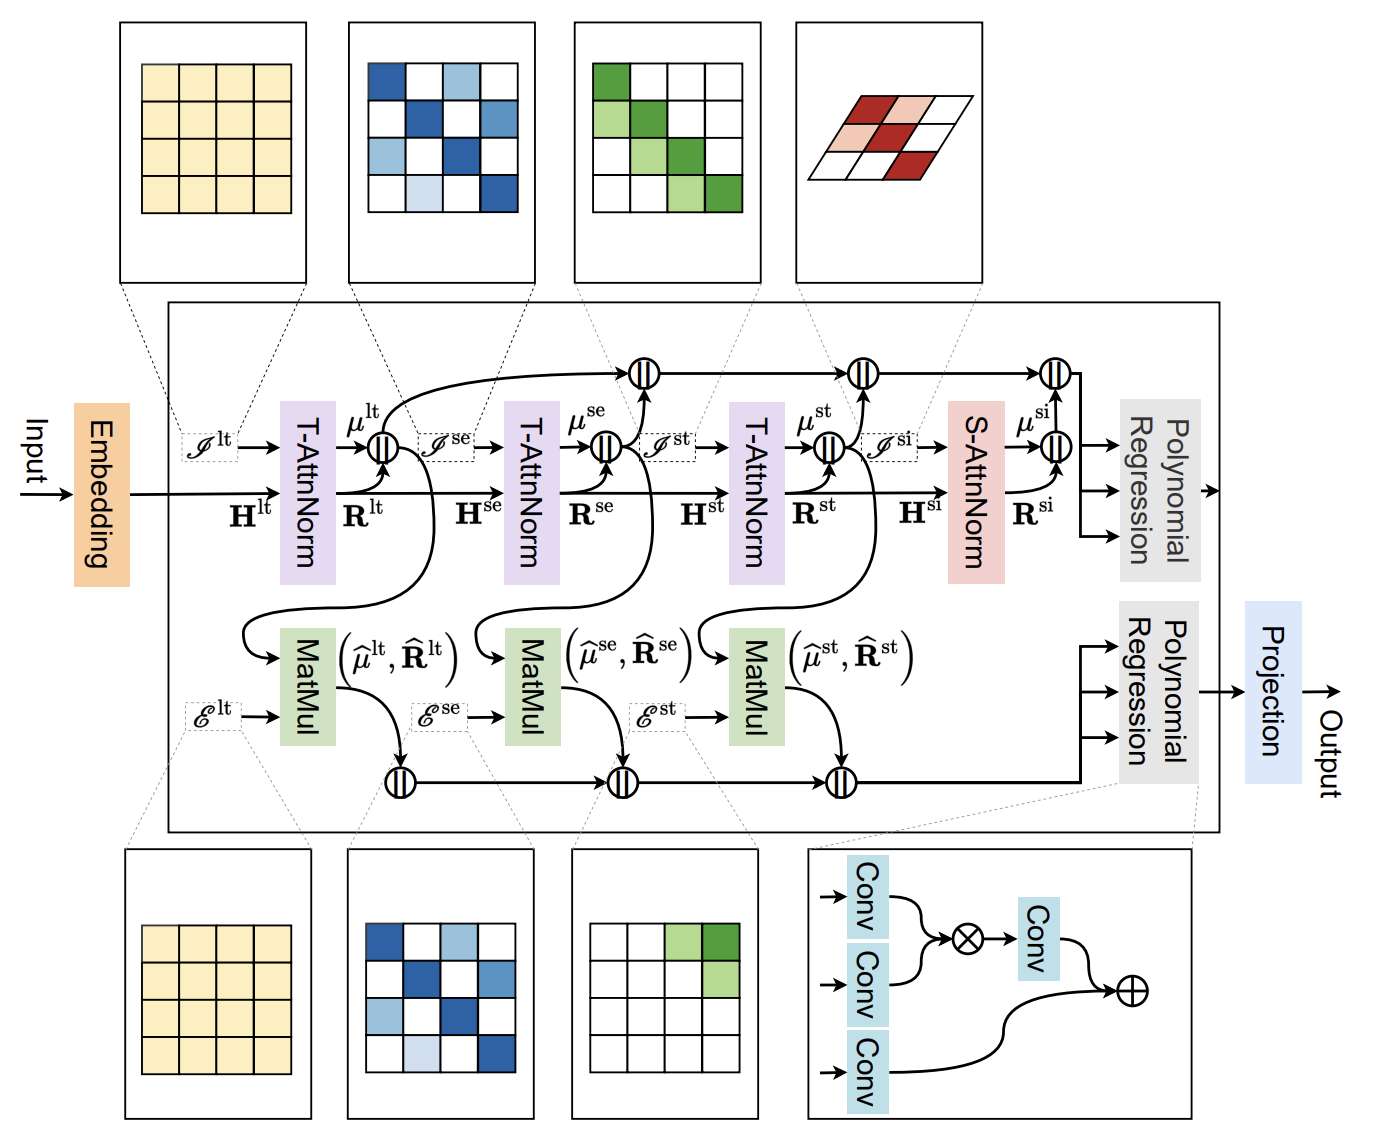
SSCNN的另一项重要优势是模块化。SSCNN架构具备良好的可扩展性,可以针对特定任务定制改造,无论是短期价格动量预测,还是长周期识别都适用。分层数据感知的设计赋予模型灵活性与稳健性:模型的每一层提取专属特征集,并传递给下一层。
在之前的文章中,我们已经详细讲解了上述思路的代码实现,以及如何在MQL5环境中完成集成,为搭建一套完整交易系统打下基础。
现在,我们来到最后阶段,将理论放入最严苛的场景下接受实战检验。我们会把各个独立组件整合为一套连贯的框架架构,评估SSCNN如何处理、解读行情数据。测试方案将尽可能贴近真实交易环境,验证这套实现方案的有效性。这一步的意义,不只是衡量预测精度或者模型稳定性;更重要的是理解算法对市场的感知深度、识别隐式结构、捕捉上下文切换的能力。归根结底,一套交易系统能否成功,并不取决于架构有多精巧,而是看它能否妥善应对噪声、突发脉冲以及行情中难以预判的转向。
编码器
在之前的文章中,我们已经搭建好了SSCNN架构的各个独立模块,本篇开始将它们组合为单个编码器(Encoder)。众多信息流(长期趋势、季节性模式、短期波动、空间关联)都在该节点完成精细分解、整理,投影至目标预测时域,最终融合成统一的预测表征。
CNeuronSSCNNEncoder类在代码层面实现了这一设计思想。它的任务并非简单串行调用一组模块,而是协调同步各个模块的运行:按照各自逻辑分离不同分量,外推至所需预测时域,预测对应的统计量;之后再将全部结果组装成信息丰富、结构化的表征,供给后续多项式回归使用。编码器统一管理数据流,在需要时对数据做转置,保障基于相位的运算正常执行;同时确保各个子模块输出的结果,以规定格式拼接至正确位置。类结构如下所示。
class CNeuronSSCNNEncoder   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronPeriodNorm       cLongNorm;
   CNeuronConvOCL          cLongExtrapolate;
   CNeuronTransposeOCL     cLongMeanSTDevTransp;
   CNeuronBaseOCL          cLongMeanExtrapolate;
   CNeuronTransposeVRCOCL  cSeasonTransp;
   CNeuronAttentNorm       cSeasonNorm;
   CNeuronTransposeVRCOCL  cUnSeasonTransp;
   CNeuronConvOCL          cSeasonExtrapolate;
   CNeuronConvOCL          cSeasonMeanExtrapolate;
   CNeuronAttentNorm       cShortNorm;
   CNeuronConvOCL          cShortExtrapolate;
   CNeuronConvOCL          cShortMeanExtrapolate;
   CNeuronSAttentNorm      cSpatialNorm;
   CNeuronConvOCL          cSpatialExtrapolate;
   CNeuronConvOCL          cSpatialMeanExtrapolate;
   CNeuronBaseOCL          cConcatenated;
   CNeuronTransposeOCL     cTranspose;
   CNeuronPolynomialRegression   cFusion;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSSCNNEncoder(void) {};
                    ~CNeuronSSCNNEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSSCNNEncoder; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { }
  };
编码器内部的处理链路经过精心排布。所有内部对象均采用静态声明,因此类的构造函数与析构函数为空,计算图的实际构建工作统一在Init方法中集中完成。
bool CNeuronSSCNNEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                               uint units_count, uint variables, uint forecast,
                               uint season_period, uint short_period,
                               ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, units_count + forecast,
                                variables, optimization_type, batch))
      return false;
   activation = None;
该方法的算法首先初始化父类CNeuronTransposeOCL,并向其传入待构建架构的基础参数。这一调用会搭建底层基础框架:分配全局缓冲区、设置张量尺寸、绑定OpenCL上下文。
请注意,结果张量的维度被指定为待分析序列长度与预测时域之和。由此可以看出,模块输出端希望同时得到经过清洗的原始数据,以及目标预测值,二者放在同一个可对比的表征结构中。
完成基础初始化后,会显式禁用当前层的激活函数(activation = None),因为编码器处理的是数值表征与统计量。
接下来,我们开始初始化内部子对象,首先初始化长周期分支 —— cLongNorm。此处会创建一个基于周期的归一化模块,用于提取序列中的稳定分量(趋势项)。
   int index = 0;
   if(!cLongNorm.Init(0, index, OpenCL, 1, units_count, iWindow, optimization, iBatch))
      return false;
之后初始化cLongExtrapolate,它是趋势外推模块,负责将长期分量延伸至预测时域。
   index++;
   if(!cLongExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1, optimization, iBatch))
      return false;
   cLongExtrapolate.SetActivationFunction(None);
需要指出的是,在原作者的实现方案里,是通过可训练参数矩阵E来完成数据外推。
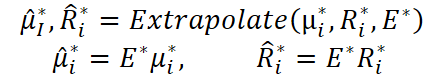
而在我们的实现中,选择采用无激活函数的卷积层来实现该功能。不带激活函数的卷积层本质上同样是线性算子,但在工程上具备额外优势:卷积支持参数共享(共享权重)、有硬件加速优化,并且天然适合刻画时序中常见的局部及准局部变换。
完成长期分量残差的外推之后,接下来需要对均值本身做外推。其中一个实现细节为CNeuronPeriodNorm输出的张量是以成对形式存储数值 —— 均值与方差。我们没有做显式拆分和拷贝数据,而是采用了一个简洁技巧:直接对张量做转置。
转置会重新排布数据,让流水线依次构建两条独立序列 —— 全部均值和全部方差,且均值序列在前。这样就可以直接把转置后的张量送入均值外推模块。简言之,我们利用内存中的元素排布顺序,以最小开销得到逻辑上相互独立的数据流。
   index++;
   if(!cLongMeanSTDevTransp.Init(0, index, OpenCL, iWindow, 2, optimization, iBatch))
      return false;
   if(!cLongMeanSTDevTransp.getGradient().Fill(0))
      return false;
   index++;
   if(!cLongMeanExtrapolate.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cLongExtrapolate.SetActivationFunction(None);
   if(!cLongMeanExtrapolate.getPrevOutput().Fill(1))
      return false;
但还有两个虽特殊却十分关键的细节需要提前处理。第一点是防止方差梯度被污染。由于我们的外推模块只处理均值,必须保证方差对应的梯度内存中不会混入随机值 —— 这类随机值会扰乱后续反向传播。实现上的处理方式简单可靠:在初始化阶段,将转置对象的梯度缓冲区清零。这会清除内存里残留的脏数据,避免无效值对σ²造成干扰。
第二点是均值本身的外推实现。在原始公式中,作者直接用得到的数值填充张量。而我们选择了工程效率更高的实现方式:采用最简形式的外积来生成目标填充张量。取一个维度为 N×1的均值列向量µ ,与维度为1×M的全1行向量相乘。输出是N×M的矩阵,矩阵每一行都是对应µi的副本。该方法无需显式循环,就能完成向指定尺寸张量的数据填充。它的实用优势非常明显:属于线性运算,可以在GPU上轻松并行化、内存开销低,并且很容易用OpenCL实现。
最终,这套均值外推机制代码简洁、开销低,逻辑清晰且便于高效部署。它保留了原作者方案的核心思想(沿时间方向做线性投影),同时更加节省资源,适配OpenCL并行计算。
随后是季节性分支。首先通过cSeasonTransp对象配置按周期转置:借助season_period参数,把数据按照单个周期内的相位分组。这一步可以简化后续同相位数据的选取,并且能够接入带注意力系数的通用归一化模块CNeuronAttentNorm。
   index++;
   if(!cSeasonTransp.Init(0, index, OpenCL, iWindow, units_count / season_period, season_period,
                                                                          optimization, iBatch))
      return false;
   index++;
   if(!cSeasonNorm.Init(0, index, OpenCL, season_period, cSeasonTransp.GetCount(), iWindow,
                                                                          optimization, iBatch))
      return false;
   index++;
   if(!cUnSeasonTransp.Init(0, index, OpenCL, iWindow, season_period, cSeasonTransp.GetCount(),
                                                                          optimization, iBatch))
      return false;
cSeasonNorm对象用于提取季节性分量,并对残差做归一化;而cUnSeasonTransp会在外推之前,将数据恢复至原始排布方向。季节性分量的外推运算,由cSeasonExtrapolate和cSeasonMeanExtrapolate两个对象直接完成。
   index++;
   if(!cSeasonExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1,
                                                                                optimization, iBatch))
      return false;
   cSeasonExtrapolate.SetActivationFunction(None);
   index++;
   if(!cSeasonMeanExtrapolate.Init(0, index, OpenCL, season_period, season_period, iCount, iWindow, 1,
                                                                                optimization, iBatch))
      return false;
   cSeasonMeanExtrapolate.SetActivationFunction(None);
短期分支由一组结构相似的模块构成,但不再对数据执行转置操作。cShortNorm对象用于提取short_period窗口内的局部快速波动分量;cShortExtrapolate负责生成该分量的预测;cShortMeanExtrapolate则对短期层的统计量做预测。请注意,在均值外推对象的初始化参数中,我们调用cShortNorm.GetUnits()来对齐数据格式,保证后续模块可以正常接收归一化器的输出作为输入。
   index++;
   if(!cShortNorm.Init(0, index, OpenCL, units_count / short_period, short_period, iWindow, optimization, iBatch))
      return false;
   index++;
   if(!cShortExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1, optimization, iBatch))
      return false;
   cShortExtrapolate.SetActivationFunction(None);
   index++;
   if(!cShortMeanExtrapolate.Init(0, index, OpenCL, cShortNorm.GetUnits(), cShortNorm.GetUnits(), iCount, iWindow,
                                                                                          1, optimization, iBatch))
      return false;
   cShortMeanExtrapolate.SetActivationFunction(None);
   index++;
接下来,初始化空间分支:cSpatialNorm是一个S-AttnNorm(空间注意力归一化)模块,用于在各个特征的单变量序列之间识别具备空间一致性的模式。
   if(!cSpatialNorm.Init(0, index, OpenCL, units_count, variables, optimization, iBatch))
      return false;
   index++;
   if(!cSpatialExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1,
                                                                             optimization, iBatch))
      return false;
   cSpatialExtrapolate.SetActivationFunction(None);
   index++;
   if(!cSpatialMeanExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, 1, iWindow,
                                                                             optimization, iBatch))
      return false;
   cSpatialMeanExtrapolate.SetActivationFunction(None);
   index++;
之后初始化cSpatialExtrapolate与cSpatialMeanExtrapolate,用于在指定预测时域上对空间分量及其统计量做预测。
所有预测分量和对应的统计量会拼接为单一张量cConcatenated。这里,我们将张量维度显式乘以 8:每个分支的输出都由分量 + 统计量成对组成(Rlt、μlt、Rse、μse、Rst、μst、Rsi、μsi),也就是每个单元一共包含8路信息流。
   if(!cConcatenated.Init(0, index, OpenCL, 8 * Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cTranspose.Init(0, index, OpenCL, 8 * iWindow, iCount, optimization, iBatch))
      return false;
得到的宽张量随后经由cTranspose模块转置,把数据转换为最终融合层所要求的格式。
初始化的最后一步是cFusion,也就是多项式回归融合模块。它接收规模为8*iWindow的组合特征集作为输入,并为每个时间步输出长度等于iWindow、经过压缩但信息保留充分的表征。各分量之间相乘效应与相加效应的组合逻辑,正是在这一模块实现的。
   index++;
   if(!cFusion.Init(0, index, OpenCL, iCount, 8 * iWindow, iWindow, optimization, iBatch))
      return false;
//---
   return true;
  }
每一个阶段都会检查对象的初始化流程;一旦出现错误,该方法就返回false。这种防御式编程机制可以在遇到异常时立刻终止编码器的组装过程。如果所有模块都成功创建并配置完毕,方法返回true,代表编码器已经就绪,可以投入运算。
完成对象结构的初始化之后,我们在feedForward方法中搭建编码器的前向传播链路:按正确时序调用各个模块,并将流程控制权移交至下一个模块。该方法按分步逻辑组织,对应四大分量的处理流程:长期分量、季节性分量、短期分量以及空间分量;之后将它们合并为单个特征向量,送入多项式融合阶段。这一点在代码中清晰可见:每一步都会调用对应模块的FeedForward,校验执行结果,再继续往下执行 —— 任意环节出错,函数直接返回false,整条链路中止。
bool CNeuronSSCNNEncoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
//--- Long
   if(!cLongNorm.FeedForward(NeuronOCL))
      return false;
   if(!cLongExtrapolate.FeedForward(cLongNorm.AsObject()))
      return false;
   if(!cLongMeanSTDevTransp.FeedForward(cLongNorm.GetMeanSTDevs()))
      return false;
   if(!MatMul(cLongMeanSTDevTransp.getOutput(), cLongMeanExtrapolate.getPrevOutput(),
              cLongMeanExtrapolate.getOutput(), 1, 1, iCount, iWindow, true))
      return false;
首先运行长期分支。调用cLongNorm.FeedForward计算待分析数据经过归一化后的长期分量;这一步属于预处理,将趋势与局部扰动分离开。随后调用cLongExtrapolate.FeedForward,接收归一化结果,在目标预测时域上对长期分量的残差进行预测。需要重点指出的是,该模块的输入数据已经由cLongNorm完成结构化整理。
随后需要对统计量(均值与标准差)进行外推。为此,先对统计张量cLongMeanSTDevTransp执行转置,把均值序列和方差序列分开分组(前面已经介绍过这项转置技巧)。之后执行矩阵乘法。本质上,我们是借助一个行向量,将转置后的统计量投影为所需格式。该实现方式可以让均值在整个预测时域上完成复制扩展,且不会产生多余的数据拷贝。
接下来启动季节性分支。首先,由cSeasonTransp按照周期相位对输入数据转置,为面向相位的归一化做好准备。
//--- Season
   if(!cSeasonTransp.FeedForward(cLongNorm.AsObject()))
      return false;
   if(!cSeasonNorm.FeedForward(cSeasonTransp.AsObject()))
      return false;
   if(!cUnSeasonTransp.FeedForward(cSeasonNorm.AsObject()))
      return false;
   if(!cSeasonExtrapolate.FeedForward(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonMeanExtrapolate.FeedForward(cSeasonNorm.GetMeans()))
      return false;
随后,cSeasonNorm执行基于周期的注意力归一化,识别关键相位位置。逆转置操作cUnSeasonTransp将数据恢复为原始形态,准备开展外推。之后,cSeasonExtrapolate接收还原后的季节性残差并对其预测,而cSeasonMeanExtrapolate则对归一化模块输出的季节性分量均值进行外推。
短期分支的处理流程与之类似:
- cShortNorm接收已经剔除季节成分的数据,提取局部快速波动分量;
- cShortExtrapolate对这些短期残差进行预测;
- cShortMeanExtrapolate生成对应统计量的预测。
//--- Short
   if(!cShortNorm.FeedForward(cUnSeasonTransp.AsObject()))
      return false;
   if(!cShortExtrapolate.FeedForward(cShortNorm.AsObject()))
      return false;
   if(!cShortMeanExtrapolate.FeedForward(cShortNorm.GetMeans()))
      return false;
请注意,将季节性分支的输出送入短期分支是有意为之的设计:先剥离大周期分量,再捕捉局部脉冲异动。
接下来是空间分支。cSpatialNorm 模块在单个时间切片内分析多组时间序列,识别具备空间相干性的结构。cSpatialExtrapolate和cSpatialMeanExtrapolate分别对空间残差及其统计量进行预测。
//--- Spatial
   if(!cSpatialNorm.FeedForward(cShortNorm.AsObject()))
      return false;
   if(!cSpatialExtrapolate.FeedForward(cSpatialNorm.AsObject()))
      return false;
   if(!cSpatialMeanExtrapolate.FeedForward(cSpatialNorm.GetMeans()))
      return false;
该处理顺序保证空间归一化模块所接收的局部效应,已经剔除了趋势与季节性的影响。
所有分支都完成预测输出后,就开始精细的特征组装流程。第一次调用Concat方法,将长期分支与季节性分支经过外推得到的残差、均值合并为一个宽缓冲区。
//--- Concat
   if(!Concat(cLongExtrapolate.getOutput(), cLongMeanExtrapolate.getOutput(),
              cSeasonExtrapolate.getOutput(), cSeasonMeanExtrapolate.getOutput(),
              cConcatenated.getOutput(), iCount, iCount, iCount, iCount, iWindow))
      return false;
   if(!Concat(cConcatenated.getOutput(), cShortExtrapolate.getOutput(),
              cShortMeanExtrapolate.getOutput(), cConcatenated.getPrevOutput(),
              4 * iCount, iCount, iCount, iWindow))
      return false;
   if(!Concat(cConcatenated.getPrevOutput(), cSpatialExtrapolate.getOutput(),
              cSpatialMeanExtrapolate.getOutput(), cConcatenated.getOutput(),
              6 * iCount, iCount, iCount, iWindow))
      return false;
现在第二次调用Concat,并入短期分支数据,对已拼接的张量做扩充。第三次调用拼接方法,再将空间分量追加至结果中。
最后,进入融合阶段。首先,通过cTranspose将这份宽张量转换为适配多项式回归器的格式:也就是对特征维度和时间步维度进行置换,让数据结构便于后续聚合运算。再由cFusion模块执行多项式融合:该模块包含加法通路与乘法通路,输出简洁且信息完备的预测表征。
//--- Fusion
   if(!cTranspose.FeedForward(cConcatenated.AsObject()))
      return false;
   if(!cFusion.FeedForward(cTranspose.AsObject()))
      return false;
//---
   return CNeuronTransposeOCL::feedForward(cFusion.AsObject());
  }
前向传播算法的最后一步,调用父类CNeuronTransposeOCL的同名方法,将结果张量转换为一组单特征序列,供给模型后续神经网络层处理。
每一步代码都会严格校验运算结果。这不只是走个流程,而是刻意设计的保护机制:一旦出现异常、缓冲区分配失败或者格式非法,程序会立刻终止执行。这既便于调试,也保障模型在实盘环境下安全运行。
从架构角度来看,调用顺序体现了自底向上的思路:先提取、外推粗粒度、稳定的分量;再依次处理更高分辨率的分量;之后挖掘空间关联;最后在融合模块中把所有分量审慎整合。这种设计便于追踪错误,每个模块都具备明确语义,支持分步校验质量,从趋势分量一直到局部脉冲异动都可以逐一验证。
如果把前向传播函数比作一场剧本,我们按顺序让各个角色依次登台表演。那么在这个场景中,calcInputGradients就是演出结束后的环节:需要仔细拆解道具、整理导演记录,把误差信号回传给每一个模块,让各个模块据此调整自身参数。
bool CNeuronSSCNNEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
在该方法内部,首先检查源数据对象NeuronOCL的指针是否有效。这是一项简单但必不可少的防护逻辑:如果指针无效,梯度就没有回传的目标位置,因此出错时会稳妥退出。
之后进入融合阶段。因为前向传播的最后一步是多项式融合与张量转置,反向传播需要逆序执行,先将梯度经由这两个模块反向回传。
//--- Fusion
   if(!CNeuronTransposeOCL::calcInputGradients(cFusion.AsObject()))
      return false;
   if(!cTranspose.CalcHiddenGradients(cFusion.AsObject()))
      return false;
   if(!cConcatenated.CalcHiddenGradients(cTranspose.AsObject()))
      return false;
我们调用父类CNeuronTransposeOCL的同名方法,将外部上下文传来的误差送入多项式回归模块。随后,把梯度向下传递给转置对象cTranspose。最后,将得到的梯度值传给宽张量对象cConcatenated,该张量存放所有分量拼接后的结果。
接下来,需要逐步解包各个分量的梯度贡献,也就是分步执行解拼接(DeConcat),把合并后的总梯度拆分为各个子分量对应的梯度。
//--- DeConcat
   if(!DeConcat(cConcatenated.getPrevOutput(), cSpatialExtrapolate.getGradient(),
                cSpatialMeanExtrapolate.getGradient(), cConcatenated.getGradient(),
                6 * iCount, iCount, iCount, iWindow))
      return false;
   if(!DeConcat(cConcatenated.getGradient(), cShortExtrapolate.getGradient(),
                cShortMeanExtrapolate.getGradient(), cConcatenated.getPrevOutput(),
                4 * iCount, iCount, iCount, iWindow))
      return false;
   if(!DeConcat(cLongExtrapolate.getGradient(), cLongMeanExtrapolate.getGradient(),
                cSeasonExtrapolate.getGradient(), cSeasonMeanExtrapolate.getGradient(),
                cConcatenated.getGradient(), iCount, iCount, iCount, iCount, iWindow))
      return false;
首先,我们从cConcatenated中提取空间分支(cSpatialExtrapolate和cSpatialMeanExtrapolate)对应的梯度。随后两次调用DeConcat方法,解析短期、季节性、长期分量的梯度。本质上就是把这一块宽缓冲区里的总梯度分配给各个接收模块:每个模块拿到的,正是它在前向传播过程中所产生那部分对应的梯度。
接下来沿着各个分支依次反向传播梯度,传播顺序和前向构建顺序相反。对于空间分支,先传递统计量的梯度 —— 把空间分量均值预测模块的误差回传给负责计算该均值的归一化模块。
//--- Spatial
   if(!cSpatialNorm.GetMeans().CalcHiddenGradients(cSpatialMeanExtrapolate.AsObject()))
      return false;
   if(!cSpatialNorm.CalcHiddenGradients(cSpatialExtrapolate.AsObject()))
      return false;
cSpatialNorm.CalcHiddenGradients方法计算主空间分支的梯度,并准备向下传递。
短期分支的处理需要留意:首先通过cShortNorm.CalcHiddenGradients,将来自空间归一化的梯度传递给短期效应归一化器。
//--- Short
   if(!cShortNorm.CalcHiddenGradients(cSpatialNorm.AsObject()))
      return false;
   CBufferFloat* temp = cShortNorm.getGradient();
   if(!cShortNorm.SetGradient(cShortNorm.getPrevOutput(), false) ||
      !cShortNorm.CalcHiddenGradients(cShortExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cShortNorm.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cShortNorm.SetGradient(temp, false))
      return false;
   if(!cShortNorm.GetMeans().CalcHiddenGradients(cShortMeanExtrapolate.AsObject()))
      return false;
接下来,我们需要获取数据外推模块输出的误差梯度。为避免之前算出的梯度值丢失,我们把误差梯度缓冲区的当前指针存入局部变量temp。此处用到一个巧妙技巧:先用一个同等大小的空闲对象临时替换归一化器当前的梯度缓冲区指针。再计算外推模块对应的梯度。完成之后,将两路信息流的梯度数值相加,并把缓冲区指针恢复至原来状态。在短期分量的误差梯度分发逻辑末尾,把短期分支均值预测模块产生的误差回传给生成这些均值的上游链路。
季节性分支的处理流程与之相近,但额外增加一步转置操作。
//--- Season
   if(!cUnSeasonTransp.CalcHiddenGradients(cShortNorm.AsObject()))
      return false;
   temp = cUnSeasonTransp.getGradient();
   if(!cUnSeasonTransp.SetGradient(cUnSeasonTransp.getPrevOutput(), false) ||
      !cUnSeasonTransp.CalcHiddenGradients(cSeasonExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cUnSeasonTransp.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cUnSeasonTransp.SetGradient(temp, false))
      return false;
   if(!cSeasonNorm.GetMeans().CalcHiddenGradients(cSeasonMeanExtrapolate.AsObject()))
      return false;
   if(!cSeasonNorm.CalcHiddenGradients(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonTransp.CalcHiddenGradients(cSeasonNorm.AsObject()))
      return false;
首先,cUnSeasonTransp.CalcHiddenGradients将来自短期归一化模块的梯度回传给逆转置模块。这里再次使用临时缓冲区技巧:将梯度缓冲区存入temp,切换为空闲缓冲区,执行CalcHiddenGradients,累加计算结果,再写回cUnSeasonTransp中。这样保证各分量梯度能够被正确累加,同时完成量级对齐。
接着,将误差向下传递至季节性归一化器,并执行逆转置,也就是恢复为从长期归一化模块输出时的数据格式。
长期分支是整个流程中最精细复杂的部分 —— 针对统计量矩阵乘法的反向运算。在MatMulGrad方法中,执行和前向传播向量乘法对应的反向运算:计算cLongMeanExtrapolate对转置缓冲区cLongMeanSTDevTransp的误差贡献。本质上是结合均值外推时用到的复制扩展结构,完成梯度在各个均值分量上的分配。最后将得到的梯度送入归一化模块。
//--- Long
   if(!MatMulGrad(cLongMeanSTDevTransp.getOutput(), cLongMeanSTDevTransp.getGradient(),
                  cLongMeanExtrapolate.getPrevOutput(), cLongMeanExtrapolate.getGradient(),
                  cLongMeanExtrapolate.getGradient(), 1, 1, iCount, iWindow, true))
      return false;
   if(!cLongNorm.GetMeanSTDevs().CalcHiddenGradients(cLongMeanSTDevTransp.AsObject()))
      return false;
   if(!cLongNorm.CalcHiddenGradients(cSeasonTransp.AsObject()))
      return false;
   temp = cLongNorm.getGradient();
   if(!cLongNorm.SetGradient(cLongNorm.getPrevOutput(), false) ||
      !cLongNorm.CalcHiddenGradients(cLongExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cLongNorm.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cLongNorm.SetGradient(temp, false))
      return false;
之后,cLongNorm.CalcHiddenGradients将来自季节性转置链路的累加梯度回传给长期归一化器,我们会再次使用临时缓冲区技巧。这样可以保证长期分量残差外推模块以及其他依赖模块的梯度贡献能够累加,不会丢失任何中间计算结果。
至此,整条反向传播链路将梯度传递给上一层(NeuronOCL)。这是误差信号自然的出口:经过全部内部重算之后,编码器向计算图里的上一个节点输出格式正确的梯度贡献。
//---
   if(!NeuronOCL.CalcHiddenGradients(cLongNorm.AsObject()))
      return false;
//---
   return true;
  }
该方法内的所有调用都包裹了结果校验。这不只是为了可靠性,更是快速失败(fail‑fast)策略:尽早捕获异常,避免缓冲区产生隐蔽的不一致问题,因为这类问题后续很难排查。本方法中反复用到几项关键技术,值得重点留意:
- 使用临时数据缓冲区累加局部梯度;
- 切换当前激活的梯度缓冲区,防止数据丢失;
- 调用SumAndNormilize,在窗口维度上正确聚合各分量贡献
总结:该方法严格按照前向传播的逆序执行,对拼接缓冲区解包,向各个分支分发梯度;借助临时缓冲区与归一化操作叠加多路梯度贡献,最终将误差回传到上一层。这套流程保证每个模块收到的梯度都由其自身产生,使得训练过程里整体参数更新逻辑自洽、稳定收敛。
梯度收集完成并分发至编码器所有分支后,进入最后阶段 —— 对可训练参数执行更新。在我们的代码中,该过程就是依次调用各个内部组件的同名更新方法:每个模块负责用累加得到的梯度更新自身权重。
bool CNeuronSSCNNEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
//--- Long
   if(!cLongNorm.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cLongExtrapolate.UpdateInputWeights(cLongNorm.AsObject()))
      return false;
//--- Season
   if(!cSeasonNorm.UpdateInputWeights(cSeasonTransp.AsObject()))
      return false;
   if(!cSeasonExtrapolate.UpdateInputWeights(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonMeanExtrapolate.UpdateInputWeights(cSeasonNorm.GetMeans()))
      return false;
//--- Short
   if(!cShortNorm.UpdateInputWeights(cUnSeasonTransp.AsObject()))
      return false;
   if(!cShortExtrapolate.UpdateInputWeights(cShortNorm.AsObject()))
      return false;
   if(!cShortMeanExtrapolate.UpdateInputWeights(cShortNorm.GetMeans()))
      return false;
//--- Spatial
   if(!cSpatialNorm.UpdateInputWeights(cShortNorm.AsObject()))
      return false;
   if(!cSpatialExtrapolate.UpdateInputWeights(cSpatialNorm.AsObject()))
      return false;
   if(!cSpatialMeanExtrapolate.UpdateInputWeights(cSpatialNorm.GetMeans()))
      return false;
//--- Fusion
   if(!cFusion.UpdateInputWeights(cTranspose.AsObject()))
      return false;
//---
   return true;
  }
归根结底,updateInputWeights方法是一个简洁而高效的调度器:它仅遍历组件列表,将权重更新的职责委派给每一个子组件,同时仔细收集各组件的执行状态。该方法保留了模块化特性,便于测试,也方便架构扩展:当新增可训练组件时,只需要在这条链路的合适位置插入对应的更新调用即可。
至此,我们对编码器搭建逻辑的详细讲解告一段落。CNeuronSSCNNEncoder类及其全部方法的完整源码放在附件中,可以作为实现或二次修改的参考。
顶层对象
SSCNN框架最初的设计思路是由一串编码器组合而成;每经过一个编码器,分析深度就进一步提升,特征抽象层级也随之提高。在实际应用中,这套结构可以先做对齐并提取显性分量(趋势、季节性、局部脉冲),之后再逐步处理信息量更丰富、经过压缩的表征,从中挖掘细微的关联关系。为了管控这一处理序列,我们引入顶层对象CNeuronSSCNN,该类继承自 CNeuronSCNN。
该类承担调度器的角色:它封装一组编码器,管理编码器之间的张量数据流,处理尺寸与格式对齐,并保证整条链路的前向传播与反向传播能够正确执行。
class CNeuronSSCNN    :  public   CNeuronSCNN
  {
protected:
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSSCNN(void) {};
                    ~CNeuronSSCNN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period, uint layers,
                          ENUM_OPTIMIZATION optimization_type, uint batch) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSSCNN; }
  };
值得注意的是,CNeuronSSCNN的运行逻辑完全遵循从父类继承而来的规则:我们并没有创造新算法,只是明确指定在这套新配置里要使用哪些编码器。重新定义这个类纯粹出于工程上的实用考量:我们需要固定特定的编码器类型及其参数,以此逐层串行搭建多级结构。在新增的方法中,我们只做针对性改动:替换所使用编码器的类型与数据格式,而不改动底层计算逻辑本身。因此,之前已经讲解过的算法无需重复详述,它们的实现方式保持不变。该类及其全部方法的完整源码见附件。
训练模型
简要介绍一下模型的训练流程。我们采用两阶段训练策略:首先是高强度离线训练,之后在运行模式下开展精细的在线微调。为加快离线训练阶段速度,我们特意简化了环境状态编码器里的环境状态表征,并且跳过辅助预测模块的训练;这能大幅缩短准备耗时,但会降低初始表征的表达能力。训练逻辑在Train方法中实现。
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
首先,该方法计算训练窗口的起始与结束索引,然后从交易终端加载历史数据。这是标准的数据准备流程:我们需要原始价格与时间戳,作为后续所有特征与样本的基础。
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
这段代码用于校验指标缓冲区是否成功完成扩容。只要任意一个缓冲区分配失败,程序就会打印调试信息并调用ExpertRemove终止EA,避免其在状态不一致的情况下继续运行。
之后进入循环,等待指标计算完成。我们会在限定迭代次数内轮询,判断指标是否已经计算完毕。这是为了应对数据尚未就绪的场景:不会拿着不完整的数据直接开始训练,而是给系统一段等待时间,但不会无限等待。如果超出迭代上限,则打印提示信息并终止运行。
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
之后,我们调用Refresh方法刷新指标,并将Rates数组设置为序列模式,这样就可以按照历史数据的常规顺序通过索引访问数据。接下来,调整可用K线的数量。这里要考虑到,每一条训练样本都需要前置HistoryBars个历史数据,还要预留出预测长度NForecast的余量。如果计算结果小于0,代表数据量不足,程序终止运行。
然后初始化工作向量与早停标记。同时记录当前时间,用于定时刷新UI以及运行时长监控。
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
主训练循环按轮次(epoch)迭代执行。循环持续运行,直到达到最大轮次上限、触发外部停止信号IsStopped,或是因内部错误置位Stop标识。每一轮开始时,都会清空编码器的内部状态。
   for(int epoch = 0; (epoch < Epochs && !IsStopped() && !Stop); epoch ++)
     {
      if(!cEncoder.Clear())
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
在单个轮次内部,会遍历各个采样位置posit,从起始边界向结束边界依次迭代。对每一个位置,首先调用CreateBuffers准备输入数据,生成状态(State)缓冲区和时间(Time)缓冲区,供网络使用。之后,我们构建账户状态向量,并生成基准动作标签。
for(int posit = start - HistoryBars - NForecast - 1; posit >= end; posit--)
  {
   if(!CreateBuffers(posit, GetPointer(bState), GetPointer(bTime), Result))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
   const vector<float> target_action = OraculAction(account, Result);
   if(!bAccount.AssignArray(account))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
我们采用混合学习方式,既基于奖励信号训练,也基于由未来数据构造的参考轨迹训练。
现在执行前向传播。首先,由环境状态编码器构建当前市场状态的表征。
   //--- Feed Forward
   if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
随后由Actor(行动者)输出智能体的动作。Critic(评估器)用于评估在当前状态下该动作的优劣。
   if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
所有函数调用都带有校验防护:一旦发生错误,程序会立刻中止并置位Stop标识。
Study代码块是基于奖励更新的核心步骤。我们获取智能体输出的动作,并计算奖励值。一个值得留意的细节:如果奖励为负值,会将其乘以2,也就是加大对错误决策的惩罚力度。这种放大机制可以加快模型从负样本中学习的速度,但使用时需要谨慎:惩罚强度过高会造成训练不稳定。
//--- Study
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(reward < 0)
   reward *= 2;
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
接下来依次执行反向传播:先对Critic进行反向传播,再将梯度传递给Encoder,最后传递给Actor。这是经典的Actor-Critic架构:Critic根据价值估计误差完成更新,随后将信号传递给Actor与Encoder。这里必须严格遵守顺序:Critic → Encoder → Actor,才能让梯度在共享计算图中正确传递。
然后进入Oracul(基准引导)阶段,即基于参考轨迹开展训练。我们再次对Encoder和Actor执行前向传播 —— 由于参数刚刚更新过,即使输入相同的市场状态,输出也可能发生变化。
//--- Oracul
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Action.AssignArray(target_action))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
随后,我们用基准动作替换智能体的动作,并计算其对应的奖励。再对Actor执行反向传播 —— 也就是训练它去模仿参考轨迹。
if(!cActor.backProp(Action, GetPointer(cEncoder), LatentLayer))
   {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.feedForward(Action, 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
//---
if(GetTickCount() - ticks > 500)
  {
   double percent = (epoch + 1.0 - double(posit - end) / (start - end - HistoryBars - NForecast)) /
                                                                                    Epochs * 100.0;
   string str = "";
   str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                                    cActor.getRecentAverageError());
   str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                                   cCritic.getRecentAverageError());
   Comment(str);
   ticks = GetTickCount();
  }
 }
}
接下来,我们基于基准动作运行Critic,执行前向传播与反向传播。之后再次优化编码器的参数。因此,每一步都会先从自身交互经验中学习(强化学习),再向着基准轨迹调整策略(监督学习)。该方式通常可以让收敛更加稳定且速度更快。
循环运行期间,大约每500毫秒生成一条状态信息字符串,包含训练进度百分比以及Actor和Critic当前的误差值。该机制用于向用户实时展示训练进展。
全部训练轮次结束后,清空图表注释,向终端日志输出最终指标,随后安全退出程序。
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor", cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic", cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
离线训练程序的完整源码已放入附件中。附件里同时包含撰写本文所用到的全部程序源码,以及可训练模型的架构;这套模型架构沿用了之前研究的成果,几乎没有改动。在编码器架构内,我们仅更换了编码器主层的类型。
测试
如之前所述,训练流程分为前后衔接的两个阶段。第一阶段为离线训练:使用2024年全年的EURUSD(欧元兑美元)货币对在H1(1小时)历史K线数据训练模型。该时间段覆盖了丰富多样的市场状况 —— 既有平稳震荡阶段,也包含剧烈脉冲行情,能够让模型学习常规形态与罕见极端走势。
第二阶段,在高度贴近真实市场的环境下开展在线微调。训练在MetaTrader 5策略测试器中进行,模型按顺序接收流式行情K线数据。该模式可以检验模型对噪声与数据畸变的鲁棒性,并且让模型能够在市场环境发生切换时自适应调整策略。
最后,我们使用全新的数据集对模型进行测试:数据区间为2025年1月至3月的报价。测试过程中所有参数与配置均保持不变。本次测试结果能够客观反映该方案的预测精度与实际可靠性。测试结果呈现如下。
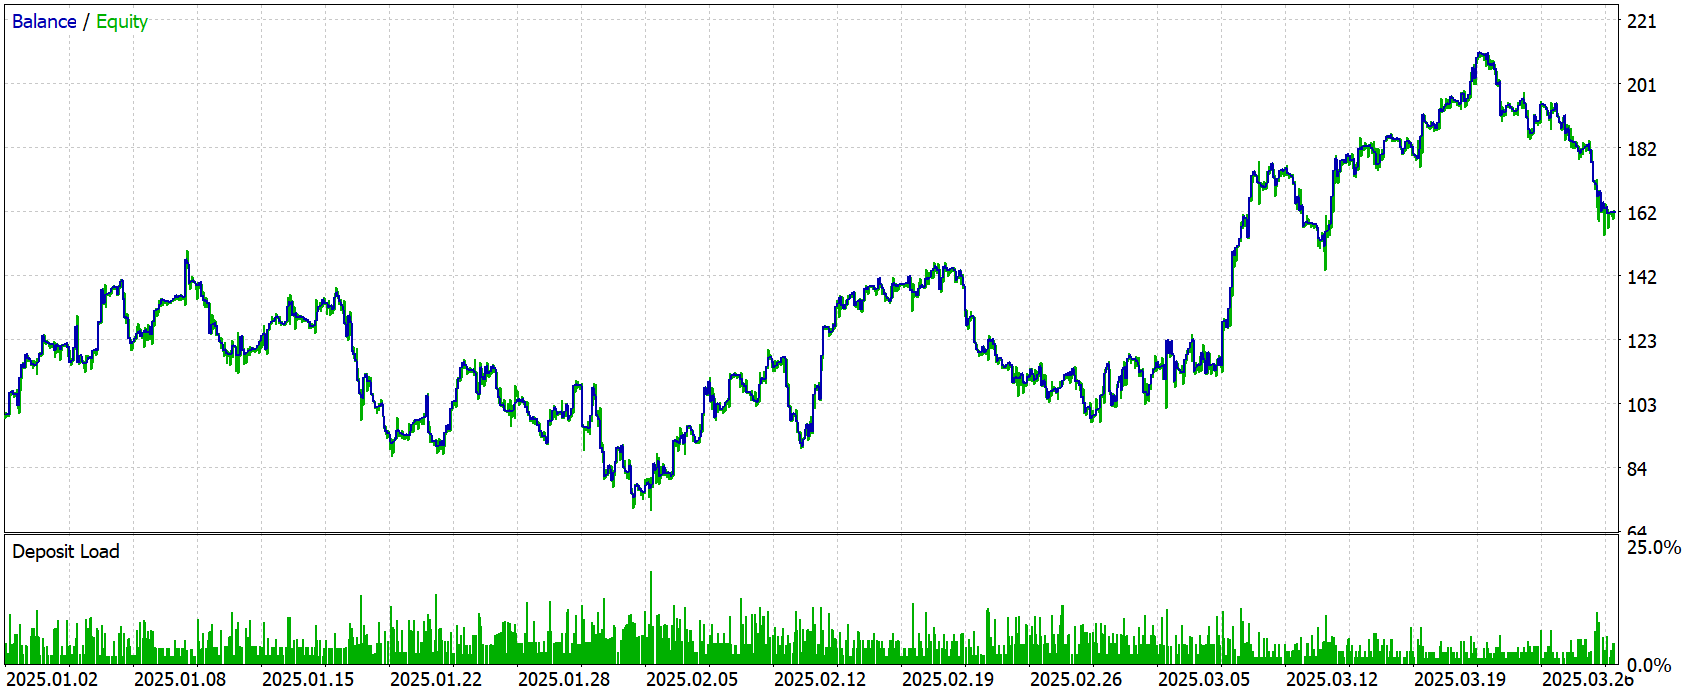
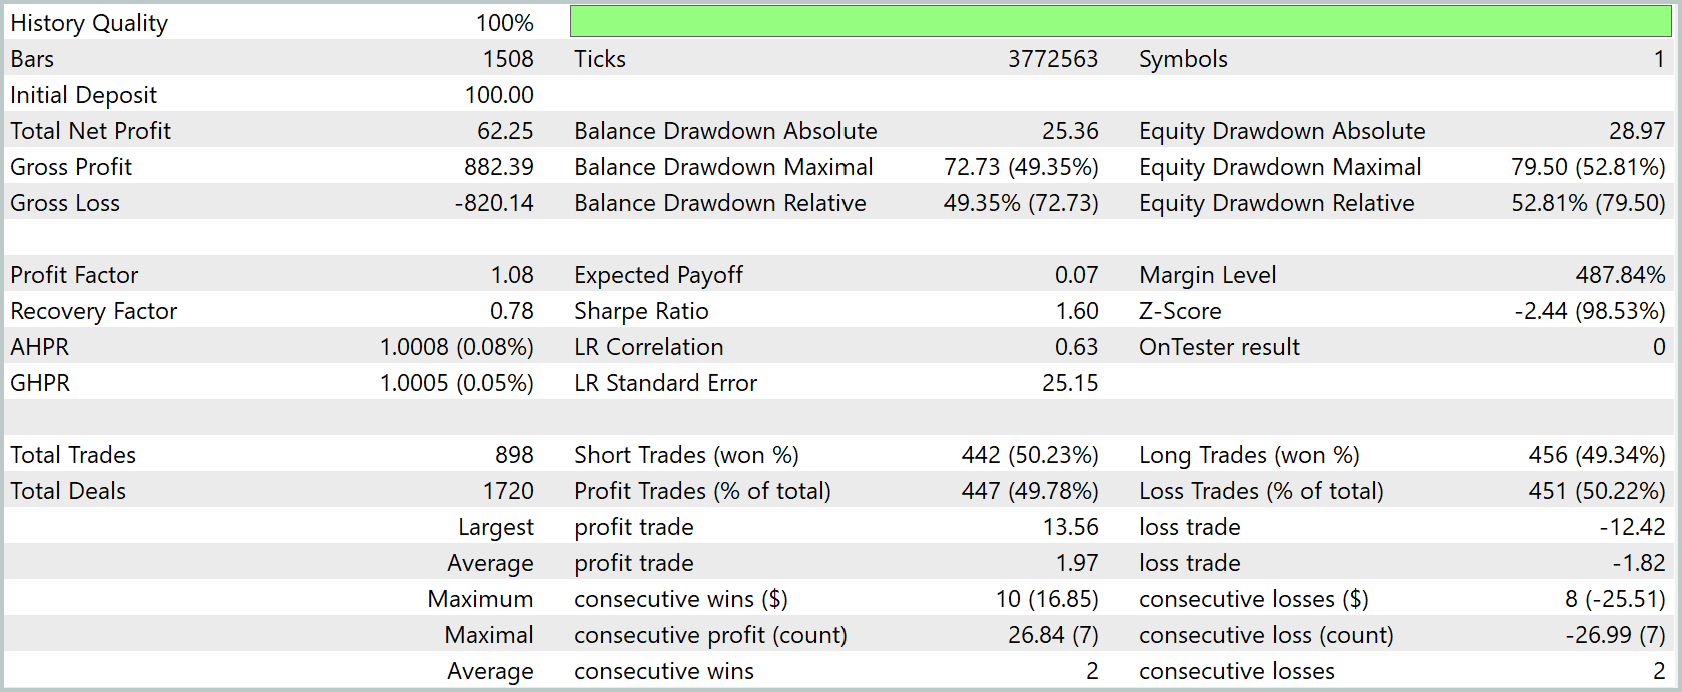
测试结果呈现出中等程度的正向收益表现。初始资金100美元,该EA最终盈利62.25美元,总盈利略高于总亏损。但与此同时,盈利因子仅略高于1,说明这套策略的效果并不理想。
测试期间一共执行了898笔交易,多单与空单的数量基本均衡。两类订单的胜率均维持在50%附近,空单小幅占优。盈利单平均盈利为1.97美元,亏损单平均亏损为1.82美元。单笔最大盈利为13.56美元,单笔最大亏损为12.42美元。
整体来看,EA运行稳定、下单执行准确,但策略的盈利能力与稳健性仍有待提升。
结论
本文完成了基于MQL5实现SSCNN框架理论方案的全部工作。文中介绍了时空特征融合思想:每个时间节点都承载着内部数据结构与外部市场冲击之间复杂的关联关系。
该模型不仅拓展了我们对市场运行规律的认知,也提供了一套适配市场状态切换的工具,可以应对从平稳行情到波动率剧烈震荡的各类场景。注意力归一化的实现,让模型更聚焦关键特征区间,同时稳定训练过程,使SSCNN成为一套灵活的分析工具,能够解析金融时间序列中复杂的结构特征。
参考文献
本文使用的软件
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 用于模型测试的EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构 |
| 5 | NeuroNet.mqh | 类库 | 用于构建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19134
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。


 价格行为分析工具包开发(第三十九部分):在MQL5中实现BOS与ChoCH的自动识别
 新手在交易中的10个基本错误
 市场模拟:仓位视图(四)
