

取引におけるニューラルネットワーク:構造成分の分離(SCNN)
 16
 0

はじめに
多変量時系列の予測は、機械学習における基本的な課題の一つです。 この観点から、需要予測や交通量の予測から、市場参加者の行動や気配値の変動の分析に至るまで、幅広い応用分野の課題を捉えることができます。 これは特に金融分野で重要です。株式、通貨、商品など、ほぼすべての金融資産は、出来高、価格、各種指標、マクロ経済データ、行動に関するシグナルなど、相互に関連する多数の要因から成る複雑な多変量時系列として表されるためです。
こうした予測における主な課題は、時空間パターンを特定することです。 空間的な側面には、流動性の違い、取引時間帯、地域ごとの市場活動といった、外部環境の特徴が反映されます。 一方、時間的なパターンは、市場そのもののリズムと関係しています。具体的には、取引サイクル、ニュースをきっかけとした市場活動の急増、マクロ経済指標の発表周期などが挙げられます。 実際の金融時系列は、定常的とはいえません。 急激な変動やデータ分布の変化が生じるほか、トレンド相場、レンジ相場、パニック、過熱といった市場局面の間で、複雑な移行が発生します。 さらに、自己相関の構造も安定していません。今日有効なパターンが、明日には予測力を失っている可能性もあります。
Transformer、リカレントニューラルネットワーク(RNN)、畳み込みニューラルネットワーク(CNN)など、ニューラルネットワークを用いた最新の手法は、データの定常性を前提とせず、短期予測において有効性を示してきました。 しかし、実際の市場環境では、こうしたモデルが頑健性を発揮できるのは、主に既知のパターンが現れる状況に限られることがあります。 流動性の急激な低下や市場参加者の行動パターンの変化など、突発的な変化が起こると、予測精度が大幅に低下する場合があります。 また、これらのモデルは本質的にブラックボックスとなりやすく、計算負荷が高い一方で、予測結果の解釈が難しいという課題も抱えています。
こうした背景から、時系列分解、すなわち時系列データをトレンド、季節性、残差変動などの成分に分けて分析する手法が、注目を集めています。 このアプローチは、問題の構造を単純化し、モデルの適応性を高めるとともに、予測の根拠をより明確に理解するのに役立ちます。 場合によっては、時系列分解を取り入れた単純な線形モデルが、複雑なニューラルネットワークを予測精度や安定性の面で上回ることさえあります。
ただし、こうした手法にも限界があります。 多くの手法は長期成分と季節成分に重点を置く一方、短期的な変動や変動の激しい局面を十分に扱っていません。しかし、そうした局面にこそ、重要な市場シグナルが含まれている可能性があります。 また、各成分を相互に情報交換させずに個別に処理すると、成分間に存在する高次の関係や非線形な相互作用を捉えることが難しくなります。 さらに、自己相関の構造が動的に変化する市場では、パラメータを固定したモデルでは十分に対応できません。市場の状況に応じて、モデルの設定を柔軟に調整する必要があるのです。
これらの課題に対処するため、論文「Disentangling Structured Components: Towards Adaptive, Interpretable and Scalable Time Series Forecasting」では、新しいアーキテクチャである構造成分ニューラルネットワーク(Structured Component Neural Network, SCNN)が提案されました。 このモデルは、時系列の構造的な分解を基盤として設計されています。 SCNNの基本的な考え方は、データを性質の異なる複数の成分に分解して扱うことです。対象となるのは、長期的なトレンドや季節変動だけではありません。急速に変化する短期的な成分や、変動の激しい局面も含まれます。 それぞれの成分は、その固有の動的特性に合わせて設計された専用のサブネットワークによって処理されます。 この仕組みにより、モデルは市場環境の変化に柔軟に対応できるようになり、その処理過程もより理解しやすくなります。
SCNNの大きな特徴は、データの分解と再構成が、単に入力段階や出力段階でおこなわれるのではなく、ニューラルネットワークの内部構造に組み込まれている点です。 これにより、データを詳細に分解できるだけでなく、成分間の複雑な相互作用も捉えられます。そこには、成分間の接続や、直接には観測できない潜在的な依存関係も含まれます。 さらに、各ネットワークモジュールは、2つの分岐から成る構造を採用しています。一方の分岐は、現在の市場環境に応じてモデルのパラメータを動的に調整し、もう一方の分岐は、そのパラメータを用いて隠れた特徴量を処理します。 つまり、モデルは現在の自己相関構造に合わせて、内部の処理を動的に調整する仕組みを備えているのです。
SCNNの頑健性と汎化性能をさらに高めるため、著者らは、特別な構造的正則化の仕組みも導入しました。 この仕組みは、ノイズや歪みの影響を受けにくい時系列成分にモデルが注目するよう促します。 その結果、一部のパターンの影響力が急速に弱まる一方で、新たなパターンが突如として現れるような不安定な市場環境においても、SCNN高い予測精度と安定性を維持することが期待されます。
著者らが3つの独立したデータセットを用いて実施した大規模な実験でも、SCNNの有効性が示されています。SCNNは比較対象となる手法を一貫して上回る性能を示し、特にデータ分布の急激な変化や異常値が存在する状況で優れた結果を得ました。 さらに重要なのは、こうした性能が、過大ではない計算負荷で実現されている点です。このため、SCNNはローカル環境での計算に加え、取引システムへの組み込みにも適したモデルといえます。
SCNNアルゴリズム
SCNNフレームワークの著者らは、時系列がランダムな摂動から複雑な市場構造へと段階的に形成されると仮定しています。
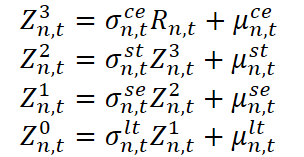
ここで、Z⁰n,tは観測された時系列の元の値(価格や出来高など)を表し、i = 1, 2, 3 に対するZⁱn,tは、構造の各階層における中間表現を表します。Rn,tは残差成分であり、ノイズや予期しない外れ値が含まれます。 各段階には、スケーリング効果を表す乗法係数σと、絶対値の調整に対応する加法的シフトµの両方が含まれます。
この構造を直感的に理解するために、市場データの分析に当てはめて考えてみましょう。 ある資産の価格変動を例に取ります。 長期成分は、金利の変化や経済構造の変化など、 価格に影響を与える根本的な要因を反映します。 季節成分は、四半期決算の発表、納税時期、主要な市場参加者の行動などに関連して繰り返し現れるパターンを表します。 短期成分は、ニュースの発表、取引活動の活発化、一時的な流動性不足などによって生じる局所的な変動を捉えます。 共変動層は、複数の銘柄が同じセクター内で共通のマクロ経済ニュースに同時に反応する場合など、複数の市場で同期して発生する動きをモデル化します。 残差成分には、ホワイトノイズや、突発的な大口注文、気配値の誤りなどによって生じる外れ値が含まれます。
実際の市場環境では、これらの成分の境界が明確に分かれているわけではなく、状況に応じて変化することが重要です。 たとえば、特定の銘柄の出来高が急増した場合、当初は外れ値と見なされるかもしれません。しかし、その状態が続けば短期的なトレンドとなり、 数週間にわたって持続すれば、やがて長期的な構造の一部となる可能性があります。 このようにパターンは時間とともに変化するため、モデルには柔軟性と、データ構造の変化に適応する能力が求められます。
このフレームワークでは、各成分が乗法的な効果と加法的な効果の両方を持ちます。 乗法的な効果は、比例的な変化をモデル化するために用いられます。 一方、加法的な効果は、現在の価格水準に依存しない一定量の変化を表します。たとえば、企業配当の継続的な影響や、季節的な手数料などがこれに当たります。 この2種類の効果を組み合わせることで、市場データをより現実に即してモデル化できます。 相対的な変化が重要な場合もあれば、絶対的な変化量が重要な場合もあるためです。
長期成分は、出来高の持続的な増加や、景気拡大を背景とした市場活動の活発化など、時系列に見られる安定した構造的なパターンを特定するために用いられます。 ここでいう「パターン」とは、単なる時系列上の並びではなく、特定の時点に依存しない、集計データの分布形状を指します。 したがって、長期的な構造は、複数の季節サイクルにわたって収集されたデータの統計的な特徴によって捉えられます。
考え方はシンプルです。異なる季節サイクルの観測値を組み合わせることで、短期的な変動を平滑化し、持続的なトレンドをノイズの少ない形で推定できます。 これにより、出来高の一時的な急増や短期的な価格調整といった一過性の異常に過度に適合することを避け、市場の根本的な動きに焦点を当てられます。
この処理には、長さ∆のスライディングウィンドウを使用し、各時点で対象となる観測値を動的に選択します。 次に、2つの主要な統計量、すなわち平均(分布の中心)と標準偏差(変動の尺度を表すもの)を計算します。 この2つの値を組み合わせて、長期成分の表現を構成します。 続いて、各分析対象セグメントを正規化します。具体的には、長期平均を差し引き、その結果を標準偏差で割ります。 これにより、各セグメントの尺度が統一され、長期的なオフセットが取り除かれます。こうして、データは次の分解段階に進む準備が整います。
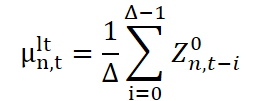
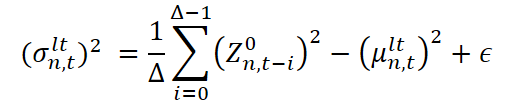
ここで、μˡᵗn,tとσˡᵗn,tは、それぞれウィンドウ∆内のデータから算出した長期平均と尺度(標準偏差)を表します。 また、Z¹n,tまは長期成分を除去した正規化値であり、季節成分を特定する次の処理段階に渡されます。
この段階では、持続的な構造的トレンドの影響を考慮した、市場の水準調整済みの表現が得られます。 これは金融市場の予測において特に重要です。たとえば、日中取引などの短期戦略では、全体的なトレンドに影響されることなく局所的な取引機会を特定するために、長期的な水準変化を除去したデータが必要となります。平準化された表現と解釈できます。
季節成分は、時系列に繰り返し現れる周期的なパターンを特定する役割を担います。 金融市場では、午前中の取引活動の急増、昼頃の小休止、取引終了前の夕方の活発化など、日中の周期的な変動が例として挙げられます。 また、金曜日にはボラティリティが低下し、月曜日には出来高が増加するといった週単位のパターンや、決算発表やマクロ経済指標の公表に関連する四半期・年単位の季節的な影響も含まれます。
ここでは、季節サイクルの長さが時間の経過によって変化しないと仮定します。これは単純化した仮定ですが、実用上は有効です。 ただし、サイクル長が変動する状況に対応するため、著者らはFFT(高速フーリエ変換)を用いた季節性の自動推定を組み込むことを提案しています。
技術的には、季節成分の抽出は長期成分の正規化と似ていますが、重要な違いがあります。ここでは、周期長に対応する間隔でデータを抽出する間引きウィンドウを使用します。 ウィンドウサイズをτ、間引き率をm(ここでは周期長に相当)とします。 これにより、季節構造に対応した間隔でデータを走査することが可能になります。
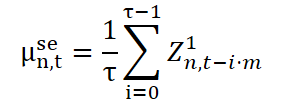
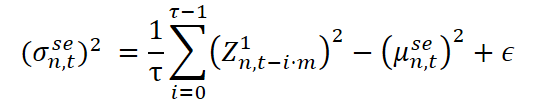
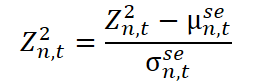
ここで、Z²n,tは、正規化と季節調整を施したデータを表し、次の処理段階に渡されます。
短期成分は、長期トレンドや季節パターンでは説明できない、局所的かつ不規則な変動を捉えます。 金融市場では、ニュース発表への突発的な反応、技術的な不具合、投機的な取引による流動性の急増、ボラティリティの高まりに伴うトレーダー心理の急激な変化などが、こうした変動を引き起こす可能性があります。 短期成分は、非常に短い時間間隔における外部刺激への市場の反応を捉える、いわば市場の脈動です。
長期成分の正規化とは異なり、ここでは短期的な変動を過度に平滑化してしまわないよう、短い平滑化ウィンドウを使用します。 このウィンドウの長さをδとします。 これを用いて、標本の位置と尺度を表す統計量を計算し、その後、データを正規化します。
その結果得られる値Z³n,tは、短期的な変動を除去するための処理を施した中間表現であり、正規化の最終段階へと渡されます。
ただし、この成分にも限界があります。 第一に、急激かつ大幅な変化に即座に反応できるわけではなく、モデルには一定の慣性があります。 第二に、変化が2~3タイムステップしか続かない場合、特に分散が大きい状況では、その変化が検出されない可能性があります。 これは、個別銘柄に短期的な変動が生じても、その変動が集約されたノイズに埋もれてしまい、市場全体を対象とするシステムでは見過ごされる状況に似ています。
こうした影響を緩和し、短期的なシグナルに対する感度を高めるため、SCNNでは共変動する時系列を利用します。 つまり、ある金融商品に変動が観測された場合、モデルはデリバティブ、指数、出来高など、ほかの関連する系列にも同時にシグナルが現れていないかを確認します。 この仕組みにより、短期成分は変化に反応するだけでなく、その変化を周囲の状況と関連付けて捉えられるようになります。これは、高頻度取引やアルゴリズム取引において特に重要です。
共変動層は、モデル全体の構造において特別な役割を果たします。 各時系列を個別に分析する前述の3つの成分とは異なり、この成分は系列間の相関関係を利用し、複数の時系列で同時に発生する変化を捉えます。 2つ以上の時系列が同じ時点で類似した動きを示す場合、共通の生成過程が存在する可能性が高いと考えられます。 その場合、関連する観測値を集約することで、その共通の過程を推定できます。
ただし、このアプローチを実装するには、どの時系列が共通の変動過程に関与しているのかを特定する必要があります。 そのためには、時系列間の相関を測定します。 方法としては、専門家の知見に基づいて相関行列をあらかじめ固定する方法と、データから直接学習する方法の2つが考えられます。 著者らは後者を採用しています。これは、特にデータの構造に関する事前情報がない場合に、より柔軟で汎用性の高い方法です。
時系列nとn'の各ペアについて、個別のAttention係数を計算し、SoftMax関数によって正規化します。 これにより、各系列に対応する重みの合計が1になります。
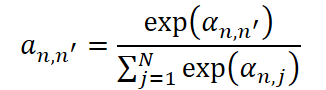
これらの重みを用いて、共変動層のパラメータを計算します。 まず、系列間の相互関係を考慮しながら局所的な中心化をおこなうため、平均値を算出します。
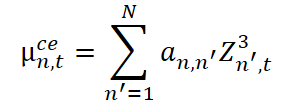
次に、安定化定数ϵを加えて、尺度(標準偏差)を推定します。
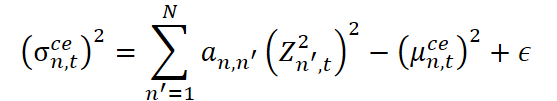
これらの値に基づいて、正規化された残差を構成します。
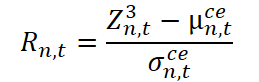
残差Rn,tは、これまでに特定された成分では説明できない信号の部分を表します。 そこには、残存する不確実性、構造的なノイズ、あるいは特定の時系列が全体的な動きから示す固有の変動など、明示的なモデル化が難しい要素が含まれます。
多数の時系列を扱う場合には、モデルのスケーラビリティをさらに高めることも可能です。 そのために、隣接行列学習モジュールの利用が提案されています。このモジュールによって、Attention機構を柔軟に調整し、計算を最適化できます。
最終段階では、すべての中間表現を1つの特徴量ベクトルに統合します。
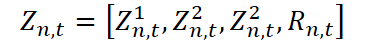
同時に、正規化パラメータをまとめた補助ベクトルも生成します。
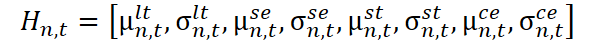
このように、時系列はもはや、時間の経過に沿って記録された値の単なる集合ではありません。 構造的なトレンド、繰り返される季節変動、局所的な短期変動、複数の系列にまたがって同期して生じる変化など、それぞれ異なる動態を表す多成分の表現へと変換されます。 これにより、データをより詳細に分析し、解釈可能なモデルを構築するとともに、頑健な予測アルゴリズムを開発できます。
各成分はそれぞれ異なる動態を持ち、予測可能性の程度も異なります。そのため、各成分の挙動を個別にモデル化することが合理的です。 これは特に短期予測で重要になります。長期成分と季節成分は一般に安定しており、比較的規則的なパターンを示すためです。 このような場合には、追加のパラメータや複雑なモデルを導入することなく、それらの成分を直接外挿できます。
長期成分については、最も単純な方法を採用します。予測期間全体を通じて、その値が一定に保たれると仮定するのです。 つまり、この成分のパラメータの現在の推定値が分かっていれば、それをそのまま将来の時点にも適用します。
一方、季節成分は周期性に基づくため、もう少し工夫が必要です。 周期性が維持されると仮定し、予測対象の時点と周期内の位相が同じ過去の時点から、パラメータ値を再利用します。 具体的には、時刻t+iにおける季節成分の値として、時刻t-m+iの値を用います。ここで、mは周期の長さを表します。
この方法では、季節的なリズムを維持しながら、モデルに余分な計算負荷をかけることなく、季節成分の挙動を外挿できます。
長期成分や季節成分とは異なり、短期成分、共変動に関する依存関係、残差成分は、より確率的な性質が強く、規則性も低くなります。 そのため、固定的な経験則や厳密に定められた外挿ルールでは十分に対応できません。 そこで著者らは、これら3つの成分それぞれに、自己回帰に基づくパラメータ化モデルを適用し、複雑で予測が難しい変動を捉えます。
予測期間内の各時点iについて、対応する成分の値を、直前のδ個の値と、学習可能な重みを持つ線形モデルに基づいて計算します。 短期成分、共変動層、残差成分の外挿には共通の手順が用いられ、次のように表されます。
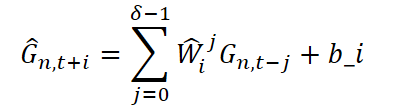
ここで、G ∈ {Zˡn,t+i, μstn,t+i, σstn,t+i,μcen,t+i, σcen,t+i}は、各成分に対応する外挿されたパラメータを表します。Ŵji ∈ Rdz · dzは、過去の値が与える影響を表す学習可能な重み行列です。biはバイアス項(bias)であり、これも学習可能です。
外挿後、すべての成分は次の2つのベクトルにまとめられます。
- Ĥn, t+i:統計パラメータの集合
- Źn, t+i:正規化された表現の集合
これら2つの特徴量集合の相互作用をモデル化するため、それぞれ学習可能なパラメータ行列によって生成された2つの線形射影に対し、要素ごとの積(ペアワイズ乗算)を適用します。
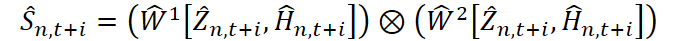
こうして、対象とするプロセスの統計的に重要な側面を統合した、最終的な予測表現が形成されます。
MQL5を使用した実装
SCNNフレームワークの理論的な基礎を詳しく検討したので、次に実装へと進みます。 このセクションでは、MQL5を使用してモデルの主要な考え方を実装する方法の一例を紹介します。 時系列を構造成分に分解する方法と、モデルの解釈可能性とモジュール性を維持しながら予測部分を構築する方法を示します。 このアプローチは、複雑なニューラルネットワークアーキテクチャに基づく、理解しやすく、柔軟で適応性の高い取引戦略の構築につながります。
SCNNフレームワークの実装の第1段階では、中核となるブロック、すなわち一定の時間区間内で統計的特性を抽出し、入力データを正規化するアルゴリズムの構築に取り組みます。 この段階は時系列分解において重要な役割を果たします。ここで、後続の予測の基礎となる長期成分と短期成分が形成されるためです。
このアルゴリズムは、PeriodNormという名前のOpenCLカーネルとして実装されています。このカーネルは、時系列のスライディングウィンドウ内で統計的特性を計算し、データを正規化します。 実装には並列処理の考え方が取り入れられており、すべての変数と時間ウィンドウのデータを同時に処理します。
__kernel void PeriodNorm(__global const float* inputs,
                         __global float2* mean_stdevs,
                         __global float* outputs,
                         const int total_inputs
                        )
  {
   const size_t i = get_global_id(0);
   const size_t p = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t windows = get_global_size(0);
   const size_t period = get_local_size(1);
   const size_t variable = get_global_size(2);
この関数は、入力値の配列inputsに加え、正規化された値を格納する配列outputsと、計算された統計パラメータ(平均値と標準偏差)を格納する配列mean_stdevsを受け取ります。 また、total_inputsパラメータも受け取ります。このパラメータは、変数ごとの時系列の長さを指定します。
ワークアイテムは3次元に配置されます。第1の座標はウィンドウ番号(time segment)、第2の座標はウィンドウ内の位置、第3の座標は変数のインデックスに対応します。 したがって、各ワークアイテムは、特定の変数における、特定のウィンドウ内の時系列要素を1つ担当します。
まず、メモリ内のデータに正しくアクセスするために必要なインデックスを計算します。 変数shift_iは時系列の先頭から見た現在の点の位置を、shift_vは変数方向のオフセットを、shift_msは統計量配列内の位置を指定します。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_i = i * period + p;
   const int shift_v = v * total_inputs;
   const int shift_ms = v * windows + i;
次に、ソース配列から時系列の値を取得し、無効な値がないかを確認します。NaNや無限大の値が見つかった場合は、ゼロに置き換えます。
//---
   float val = 0;
   if((shift_i) < total_inputs)
      val = IsNaNOrInf(inputs[shift_v + shift_i], 0);
続いて、現在のウィンドウ内の平均値を計算します。 この計算には、補助関数LocalSumを使用します。この関数は、ワークグループ内の各ワークアイテムが持つ値を合計するため、処理効率の向上につながります。
   float mean = IsNaNOrInf(LocalSum(val, 1, Temp) / period, 0);
   val -= mean;
   BarrierLoc;
次に、計算した平均値を現在の観測値から差し引き、その偏差をもとに標準偏差を計算します。具体的には、偏差の二乗の平均を求め、その平方根を取ります。 各段階には、ゼロ除算や数値誤差の蓄積を防ぐために数値安定性のチェックが組み込まれています。
   float stdev = LocalSum(val * val, 1, Temp) / period;
   stdev = IsNaNOrInf(sqrt(stdev), 1);
計算結果は2つの形式で保存されます。各ウィンドウと各変数の統計量をmean_stdevs配列に書き込み、正規化された値をoutputs配列に格納します。
   mean_stdevs[shift_ms] = (float2)(mean, stdev);
   if((shift_i) < total_inputs)
      outputs[shift_v + shift_i] = IsNaNOrInf(val / stdev, 0);
  }
正規化には標準的なZスコア正規化の式を用い、その都度計算した標準偏差を分母として使用します。
このカーネルは、ロジックを変更することなく、ウィンドウサイズ、変数の数、時系列の長さを変更できるように設計されています。 特に、ウィンドウ長を大きくすると、正規化は長期的なトレンドの影響を受けやすくなり、トレンドの抽出に利用できます。 逆に、ウィンドウサイズを小さくすると、短期的な偏差や異常をより細かく検出できるようになります。
誤差逆伝播法を含む完全な学習サイクルを備えたモデルを実装するには、ニューラルネットワークの出力から入力へと勾配を伝播できるようにする必要があります。 PeriodNormカーネルには学習可能なパラメータがありません。すべての計算は、入力された時系列データに基づく統計計算です。しかし、計算グラフの一部として正規化をおこなう場合は、勾配を計算する必要があります。 そのため、このアーキテクチャに2つ目のカーネルPeriodNormGradを追加します。
__kernel void PeriodNormGrad(__global const float* inputs,
                             __global float* inputs_gr,
                             __global const float2* mean_stdevs,
                             __global const float2* mean_stdevs_gr,
                             __global const float* outputs,
                             __global const float* outputs_gr,
                             const int total_inputs
                            )
  {
   const size_t i = get_global_id(0);
   const size_t p = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t windows = get_global_size(0);
   const size_t period = get_local_size(1);
   const size_t variable = get_global_size(2);
学習可能なパラメータを持つ従来のブロックとは異なり、PeriodNormGradカーネルのアルゴリズムは、ニューロンも重みも持たない層を通じて、誤差を正しく逆伝播できるように設計されています。 まず、各変数について、時系列の各ウィンドウ内の要素にアクセスできるようにします。 インデックスは順伝播と同じ方法で計算します。
- i:ウィンドウ番号
- p:ウィンドウ内での位置
- v:変数番号
座標を取得したら、必要なデータを取り出します。具体的には、入力値)inp)、その正規化値(out)、正規化値に関する勾配(out_gr)、ウィンドウ内で事前に計算された平均値と標準偏差(mean_stdev)、およびこれらに関する勾配(mean_stdev_gr)です。平均値と標準偏差が繰り返し使用される場合にも、それらに関する勾配を取得できます。 特に、SCNNフレームワークでは、これらの値をデータの外挿に使用することを想定しています。 すべての値について妥当性を確認し、NaNや無限大を除外して、計算結果が不正になるのを防ぎます。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_i = i * period + p;
   const int shift_v = v * total_inputs;
   const int shift_ms = v * windows + i;
//---
   float inp = 0;
   float inp_gr = 0;
   float out = 0;
   float out_gr = 0;
   const float2 mean_stdev = means_stdevs[shift_ms];
   const float2 mean_stdev_gr = means_stdevs_gr[shift_ms];
   if((shift_i) < total_inputs)
     {
      inp = IsNaNOrInf(inputs[shift_v + shift_i], 0);
      out = IsNaNOrInf(outputs[shift_v + shift_i], 0);
      out_gr = IsNaNOrInf(outputs_gr[shift_v + shift_i], 0);
     }
ここからが重要な部分です。 各入力値がモデルの最終的な誤差にどの程度影響したかを把握するには、その値をわずかに変化させたときに誤差がどう変わるかを計算する必要があります。 統計的な正規化では、平均値を引き、標準偏差で割ります。 つまり、入力値が変化すると、分子である平均値からの偏差と、分母であるウィンドウ内のばらつきの度合いの両方に影響が及びます。 そのため、平均値と標準偏差の両方について勾配を計算する必要があります。
   float mean_gr = LocalSum(out_gr, 1, Temp) / period + IsNaNOrInf(mean_stdev.x, 0);
   BarrierLoc;
   float stdev_gr = out * LocalSum(IsNaNOrInf(out * out_gr, 0), 1, Temp) / period +
                                                        IsNaNOrInf(mean_stdev.y, 0);
まず、層の出力における勾配out_grを現在のウィンドウ全体で合計し、その平均を求めます。これが、平均値に関する勾配mean_grへの寄与となります。 ここでは勾配を単純にそのまま伝播させるのではなく、平均値の変化がウィンドウ全体の正規化値に与える影響を考慮しています。
次に、標準偏差に関する勾配stdev_grを計算します。この計算では、平均値を差し引いた値に誤差勾配を掛け、その結果を平均することで、データのばらつきに対する誤差の感度を求めます。
これら2つの勾配を求めたら、入力値そのものに関する勾配を計算します。 out_grからの勾配と、平均値および標準偏差に関する微分を組み合わせます。 これにより、ウィンドウ内での位置や、入力値がウィンドウ全体の統計的特性に与える影響を考慮しながら、モデルの総誤差に対する各入力値の寄与を反映します。
   inp_gr = (out_gr - mean_gr - stdev_gr) / IsNaNOrInf(mean_stdev.y, 1);
//---
   if((shift_i) < total_inputs)
      inpurs_gr[shift_v + shift_i] = IsNaNOrInf(inp_gr, 0);
  }
最後に、算出された値を入力勾配配列inputs_grに書き戻します。 すべての操作で配列の範囲を考慮し、現在のインデックスが配列の範囲外にある場合は処理をおこないません。
このように、PeriodNormGradは単に勾配計算を形式的に実装したものではありません。古典的な統計処理と現代的なモデル学習手法をつなぐ重要な役割を果たします。 これにより、統計演算を計算グラフの一部として扱い、誤差情報をその発生源へと正しく逆伝播させることで、学習に組み込めるようになります。
メインプログラムでは、専用クラスCNeuronPeriodNormを作成します。このクラスは、順伝播と逆伝播の両方で、周期正規化用のOpenCLカーネルを扱うロジックをカプセル化するものです。 基底クラスCNeuronBaseOCLを継承しており、計算モデルの構成要素階層に属しています。 新しいクラスの構造を以下に示します。
class CNeuronPeriodNorm :  public CNeuronBaseOCL
  {
protected:
   uint                    iPeriod;
   uint                    iVariables;
   uint                    iCount;
   CNeuronBaseOCL          cMeanSTDevs;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return true; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronPeriodNorm(void) : iPeriod(-1), iVariables(1) {};
                    ~CNeuronPeriodNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint period, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronPeriodNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
//---
   CNeuronBaseOCL*   GetMeanSTDevs(void) { return cMeanSTDevs.AsObject(); }
   virtual uint      GetPeriod(void) const { return iPeriod; }
   virtual uint      GetVariables(void) const { return iVariables; }
   virtual uint      GetUnits(void) const { return iCount; }
  };
このクラスの内部フィールドは、主要な設定パラメータを表しています。 変数iPeriod変数は、平均値や標準偏差の計算などの統計処理をおこなうウィンドウの長さを指定します。 iVariablesは処理対象となる変数(特徴量)の数を指定し、iCountは各シーケンス内の独立したウィンドウの数を指定します。
また、クラスにはcMeanSTDevsオブジェクトが含まれています。これは、順伝播中に計算された平均値と標準偏差を格納する中間バッファとして機能します。 このバッファは、PeriodNormGradカーネルによる誤差逆伝播でも使用されます。
Initメソッドは初期化メソッドとして機能します。すべてのパラメータを受け取り、それらを使って内部構造を準備し、オブジェクトを必要なOpenCLリソースに関連付けます。
順伝播と逆伝播のメソッドは、基本的にユーティリティラッパーとして機能します。 これらのメソッドの役割は、データを手作業で再計算することではなく、対応するOpenCLカーネルを実行キューに正しく登録するための準備を整えることです。
GetMeanSTDevs関数にも注目してください。この関数は、計算済みの統計情報を格納したバッファへのアクセスを提供します。この情報は、モデルの他の構成要素で、たとえば可視化や追加処理などに利用できます。
このように、CNeuronPeriodNormクラスは正規化を実行するだけでなく、学習機能を備えた計算モデルに適切に統合するための仕組みも備えた、独立性と柔軟性の高い構成要素です。 ニューラルネットワークフレームワークの原則に従いながら、MQL5とOpenCLのように計算を細かく制御するシステムに求められる、明確なロジックも維持しています。
このクラスの全メソッドを含む完全なコードは、添付ファイルで確認できます。
今回は、実装を大きく前進させることができました。 内容がかなり盛りだくさんなので、理解するには少し時間がかかるかもしれません。 ここで少し休憩して一息つき、次の記事で気持ちを新たに作業を続けましょう。
結論
本記事では、SCNNフレームワークの理論的な側面を検討しました。このフレームワークは、時系列を長期成分、季節成分、短期成分、残差成分という解釈可能な要素に分解する、独創的で理論的にも妥当なアプローチを提供します。 この構造は予測精度の向上だけでなく、モデルの透明性も大幅に高めます。その結果、モデルの挙動をより予測しやすくなり、変化する市場環境への適応力も向上します。
特に重要なのは、各成分の動的特性が異なる点です。そのため、成分ごとに適した補間手法を使用する必要があります。長期成分と季節成分には単純な繰り返しパターンを適用し、短期成分と残差の変動は、学習可能な自己回帰構造を用いてモデル化します。
本記事の実践編では、提案された手法を独自に解釈して実装に着手し、モデルの基本要素の一つである、時系列の周期的な区間を正規化するアルゴリズムを構築しました。 また、順伝播と逆伝播を含め、OpenCL側での計算処理の実装について詳しく検討しました。これにより、今後この仕組みを学習可能なニューラルネットワークアーキテクチャに組み込めるようになります。 このステップは、MQL5環境で取引向けのモデルを構築するうえで、重要な前進となりました。
次の記事では、新しいモデル構成要素を追加して実装をさらに発展させ、SCNNフレームワークに基づく本格的な時系列分析・予測システムの構築を段階的に進めていきます。
リンク
- Disentangling Structured Components: Towards Adaptive, Interpretable and Scalable Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18950
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:構造成分の分離(Encoder)
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(最終回)
 取引におけるニューラルネットワーク:構造成分の分離(最終回)
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(主要構成要素)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索