

取引におけるニューラルネットワーク:確率的時系列予測(最終回)
 22
 2

はじめに
金融時系列データは、依然として分析が非常に難しいデータの一つです。 その振る舞いは決して安定しているとは言えません。明確なパターンが存在するというよりも、トレンドや周期性、ノイズ、さらには予期しない構造変化が複雑に絡み合っています。 そのため、線形回帰や移動平均といった従来のモデルは、シンプルで計算が速いという利点がある一方、多くの場合、十分な性能を発揮できません。 一方、表現力に優れた最新のニューラルネットワークも、過学習や予測の不安定さ、解釈可能性の低さといった課題を抱えています。
こうした状況において、実績のある数学的手法とニューラルネットワークの柔軟性を組み合わせたハイブリッドアプローチは、特に注目に値します。 まさにこの両者のバランスを追求したものが、K²VAEフレームワークです。これは、現実の時系列データが持つ特性を考慮しながら、その分析と予測を行うために設計されたシステムです。 このフレームワークの大きな特長は、市場状態の時系列から学習することで、システムの背後にある動的な構造を捉え、新たなデータが得られるたびに推定結果を更新できる点にあります。
このフレームワークは、互いに補完し合い、それぞれの弱点を補う3つの基本的な考え方に基づいています。 1つ目はKoopman表現です。これは、非線形システムの振る舞いを線形な部分空間上で表現することを目指す手法です。 この変換はあくまで近似的なものですが、システムの挙動を記述・予測するうえで強力な手段となります。表面的な統計量だけに着目するのではなく、システムの背後にある動的な構造を捉えることで、時系列データをより深く分析できるようになります。
2つ目は、カルマンフィルタの活用です。ここでは標準的な形式をそのまま用いるのではなく、確率的なニューラルネットワークアーキテクチャで利用できるよう、安定性を考慮した形式を採用します。 カルマンフィルタは、適応的な補正機構として機能します。具体的には、KoopmanNetモジュールが生成した推定値を新たな観測データに基づいて補正するとともに、各予測の不確実性に関する情報も提供します。 この機能は、単に価格を予測するだけでなく、特定のシナリオが生じる可能性を評価したい場合に、特に有用です。
3つ目は、変分オートエンコーダの統合です。 これにより、点予測ではなく、確率分布として予測結果を表現できます。つまり、1つの将来シナリオを提示するだけでなく、主要なトレンドと、そこから外れる可能性のある変動の両方を反映した、複数の可能性を含む分布を得ることができます。
このように、K²VAEは単なる分析ツールの一つにとどまりません。予測の不確実性を定量的に表現し、複数の将来シナリオを考慮しながら、新たな市場環境にも適応できるシステムです。
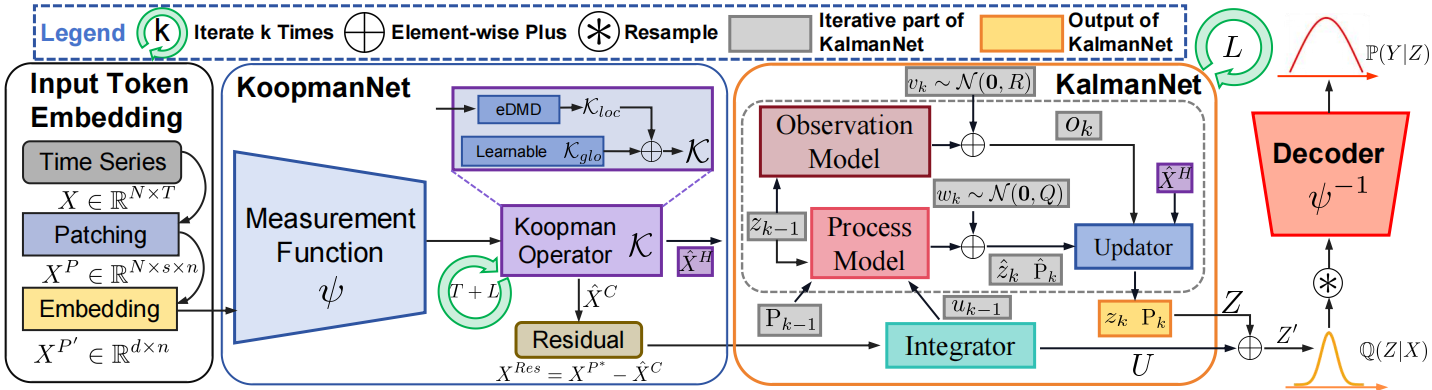
これまでの記事では、このフレームワークの主要な構成要素について、すでに詳しく解説してきました。 KoopmanNetの仕組み、潜在表現の形成方法、カルマンフィルタのアーキテクチャへの統合方法、そしてすべての要素を共同で学習する方法について説明しました。 特に、計算の安定性と、モデル内部における情報伝播の仕組みに重点を置いて解説しました。
モデルアーキテクチャ
K²VAEフレームワークのアーキテクチャの基盤を構成する各コンポーネントを段階的に構築してきました。ここからは、次の論理的な段階として、すべての要素を単一の機能的なシステムへと統合していきます。
ここで強調しておきたいのは、これまでの研究と同様に、私たちの目的は、従来型の独立した予測モデルを構築することではないという点です。 本フレームワークにおける予測は、あくまでも副次的な成果です。より本質的な目的は、現在の環境状態を表す、表現力に優れた安定的な潜在表現を生成することにあります。 この表現は、入力された情報を要約するだけでなく、学習可能なエージェントが取引判断を下す際の重要な入力情報としても機能します。
したがって、私たちはK²VAEフレームワークを、独立した予測モデルとしてではなく、環境状態を表現する高度なEncoderとして位置づけています。このEncoderは、すでに実装したActor–Director–Criticアプローチに基づくアーキテクチャに統合されています。 ここでは、VAEコンポーネントが将来のシナリオを確率的に記述する役割を担い、KoopmanNetが潜在空間における線形ダイナミクスをモデル化し、カルマンフィルタが新たに入力される観測値に基づいて状態の補正と推定の精緻化をおこないます。 これらすべての要素は、十分に検討され、統計的な妥当性を備えた取引判断を下すために有用な情報を可能な限り多く含む環境表現を、エージェントに提供するという共通の目的に向けて機能します。
K²VAEの各コンポーネントをActor–Director–Criticアーキテクチャに統合することで、システムに必要な表現の深さと安定性がもたらされます。 その結果、Encoderによって形成される潜在状態には、現在の状況に関する情報だけでなく、今後どのような経路をたどって変化していく可能性があるのかという情報も含まれるようになります。 これにより、エージェントの振る舞いは質的に向上します。つまり、現在のシグナルに単純に反応するのではなく、起こり得る複数のシナリオを考慮しながら行動できるようになります。この特性は、変動が激しく、先行きを予測しにくい市場環境において、特に重要です。
ここで重要な役割を果たすのが、CreateDescriptionsメソッドです。 このメソッドは、Encoderや予測モジュールから意思決定コンポーネントに至るまで、アーキテクチャを構成するすべての要素の記述を組み立てます。 また、システムの各コンポーネントで使用する層とその適用順序を定義することで、後続の学習プロセスの基盤を構築します。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
メソッドの引数として、各モデルに対応する複数の動的配列へのポインタを受け取ります。 これらの配列は、ニューラルネットワークの各ブロックのアーキテクチャ記述を格納するためのコンテナです。 配列にデータを格納する前に、受け取ったポインタが正しいものであることを必ず確認します。 必要なオブジェクトが存在しない場合は、ダングリングメモリを参照して処理を続行するのではなく、新しい配列インスタンスを適切に生成します。 この手順は技術的な形式要件にすぎないように思えるかもしれませんが、実際には、後続のすべての処理の安定性を確保するための重要な基盤となります。
その後、処理の中心となる部分に移ります。各配列に適切な層と接続を設定し、ニューラルネットワーク全体の構成を完成させます。 まずは、システムの中核を担うEnvironment State Encoderから始めます。 このコンポーネントに、K²VAEフレームワークの基盤となる主要なアイデアを組み込みます。 ここで改めて確認しておくと、Encoderの役割は、単に市場の状況に関する情報を収集することではありません。エージェントが信頼性の高い取引判断を下すための基盤として利用できる、表現力と情報量に優れた潜在表現を生成することが、その本質的な役割です。
ターミナルから直接取得した生の入力データを、全結合層に渡します。 この層は、外部環境とモデル内部の処理ロジックをつなぐインターフェースとして機能します。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
その後、データは前処理段階であるバッチ正規化層へと送られます。 ここでは、スケールや値の範囲、物理的な意味が異なる多様な入力特徴量を、相互に比較可能な形式へと整えます。 この処理は、数値的な安定性を確保するうえで重要であるだけでなく、モデル全体の学習という観点からも重要です。データを正規化することで、ニューラルネットワークの収束が速まり、特徴量間の関係をより正確に捉えられるようになります。
このような役割において、バッチ正規化は、統計的なノイズを平滑化し、入力信号を構成する各成分の分布を整えるフィルタとして機能します。 これにより、後続の変換処理に向けて安定的かつ予測可能な環境が整い、処理の初期段階で生じる歪みを最小限に抑えることができます。
データの正規化が完了すると、次の重要なステップである空間的な分割、すなわちパッチ化へと進みます。 オリジナルのK²VAEフレームワークでは、前処理済みの入力データを、互いに重複しない複数のパッチに分割することが提案されています。それぞれのパッチは、データストリーム全体の一部分を表します。 同時に、異なるチャネルの値が単一のパッチ内にまとめられるため、モデルは特徴量間の依存関係を自然に学習できるようになります。
しかし、私たちの実装では、さらに一歩踏み込み、標準的なパッチ化の方式にとどまらないことにしました。その代わりに、これまでの記事で取り上げてきた複数の最新アーキテクチャに着想を得て、より複雑な構造を実装しました。 まず、各チャネルの値の段階的な変化を捉える差分特徴量を追加し、入力特徴量の配列をさらに拡張します。 これにより、短期的なシグナルの動的変化を考慮するとともに、市場構造の変化に対するモデルの感度を高めることができます。同時に、ノイズに対する頑健性も維持します。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
続いて、データにタイムスタンプを付与します。これは、モデルが特徴量の値だけでなく、それらが時間軸上のどの位置にあるのかも考慮できるようにする重要な要素です。 タイムスタンプによって、イベントが実際に発生した時刻に関する情報がニューラルネットワークに与えられます。具体的には、分、時、曜日、あるいはその他の時間単位に基づく情報が含まれます。 その結果、モデルは金融時系列データに特有の周期的なパターンや季節的な変動を識別できるようになります。 こうした時間情報の組み込みは、特に過去の相場データを扱う際に重要です。市場の周期性は、取引戦略を構築するうえで重要な役割を果たすためです。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
ここで、重要な点を強調しておく必要があります。入力チャネルによって内部的なリズムが異なる場合があります。つまり、それぞれのチャネルが異なる周期のサイクルを示す可能性があるということです。 このような状況では、すべてのチャネルの値を単一のストリームに機械的に統合すると、潜在的な季節性の依存関係が見えにくくなり、シグナルの動的な特性が歪められるおそれがあります。
こうした特徴が失われるのを防ぐため、私たちは適応型畳み込みメカニズムを実装しました。 このメカニズムの目的は、各時系列の特性を分析し、それぞれのチャネル固有の特徴を考慮したパッチを生成することです。 これにより、各チャネルに対して潜在空間内で同数の表現が割り当てられると同時に、それぞれに固有の周期性に対する感度も維持されます。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronAdaptConv;
   descr.count = Segments;
   descr.window = 2 * prev_out / Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
生成されたパッチにRoPE(Rotary Positional Encoding:回転位置エンコーディング)を適用します。これにより、時間系列における各要素の相対的な位置情報をモデルに与えます。 従来の位置エンコーディングとは異なり、RoPEは潜在空間内で特徴ベクトルを回転させることによって、位置情報を組み込みます。 これにより、後続のTransformer層による処理においてもデータの時間的な構造が保持され、イベント間の距離に関する情報を効率的に伝達できるようになります。 この手法は、イベントの順序やイベント間の時間間隔が重要な役割を果たす時系列分析において、特に重要です。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRoPE;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = prev_var;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、独立した各チャネルのパッチから構成される3次元テンソルを転置し、複数のチャネルのパッチを組み合わせた時間系列形式へと変換します。 この変換により、データの構造を[チャネル × パッチ × 特徴量]から、系列モデルによる処理により適した[パッチ × チャネル × 特徴量]へと変更します。この形式では、各パッチが、すべてのチャネルのデータを同時に含む時間軸上の一断面を表します。 このようにして、K²VAEEncoderでの後続処理に向けてデータを準備し、全体的な時間の流れにおける特徴量間の関係へモデルの注意を向けます。
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
このデータ表現手法は、K²VAEフレームワークの著者らが提唱する主要な概念、特に異種の情報を単一の潜在空間に統合するという目的と整合しています。 一方、ベースライン実装とは異なり、本手法では時系列データの重要な構造的特性、特に各チャネル固有の周期性を保持しています。この特性は、周期的な変動が重要な意味を持つ金融データを扱う上で極めて重要です。 さらに、拡張パッチ化、ステップごとの差分情報、およびタイムスタンプを導入することで、入力表現をより豊かなものにしています。これにより、個々のデータソースが持つ固有の特徴を損なうことなく、安定したパターンや季節性に起因する依存関係をモデルが捉える能力を高めています。
このように拡張され、構造化された環境の現在状態に関する情報を含むパッチ列は、K²VAEEncoderに入力されます。 この段階では確率的エンコーディングがおこなわれ、各入力シーケンスは、エンコーダブロックの出力において埋め込みベクトルの確率分布へと変換されます。 この分布を構成する各埋め込みベクトルは、分析対象の時系列が将来的に取り得る複数のシナリオの一つを、コンパクトでありながら高い表現力を備えた形式で符号化したものです。 したがって、本モデルは将来状態を単一の点推定値として予測するのではなく、将来の推移として考えられる多様な軌跡を反映した確率的な仮説の集合を生成します。 この特性は、本質的に不確実性の高い金融市場を分析する上で、特に重要な意味を持ちます。
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronK2VAEEncoder;
     {
      uint temp[] = {prev_count,                        // units in
                     NScenarios,                        // Scenarios
                     NExperts,                          // MoE
                     TopK                               // Top K
                    };
      if(ArrayCopy(descr.units, temp) < int(temp.Size()))
         return false;
     }
   descr.step = NHeads;
     {
      uint temp[] = {prev_out * prev_var,               // window
                     prev_out * prev_var / descr.step,  // Key dimension
                     2 * prev_out*prev_var / NExperts   // MoE dimension
                    };
      if(ArrayCopy(descr.windows, temp) < int(temp.Size()))
         return false;
     }
   descr.layers = 3;
   descr.variables = 1;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
ここで重要なのは、K²VAEEncoderの出力として得られる潜在空間上の確率分布そのものが、その後の取引意思決定をおこなうためにエージェントへ渡されるという点です。 ただし、この潜在状態の表現力と実用性、すなわち、時系列の将来的な挙動に関する最も可能性の高いシナリオの情報を保持する能力を確保するためには、モデル内部に一連の予測処理パイプラインを構築する必要があります。
前述のとおり、本フレームワークの目的は、従来の意味で高精度な予測を生成することではありません。 それでも、最終的な出力から各埋め込みの確率分布を構成する要素に至るまで、誤差勾配が逆伝播するように学習プロセスを設計する必要があります。 そのために、TimeMoEAttentionと呼ばれる専用の層を導入します。
この層は重要な機能を果たします。すなわち、確率的な埋め込みを集約して統一的な表現を生成し、従来の予測モデルと同様の機能を果たす仕組みを構築します。 このアプローチにより、潜在空間の確率的な性質と、学習および最適化に求められる要件を両立させることができます。その結果、最終的な出力に基づいて、確率分布全体をエンドツーエンドで学習できるようになります。
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * NScenarios, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 3;
   descr.step = NHeads;                                          // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }//---
   CLayerDescription *latent = descr;
次に、短期・中期・長期というそれぞれ異なる予測期間を担当する、3つの標準的な予測モデルのアーキテクチャを構築します。 これらのモデルは重要な役割を担っており、Encoderで形成された潜在表現を、観測データの空間へと写像します。 これにより、各潜在状態は、時系列の将来的な挙動として想定されるシナリオを反映する、実世界の具体的な数値として解釈されます。
なお、これらの予測モデルのアーキテクチャについては、以前の記事ですでに詳しく解説しています。 実際の運用でも十分な有効性が確認されているため、今回は構造を変更せず、そのまま採用しました。 そのため、この記事では、各モデルの具体的な構築方法については詳しく説明しません。
次の論理的なステップは、意思決定システムの中核を担う、取引Actorのアーキテクチャを構築することです。 Actorの役割は、利用可能な情報に基づいて最適な取引行動を選択することです。 将来の市場動向を直接予測しようとする従来の予測モデルとは異なり、ActorはEncoderから提供される将来シナリオの確率的な記述を利用し、各行動がもたらし得る効果を評価します。
Actorモデルには、2つの情報源からのデータが入力されます。 1つ目は、オープンポジション、エクイティ、その他の補助情報を含む現在の口座状態です。 2つ目は、K²VAEEncoderから得られる潜在表現の確率分布であり、その各表現は将来の市場シナリオの1つを記述します。 この確率分布は、最も可能性の高い市場の推移に関する情報を提供するだけでなく、それらのシナリオに対するモデルの不確実性の度合いも表現します。
最初の層には、これまでと同様に、モデルの外部インターフェースとして機能する全結合層を使用します。 Actorはこのインターフェースを通じて、現在の口座状態に関する情報を入力として受け取ります。
//--- Actor
   latent = encoder.At(LatentLayer);
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
入力データは、バッチ正規化層を通じてスケールを調整し、各特徴量を比較可能な形式に変換します。 これにより、特徴量間のスケールの違いを補正し、元のデータの値の大きさや性質に左右されることなく、後続の層が安定して動作できるようにします。
口座状態のデータを正規化した後、Cross-Attentionモジュールに渡します。このモジュールでは、将来の環境状態を表す確率分布を考慮しながら、現在の口座状態を評価します。
ここで、従来のモデルとの重要な違いがあります。Actorは現在の状況に単純に反応するのではなく、将来シナリオの確率分布の広がりや形状を考慮して、意思決定に伴うリスクを評価します。 Encoderの予測に対する確信度が高いほど、つまり確率分布が狭く集中しているほど、Actorが考慮するシナリオのばらつきも小さくなります。 その場合、ポジションサイズを大きくしたり、より積極的な取引パラメータを採用したりするなど、より確信を持った判断が可能になります。 このように、市場の不確実性の変化に応じて、取引戦略が適応的に調整されます。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,           // Inputs window
                     latent.windows[0]       // Cross window
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                      // Input units
                     latent.units[1]         // Cross units
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = NHeads;                      // Heads
   descr.window_out = 8;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
処理された情報は、続いて3層の全結合ニューラルネットワーク(MLP)に入力され、最終的な取引判断が生成されます。 この段階では、現在の口座状態、将来の確率的な表現、そしてアテンション機構によって抽出されたコンテキスト情報が統合されます。 モデルはこれらの情報を総合的に分析し、取引の方向性や具体的なパラメータを決定します。 一見シンプルな構造ですが、取引システム全体の柔軟性と適応性を確保する上で、重要な役割を果たしています。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = TANH;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = 2 * NActions;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Actor の出力層には、取引判断を生成するための確率的ヘッドを設けており、CNeuronVAEOCL層によって実装しています。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronVAEOCL;
   descr.count = NActions;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = NActions / 3;
   descr.window = 3;
   descr.step = 3;
   descr.window_out = 3;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
一見すると、このようなアプローチはリスクが高すぎるように思えるかもしれません。将来シナリオの確率分布に、もともと確率的な性質を持つActorの出力ヘッドを組み合わせることで、意思決定におけるランダム性がさらに高まるのは確かです。 実際の市場環境での運用を考えると、こうした懸念はもっともです。
しかし、このアプローチの重要なポイントは、Actorの確率的な性質が主にモデルの学習初期段階で強く現れるという点にあります。 この段階では、Actorはさまざまな行動を積極的に探索し、環境から得られる幅広い反応を通じて学習します。 経験が蓄積され、行動の結果に対する評価が繰り返されるにつれて、出力分布は次第に有望な戦略の周辺へと集中し、そのばらつきも小さくなっていきます。 その結果、Actorの振る舞いは徐々に安定し、実際の市場環境で自信を持って意思決定するために必要な方向性と一貫性を備えるようになります。
DirectorとCriticの評価モデルは、基本的な構造とデータ処理の仕組みを維持しており、全体としてActorのアーキテクチャを踏襲しています。 主な違いは、入力データの中心となる情報源にあります。現在の口座状態の代わりに、Actorが生成した行動を表すテンソルを入力として受け取ります。 これにより、それぞれの行動をより具体的かつ詳細に評価できるようになります。
一方、Actorに特徴的な確率的意思決定ヘッドは、これらのモデルには設けられていません。 行動の確率分布を出力する代わりに、DirectorとCriticは各行動に対する具体的な評価値や品質シグナルを生成します。 こうした詳細なフィードバックを通じて、Actorは戦略を改善し、取引判断の有効性を高めていきます。
すべてのモデルのアーキテクチャを記述したソースコード一式は、添付ファイルに含まれています。
学習
すべてのモデルコンポーネントのアーキテクチャ設計が完了したら、次のステップである学習プロセスに進みます。 これまでの記事と同様に、学習は2つの段階に分けておこないます。 第1段階では、ターミナルから直接取得できる過去のデータを用いてオフライン学習をおこないます。 このアプローチの特徴は、あらかじめ学習用データセットを用意する必要がないことです。 代わりに、行動を評価する仕組みを学習プロセスに直接組み込んでいます。これにより、初期学習に利用できる過去のデータの範囲が大幅に広がり、手動でのラベル付けや専用データセットの作成といった制約も解消されます。
ここで、これまでの実験を通じて明らかになった重要な問題について説明します。 予測状態の限られた期間内でActorの行動を評価すると、望ましくない挙動が繰り返し発生しました。 具体的には、指定された評価期間内には到達しないほど、ストップロスやテイクプロフィットの水準を高く設定する傾向が見られました。 その結果、相場の反転やポジションを決済する十分な根拠がないまま、含み損を抱えたポジションを長期間保有し続けるという問題が生じます。 この挙動が次第に支配的になると、モデルは短期的な市場の変化に対応する能力を実質的に失い、戦略全体が大局的なトレンドを受動的に追い続けるものになってしまいます。
この問題を解消するため、学習手順に2つの重要な変更を加えました。 1つ目は、割引率(Discount Factor)を大幅に引き下げ、短期的な利益の獲得に重点を置くことです。 この変更により、モデルは行動によって得られる直近の結果を重視し、短期的な影響をより強く考慮するようになります。 この設定では、遠い将来に大きな利益が期待できる場合であっても、現在発生している損失が最終的な報酬に与える影響が相対的に大きくなります。 その結果、モデルは相場の反転を受動的に待ち続ける戦略を避けるようになり、含み損を抱えたポジションを長期間保有し続ける傾向も抑えられます。これにより、実際の市場の動きに対する戦略の適応性が高まります。
2つ目は、構造面での変更として、CheckActionメソッドの評価方法を見直したことです。 従来のように限られた予測期間内で行動を評価する方式を廃止し、利用可能な過去のデータ区間全体を対象として評価する方式を採用しました。 この変更により、学習時のフィードバックの精度が大幅に向上します。評価対象となる履歴期間を広げることで、多くの場合、ストップロスとテイクプロフィットのどちらの水準に到達するかを、過去の価格推移に基づいて正確に判断できるためです。 その結果、各行動をより客観的に評価できるようになり、学習システムは有効な意思決定と効果の低い意思決定を、より明確に区別できるようになります。
double CheckAction(CBufferFloat *action, double equity, uint start_position)
  {
   if(!action || start_position >= Rates.Size())
      return 0;
このメソッドは、以下のパラメータを受け取ります。
- action:取引アクションを表すテンソル。取引量やストップロス(SL)・テイクプロフィット(TP)の水準を含みます。
- equity:現在のエクイティの状態を表す値で、最大ドローダウンの評価に使用します。
- start_position:市場データ配列Ratesにおいて、ポジションを開いた時点の状態を示すインデックスです。
メソッドはまず、actionオブジェクトへのポインタが有効であること、また、開始位置のインデックスがレート配列の範囲を超えていないことを確認します。
次に、取引パラメータを取得します。
double buy_lot = MathMax(double(action[0] - action[3]), 0);
double sell_lot = MathMax(double(action[3] - action[0]), 0);
この仕組みでは、買い方向と売り方向それぞれに対して、個別に取引量を指定できます。 たとえば、action[0] > action[3] の場合は買いポジションを、それ以外の場合は売りポジションを建てるものと判定します。
次に、現在の価格に基づいて必要証拠金を計算し、価格が1ポイント変動した場合の損益額(point_cost)を求めます。取引量が最小許容値を下回っている場合、メソッドはローソク足の値幅に基づいて逸失利益(foregone profit)を算出し、その値を返します。
double marg = 0;
if(!OrderCalcMargin(ORDER_TYPE_BUY, Symb.Name(), 1, Symb.Ask(), marg))
   return 0;
double point_cost = Symb.TickValue() / Symb.TickSize();
if(MathMax(buy_lot, sell_lot) < Symb.LotsMin())
  {
   double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                          Rates[start_position].open - Rates[start_position].low) *
                 point_cost * equity / (2 * marg);
   return loss;
  }
if((marg * MathMax(buy_lot, sell_lot)) >= equity)
  {
   double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                          Rates[start_position].open - Rates[start_position].low) *
                 point_cost * MathMax(buy_lot, sell_lot);
   return loss;
  }
point_cost *= MathAbs(buy_lot - sell_lot);
取引量が大きすぎて、利用可能な資金で必要証拠金をまかなえない場合(marg * lot > equity)も同様です。 この仕組みにより、モデルは利用可能な資金の範囲内で取引を行うよう促される一方、取引を見送ること(inaction)も抑制されます。
次に、提案された行動の有効性を評価します。 まず、買いポジション(ロングポジション)から確認します。
//---
  double tp = 0, sl = 0, profit = 0, reward = 0;
  int stops = MathMax(Symb.StopsLevel(), 10);
  int spread = Symb.Spread();
  if(buy_lot > 0)
    {
     tp = action[1] * MaxTP;
     sl = action[2] * MaxSL;
     if(int(tp) < stops || int(sl) < (stops + spread))
       {
        double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                               Rates[start_position].open - Rates[start_position].low) *
                      point_cost * buy_lot;
        return loss;
       }
     tp = (tp + spread) * Symb.Point() + Rates[start_position].open;
     sl = Rates[start_position].open - (sl + spread) * Symb.Point();
     reward = profit = -spread * Symb.Point() * point_cost;
Actionテンソルの要素からTakeProfitとStopLossの各水準を取得します。 次に、それぞれの値をスケーリングし、ブローカーが定めるストップレベルの要件を満たしているか確認します。
条件を満たしている場合は、TPとSLを実際の価格に変換します。 条件を満たしていない場合は、逸失利益を算出します。
続いて、過去の価格データの一定区間を対象に、価格変動をシミュレーションします。 そのためにループを設定し、履歴データを時系列に沿って順番に走査します。
ここで重要なのは、Rates配列が時系列データであるという点です。 そのため、過去の時間順序を正しく保つために、データを逆順に処理します。
for(uint i = start_position; i >=0; i--)
  {
   if(sl >= Rates[i].low)
     {
      double p = (Rates[i].open - sl) * point_cost;
      profit -= p;
      reward -= p * MathPow(DiscFactor, float(i - start_position));
      break;
     }
ループ内では、リスクを重視した評価方式を採用しており、まずSLへの到達を優先的に確認します。 これは、相場では利益が徐々に積み上がるのに対し、損失は突然、かつ急速に発生する傾向があるためです。 SL水準に到達した場合は、割引率を考慮したうえで、損失額を金額ベースで算出します。
割引率を用いることで、短期的な結果と長期的結果のバランスを柔軟に調整し、安定した収益につながる行動をモデルに学習させることができます。 割引率が高いほど長期的な利益が重視され、低いほど短期的な結果が重視されます。 ただし、この柔軟性にはデメリットもあります。割引を適用すると、大幅なドローダウンを正確に評価することが難しくなります。 発生までに多くのステップを要する損失は大きく割り引かれるため、モデルがその影響を軽微なものとして扱ってしまう可能性があるのです。 その結果、モデルは相場の反転に期待して、含み損を抱えたポジションを保有し続ける傾向があります。実際の市場では、このような挙動がStopOut水準に達するほどの壊滅的なドローダウンにつながるおそれがあります。 このような挙動を防ぐため、割引後の評価に加えて、割引を適用しない絶対的なドローダウン管理も導入しています。
TP(利確)水準への到達確認も、同様の方法でおこないます。
if(tp <= Rates[i].high)
  {
   double p = (tp - Rates[i].open) * point_cost;
   profit += p;
   reward += p * MathPow(DiscFactor, float(i - start_position));
   break;
  }
いずれの決済水準にも到達しなかった場合は、次のローソク足の始値に基づいて、その時点での損益を記録します。
double p = (Rates[i - 1].open - Rates[i].open) * point_cost;
profit += p;
reward += p * MathPow(DiscFactor, float(i - start_position));
ここで特に重要なのは、現在のローソク足の終値ではなく、次のローソク足の始値を使用しているという点です。 多くの場合、両者の値は同じか、わずかな差しかありません。しかし、市場の値動きの特性を考慮する必要があります。 モデルは新しいローソク足が始まる時点で取引判断を下すため、オープンポジションの損益を計算する際にも、その時点の価格を使用するのが適切です。
この方法により、シミュレーションの現実性を保ち、相場の急変時や重要なニュースの発表時などに発生しやすい価格のギャップ(窓開け)も、評価に反映できます。 また、次のローソク足の始値を使用することで、取引判断から実際の約定に至るまでのイベントの順序が明確になり、実際の市場環境における意思決定とその結果の因果関係を適切に捉えられます。
次に、割引率を適用せずに累積した損失を、ポジションを建てた時点のエクイティと比較します。 これにより、取引の実行に必要な資金が十分に確保されているかを確認できます。 損失が利用可能な資金を上回り、口座が破綻する状態に陥った場合は、報酬関数におけるペナルティを増加させ、シミュレーションを直ちに終了します。 これは、資金不足によって取引の継続が不可能になる実際の市場状況を再現するものです。同時に、モデルの学習過程において取引戦略をより現実的かつ安全に評価できるようになります。
    if(-profit >= equity)
      {
       reward-=1000;
       break;
      }
   }
}
ショートポジションも同様に評価します。
   if(sell_lot > 0)
     {
      tp = action[4] * MaxTP;
      sl = action[5] * MaxSL;
      if(int(tp) < stops || int(sl) < (stops + spread))
        {
         double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                                Rates[start_position].open - Rates[start_position].low) *
                       point_cost * sell_lot;
         return loss;
        }
      tp = Rates[start_position].open - (tp + spread) * Symb.Point();
      sl = Rates[start_position].open + (sl - spread) * Symb.Point();
      for(uint i = start_position; i >=0; i--)
        {
         if(sl <= Rates[i].high)
           {
            double p = (sl - Rates[i].open) * point_cost;
            profit -= p;
            reward -= p * MathPow(DiscFactor, float(i - start_position));
            break;
           }
         if(tp >= Rates[i].low)
           {
            double p = (Rates[i].open - tp) * point_cost;
            profit += p;
            reward += p * MathPow(DiscFactor, float(i - start_position));
            break;
           }
         double p = (Rates[i - 1].open - Rates[i].open) * point_cost;
         profit -= p;
         reward -= p  * MathPow(DiscFactor, float(i - start_position));
         if(-profit >= equity)
           {
            reward-=1000;
            break;
           }
        }
     }
//---
   return reward;
  }
最後に、割引率を適用して累積報酬を調整し、その値を呼び出し元のプログラムに返してメソッドの処理を終了します。
モデルのオフライン学習用エキスパートアドバイザー(EA)「…\Experts\K2VAE\Study.mq5」の完全なコードは、添付ファイルに含まれています。 同じ添付ファイルには、本記事の作成に使用したすべてのプログラムも含まれています。
テスト
前述のとおり、モデルの学習は2つの段階に分けておこないます。 まず、第1段階では、15年分のEURUSDの価格履歴を使用し、H1(1時間足)でオフライン学習を実施しました。 このデータセットには、長期間にわたるレンジ相場から急激なトレンド相場まで、また、値動きの穏やかな期間からボラティリティが急上昇する局面まで、さまざまな市場環境が含まれています。 これにより、モデルは多様な市場の動きを学習できました。 Encoderは、市場の重要なパターンを識別し、市場状態をコンパクトでありながら情報量の豊富な表現へと変換する能力を獲得しました。この表現が、エージェントの意思決定の基盤となります。 一方、Actorは、CriticおよびDirectorからのフィードバックを活用し、さまざまな市場環境で有効に機能する、堅牢な取引戦略の構築に取り組みました。
続いて第2段階として、 2024年のデータを使用したオンライン学習をMetaTrader 5 のストラテジーテスターで実施しました。 この段階では、モデルは実際の市場に近い環境で、ローソク足ごとに市場を分析しながら動作します。 そこでは、実際の市場で発生するノイズやランダムな価格変動、さまざまな歪みも考慮されます。 この方法により、モデルの微調整だけでなく、実際の市場の動きに合わせた挙動の調整、戦略の改善、不確実な状況に対する頑健性の向上も図ることができました。
学習完了後は、学習時のパラメータを一切変更せず、2025年1月~3月までの新しい価格データを使用してモデルをテストしました。 その結果を以下に示します。
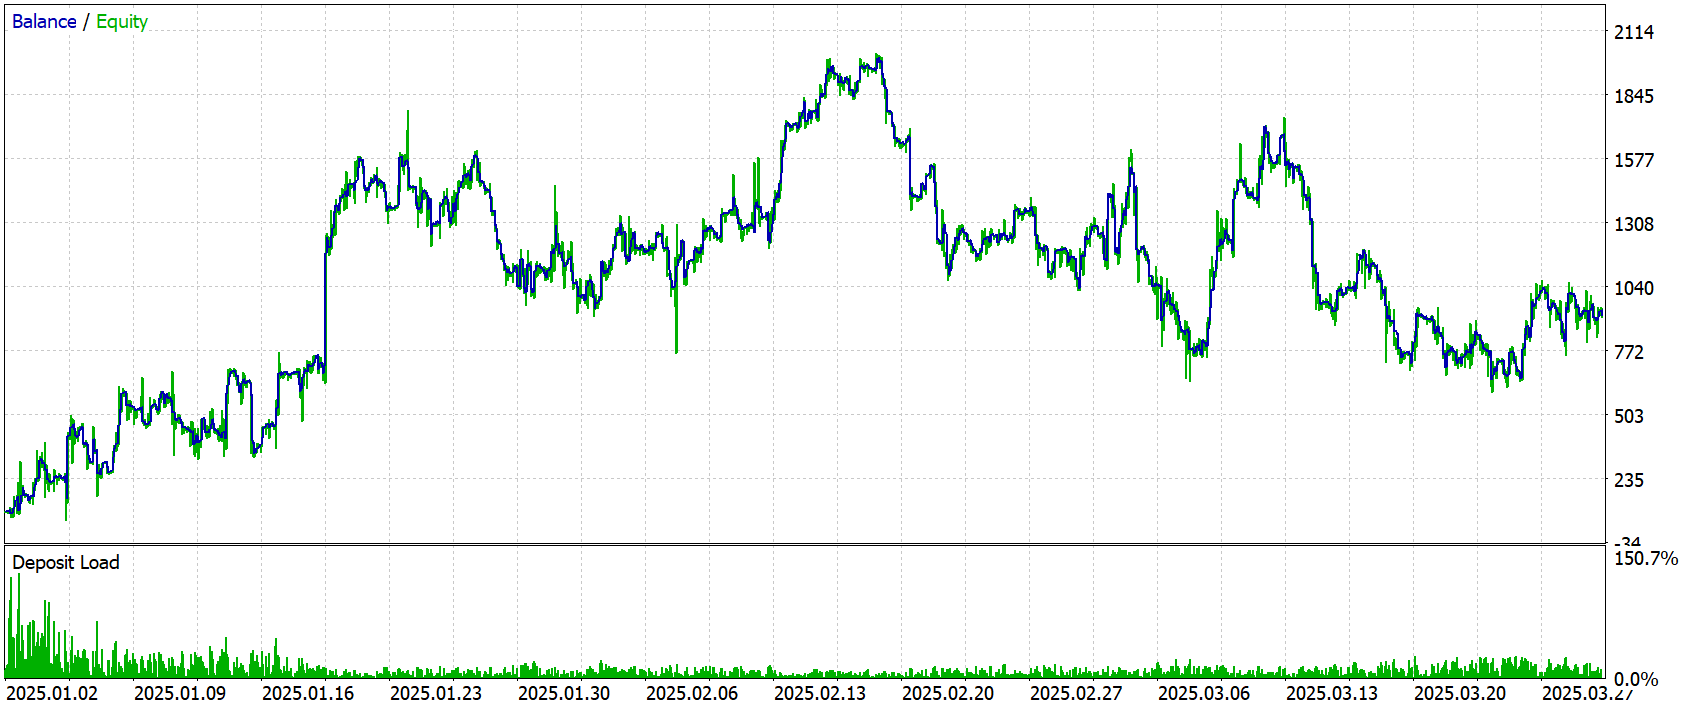
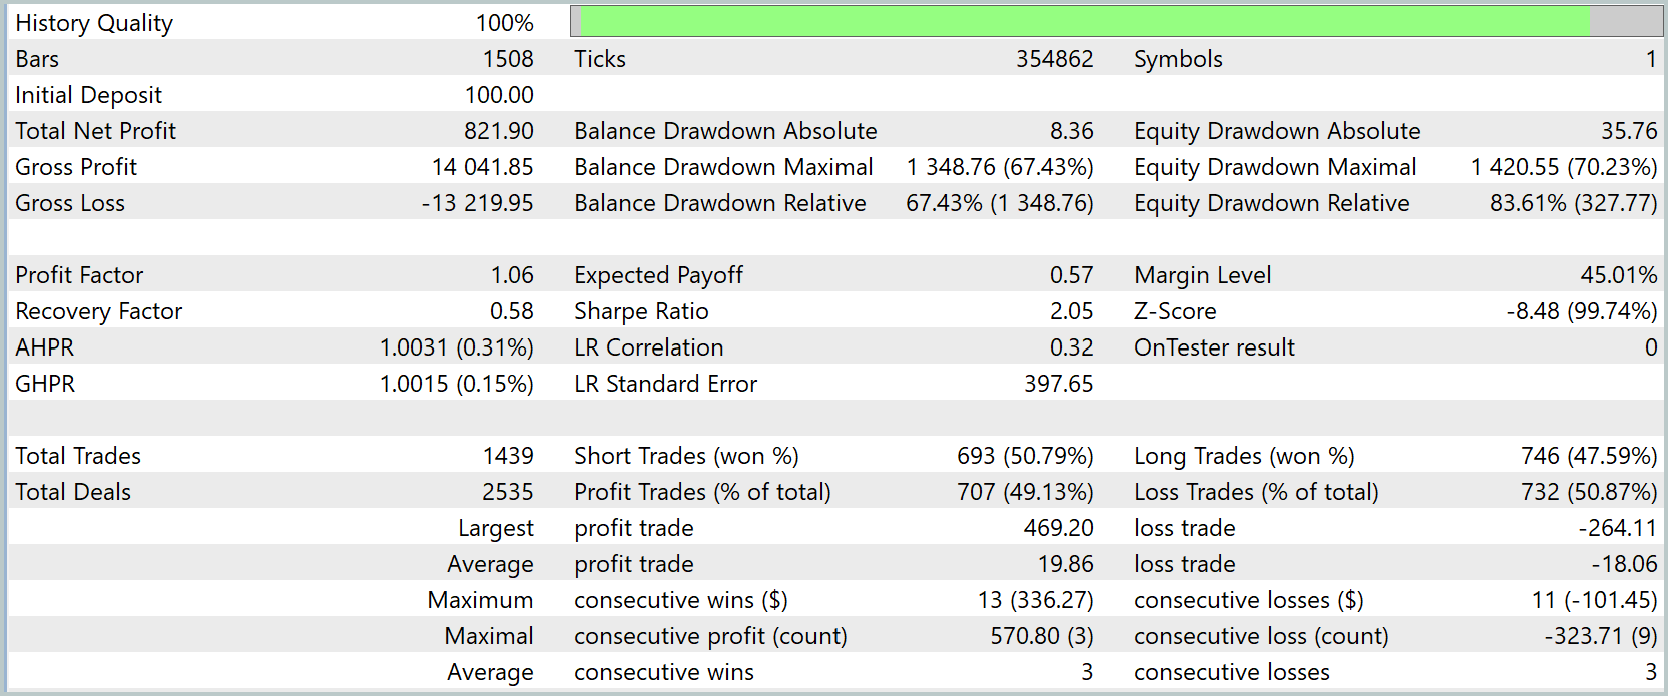
テスト結果から、選択した過去の期間において、モデルが利益を上げたことが確認できます。 初期入金額が100.0ドルであったのに対し、総純利益は 821.90ドルに達し、資金の増加が見られました。 ただし、プロフィットファクターは1.06にとどまっており、利益が損失をわずかに上回る水準であることには注意が必要です。
取引統計を見ると、勝ちトレードと負けトレードの割合はほぼ拮抗しており、それぞれ約49%と51%となっています。この結果からも、利益を上げた取引と損失を出した取引がほぼ同程度の割合で発生していることがわかります。
残高推移のチャートを見ると、途中で目立ったドローダウンや残高の減少が見られるものの、全体としては上昇傾向を示しています。 特に、1月から2月前半にかけて、口座残高が明確に増加している点が注目されます。 一方、3月は明確な損失期間となっています。 この結果は、より長期間の履歴データを用いてモデルをさらに調整する必要性を示唆しています。
結論
今回提案したK²VAEフレームワークは、取引エージェントの一部として一定の有効性を示し、過去の市場データを用いた検証でもその実用性が確認されました。 モデルは、市場の基礎的な動態を捉える能力、状況に応じたリスク調整、そして確率的なシナリオの生成を組み合わせることで、資金の増加を実現しました。 一方、より長期にわたるテスト区間でパフォーマンスが低下したことは、モデルの汎化性能をさらに高めるための改善が必要であることを示しています。
参考文献
- K²VAE: A Koopman-Kalman Enhanced Variational AutoEncoder for Probabilistic Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18807
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(GinAR)
 取引におけるニューラルネットワーク:確率的時系列予測(Encoder)
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(主要構成要素)
 取引におけるニューラルネットワーク:確率的時系列予測(K2VAE)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
VAE.mqhに関していくつかの問題に直面していましたが、以下の方法がその問題をうまく回避できることがわかりました。