取引におけるニューラルネットワーク:スケーリングの代わりに分解する(SSCNN)
 4
 0

はじめに
時系列予測は、データ分析、機械学習、統計学において、依然として基本的な分野の一つです。 その重要性はいくら強調してもしすぎることはありません。金融や気象学から都市インフラや通信に至るまで、動的な変化や予測可能性が重要となるあらゆる分野において、時系列データは重要な役割を果たしています。 しかし、ARIMAや指数平滑法といった従来の単変量モデルでは、外部に開かれ、動的に変化するシステムの複雑さに十分対応できないことが、ますます明らかになっています。
ディープラーニング手法の登場により、状況は劇的に変化し始めました。 特に大きな飛躍をもたらしたのは、Transformerアーキテクチャの導入です。このアーキテクチャは、系列内の要素間の複雑なペアワイズな依存関係を特定するだけでなく、それらの多階層的な表現を抽出することもできます。 まさにこれらの特性によって、Transformerは現代の予測技術における主要な手法の一つとなり、モデル精度の新たな基準を打ち立てました。
大規模言語モデル(LLM)の急速な発展を背景に、ニューラルネットワークの大規模化は、事実上、主流の傾向となっています。 今日、最先端のモデルの大半は数百万のパラメータを有しており、事前学習済みのLLMでは、その数は数十億に達します。 こうした大規模化によって、予測性能は大幅に向上するはずだと思われます。 しかし、予想に反して、改善幅はかなり小さいものにとどまりました。精度の向上(MSEおよびMAE による評価)は30%を超えない一方で、パラメータ数は単純な線形モデルと比較して数百倍から数千倍に増加しています。 さらに、PatchTSTモデル以降、進歩のペースは劇的に鈍化しており、その後のモデルでは緩やかでわずかな改善しか見られません。
こうした観察結果は、この分野が向かっている方向そのものに疑問を投げかけています。 モデルの規模だけでは、高い性能が保証されないことは明らかです。 こうした背景から、予測能力を損なうことなくパラメータ数を削減するという、これとは逆のアプローチがますます重要になっています。
しかし、代替案を提案する前に、パラメータ数を減らすと、なぜ現在の手法の性能が低下するのかを理解することが重要です。 現在のアーキテクチャの多くは、いわゆるパッチ化、すなわち時間軸または空間軸に沿ってデータを断片に分割する手法を採用しています。 このアプローチをAttention機構と組み合わせることで、確かに複雑な依存関係を捉えることが可能になります。 しかし、これには欠点もあります。パッチ化は時間的(あるいは空間的)な識別情報を損ない、観測値間のつながりを断つため、結果として、モデルが捉えるべき構造そのものが失われてしまいます。
こうした損失を部分的に補うため、研究者らは識別情報や時間的位置に関する追加のエンコーディングを導入し、それによって潜在特徴空間を拡張しています。 しかし、保持すべき識別情報が増えるほど、空間の次元数は高くなり、それに伴ってパラメータ数も増加します。 その結果、モデルのサイズは指数関数的に増大します。 これにより、過学習のリスクも高まります。特に、時系列タスクで一般的に見られるように、利用可能な学習データが限られている場合には、そのリスクがさらに高まります。
効果的であるだけでなく少ないパラメータで済むモデルを構築することが目的であれば、パラダイムそのものを再考する必要があります。つまり、潜在空間で構造を再構築するのではなく、最初からデータに含まれる規則性を保持し、活用する方が望ましいのです。 最近の研究では、特徴分解によって、大規模なモデルを使用しなくても精度を大幅に向上できることが示されています。 しかし、このアプローチにも限界があります。 何よりもまず、特にデータに複雑な時空間的関係が存在する場合、長期予測タスクへの適用には限界があります。 さらに、分析面での課題もあります。すなわち、分解はなぜ、どのように機能し、パッチ化と比較してどのような点で優れているのか、という問題です。
これらの問題に応えるため、論文「Parsimony or Capability? Decomposition Delivers Both in Long-term Time Series Forecasting」の著者らは、新しいアプローチとしてSSCNN (Selective Structured Components-based Neural Network)アーキテクチャを提案しています。 このモデルは、精度、パラメータ効率、そして分析的な厳密性を兼ね備えています。 従来の手法とは異なり、SSCNNは、パッチ化に対する特徴分解の利点を初めて形式的に分析し、その優位性を効率性とコンパクト性の両面から裏付けています。 さらに、ここでは選択機構によって基本的な分解が強化されています。このモデルは、個々の時間ステップのレベルで重要な関係を特定できるため、構造成分の再構築精度が大幅に向上し、ひいては予測全体の精度も向上します。
このフレームワークの著者らが実施したベンチマークタスクでのSSCNNのテスト結果は、予測品質の面で既存の手法を一貫して上回る一方、99%のケースでPatchTSTやiTransformerよりも少ないパラメータ数で済むことを示しています。 さらに注目すべきことに、長期予測タスクにおいて、SSCNNは超コンパクトなDLinearモデルと比較しても、パラメータ数を87%削減しています。
SSCNNは、計算能力を増強することによってではなく、データ構造を巧みに活用し、精密に設計することによって、一歩前進を実現しています。 このアプローチは、質の高い予測への道は「量」ではなく「理解」にあることを示唆しています。
SSCNNアルゴリズム
多変量時系列予測の問題において、過去の観測値X= {x1, …,xN} ∈RN*Tin(ここで、Nは変数の数、Tinは分析対象の時系列の長さ)が与えられたとき、長さTout の将来区間における値をX̂∈RN*Toutとして予測することが課題となります。 入力データには、まだ観測されていない将来の値を予測するための前処理が施されます。 予測プロセスでは、データの内部的な動態を反映する一連の中間表現が形成されます。
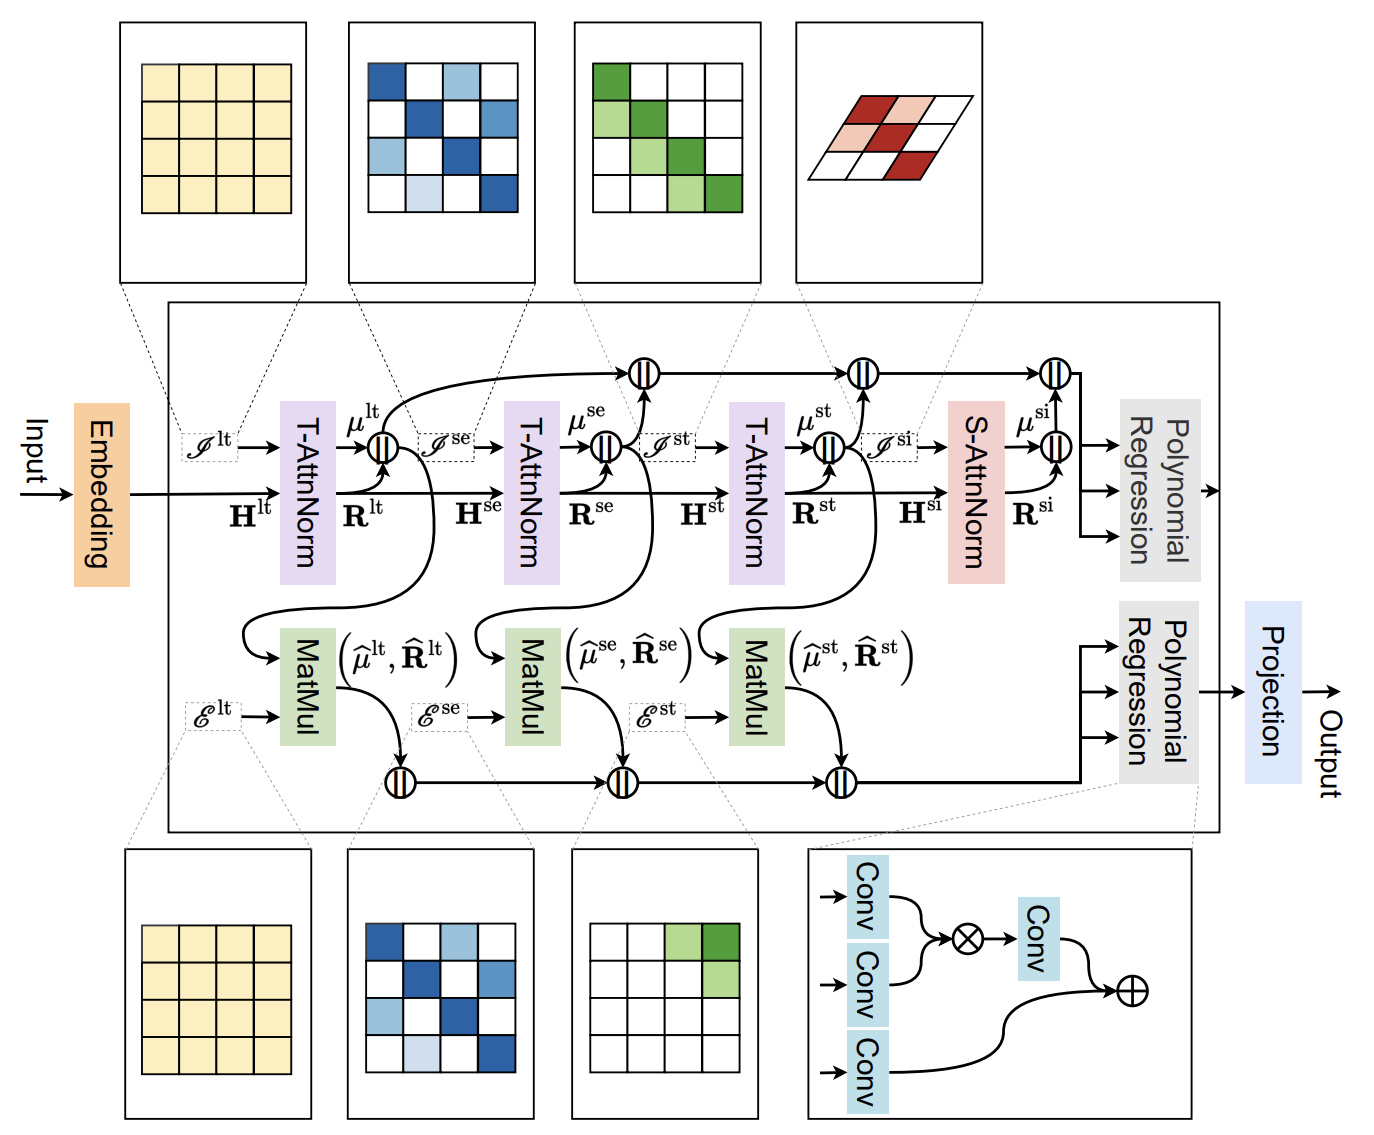
SSCNNアーキテクチャは、機能の異なる2つの分岐で構成されています。 上側の分岐は推論処理を担当し、時系列の構造成分と、それぞれに対応する残差を抽出します。 一方、下側の分岐は外挿、すなわち、これらの成分が時間の経過とともにどのように変化するかを予測する処理を担います。
抽出された成分と残差は、1つの幅広いベクトルに連結され、多項式回帰層に入力されます。 この層により、データの構造的なラベル付けを維持しながら、要素間の複雑な関係を特定できます。
SSCNNフレームワークの著者らは、時間方向のAttention機構に基づく新しい正規化手法であるT-AttnNormを導入しています。 これにより、時系列の主要な構成要素である長期成分、季節成分、短期成分を段階的に特定できます。 これらの成分は、時間軸に沿って、各変数について個別に抽出されます。 同時に、対象となる成分の動的な変化を反映するAttentionマップ(選択マップ)も形成されます。
成分を抽出した後、モデルはその成分を時系列全体の表現から分離し、抽出された成分の構造に含まれない情報を保持する残差信号を生成します。 このように、時系列の初期表現H ∈ RN*Tin*dから、構造成分µ ∈ RN*Tin*dと残差R ∈ RN*Tin*dという2つのストリームが形成されます。 選択マップI ∈ RN*Tin*Tinは、各成分の形成を規定します。
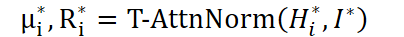
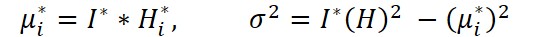
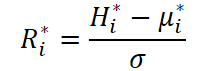
正しく正規化するため、行列I*の各行は、要素の合計が1になるように正規化されます。 長期成分、季節成分、短期成分の違いは、まさにこの行列の構築方法にあります。
ここで重要なのは、ある段階で得られた残差が、次のブロックの入力として渡されるという点です。 たとえば、季節成分を抽出する場合は、長期成分を除去した後に残る残差を入力として使用します。
各構造成分と残差信号への分解が完了すると、両方のストリームは、行列E* ∈ RN*Tin*Toutで定義される線形写像を用いて、将来の予測期間まで外挿されます。 AttentionマップI*と同様に、行列E*も行ごとに正規化されます。
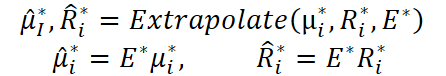
その結果、予測された成分̂µ*および R̂* ∈ RN*Tout*dが得られます。
モデルの長期成分は、時系列における持続的なトレンドを特定し、記述するために使用されます。 この成分をできる限り客観的に評価するため、フレームワークの著者らは、複数の季節にわたって収集された値の平均を算出しています。 このアプローチにより、局所的な影響にとどまり、全体的なトレンドを歪める可能性のある季節変動や短期的な変動の影響を最小限に抑えることができます。
長期成分の抽出と外挿の仕組みは、すべての要素が同じ値を持つ単純な行列を使用して実装されています。このような行列の各要素には 値1/Tinが設定されます。 つまり、過去の各時点が長期的な全体像に等しく寄与するということです。 したがって、時系列の特定のセグメントが優先されることはありません。モデルは、系列全体を平均した挙動に基づいて処理をおこないます。
フレームワークの著者らは、長期成分の処理からAttention機構(attention)を意図的に除外しています。 これまでの経験から、対象となるデータセットでは、Attention機構を導入しても予測精度の向上につながらないことが分かっています。 成分の分布が時間とともに大きく変化する場合には、Attention機構が有効に働き、推定のバイアスを低減できることがあります。 しかし、長期成分の場合、その分布は入力区間全体を通じて安定しています。 そのため、この場合にAttention機構を使用することには合理性がなく、実用的なメリットがないまま、モデルの複雑さを不必要に増すだけです。
モデルの季節成分は、特定の周期で繰り返される規則的な変動を記述するためのものです。 その抽出は、周期の長さが一定であるという前提に基づいており、これによって季節パターンを特定しやすくなります。 ここでは、1周期の長さを表す記号としてcを導入します。 このとき、τinは解析対象の系列に含まれる完全な周期の数を表し(τin • c ≤ Tin)、一方、τoutは出力系列を覆うために必要な最小の周期数を表します(τout • c ≥ Tout)。 以降の計算を簡便にするため、入力長Tinがcの倍数であると仮定します。
季節成分の正確かつ偏りのない推定値を得るため、SSCNN(選択的構造成分に基づくニューラルネットワーク)フレームワークの著者らは、学習可能なパラメータ行列Wse ∈ Rτin*τinを導入しています。この行列の各要素は、2つの周期間の関係を表します。 この行列は、SoftMaxを用いて行ごとに正規化されます。 これにより、現在の周期の重みを計算する際に、それ以前のすべての周期の寄与が考慮されるため、局所的なパターンと全体的なパターンの両方を捉えることができます。
モデルは、特殊な選択マップ、つまり一種のフィルターを構築します。これにより、異なる周期において同じ位相に対応する値だけを抽出できます。 言い換えると、周期の長さに応じて、例えば各月の1日だけ、あるいは毎週の月曜日だけを比較対象とします。 これは、インデックスの差がcの倍数となる要素だけを考慮することで実現されます。また、特定の周期への所属は整数除算によって判定されます。
外挿、すなわち将来の時点における季節成分の予測にも、同様の考え方が適用されます。 出力系列と入力系列の周期間の関係を表す行列Ŵse ∈ Rτout*τinが導入されます。 この行列も正規化され、外挿用の選択マップを生成します。これにより、すでに特定された季節パターンを、将来に向けて論理的かつ一貫した形で拡張できます。
この仕組みにより、モデルは繰り返し現れるデータ構造を正確に考慮し、それらを予測の基準として活用できます。その結果、季節成分の予測において、高い頑健性と精度が確保されます。
短期成分は、季節パターンや長期パターンでは説明できない局所的な異常や短期的な影響を特定するためのものです。 トレンドとは異なり、この成分は限られた観測窓δに基づいて形成されます。この観測窓によって、時間的にどこまで遡ってデータを参照するかが決まります。 こうしたデータは短期的にのみ有効であり、ラグ、すなわち観測点間の時間的な隔たりに応じて、相関の度合いが異なります。
このため、短期成分の抽出にはパラメータベクトルwst ∈ Rδが使用され、指定された観測窓内の各値に異なる重みを付けることができます。 これらの重みにはSoftMax正規化が適用され、モデルの数値的な安定性を維持しながら、重要度の高い観測値を強調できます。 つまり、時系列の直近の値にAttentionを集中させ、予測時点に最も近い変化を捉えます。
短期成分の予測方法は、予測期間がどこまで先に及ぶかによって異なります。 予測対象が今後数ステップであれば、直近の値との相関関係が維持されるため、パラメータ行列wst ∈ Rδ*δに基づく回帰モデルが使用されます。 しかし、モデルがより遠い将来を予測するにつれて、不確実性が蓄積し、予測の信頼性が低下します。 このような場合、モデルはゼロパディングを使用し、過学習につながる可能性のある余分なパラメータを意図的に排除します。
このように、短期成分はコンパクトさと柔軟性を維持し、不要な計算や重みによってモデルを過度に複雑化することなく、局所的な変動を正確に捉えます。 この適応性は、短期的な動態が意思決定において重要な役割を果たす、不安定なデータやノイズの多いデータを扱う際に特に重要です。
空間成分は、これまでに特定された時間的な構造、すなわち長期成分、季節成分、短期成分では説明できない時系列の側面を捉えます。 言い換えると、時間的には不規則でありながら、空間的には一貫性があり、複数の系列において同時に類似した形で現れる特徴を反映します。
この成分は、空間方向のAttention機構に基づく特殊な正規化手法であるS-AttnNormを使用して抽出されます。 時間軸に沿って適用される時間方向の正規化とは異なり、ここでは空間次元に沿って、フレームごとに処理がおこなわれます。 つまり、各時間ステップにおいて、モデルはすべての時系列の挙動を同時に分析し、それらに共通する特徴を特定します。
計算処理は時間方向の正規化と同様の方法でおこなわれます。各フレームについて、平均(centroid)、標準偏差、残差成分が計算されます。 ただし、ここでは時間軸に直交する方向にベクトル化が行われます。つまり、各時間ステップは空間方向の断面として扱われます。
相関分析は、時系列間の関係を特定するために使用されます。特に、主要な時間的構造(トレンド、季節性、短期的な動態)を除去した後にも残る関係に注目します。 各時系列はTin × dの行列として表現され、その後、ベクトル化されます。 これにより、系列間の条件付き相関を反映する類似度行列Isi ∈ RN×Nを構築できます。 したがって、モデルは、反応の時間的な変動がある場合でも、外部要因に対して類似した反応を示す時系列のグループを特定できます。
時間成分と空間成分への分解が完了すると、モデルは集約と解釈の段階に進みます。この段階では、抽出された成分を最終的な予測に使用する統一的な表現へと統合します。 この処理は、多項式回帰層を用いて実装されます。この層は、成分間の線形および非線形の相互作用を可能にする、アーキテクチャの重要な構成要素です。
SSCNNフレームワークの著者らは、独自の実装において、このモジュールの機能を大幅に拡張しています。加法的な関係(加算による関係)に乗法的な依存関係を加えることで、2次の効果を含む、成分間のより複雑な関係をモデル化できるようにしています。
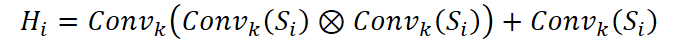
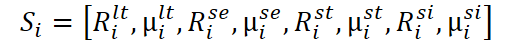
ベクトルSiは、これまでに得られたすべての成分と、それぞれに対応する残差を連結したものです。
この構造により、この層は抽出された特徴量を単に加算するだけでなく、それらの相互依存関係や複合的な効果も特定できます。これは、高次元で相互に関連する時系列を扱う場合に特に重要です。
処理結果であるHiは、主要なパターンをすべて考慮した一般化表現です。 この表現はモデルの次のレベルに渡され、長期ブロックHlt iの新たな反復が始まります。これによってアーキテクチャのループが閉じられ、一貫した予測の動態が確保されます。 このアプローチにより、モデルの表現力が高まり、実際の市場データに合わせて細かく調整する能力も向上します。実際の市場データでは、成分を単純に加算するだけでは不十分な場合が多いためです。
著者によるSSCNNフレームワークの構成図を以下に示します。
MQL5での実装
SSCNNフレームワークの理論的な基礎を詳しく検討したので、次に実装へと進みます。 ここでは、MQL5環境の機能を活用した提案手法の実装例を一つ取り上げ、詳しく見ていきます。 これにより、理論的な概念への理解を深めるとともに、実際の金融市場でどのように効果的に適用できるかを示します。
理論編を読み進める中で、今回紹介するSSCNNフレームワークと、以前取り上げたSCNNのアプローチが、概念的に非常によく似ていることにお気づきかもしれません。 この類似性はフレームワークの名称にも表れており、決して偶然ではありません。 どちらの手法も、時系列を個別の成分に分解するという考え方に基づいています。これにより、データをよりきめ細かく、構造的に分析できるようになります。
しかし、重要な違いは、成分を特定し、その後に外挿するためのアプローチそのものにあります。 SCNNが従来型の分解・予測手法を使用するのに対し、SSCNNでは、選択的な構造分解や専用のAttentionマップなど、革新的な適応機構を取り入れています。これにより、予測の精度と効率が大幅に向上します。
とはいえ、同一の固定値で埋められた行列を使用して長期成分を抽出する処理は、本質的には古典的な正規化、すなわち時間区間全体にわたる平均化に相当します。 この方法なら処理を簡素化でき、新しい仕組みを考案することなく、実績のある既存のソリューションを活用できます。
一方、より複雑な成分である季節成分と短期成分の特定には、 さらに多くの労力と微調整が必要になります。 これらを正しく抽出するには、時系列の周期性、変動性、局所的な特性を捉えることのできる適応機構が必要です。 そのためには、専用のAttentionマップを構築し、期間間の関係をパラメータ化するとともに、局所的な相関を考慮する必要があります。
それでは、実装の重要な要素である、OpenCLによる順伝播カーネルの記述と解析に移りましょう。 実際のデータ処理は、計算アーキテクチャの低レベルに位置するこの部分から始まります。ここでは、基本的な正規化演算とAttention演算を実行します。これらの処理がなければ、モデルの高い予測精度と安定性は実現できません。
この段階への移行は、自然であり、必要なものです。 時系列から長期成分、季節成分、短期成分を慎重かつ一貫して抽出することがいかに重要であるかは、すでに確認しました。 しかし、これらの概念を効率的かつ拡張性のある形で実装するには、大規模なデータセットを並列処理できる強力なツールが必要です。OpenCLはまさにそのようなツールであり、最新のGPUやCPUのリソースを柔軟かつ高いパフォーマンスで利用できます。
まず、Attention機構の適用と入力データの正規化を担う主要な処理モジュール、AttentNormカーネルを作成します。 このカーネルは、生の時系列データを受け取り、事前に計算されたAttention行列を用いて重み付けをおこないます。その後、局所的な平均値と標準偏差を計算し、標準化によってデータを正規化された形式に変換します。
カーネルのパラメータには、分析対象のデータ、Attention重み、平均値と標準偏差を格納する配列、および正規化後の結果を保存するバッファへのポインタが含まれます。 さらに、各シーケンスの要素数と、処理対象となるセグメントのサイズを示す定数も渡されます。
__kernel void AttentNorm(__global const float* inputs,
                         __global const float* attention,
                         __global float* means,
                         __global float* stdevs,
                         __global float* outputs,
                         const int total_inputs,
                         const int segment_size
                        )
  {
   const size_t s = get_global_id(0);
   const size_t i = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t total_segments = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t variables = get_global_size(2);
次に、カーネル内部で、3次元における現在のワークアイテムのインデックスを取得します。 変数sはセグメントのグローバルインデックスを、iはブロック内のローカルインデックスを、vは変数またはチャネルのグローバルインデックスを表します。 これらの値によって、各スレッドは自分が担当するデータ領域を正確に把握できます。 また、処理を適切に分散させるために、セグメントの総数、ローカルブロックのサイズ、および変数の数も取得します。
中間結果を一時的に保存するため、デバイスの高速メモリ内にTempという名前のローカル配列を宣言します。 続いてオフセットを計算します。これは、現在のスレッド、変数、およびセグメントに対応する、元のデータ配列内のインデックスです。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift = v * total_inputs + s * segment_size + i;
計算の開始時に、平均値、標準偏差、および計算の過程で累積される一時的な値を格納する変数を初期化します。 続いてループを開始し、各ローカルスレッドが指定されたストライドでセグメント内の要素を順に処理します。これにより、並列処理と計算負荷の均等な分散が実現されます。 同時に、メモリアクセスエラーを防ぐため、配列の範囲外へのアクセスがないか確認します。
   float mean = 0, stdev = 0;
   float val = 0;
   for(uint l = 0; l < segment_size; l += total_local)
     {
      if((l + i) >= segment_size ||
         (s * segment_size + l + i) >= total_inputs)
         break;
      float val_l = IsNaNOrInf(inputs[shift + l], 0);
      if(l == 0)
         val = val_l;
      float att = IsNaNOrInf(attention[v * segment_size + l + i], 0);
      mean += val_l * att;
      stdev += val_l * val_l * att;
     }
ループの各反復では、オフセットを考慮して元の配列から値を取得します。その際、数値でない値や無限大の値をゼロに置き換える関数を適用し、無効なデータによる問題を防ぎます。 最初の反復では、取得した値を後で使用するために別の変数に保存します。 同様に、対応するAttention重みをAttention重みの配列から取得し、その値が有効であるかどうかも確認します。
次に、平均値を計算するために重み付きの値を累積します。また、後で分散を計算するため、各値の二乗にAttention重みを掛けた値も累積します。 ループが完了すると、ローカル加算関数によって、ブロック内のすべてのローカルスレッドにわたるリダクションが実行されます。各スレッドの部分和が一つの合計値にまとめられ、統計量が正確に計算されます。 さらに、スレッド間の適切な同期を確保するためにバリアを使用し、すべてのスレッドが計算を完了してから次の処理に進むようにします。
   mean = LocalSum(mean, 1, Temp);
   BarrierLoc;
   stdev = LocalSum(stdev, 1, Temp);
//---
   stdev -= mean * mean;
   stdev = IsNaNOrInf(sqrt(stdev), 1);
   if(stdev <= 0)
      stdev = 1;
次に、二乗和から平均値の二乗を引いて分散を計算し、その平方根を求めて標準偏差を算出します。 標準偏差がゼロ以下、または無効な値である場合は、その後の正規化処理でエラーが発生するのを防ぐため、値を1に置き換えます。
続いて、ローカルスレッドの一つが、計算した平均値と標準偏差を対応する出力配列に書き込みます。これにより、各セグメントおよび各変数の計算結果が保存されます。
   if(i == 0)
     {
      int shift_ms = v * total_segments + s;
      means[shift_ms] = mean;
      stdevs[shift_ms] = stdev;
     }
その後、別のループを実行し、データの正規化をおこないます。各入力値から平均値を引き、その結果を標準偏差で割ります。また、計算結果が有効な値であることも確認します。 正規化された値は出力バッファに保存され、後続の処理に渡されます。
   for(uint l = 0; l < segment_size; l += total_local)
     {
      if((l + i) >= segment_size ||
         (s * segment_size + l + i) >= total_inputs)
         break;
      if(l > 0)
         val = inputs[shift + l];
      outputs[shift + l] = IsNaNOrInf((val - mean) / stdev, 0);
     }
  }
このカーネルは、スレッド間で処理負荷を効率的に分散し、Attention重みを考慮しながら統計量を正確に計算するとともに、データを適切に正規化します。これは、予測や分析のタスクで時系列データを扱う際に特に重要です。 ローカルメモリと同期処理を活用することで、高いパフォーマンスと計算の安定性を実現します。
ここで、このカーネルのアルゴリズムが前提としている重要な条件についても触れておく必要があります。 具体的には、ローカルワークグループのサイズが、分析対象となるセグメントのサイズと等しいことを前提としています。 これは単なる形式上の一致ではありません。計算ロジックを簡素化し、GPU上でのコード実行の効率を高めるための基本的な条件です。
この条件が満たされると、ローカルワークグループのサイズと同じ幅でセグメントを順に処理するよう設計されたループは、実質的に1回の反復だけで済みます。 つまり、各スレッドは繰り返し処理を行うことなく、担当するセグメントの要素をちょうど1つだけ処理します。 この方法により、内部ループの複雑さが大幅に軽減され、ロジックが簡素化されます。さらに重要なのは、グローバルメモリへのアクセス回数を最小限に抑えられることです。
グローバルバッファからデータを繰り返し読み込む代わりに、各セグメントの値は最初に読み込んだ時点でローカル変数に保存され、その後はレジスタからアクセスされます。 これによって、パフォーマンスは大きく向上します。レジスタやローカルメモリへのアクセスは、グローバルメモリへのアクセスよりも桁違いに高速です。特に、数百から数千ものセグメントを並列にリアルタイム処理する場合、その違いは顕著になります。
したがって、ワークグループのサイズとセグメントのサイズの比率を適切に設定することは、単なる設定上の要素ではなく、積極的な最適化要因となります。 これにより、ハードウェアアクセラレーションの能力を最大限に引き出し、オーバーヘッドを削減するとともに、時系列処理システム全体の効率を高めることができます。
とはいえ、ここまで説明してきたアプローチがどれほど洗練され、効果的であっても、実際の環境では理想的な条件だけを前提にすることはできません。 残念ながら、ハードウェアの技術的な制約が、常にこちらの希望どおりとは限らないからです。GPUプラットフォームは、アーキテクチャ、利用可能なメモリ、ローカルワークグループのサイズ制限、さらにはドライバー固有の機能など、さまざまな点で異なります。 そのため、ワークグループのサイズとセグメントの長さが厳密に一致することは望ましいものの、必ずしも保証されるわけではありません。
だからこそ、適応性と汎用性を確保するために、コード内にループを残しています。 最適な条件では1回しか実行されませんが、ハードウェアの制約によって必要なサイズのローカルワークグループを指定できない場合には、このループが必要になります。 いわば安全策です。セグメントが利用可能なローカルワークグループのサイズを超えていても、ループによってセグメントを複数の部分に分けて適切に処理できるため、どのような状況でも正しい計算を実行できます。
このように効率と柔軟性のバランスを取ることで、可能な限り高いパフォーマンスを維持しながら、処理能力の低いデバイスでも正しく動作させることができます。 計算処理の世界でも、人生と同じように、常に代替策を用意しておくことが大切です。特に、こちらの都合に合わせてくれるとは限らないハードウェアを扱う場合は、なおさらです。
各要素を、そのセグメントの平均値と標準偏差に基づいて正規化する順伝播について説明しました。次に、より繊細であると同時に、極めて重要な部分である逆伝播アルゴリズムに進みます。 ここでは、単に誤差を伝播させるだけでは不十分です。 平均値と分散はセグメント全体のデータを使って計算されるため、出力勾配の各要素が入力セグメント内のすべての要素に影響することを考慮する必要があります。 このことが、実装に固有の要件をもたらします。
これをより明確に理解するために、正規化された値の入力値に関する導関数を表す式を見てみましょう。
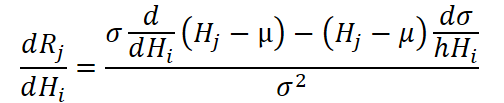
この式には2つの項があります。一方は入力値に関する導関数に直接依存し、もう一方は標準偏差に関する導関数に依存します。そして、標準偏差はセグメント内のすべての値に依存しています。 つまり、他のすべての要素からの寄与を考慮せずに、単一の要素の勾配を計算することはできません。
数式上、これは、各出力勾配を、それに対応する入力の「セル」だけでなく、セグメント全体に逆向きに伝播させる必要があることを意味します。したがって、特定の入力要素に関する勾配を正しく計算するには、セグメント内のすべての出力要素を順に処理し、対象の入力値を変化させた場合に平均値と標準偏差がどのように変化するかを考慮しながら、それぞれの寄与を合計する必要があります。
現在の出力要素のインデックスが、勾配を計算している入力要素のインデックスと一致する場合は、特別なケースとなります。 この場合、影響は統計量の変化を通じてだけでなく、その値自体の正規化に関する導関数を通じても直接伝播します。 一方、インデックスが異なる場合には、間接的な影響だけが残ります。この影響は、平均値と分散の変化によって完全に決まります。
実装上、これは、各入力要素について、セグメント内のすべての出力勾配を順に処理し、それぞれの寄与を合計する必要があることを意味します。 このアプローチではカーネルの構造がより複雑になりますが、数学的な定式化に忠実な計算が可能になります。 ニューラルネットワークモデルを正しく、かつ効率的に学習させるうえで、これは特に重要です。
それでは、AttentNormGradカーネルのアルゴリズムを見ていきましょう。ここでは、誤差逆伝播アルゴリズムの核心部分を扱います。 正規化された出力がセグメント内のすべての値にどのように依存するかを考慮しながら、入力データとAttention重みに関する勾配を計算します。
__kernel void AttentNormGrad(__global const float* inputs,
                             __global float* inputs_gr,
                             __global const float* attention,
                             __global float* attention_gr,
                             __global const float* means,
                             __global const float* stdevs,
                             __global const float* means_gr,
                             __global const float* outputs_gr,
                             const int total_inputs,
                             const int segment_size
                            )
  {
   const size_t i = get_global_id(0);              // main
   const size_t loc = get_local_id(1);             // local to sum
   const size_t v = get_global_id(2);              // variable
   const size_t total_main = get_global_size(0);   // total
   const size_t total_loc = get_local_size(1);     // local dimension
   const size_t variables = get_global_size(2);    // total variables
カーネルの冒頭では、インデックスを次のように定義します。
- i:現在の要素のグローバルID
- loc:ワークグループ内のローカルインデックス
- v:処理対象の変数のインデックス
   __local float Temp[LOCAL_ARRAY_SIZE];
//--- Input gradients
     {
      const int s = i / segment_size;
      const int shift_in = v * total_inputs + i;
      const int shift_ms = v * segment_size + s;
      float grad = 0;
      if(loc == 0 && i < total_inputs)
        {
         Temp[0] = IsNaNOrInf(inputs[shift_in], 0);
         Temp[1] = IsNaNOrInf(means[shift_ms], 0);
         Temp[2] = IsNaNOrInf(stdevs[shift_ms], 1);
         Temp[3] = IsNaNOrInf(means_gr[shift_ms], 0);
         Temp[4] = IsNaNOrInf(attention[(v - s) * segment_size + i], 0);
        }
      BarrierLoc;
ここから、カーネルの最初の処理である、入力データinputsに関する勾配の計算に進みます。 まず、要素iが属するセグメントを特定し、必要なメモリオフセットを計算します。そして、ローカルワークグループ内の最初のスレッド(loc == 0)であれば、入力値そのもの、平均値、標準偏差、平均値に関する勾配、および対応するAttention重みをローカルバッファに読み込みます。 続いて同期バリアを設け、データの読み込みが完了するまで、すべてのスレッドを待機させます。これにより、各スレッドが安全にデータを処理できるようになります。
ここからが最も重要な処理です。 セグメント全体を順に調べ、正規化された各出力が、対象となる入力値の勾配にどの程度寄与するかを分析します。 この処理では、対象となる位置が一致するかどうか(same)、つまり、勾配を求めている入力要素と同じ要素であるかどうかに特に注意します。 同じ要素であれば、その寄与を直接計算します。一致しない場合は、セグメントの統計量の変化を通じた間接的な寄与だけを計算します。 そのため、値が平均値からどの程度離れているかだけでなく、その値が標準偏差に与える影響も考慮します。 これらの寄与は、変数gradに順次累積されます。 また、他の情報ストリームを通じて累積された平均値に関する勾配も考慮します。
      if(i < total_inputs)
        {
         float x = Temp[0];
         float mean = Temp[1];
         float stdev = Temp[2];
         float mean_gr = Temp[3];
         float att = Temp[4];
         for(int l = 0; l < segment_size; l += total_loc)
           {
            if((l + loc) >= segment_size ||
               (i * segment_size + loc + l) >= total_inputs)
               break;
            float out_gr = IsNaNOrInf(outputs_gr[v * total_inputs + s * segment_size + loc + l], 0);
            bool same = (i - s * segment_size) == (loc + l);
            float xl = x;
            if(!same)
               xl = IsNaNOrInf(inputs[v * total_inputs + s * segment_size + loc + l], 0);
            float dy = ((int)same - att) * (1 / stdev - (xl - mean) * att * x / pow(stdev, 3.0f));
            float dmean = (same ? IsNaNOrInf(mean_gr * att, 0) : 0);
            grad += IsNaNOrInf(dy * out_gr + dmean, 0);
           }
        }
      grad = LocalSum(grad, 1, Temp);
      if(loc == 0 && i < total_inputs)
         inputs_gr[shift_in] = grad;
      BarrierLoc;
     }
計算された値はローカルで合計され、inputs_grバッファに書き込まれます。
入力データに関する勾配の計算が終わったら、次の処理である、Attention重みに関する勾配の計算に進みます。 ここでは、先ほどとは着目点が変わりますが、基本的なロジックは同じです。 各i(セグメント内の要素)について、すべての入力データを順に調べ、Attention重みが変化したときに出力がどのように変化するかを計算します。 処理の構造は変わりません。局所勾配を計算し、位置の一致を確認し、標準偏差と平均値の変化を通じた寄与を考慮します。 そして、再び局所的な総和を慎重に計算し、その結果をattention_grに保存します。
//--- Attention gradient
     {
      float grad = 0;
      int shift_att = v * segment_size + i;
      if(i < segment_size)
        {
         float att = IsNaNOrInf(attention[shift_att], 0);
         for(int l = 0; l < total_inputs; l += total_loc)
           {
            if((l + loc) >= total_inputs)
               break;
            int shift_out = (l + loc) + v * total_inputs;
            int s = (l + loc) / segment_size;
            int shift_in = v * total_inputs + s * segment_size + i;
            float x = IsNaNOrInf(inputs[shift_in], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float mean = means[v * segment_size + s];
            float stdev = stdevs[v * segment_size + s];
            float mean_gr = means_gr[v * segment_size + s];
            bool same = (i - s * segment_size) == (loc + l);
            float xl = x;
            if(!same)
               xl = IsNaNOrInf(inputs[shift_out], 0);
            float dy = -x / stdev - (xl - mean) * x * x * (1 - 2 * att) / (2 * pow(stdev, 3.0f));
            float dmean = IsNaNOrInf(mean_gr * x, 0);
            grad += IsNaNOrInf(dy * out_gr + dmean, 0);
           }
        }
      grad = LocalSum(grad, 1, Temp);
      if(loc == 0 && i < segment_size)
         attention_gr[shift_att] = grad;
     }
  }
このカーネルは、先に導出した式に従って勾配を計算します。 コード全体は単なる命令の集まりではなく、緻密に構成されたシステムです。 各スレッドは、個々の入力値やAttention重みの変化が、グループ全体の出力にどのような影響を与えるかを慎重に計算します。 その処理には、ローカルバッファによる最適化、正確な同期、および境界条件への適切な対応が含まれています。 これこそが、真のエンジニアリングによる解決策です。厳密に設計され、適切に調整されている一方で、ハードウェアの性能や数値微分の特性にも柔軟に対応できます。
ここまで、SSCNNフレームワークの主要な構成要素である、Attention機構を備えた正規化モジュールのOpenCLプログラム内での実装を詳しく検討してきました。 理論は、各要素の重みを考慮し、その影響をデータ構造全体に高い精度で分配できる、実際に動作するアルゴリズムへと変わりました。 ローカルメモリとグローバルメモリの連携を適切に調整することがいかに重要か、ハードウェアアーキテクチャの特性を考慮することがいかに不可欠か、そして、形式上は単純な正規化演算であっても、並列処理環境では本格的な計算タスクとなる理由を確認しました。
しかし、私たちの取り組みはまだ終わりではありません。 正規化は、SSCNNフレームワーク全体を支える複数の構成要素からなる仕組みの一側面にすぎません。 次の記事でも、引き続き実装を進めていきます。 最も興味深い部分は、これから始まります。
結論
本記事では、SSCNNフレームワークの理論的側面について、特に時系列の構造的分解という考え方と、Attention機構に基づく正規化を用いた成分の抽出に焦点を当てて検討しました。 このフレームワークの著者らは、計算オーバーヘッドを最小限に抑えながら、高次元の時系列を処理できる、理論的に裏付けられたアーキテクチャを提案しています。
本記事の実践編では、フレームワークの主要な構成要素の一つであるT-AttnNorm層の実装を詳しく検討しました。 特に、順伝播と逆伝播の処理、およびグローバルメモリとローカルメモリの相互作用に注目しました。 また、特殊なケースにおけるアルゴリズムの動作上の細かな点を確認し、OpenCLアーキテクチャに適応させるための実践的な解説も加えました。
これにより、SSCNN全体を実装するための基盤を整え、モデルの学習可能性を確保するための土台を築きました。また、勾配の正確な集約と導関数の計算が重要であることも確認しました。 次の記事でも、引き続き取り組みを進めていきます。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19069
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。